流萤简历是我做的 AI 简历与求职资料工作台。这是专栏第 5 篇,从资料分享与共同编辑切入,聊统一写入、事务、版本和动态权限。
产品特写:分享一份资料,也把编辑边界交代清楚
流萤的资料可以按知识库或单页分享,页面也能继承父级权限。你可以让同伴阅读、评论或编辑某个专题,再让自己的 AI 在授权范围内整理内容。操作入口不同,写的仍是同一份资料。
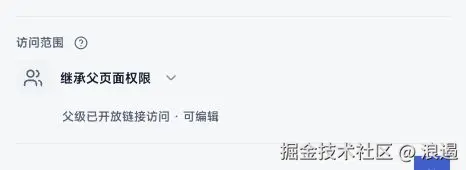
截图截取了分享弹窗的权限区。"继承父页面权限"意味着页面当前角色要沿目录和授权来源计算,不是复制一个永久不变的 canEdit。如果资料后来被移动、上级授权被撤销,原来能编辑的人不一定还能继续写。
产品里增加一个写入口很容易:再加一个保存接口即可。困难是让所有入口都同时维护正文、版本、历史、页面地址和权限。如果这些责任分散,系统可能出现正文已变、目录索引仍旧,或者网页受限、CLI 却能继续提交的状态。
数据放在哪里,决定锁要保护多大范围
当前练习资料以 practice_libraries.nodes 的 JSONB 数组保存,包含页面树和内容;一个所有者的资料库有一个 revision。JSONB 是 PostgreSQL 存储 JSON 结构的类型,可以在数据库里查询其中字段。
页面的稳定身份、父子关系、访问设置等另外在 workspace_pages 维护。历史版本进入 flowing_versions。这些表承担不同职责:正文树是内容,页面索引让 UUID 能被解析到所有者和权限,历史记录支持回看和恢复。
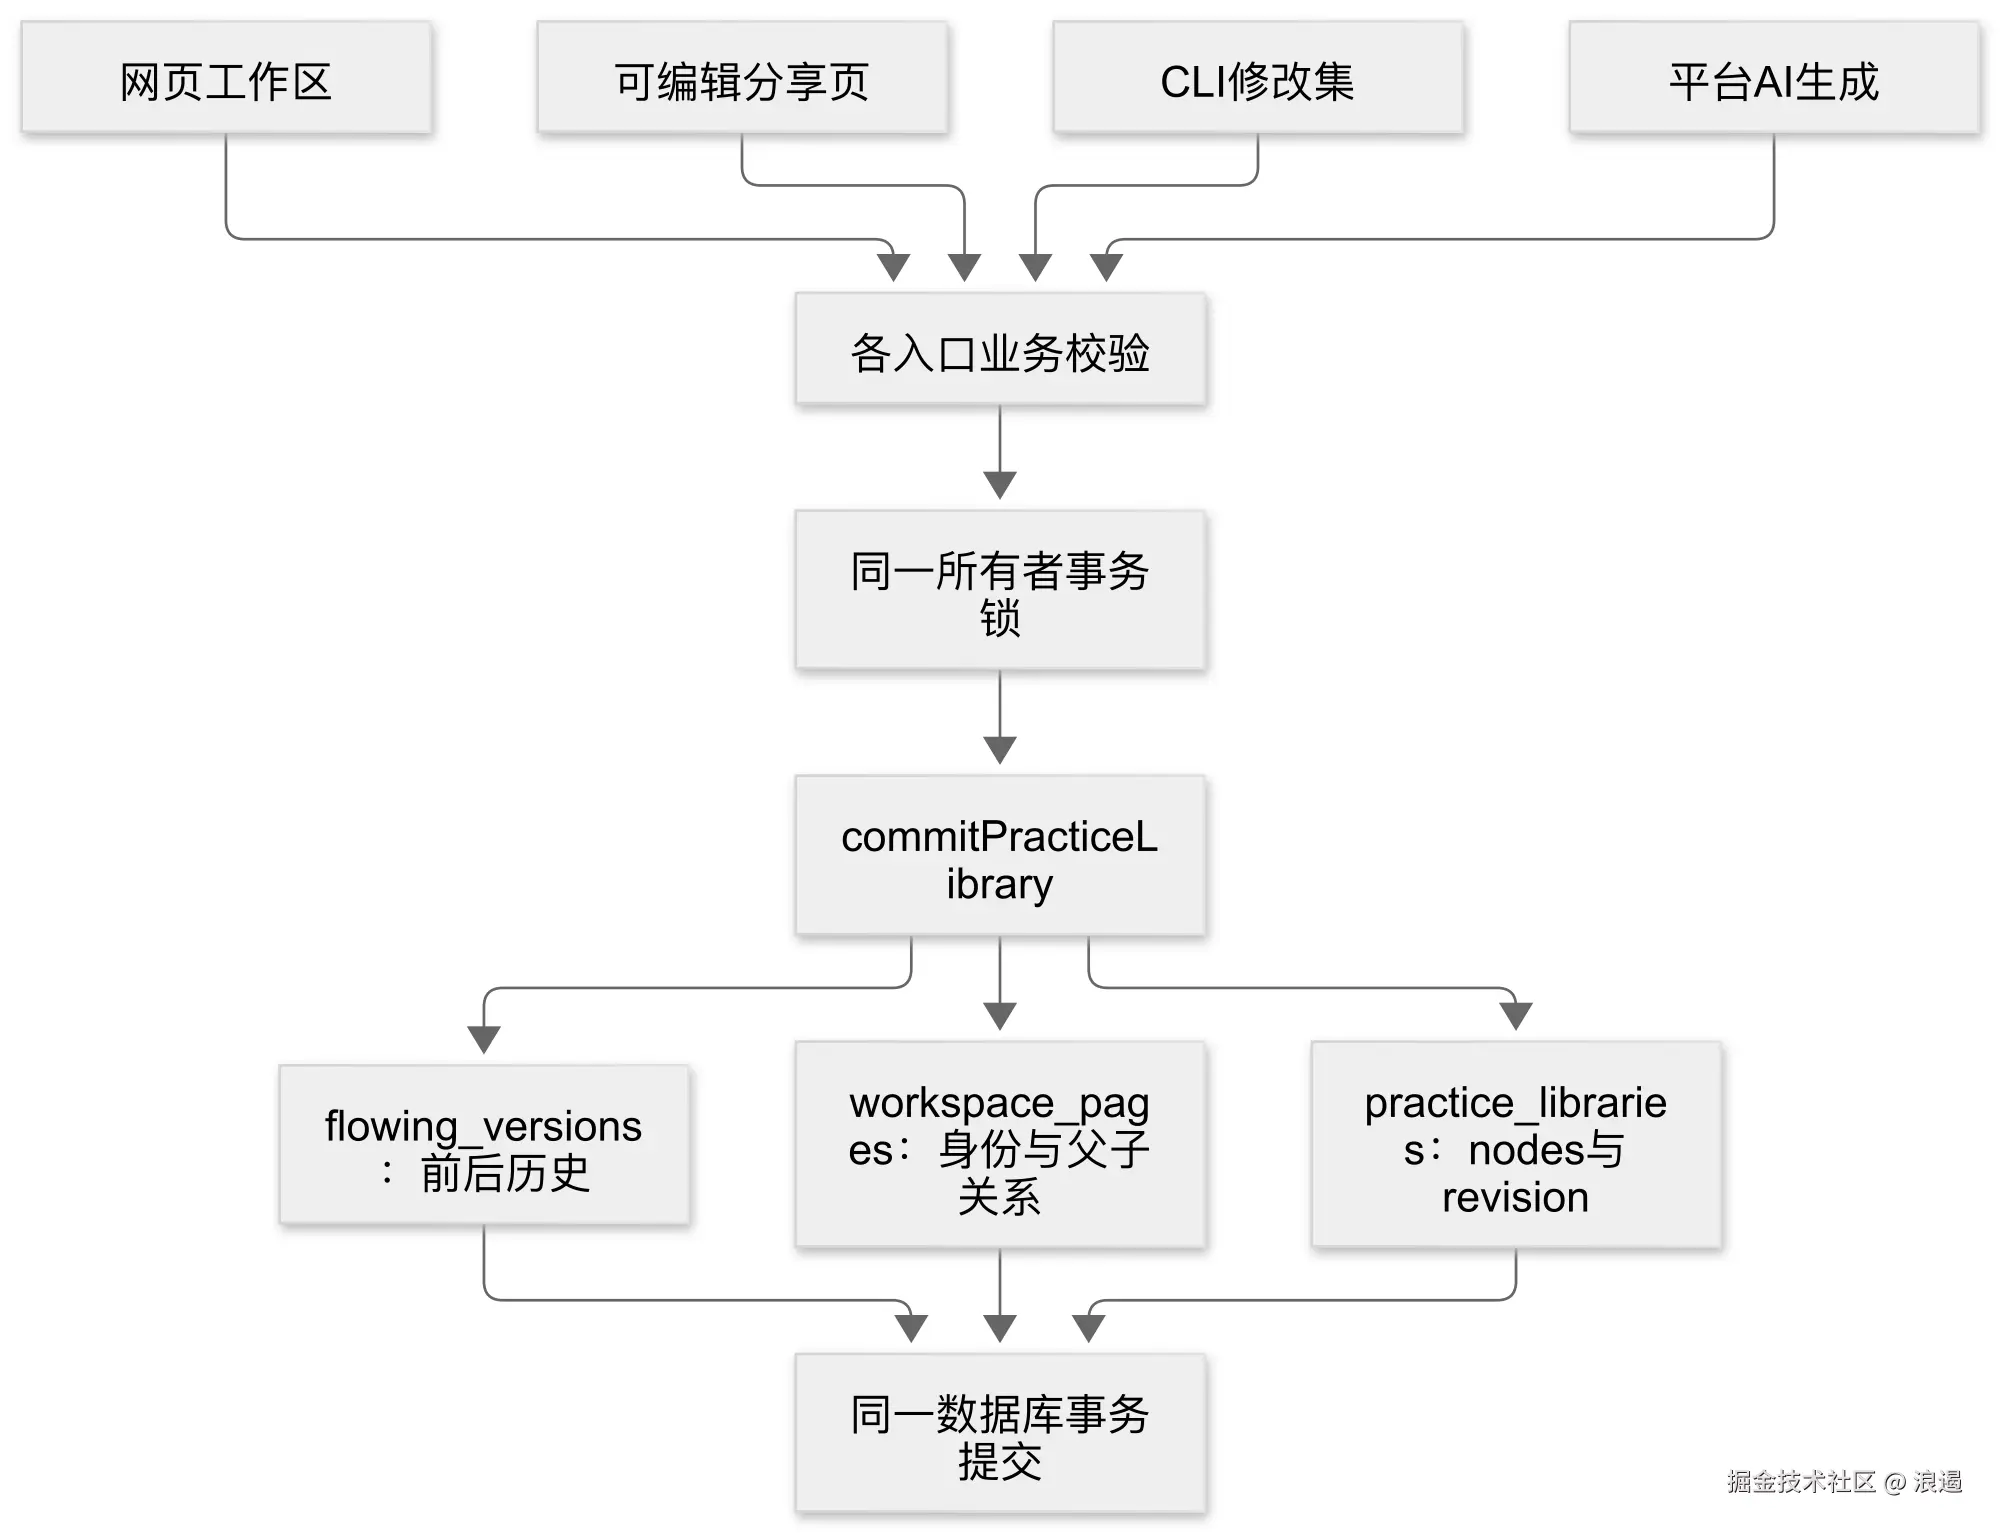
"统一"并不是让每个入口都接受同样的请求体。网页提交可编辑字段,共享页只允许改当前页面,CLI 还要检查连接范围。它们可以有各自的适配与业务校验,最终内容落库应经过同一个负责版本、历史与索引的函数。
当前的统一点是 commitPracticeLibrary()。它的前提写得很明确:调用方已经持有所有者事务锁。锁在哪里获取、什么时候释放,是函数契约的一部分,不能每个调用方都临时创造一套不同的锁键。
所有者锁与 revision,分别防什么
锁和版本检查经常被当作二选一。这里它们处理不同层次的问题。
所有者事务锁使用 PostgreSQL 的 advisory transaction lock,也就是应用约定锁键、由数据库随事务释放的协作锁。资料写入、权限变化和相关业务使用同一 career:<ownerId> 键时,才能在多进程之间按所有者串行安排关键操作。
revision 则防止旧客户端覆盖已经提交的新状态。即使所有请求都排队,两个请求可能都基于版本 20 生成候选;后进入锁的请求仍然是过时的,不能因为"已经排队了"就让它覆盖前一个结果。
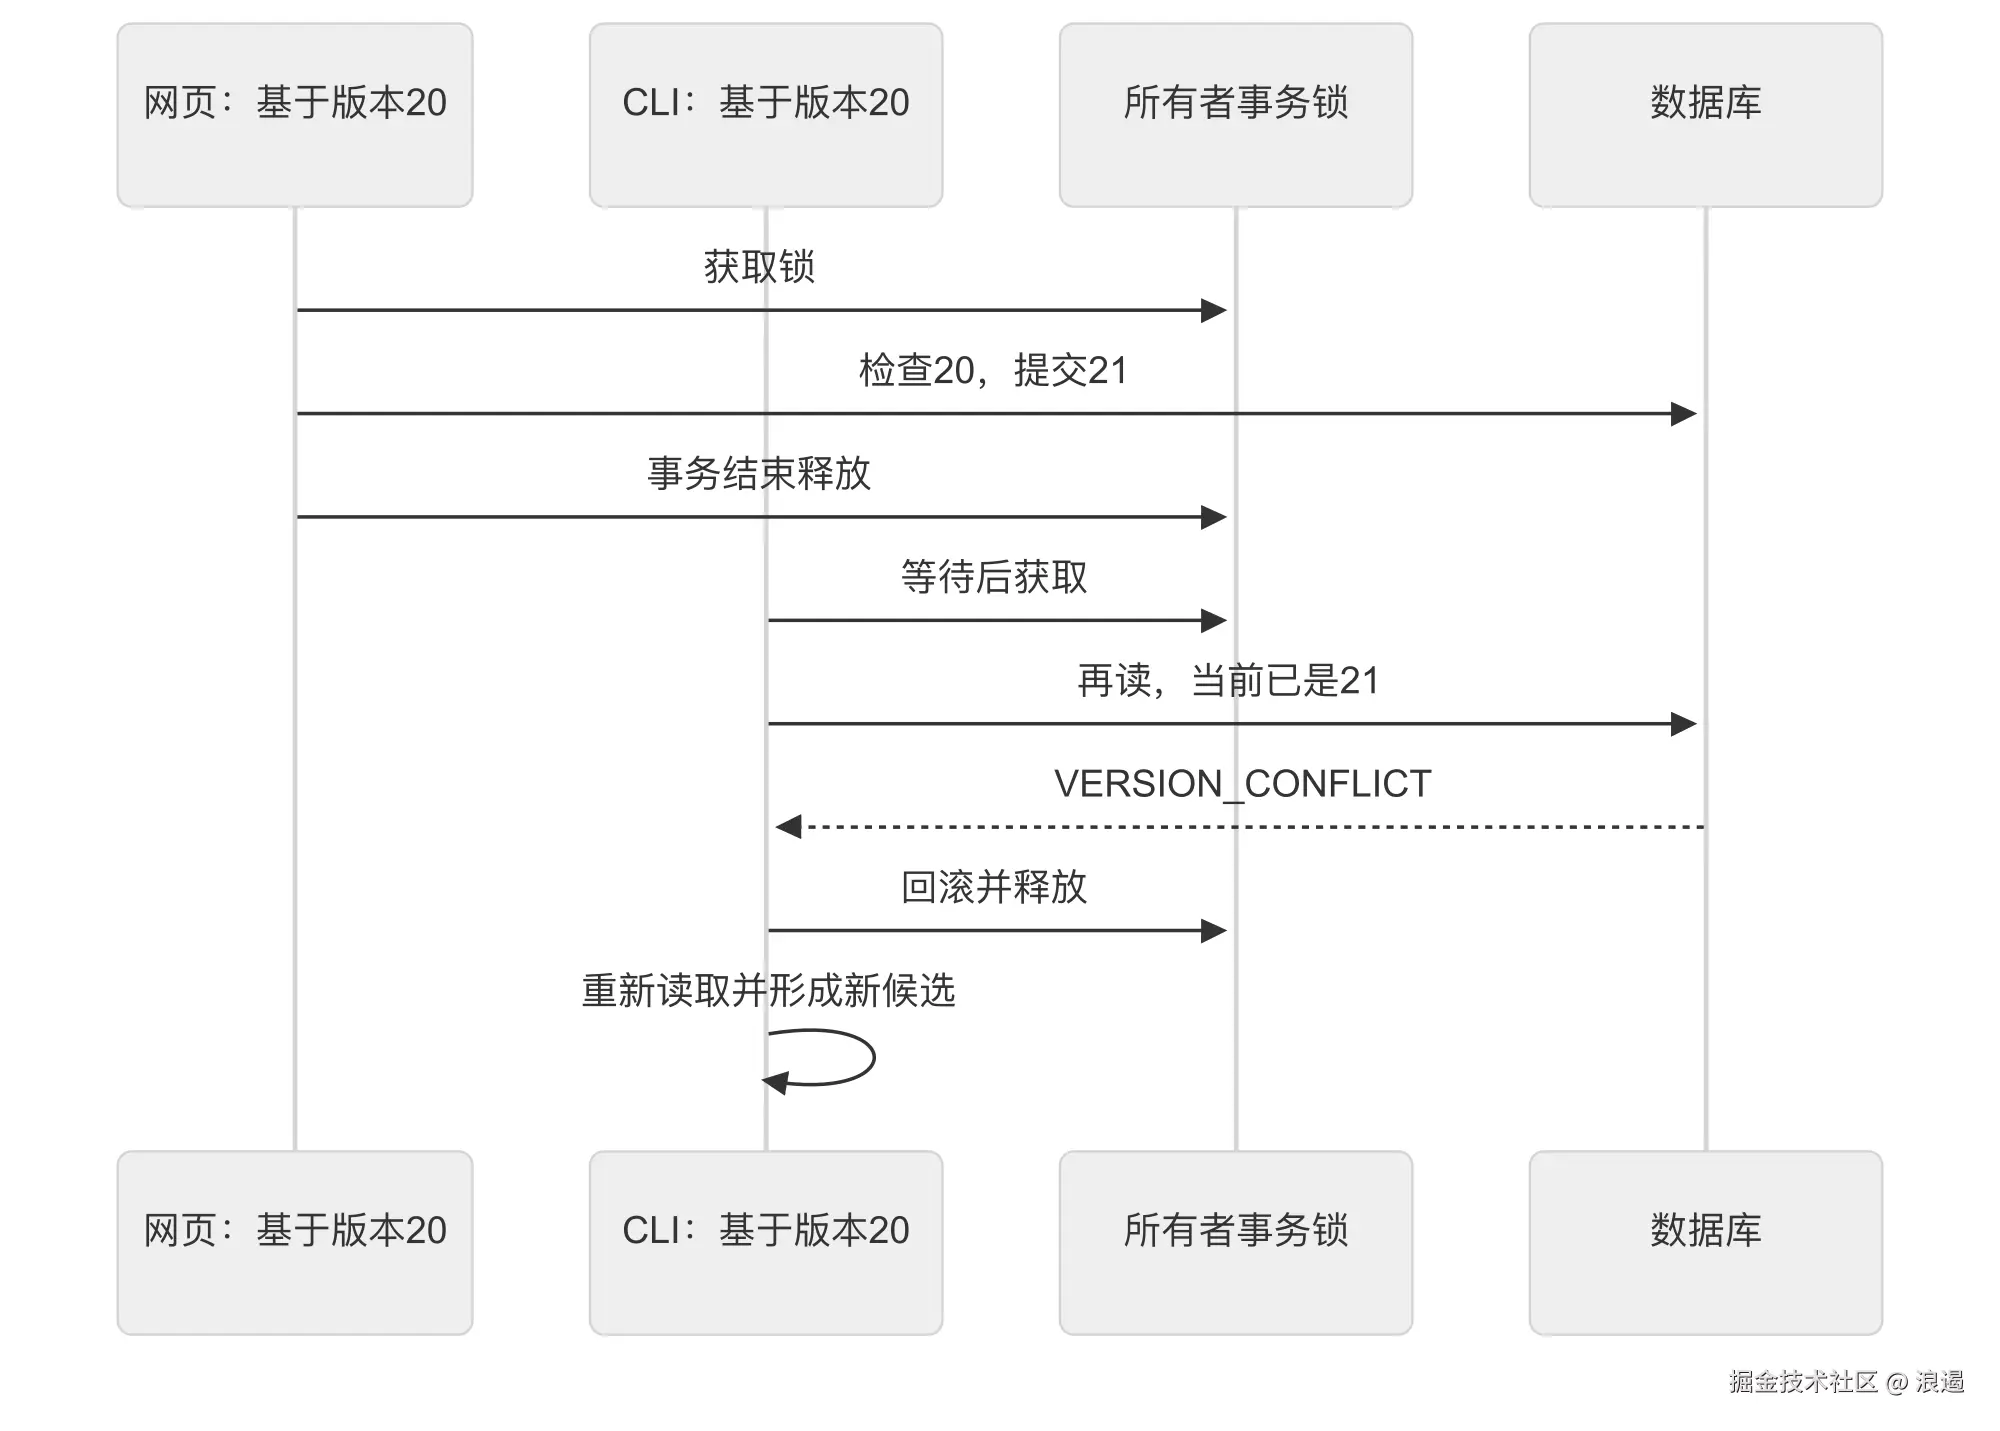
只做"先查后写"而没有共同锁与条件更新,会在查询和写入之间留下窗口;只有锁而没有客户端版本,又无法判断候选是否基于旧内容。两者与事务组合,才对应这里的数据布局。
代价是锁粒度较大。同一所有者的不同页面修改也可能互相等待,revision 还会让两个不同页面的编辑产生整库冲突。当前资料规模由业务限制控制,这是一种可理解的简化,但不是无限扩展的终点。若以后把页面拆成独立存储,需要连同历史、目录操作和权限一致性一起重新设计。
一次提交里,实际上要完成哪些事
commitPracticeLibrary() 读取旧资料并核对 revision,推导页面视图,按 ID 比较新旧节点,为发生变化的页面写入前后快照,再同步页面索引,最后以期望 revision 条件更新整库。
历史只记录变化页,不把每个未变化页面都复制一次。actorId 记录实际操作者,changeId 可以关联外部修改集。一个共享成员修改所有者资料时,资源归属仍是 owner,历史里的 actor 应是那个成员,两者不能混成同一个账号。
下面是机制伪代码,省略了 SQL 和历史去重:
ts
assert(old.revision === expectedRevision);
const nodes = derivePracticeViews(candidate);
for (const changedPage of diffById(old.nodes, nodes)) {
  await writeBeforeAndAfter(tx, changedPage, actorId, changeId);
}
await syncPageIndex(tx, ownerId, nodes);
await updateLibraryConditionally(tx, nodes, expectedRevision);
把这几步放进同一事务,意味着索引同步失败,正文和历史都不会留下半成品;条件更新失败,也不会出现"历史说保存过,但正文没有对应版本"。
这比给几个更新函数分别加 try/catch 更根本。捕获异常可以让程序展示错误,事务才能让多项状态回到共同边界。恢复策略应该首先由数据负责层定义,调用方负责保留草稿与呈现可恢复状态。
页面永久地址,靠的是身份连续
用户收藏或发给同事的是 /p/<pageId>。如果每次重排目录都重新生成 ID,这个地址就会断。当前页面索引把身份与正文树分开,移动页面更新父级关系,原 ID 继续使用。
同步索引还要防止跨账号接管。候选里的 ID 如果已经属于其他所有者,或者对应知识库入口而不是普通页,必须拒绝;不能因为请求来自一个已登录账号,就允许它把那个 ID "同步到自己名下"。
删除从正文树中移除节点,但页面索引用 deletedAt 记录回收状态。恢复同一页面 ID,原地址可以继续对应该资源,成员与评论的身份关系也能延续。能否恢复正文,还依赖历史保留期和目标目录校验,软删除并不等于正文永远保留。
同步过程中,父级关系变化会递增 accessRevision。这是因为移动页面可能改变继承的权限。结构变化与访问变化在产品里常是同一动作的两面,不能只更新目录视图。
继承权限,应该沿当前来源计算
资料角色从 view、comment、edit 到 full 分级。pagePermissionSources() 从当前页向上查找,遇到停止继承或知识库入口结束,再由 resolvePageRole() 综合有效授权。
直接用户成员、已验证邮箱对应的历史授权、链接访问与所有者身份有各自的条件。多个有效来源取最高角色;被回收的相关权限来源会拒绝访问。当前产品的链接访问还要求满足微信身份等条件,不能写成"任何匿名访客拿到链接即可看"。
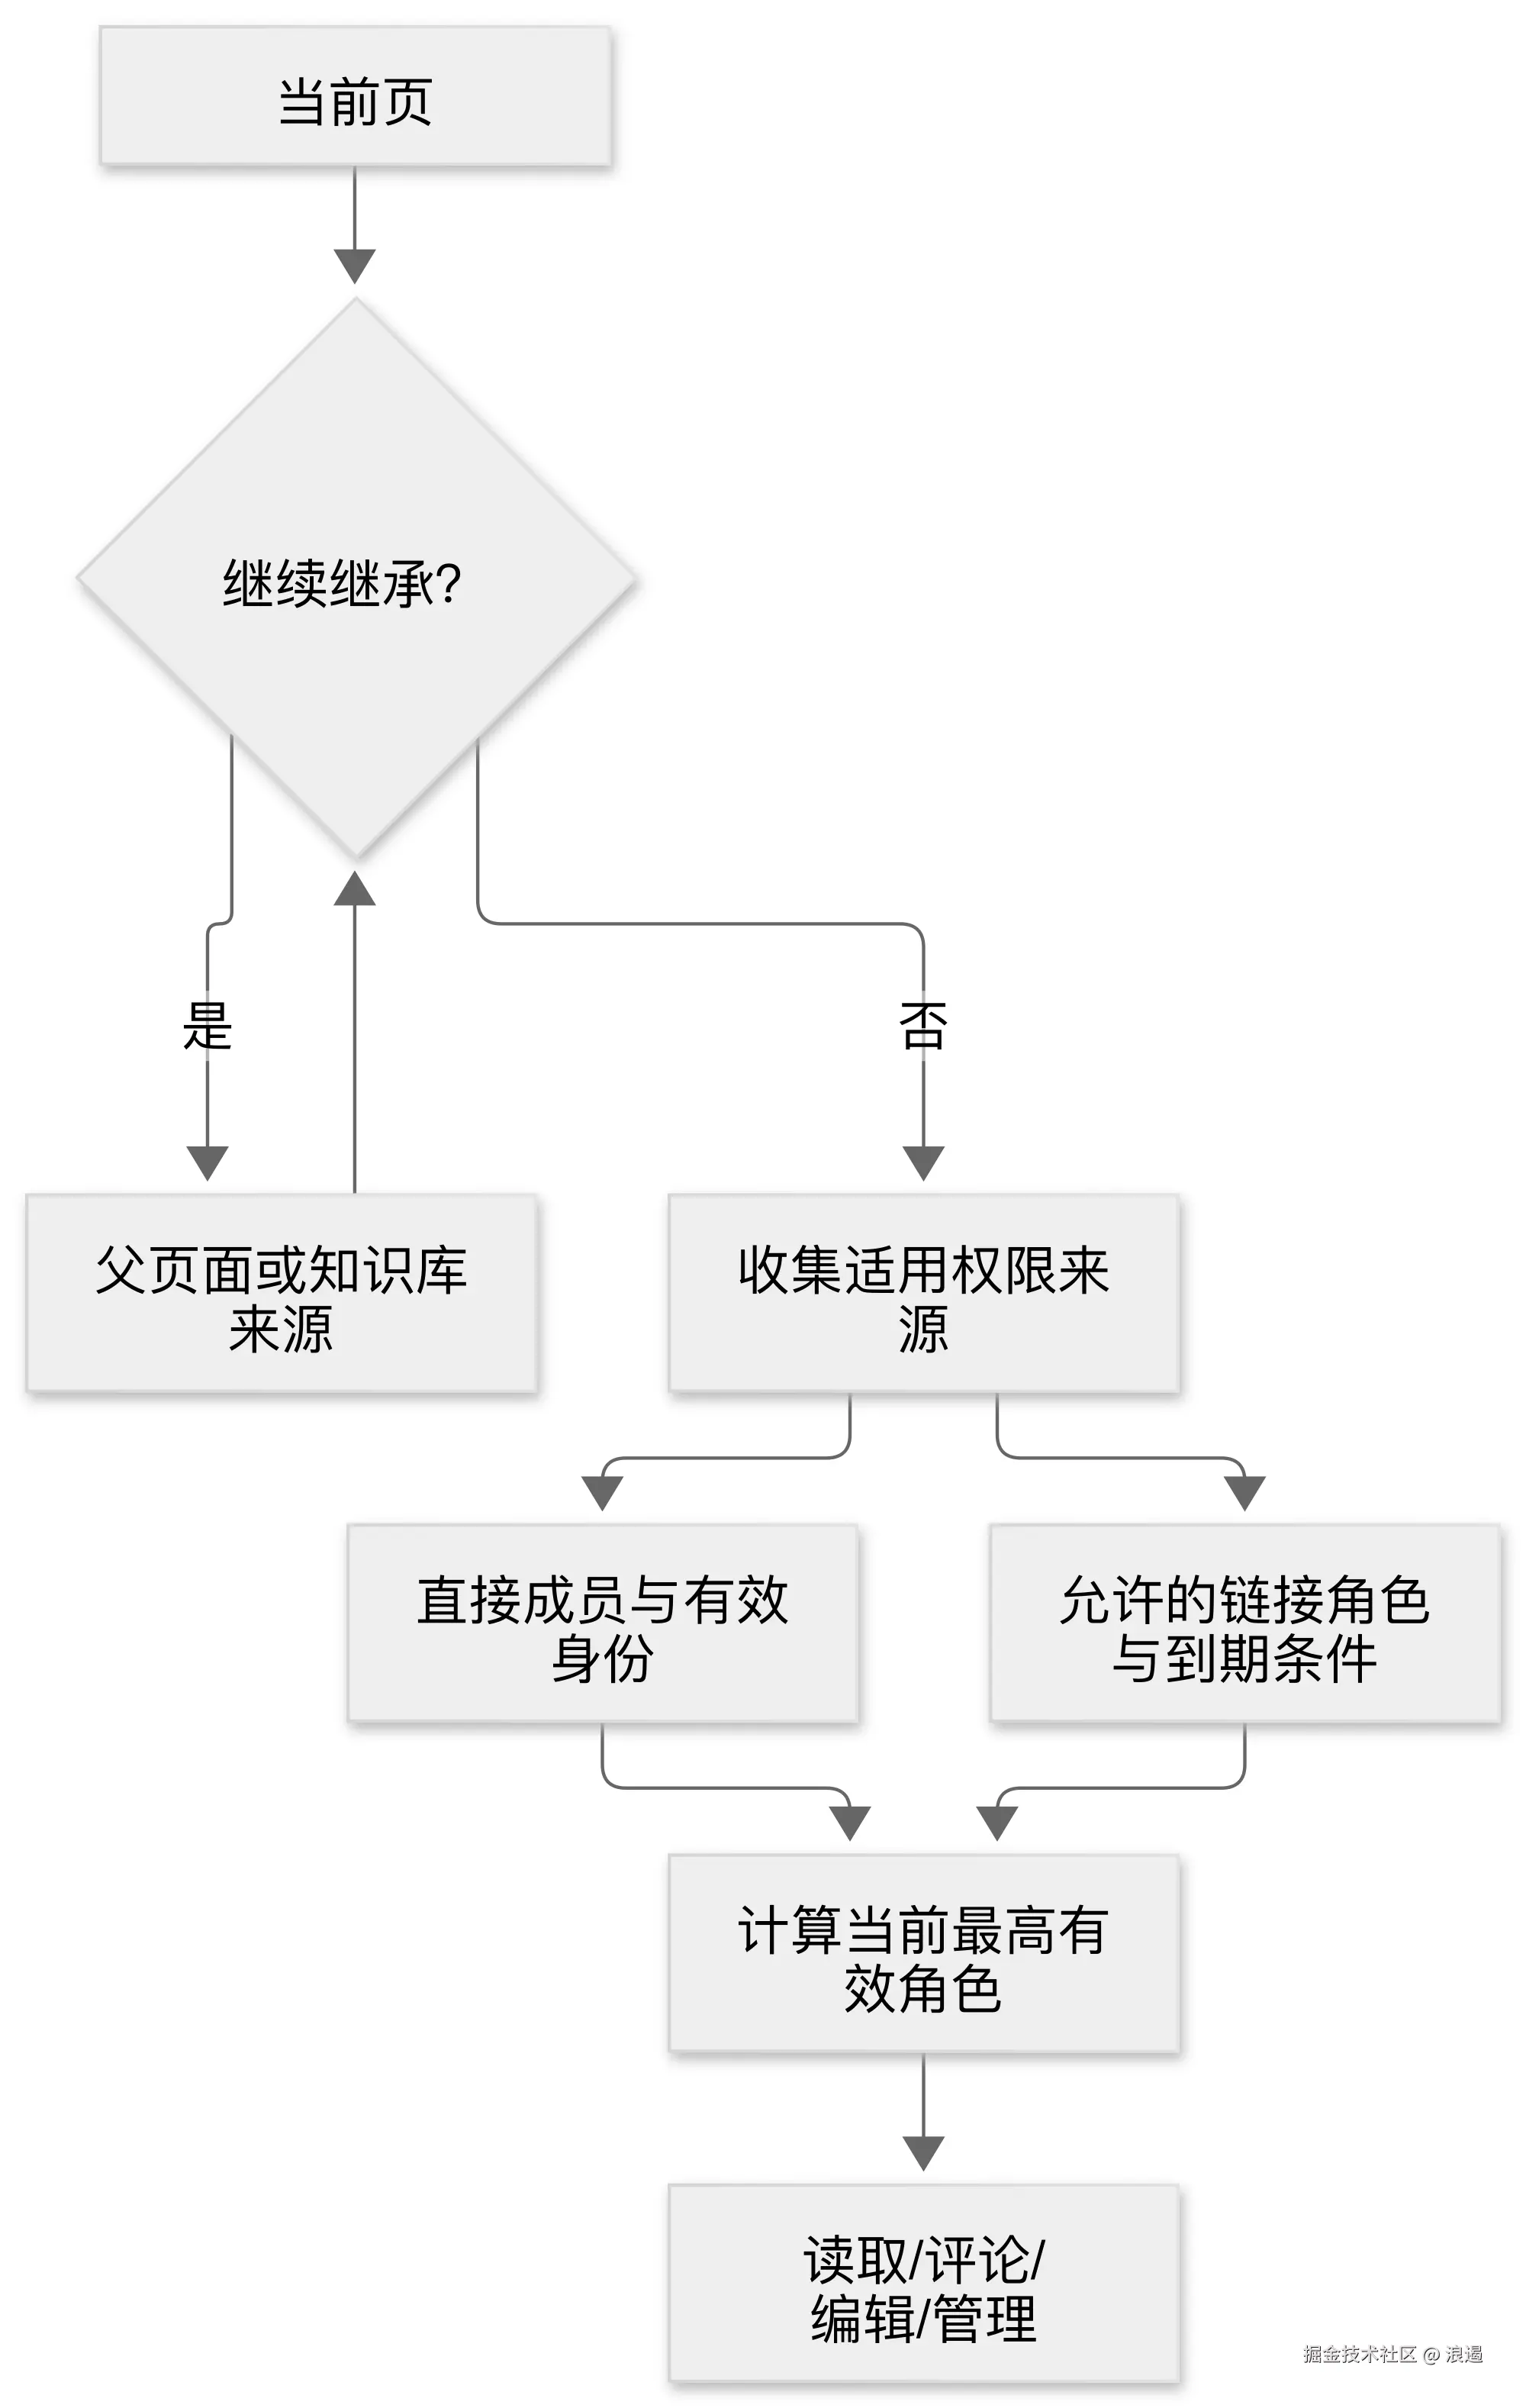
图表达的是计算思路,实际实现还处理跨所有者边界和循环防护。循环防护在这里有实际故障对象:页面结构来自可编辑数据,错误父链不能让权限计算无限循环。
CLI 委托权限计算显式关闭链接访问。一个人在网页上通过持链接方式看到资料,不应自动获得把这份资料长期委托给外部 AI 的权利。能读到页面与能授权机器持续访问,是两种不同能力。
权限变化还必须与写入共享锁。否则请求先通过检查,再等着保存,期间管理员或所有者撤销权限,旧请求仍有可能落库。当前 sharing 的上下文读取与权限变化都放在所有者锁保护的事务中,目的就是把这段空隙收紧。
"不显示"也要包括目录、面包屑和候选差异
只给正文 API 加鉴权还不完整。页面标题、父目录名、评论和候选差异都可能包含内容信息。分享页读取时,导航与面包屑按当前角色过滤;看不到的父级不能因为树结构就顺带泄露名称。
对于 CLI,同样要检查复制来源、被移动的后代和修改集的旧快照。失去权限后,即使修改集还保留在历史表里,也不应该继续返回 before 正文。这也是为什么权限不能只在 prepare 时检查一次。
产品上可以把它理解成:你收回一个专题的访问权,收回的是这个专题在各入口中的可见与可操作能力。若正文关了,历史差异还能看,用户的撤销预期仍然被破坏。
网页冲突怎样合并,和简历有什么不同
资料库网页保存也使用三方比较:共同基线、当前草稿和远端。标题、父级、原文、解答、拓展与目录顺序分别判断变化,独立字段可以合并,重叠字段优先当前正在编辑的草稿。
但原文把 content 与 sourceDocument 看成一组。不能从本地取文字、从远端取 HTML,拼成彼此不对应的正文。富文本按完整字段选择,不做任意字符串拼接。
删除与子页面创建还可能形成无效树:父页被一端删除,另一端新增孩子,简单合并后孩子没有父级。当前合并最后调用 validatePracticeBlocks() 检查结构,不会悄悄把它移动到根目录。这里保留错误有实际目的,因为静默搬家会改变位置和可能的权限来源。
整库 revision 让冲突检查简单,但也意味着独立页面会共享版本。客户端轮询或重新聚焦检查远端时,还要避免在有未保存草稿或目录操作期间直接覆盖输入。远端更新是一条需要处理的信息,不能一律变成 setState(remote)。
目录先加载,也得守住同一套权限
富文本很大时,目录只需要 ID、父级、标题、视图类型和是否有分析。directoryProjection() 在 SQL 中投影这些字段,让首个目录响应不用携带整份正文。
这是一项从产品交互反推的数据优化:用户先找到资料,再读取内容。它减少传输与序列化的负担,但数据库仍然要对 JSONB 做投影,不能因此声称每个页面已经拆成独立查询,也不能在没有测量时给出性能提升百分比。
分享目录的读取同样过滤可见节点。优化不能通过省掉权限计算获得"更快",否则用户还没打开正文,就在左侧目录里看见受限标题。元数据是协议的一部分,也需要同样的资源边界。
怎样验证统一写路径没有遗漏入口
验证可以从不变量出发:每一次内容成功提交都递增整库 revision;发生变化的页面有相应历史;目录关系与索引一致;操作者记录正确;失败时这些状态一起回滚。
然后按入口安排相同场景。网页编辑、共享页编辑、平台 AI 生成和 CLI 修改,分别走一次;在提交中途制造索引失败,检查没有半份正文或历史;两个同版本请求竞争,只能一个成功。
权限验证需要组合树形关系。直接邀请、父级继承、停止继承、移动、过期链接与撤销后再读,都要有可观察结果。还应检查导航、面包屑、历史和差异,不能只测试页面是否显示一个"无权限"。
可以在流萤 AI 练习用一个占位专题试试目录与分享,再观察页面如何沿同一个地址继续被编辑。多个入口能成立,前提是它们对同一次写入承担相同的一致性责任。下一篇聊另一个用户能直接感知的承诺:AI 失败不扣次。