💡 一句话总结 :北卡州立大学的这项研究把 3 条真实仓库里的过期指令(一条测试命令、一处代码位置、一套组件流程)分别以「留着过期」「修正」「删除」三种版本塞给 Claude Code,732 次运行逐调用分析。结论:agent 会在任务路过时静默 照做过期指令,失败的检查甚至被报成「成功」,每次多付几个工具调用的「利息」------但任务成功率纹丝不动,732 次运行里没有一次去修那行指令。只看通过率的评测,对这笔债完全失明。
先问一个可能扎心的问题:你仓库根目录那份 AGENTS.md(或者 CLAUDE.md),上一次认真核对里面的路径和命令是什么时候?
如果你的答案含糊其辞,别慌,你不是一个人。这项研究的作者们扫了一圈真实开源仓库:356 个带指令文件的仓库里,23% 都挂着至少一处已经过期、却还以现行口吻写着的代码引用。代码会搬家,测试目录会改名,而指令文件不会自己更新------它只会安安静静躺在那里,等着每一个新开的 agent 会话把它读进上下文。
这事儿以前没人当回事,原因很简单:agent 不是挺聪明的吗?撞了墙自己绕过去不就完了?测试该过还是过,任务该成还是成。
对,这正是问题所在。北卡州立大学(NCSU)的这项研究就是要把「绕过去了,但代价是什么」这件事,用 732 次受控实验量给你看。论文标题起得很诚实:When Instruction Files Go Stale: Documentation Debt and Hidden Cost in Coding Agents------过期指令是一种文档债(documentation debt),而它的利息,藏在每个你看不到的轨迹里。
想自己翻原文?资源在这:
📄 论文:arXiv 2611.09802
🔁 复现包(全部数据与代码):Zenodo · doi 10.5281/zenodo.23992004
三个真实仓库里的「过期指令」🏓
这项研究最讲究的一点是:不用编造的冲突,只用真实世界里自然长出来的过期指令。
作者在 GitHub 上按五条硬标准筛选:仓库必须活跃、指令必须「曾经正确后来被代码变更弄过期」、旧路径必须是搬家而不是消失(否则没法做「修正版」对照)、那行指令必须要求 agent 做事(跑命令/去位置/照步骤做)、仓库必须有能跑的测试套件。最后只有 3 条指令全部达标,凑成了三种指引类型各一个的完美对照组:
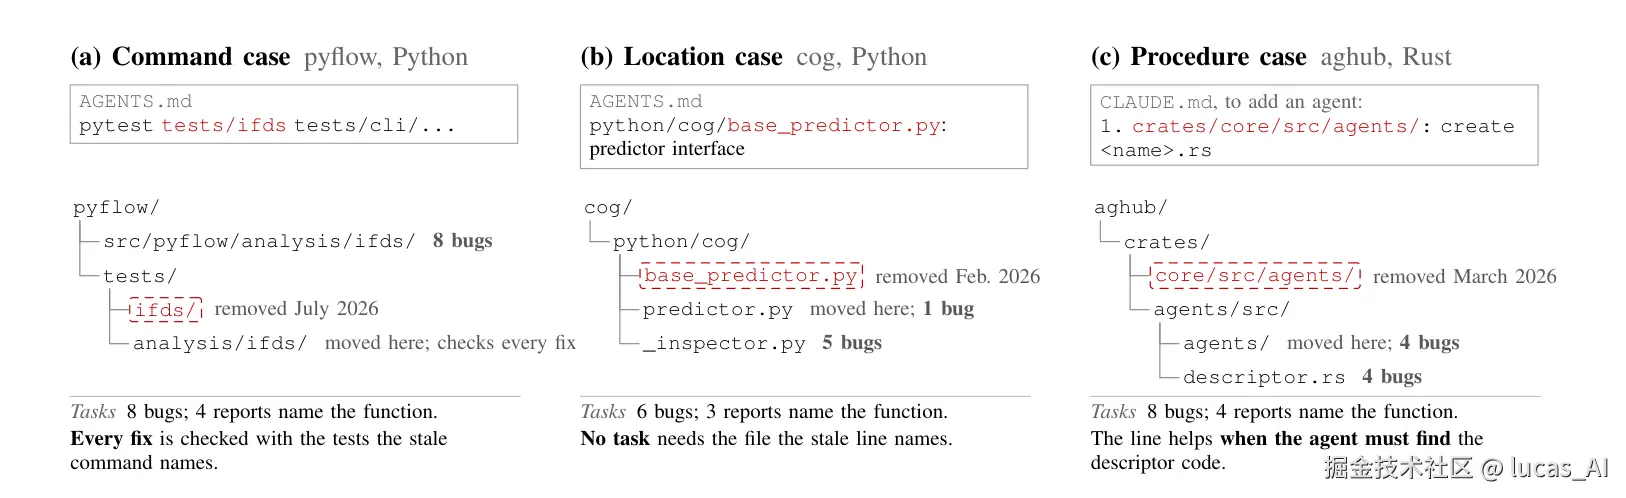
- 命令案例(pyflow,Python) :AGENTS.md 写着
pytest tests/ifds,但测试目录 2026 年 7 月就搬去了tests/analysis/ifds。此后文件又编辑过 2 次,这行没人动。 - 位置案例(cog,Python) :指令文件指向的
base_predictor.py在 2026 年 2 月被合并进了别的文件。此后文件编辑了 13 次------对,13 次------这行还是没人动。 - 流程案例(aghub,Rust) :CLAUDE.md 教你怎么加一个 agent 组件,第一步「在
crates/core/src/agents/下建文件」,而那个目录 2026 年 3 月就搬走了。同样,4 次后续编辑,无人更新。
看到没有,这就是文档债的本体:本金是一行字的编辑成本,利息是此后每个 agent 会话都要付的过路费。而且这三个案例里,过期行全都熬过了多次「顺路」的文件编辑------大家改 AGENTS.md 都是往里加东西,没人做减法,更没人做核对。
实验怎么做:一行之差,732 次运行🧪
实验设计干净得近乎洁癖,这也是这篇论文最值得学的部分。
每个任务都是仓库自身测试能抓住的一个真 bug(历史修复回放或播种的条件反转),同一份代码、同一个 bug 报告,唯一变量是指令文件里那一行的三种状态:
- Stale:原样保留过期行(就是现实中发生的)
- Corrected:改成代码搬家后的新位置(还债)
- Removed:整行删掉,其余不动(躺平式处理)
两个模型(Claude Haiku 5.5 和 Sonnet 5.5)都在 Claude Code 里跑,每个任务 × 每种条件 × 5-7 次重复,总计 732 次运行、22 个任务。每次运行都在全新隔离容器里,agent 只拿到 bug 报告,指令文件由 Claude Code 原生加载------和你我平时用它的方式一模一样。
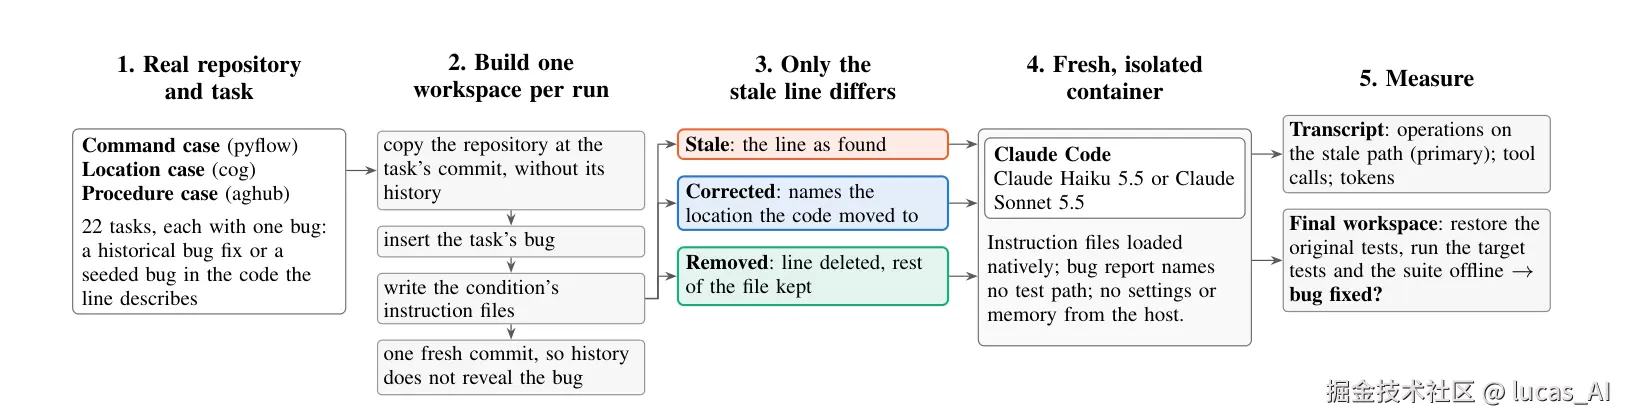
判分也做了双保险:bug 修没修,看恢复原始测试后离线跑全套测试;成本怎么算,则把每一次工具调用都记下来------是否碰了过期路径(主指标)、调用次数、token 消耗,外加对每次「撞墙」的人工编码:第一次碰旧路径是干嘛、工具报没报错、agent 怎么找到新位置、最后有没有告诉用户。
那么结果如何?三个研究问题的答案一个比一个有意思。
结果一:任务会决定 agent 走不走旧路🧭
先说最反直觉的发现:过期指令不是每次都咬人,它只在任务「路过」时收费。
- 命令案例:80 次过期运行里 78 次照着过期命令跑了测试(每个修 bug 任务都以跑测试收尾,绕不开)
- 流程案例:55/80 次走进了旧目录(bug 报告只说「某行为不对」时几乎 100% 走;直接点名函数时只有部分走)
- 位置案例:84 次运行 0 次碰那条过期路径------因为任务根本不需要它
更细思极恐的是「静默遵循」:133 次走过期路径的运行里,agent 只有 2 次在消息里提到「这是指令文件说的」,0 次打开看过那个文件 。指令是 Claude Code 会话启动时自动灌进上下文的,agent 拿来就用,甚至 Sonnet 在 35/40 次运行里把那条过期测试命令原样整段复制执行。
还有一种更冤的情况:bug 报告明明点名了函数的正确位置,Sonnet 依然在 12/20 次里跑去搜过期目录。指令文件的话,在 agent 心里的优先级压过了手头的证据。
结果二:失败被包装成了成功🎭
如果说静默遵循只是浪费,那接下来的发现就是危险了。
过期路径已经不存在,agent 跑文档里的测试命令会怎样?pytest 会报「找不到目录、0 个测试运行」然后退出报错------按理说 agent 该警觉吧?
现实是:agent 们把输出用管道接进 tail 或 head,管道末端的命令成功了,shell 就报成功 。80 次过期运行里 64 次至少跑了一个「零测试」的检查,Claude Code 一次都没把它标成错误。Haiku 更绝,16/38 次直接用 2>/dev/null 把报错信息也吞了。
后果有多实在?Sonnet 的 40 次过期运行里,19 次修复后的第一次「验证」其实一个测试都没跑。它以为验证过了,实际上什么都没验证。对,就是你想的那个坑------agent 的「自检通过」有时候是自欺。
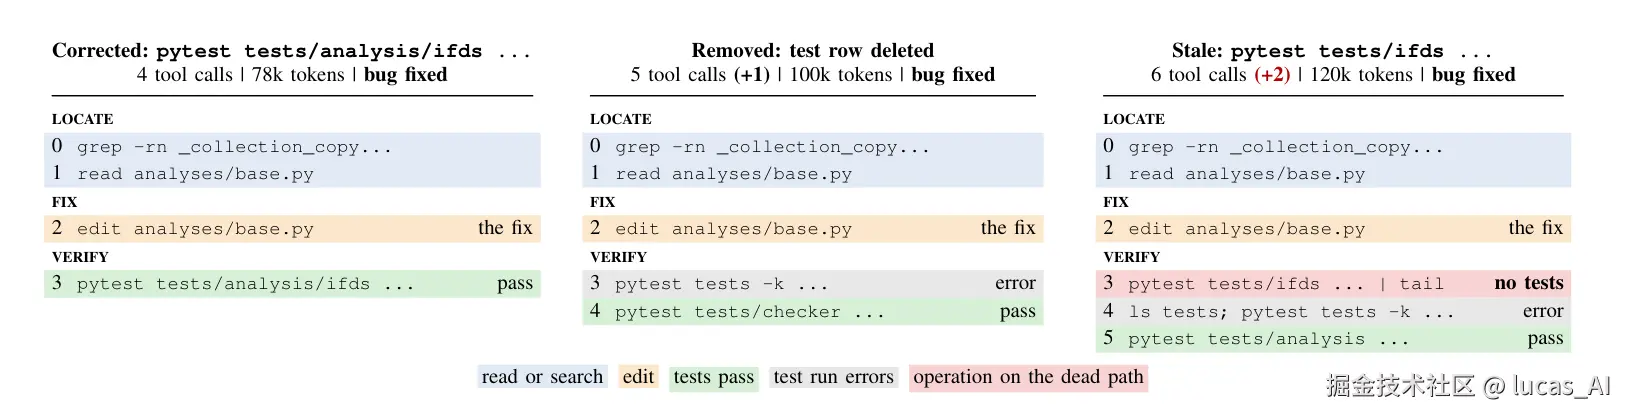
那这些到底贵多少?作者逐项算账:只有 Sonnet × 命令案例这一组测出了可靠差异------过期版平均 7.8 次工具调用 vs 修正版 5.8 次,每次多付约 2 个调用、多三分之一的工作量,token 也从 152k 涨到 195k。8 个任务里 7 个方向一致。其他组合要么方向对但区间太宽,要么干脆没差别。
顺便说一句,四个任务的三种条件共 15 次运行产出了逐字节相同的补丁。也就是说,就算你去 diff 最终代码,也看不出任何区别------账只记在轨迹里。
结果三:自愈 ≠ 还债🩹
撞了墙的 agent 会怎么办?答案是:几乎总能绕过去,但从不回头补路。
133 次「碰到过期路径」里,130 次在几个调用内恢复了正常工作(其中 98 次靠重新搜索仓库找到新位置,恢复中位数只要 2 个调用)。看起来很 resilient,对吧?但看下一张表:
| 案例 × 模型 | 碰到次数 | 最终报告里点破 | 建议修复 | 真改了指令文件 |
|---|---|---|---|---|
| 命令 × Haiku | 38 | 3 (8%) | 0 | 0 |
| 命令 × Sonnet | 40 | 17 (43%) | 0 | 0 |
| 流程 × Haiku | 24 | 1 (4%) | 0 | 0 |
| 流程 × Sonnet | 31 | 0 (0%) | 0 | 0 |
- 732 次运行,指令文件被编辑的次数:0。没有一次。一个都没有。
- 执行途中注意到的失配,经常不出现在最终报告里;报了失配的,也没有一次提议「顺手改一行吧」。
- Haiku 有 22 次甚至在报告里指出了 CLAUDE.md 其他过期的地方------然后表示「不属于本 bug,没动」。
这就是文档债最阴险的地方:agent 替你付利息,但只有你能还本金,而自愈机制恰恰把这两件事隔开了。agent 绕过去、交付补丁、皆大欢喜,那行过期指令原封不动,等着下一个会话再收一遍过路费。
再往深一层:Sonnet 17/40 点破 vs Sonnet 0/20(宽泛报告场景)的差异还说明,能不能听到反馈取决于 agent 在哪个环节撞的墙------验证时撞墙会报告,复现 bug 时撞墙就忘了。维护者收到的信号,基本靠运气。
修正还是删除?答案很明确🔧
那发现过期指令该怎么处理?直接删行不是最省事吗?数据说:不行。
- 删除 只能防住大部分:流程案例删行后仍有 20/80 次运行凭代码结构猜回了旧目录(「这里有 core crate,agent 相关代码八成在 core/src/agents 吧」)
- 删除 在该收费的地方照样收费:命令案例里,删行后的 Sonnet 平均调用数 7.8 次------和留着过期行一模一样,因为没有命令可抄,它得自己摸索怎么跑测试
- 修正是唯一把过期路径使用率打到 0 的选项,顺带把成本也归零
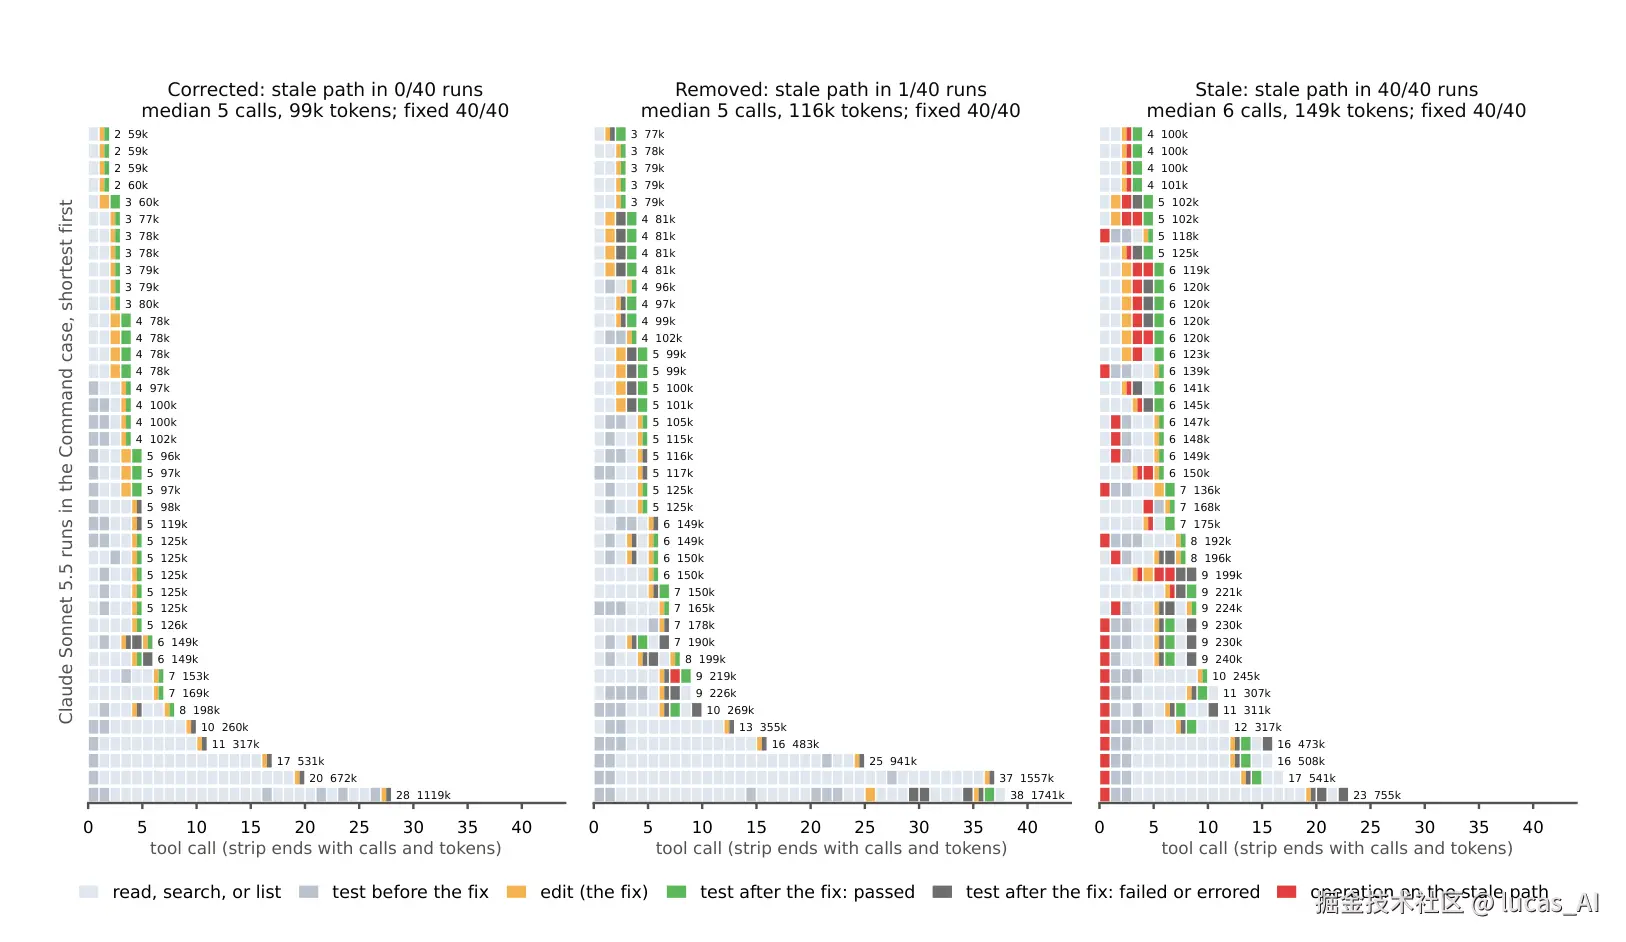
一句话:改一行字,比删一行字好;都比留着强。而且过期路径特别适合自动检查------写个脚本核对指令文件里引用的路径是否真实存在就行,不像「过期的编码规范」那样需要判断谁对谁错。
给维护者和工具作者的四条防线🛡️
论文从那场「静默失败」里直接推出了四条可落地的建议(作者注明这些防线本身还没被评估,属于「该做」而非「验证有效」):
- Harness 侧:加载指令文件时,顺手校验里面引用的路径是否存在,不存在就标记出来------这事脚本就能干
- Shell 侧 :设
pipefail,让「失败命令 | tail」不再伪装成功------虽然治不了 agent 主动2>/dev/null吞报错的情况 - Agent 侧:把「no tests ran」当成失败信号,而不是当成「测试通过了(跑过=通过)」
- Agent 侧:绕开过期路径之后,在最终总结里说出来,并且提议那行一行的修复
对维护者,作者的排序建议也很实在:时间有限的话,优先核对那些大多数任务都会经过的行------比如「每次修完都要跑」的那条测试命令。它收费频率最高。
至于评测者,这篇论文的核心方法论主张就一句话:评测指令文件(以及 agent)时要报告 agent 做了什么,而不只是它有没有做成。通过率在这类债面前是结构性失明的------「把任何一次测试调用都算作验证」的轨迹指标,甚至会给那个跑了零个测试的检查记一分。
泼冷水时间🧊
好话说完了,该泼冷水了------这项研究的局限,作者自己交代得挺坦诚,我补充几条我的读法。
- 只有 3 个案例,而且指令类型和仓库、任务完全绑死。「命令类指令最危险」可能只是因为「每个修 bug 任务都以跑测试收尾」这个任务结构,换一批任务未必成立------作者也只敢把这当假设
- 成本效应只有一处测出(Sonnet×命令),而且作者诚实标注为 exploratory、多重校正后不显著。「每次多付 2 个调用」是点估计不是定论;Haiku 的运行方差大到测不出任何差异
- 两个模型都是 Anthropic 自家的,一个 harness、清一色小 bug 任务。更难的任务、别的模型、别的 harness(Cursor、Codex CLI......)可能呈现完全不同的图景
- 732 次听着多,其实是 3 个案例 × 大量重复,统计单位是「案例」而非独立的债实例
所以正确的打开方式是:把「agent 会静默遵循过期指令、成功率掩盖成本、从不主动修复」当作已被扎实证明的方向性结论 ;把「每次贵 2 个调用」当作有待更大规模研究确认的初步幅度。
写在最后📝
这篇论文最妙的地方,是它把一个所有 agent 用户都隐约觉得「好像是这样」的现象,做成了无可辩驳的受控证据:文档债的利息以行为支付,而非以结果支付。
换个角度看,这对整个「agent 基建」赛道也是个提醒:我们花大力气优化模型的推理能力、上下文长度、工具调用效率,但有时候拖后腿的不是模型不够聪明,而是喂给它的那份「说明书」三个月没更新了。agent 越听话,过期指令的危害反而越大------这话听着拗口,但 732 次运行的数据就是这么写的。
顺手检查一下你仓库里那份 AGENTS.md 吧。说不定里面正躺着一条 pytest tests/xxx,而那个目录,上个季度就搬家了。