目录
- B.0 这篇补什么:一张"卡点自查表"
- B.1 信号:操作系统拍你肩膀的艺术
- B.2 CAS 与自旋锁:一句"我来"引发的学问
- B.3 三色标记与写屏障:GC 为什么怕你写指针
- B.4 单写单读环形缓冲:不需要锁的账本
- B.5 四块地基拼回 cpuprof.go:总映射表
- B.6 自测题
B.0 这篇补什么:一张"卡点自查表"
读 03 篇时的常见卡点,与对应地基:
| 03 篇卡点 | 缺的地基 | 去哪补 |
|---|---|---|
| "信号处理器"到底是什么?它什么时候被谁调用? | 信号与异步打断 | B.1 |
signalLock 为什么 CompareAndSwap 一下就拿走,拿不到直接放弃? |
CAS 与自旋锁 | B.2 |
//go:nowritebarrierrec 为什么存在?写屏障是个啥? |
三色标记与写屏障 | B.3 |
prof.signalLock 拿不到为什么是"丢一个样本"而不是"等一等"? |
B.1 + B.2 | B.1/B.2 |
profbuf.go 凭什么无锁?count & (n-1) 是什么操作? |
单写单读环形缓冲 | B.4 |
| 为什么 add() 里全是裸数组写,一点堆都不碰? | B.1 + B.3 | B.1/B.3 |
一个总的观察 :
cpuprof.go的每一处"反直觉"设计,几乎都是在向"我在信号处理器里跑"这个事实妥协。把 B.1 的三条铁律记住,后面三块地基全是铁律的推论。
B.1 信号:操作系统拍你肩膀的艺术
从零开始:你的代码不是唯一在跑的东西
先建立一个世界观:CPU 每秒执行几十亿条指令,你的 Go 程序只是其中一股指令流。真正掌控 CPU 的是操作系统内核------它给你的程序分时间片、处理键盘中断、应付网卡。内核可以在任意两条机器指令之间夺走 CPU,转去干别的,再回来让你的程序若无其事地继续。
信号(signal) 就是内核"叫停你的程序"的机制之一:内核在任意两条指令之间 插入一次跳转,强行执行一个你(或 runtime)事先注册的函数------信号处理器(signal handler)------执行完再回到被打断的位置,就像什么都没发生过。
生活类比:你在流水线拧螺丝(主程序),车间主任(内核)随时拍你肩膀(信号)。你必须在当前这颗螺丝拧完的瞬间停下来,听主任交代事情(信号处理器),然后回去接着拧------而且拧到一半的那颗不能报废。
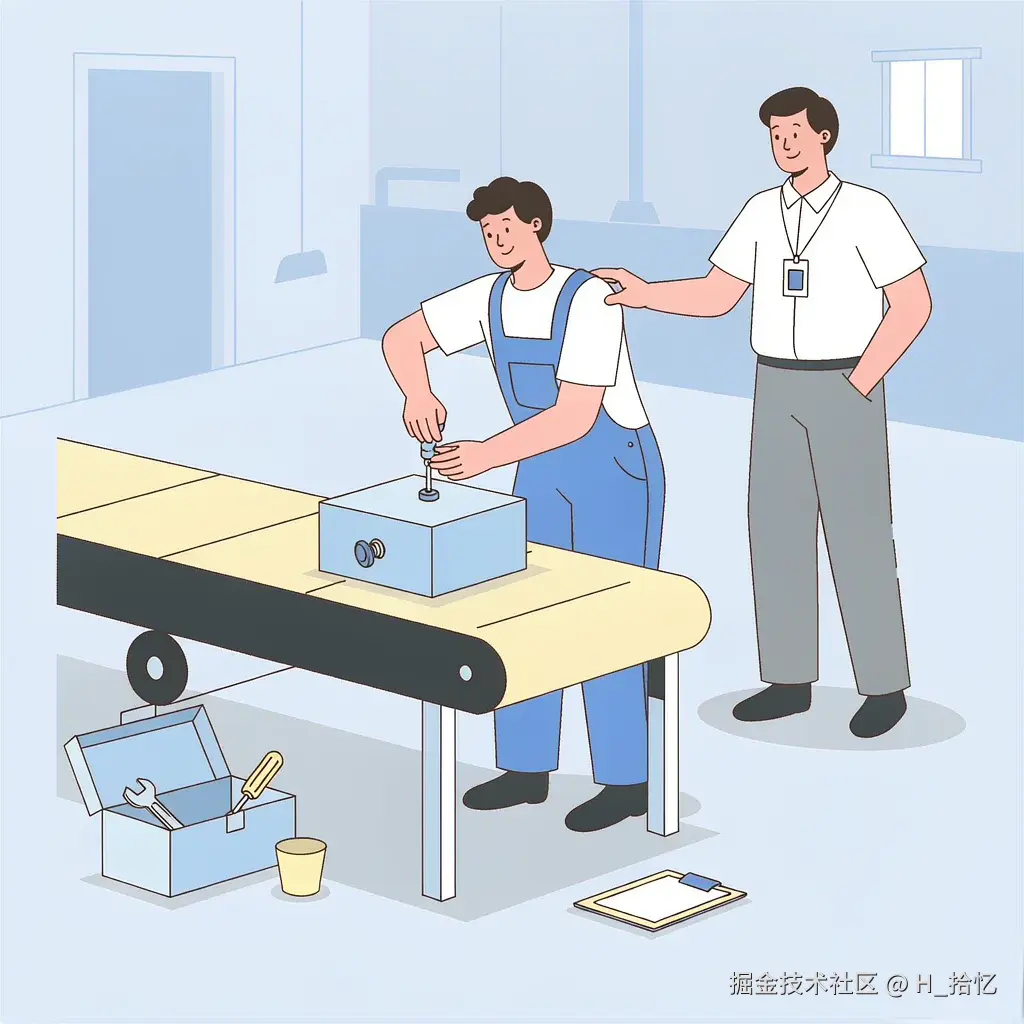
图 B-1:信号就是操作系统(车间主任)在任意两条指令之间"拍你肩膀"。被打断的代码可能正干到一半,所以信号处理器必须"快进快出"。
Go runtime 对 SIGPROF 的用法:让内核每 10ms 拍一次肩 (定时器到点 → 内核发 SIGPROF),处理器里看一眼"我此刻在执行什么函数、调用栈长什么样",记一笔账就走。这就是 CPU 剖析采样的全部秘密------不是剖析器在循环里不停查,而是内核在随机时刻不停地拍。
铁律:信号处理器里不能做什么
打断点不可预测,这带来三条铁律。cpuprof.go 所有反直觉设计都是这三条的推论:
- 不能睡觉/阻塞。你睡觉的那一刻,当前整条线程就停了------而被打断的代码可能正干到一半,持有别的 goroutine 都在等的资源。一等可能就是永远。
- 不能用"会等待的锁"。想想:如果被打断的代码正拿着锁 L,你的处理器也要拿 L------死锁,而且和自己的死锁(同一根线程)。唯一安全姿势是"试一下,拿不到立刻走"(B.2 专门讲)。
- 尽量别碰堆(GC 的地盘)。GC 可能正在标记到一半(一半对象黑、一半白),处理器里分配对象/改指针 = 往一锅正在熬的汤里加料(B.3 专门讲)。
所以"记一笔就走"是唯一正确姿势:数据结构提前分配好 (裸数组),写入无锁 (CAS / 单写单读),函数不分配、不阻塞、不碰指针语义 。对照 cpuprof.go:add() 只往预分配的缓冲里写定长记录,一个 malloc 都没有。
Windows 例外
Windows 没有 POSIX 信号这套机制。runtime 用一个专职线程 profileLoop 每 10ms 主动"点名":挂起每个线程 → 读它的寄存器/栈 → 走同一条 sigprof → add 路径(见 03 篇 §十一)。效果等价:还是"在任意时刻抓拍正跑的代码",只是"拍肩"换成了"点名"。本系列实验全在 Windows 上跑,但结论两边通用。
配套实验 :03 篇的"动手实验 2"(连开两轮
runtime.SetCPUProfileRate,观察第二轮失败)演示的是同一族问题的另一面------"已开启"标志的防重入;signalLock的"试一下就走"语义见 B.2。本篇不再重复。
B.2 CAS 与自旋锁:一句"我来"引发的学问
从零开始:多核就是多人同时摸一块黑板
单核时代,同一时刻只有一个人执行,天下太平。多核 = 多个工人同时读写同一块黑板 。麻烦来了:n++ 在机器层面不是一步,是三步:
text
读 n 到寄存器 → 寄存器加 1 → 写回 n工人甲刚"读走 n=5",工人乙也"读走 n=5",各自加 1 各自写回 6------两次自增,黑板上只涨了 1。这叫丢失更新(lost update),是并发 bug 的祖师爷。
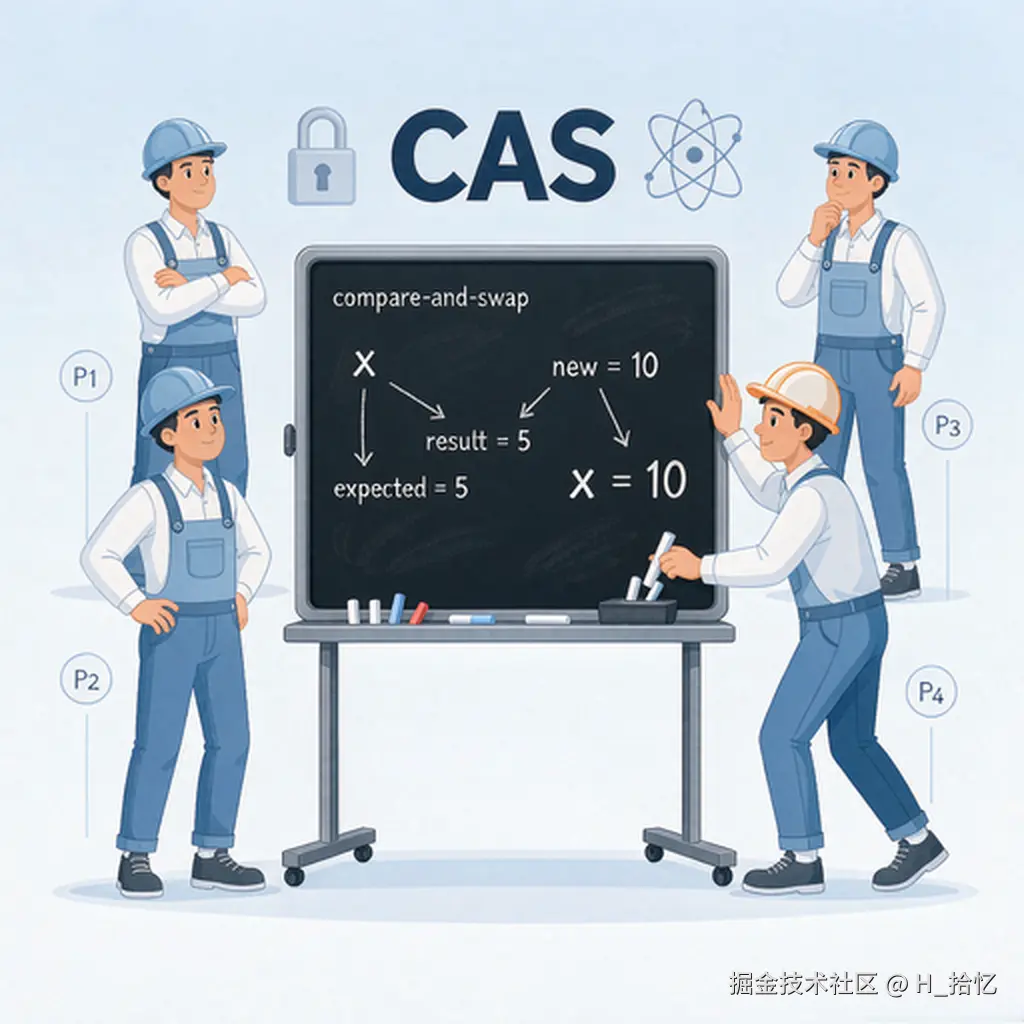
图 B-2 :
n++在机器层面是"读→加→写"三步,多核下会丢更新。CAS 把"看一眼+换"变成不可分割的原子操作------谁 CAS 成功谁拿锁。
CAS:黑板前的一次原子抢答
硬件给了个救星------CAS(Compare-And-Swap,比较并交换),一条 CPU 原子指令,语义是:
"我觉得黑板当前值是 A;如果是,把它换成 B,并告诉我'成功';如果不是,啥也不动,告诉我'失败'。"
整个"看一眼+换"的过程不可分割 ,没有第二个工人能插进来。Go 里就是 sync/atomic 的 CompareAndSwap。
拿锁的完美实现:locked 从 false 改成 true 用一次 CAS------谁 CAS 成功谁拿锁。拿不到怎么办?两个流派:
- 睡觉流派(mutex) :把自己挂到等待队列,让出 CPU,等解锁时被叫醒。不烧 CPU,但入睡/唤醒有开销(陷入内核、上下文切换,微秒级)。
- 自旋流派(spinlock) :不睡!立刻再试一次 CAS,失败再试,循环往复("自旋"= 原地打转)。零切换开销,但烧着 CPU 等待。
经验法则:临界区只有几十纳秒、等一下就好 → 自旋划算;可能等很久 → 必须睡,不然烧掉一个核。Go 的 sync.Mutex 是混合流派:先自旋一小会儿,没戏再睡。
铁律视角:信号处理器里只能"试一次,拿不到就放弃"
把 B.1 铁律 2 套进来:信号处理器里拿锁------
- 睡觉等待?违反铁律 1,直接出局。
- 自旋等待?持锁的可能恰好是被打断的代码自己 (比如抄账员抄到一半被拍肩)------它要等你让出 CPU 才能接着跑并放锁,而你又在等它放锁。永久卡死。
所以只剩一种姿势:CAS 一次,拿不到立刻放弃 。这正是 cpuprof.add 对 signalLock 的做法(cpuprof.go:106 一带):
go
if !prof.signalLock.CompareAndSwap(false, true) {
    return // 拿不到?说明上一笔还在被处理,本样本直接放弃,等下一个 10ms
}
丢一笔账 vs 死锁一笔账,never a question。10ms 后还有下一班车。
映射:cpuprof.go 里的对应物
| 本篇概念 | cpuprof.go / runtime 对应物 |
|---|---|
| CAS 抢锁 | prof.signalLock atomic.Boolean + CompareAndSwap |
| "试一下就走" | add() 拿不到 signalLock 直接 return(丢样本) |
| 自旋 + 让出 | spinlock.Lock() 里的 runtime.Gosched() ≈ 源码各处的 osyield() |
| 睡觉等待 | sync.Mutex(抄账员等数据用的可不是信号侧,是普通世界) |
动手实验 B-1:自旋锁的正确性,与它的代价
模块准备(做过附录 A 的话 apx-lab 已存在,直接加子目录即可):
bash
mkdir apx-lab && cd apx-lab   # 已存在就 cd 进去
go mod init apx-lab # 已有 go.mod 就跳过spin/main.go(完整可复制):
go
package main

import (
	"fmt"
	"os"
	"runtime"
	"sync"
	"sync/atomic"
	"time"
)

// spinlock:CAS 自旋锁------拿不到就"原地再试",绝不睡觉
type spinlock struct{ locked atomic.Bool }

func (l *spinlock) Lock() {
	for !l.locked.CompareAndSwap(false, true) { // ← 一次 CAS 抢答
		runtime.Gosched() // 让出 CPU 再试(≈ 源码里的 osyield)
	}
}
func (l *spinlock) Unlock() { l.locked.Store(false) }

var sink int
var spins atomic.Int64 // 等待者一共自旋了多少轮(自旋的"代价"直观化)

// part1:自旋锁的正确性------互斥是精确的
func demo() {
	var lk spinlock
	var n int
	var wg sync.WaitGroup
	for i := 0; i < 8; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			for j := 0; j < 1000; j++ {
				lk.Lock()
				n++ // 非原子自增,全靠锁保护
				lk.Unlock()
			}
		}()
	}
	wg.Wait()
	fmt.Println("part1 正确性:8 goroutine × 1000 次自增 =", n, "(期望 8000)")
}

// part2:持锁者被"冻结"后,等待者的两种姿态
//   mutex:等待者睡觉(不耗 CPU),两个无辜任务各占满一个核
//   spin :等待者原地打转(耗 CPU),3 个 goroutine 抢 2 个核 → 无辜任务减产
func frozen(mode string) {
	runtime.GOMAXPROCS(2) // 两个 P:无辜任务理论上各占一个全速跑

	var mu sync.Mutex
	var sp spinlock
	acquired := make(chan struct{})

	go func() { // 持锁者:拿到锁后永久冻结(≈ 信号打断了持锁者,它醒来前谁也动不了锁)
		if mode == "mutex" {
			mu.Lock()
		} else {
			sp.Lock()
		}
		close(acquired)
		select {}
	}()
	<-acquired

	go func() { // 等待者:等一把永远不会放的锁
		if mode == "mutex" {
			mu.Lock() // 睡眠等待:不耗 CPU
		} else {
			// 纯自旋:不 Gosched、不睡觉,占着核空转烧 CPU 等到世界末日
			for !sp.locked.CompareAndSwap(false, true) {
				spins.Add(1)
			}
		}
	}()

	deadline := time.Now().Add(2 * time.Second)
	var c, d atomic.Int64        // 两个无辜任务:它们的减产量就是等待者烧掉的 CPU
	var sinkC, sinkD int         // 各写各的,无竞争
	go func() {                  // C
		for time.Now().Before(deadline) {
			for i := 0; i < 1000; i++ {
				sinkC += i
			}
			c.Add(1)
		}
	}()
	for time.Now().Before(deadline) { // D(主 goroutine)
		for i := 0; i < 1000; i++ {
			sinkD += i * 2
		}
		d.Add(1)
	}
	sink += sinkC + sinkD
	fmt.Printf("part2 模式=%-5s 两个无辜任务 2 秒合计跑了 %d 轮(等待者自旋 %d 万轮)\n",
		mode, c.Load()+d.Load(), spins.Load()/10000)
}

func main() {
	switch os.Args[1] {
	case "demo":
		demo()
	case "mutex", "spin":
		frozen(os.Args[1])
	}
}
bash
go run ./spin demo
go run ./spin mutex
go run ./spin spin实测输出(go1.24.0 / Windows 11):
输出
part1 正确性:8 goroutine × 1000 次自增 = 8000 (期望 8000)
part2 模式=mutex 两个无辜任务 2 秒合计跑了 7598068 轮(等待者自旋 0 万轮)
part2 模式=spin  两个无辜任务 2 秒合计跑了 4006631 轮(等待者自旋 19754 万轮)
解读:
- part1:CAS 抢答 + 自旋等待,8000 次自增一个不丢------自旋锁作为锁,正确性没问题。
- part2 :持锁者被冻结(这是对"信号打断了持锁者"的模拟)。mutex 模式下等待者睡觉,无辜任务满速 759 万轮;spin 模式下等待者纯自旋,3 个 goroutine 抢 2 个核,无辜任务掉到 400 万轮 ------等待者空转了近 20 亿轮 CAS,烧掉的 CPU 一半本来是无辜任务的。这就是信号处理器里"绝不自旋、绝不睡觉"的物证:等待者要是 sigprof 本身,烧的是你正在剖析的程序,还可能永远等不到。
(细节:spin 模式若改成"每轮自旋都 Gosched 让出",两个无辜任务几乎不减产------让出式自旋太"礼貌",占不住核。真实信号处理器里没有 Gosched 这种好事,所以姿势只剩"CAS 一次,失败即走"。)
B.3 三色标记与写屏障:GC 为什么怕你写指针
从零开始:GC 怎么判断"谁是垃圾"
Go 的 GC 思路:从"根"(全局变量、各 goroutine 栈上的指针等一定活着的东西)出发,顺着指针把摸得到的对象 全部标记为活的;一轮摸完,没被摸到的就是垃圾,回收。
标记过程用三色抽象管理进度,这是并发标记的标准心智模型:
- 白:还没被发现。标记结束时还是白 → 判定为垃圾。
- 灰:发现了,但它的孩子(它指向的对象)还没查完。放在"待查队列"里。
- 黑 :我和我的孩子都查完了。黑对象不会再被看第二眼------这是效率的来源,也是事故的来源。
算法就是一句话:从队列里逐个取出灰对象,把它的白孩子染灰入队,自己染黑;队列空了,标记结束。
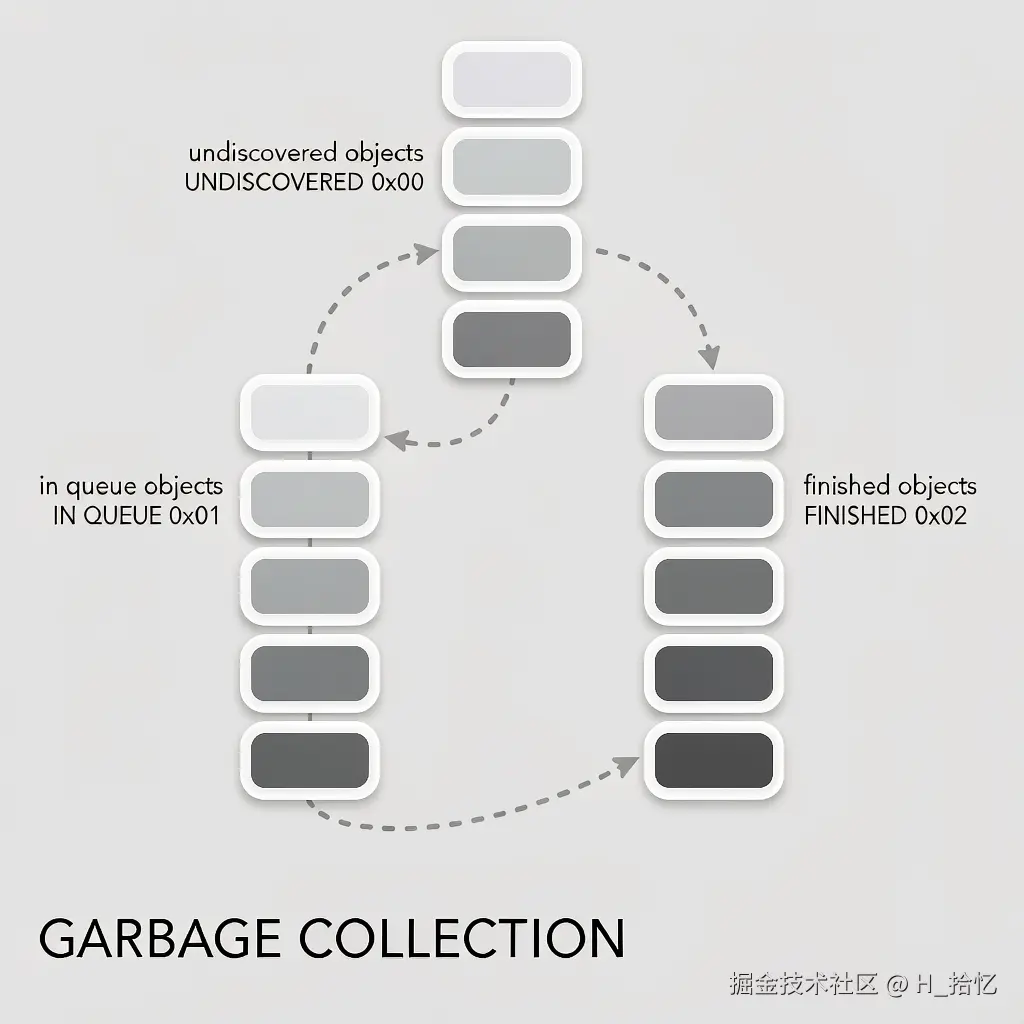
图 B-3:白=还没被发现,灰=已发现但孩子没查完(在待查队列),黑=自己和所有孩子都查完了。黑对象不再被看第二眼,既是效率来源也是漏标事故的来源。
事故:标记和你同时跑
麻烦在于 Go 的 GC 是并发 的------标记的同时你的程序还在跑(否则每次 GC 全世界暂停,程序没法用)。你的程序每次执行 a.x = c 这样的指针写,都在修改 GC 正在遍历的地图。漏标事故的经典配方只需要两步:
- 黑 A 拿到白 C 的指针(A 已查完,GC 不会再回头看 A,所以发现不了 C);
- 灰 B 到白 C 的旧路被掐断(B 还没查,但等查它时 C 已经不在它的孩子里了)。
两步都发生 → C 从此无人知晓 → 标记结束仍为白 → 被当垃圾回收 。可 A 里明明还存着 C 的指针------悬空指针,随后就是内存错乱。注意单独任何一步都无害(只有 1,C 还是能从 B 摸到;只有 2,C 本来就该没人引用),必须两步同时发生------这正是写屏障要盯的死窗口。
生活类比:图书管理员逐排登记藏书(标记),每登记完一排就挂"此排已完"的牌子(染黑)。你(读者,mutator)趁他背过身,把一本书从还没登记的书架 (灰 B)塞进已挂牌的书架(黑 A),还把它原来的位置清空。管理员永远登记不到这本书 → 当废品处理。可你手里还捏着它的借书卡(黑 A 里的指针)。
写屏障:每次指针写都过一道岗哨
写屏障(write barrier) = 编译器在每次指针写操作 前后插进的一小段代码,像一个岗哨:凡是"黑/灰对象拿到白对象指针"这种危险写法,岗哨立刻把那个白对象染灰入队 (术语叫 shade)------保证它不会被漏掉,代价是那一轮 GC 多查几个对象。Go 1.8+ 用的是混合写屏障,细节不展开;你只需要记住:指针写不再是免费的,背后有个岗哨。
铁律视角:信号处理器为什么连写屏障都不许有
回到 B.1 铁律 3,现在可以说精确了:add() 运行在信号处理器里,而信号可能打断岗哨自己 、打断 GC 内部记账的中间状态。写屏障代码假设自己在"正常世界"运行(可能要入队、拿 GC 内部的锁),在信号里重入它 = 在岗哨执勤时把岗哨调走。所以 Go 干脆给了 //go:nowritebarrierrec:编译期检查------这个函数以及它调用的所有函数,调用链上禁止出现任何写屏障,出现即编译报错 。add() 从根上被摁住:零分配、零指针写屏障,只写提前分好的裸数组。
动手实验 B-2:亲手制造一次漏标,再看岗哨救场
mark/main.go(完整可复制;纯单线程确定性模拟,没有真 GC 参与,专门把事故窗口演给你看):
go
package main

import "fmt"

// 三色:0=白(未发现) 1=灰(已发现,孩子没查完) 2=黑(查完)
type obj struct {
	name     string
	color    int
	children []*obj
}

var cname = map[int]string{0: "白", 1: "灰", 2: "黑"}

func show(title string, objs []*obj) {
	fmt.Print(title)
	for _, o := range objs {
		fmt.Printf("  %s(%s)->[", o.name, cname[o.color])
		for i, ch := range o.children {
			if i > 0 {
				fmt.Print(" ")
			}
			fmt.Print(ch.name)
		}
		fmt.Print("]")
	}
	fmt.Println()
}

// popScan:从灰队列取一个对象,把它的白孩子染灰入队,自己染黑
func popScan(grey *[]*obj) *obj {
	o := (*grey)[0]
	*grey = (*grey)[1:]
	for _, ch := range o.children {
		if ch.color == 0 {
			ch.color = 1
			*grey = append(*grey, ch)
		}
	}
	o.color = 2
	return o
}

func run(withBarrier bool) {
	// 对象图:root → {A, B};B → C。C 只有 B 这一条路能被摸到。
	root := &obj{name: "root"}
	a := &obj{name: "A"}
	b := &obj{name: "B"}
	c := &obj{name: "C"}
	root.children = []*obj{a, b}
	b.children = []*obj{c}

	fmt.Printf("\n===== %s =====\n", map[bool]string{false: "无屏障:漏标事故现场", true: "有屏障:岗哨救场"}[withBarrier])
	grey := []*obj{root}
	root.color = 1
	show("初始          ", []*obj{root, a, b, c})

	popScan(&grey) // 扫 root → root 黑,A/B 灰
	show("扫完 root     ", []*obj{root, a, b, c})

	popScan(&grey) // 扫 A → A 黑(A 此刻没有孩子)
	show("扫完 A        ", []*obj{root, a, b, c})

	// ---- mutator 窗口:标记进行中,程序做了两次指针写 ----
	a.children = append(a.children, c) // 黑 A → 白 C!
	b.children = nil                   // 灰 B → 白 C 的旧路被掐断
	if withBarrier {                   // 写屏障:A.field=C 触发 shade(C)
		if c.color == 0 {
			c.color = 1
			grey = append(grey, c)
		}
	}
	show("mutator 写指针后", []*obj{root, a, b, c})

	popScan(&grey) // 扫 B:孩子已被掐空,B 黑
	for len(grey) > 0 { // 有屏障时队列里还躺着 C;无屏障时队列已空
		popScan(&grey)
	}
	show("标记结束      ", []*obj{root, a, b, c})

	fmt.Println("判定垃圾(未染黑即回收):")
	for _, o := range []*obj{root, a, b, c} {
		if o.color != 2 {
			fmt.Printf("  回收 %s", o.name)
			if !withBarrier {
				fmt.Printf("  ← 但 A.children 里还躺着 C 的指针:悬空!")
			}
			fmt.Println()
		}
	}
}

func main() {
	run(false) // 先看事故
	run(true)  // 再看岗哨怎么救
}
bash
go run ./mark实测输出(go1.24.0 / Windows 11):
输出
===== 无屏障:漏标事故现场 =====
初始            root(灰)->[A B]  A(白)->[]  B(白)->[C]  C(白)->[]
扫完 root       root(黑)->[A B]  A(灰)->[]  B(灰)->[C]  C(白)->[]
扫完 A          root(黑)->[A B]  A(黑)->[]  B(灰)->[C]  C(白)->[]
mutator 写指针后  root(黑)->[A B]  A(黑)->[C]  B(灰)->[]  C(白)->[]
标记结束        root(黑)->[A B]  A(黑)->[C]  B(黑)->[]  C(白)->[]
判定垃圾(未染黑即回收):
  回收 C  ← 但 A.children 里还躺着 C 的指针:悬空!

===== 有屏障:岗哨救场 =====
初始            root(灰)->[A B]  A(白)->[]  B(白)->[C]  C(白)->[]
扫完 root       root(黑)->[A B]  A(灰)->[]  B(灰)->[C]  C(白)->[]
扫完 A          root(黑)->[A B]  A(黑)->[]  B(灰)->[C]  C(白)->[]
mutator 写指针后  root(黑)->[A B]  A(黑)->[C]  B(灰)->[]  C(灰)->[]
标记结束        root(黑)->[A B]  A(黑)->[C]  B(黑)->[]  C(黑)->[]
判定垃圾(未染黑即回收):
解读:
- 第一轮(无屏障) :黑 A 拿到白 C、灰 B 掐断旧路------两步同发,队列空了 C 还是白 → C 被回收,而 A 里还留着它的指针。这就是写屏障要防的内存事故的完整因果链。
- 第二轮(有屏障) :同一串扫描、同一串指针写,唯一区别是写 A 的字段时岗哨把 C 染了灰(输出第 4 行
C(灰))→ C 入队 → 标记结束全黑,C 存活。 - 映射回源码 :
//go:nowritebarrierrec不是"add 里的写不安全所以要拦",而是"add 连岗哨都不能惊动"------它跑在信号里,岗哨的账本(GC 内部队列)可能正处于任何中间状态。
B.4 单写单读环形缓冲:不需要锁的账本
从零开始:两个速度不同的人怎么共用一本账
cpuprof 的世界里有两个角色,速度天生不匹配:
- 记账员 (信号处理器
add):每 10ms 记一笔,必须立刻记完走人(铁律),绝不能等任何人; - 抄账员 (
profileWritergoroutine):每 100ms 醒一次,把攒的账批量抄走、编码、写盘。
中间必须有本子兜着差距。朴素方案是加锁:记账前拿锁、抄账前拿锁。但铁律 2 说记账员不能等锁。于是有了并发编程里一个精巧的解法:让"锁"消失,代价是各自的计数器只能自己写。
环形缓冲 + 各写各的计数器
结构:一个固定长度的数组(想象首尾相接成环),外加两个计数器:
text
buf  [N]uint64   ← 环形数组,N 是 2 的幂
wcnt             ← 写者已写总笔数(只有写者能改!)
rcnt             ← 读者已读总笔数(只有读者能改!)
规则:
- 写者 :
w - r == N说明写者绕一圈追上了读者 → 满 ,这笔丢掉并给溢出计数 +1(绝不等待!);否则写进buf[w & (N-1)],然后w++。 - 读者 :
r == w说明空,没账可抄;否则读buf[r & (N-1)],然后r++。
为什么不需要锁?每个共享变量恰好只有一个写入者 (wcnt 只有写者碰,rcnt 只有读者碰,数组每个格子从写到读之间只有一对一交接),读写计数器用原子指令(RISC/CISC 各有便宜的原子读),就再没有"两个工人摸同一块黑板"的局面。这叫 SPSC (Single-Producer Single-Consumer)无锁队列------无锁不是魔法,是通过"单一写者"约定把冲突从根上消灭。
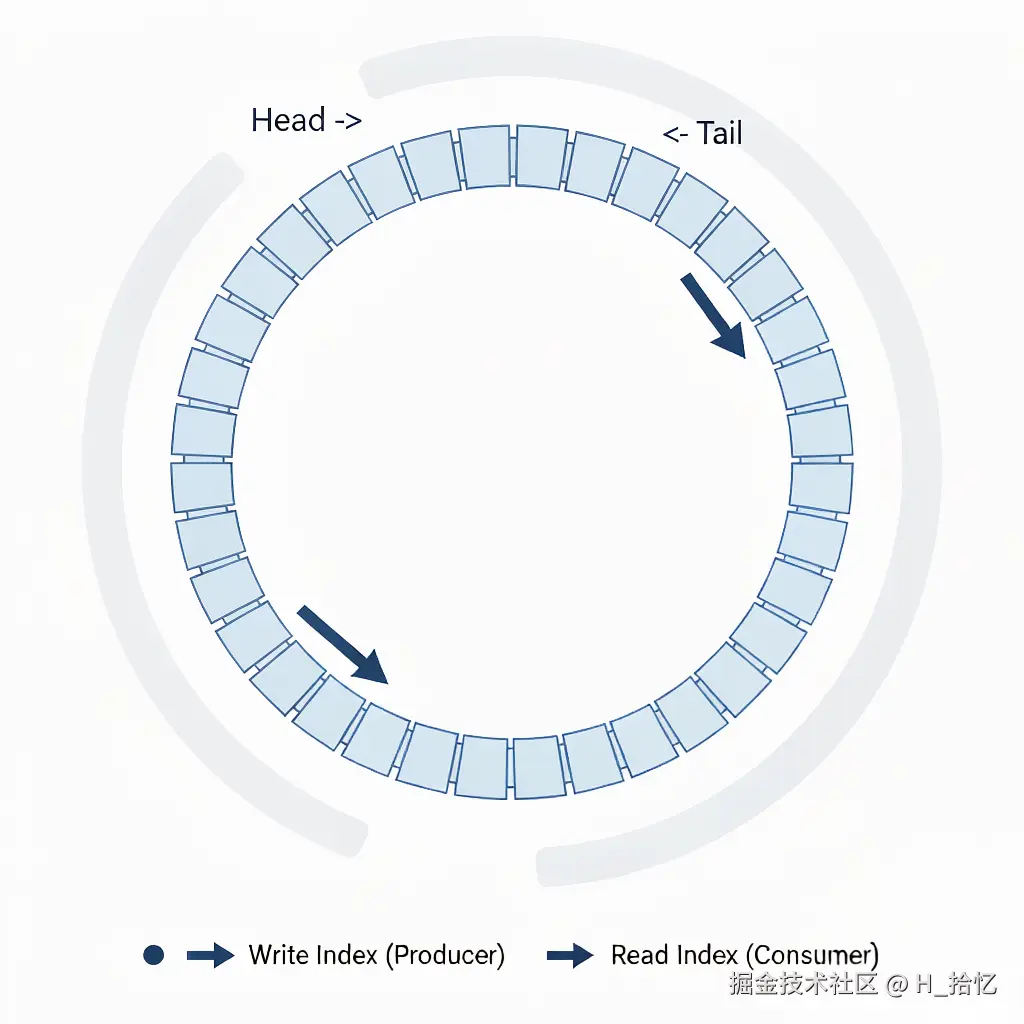
图 B-4 :环形数组 + 两个只属于自己的计数器(写者
wcnt、读者rcnt)。写者绕一圈追上读者说明"满",直接丢笔;下标用& (N-1)取代除法取模。
两个精妙细节:
- 容量取 2 的幂 :下标本来要算
w % N(除法,几十个时钟周期),改成w & (N-1)(与运算,1 个时钟周期)。代价只是 N 必须是 2 的幂------cpuprof.go 里profBufWordCount = 1 << 17就是这么来的。 - 满时丢笔而非等待 :这是铁律 1 的直接推论。丢的笔会累计到溢出计数器,最后作为"丢失样本"上报------宁可账本缺一笔,不能流水线卡一秒。映射:非 Go 线程样本跟不上时的
_LostExternalCode机制(03 篇 §七)。
映射:cpuprof 的真身
| 本篇玩具 | runtime 真身(profbuf.go) |
|---|---|
buf [64]uint64 |
profBuf.data(1<<17 词,还分 data/tags 两层) |
wcnt/rcnt |
写读两侧各自维护的 count(配合翻面 publish 机制) |
overflow 计数 |
profBuf.overflow,读出时变成 _LostExternalCode 记录 |
| 丢笔不等待 | 信号侧写缓冲的全部哲学 |
真身比玩具精巧(双缓冲翻面、tag/普通记录两种槽位、profBufDead 状态机),04 篇逐行拆;本篇建立直觉即可:一本两个人各写各计数器的环形账本,满了就撕,绝不锁。
动手实验 B-3:快慢两个抄账员,亲眼看丢笔
ring/main.go(完整可复制):
go
package main

import (
	"fmt"
	"os"
	"sync/atomic"
	"time"
)

// 迷你 profBuf:固定容量环形账本,一个写者 + 一个读者,全程无锁
const N = 64 // 2 的幂!(真身是 1<<17)

type ring struct {
	buf      [N]uint64
	wcnt     atomic.Uint64 // 写者推进的总笔数(只由写者改)
	rcnt     atomic.Uint64 // 读者推进的总笔数(只由读者改)
	overflow atomic.Uint64 // 没抄走就被迫撕掉的笔数
}

func (r *ring) write(v uint64) bool {
	w, rd := r.wcnt.Load(), r.rcnt.Load()
	if w-rd >= N { // 写者绕一圈追上读者:账本满
		r.overflow.Add(1) // 只能丢这笔并计数(→ _LostExternalCode 的机制本质)
		return false
	}
	r.buf[w&(N-1)] = v // &(N-1) 取下标:容量必须 2 的幂的原因
	r.wcnt.Store(w + 1)
	return true
}

func (r *ring) read() (uint64, bool) {
	rd, w := r.rcnt.Load(), r.wcnt.Load()
	if rd == w {
		return 0, false // 账本空
	}
	v := r.buf[rd&(N-1)]
	r.rcnt.Store(rd + 1)
	return v, true
}

func main() {
	readerSpeed := 100 // 笔/秒
	if len(os.Args) > 1 && os.Args[1] == "slow" {
		readerSpeed = 40
	}
	var r ring
	deadline := time.Now().Add(3 * time.Second)

	go func() { // 写者:每 10ms 记一笔(≈ 100Hz 的信号处理器)
		t := time.NewTicker(10 * time.Millisecond)
		defer t.Stop()
		for time.Now().Before(deadline) {
			<-t.C
			r.write(uint64(time.Now().UnixNano()))
		}
	}()
	go func() { // 读者:按 readerSpeed 抄账(≈ profileWriter,真身每 100ms 醒一次)
		t := time.NewTicker(time.Second / time.Duration(readerSpeed))
		defer t.Stop()
		for time.Now().Before(deadline) {
			<-t.C
			r.read()
		}
	}()

	time.Sleep(3*time.Second + 200*time.Millisecond)
	fmt.Printf("读者 %d 笔/秒(写者恒 100):写出=%d 抄走=%d 撕掉(丢)=%d\n",
		readerSpeed, r.wcnt.Load(), r.rcnt.Load(), r.overflow.Load())
}
bash
go run ./ring        # 快读者:100 笔/秒,跟得上写者
go run ./ring slow # 慢读者:40 笔/秒,跟不上实测输出(go1.24.0 / Windows 11):
输出
读者 100 笔/秒(写者恒 100):写出=300 抄走=299 撕掉(丢)=0
读者 40 笔/秒(写者恒 100):写出=184 抄走=120 撕掉(丢)=116
解读:
- 快读者 :读者每秒抄 100 笔 ≥ 写者速度,账本永远只有一两笔存货,3 秒 300 笔只丢 0 笔(那 1 笔差值是起停相位,非溢出)。这就是正常运行时的 cpuprof:profileWriter 足够勤快,你从没听过 CPU 剖析丢样本。
- 慢读者 :写者恒 100 笔/秒,读者只抄得动 40 笔/秒,缺口 60 笔/秒。前 ~1 秒靠 64 格本子硬扛(存量 64),本子写满后写者只能"读者抄一笔、我写一笔",实际写出降到读者的速度;3 秒共尝试 300 笔,成功 184、抄走 120、撕掉 116 (184+116=300,一笔不差)。撕掉的 116 笔,就是剖析报告里"lost samples"的诞生过程。
- 注意整个程序没有一把锁:写者和读者从没互相等待过,靠"各写各的计数器"相安无事------这就是 B.4 标题的含金量。
B.5 四块地基拼回 cpuprof.go:总映射表
把四块地基按 03 篇的源码顺序拼回去。每一行都可以这样读:源码写法 ← 地基铁律。
| cpuprof.go 位置 | 源码做了什么 | 踩的是哪块地基 |
|---|---|---|
| §四 SetCPUProfileRate | 装/拆定时器(POSIX)或启停 profileLoop(Windows) | B.1:信号由内核定时触发 |
| §五 add:106 一带 | signalLock.CompareAndSwap 拿不到直接 return |
B.2:CAS-once,绝不自旋绝不睡 |
| §五 add 全函数 | 零分配,只写预分配数组;//go:nowritebarrierrec |
B.1 铁律 3 + B.3:不能惊动写屏障/GC |
| §五 add:计数递增、写 tagPtr、写栈帧 | 定长记录写入环形缓冲 | B.4:SPSC 无锁账本 |
| §七 addExtra/addNonGo | 溢出计数 → _LostExternalCode |
B.4:满了撕笔不等待 |
| §八 readProfile | signalLock 短暂置真,抄空缓冲,置 log=nil |
B.1+B.2:抄账员与记账员的唯一同步点 |
| §九 sigprof(proc.go) | 收 SIGPROF → 抓当前栈 → 调 add | B.1:被拍肩的是谁,记的就是谁 |
一句话总结 :
cpuprof.go是把"信号处理器的三条铁律"翻译成数据结构设计的一篇范文------锁变成 CAS-once(B.2),堆变成预分配数组(B.3),队列变成 SPSC 环形账本(B.4),而这一切的起点是"内核每 10ms 拍一次肩"(B.1)。