💡 一句话总结:一篇实测研究把「模型升级后 KV Cache 要不要清」从玄学变成了可测量的决策问题------同家族新模型直接复用旧缓存,检索强的模型近乎无损还能白拿 2.10×--5.08× 的首 token 加速,检索弱的(Qwen)则从 55% 崩到 13%。做推理服务、长上下文应用的工程师值得花十分钟看完。
先问一个可能戳到你的问题:你辛苦搭的那套长前缀缓存------系统提示词、RAG 的检索文档、高频指令模板------上一次模型升级的时候,是不是全被清掉了?
清得对吗?没人知道。因为新版模型的权重变了,旧缓存是用旧权重算出来的,直接喂给新模型,会发生什么全凭直觉。推理框架(SGLang 之类)的做法简单粗暴:版本一变,缓存全部失效,长上下文场景全额重算一遍 prefill。钱就这么烧掉了。
但直觉真的可靠吗?最近一项研究把这个问题钉在了实验台上,专挑了当下最典型的发布节奏------同底座、后训练迭代 的模型更新来测。结论比想象中有趣得多:有的模型近乎白捡 5 倍加速,有的直接翻车。论文标题很直白:Can KV Cache Be Reused Across Model Updates? A DeepSeek-V4-Flash Case Study(arXiv 2611.14051)。
想自己翻原文?
- 📄 论文:arXiv 2611.14051
- 🔧 DeepSeek 更新日志:api-docs.deepseek.com/updates
- 🧩 DeepSeek-V4-Flash-Base:HuggingFace · deepseek-ai
这篇论文到底想解决什么问题?
先把背景捋一下。KV Cache(键值缓存)是推理加速的基石:模型处理过一段上下文后,注意力要用的中间状态被存下来,下次同前缀的请求直接接着算,不用重读整段前缀。你的系统提示词再长,也只在第一个请求时付一次 prefill 的钱。
问题出在模型迭代上。现在的发布节奏是三个月一代:DeepSeek-V4-Flash 在 2026 年 4 月 24 日发布预览版,7 月 31 日就放出了 Flash-0731------架构不变、参数量不变,纯后训练升级;GLM-5.3 也是踩着 GLM-5.2 的同一底座继续训练出来的。这种"同底座滚动更新"成了行业标配。
于是出现一个尴尬的空档:应用侧的上下文没变(系统提示词还是那份、RAG 文档还是那些),但模型的权重变了。旧缓存里存的还是"旧模型对这段话的理解"------新模型还能读懂吗?
为什么会这么问?因为 KV Cache 不是原文的压缩包,它是旧权重算出来的中间状态。打个比方:同一个图书馆,换了新的图书编目员,旧编目员留下的索引卡片,新员工拿着能不能直接用?大概率能凑合------但如果新员工的工作习惯改得太多,拿着旧索引找书,找出来的可能就不是同一本了。
论文的研究问题因此非常聚焦:新版本模型直接消费前代缓存(不做任何映射、不选择性重算),任务还有用吗?行为还像自己吗? 注意这是两个独立的问题------这正是这篇论文最重要的洞察。
它的思路是什么?
作者的实验设计不复杂,但刀切得很干净。每个输入切成共享前缀 P 和问题 Q,然后摆三个配置同台对比:
- Target:新模型自己算前缀缓存、自己答题(原生基准);
- Source:旧模型全程包办(旧世界的基准);
- KV Reuse:旧模型算缓存,新模型拿过来直接续写(被测对象)。
三个配置吃完全相同的输入、用贪心解码,差异只可能来自那一份缓存的归属。测什么?检索准确率(大海捞针 NIAH)、答案质量(四个长上下文 QA 基准)、首 token 延迟(TTFT),一共四组真实的模型更新:GLM-5.2→5.3、DeepSeek-V4.1-Flash→Flash-1017、DeepSeek-V4-Flash→Flash-0731、Qwen3-30B-A3B→Instruct-2507。
四组跑下来,图谱长这样------
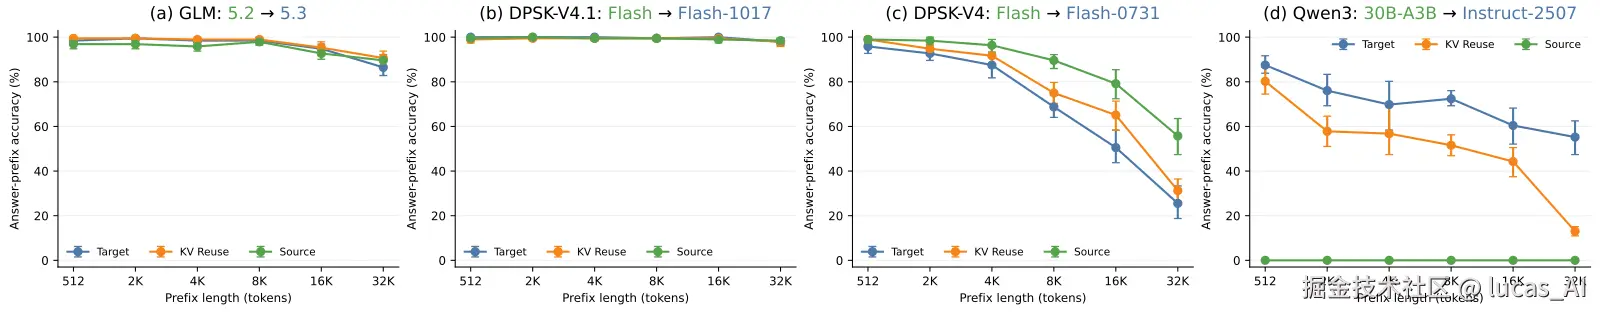 图说:横轴是前缀长度(512 到 32K token),三条曲线分别是新模型原生(Target)、旧模型(Source)、缓存复用(KV Reuse)。GLM 和 V4.1-Flash 的复用曲线几乎贴着原生走,Qwen 则明显掉队。
一个更扎心的指标也被挖了出来:harmful flip rate(HFR)------原本新模型答对的题,复用旧缓存后答错的比例。为什么要单看这个?因为总准确率是"修复"和"破坏"相抵后的净值:V4-Flash 在 32K 处复用后总准确率从 25.52% 涨到 31.25%,看着是赚了,但细看是打碎了 13 个原本正确的答案、修好了 24 个原本错的。净值上升,掩护了破坏。
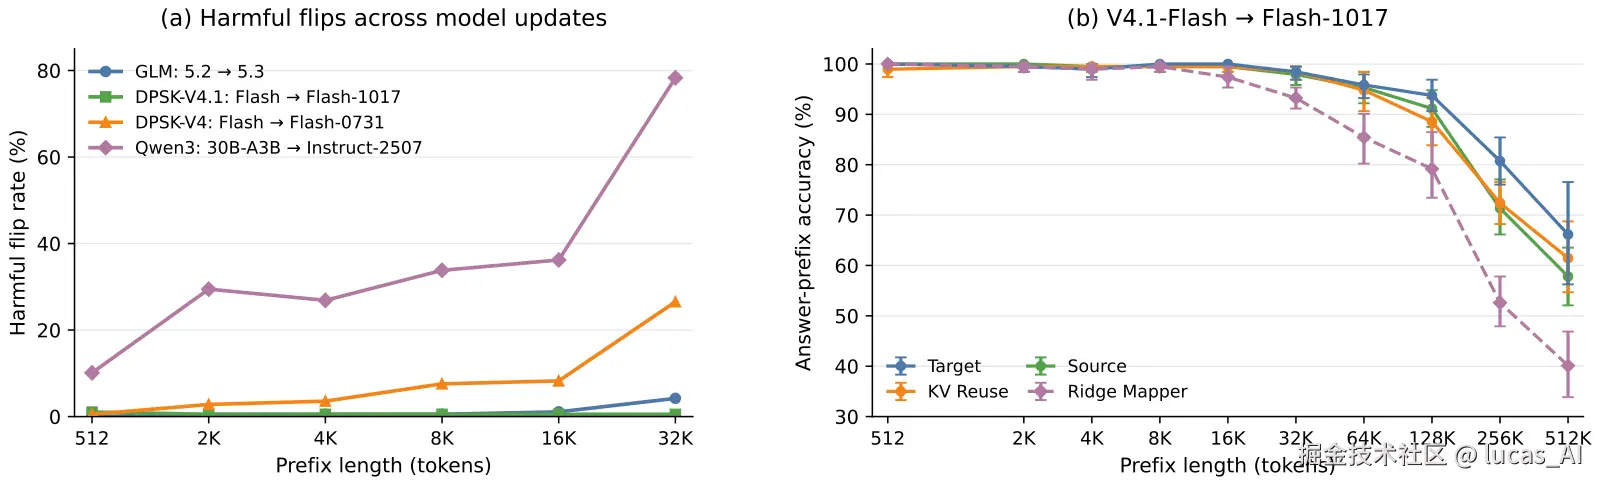 图说:左图是四组更新的有害翻转率------GLM 4.22%、V4.1-Flash 0.53% 几乎无损,V4-Flash 26.53%,Qwen 高达 78.30%;右图显示 V4.1-Flash 组把前缀拉到 512K,复用仍有 61.46% 的准确率。
那"行为像不像自己"怎么量?论文提出了一个新度量:Functional Cache Divergence(FCD,功能缓存散度)。它的任务是给"换了缓存之后模型内心的动摇程度"打分------固定后续输入和预测位置,比较新模型分别用自家缓存和旧缓存时,下一个 token 的完整概率分布差多少(缩放后的 JS 散度,0 到 100)。
为什么要搞这么细?准确率只看 argmax,输出碰巧一致时,模型内部可能已经翻天覆地。FCD 就是那个能照出"表面平静、内心波涛"的仪器。测出来的模式非常有戏剧性,后面效果节细说。
机制层面,作者还做了交叉干预实验:在中间某几层,把"进层的表示"和"本层的前缀缓存"分别替换、组合替换,看注意力输出变多少。这相当于给漂移做了一场"溯源",结论也放在后面。
效果到底怎么样?
三个最值得记住的数字来了。
第一个数字:5.08×。 在预填缓存已就绪的前提下(旧模型提前把长前缀算好了),HotpotQA 上的首 token 延迟加速中位数达到 5.08 倍,MultiFieldQA-en 是 2.51 倍,2WikiMQA 是 2.10 倍。规律很朴素:前缀越长,可省的 prefill 越多,加速越猛。唯一的反例是 BABILong------前缀中位数只有 1.7K token,省下的计算抵不过读缓存的开销,加速比掉到 0.86×,反而慢了一点。缓存复用不是免费的,它有个"起步价"。
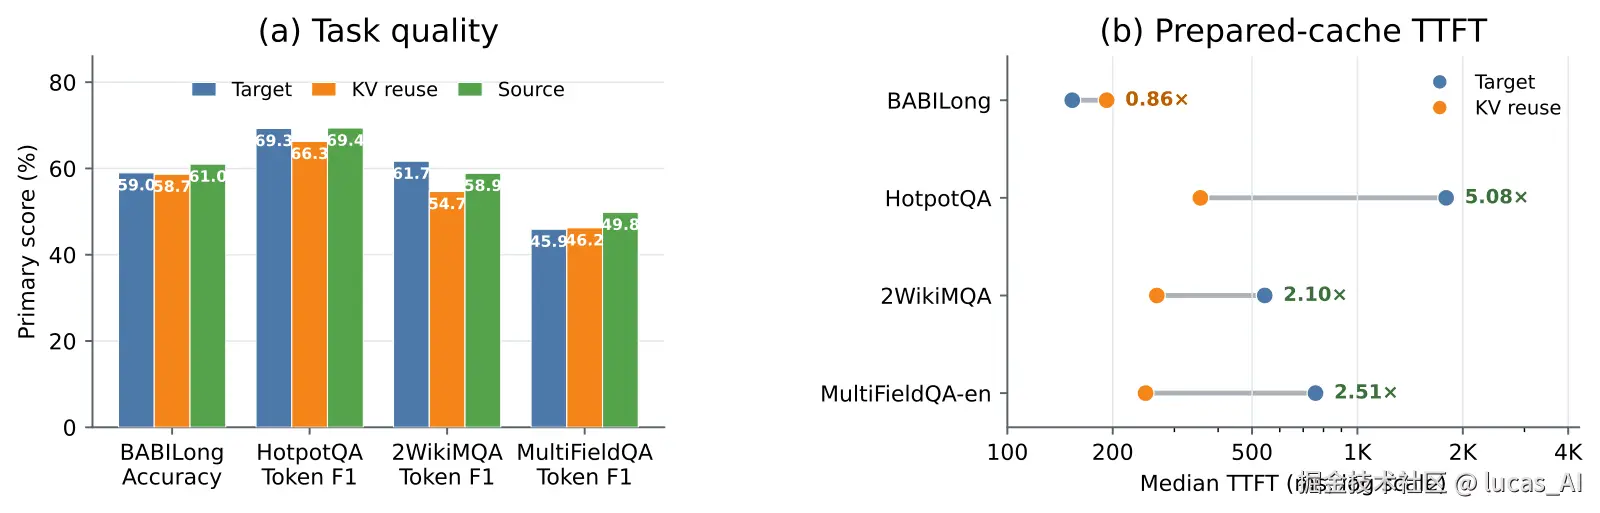 图说:TTFT 加速幅度(上排)与任务分数(下排)。MultiFieldQA 分数持平白赚加速,两个多跳 QA 各掉了 3 分和 7 分 F1。
第二个数字:0.53% vs 78.30%。 这组对比是全文最戏剧性的。同样是跨版本直接复用,DeepSeek-V4.1-Flash→Flash-1017 的有害翻转率只有 0.53%------32K 前缀下新旧模型准确率都是 97.92%,堪称无缝接力;而 Qwen3-30B→Instruct-2507 在做了 RoPE 相位对齐之后,复用仍然把 32K 准确率从 55.21% 干到 13.02%,78.3% 的正确答案被复用打碎。同架构、同家族,结局天壤之别。
为什么会这样?作者的观察是:检索能力强的模型,复用更可靠。GLM-5.3 和 V4.1-Flash 本身检索就强,接手旧缓存照样稳;Qwen 的检索能力在四组里最弱,表征坐标系在更新中偏移得也最大。一个可能的解释(作者的原话是"与同家族 checkpoint 间部分共享的表征坐标系一致"):后训练迭代没有大动检索相关的表征,而 Qwen 这次从 Base 到 Instruct 的跨度太大,坐标系都换了。
第三个数字:0% → 91.15%。 这是机制上最有味道的实验。DeepSeek-V4-Flash-Base 是没经过指令训练的底座模型,它用自己的缓存答题时只会复述问题,准确率 0%。但把 Flash 版本的缓存注射进去------Base 的权重一个参数都不动------准确率直接跳到 2K 前缀下的 91.15%。
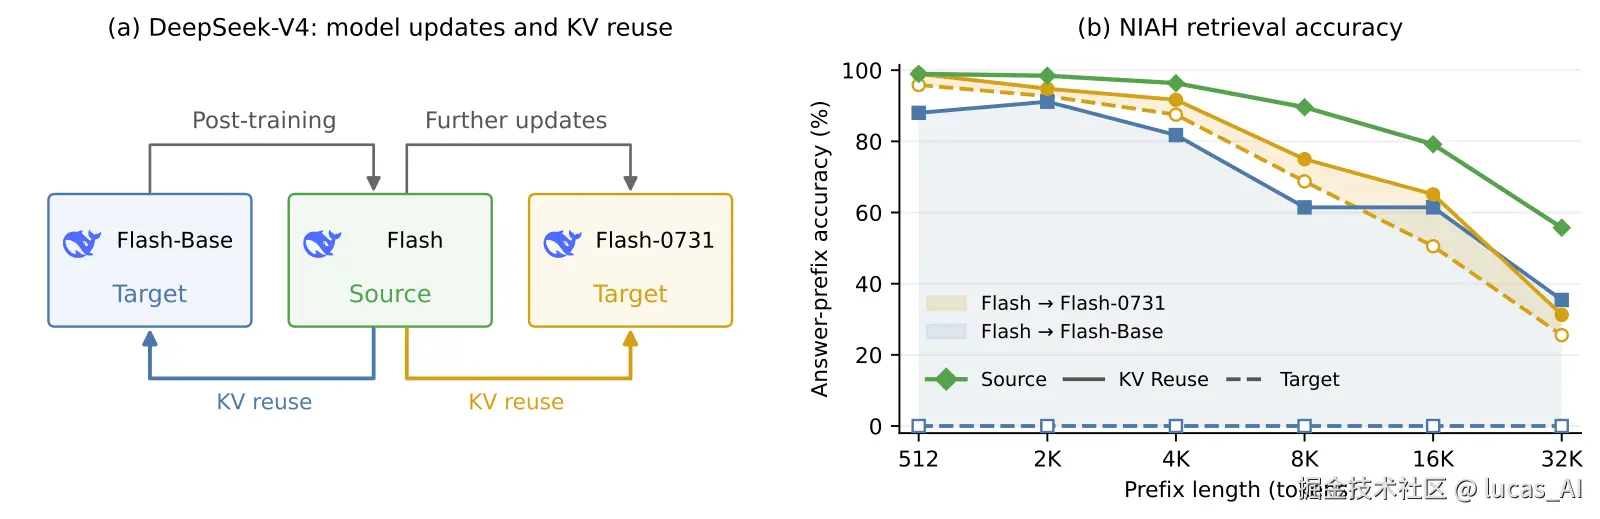 图说:同一个 Flash 缓存,喂给更早的 Base 和更晚的 Flash-0731 都能提升检索。Base 从 0% 被救到 81.77%(4K 处),说明缓存里编码了"只回答值"这条指令本身。
这说明什么?KV Cache 里存的根本不是"这段话的客观摘要",而是旧模型"处理这段话 + 理解答题指令"的完整状态。缓存是有立场的------它天然带着旧模型对"该怎么回答"的理解。新模型接手的不是一个中性的数据包,是前任的工作习惯。
那 FCD 照出了什么?检索任务和自然文本续写,从 512 到 32K token,走出了完全不同的曲线:NIAH 检索的 FCD 从 2.87 涨到 30.62(内心越来越动摇),FineWeb-Edu 文本续写始终稳在 3.04--3.64(几乎无感)。道理不复杂:检索题的答案只能来自缓存里的记录,缓存表征一漂移,答案就悬了;自然文本续写可以靠局部的语法和语义线索"自我修复",缓存怎么样都写得像模像样。
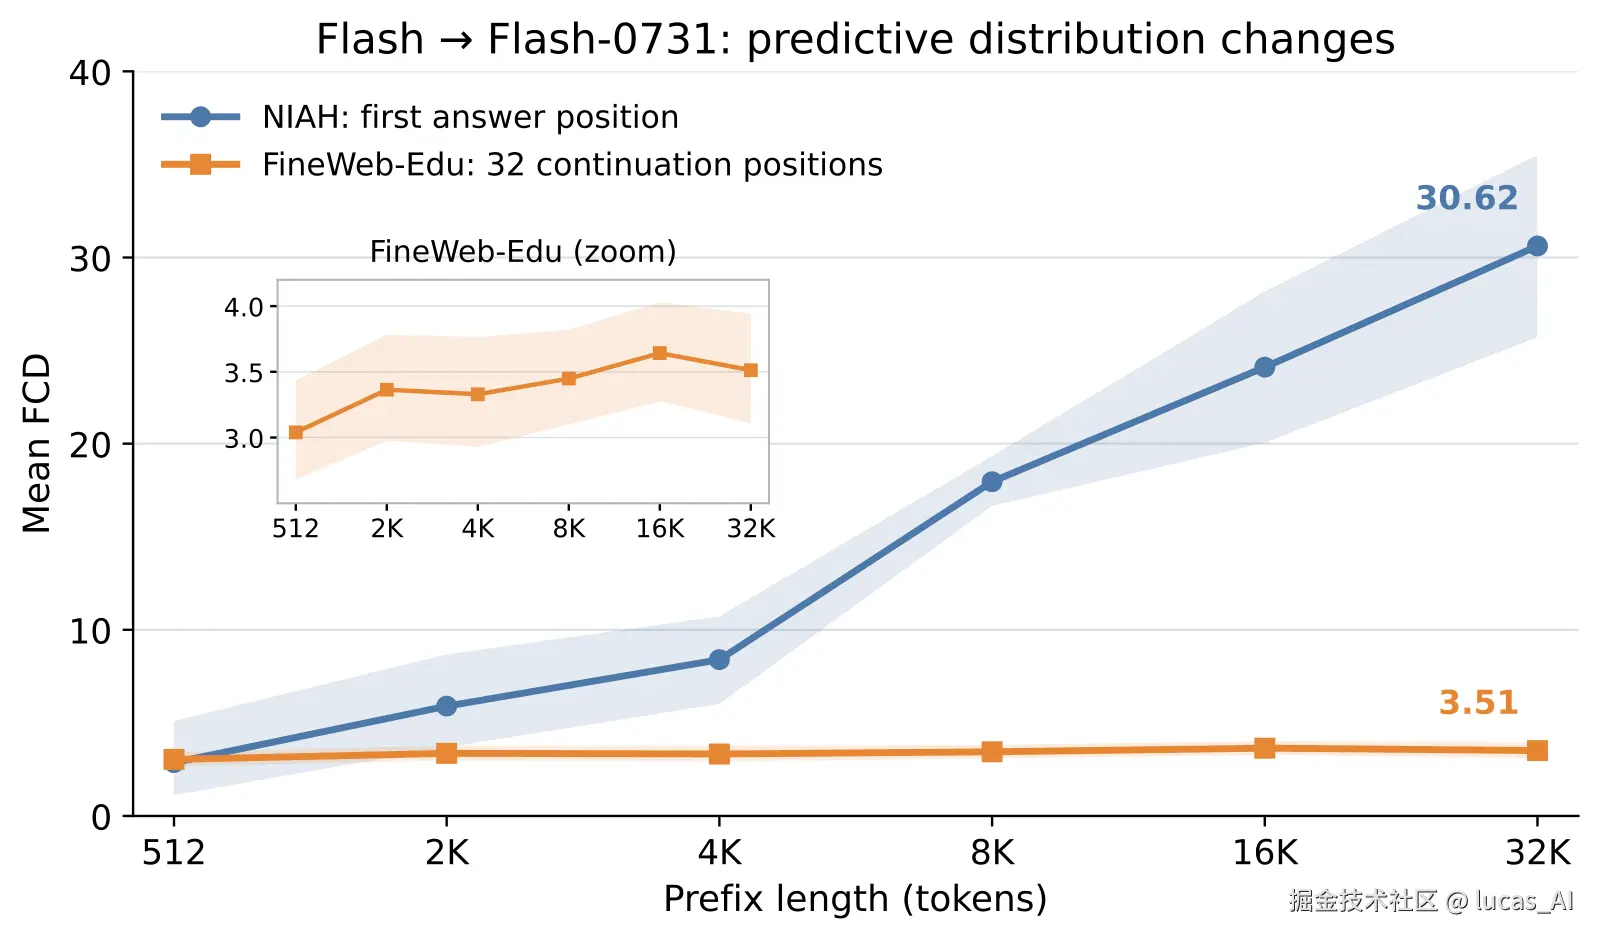 图说:两条曲线共用纵轴。蓝色(NIAH 检索)随长度陡增,绿色(FineWeb-Edu 续写)几乎水平------复用缓存的风险高度集中在"答案依赖缓存内容"的任务上。
最后是溯源实验的结果:在层 37 上,只换本层缓存、不换进层表示,注意力输出的差异只有 0.019;只换进层表示,差异是 0.473------差了 25 倍。换句话说,漂移不是困在某一层的缓存里,而是沿着层的输入表示一路传播滚雪球。四个复用后答错的案例里,把 36--42 层的注意力输出整个换回去能救回全部 4 个,只把这几层的前缀缓存换回去只救回 1 个。想"修哪层缓存"来补救,不是个局部手术。
为什么你要关心?
如果你在做推理服务、RAG 系统或者任何带长前缀的应用,这篇论文至少给你三样东西。
- 缓存清理策略有了量化依据:同底座的小步更新(如 V4.1-Flash 这种),跨版本复用的风险实测极低,升级时保留缓存可能是合理的默认;大跨度更新(换底座、大规模后训练),该清就清------Qwen 那组 78% 的翻转率就是不清缓存的代价。
- 盯住你的任务类型:风险集中在"答案必须从缓存里的记录找出来"的检索型任务(NIAH、多跳 QA);自由生成类任务对缓存换血几乎无感。评估复用方案时,别拿通用续写任务测完就上线。
- TTFT 加速是真的,但有前提:2.10×--5.08× 的前提是"旧缓存在升级期间被保留了下来"。生产上这意味着模型更新窗口内新旧两版都要能算 prefill,或者至少保留旧版的推理路径------这笔工程账论文明确没算进加速比里,落地前要自己补上。
再往远看一步:这篇论文其实是在给"缓存作为模型间的通信介质"这个方向铺路。DroidSpeak、KVComm 这些工作已经在让不同 agent 之间直接交换 KV 状态,如果连"不同版本的同一家模型"都能接力,缓存就从性能优化升格成了基础设施。反过来,FCD 这个度量本身也值得搬走------任何涉及"换权重、换缓存、换表示"的系统改动,都可以用它做回归测试。
理性看待
泼冷水的时间。其一,NIAH 是人工味很浓的极端任务(单 token 键值、固定记录密度),真实 RAG 文档的语义冗余度完全不同,长度趋势能否外推存疑;其二,QA 只有 585 例,HotpotQA 那 −3.0 分 F1 的置信区间是 −6.6, −0.1,勉强跨零,"多跳有损"的证据不算厚;其三,论文没有开源代码和数据构建脚本,DeepSeek 复合缓存(含压缩与索引状态)的结论对其他架构的外推全凭推测;其四,加速比不含旧版 prefill 与启动成本,实际收益要打折。这篇论文的价值在"给出可测量的决策依据",不在"即插即用的加速方案"------读的时候把这两件事分开。