DLX(Dancing Links)用双向十字循环链表实现 Algorithm X,通常用于求解精确覆盖问题。
一、精确覆盖问题
设全集为 U,给定若干候选子集 S1,S2,...,Sn,需要从中选出一些子集,使 U 中的每个元素都恰好被包含一次 。即所选子集两两不交,且并集等于 U。
将每个候选子集写成一行,将全集中的每个元素写成一列。若子集 Sr 包含元素 c,则矩阵的 ar,c=1,否则为 0。这样就得到用于精确覆盖的 0-1 关联矩阵(incidence matrix):
| 候选行 | C1 | C2 | C3 | C4 |
|---|---|---|---|---|
| R1 | 1 | 1 | 0 | 0 |
| R2 | 0 | 0 | 1 | 1 |
| R3 | 1 | 0 | 1 | 0 |
| R4 | 0 | 1 | 0 | 1 |
矩阵表示的内容是:
- 行:一种可以选择的完整方案。例如 R1 同时满足 C1、C2。
- 列:一个必须恰好满足一次的约束。
- 1:该方案会覆盖该列;0:该方案不覆盖该列。
这里有两组精确覆盖解:{R1, R2} 与 {R3, R4}。前者覆盖的列集合分别为 {C1,C2}、{C3,C4},不存在遗漏或重复。
二、X 算法
对于 n 行 m 列的 0-1 矩阵,最直接的做法是枚举每行是否选取,再检查每列中 1 的个数是否为 1。这需要考虑最多 2n 个行子集,逐一检查的时间开销很大。
Algorithm X 改为按约束列展开搜索。设当前还未满足的约束列集合为 C,每一次递归执行以下步骤:
- 从 C 中选出一列 c。如果 C 为空,则当前已选行构成一个解。
- 枚举所有在第 c 列取值为 1 的候选行 r。
- 假设选中 r,从剩余问题中去掉 r 所覆盖的列,并去掉与 r 在任意列发生冲突的候选行。
- 对缩小后的问题递归求解;无解时恢复状态,尝试第 c 列的下一行。
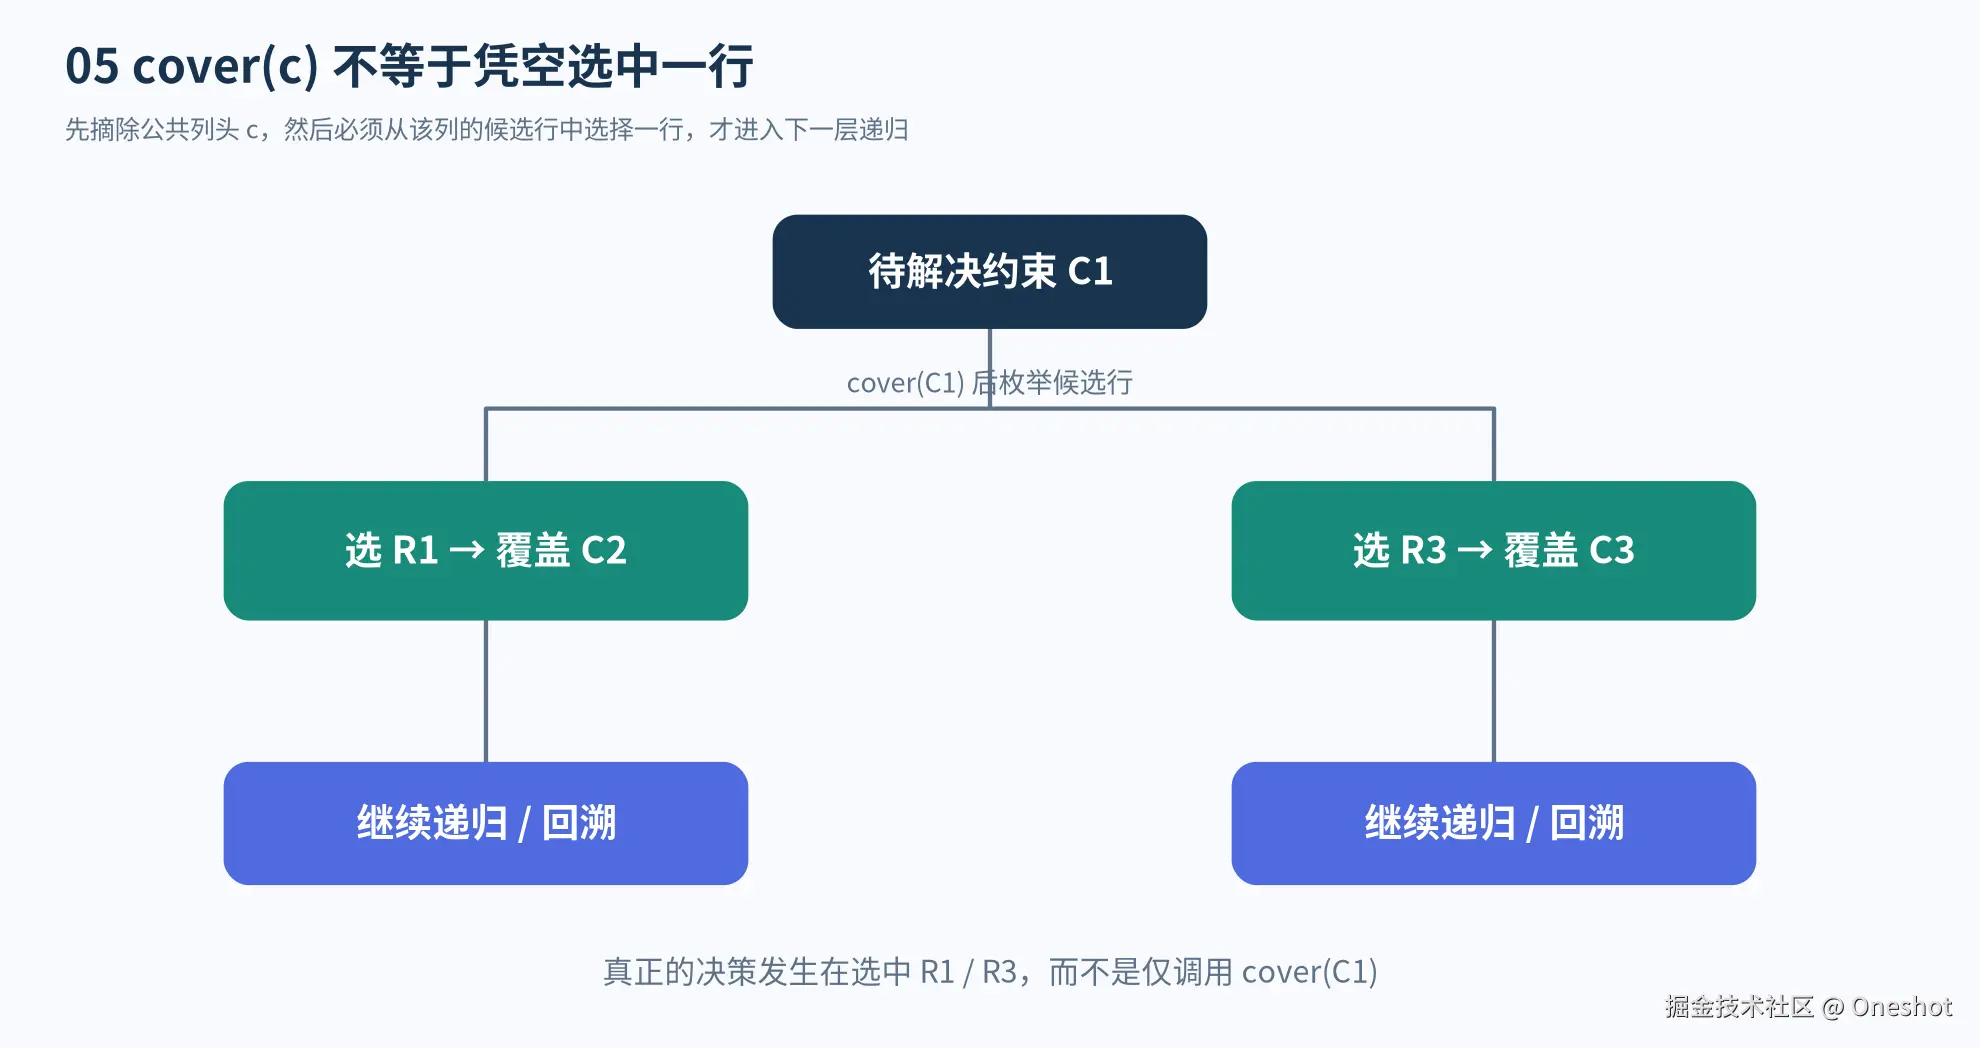
仍以四列矩阵为例,第 C1 列有 R1、R3 两种候选行。若选择 R1,则 C1、C2 已被满足,剩余的 C3、C4 可以由 R2 覆盖;若选择 R3,则 C1、C3 已被满足,剩余的 C2、C4 可以由 R4 覆盖。
text
选定 C1
├── 选择 R1(覆盖 C1、C2)
│   └── 选择 R2(覆盖 C3、C4) -> 一组解
└── 选择 R3(覆盖 C1、C3)
    └── 选择 R4(覆盖 C2、C4) -> 另一组解
搜索期间需要频繁删除行、列,并在回溯时恢复。普通二维数组可以实现,但每次删除或恢复都涉及较多元素的移动或状态判断。Dancing Links 用双向循环链表维护这些变化;Algorithm X 决定搜索顺序,DLX 负责链表操作。
三、舞蹈链的数据结构
以下使用一个 3×3 矩阵说明链表结构:
| 原矩阵 | C1 | C2 | C3 |
|---|---|---|---|
| R1 | A | 0 | B |
| R2 | C | D | 0 |
| R3 | 0 | E | F |
A~F 分别代表该位置的一个 1,不是额外的矩阵取值。
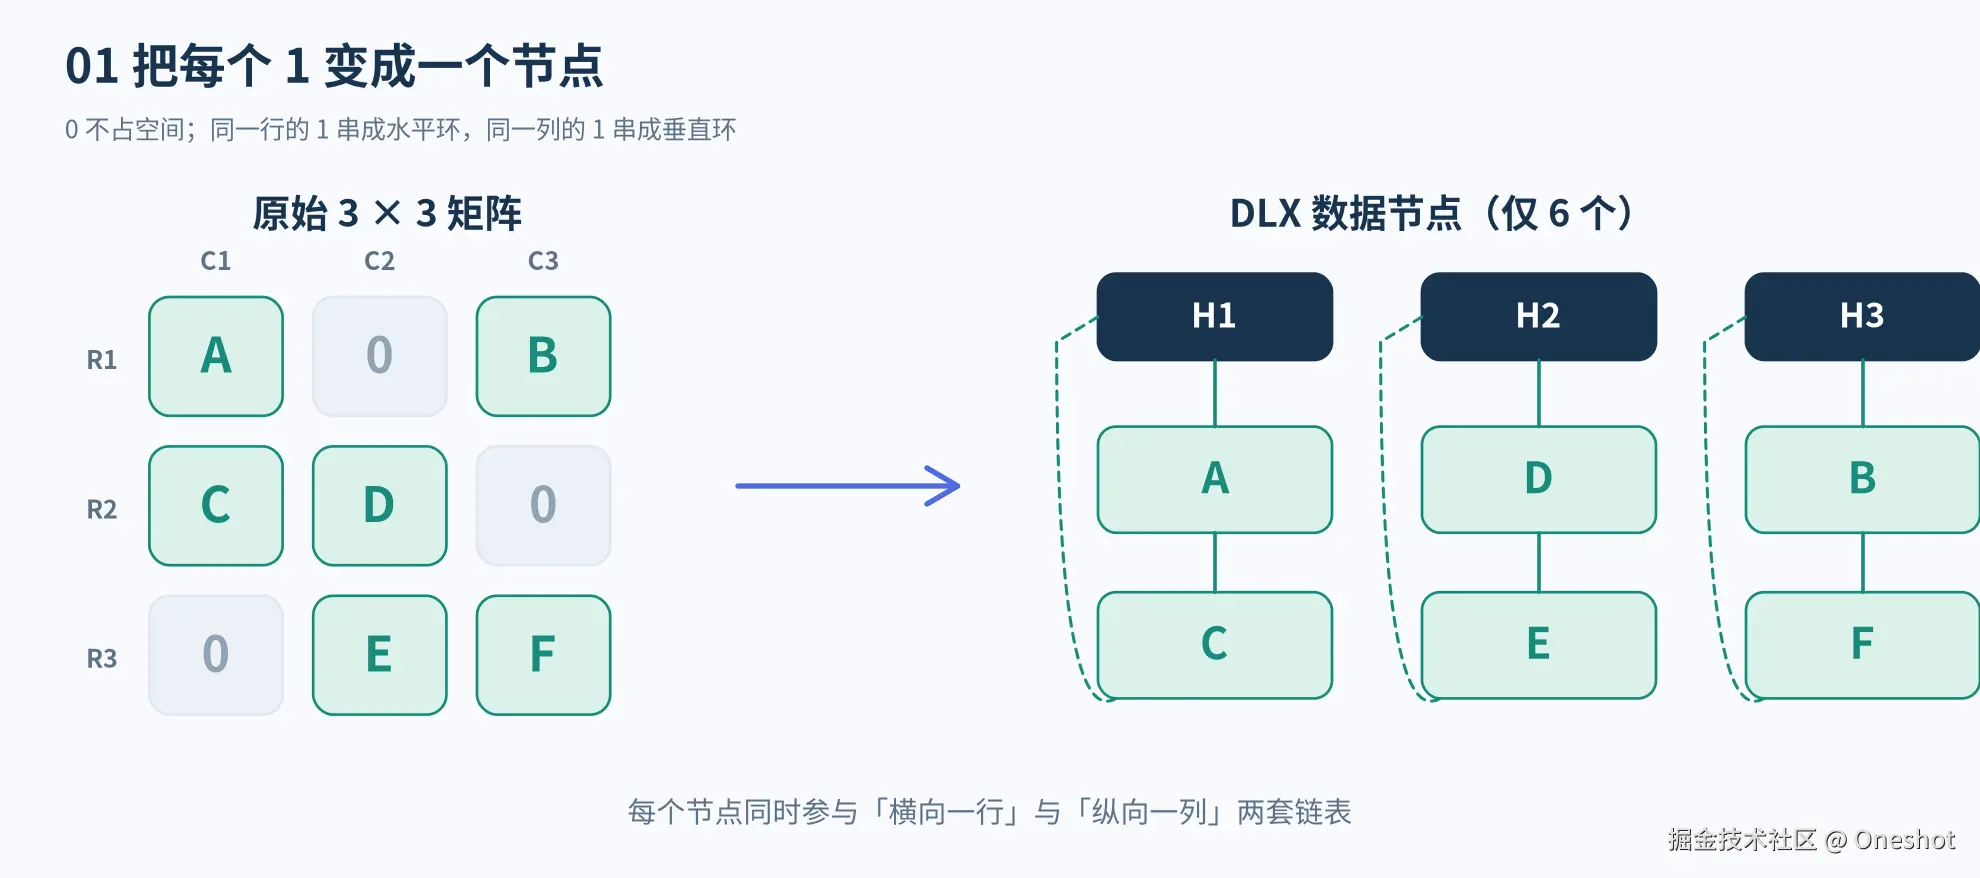
一个 1 对应一个节点
每个数据节点 p 有四个方向指针(数组模拟时实际存储的是节点编号):
| 数组 | 含义 | 连接范围 |
|---|---|---|
L[p] |
当前节点左侧节点 | 同一矩阵行 |
R[p] |
当前节点右侧节点 | 同一矩阵行 |
U[p] |
当前节点上侧节点 | 同一矩阵列 |
D[p] |
当前节点下侧节点 | 同一矩阵列 |
因此,一个节点同时加入一条横向循环链表 和一条纵向循环链表。例如 A 位于 R1、C1:横向连接 B,纵向连接 C。并不是横向、纵向各创建一个 A。
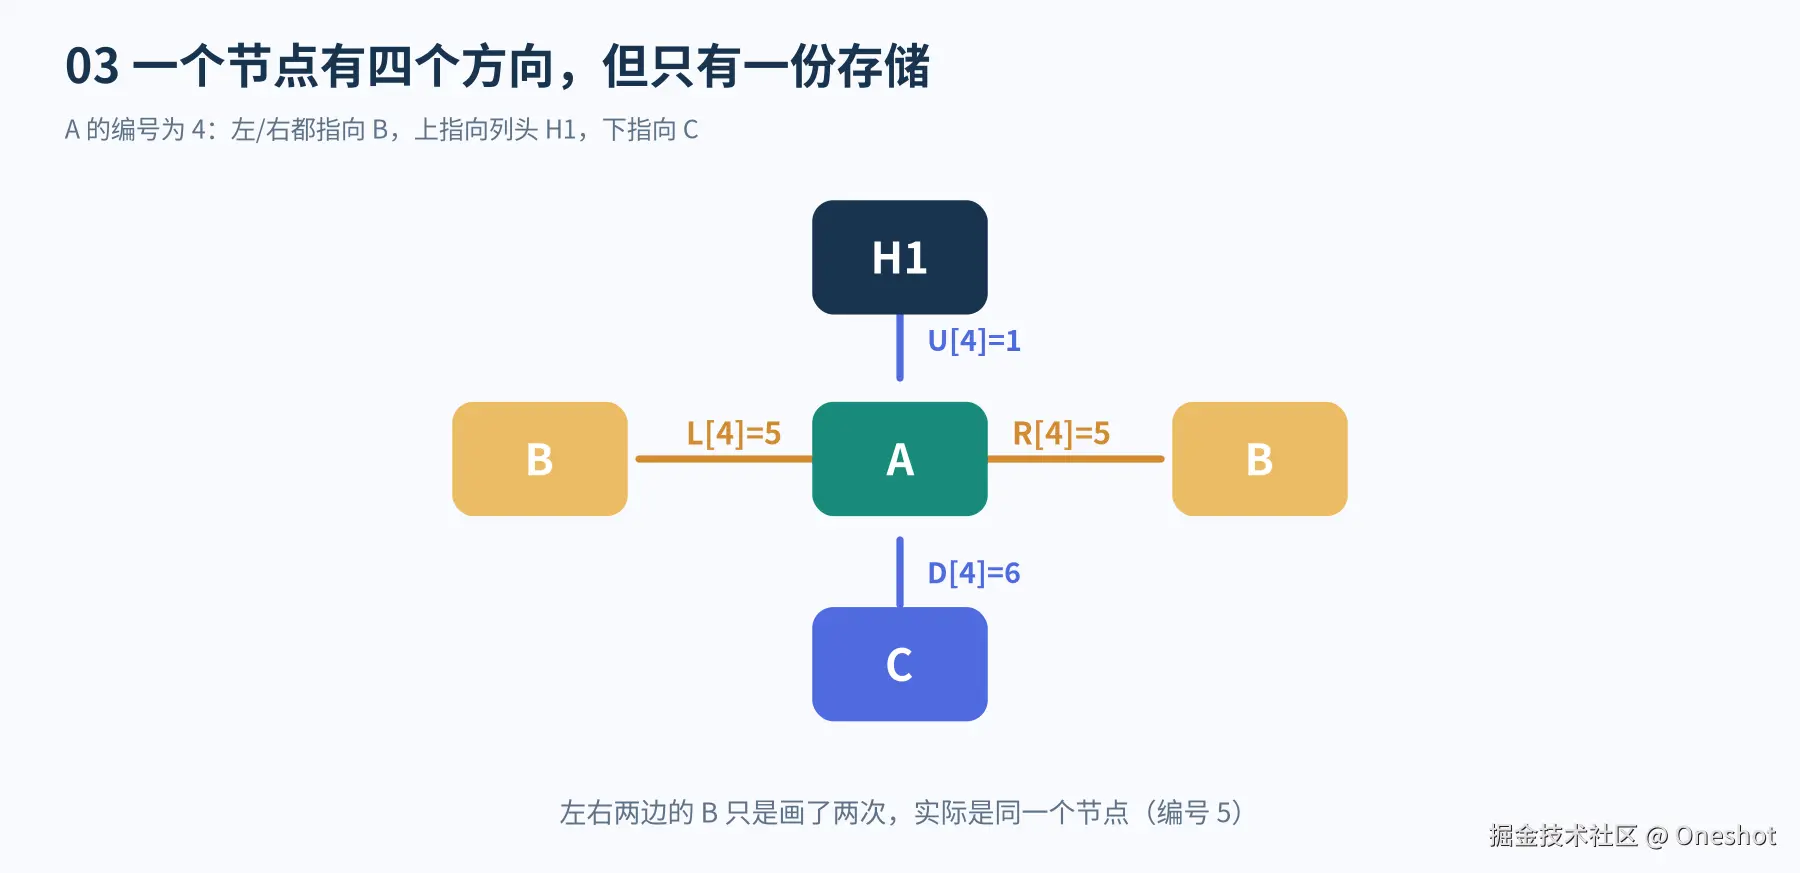
当同一行只有 A、B 两个数据节点时,L[A] = R[A] = B,L[B] = R[B] = A;当某行只有一个节点时,它的 L、R 都指向自己。
列头与总表头
DLX 额外创建:
- 编号为
0的总表头root; - 编号
1..m的列头,每列一个; - 编号
m+1开始的数据节点,每个1一个。
列头用于纵向访问该列的数据节点,且列头之间通过 L/R 连接成另一条双向循环链表:
text
root <-> H1 <-> H2 <-> H3 <-> root

H1 <-> A <-> C <-> H1    (纵向)
H2 <-> D <-> E <-> H2    (纵向)
H3 <-> B <-> F <-> H3    (纵向)

A  <-> B <-> A            (横向)
C  <-> D <-> C            (横向)
E  <-> F <-> E            (横向)
以上 <-> 只是表示相邻节点双向连接,末尾返回开头;实际横向和纵向的相邻关系分别存放在不同的数组中。行一般没有专用的行头节点 ,而是用 first[r] 记录建表时该行的一个入口。
节点编号和原矩阵坐标
按行扫描,依次插入 A、B、C、D、E、F,节点编号如下:
| 节点 | root | H1 | H2 | H3 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|---|---|---|---|
| 编号 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
例如 R[4] = 5 表示编号 4 的节点 A 的右邻居是节点 B;col[5] = 3 才表示 B 对应原矩阵第 3 列。节点编号只是存储位置,不代表行号或列号。
四、建表过程
初始化
列头先连成横向循环链表;每个列头的 U/D 指向自身,表示当前列没有数据节点:
cpp
void DLX::init(int n,int m)
{
    tot=m;
    for(int i=0;i<=n;i++)first[i]=0;
    for(int i=0;i<=m;i++)
    {
        L[i]=i-1;
        R[i]=i+1;
        U[i]=D[i]=i;
        sz[i]=0;
        col[i]=i;
    }
    L[0]=m;
    R[m]=0;
}
当 m=3 时,初始化后的部分数组为:
| 编号 | 节点 | L | R | U | D |
|---|---|---|---|---|---|
| 0 | root | 3 | 1 | 0 | 0 |
| 1 | H1 | 0 | 2 | 1 | 1 |
| 2 | H2 | 1 | 3 | 2 | 2 |
| 3 | H3 | 2 | 0 | 3 | 3 |
例如 U[1]=D[1]=1 的意思不是"第 1 列已经有数据",而是"空列的纵向循环链表只有列头 H1"。
插入节点
设待插入的 1 位于原矩阵 (r,c),给新节点分配编号 p=++tot。纵向把它插在当前列的最后一个数据节点 与列头 c 之间:
cpp
int p=++tot;
row[p]=r;
col[p]=c;

int last=U[c];
U[p]=last;
D[p]=c;
D[last]=p;
U[c]=p;
sz[c]++;
前两句指向旧末尾与列头,后两句让旧末尾和列头改为指向新节点。由于这是一个循环链表,列头 c 也充当纵向插入时的边界。
横向插入分两种情况。第一次向行 r 插入节点时,形成只有自己的循环链表:
cpp
if(first[r]==0)
{
    first[r]=p;
    L[p]=R[p]=p;
}
如果该行已有节点,就在 first[r] 之前、也就是当前行末尾插入:
cpp
else
{
    int f=first[r];
    L[p]=L[f];
    R[p]=f;
    R[L[f]]=p;
    L[f]=p;
}
这里的"末尾"只是本实现的插入位置。DLX 不要求横向节点按照原矩阵的列号严格递增;只需要保证每个候选行在链表中包含正确的节点。
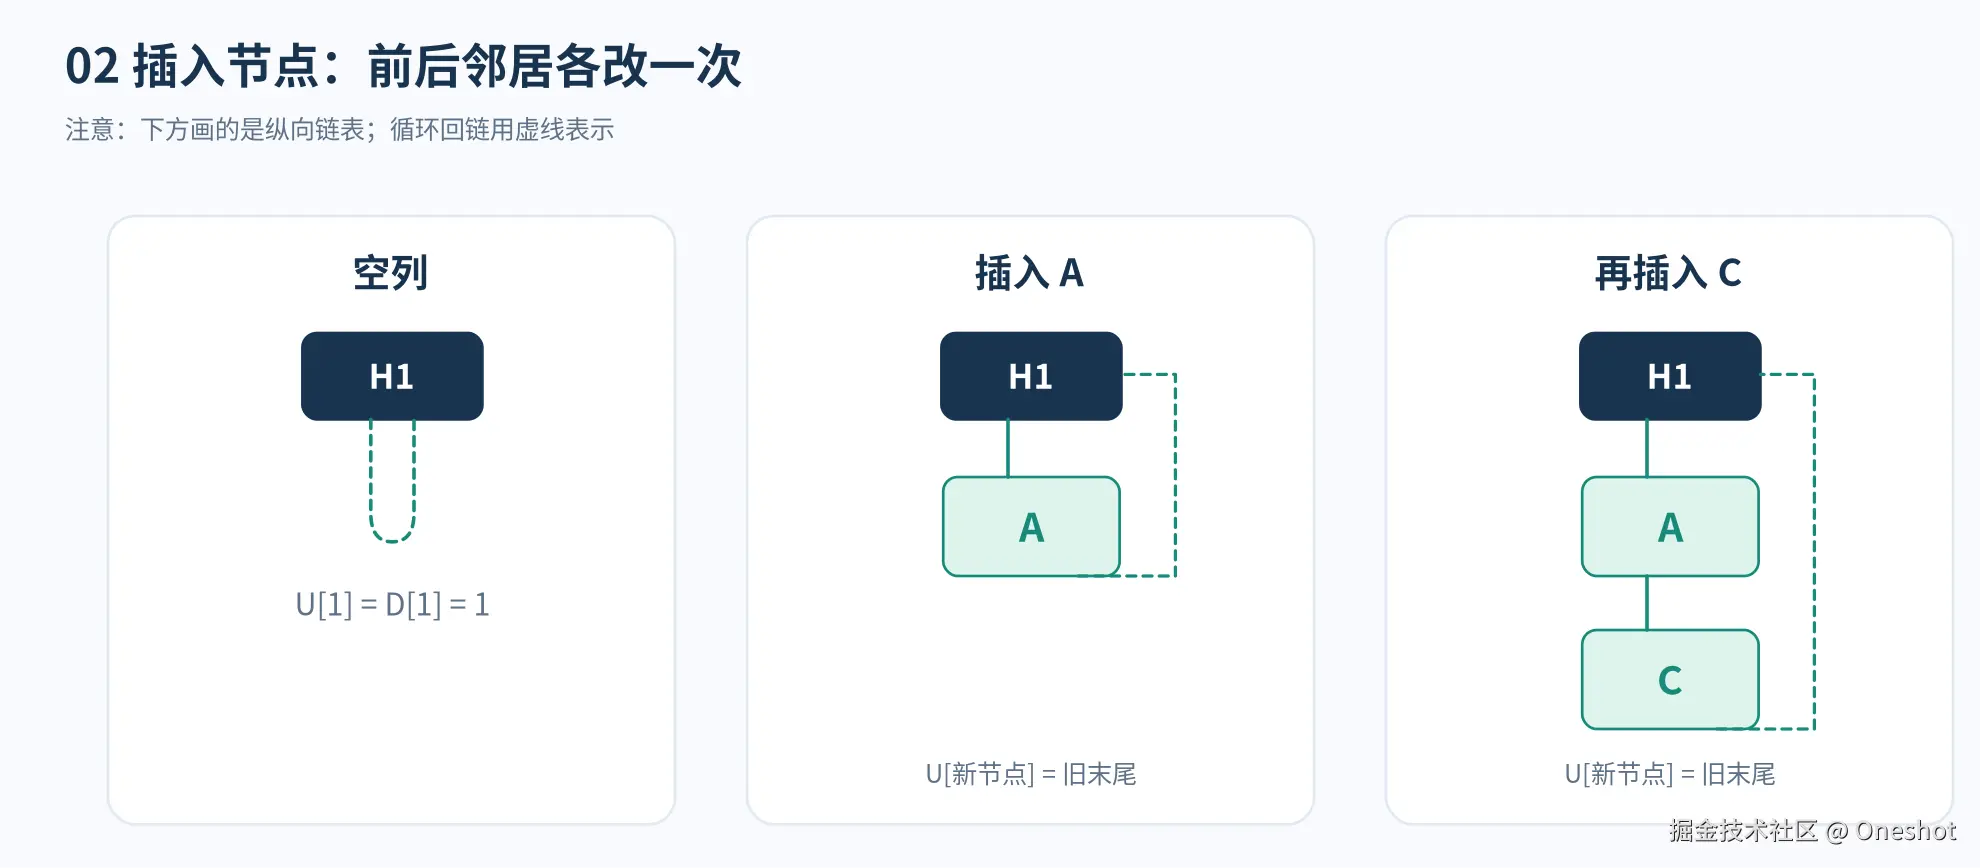
3×3 矩阵的完整插入过程
把六次插入逐一展开,比直接看完整代码更容易核对指针:
| 次序 | 插入位置 | 节点编号 | 纵向变化 | 横向变化 |
|---|---|---|---|---|
| 1 | A=(R1,C1) | 4 | H1 ↔ A ↔ H1 |
A ↔ A,first[1]=4 |
| 2 | B=(R1,C3) | 5 | H3 ↔ B ↔ H3 |
A ↔ B ↔ A |
| 3 | C=(R2,C1) | 6 | H1 ↔ A ↔ C ↔ H1 |
C ↔ C,first[2]=6 |
| 4 | D=(R2,C2) | 7 | H2 ↔ D ↔ H2 |
C ↔ D ↔ C |
| 5 | E=(R3,C2) | 8 | H2 ↔ D ↔ E ↔ H2 |
E ↔ E,first[3]=8 |
| 6 | F=(R3,C3) | 9 | H3 ↔ B ↔ F ↔ H3 |
E ↔ F ↔ E |
六次插入的指针变化如下。表中的 p 为新节点编号;列头和旧节点指针的修改同样列出。row[p]、col[p] 每次都设为对应的原矩阵坐标。
| 插入节点 | 纵向新增和修改 | 横向新增和修改 | 辅助数组 |
|---|---|---|---|
| A(4) | U[4]=1, D[4]=1, D[1]=4, U[1]=4 |
L[4]=4, R[4]=4 |
first[1]=4, sz[1]=1 |
| B(5) | U[5]=3, D[5]=3, D[3]=5, U[3]=5 |
L[5]=4, R[5]=4, R[4]=5, L[4]=5 |
sz[3]=1 |
| C(6) | U[6]=4, D[6]=1, D[4]=6, U[1]=6 |
L[6]=6, R[6]=6 |
first[2]=6, sz[1]=2 |
| D(7) | U[7]=2, D[7]=2, D[2]=7, U[2]=7 |
L[7]=6, R[7]=6, R[6]=7, L[6]=7 |
sz[2]=1 |
| E(8) | U[8]=7, D[8]=2, D[7]=8, U[2]=8 |
L[8]=8, R[8]=8 |
first[3]=8, sz[2]=2 |
| F(9) | U[9]=5, D[9]=3, D[5]=9, U[3]=9 |
L[9]=8, R[9]=8, R[8]=9, L[8]=9 |
sz[3]=2 |
例如插入 C 时,U[6]=4、D[6]=1 是新节点的邻接记录;D[4]=6、U[1]=6 则是更新 A 和 H1 的旧链接。只有双方的指针都修改完,纵向双向循环链表才完整。
全部插入完成后的方向数组如下。它可以作为调试 insert() 的直接对照表:
| 节点编号 | 节点 | L | R | U | D | row | col |
|---|---|---|---|---|---|---|---|
| 0 | root | 3 | 1 | 0 | 0 | --- | --- |
| 1 | H1 | 0 | 2 | 6 | 4 | --- | 1 |
| 2 | H2 | 1 | 3 | 8 | 7 | --- | 2 |
| 3 | H3 | 2 | 0 | 9 | 5 | --- | 3 |
| 4 | A | 5 | 5 | 1 | 6 | 1 | 1 |
| 5 | B | 4 | 4 | 3 | 9 | 1 | 3 |
| 6 | C | 7 | 7 | 4 | 1 | 2 | 1 |
| 7 | D | 6 | 6 | 2 | 8 | 2 | 2 |
| 8 | E | 9 | 9 | 7 | 2 | 3 | 2 |
| 9 | F | 8 | 8 | 5 | 3 | 3 | 3 |
辅助数组此时为 first[1..3] = {4,6,8},sz[1..3] = {2,2,2}。其中 sz[c] 统计的是该列当前活动数据节点数量,列头不计入。
五、删除与恢复
单个节点的摘除和恢复
假设纵向循环链表的局部顺序是 A ↔ B ↔ C。删除 B 的操作只有:
cpp
D[U[B]]=D[B];
U[D[B]]=U[B];
这两句修改的是 B 上下邻居的指针 ;B 自己的 U[B] 与 D[B] 保持旧值。于是活动链表中 A 直接连接 C,但 B 仍记得原来的位置。
cpp
// 按正确的回溯顺序恢复 B
D[U[B]]=B;
U[D[B]]=B;
该操作是 O(1) 的。恢复正确的前提是被摘除节点及相关邻居遵守 DLX 的逆序回溯 规则,不能随意改变恢复次序。横向摘除列头时使用的是对称的 L/R 修改。
cover(c):覆盖一列
cover(c) 的输入是列头编号,而不是某个普通数据节点编号。它完成两类修改:
- 把列头
c从root的横向活动列链表中摘除; - 遍历
c纵向链表中的每个数据节点i,将其所在行的**其他节点j**从各自的纵向活动链表中摘除。
cpp
void DLX::cover(int c)
{
    L[R[c]]=L[c];
    R[L[c]]=R[c];

    for(int i=D[c];i!=c;i=D[i])
        for(int j=R[i];j!=i;j=R[j])
        {
            U[D[j]]=U[j];
            D[U[j]]=D[j];
            sz[col[j]]--;
        }
}
cover(C1) 的实际执行过程
3×3 例子中的 C1 包含 A(R1)和 C(R2)。执行过程如下:
| 步骤 | 外层 i |
内层 j |
实际操作 |
|---|---|---|---|
| 先摘列头 | --- | --- | 让 root 的列头链表绕过 H1 |
| 第一次 | A(4) | B(5) | 将 B 从 C3 的纵向链表摘除,sz[3]-- |
| 第二次 | C(6) | D(7) | 将 D 从 C2 的纵向链表摘除,sz[2]-- |
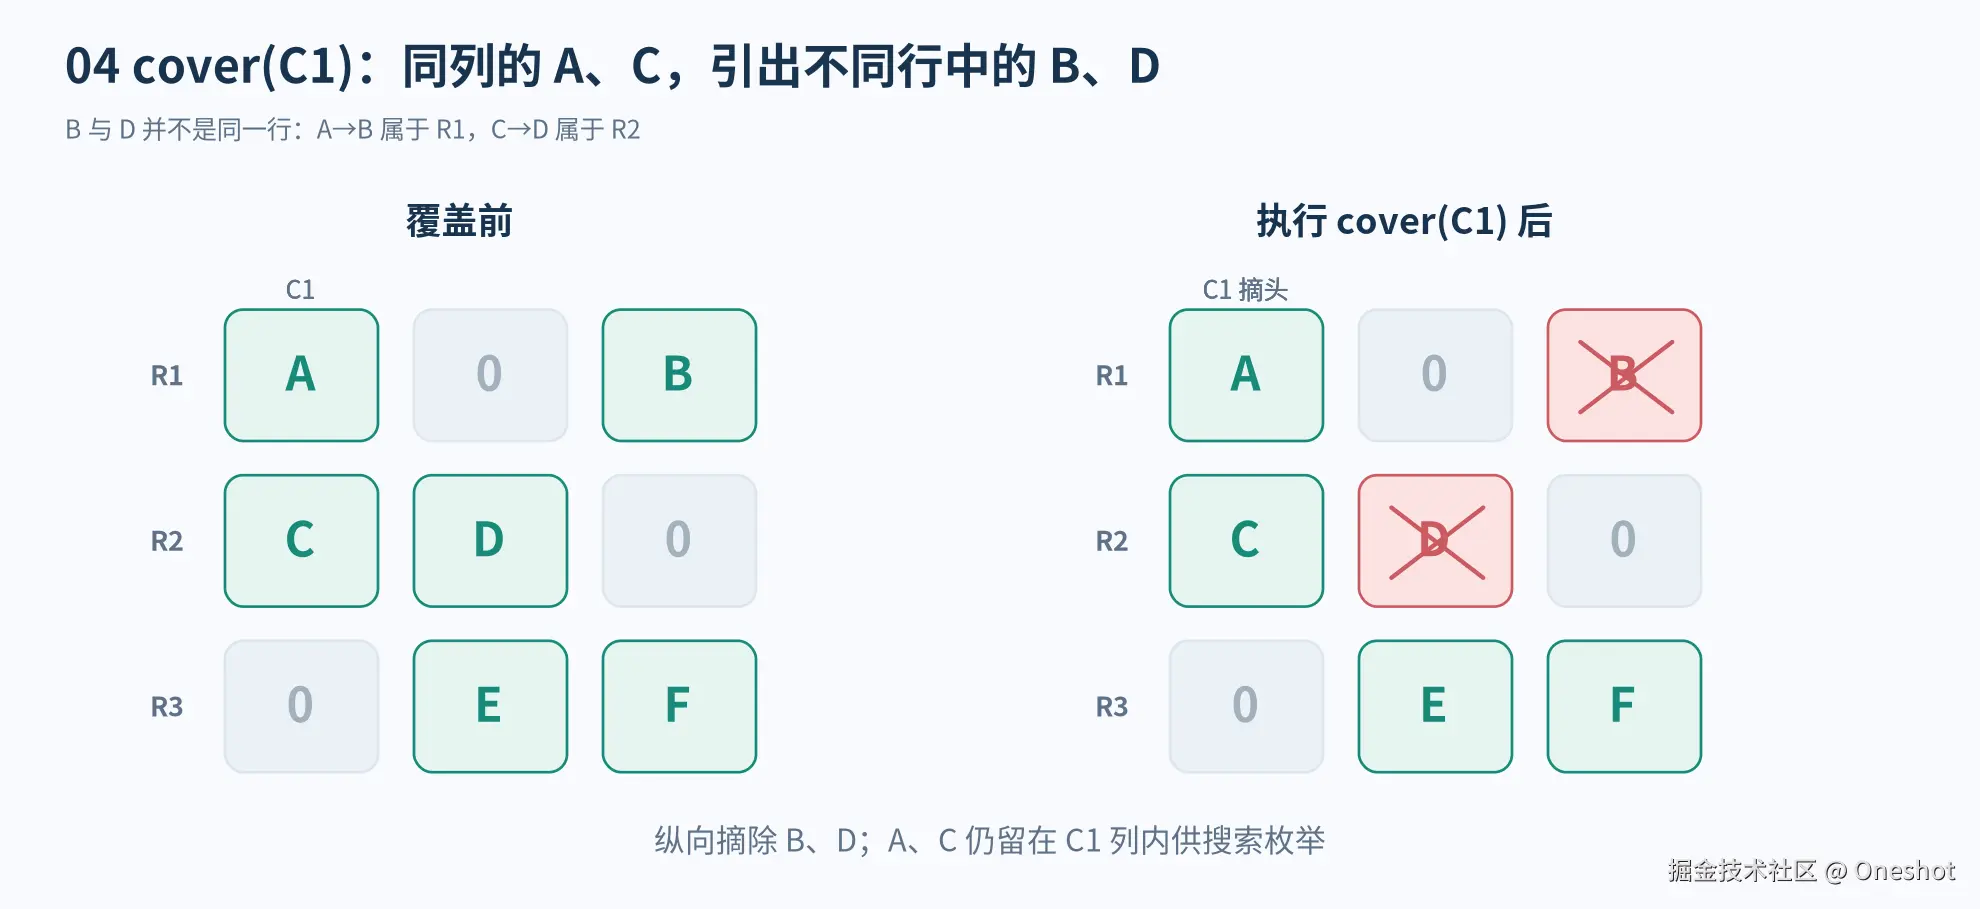
B 与 D 不是同一行 。它们分别通过 A → B 和 C → D 两条不同的横向链表被访问。之所以都被摘除,是因为 A、C 属于同一个需要处理的列 C1。
cover(C1) 完成后,活动列头只剩 H2、H3。纵向活动链表变为 H2 ↔ E ↔ H2、H3 ↔ F ↔ H3。而 H1 自己的纵向环仍为 H1 ↔ A ↔ C ↔ H1,用来在下一步枚举候选行。
因此,cover(c) 的作用是:它是在当前搜索层中维护可能的候选关系,既没有销毁整行节点,也没有直接决定选中哪一行。B、D 的横向指针同样保持不变,用于后续恢复。
节点编号与列编号
内层变量 j 是数据节点编号,例如 B 对应 j=5,但它所属的列是 col[5]=3。因此删除 B 时必须写:
cpp
sz[col[j]]--; // 正确:第 3 列的活动节点数减 1sz[j]-- 则是错误地把节点编号 5 当作列编号。类似地,选择行时也应该执行 cover(col[j]),而不是 cover(j)。
uncover(c):逆序恢复
覆盖操作按"先列头、后数据节点;向下、向右"的顺序进行。恢复时需要"先数据节点、后列头;向上、向左":
cpp
void DLX::uncover(int c)
{
    for(int i=U[c];i!=c;i=U[i])
        for(int j=L[i];j!=i;j=L[j])
        {
            U[D[j]]=j;
            D[U[j]]=j;
            sz[col[j]]++;
        }

    L[R[c]]=c;
    R[L[c]]=c;
}
以 cover(C1) 为例,被摘除的数据节点先后是 B、D,因此恢复应为 D → B → H1 列头 。对应 uncover(C1) 的遍历方向为 C→A(向上),每行沿左指针恢复。
uncover() 的标准写法把列头放在最后恢复。这与 cover() 的顺序完全对应,方便检查回溯不变量。节点本身的旧指针未被清空,因此不需要重新查找插入位置。
六、搜索过程
链表的插入、删除和恢复确定后,即可实现 Algorithm X 的递归搜索。
选列与选行
在四列示例中,若当前选择 C1,候选行只有 R1 和 R3。两个候选行分别表示:
- 选择 R1,覆盖
{C1,C2}; - 选择 R3,覆盖
{C1,C3}。
无论进入哪个分支,C1 都需要被处理;而 C2、C3 则取决于实际选择了哪一行。因此标准 DLX 将 cover(c) 放在候选行循环外。
cpp
int c=R[0];
cover(c);                     // 当前搜索层的公共操作

for(int i=D[c];i!=c;i=D[i])
{
    ans[dep]=row[i];          // 尝试选择 i 对应的原矩阵行

    for(int j=R[i];j!=i;j=R[j])
        cover(col[j]);       // 该行涉及的其他列

    dance(dep+1);

    for(int j=L[i];j!=i;j=L[j])
        uncover(col[j]);     // 与 cover 顺序相反
}

uncover(c);
cover(c) 的执行位置
从数学上讲,精确覆盖的决定是选择候选行 。仅仅执行 cover(c) 并不能证明已经有行满足 C1;这一点需要区分"搜索结构中的列头摘除"和"搜索分支选定一行"。
标准实现中:
cover(c)暂时摘除当前列头,并处理该列关联的候选行在其他列中的节点;for (i=D[c]; i!=c; i=D[i])从当前列的候选节点中选择一行;- 覆盖这行包含的其余列后,才调用下一层
dance(dep+1); - 回溯时恢复其余列,枚举下一个
i;所有候选行都试完后再恢复c。
如果列 c 没有任何候选节点,循环根本不会执行,也就不会进入下一层并误判成功。可以提前用 sz[c]==0 直接返回失败。
一个更小的反例是单元素矩阵 [1]:如果省略 cover(c),只覆盖被选中行的"其他列",该行没有其他列,递归前活动列头链表没有变化;下一层会再次处理同一个 C1,反复递归。每一次实际选行,都必须把该行的全部约束从待处理列集合中移除 ,其中就包括当前列 c。
当然,也可以在枚举每个候选行时才执行 cover(c),再覆盖该行的其他列;只要严格恢复,也能实现相同的搜索。标准写法将各分支共用的 cover(c) 提取到循环外,减少重复操作,并保持当前候选列的遍历入口稳定。
为何还能遍历当前列
因为覆盖列头时只修改它的横向 L/R 关系 ,并没有删除这个列头或它的纵向节点。D[c] 仍指向该列第一个候选数据节点。于是:
cpp
cover(c);
for(int i=D[c];i!=c;i=D[i])
{
    // 此处仍可逐个枚举 c 列的候选行
}
所需的入口始终存在,直到当前搜索层结束并执行 uncover(c)。
3×3 矩阵上的搜索过程
前面的 3×3 矩阵没有精确覆盖解,因为任意两个不同行的集合都存在重叠列,而只选择一行又不能覆盖全部 3 列。DLX 的搜索过程可以直接显示这一点。
先选 C1 :执行 cover(C1) 后,H1 保留 A、C 作为候选,H2 中只剩 E,H3 中只剩 F。接下来有两条分支:
| 分支 | 选中的原矩阵行 | 本层继续执行 | 结果 |
|---|---|---|---|
| 先试 A | R1 = {C1,C3} |
cover(C3) 时,F 所在行的 E 从 C2 中摘除 |
sz[C2]=0,失败并回溯 |
| 再试 C | R2 = {C1,C2} |
cover(C2) 时,E 所在行的 F 从 C3 中摘除 |
sz[C3]=0,失败并回溯 |
在第一条分支里,cover(C3) 会让 C2 变为空活动列;第二条分支则对称地让 C3 变为空活动列。因此两条分支都不可能继续选出合法行。恢复 C1 后,当前层所有候选行已被枚举,dance(0) 返回 false。
可以看到 cover(c) 与"选中一行"的区别:虽然在枚举之前先摘除了 C1 的列头,但实际的搜索分支仍分别由 A 和 C 两个节点决定。
sz[] 与最少候选列优化
sz[c] 是第 c 列在当前活动纵向链表中的数据节点数。初始化时为 0,insert(r,c) 使 sz[c]++;cover() 摘除某节点 j 时使 sz[col[j]]--,uncover() 再加回来。
3×3 例子中,初始 sz={2,2,2}(只列出 C1~C3)。执行 cover(C1) 后,H1 已不在活动列头链表中;H2、H3 则分别失去 D、B,活动节点数变为 1、1。sz[1] 仍然等于 2,因为 H1 的纵向节点 A、C 没有被摘除。
sz[] 最常见的用途是优先选取候选行数最少的活动列,即最少剩余值(MRV)策略:
cpp
int c=R[0];
for(int i=R[0];i!=0;i=R[i])
    if(sz[i]<sz[c])c=i;

if(sz[c]==0)return false;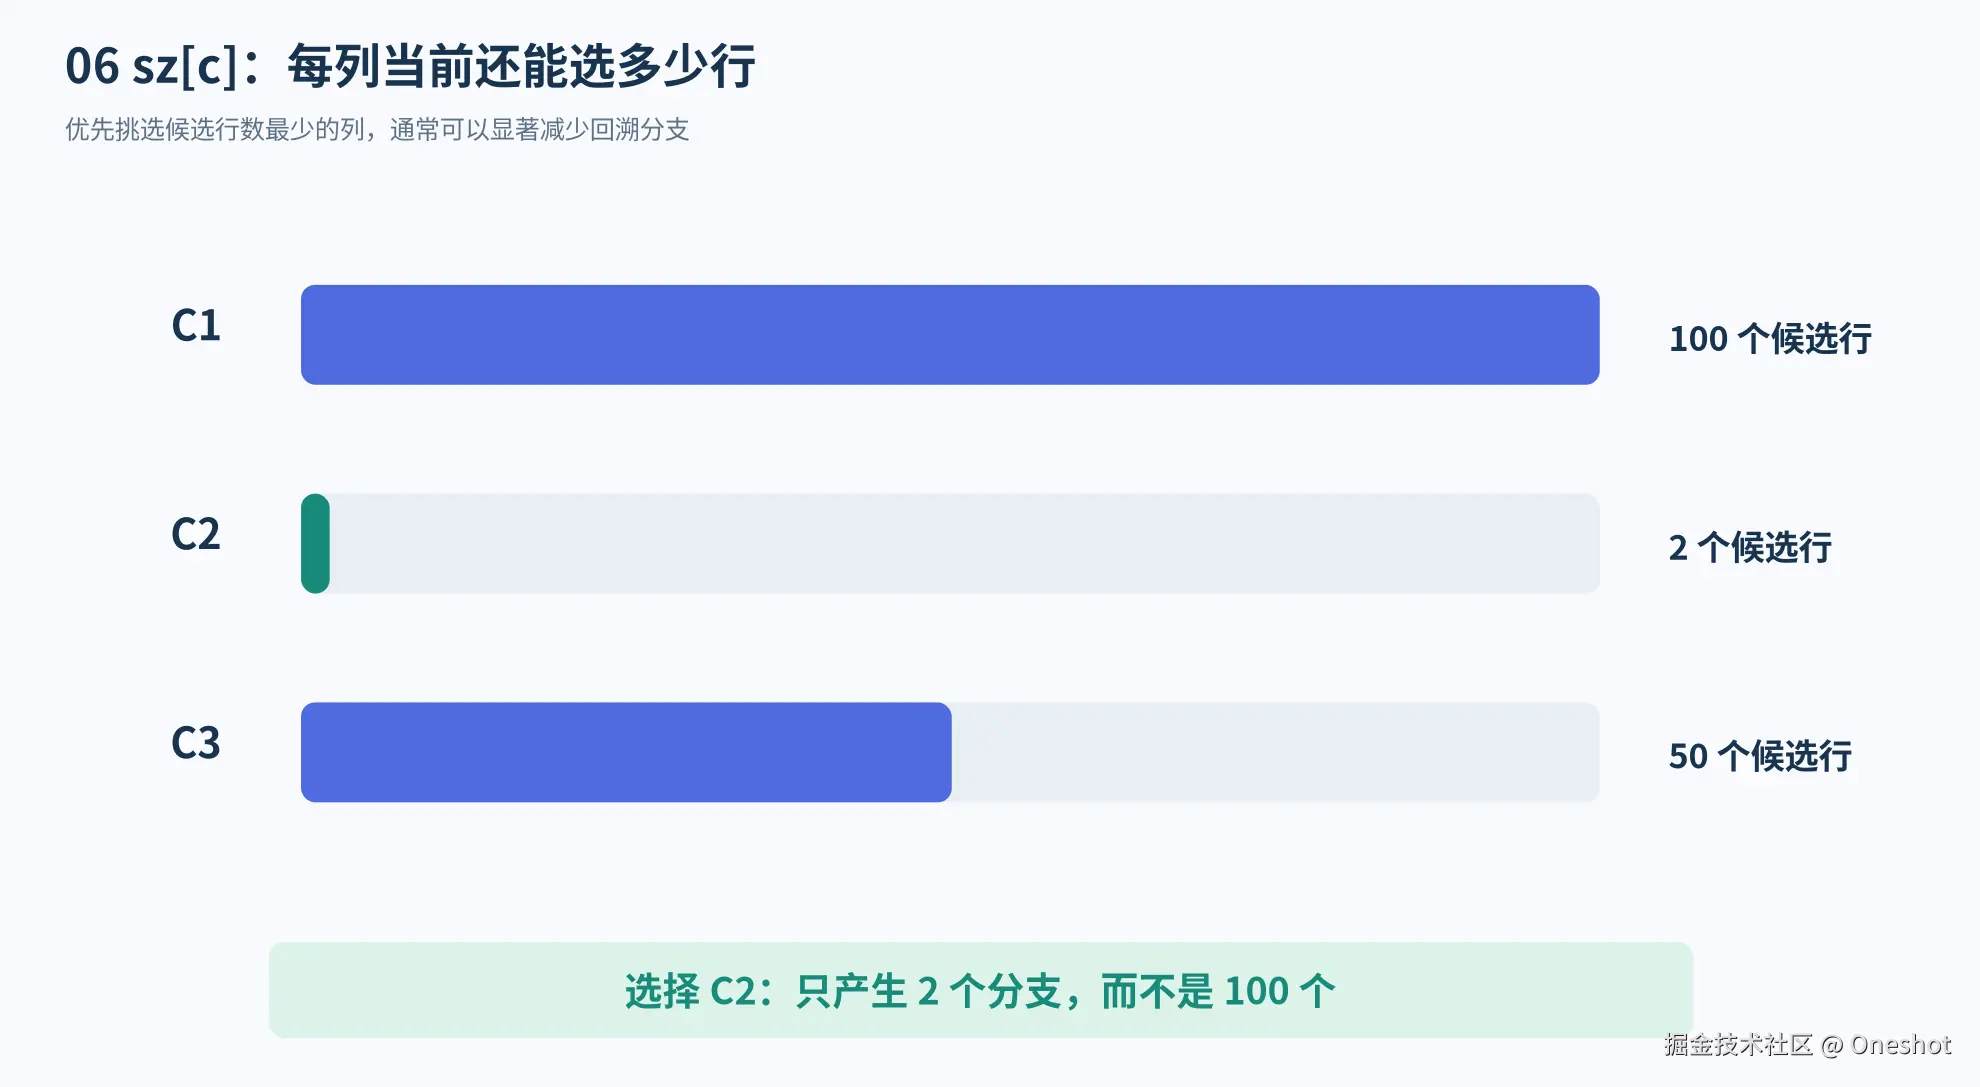
例如三个待处理列的候选行数分别是 100、2、50。选第二列只需枚举两个分支,往往能更早发现冲突。这是一种搜索顺序启发式 ,不影响解的正确性,也不能保证多项式时间。若 sz[c]==0,说明尚未处理的约束已经没有可选行,当前分支无解,可立即回溯。
ans[] 与递归返回
ans[dep] 保存第 dep 层选择的原矩阵行号:
cpp
ans[dep]=row[i];这里 i 是 DLX 内部的数据节点编号,row[i] 才是对应的候选方案行号。成功时,ans[0..dep-1] 就是选出的方案。若只判断解是否存在,可以省略 row[]、ans[],直接返回布尔值。
注意 ans[] 不需要每次回溯都清零:更浅层的值是当前路径,回到同一深度后下一条分支会覆盖 ans[dep],只有成功时记录的深度范围才有效。
仅求第一组解 时,dance() 可以返回 bool,在下一层返回成功时提前结束。若后续仍要使用同一个 DLX 对象,应先执行相应的 uncover(),再返回成功;如果找到解后程序立即终止,也可以直接返回,但那时链表尚未完全恢复。
七、完整代码
以下实现使用数组模拟链表,原矩阵行列编号从 1 开始;root=0。输入 n m 和 n×m 个 0/1,输出第一组精确覆盖所选行号;若不存在则输出 No Solution!。
代码将 DLX 对象定义在全局作用域,避免包含多个大数组的局部结构体占用栈空间。输入时直接插入 1,因此不需要再保存完整的 a[][]。
cpp
#include <bits/stdc++.h>
using namespace std;

const int MAXRC = 505;
const int MAXNODE = 500002;
const char NS[] = "No Solution!";

int n, m;

struct DLX
{
    int tot;
    int U[MAXNODE], D[MAXNODE], R[MAXNODE], L[MAXNODE];
    int row[MAXNODE], col[MAXNODE];
    int first[MAXRC], sz[MAXRC];
    int ans[MAXRC];
    int ansCount;

    void init(int r, int c);
    void insert(int r, int c);
    void cover(int c);
    void uncover(int c);
    bool dance(int dep);
};

DLX dlx;

void DLX::init(int r, int c)
{
    tot = c;
    ansCount = 0;

    for (int i = 0; i <= r; i++)
        first[i] = 0;

    for (int i = 0; i <= c; i++)
    {
        L[i] = i - 1;
        R[i] = i + 1;
        U[i] = i;
        D[i] = i;
        col[i] = i;
        sz[i] = 0;
    }

    L[0] = c;
    R[c] = 0;
}

void DLX::insert(int r, int c)
{
    int p = ++tot;
    row[p] = r;
    col[p] = c;

    // 插到第 c 列的末尾
    int last = U[c];
    U[p] = last;
    D[p] = c;
    D[last] = p;
    U[c] = p;
    sz[c]++;

    // 插到第 r 行的末尾
    if (first[r] == 0)
    {
        first[r] = p;
        L[p] = p;
        R[p] = p;
    }
    else
    {
        int f = first[r];
        L[p] = L[f];
        R[p] = f;
        R[L[f]] = p;
        L[f] = p;
    }
}

void DLX::cover(int c)
{
    L[R[c]] = L[c];
    R[L[c]] = R[c];

    for (int i = D[c]; i != c; i = D[i])
    {
        for (int j = R[i]; j != i; j = R[j])
        {
            U[D[j]] = U[j];
            D[U[j]] = D[j];
            sz[col[j]]--;
        }
    }
}

void DLX::uncover(int c)
{
    for (int i = U[c]; i != c; i = U[i])
    {
        for (int j = L[i]; j != i; j = L[j])
        {
            U[D[j]] = j;
            D[U[j]] = j;
            sz[col[j]]++;
        }
    }

    L[R[c]] = c;
    R[L[c]] = c;
}

bool DLX::dance(int dep)
{
    // 所有必选约束列都已覆盖
    if (R[0] == 0)
    {
        ansCount = dep;
        return true;
    }

    int c = R[0];
    for (int i = R[0]; i != 0; i = R[i])
    {
        if (sz[i] < sz[c])
            c = i;
    }

    if (sz[c] == 0)
        return false;

    cover(c);

    for (int i = D[c]; i != c; i = D[i])
    {
        ans[dep] = row[i];

        for (int j = R[i]; j != i; j = R[j])
            cover(col[j]);

        bool found = dance(dep + 1);

        // 与覆盖顺序相反,保证返回时链表仍可复用
        for (int j = L[i]; j != i; j = L[j])
            uncover(col[j]);

        if (found)
        {
            uncover(c);
            return true;
        }
    }

    uncover(c);
    return false;
}

int main()
{
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    cin >> n >> m;
    dlx.init(n, m);

    // 行列编号从 1 开始,0 留给 root
    for (int r = 1; r <= n; r++)
    {
        for (int c = 1; c <= m; c++)
        {
            int x;
            cin >> x;
            if (x)
                dlx.insert(r, c);
        }
    }

    if (dlx.dance(0))
    {
        for (int i = 0; i < dlx.ansCount; i++)
        {
            if (i)
                cout << ' ';
            cout << dlx.ans[i];
        }
        cout << '\n';
    }
    else
    {
        cout << NS << '\n';
    }

    return 0;
}
例如输入:
text
4 4
1 1 0 0
0 0 1 1
1 0 1 0
0 1 0 1
按代码给定的选列、插入顺序,可输出:
text
1 2表示选中 R1、R2。如果换一种合法的列选择和行遍历顺序,也可能先找到 R3、R4。矩阵本身存在多组解,不意味着所有运行顺序都会先找到同一组。
八、建模例子
数独:324 个约束列
9×9 数独的候选方案用 (r,c,v) 表示:在第 r 行、第 c 列填数字 v。每个候选方案同时满足四类约束:
| 约束类型 | 数量 | 例如候选 (2,3,5) 对应 |
|---|---|---|
| 每个格子恰好填一次 | 81 | 格子 (2,3) 已填 |
| 每行每个数字恰好一次 | 81 | 第 2 行包含 5 |
| 每列每个数字恰好一次 | 81 | 第 3 列包含 5 |
| 每宫每个数字恰好一次 | 81 | 第 1 宫包含 5 |
共 81×4=324 个约束列。最多 9×9×9=729 个候选行,每行恰好有 4 个 1。列编号可以按下式映射(均为 1-based):
text
格子约束:      (r-1)*9+c
行数字约束:    81+(r-1)*9+v
列数字约束:   162+(c-1)*9+v
宫数字约束:   243+(b-1)*9+v

b=((r-1)/3)*3+(c-1)/3+1
已知数字只保留与该已知值一致的候选填写;未填格子可以枚举 v=1..9。这样数独的四类规则全部变成精确覆盖矩阵中的"恰好一次"。
棋盘拼块与矩形排样
若板材离散成单位格,且要求所有格子被完全覆盖、每个指定拼块恰好使用一次,可建立两类列:拼块使用列 与格子占用列。每个候选行表示某个拼块放在某个合法位置(必要时包含旋转),并把"使用该拼块"及"覆盖到的全部格子"设置为 1。
这类模型适合严格的完整铺放。若只要求格子最多被占用一次、不要求全部填满,就不是所有列都"恰好一次"的普通精确覆盖;可以使用主列/次列(primary/secondary columns)等扩展。当目标变为最大化利用率、允许部分拼块不用时,还需要额外的优化目标和搜索策略。较大尺寸按单位格展开还会带来较多候选行,不一定适合直接采用标准 DLX。
九、复杂度分析
对于一个有 m 列、k 个 1 的输入,DLX 的链表节点数为 m+k+1,主要链表存储为 O(m+k);若额外使用 first[] 与答案路径,还需按原矩阵行数准备辅助空间。相较于直接存储整个 n×m 矩阵,稀疏矩阵能节省大量空间。
cover 与 uncover 的工作量取决于访问的链表节点数;每一次节点摘除或恢复只需常数次指针修改。搜索树的规模仍可能是指数级,sz[] 只是常见的启发式优化,不改变精确覆盖问题在一般情形下的搜索难度。