Qwen4 也是铺垫了很久,传得相当神!
但是,拖了很久才发。发布之后,居然没免费品尝环节,这一点就输给 HY4 了!
阿里啊阿里,你还没企鹅大气啊。
就在我犹豫要不要充值的那一刻,我就刷到了几条消息!
第一条是这样的:
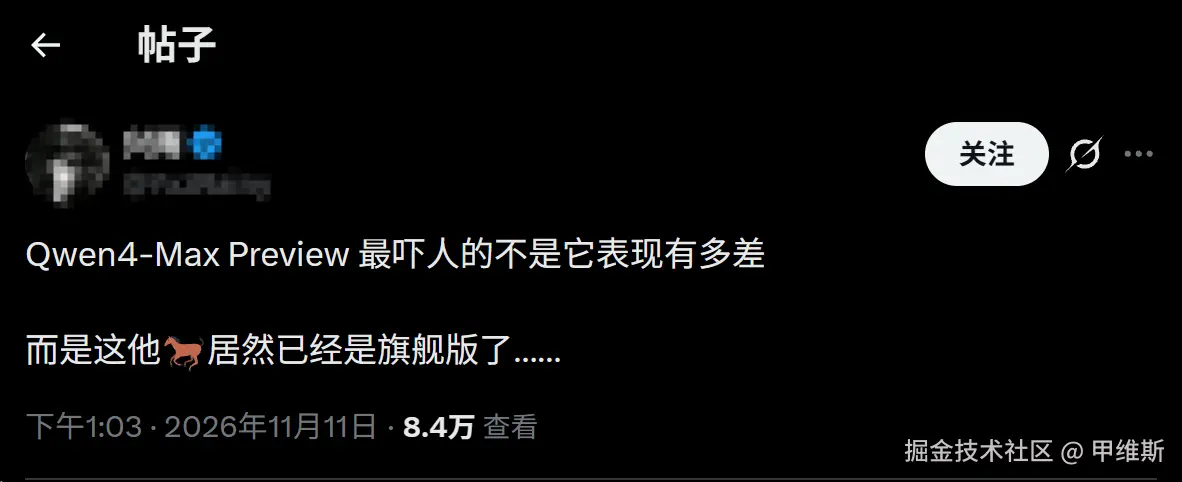
博主开玩笑地说:Qwen4 最吓人的不是它表现有多差,而是这居然已经是旗舰版了。这个推文的阅读已经 8 万了。
第二条是一个视频:
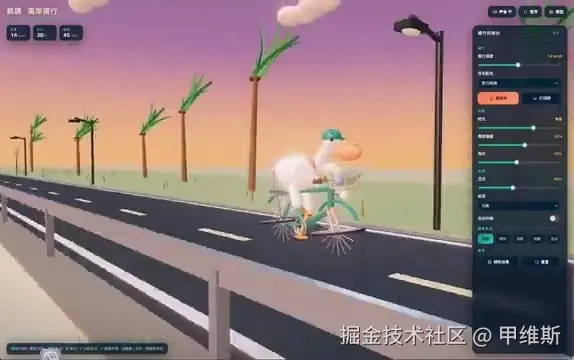
配文是:Qwen4 Max 成功解决了困扰世界的物理难题! 因为它这个轮子的走向非常神奇。
第三条,就是它们在 X 的"付费推广"信息!
推广好先进,已经推到国外去了。一边是企业付费推广,一边是 X 友的"嘲讽"。 这个节奏不对,平时都是他们负责吹牛逼,我负责来戳泡泡!
我本来都不打算冲了,他们这么一说,我立马就跑去充值了。 看我能不能来反向吹一波。
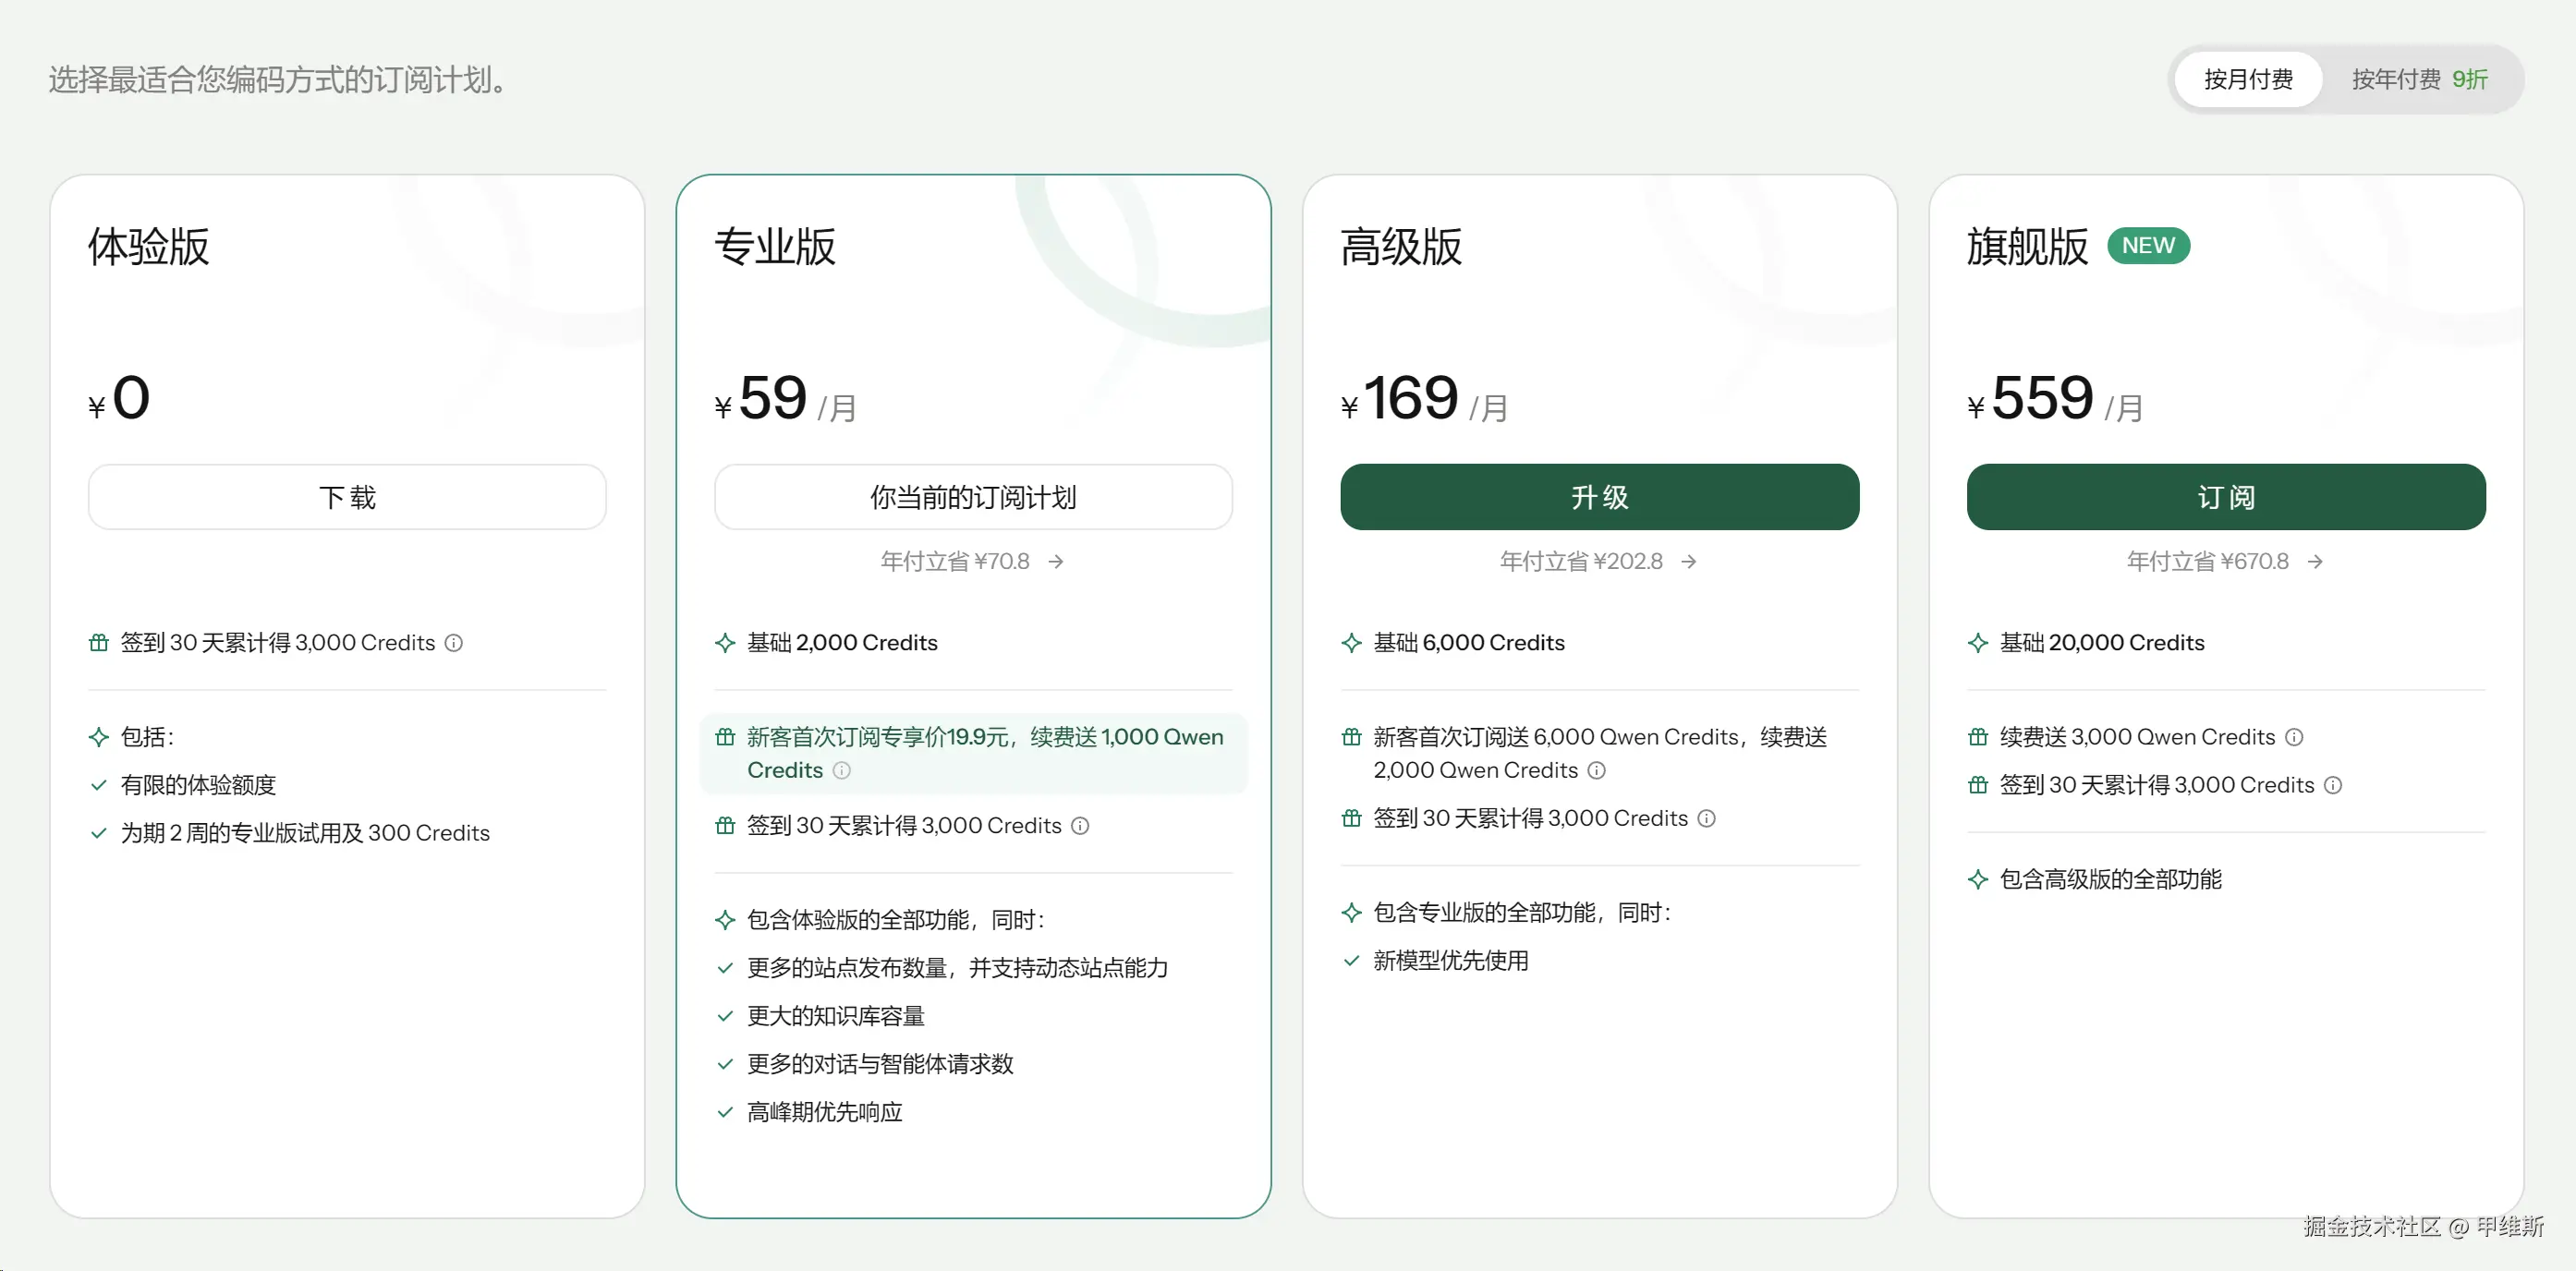
最低档专业版 10 美金不到,然后拿了个折扣。
花了半天时间,测试题目基本做完了。这次还让它做了两个大项目:绝地求生和荒野大镖客。
然后,我就准备开始写文章了。
我们的测试类文章,一般会先介绍一下这个模型的卖家秀,也就是官网给的基准信息和前期排名情况。
但是我找了半天发现还没任何相关的数据,只有一条即将发布的推文。
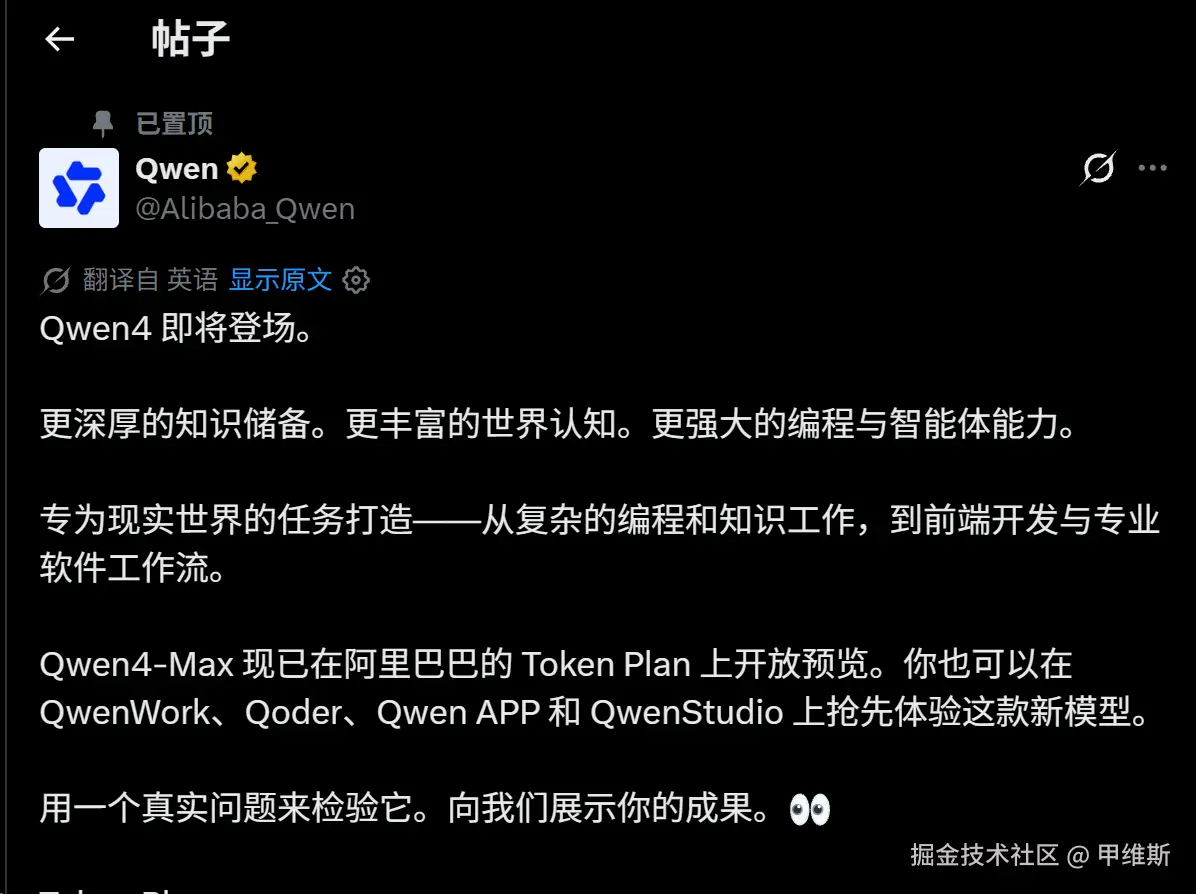
这是一个什么样的节奏啊?我特地等了一天,测试都跑完了,相关数据还没出来。
我还等着 Qwen 说它"国模第一,国际第二"呢! 它是直接不给我靶子,我都不好发射。
好吧,直接看结果吧!
首先来赛博朋克版清明上河图。 结果如下:
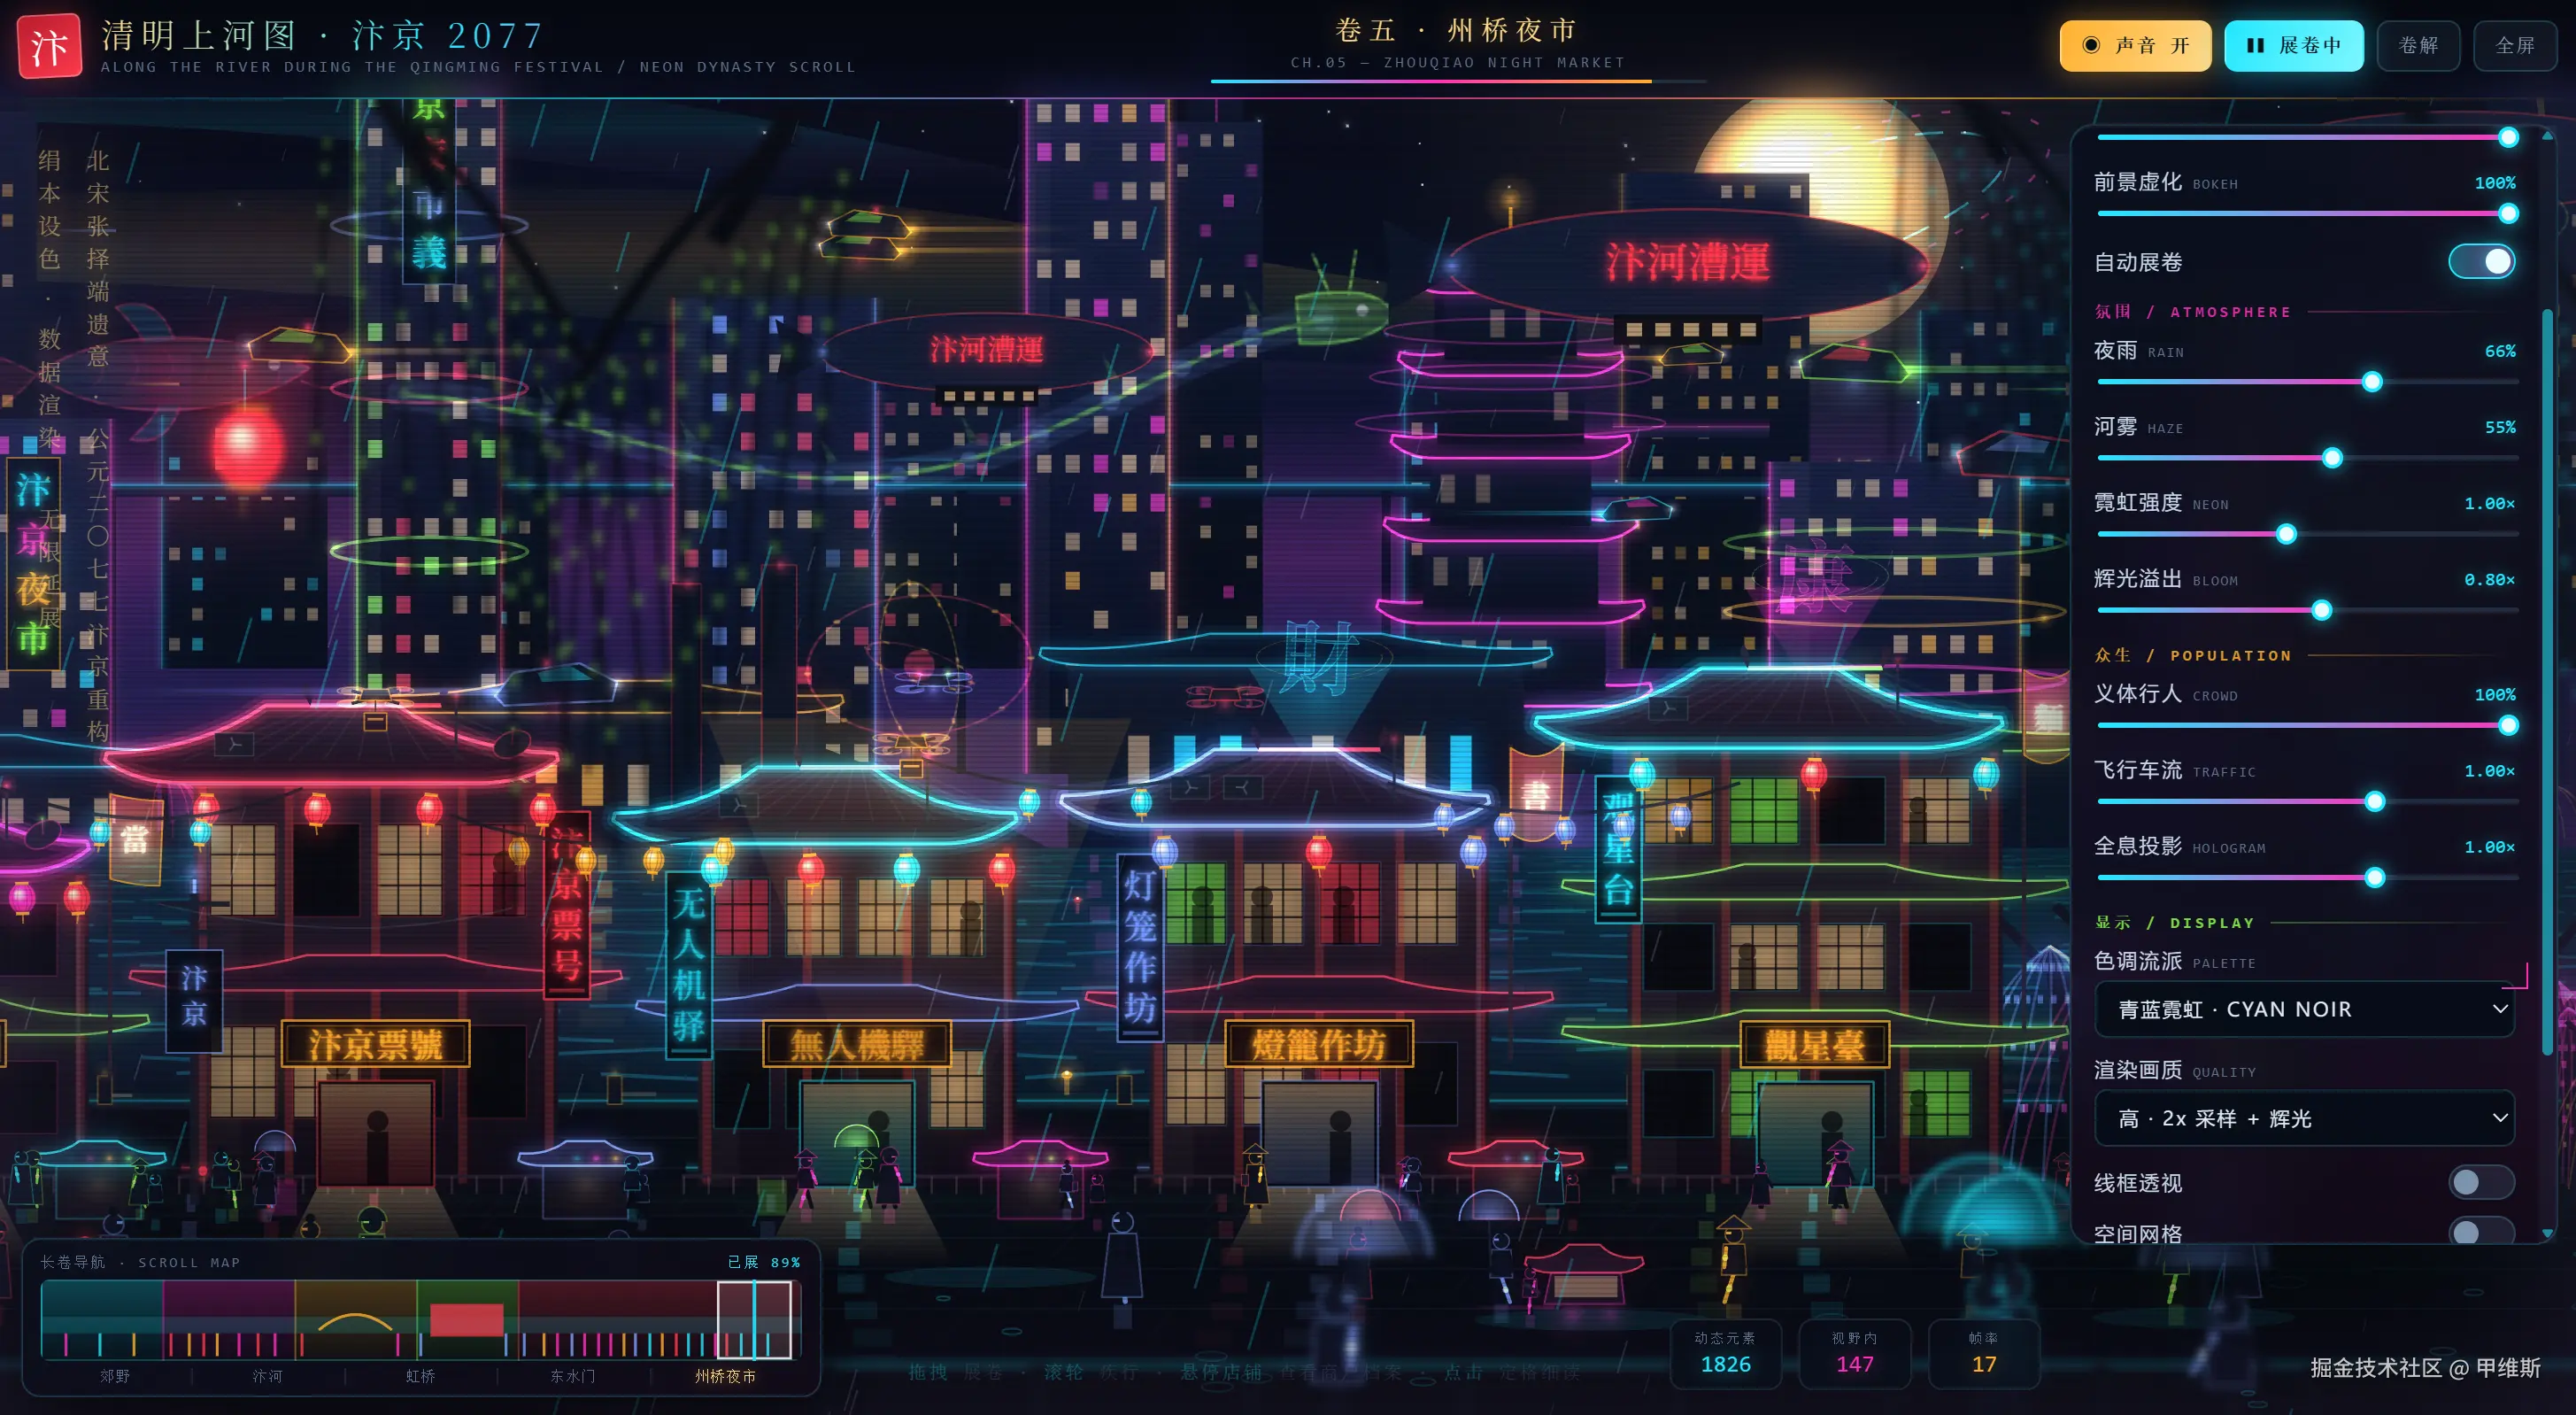
这个配色和形态其实还可以的啊。左下角搞了一个进度条,右侧还有一个控制面板,想得也挺周到的。
比较大的问题就是空间堆叠感还是比较重,元素多的部分很混乱。
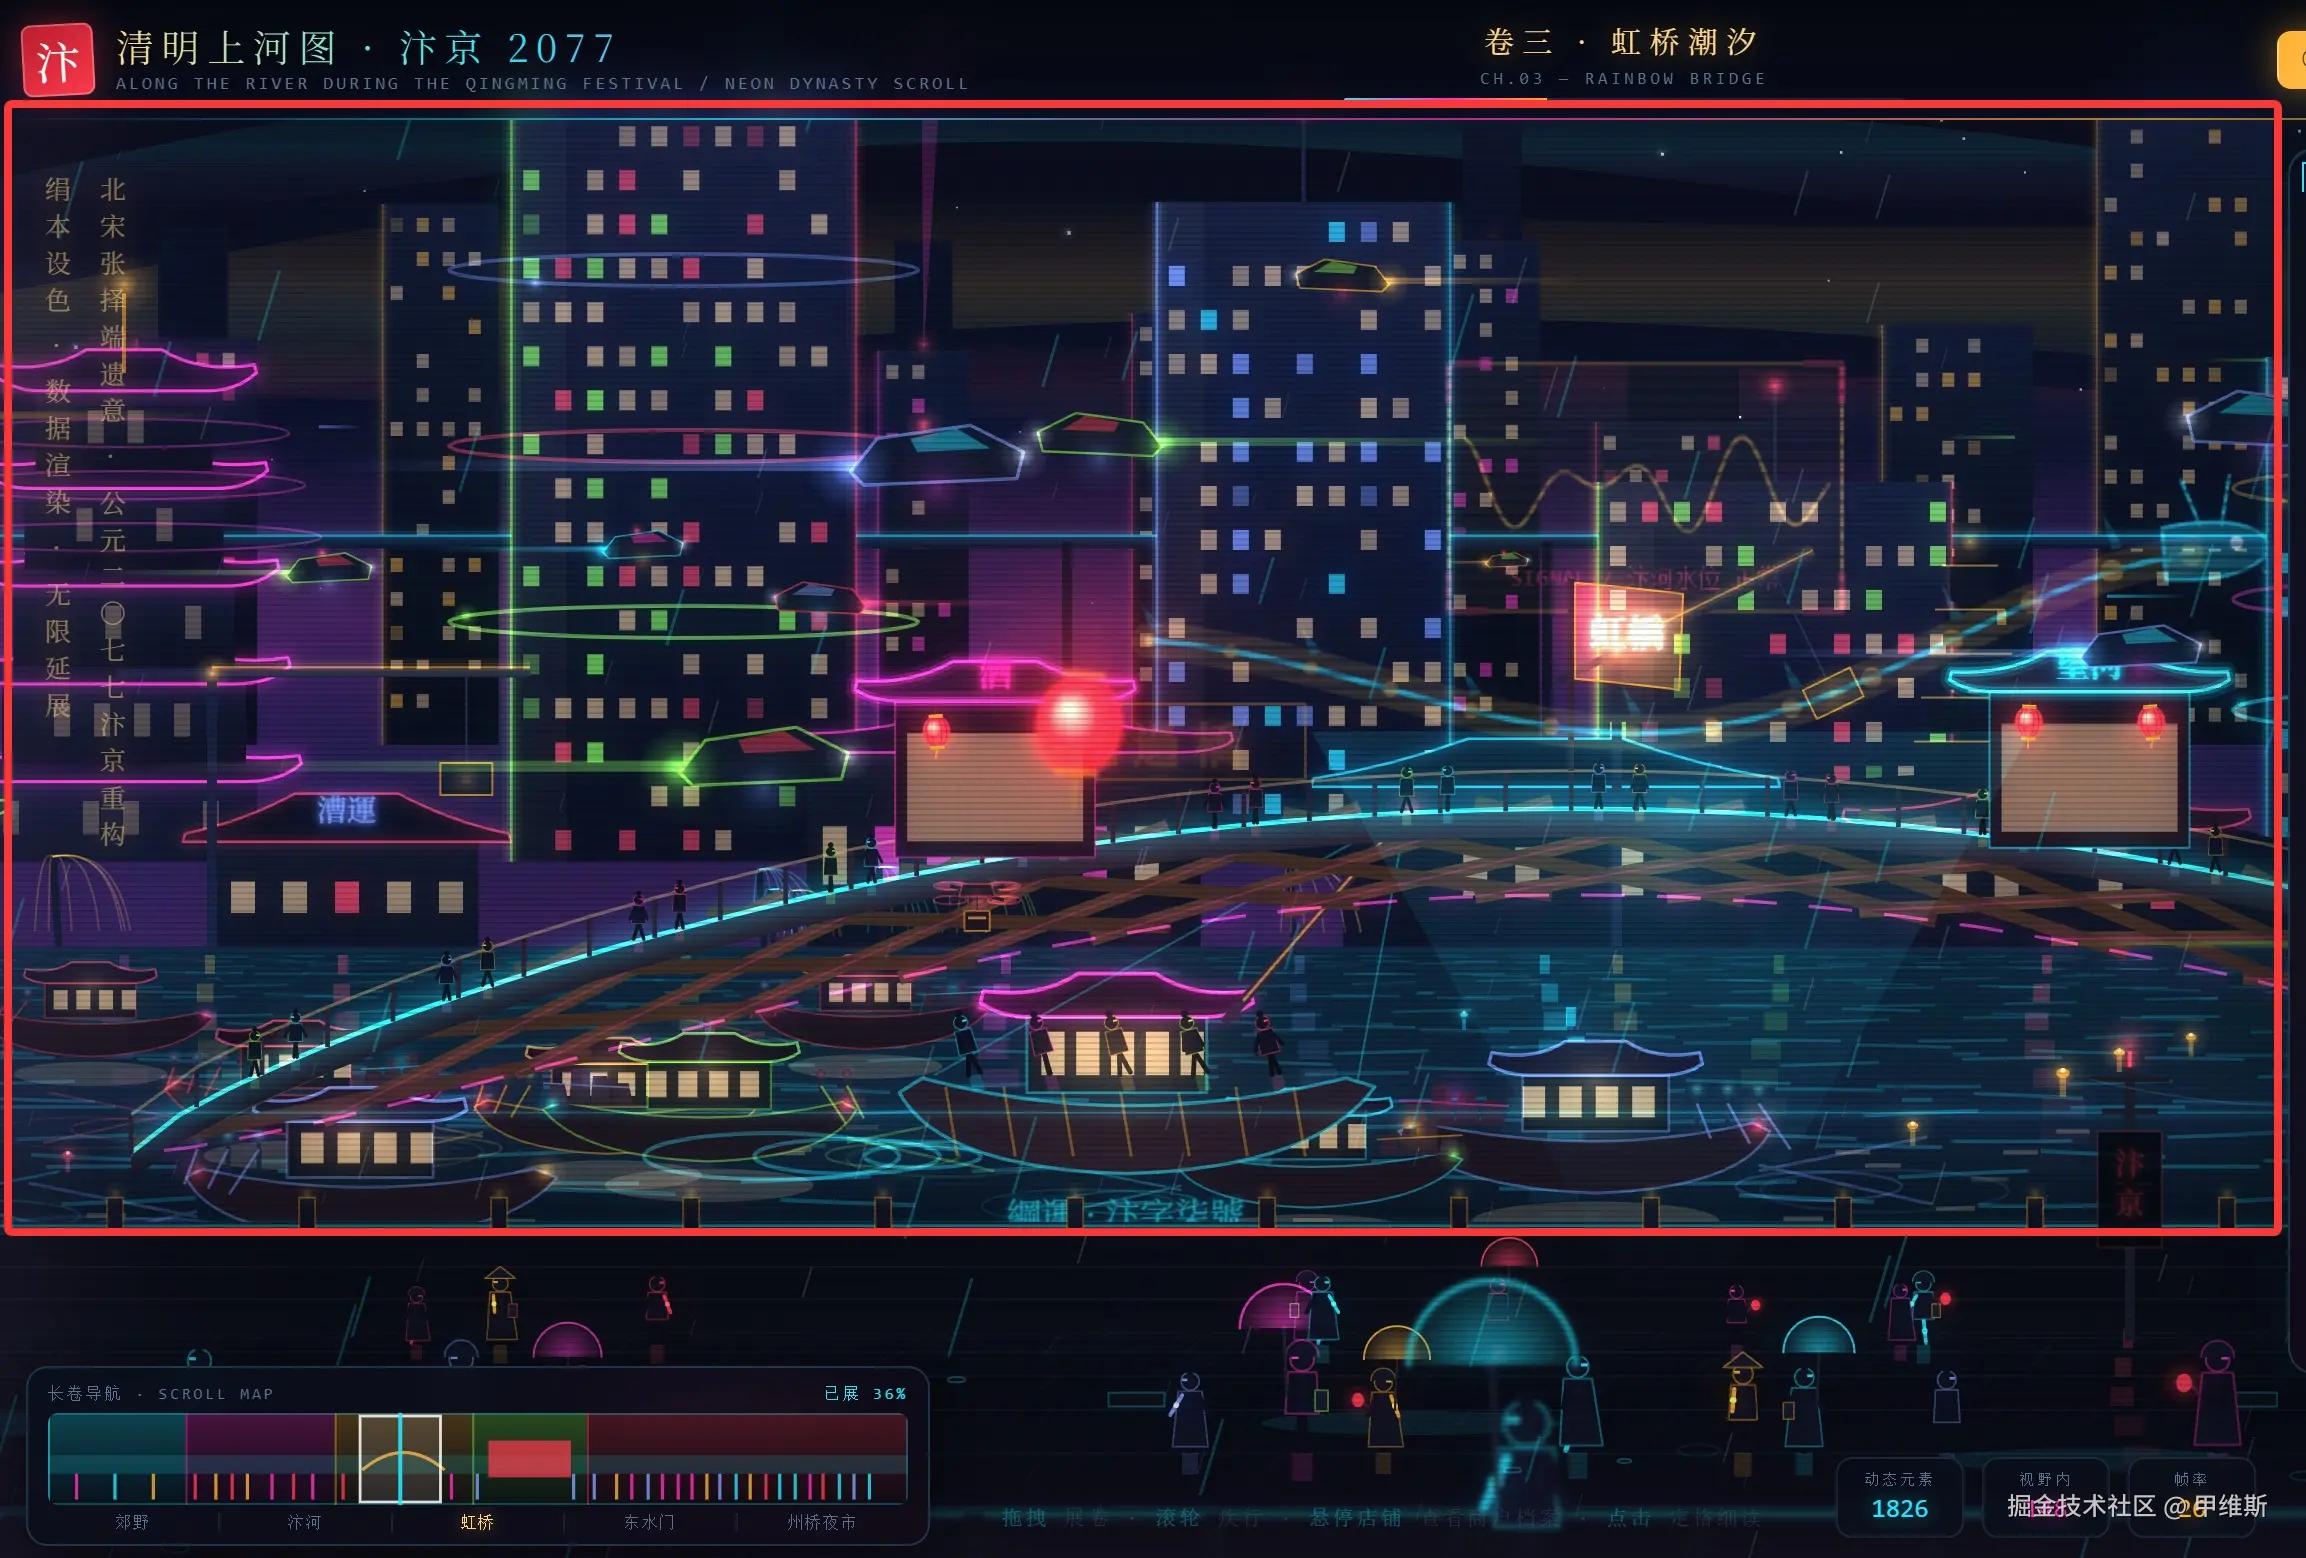
虹桥这一块,全都堆叠在一起了,桥的起点和终点都是悬空的。很多细节还是禁不起推敲。
最要命的是这个例子花了 1 小时 38 分钟,作为参考,HY4 只花了 20 分钟。 时间差这么多,效果并没有特别出众。
其实 DS3.1、Step5、HY4、Qwen4 它们这一批新模型在这个例子上都是有进步的。可以感受到它们的变化,已经从没法看,到能看了。但是这个题目上 Opus 和 Fable 很早就做得特别优秀了。
第二个例子:天文机械表。
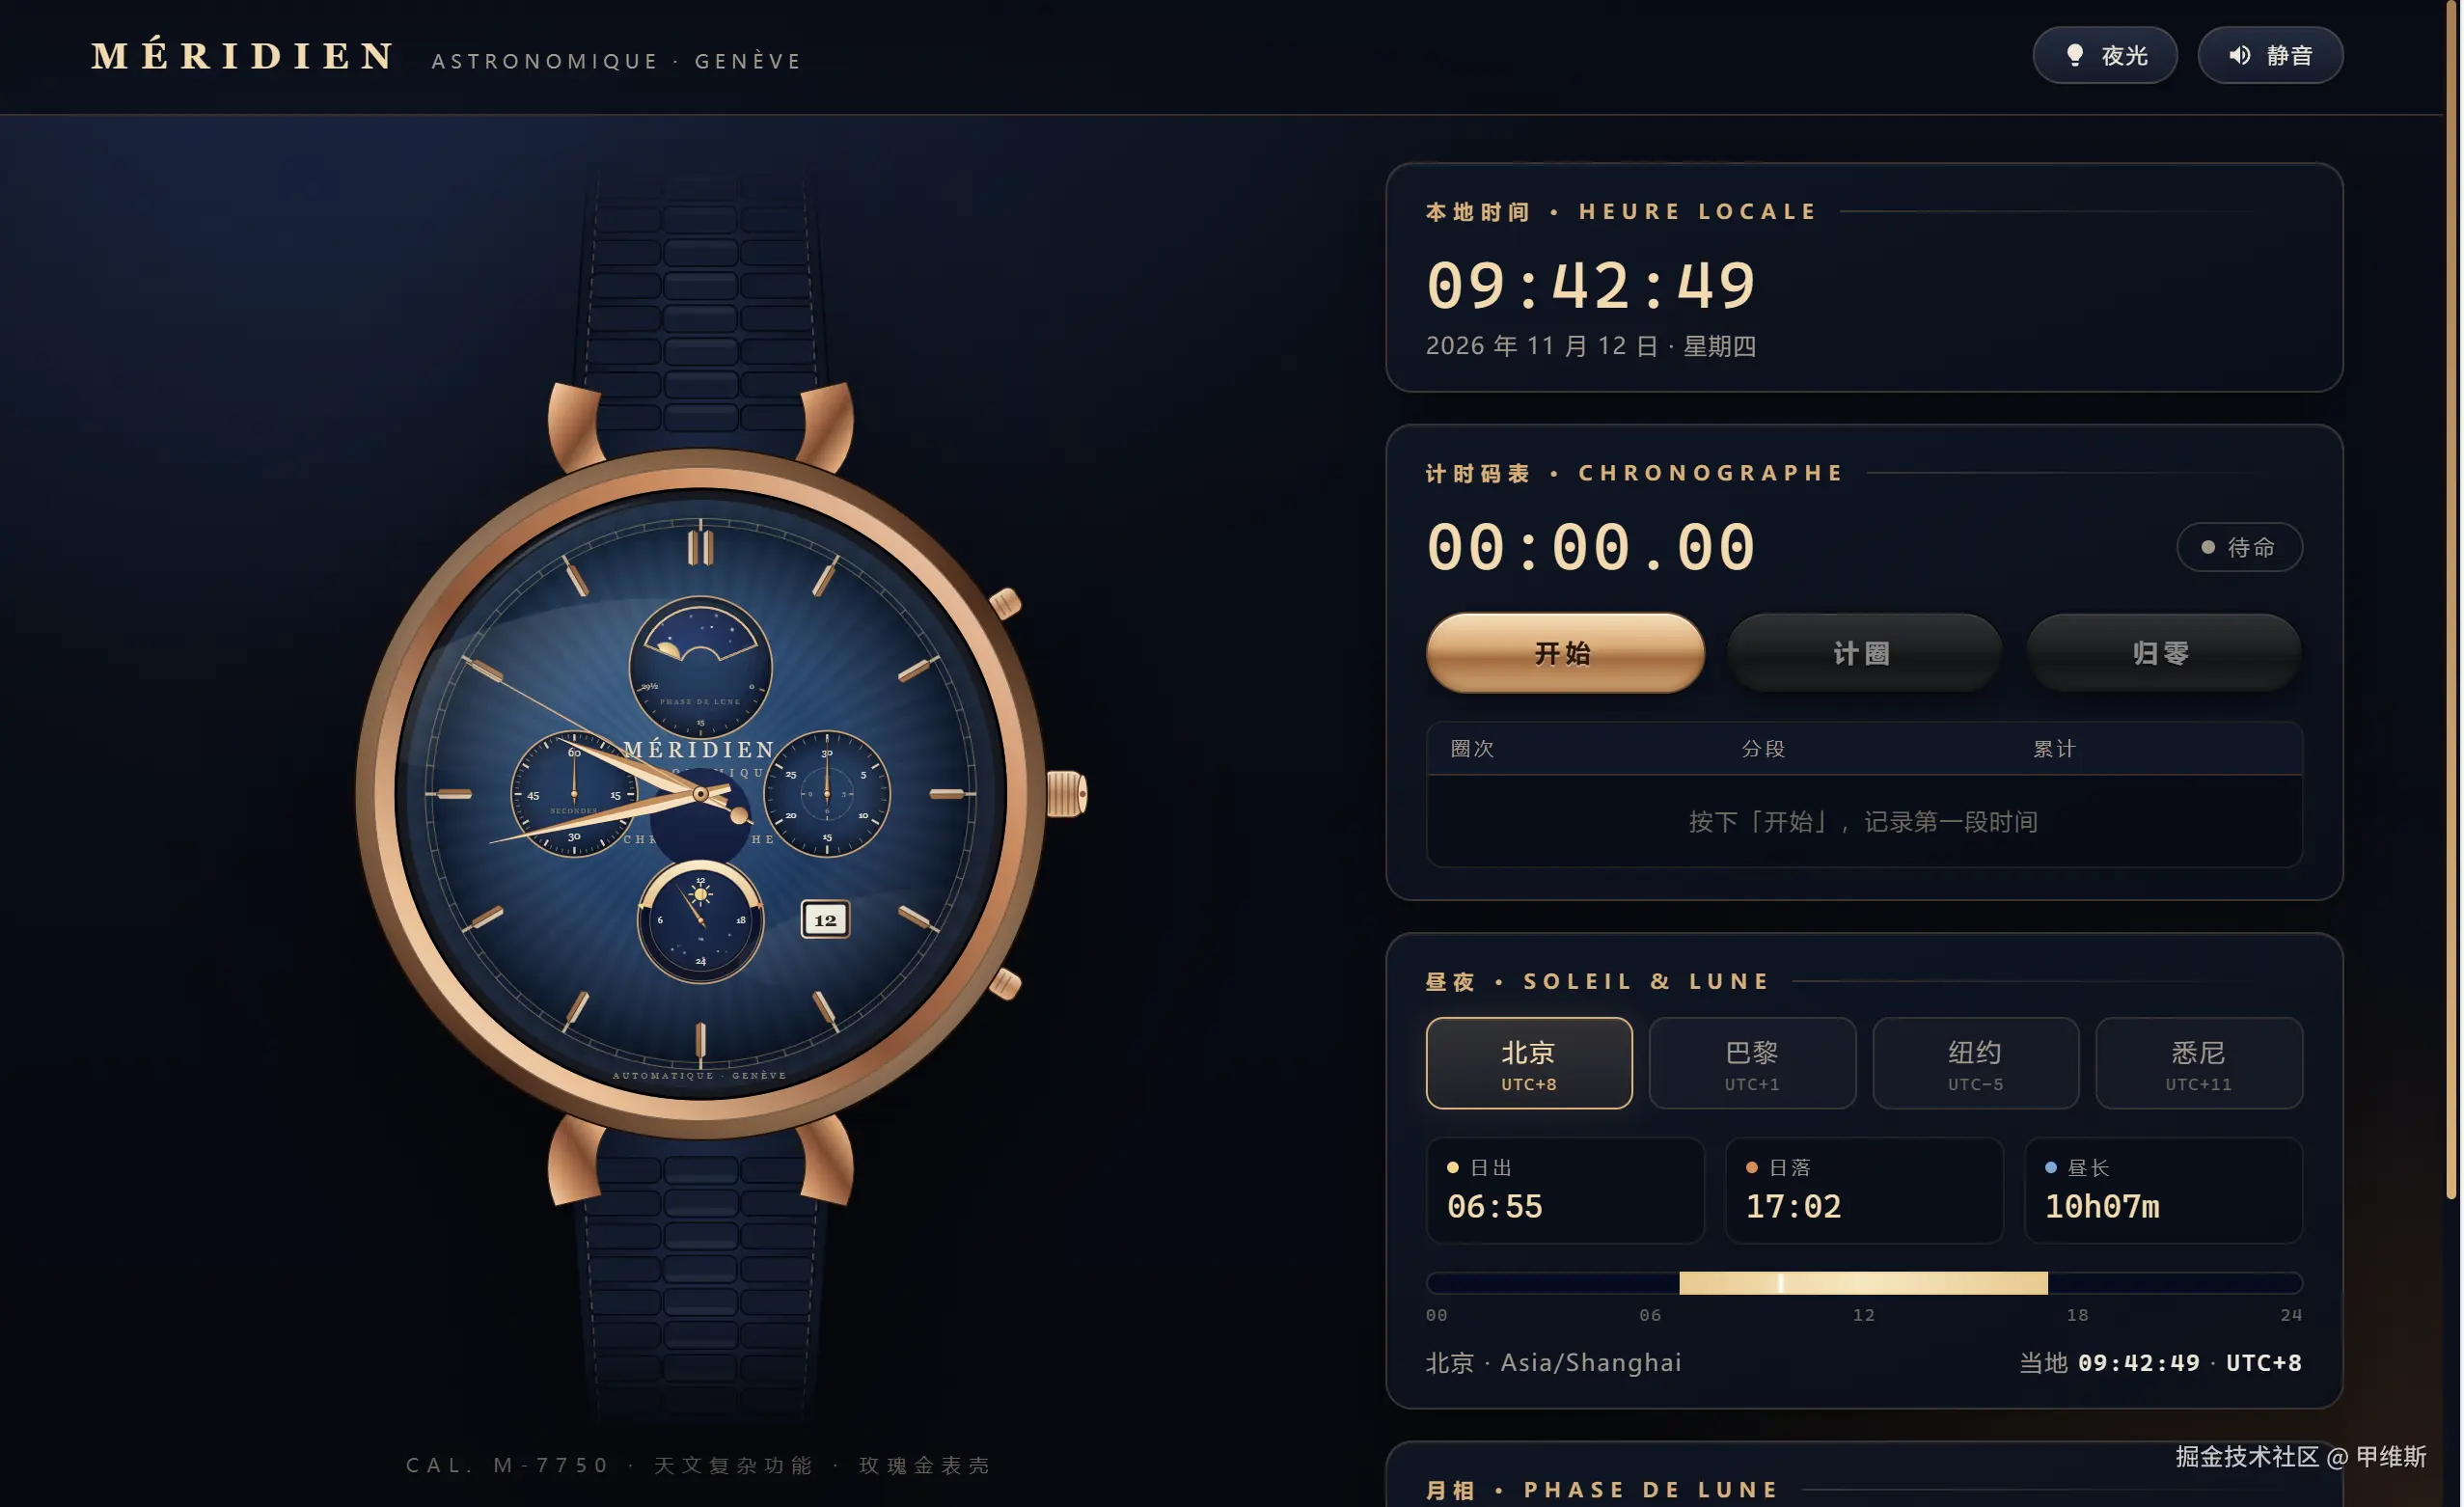
这个例子其实做得也不错,UI 上没有明显 bug,功能基本也正确。审美部分见仁见智吧。
下面放一个对比图:
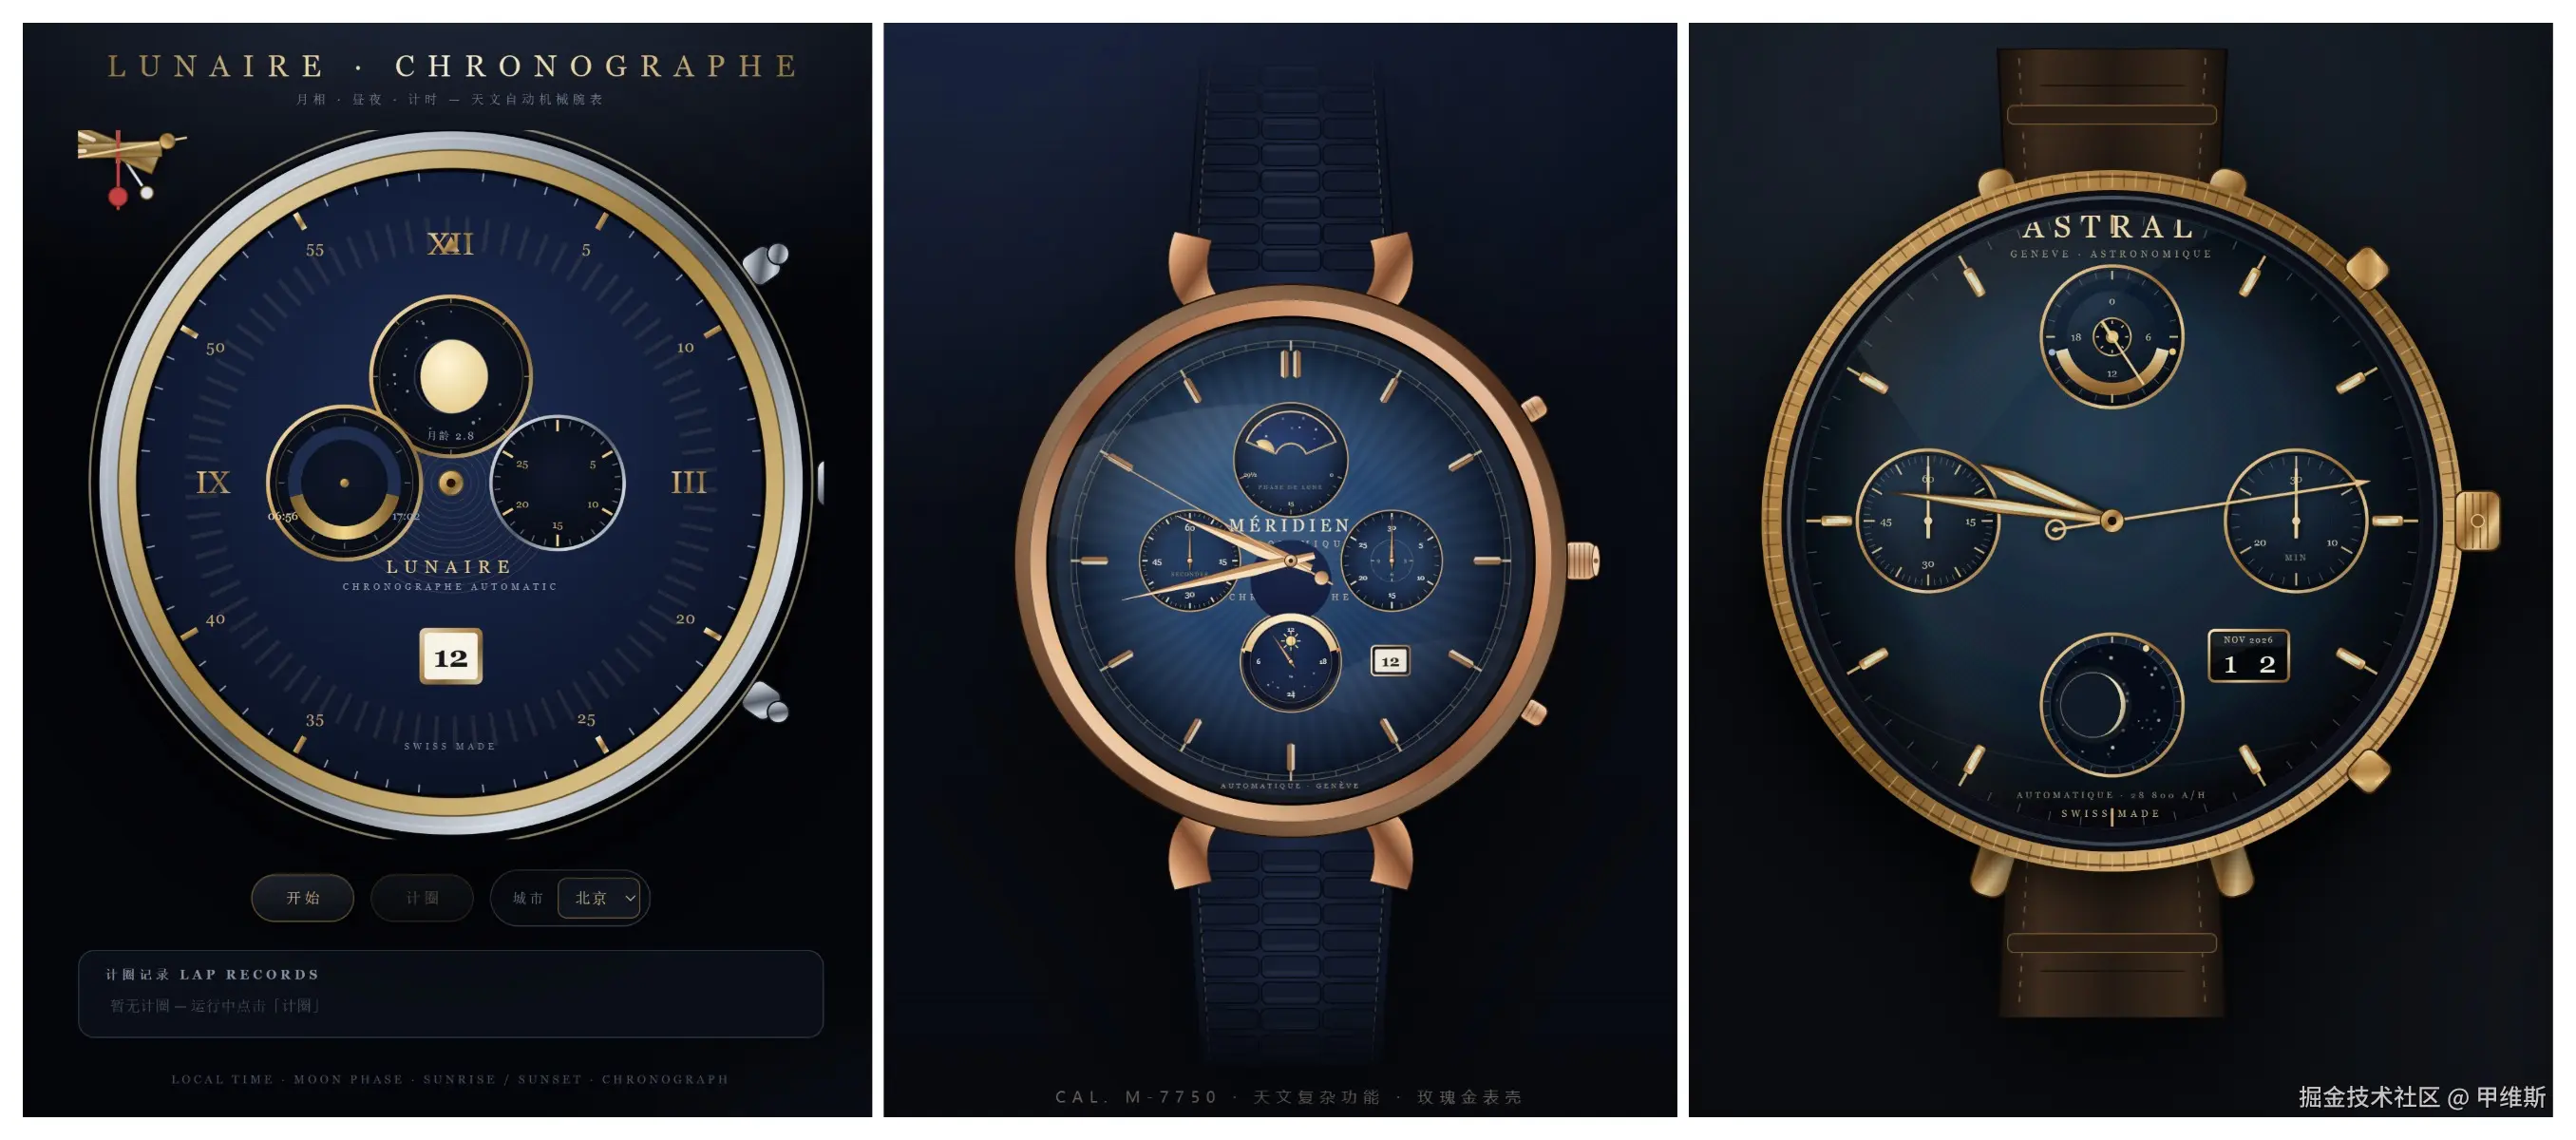
第一个是 Qwen3.8 Max 的,第三个是 HY4 的!
从对比来看,进步还是很大的,3.8 的时候问题很大,指针都没有。
设计感上 HY4 好一点,看着更高级!
然后是游戏复刻,超级玛丽的效果如下:
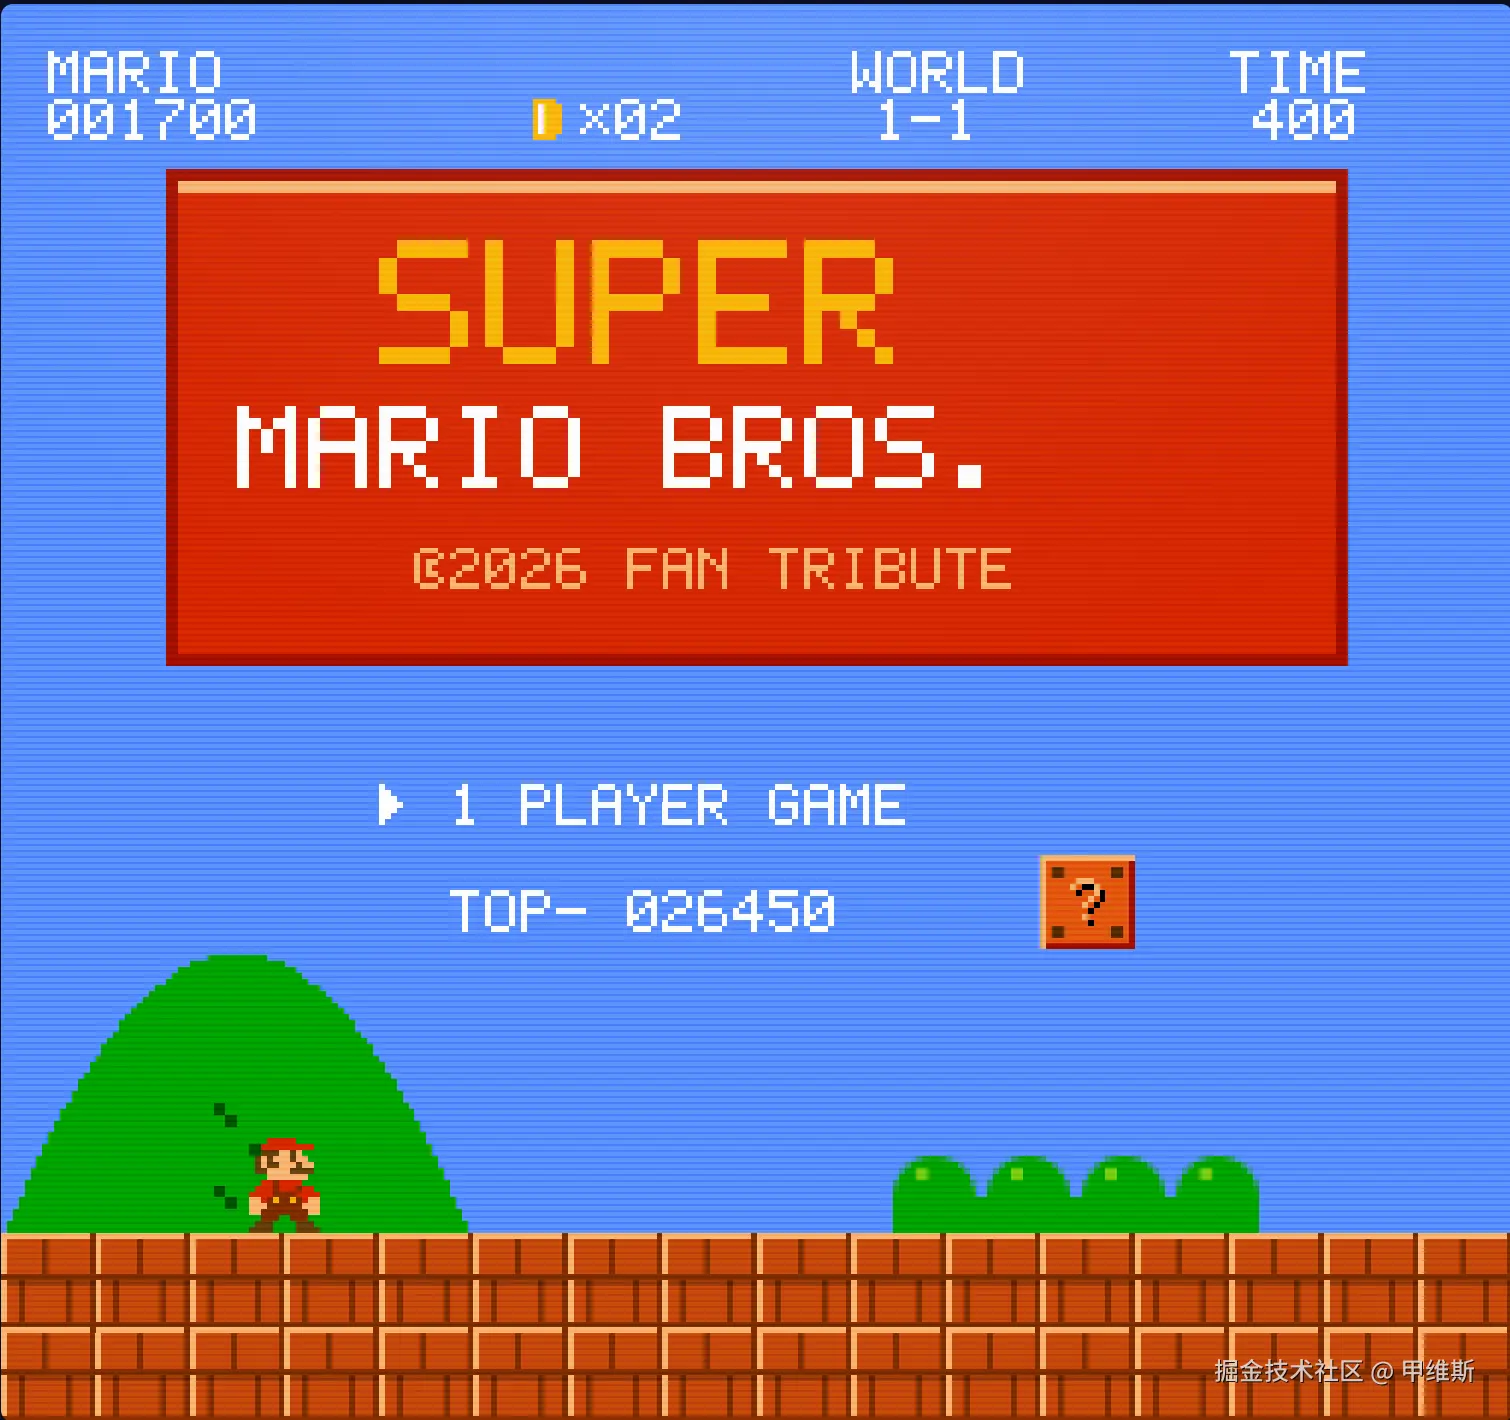
这个画面感还可以,我玩了一下,地图和玩法基本是对的,只是有一些小问题,比如跳跃有点困难。这个效果感觉比 HY4 好一些,当然它也没有做到高度还原,还原度大概 70~80% 吧!
这个例子最大的问题是,消耗时间太久了,花了差不多两个小时,HY4 当时大概是 47 分钟! 明明是抄作业,为啥要抄这么久呢?
上面的例子我都说还可以,还不错,那主要是针对最近的国产模型而言的。因为我也不想一上来就说国产模型不行,所以我就尽量表述得让大家看着舒服。
接下来是甲维斯的车库,整体效果如下:
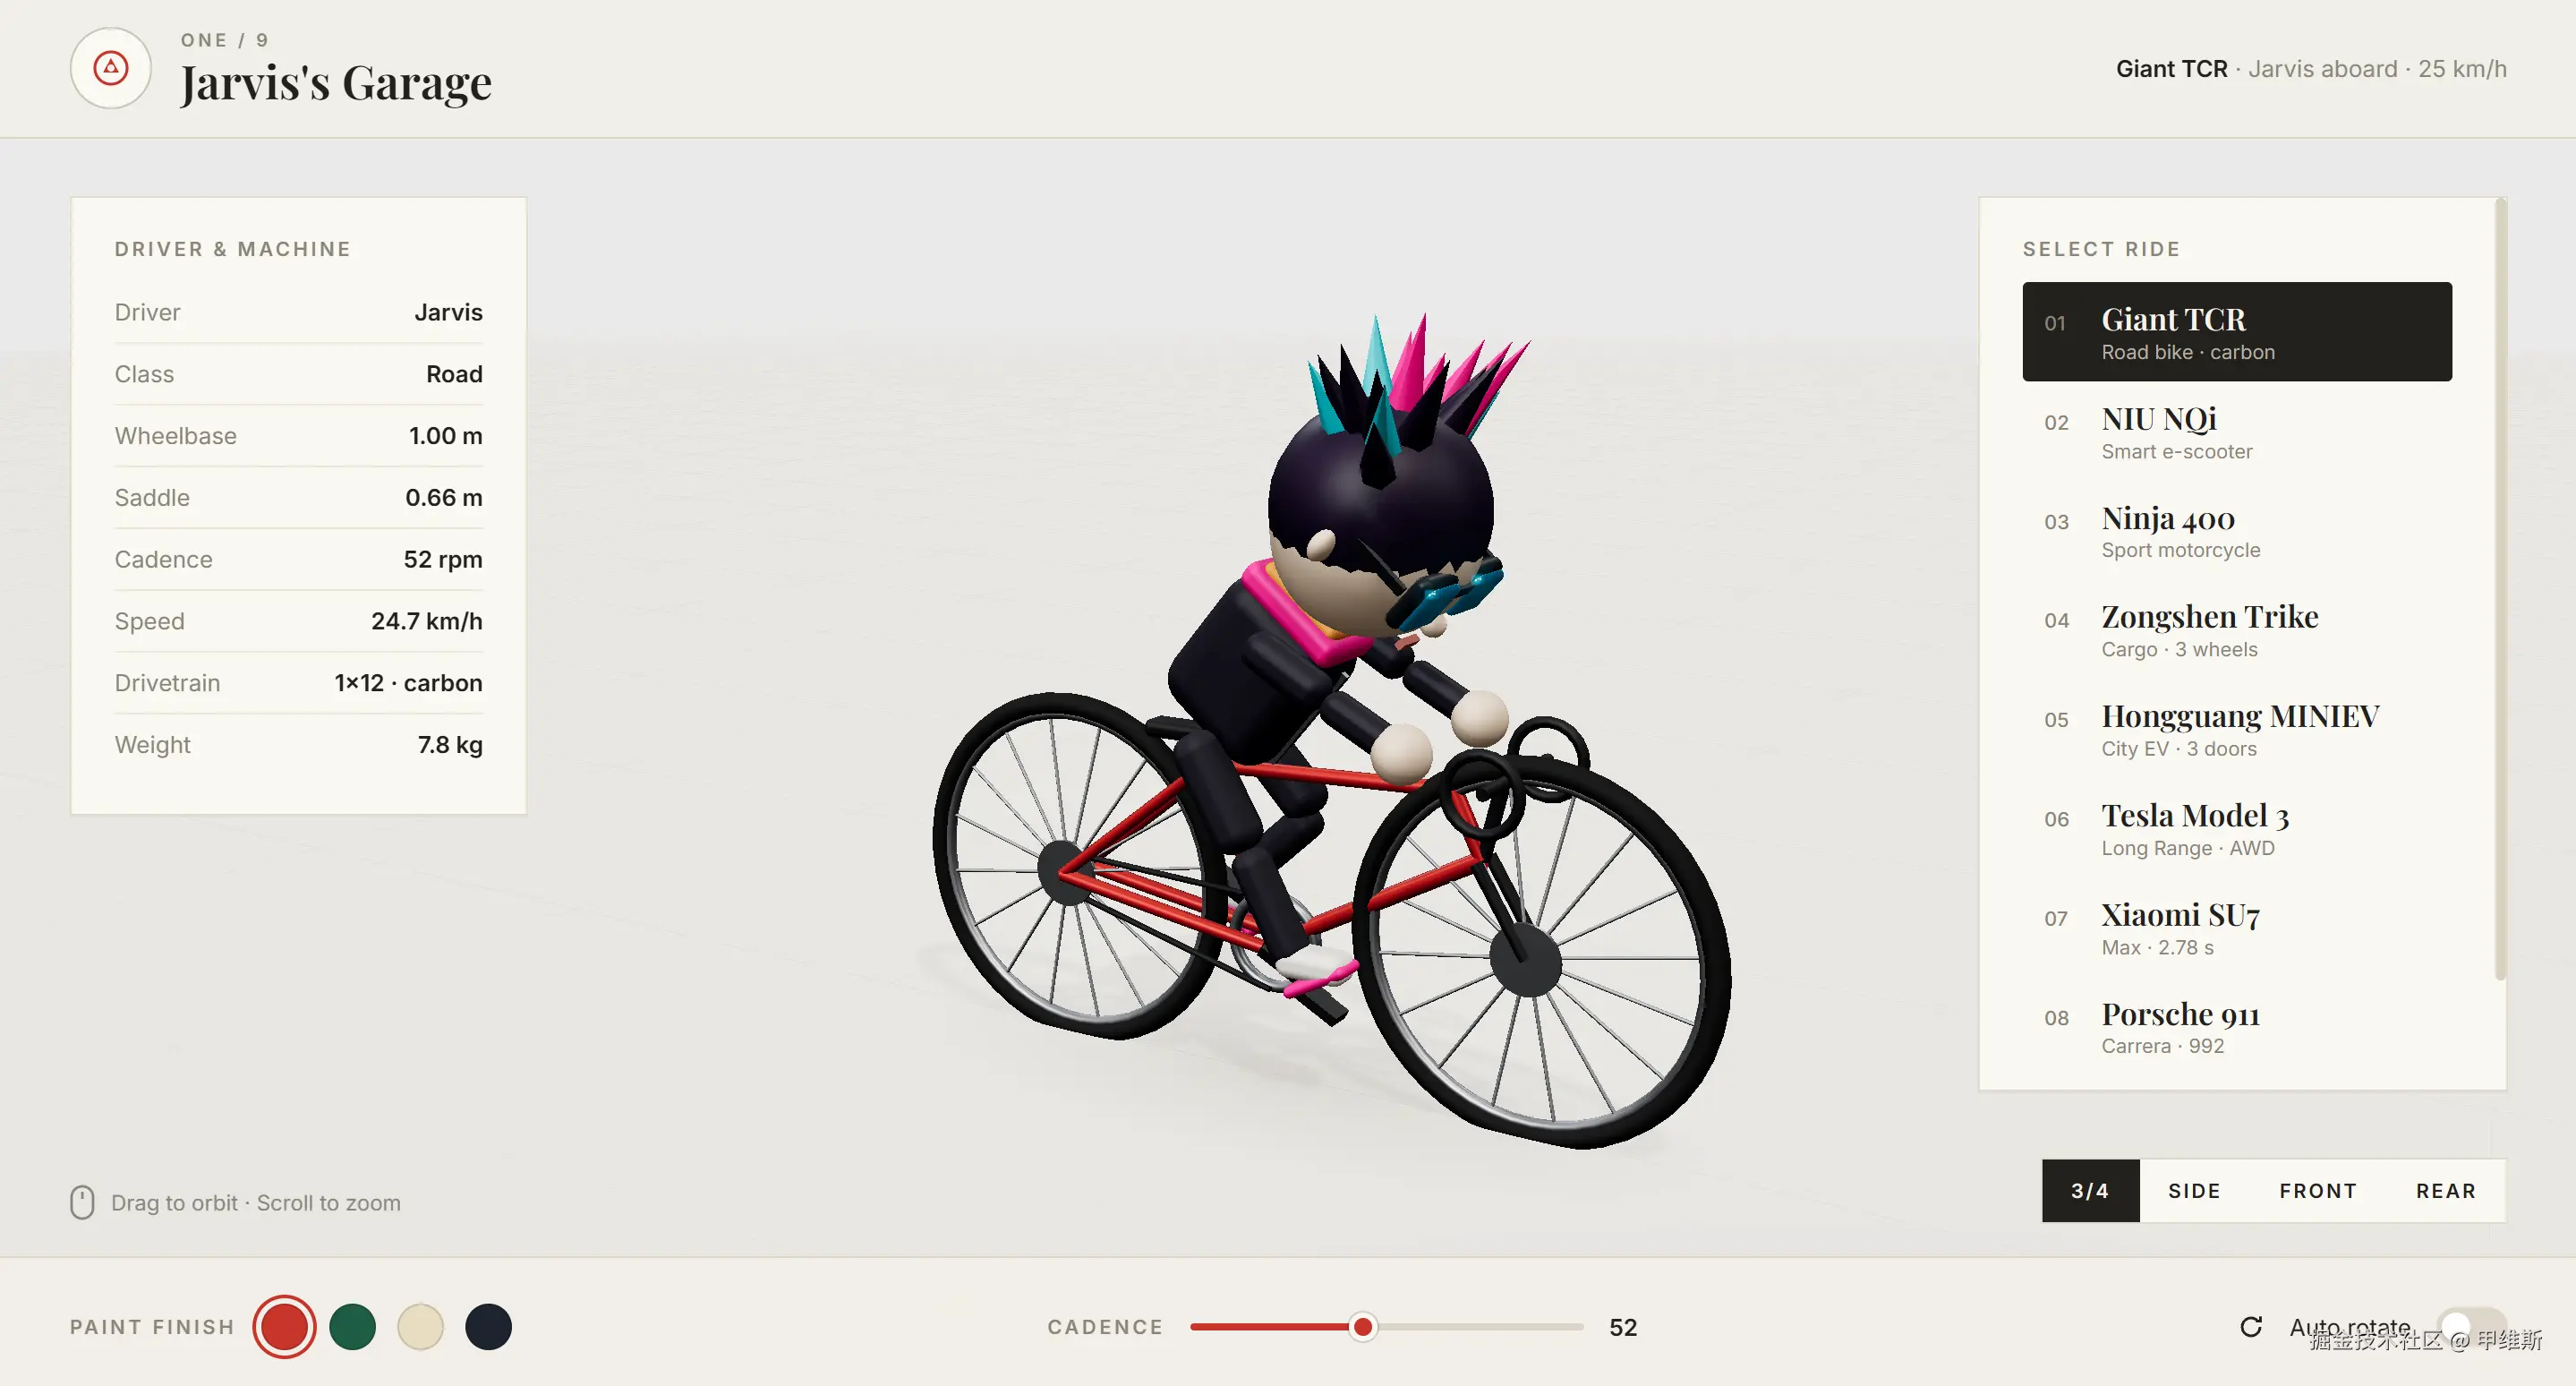
网页复刻部分基本上没问题,当前的多模态模型,基本都能很好地完成这个问题了。建模部分的话自行车和人物这部分基本是能看的。
另外其他的载具的建模就有些抽象,空间关系也有问题:
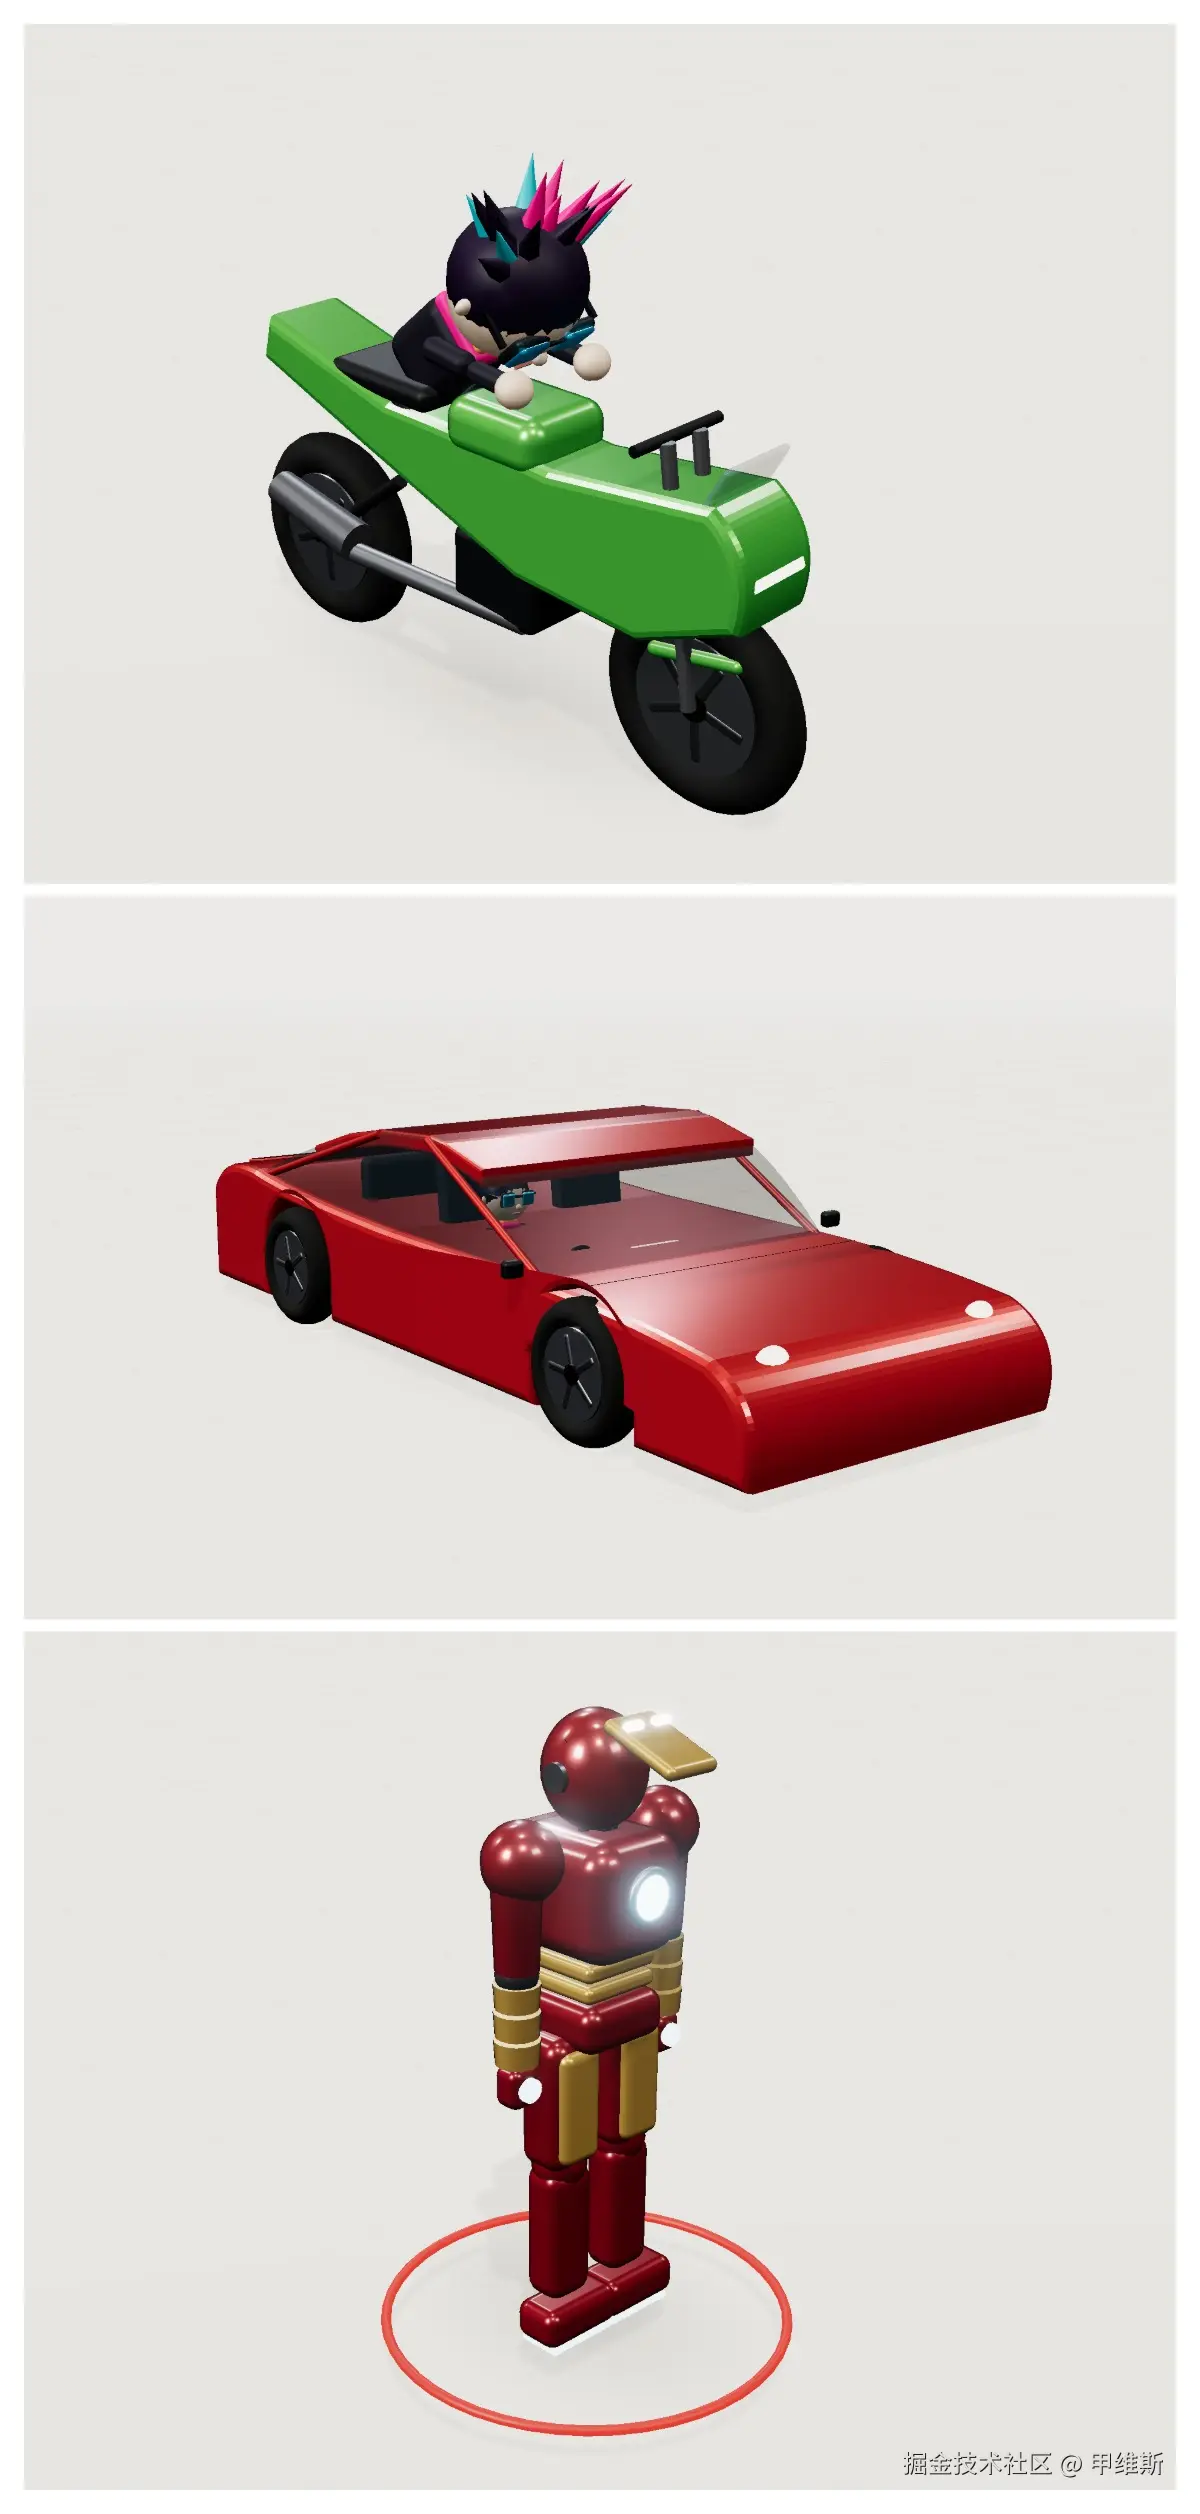
机车和保时捷,都是积木块的感觉,人陷入到车子里面了。 Mark III 现在基本上做不好,属于大家都很差,差得差不多。
这个例子跑了 1 小时 34 分钟!
我一直强调时间,就说明它这个时间相对是比较慢的!
下面来看一下,游戏手柄测试。
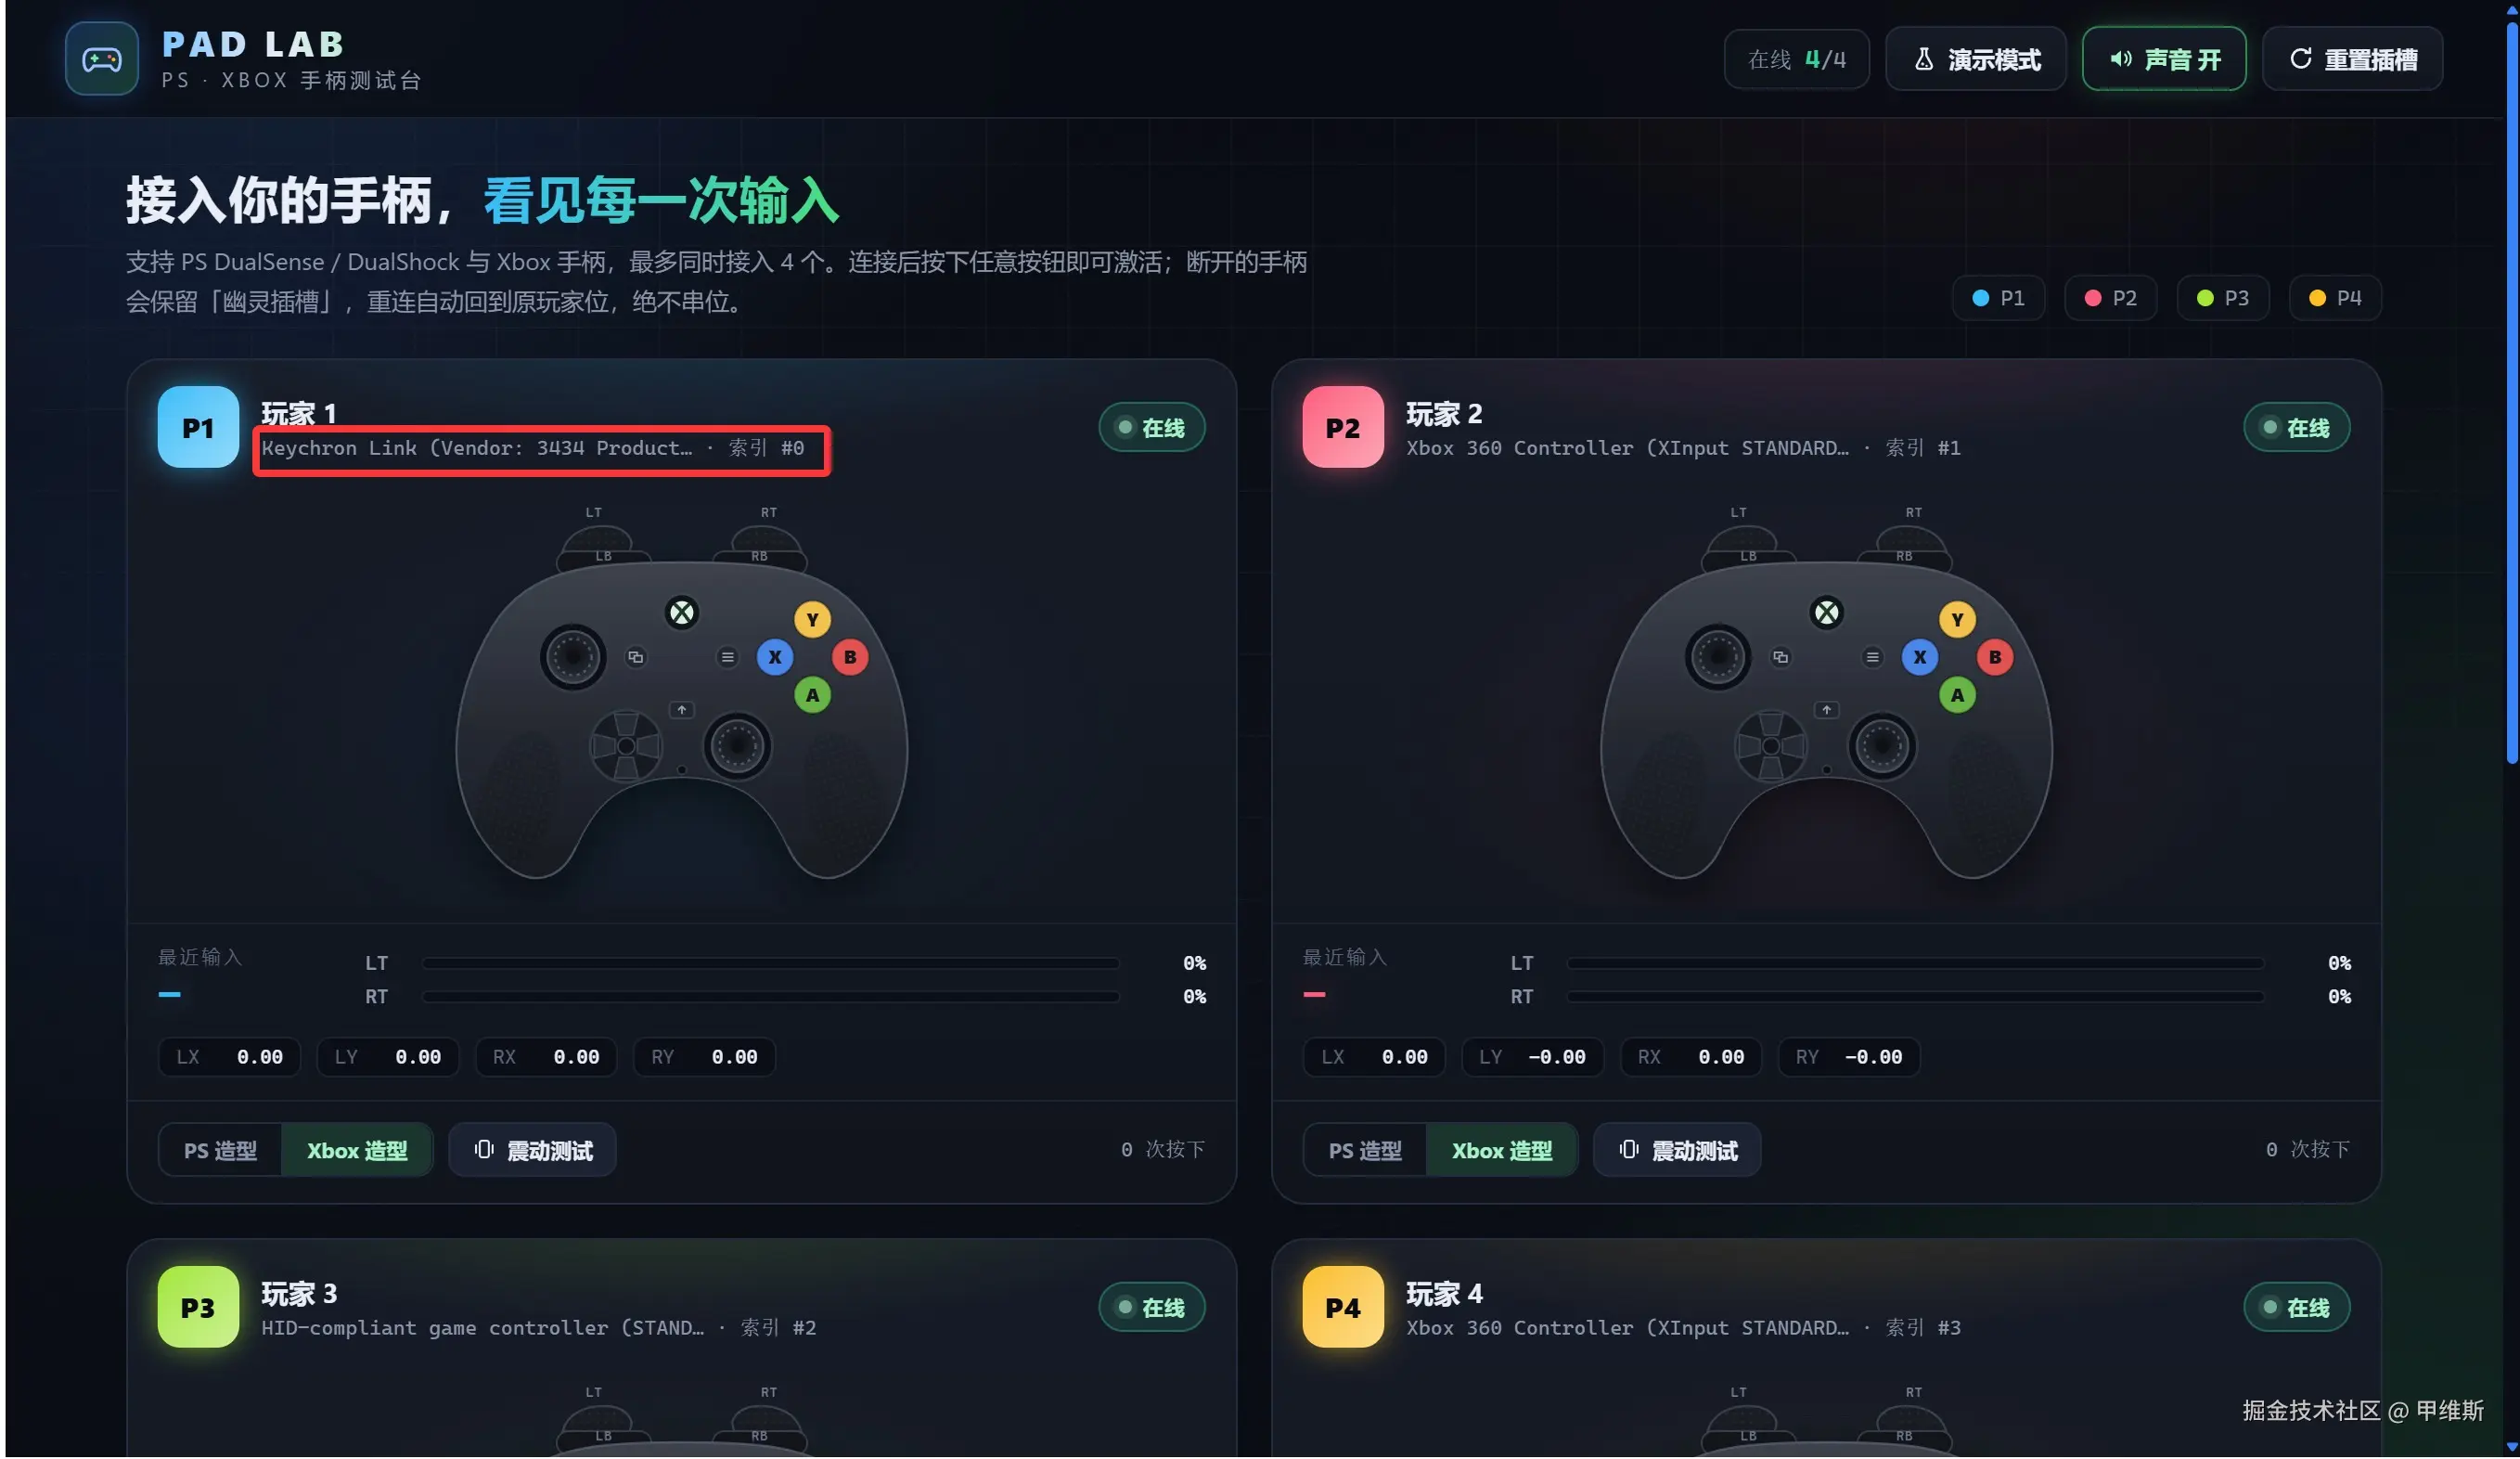
这个做得不好,和之前的一批 Flash 模型一个水准。 画得也不好看,控制逻辑也有问题。
首先它错误地把键盘鼠标识别成了手柄。其次我接入一个手柄它直接点亮了四个手柄。然后其中没有一个手柄能做出同步动作的。 我虽然提醒它要注意幽灵手柄,但是它其实并没有真的理解。
这个例子又干了 1 个多小时。作为参考,Sonnet5.5 只用几分钟,做得比它漂亮,控制逻辑全对。
Qwen4 作为一个旗舰 Max 模型,完全没有体现出旗舰模型该有的实力。 这个例子上 K3.1 Pro 肯定做得比它好。
另外我还搞了两个大制作,分别是荒野大镖客和绝地求生。结果嘛,意料之中的抽象。
绝地求生直接卡死了,不方便截图。
荒野大镖客能打开,效果如下:
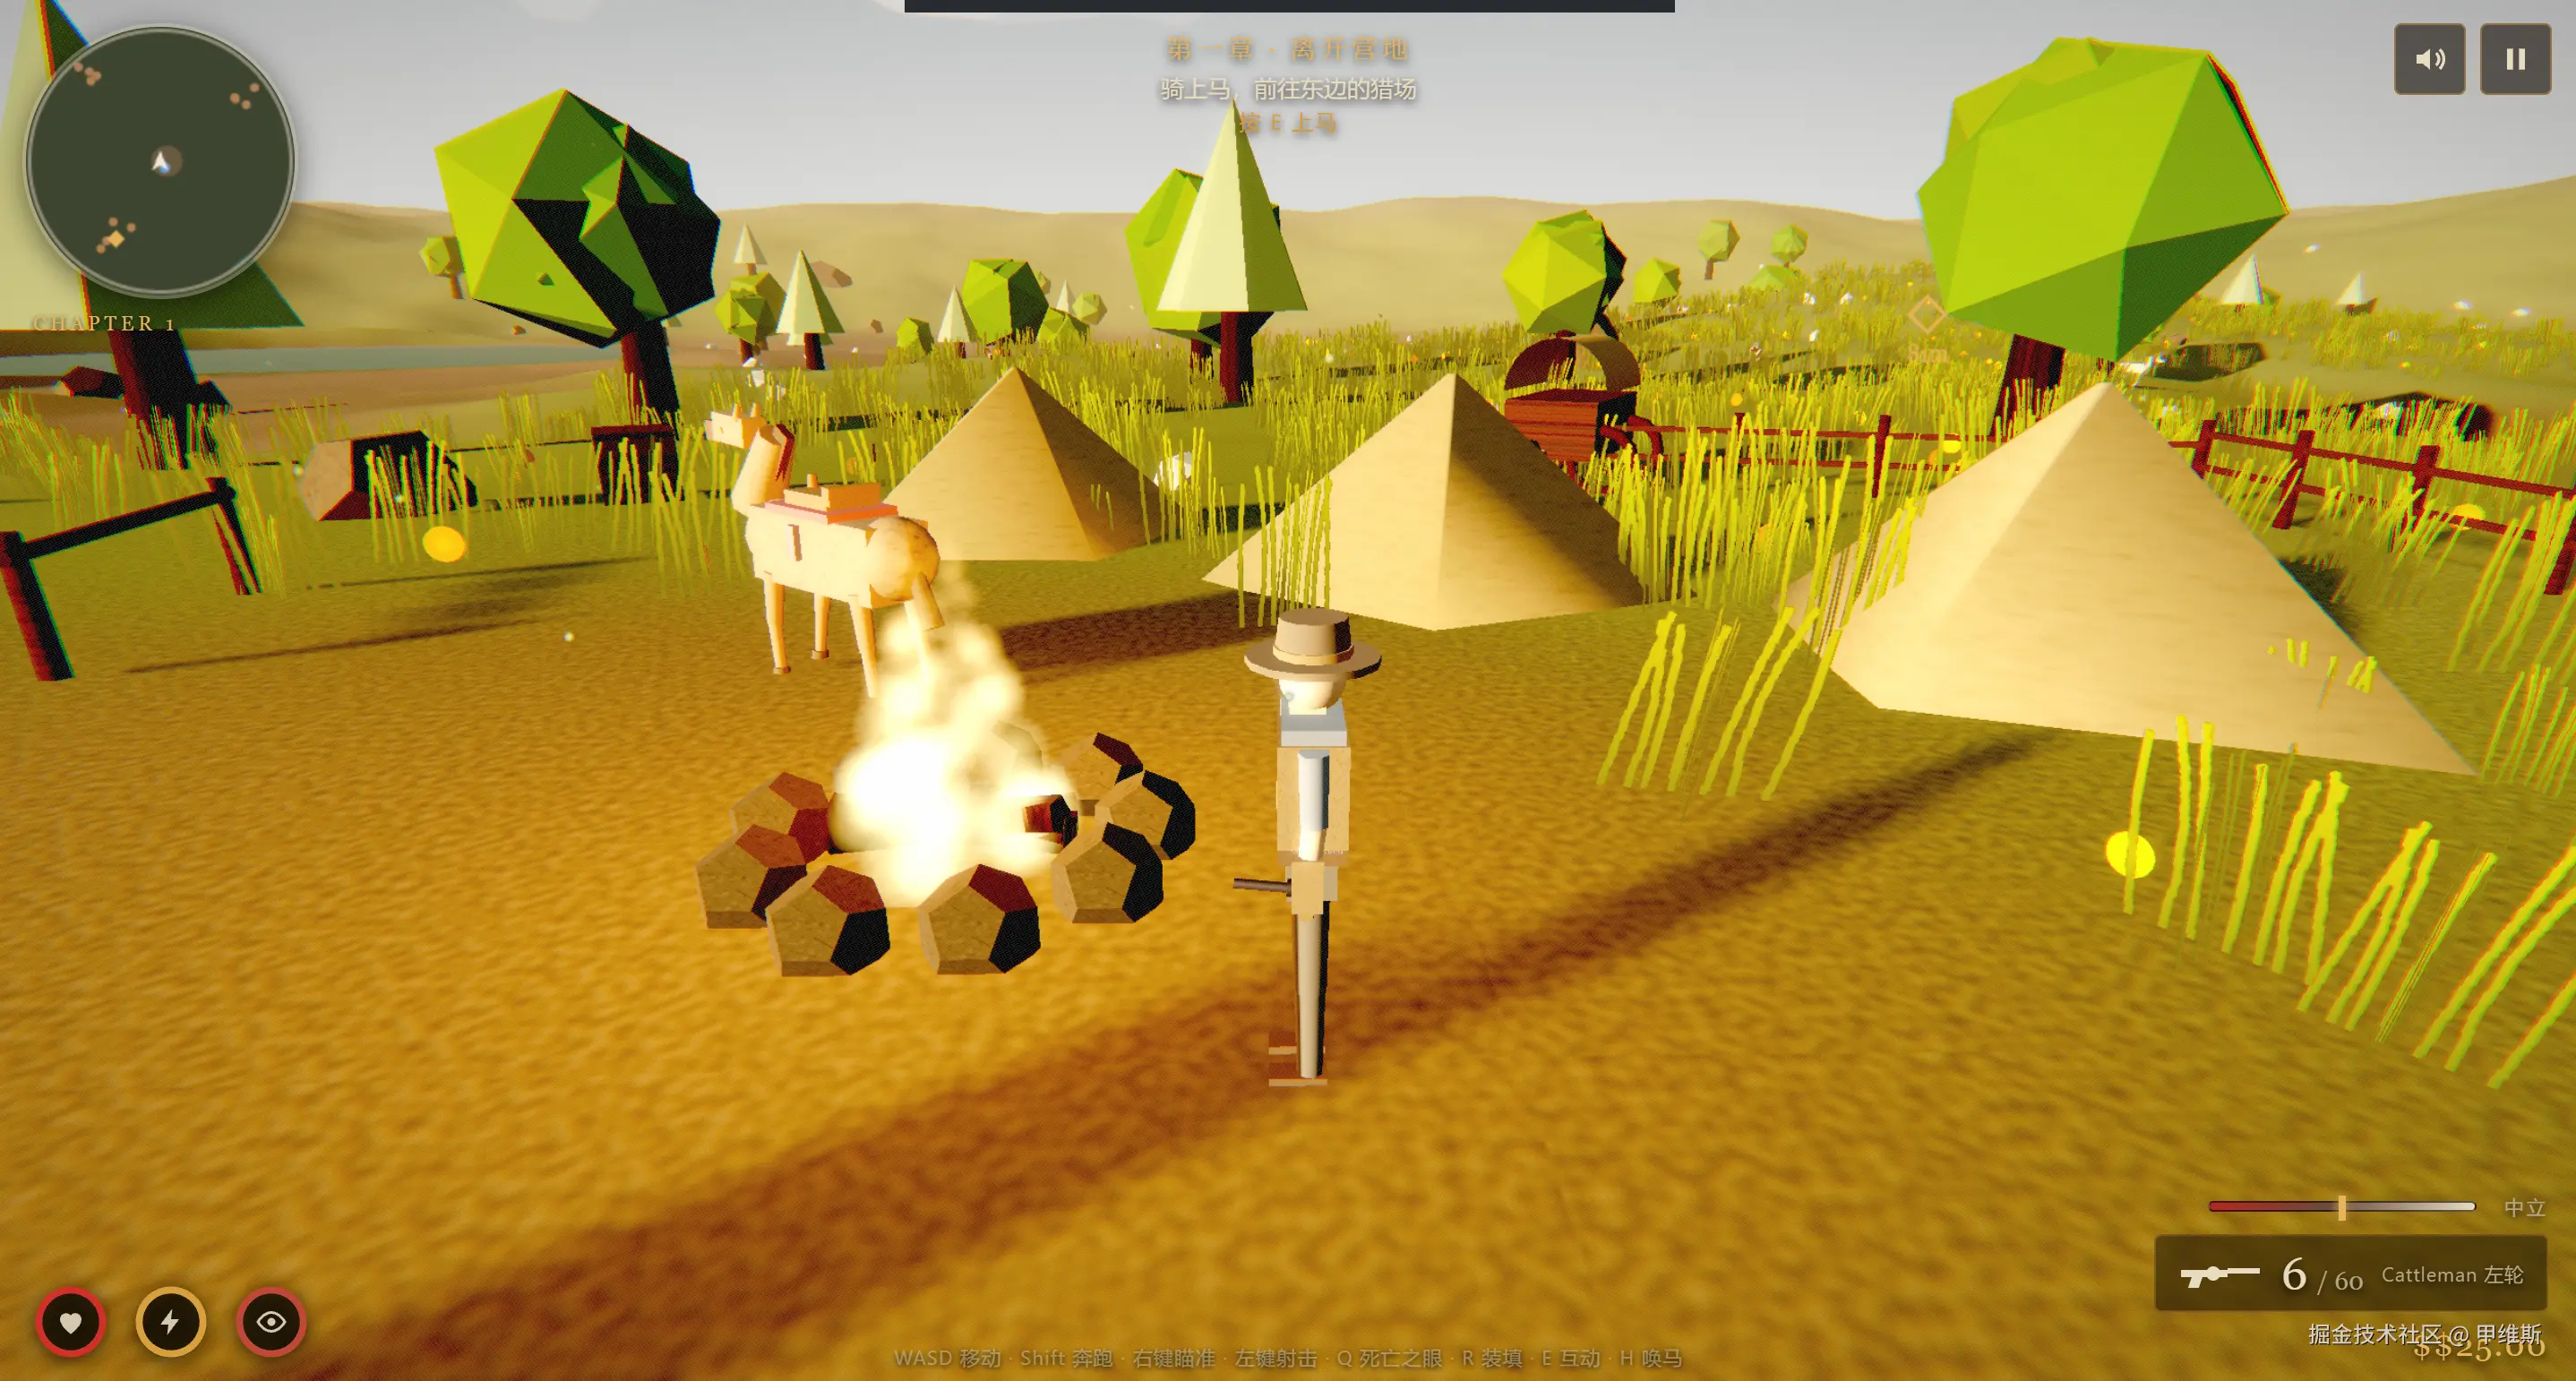
有人,有马,有篝火,还有金字塔形的帐篷,好像挺全面的。但这显然不是我要的 3A 大作。属于 3 岁小孩的大作。
骑马也是别有一番风味:
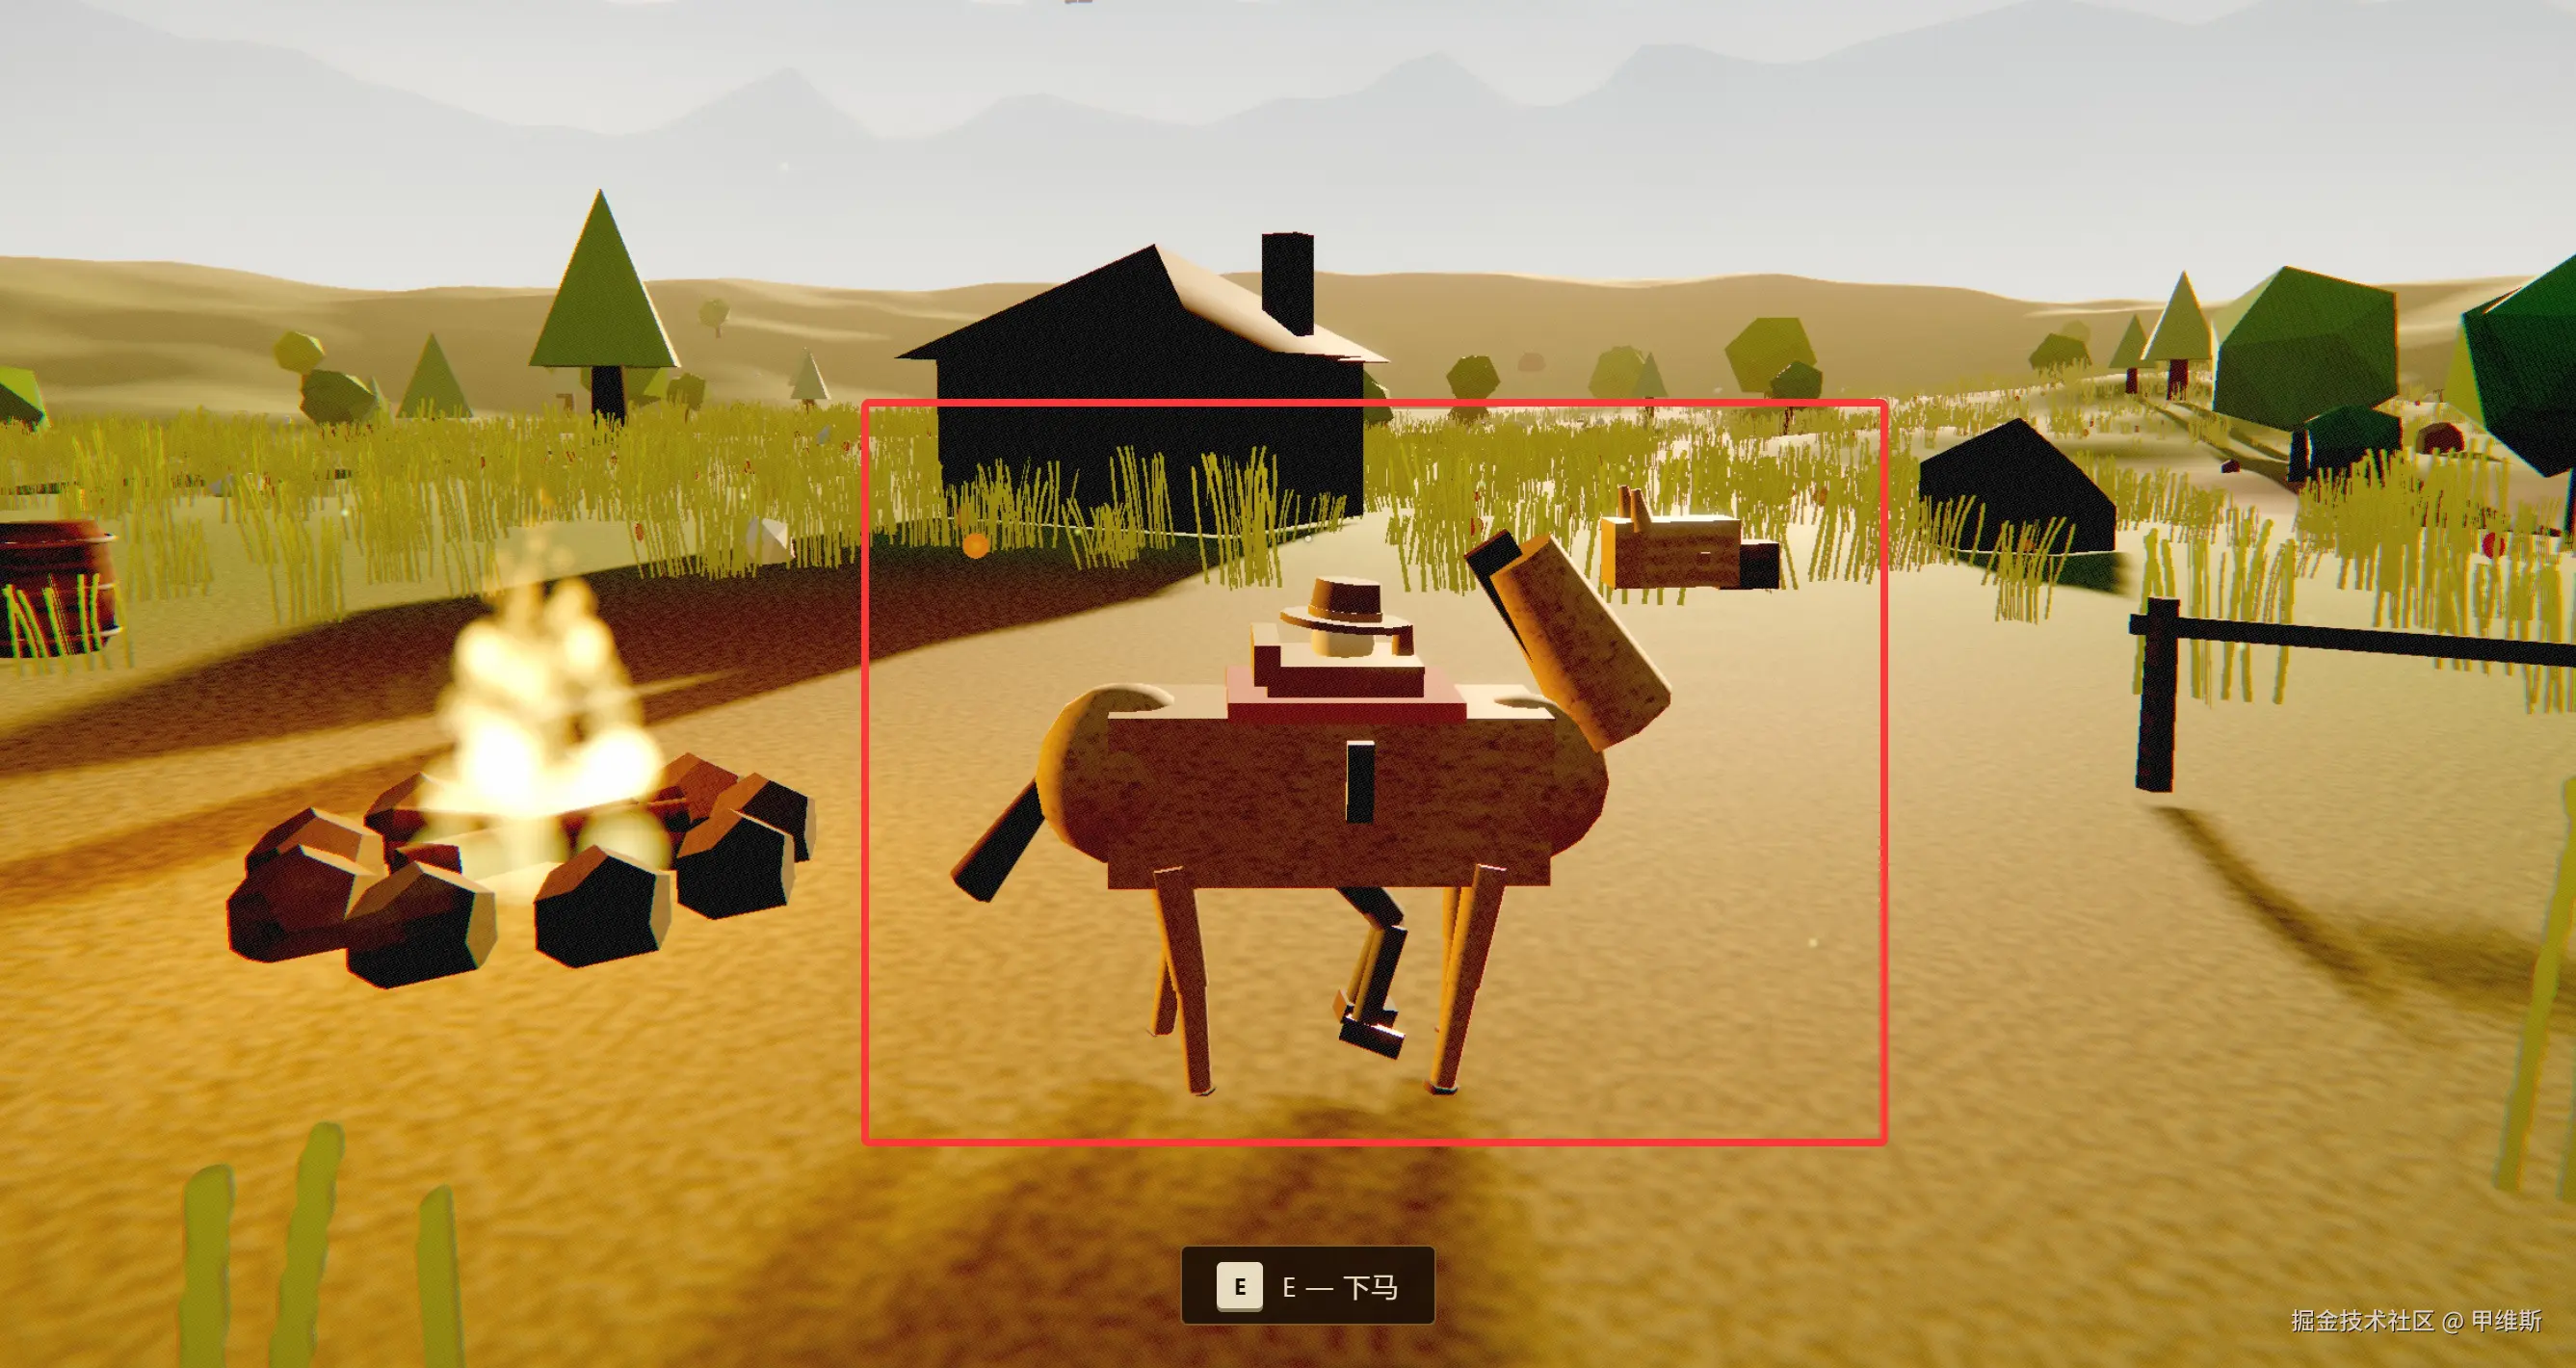
作为顶级国模,本来应该是去对标 Claude 的 Fable 5.2 的。但是...我都不好意思放对比效果,这样太残忍了。
这个例子,其实 HY4 也跑了,Opus 5.5 也跑了,Fable 5.2 也跑了。目前正在整理中,有机会后面给大家看对比视频吧。 反正国模和美模的差距已经不是一丁半点了。
实力大概就是这个样子!
下面看看消耗部分吧:
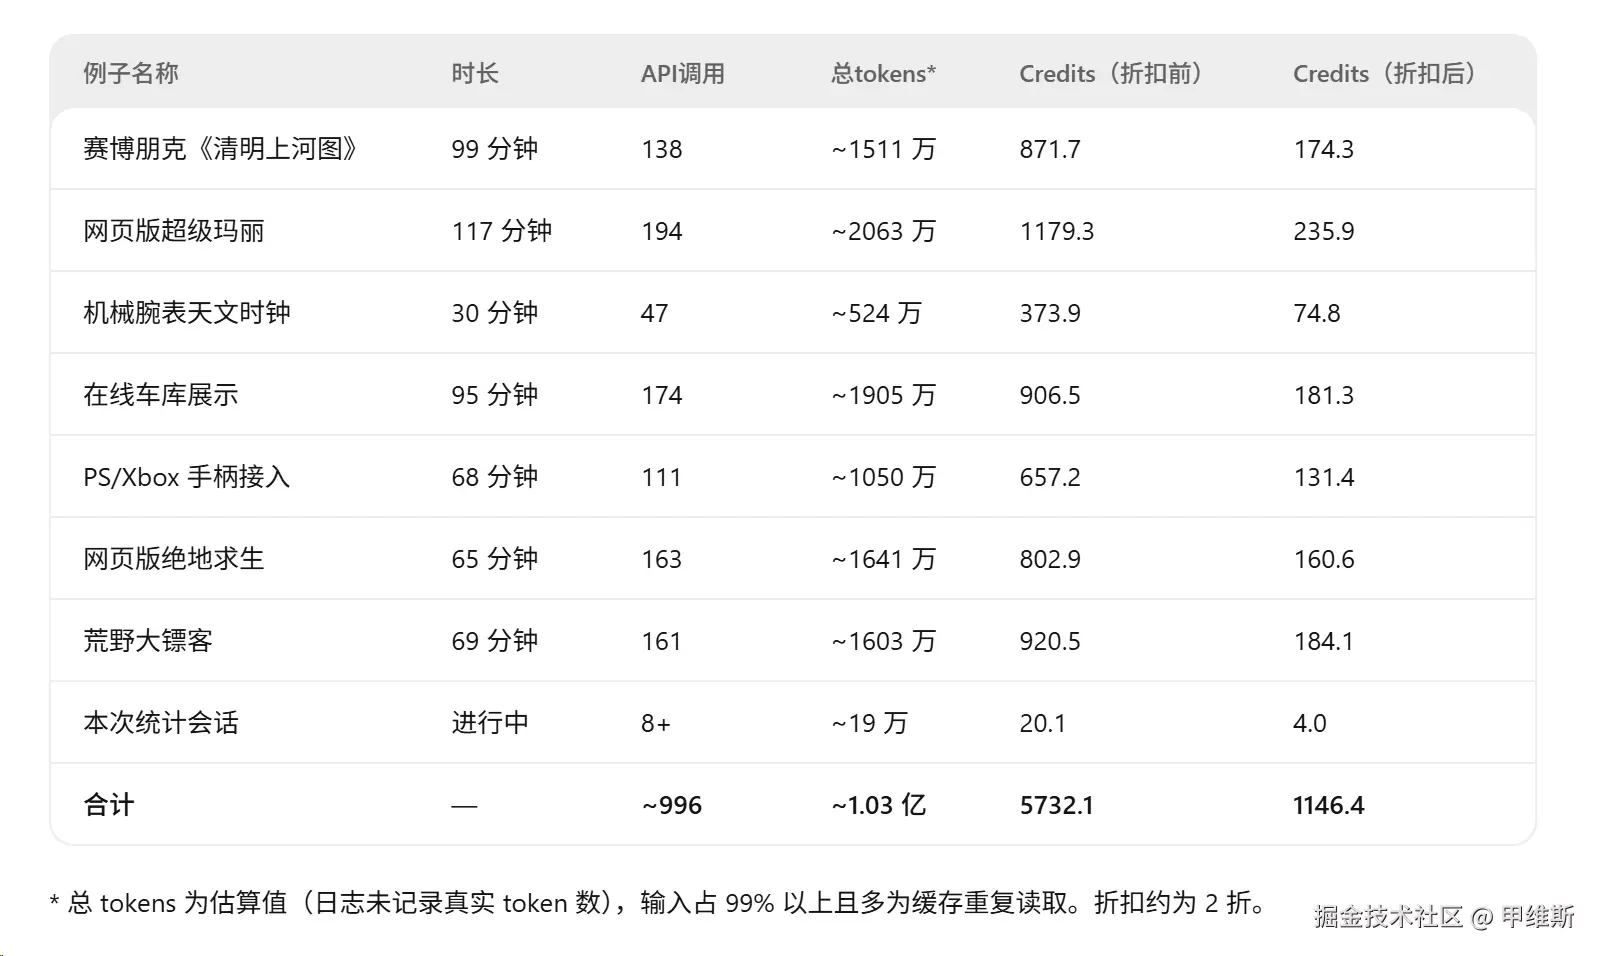
它这个 token 是乱写的,虽然有这个字段,但是字段里没有写这个数据。
Credit 应该是真实的数据!
从这个表格中可以看到,Qwen4 的时间消耗非常久,动不动就是 1 个小时起步 ,长的可以到 2 个小时。但是从它的结果来看,我觉得等这么久是不值得的。
另外看一下它的费用情况。我是入门档,价格为 59 元。 开通后一个月的 Credit 大概是 2000!
因为现在有非常大的折扣,所以只扣了 1146,相当于半个多月的配额用完了。
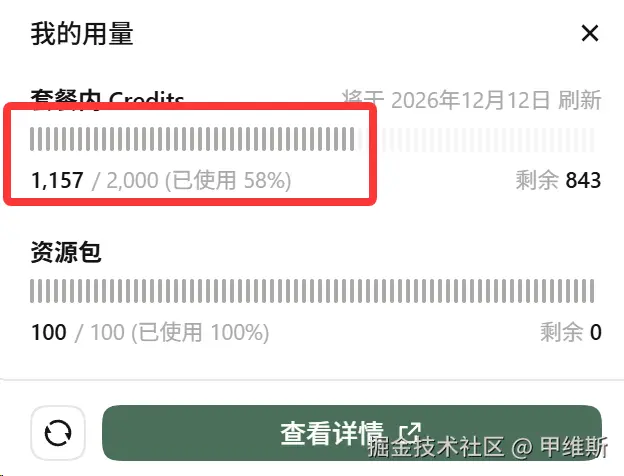
我只是跑了几个例子而已哦~~如果按原价的话,我需要三个月的配额才能跑完这些例子。 好像,没啥性价比。
所以可以总结一下了。
能力方面,在国内的话不算差,比 3.8 是有明显进步的。但是显然没有早期吹的那么神,作为一个 4 开头的版本,效果没有任何惊艳的地方。
最近更新的这一批模型都是这个状态,相比自己肯定有进步,但是能力上限不够高,自主性太差了。相比国内同行好像也差不多,没有明显地拉开差距。
相比国外的 Fable 5.2、GPT-6 Astra、Gemini 4 感觉已经不在一个水平线了。
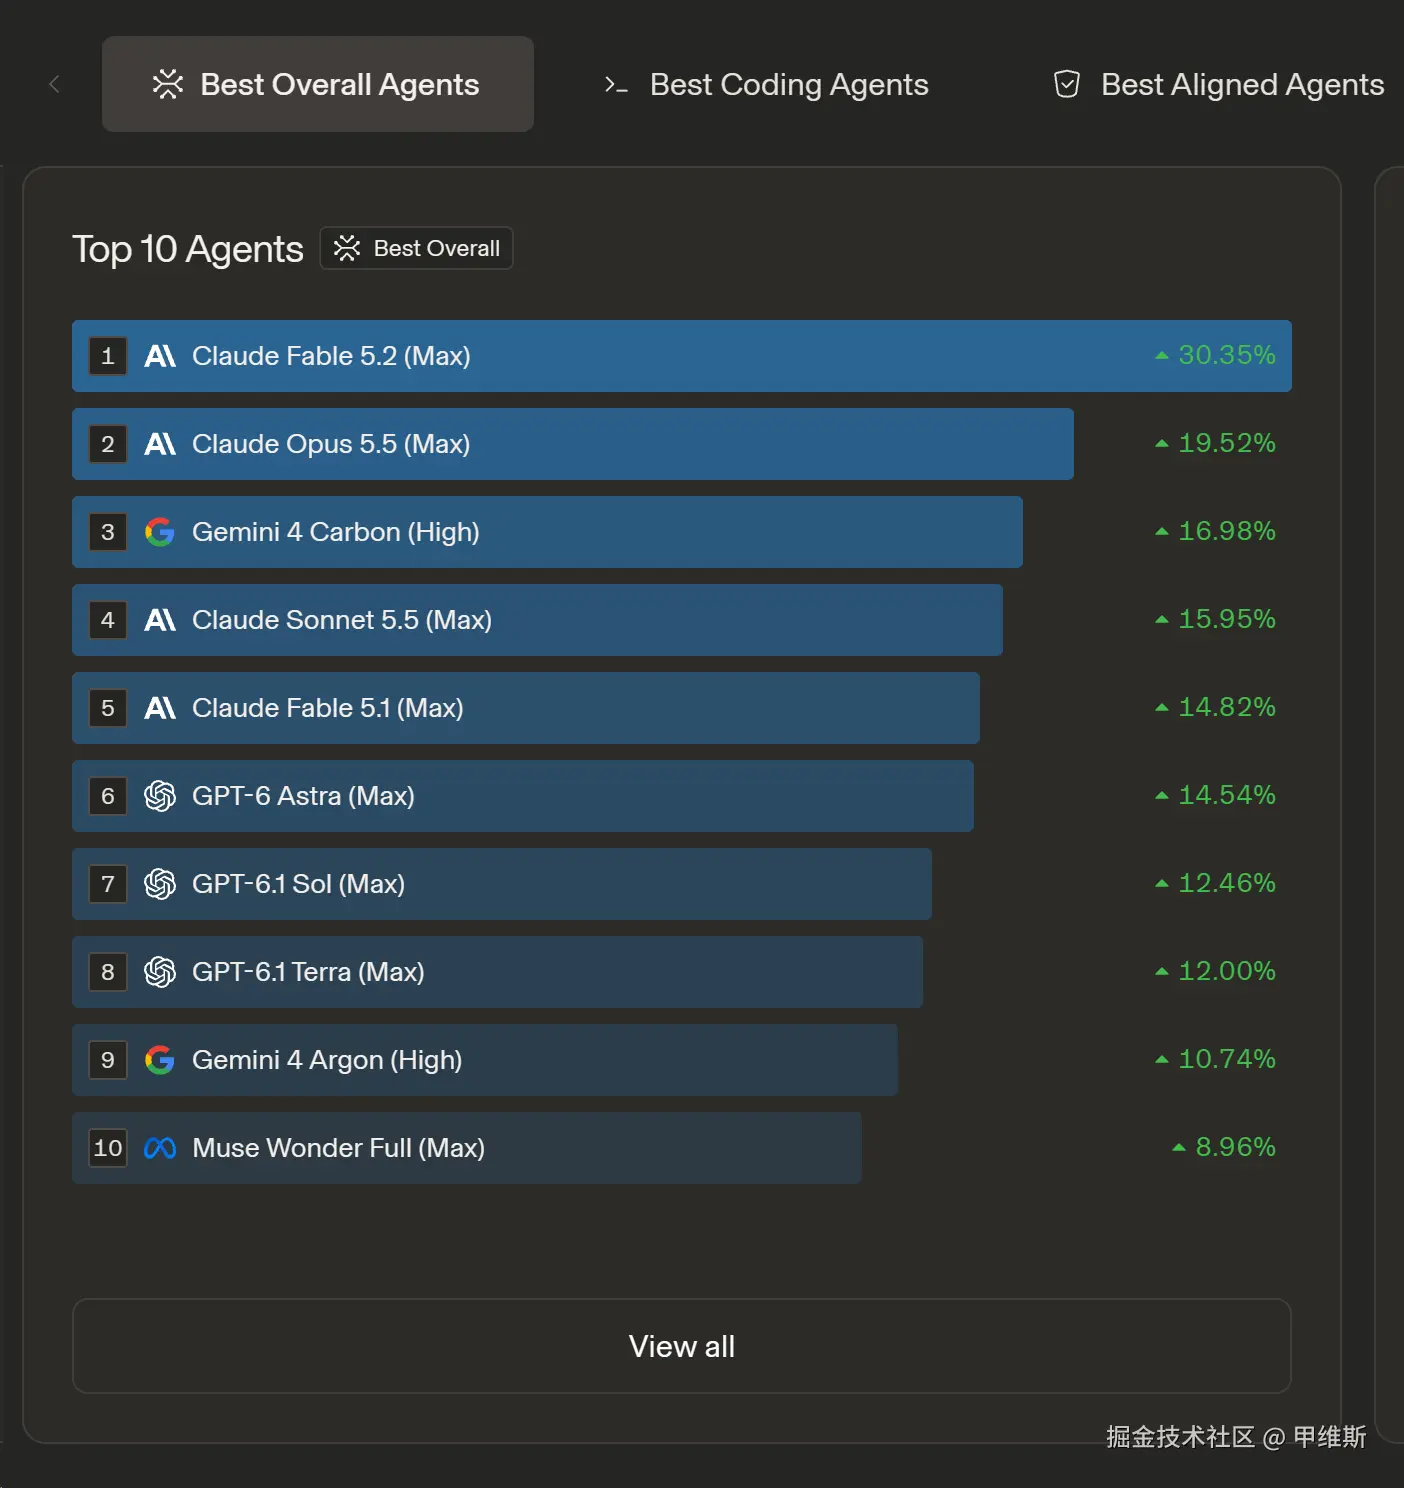
Top10 里面完全看不到国产模型了!
这个图片来自大模型竞技平台 arena,这个平台其实是华人创建的,平时国产模型上线都是会比正常状态抬高一些的,现在也抬不动了。
A 一家拿下 4 个名额,O 拿下三个,G 拿下两个。 基本上被 Anthropic、OpenAI、谷歌给包圆了。Anthropic 领先幅度太大了。次旗舰 Sonnet 就非常能打! 不说了不说了,说多了都是......!
能力说完了,再来结合一下开发效率和开发成本。
这个综合性价比就非常差了!
如果大家只是日常使用,没啥复杂的事情,那么肯定是选择既便宜,又快的模型了。
这一点我觉得不如 WorkBuddy + HY4!
HY4 明显速度更快,成本更低。
所以说回开头,被人嘲笑,也不无道理。主要确实没啥可以秀的。
感觉国模被什么东西锁死了,更新节奏很慢,提升幅度很小。
我好着急啊,我本来希望有个模型赶紧能达到 Opus 5.5 的水平。
等啊等啊等,等来了 DeepSeek 4.1 Flash,等来了 Kimi 3.1 Pro,等来了混元 4,等来了千问 4。
但是说实话,他们干 Opus 5 都很难!
前路漫漫,继续努力吧。