PDF 面单裁切、GPX 清理和 EPUB 修复都能把一部分处理放进浏览器,但它们遇到的问题很不一样:面单要把屏幕上的选择准确映射到纸张尺寸,GPX 要检查分享文件是否还包含敏感轨迹,EPUB 则要区分可重复的结构错误和源文件本身的问题。
我查看了几个实现和公开求助,下面集中讨论处理流程、已有体验及需要补做的验证。文中的检查步骤是实现建议,未完成的测试会单独说明。
PDF 面单:先分清裁切、页面尺寸和打印缩放
一张面单打印得太小,可能是原始 PDF 留白太多,也可能是目标纸张或驱动缩放设置有误。只在预览里放大图像,并不等于导出的页面尺寸已经正确。
Adobe 社区有用户尝试把整页中的面单改成 4×6,调整尺寸后仍然打印过小。Etsy 的官方说明也区分了标签下载格式。因此,排查时应先确认能否直接下载合适尺寸的原文件,再决定是否需要裁切。
浏览器端可以把流程拆成:读取 PDF、预览并选择区域、生成目标尺寸页面,最后下载文件。PDF.js 可承担预览,pdf-lib 可用于页面重组。对于固定版式,先用确定性规则;确实需要文字定位时再引入 OCR。
这里有几个容易混在一起的量:
- 预览缩放影响屏幕上的坐标。鼠标选区需要转换回文档坐标,不能直接把 CSS 像素作为 PDF 坐标。
- 旋转会改变选区与页面的对应关系。需要明确先旋转还是先裁切,并在导出时使用一致的变换。
- 目标页面尺寸决定输出纸张。裁掉留白后,仍需明确内容是等比缩放还是按原比例放置,避免条码被拉伸。
- 打印驱动可能再次缩放。文件预览正确后,还要检查实际打印的纸张和缩放选项。
样例导出能证明什么
本次用 Labelplane 的合成样例生成并下载了一份 PDF,页面显示为一张 4×6 面单。下面的截图是这次样例流程中的选区界面。
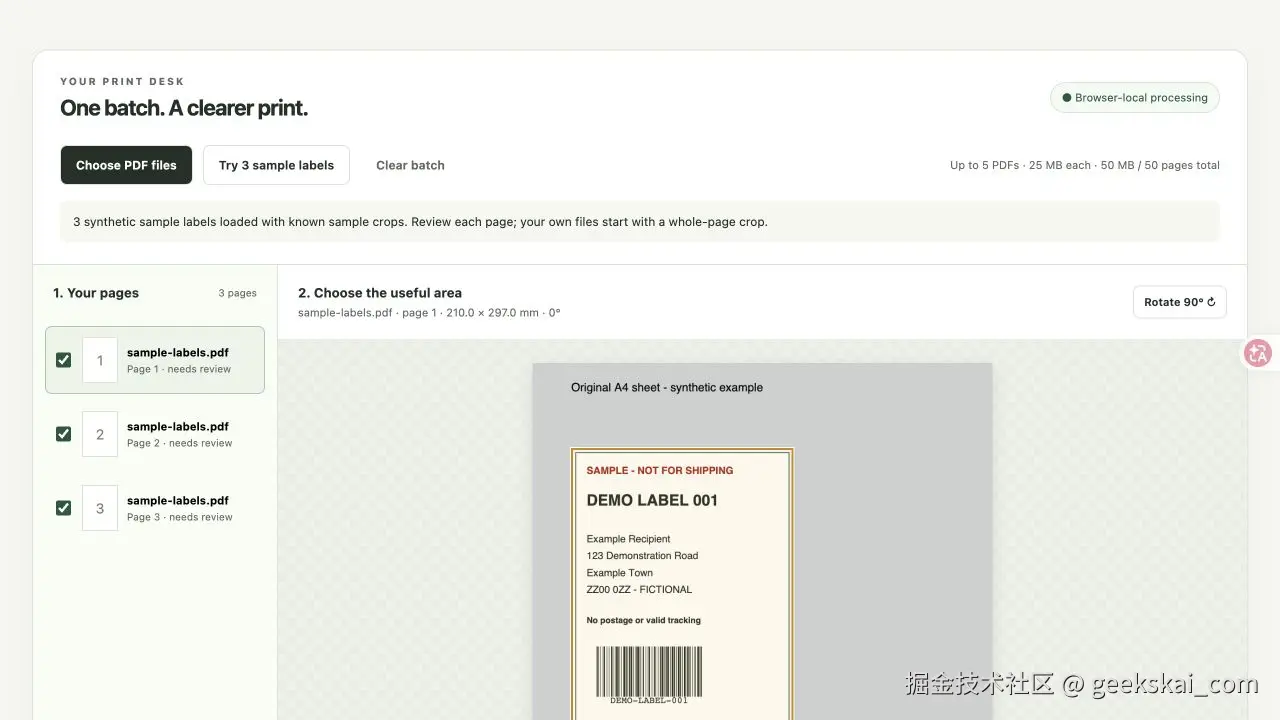
图 1:Labelplane 合成样例,未验证实体打印和扫码。来源:Labelplane,2026-11-12。
这次没有使用真实订单,也没有进行实体打印、承运商扫码或全站网络隐私审计。样例导出只能证明该输入走完了下载流程,不能推出所有面单都能正确打印。
另一个参考是 Label Studio 浏览器扩展。源码发布包包含页面读取、嵌入和重新排版逻辑,功能覆盖批处理、裁切旋转及打印机预设。阅读这类实现时,除了正常路径,还值得检查旋转页、混合尺寸文件和无法确定裁切范围时的处理。
本地处理的边界在具体流程里
只接收用户手动选择的文件、不保存订单的网页,可以把主要文件处理放在浏览器中。这能减少服务端的计算与存储需求,但资源下载、兼容性和错误处理仍然需要维护。
浏览器扩展的情况有所不同。Label Studio 的源码包含获取来源 PDF 所需的联网和站点权限。将这种能力移植成普通网页时,需要重新检查跨域和权限限制,不能仅因为裁切发生在本机,就说整个应用完全不联网。
它的依赖说明列出了 pdf-lib 的 MIT 许可,以及 PDF.js、ZXing 的 Apache-2.0 许可,仓库页面标注项目为 MIT。实际复用时仍应核对所采用版本及字体、素材的许可范围。
对面单流程,我会准备以下测试;这些测试尚未全部执行:
- 使用合成或充分脱敏的 PDF,覆盖留白、旋转、多页与不同尺寸。
- 对照选区与导出结果,检查目标页面尺寸、方向和内容比例。
- 对无法确定的页面要求人工确认,避免直接批量输出错误结果。
- 用目标打印机检查实体结果,记录驱动与纸张设置;扫码结果另行验证。
GPX:地图隐藏区域与导出文件要分别检查
跑步或骑行路线可能经过住处。平台上的地图隐藏了某段轨迹,不代表导出文件也做了同样处理。Strava 的相关文档说明,导出活动时的地图可见性规则存在自己的文件这一例外,因此分享文件前需要重新检查。
我查看了 key.is 的轨迹清理界面,页面描述包括起终点附近裁切和时间信息清理。下图仅用于说明设置项,没有验证它的实际导出结果,也没有确认其源码许可。
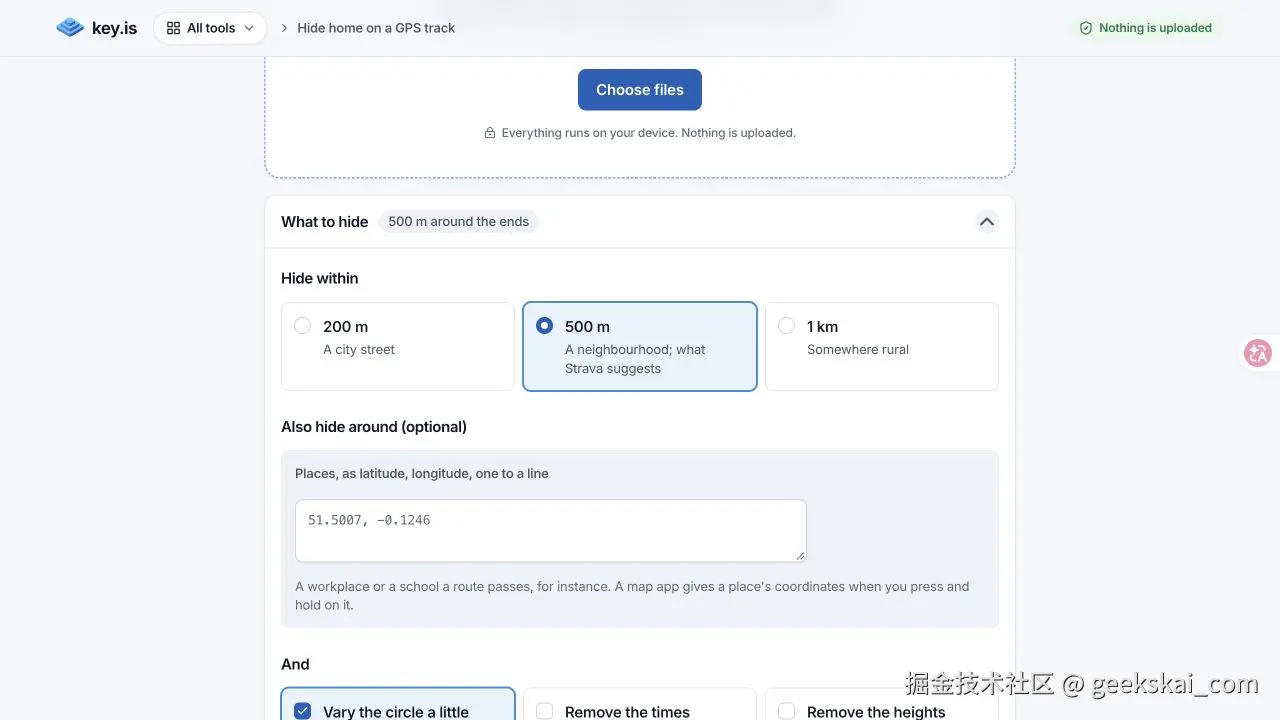
图 2:key.is 轨迹清理界面,仅查看设置,未验证导出。来源:key.is,2026-11-12。
如果自己实现类似处理,我会先用合成轨迹验证几个情况:路线离开隐藏区后又折返、途中穿过另一片敏感区域,以及文件包含多个轨迹段。仅删除开头和结尾几个点,无法覆盖这些情况。
删除点之后还要检查分段是否合理、附带信息是否保留,以及下载的文件重新打开后是否仍包含不应分享的内容。地图预览和导出内容应当一起验证。清理规则的覆盖范围也要明确写出来,避免给出完整匿名化的保证。
EPUB:先找出是哪一类结构错误
本次查看的 Calibre 求助中,有段落问题通过现有 HTML 转换功能解决,也有问题需要重新获取质量更好的源文件。两类问题需要不同处理,统一套用一个"修复"操作很难判断结果是否正确。
如果要做浏览器端处理,我会先限定一个可识别的错误类型,保存原文件,再提供修改前后的对照。验证应覆盖内容是否丢失、段落结构是否符合预期,以及目标阅读器的显示结果。当前材料不足以支持一个通用 EPUB 修复方案。
对这三个方向,前端界面的完成都只是中间一步。PDF 要检查实际交付尺寸,GPX 要核对下载文件里的敏感信息,EPUB 要检查内容与结构。测试应围绕这些最终输出安排。
参考资料
资料查看日期:2026 年 11 月 12 日。公开求助是个案,不代表问题发生率。
本文含 AI 辅助研究与编辑。样例结果与尚未执行的验证已分别说明。