本文介绍了RocksDB这一业界领先的嵌入式键值存储引擎。它已被Meta、微软、阿里、字节、美团等国内外众多知名公司广泛采用,支撑了包括消息系统、用户行为追踪、AI大模型训练平台等大规模数据存储场景。通过本文,你将收获:
- 深入理解RocksDB的核心功能与底层实现原理
- 掌握LSM-Tree存储引擎的设计范式,及其与传统B+Tree的差异
- 学习存储引擎的设计优化思路,加深对MySQL、Redis等常用存储系统的理解
- 了解在大规模写入场景下一种新的数据存储选择
引言
在现代应用架构中,存储层的选型往往直接影响系统的性能、可靠性和扩展性。当前主流技术栈中,MySQL凭借完善的事务和复杂查询能力承担核心业务数据存储;Redis以极低延迟作为热数据缓存的首选。
然而,在面对高吞吐写入(如日志采集、监控指标上报)和大容量低成本存储(如冷数据归档)等场景时,现有存储组件往往面临挑战:MySQL在超高并发写入时容易出现锁竞争与I/O瓶颈;Redis的内存成本与容量限制难以平衡。
RocksDB作为Facebook开源的嵌入式高性能键值存储引擎,采用"日志结构合并树(LSM-Tree)"作为核心架构,通过顺序写入优化、分层合并等机制,在高吞吐写入、低延迟读取与大容量存储之间取得了优异平衡。它以嵌入式库的形式集成到应用中,无需独立部署,可无缝融入Java技术栈,成为现有存储体系的有力补充------无论是作为Flink、Pulsar等中间件的底层存储,还是在业务系统中承担高吞吐数据写入或冷热数据分离的角色,RocksDB已在Meta、微软、阿里、字节、美团等企业的核心业务中得到了广泛验证,成为突破存储瓶颈的关键技术选项。
1.RocksDB概述
1.1 定义
RocksDB是由Facebook开源的一款嵌入式、持久化的键值(Key-Value)存储引擎,具有以下核心特点:
- 嵌入式部署: 作为库文件直接集成在应用程序中,与主进程共享内存等资源,避免了网络通信和跨进程调用的开销
- 数据持久化: 数据可靠存储在物理介质中,能够承受进程重启或意外断电等故障场景
- 灵活数据模型: 以键值对形式存储数据,key和value均为任意长度的字节数组,不强制预定义Schema
在实现层面,RocksDB使用C++编写,并通过C绑定接口支持Java、Go、Rust等多种编程语言,使用者无需担心语言兼容性问题。同时,它适配了Linux、Windows、macOS等主流操作系统的文件系统,具备良好的跨平台部署能力。
1.2 主要操作及核心特性
由于RocksDB以没有类型的任意长度字节数组作为键值,其用于键值操作的基本接口十分简洁:
Put(key, value): 插入新的键值对,或者更新已有的键值对Merge(key, value): 按照自定义的合并算子,合并数据库中原值与给定的新值Get(key): 通过点查获取key对应的valueDelete(key): 从数据库中删除key对应的键值对DeleteRange(start_key, end_key): 删除指定范围内的键值对
通过构建迭代器的方式可在键范围进行范围顺序扫描:
iterator.seek(key_prefix): 查找等于或大于指定前缀的第一个键值对iterator.value(): 获取当前key的valueiterator.next(): 将迭代器按顺序移动到下一个键值对
除这些基本接口,RocksDB还提供了以下特性:
- 批量操作原子性: 可将多个数据写入操作作为一个write batch,保障写入原子性
- 快照: 提供数据库在某个时间点的一致性只读视图
- 事务: 支持多操作事务,提供ACID语义
- 列族(ColumnFamily): 将数据库从逻辑上划分为多个分区,每个分区有自己的配置和数据压缩策略,支持跨分区原子操作。
- TTL: 支持设置键值对的生存时间,在指定时间后自动删除过期数据
- 压缩优化: 内置 LZ4、Snappy、ZSTD 等多种压缩算法,可按需配置(如冷数据用高压缩比算法),降低存储成本。
1.3 核心定位
RocksDB 的核心定位是面向高性能、大容量场景的嵌入式键值存储引擎,并非替代 MySQL、Redis等现有存储组件,而是通过差异化能力填补技术栈空白,形成互补协同:
- 从部署形态看,它以库文件形式嵌入应用进程,无需独立部署与网络通信,专注解决 "应用内本地存储" 的高性能需求,区别于 Redis(独立缓存服务)、MySQL(独立关系型数据库)的 "服务式存储" 定位;
- 从能力侧重看,聚焦 "高吞吐写入、低延迟读写、大容量持久化" 三大核心场景,弥补了 MySQL 在千万级 QPS 写入场景下的性能瓶颈、Redis 大容量存储的成本压力;
- 从场景边界看,不追求复杂查询与分布式原生支持,而是将灵活性交给上层架构 ------ 既可为简单业务提供轻量嵌入式存储,也能作为分布式系统的 "本地存储层",配合 Raft 等分布式一致性协议实现高可用扩展。
典型应用场景包括:中间件底层存储(如流处理、消息队列的状态/消息持久化);高吞吐数据存储(如日志、监控指标、物联网数据的写入与归档);针对特定场景的存储系统的底层引擎(如向量数据库、列存储数据库等);混合存储架构中的专项角色(如冷热数据分离中的冷数据存储、缓存+持久化混合场景)。
| 对比维度 | RocksDB(嵌入式 K-V 存储引擎) | MySQL(InnoDB) | Redis(内存数据库) |
| 核心定位 | 嵌入式高性能持久化存储,专注高吞吐写入、大容量存储 | 关系型数据库,专注事务完整性、复杂业务数据管理 | 内存优先的缓存与键值存储,专注超低延迟读写 |
| 部署形态 | 嵌入式库(无独立进程),无网络开销 | 独立服务(单机/主从/集群),需网络通信 | 独立服务(单机/集群),需网络通信 |
| 数据模型 | 键值对(K-V) | 关系模型(表/行/列) | 键值对(K-V) |
| 存储引擎 | LSM-Tree(日志结构合并树),优化顺序写 | B+ 树,优化随机读写与范围查询 | 内存哈希表(持久化时用 RDB/AOF) |
| 核心优势 | 高吞吐写入、大容量存储(10TB 级)、嵌入式低开销 | 事务 ACID 完整支持、复杂 SQL 查询、Join 关联、成熟的容灾与备份机制 | 超低延迟(微秒级)、高并发读写、丰富的数据结构、分布式集群支持 |
| 性能特征 | 写入吞吐极高,写入/读取延迟低(NVME 下写入可达十万乃至百万 QPS,写入微秒级,查询百微秒级) | 读写均衡,随机写延迟中等(毫秒级),吞吐通常在数千到数万 | 读写延迟极低(亚微秒~微秒级),读写吞吐高 |
| 持久化能力 | 支持(WAL 预写日志+SSTable 刷盘),崩溃可恢复,持久化性能优 | 支持(Redo/Undo Log+数据文件),事务持久化保障强 | 支持(RDB 快照+AOF 日志),但大容量持久化成本高、恢复慢 |
| 典型局限 | 无复杂查询、原生不支持分布式、Compaction 可能占用 CPU/IO、需手动调优参数较多 | 高吞吐写入瓶颈、大容量存储成本高、分库分表后复杂度上升 | 大容量存储成本极高、持久化恢复慢、不支持复杂查询 |
1.4 技术生态地位
自2013年由Facebook开源以来,RocksDB凭借其工业级实现、卓越性能表现与灵活的配置能力,构建了覆盖开源社区、大厂实践、中间件生态的完整技术体系,成为嵌入式高性能存储领域的事实标准:
- 大厂核心应用
- 国外:Facebook内部将其用于社交数据存储、日志处理等核心场景,支撑数百PB生产数据;LinkedIn、Twitter采用其作为分布式系统的本地存储层;Google、Amazon在云原生存储服务中集成RocksDB优化性能
- 国内:阿里、字节跳动、美团、小红书等企业广泛应用于日志平台、监控系统、分布式数据库、AI大模型训练、边缘设备数据存储等场景,支撑业务数据的海量快速写入
- 中间件生态集成
RocksDB已成为众多主流中间件与分布式系统的底层存储首选,形成"上层框架 + RocksDB存储"的成熟架构模式:
- 流处理:Flink采用RocksDBStateBackend作为大状态存储方案,突破内存存储的容量限制
- 消息队列:Apache Pulsar、SofaMQ集成RocksDB优化消息持久化性能,平衡吞吐与延迟
- 分布式数据库:TiDB、Apache Kudu等将其作为底层存储引擎,利用LSM-Tree架构优化写入性能
- 其他场景:在分布式锁、元数据存储、搜索引擎索引等场景中,RocksDB常作为本地持久化层,配合分布式协议实现高可用
- 行业标准影响
RocksDB基于LSM-Tree架构的优化实践(如分层合并策略、布隆过滤器、多线程并发控制),已成为嵌入式存储引擎的设计标杆。其技术思路被广泛借鉴,推动了LSM-Tree架构在工业界的普及,也为后续同类存储引擎的发展提供了成熟的工程参考。
凭借"嵌入式 + 高性能 + 可定制"的核心价值,包括CockroachDB、Yugabyte、PingCAP和Rockset等一批创新型企业都选择将其作为数据库内部存储引擎,进一步巩固了其在现代数据存储架构中的基石地位。
2. 核心原理解析: LSM-Tree 与 RocksDB底层设计
2.1 数据存储结构:B+Tree 与 LSM-Tree 的设计哲学
在存储引擎领域,B+Tree 长期占据主导地位。其核心优势在于数据在叶子节点中有序排列并构成链表,使得点查和范围查询性能卓越。
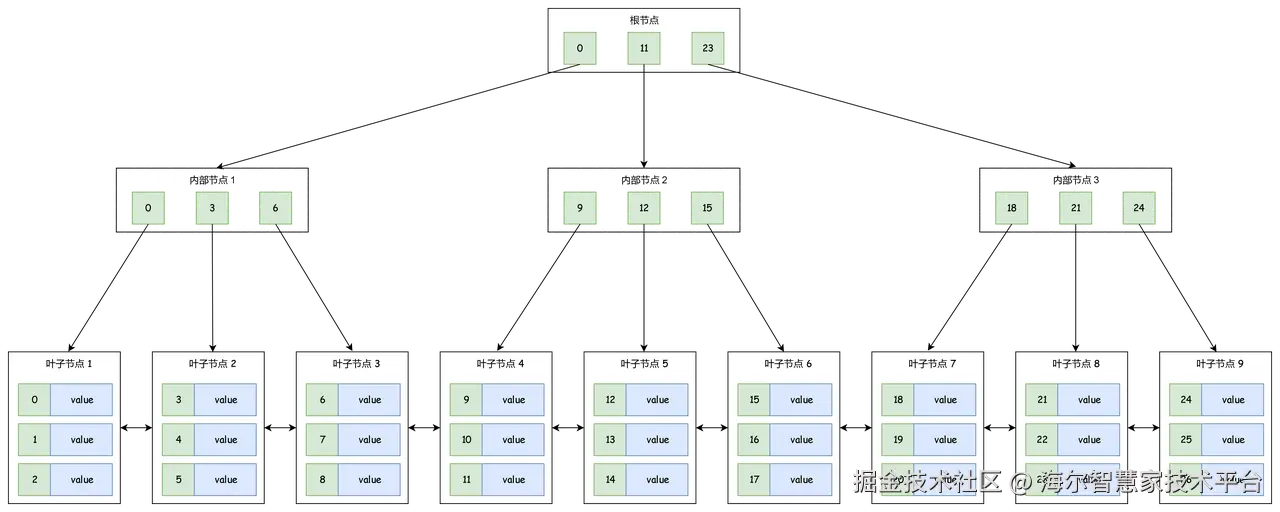
然而,这种有序结构也限制了其写入性能。当数据写入时:
- 磁盘随机写:即使顺序写入的业务数据,在 B+Tree 中也可能落在不同的叶子节点,导致物理磁盘上的随机 I/O。无论是 HDD 还是 SSD,随机写性能都远低于顺序写。
- 写入伴随读:为了定位数据插入的叶子节点,需要先多次读取内部索引节点,产生额外的 I/O。
- 昂贵的页分裂:当数据页写满时,会触发页分裂。这不仅是数据的移动,还需要更新父节点索引,带来显著的写放大。
正因如此,B+Tree 虽在读取场景表现出色,却难以应对大规模写入负载。
为优化写入密集型场景,日志结构合并树(Log-Structured Merge Tree,LSM-Tree) 应运而生。其核心思想非常巧妙:将对数据的"随机修改"转换为"顺序追加"。
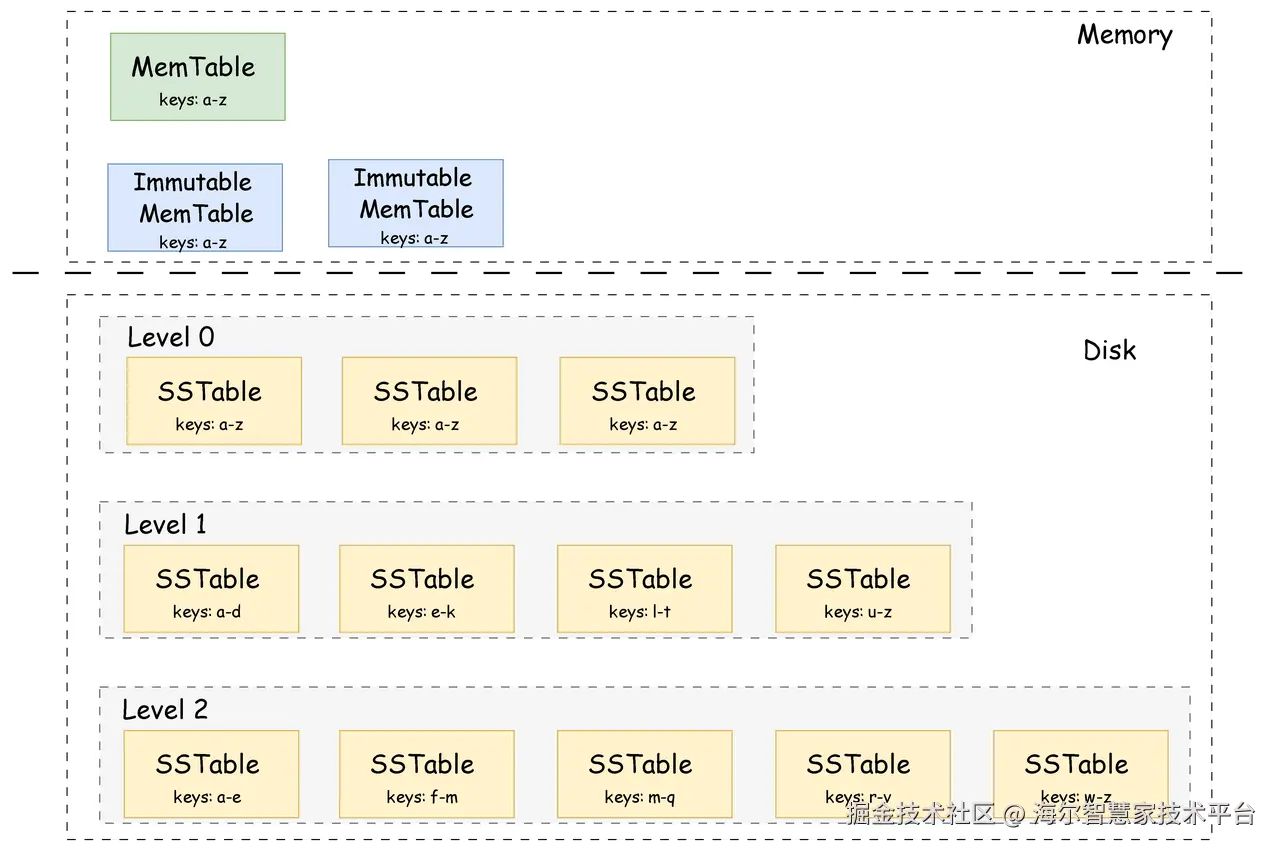
LSM-Tree 并非传统树形,而是一种多层次组合,数据在不同层级中按 Key 排序。其核心组件包括:
- MemTable:内存中的有序数据结构(RocksDB 使用跳表),充当写入缓冲区。
- Immutable MemTable:MemTable 写满后变为只读状态,等待刷盘,以此实现前台写入与后台落盘的无缝切换。
- SST(Static Sorted Table):磁盘上不可变的、有序的键值对集合文件。
当更新数据时,LSM-Tree 并不修改旧数据,而是直接将新数据以顺序写的方式写入最上层。这使得它能充分利用磁盘顺序 I/O 的高带宽。随着数据累积,通过后台的 Compaction 过程,将上层数据与下层数据合并,并清理过期数据,最终沉降到最底层。
简单来说,B+Tree 用写入的复杂性换取了读取的简单性,而 LSM-Tree 则用读取的复杂性换取了写入的高吞吐。
2.2 写入流程剖析
RocksDB 的写入流程可以划分为前台快速响应和后台异步处理两部分,这是提高吞吐的关键设计。
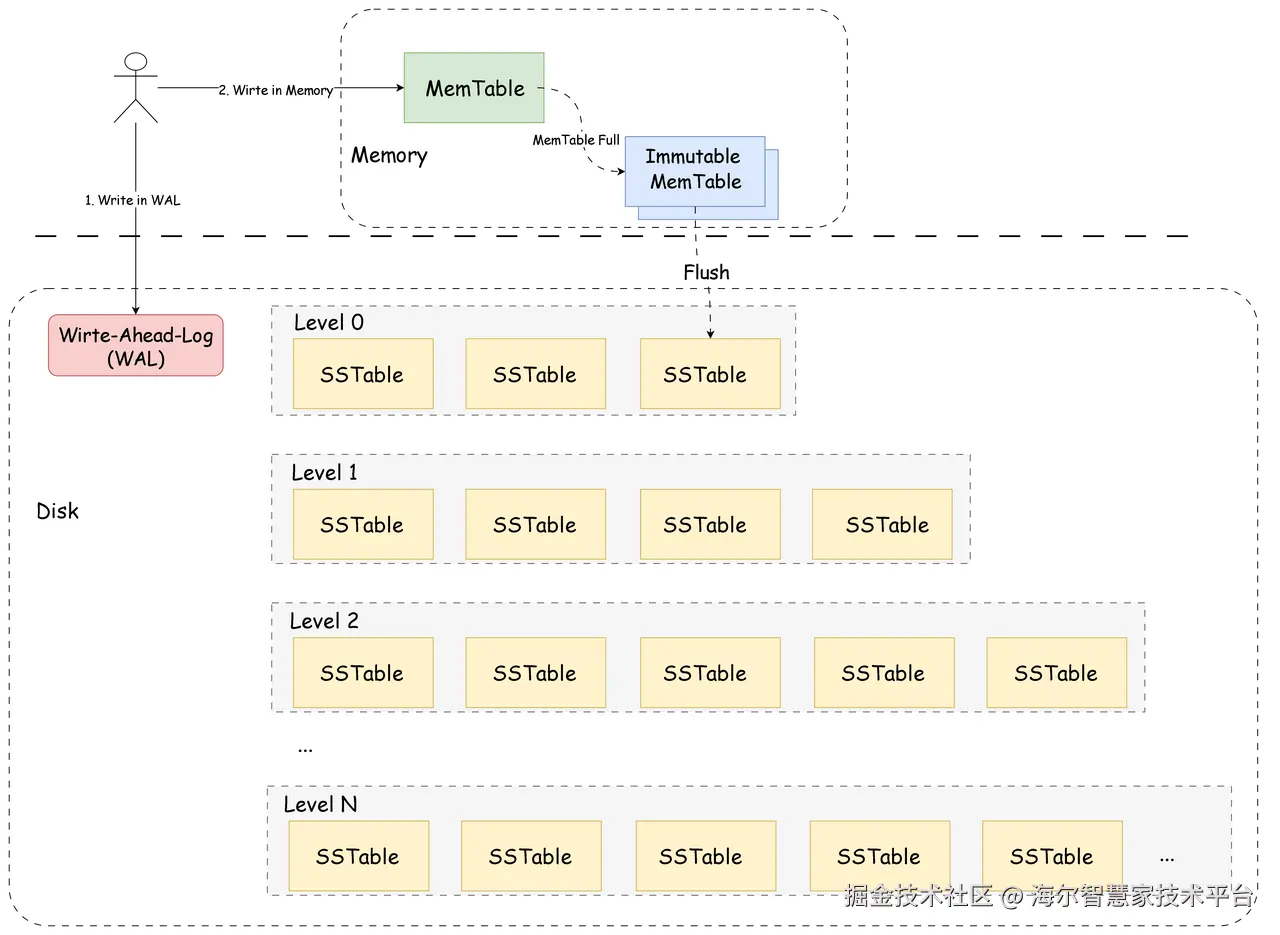
前台写入路径(极速响应):
- 写 WAL(Write-Ahead Log):首先将操作追加到预写日志,确保进程崩溃后数据可恢复。
- 写 MemTable:随后将数据插入内存中的 MemTable,此时即可向客户端返回写入成功。
后台处理路径(异步落盘):
- 当 MemTable 大小达到阈值,会切换为一个新的空 MemTable 继续服务写入。
- 满的 MemTable 转变为 Immutable MemTable,由一个后台线程将其有序地刷入磁盘,形成一个 L0 层的 SST 文件。
这个设计使得写入的关键路径(从接受请求到返回)非常短,仅涉及一次顺序写日志和一次内存操作,从而实现了极高的写入吞吐。
2.3 读取路径与性能优化
2.3.1 多级查询流程
LSM-Tree 的读取是一个从新到旧、自上而下的搜索过程。
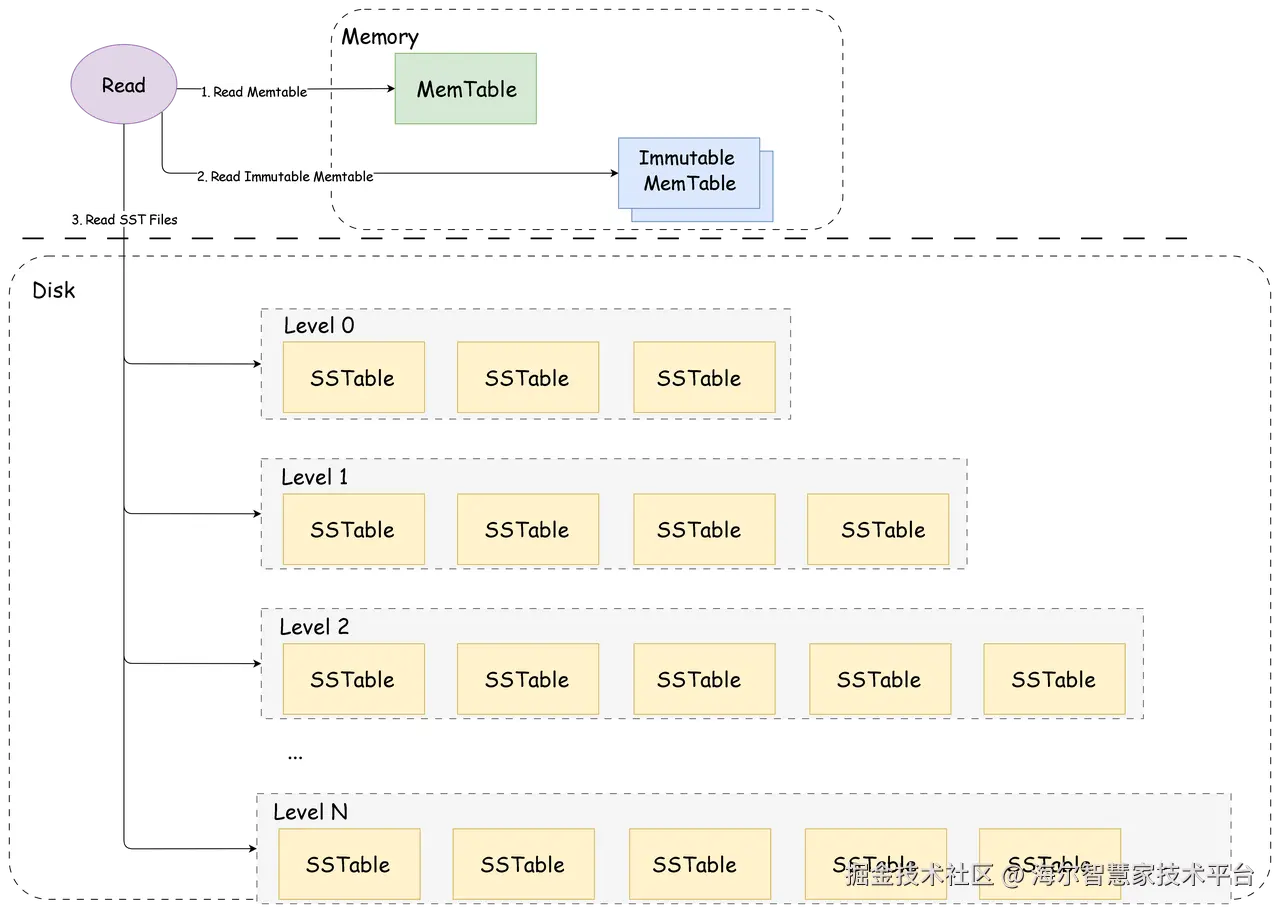
- 查询 MemTable/Immutable MemTable:首先在内存中的两个结构里查找最近写入的键值。
- 查询 L0 层 SST 文件:由于 L0 层的文件由 MemTable 直接刷盘而来,键范围可能重叠,因此需要检查所有相关的 L0 文件。
- 查询 L1 及以下层 SST 文件:从 L1 开始,每层内的 SST 文件键范围是不重叠且有序的。可以通过二分查找快速定位到可能包含 Key 的单个 SST 文件。
这种设计的代价是:读取延迟取决于数据的新旧程度。热点数据(在内存或上层)访问极快,而冷数据(在底层)则需要多次 I/O,延迟较高。
2.3.2 读优化:布隆过滤器、索引、缓存
为了对抗多层查找带来的潜在性能损耗,RocksDB 引入了多重优化机制。
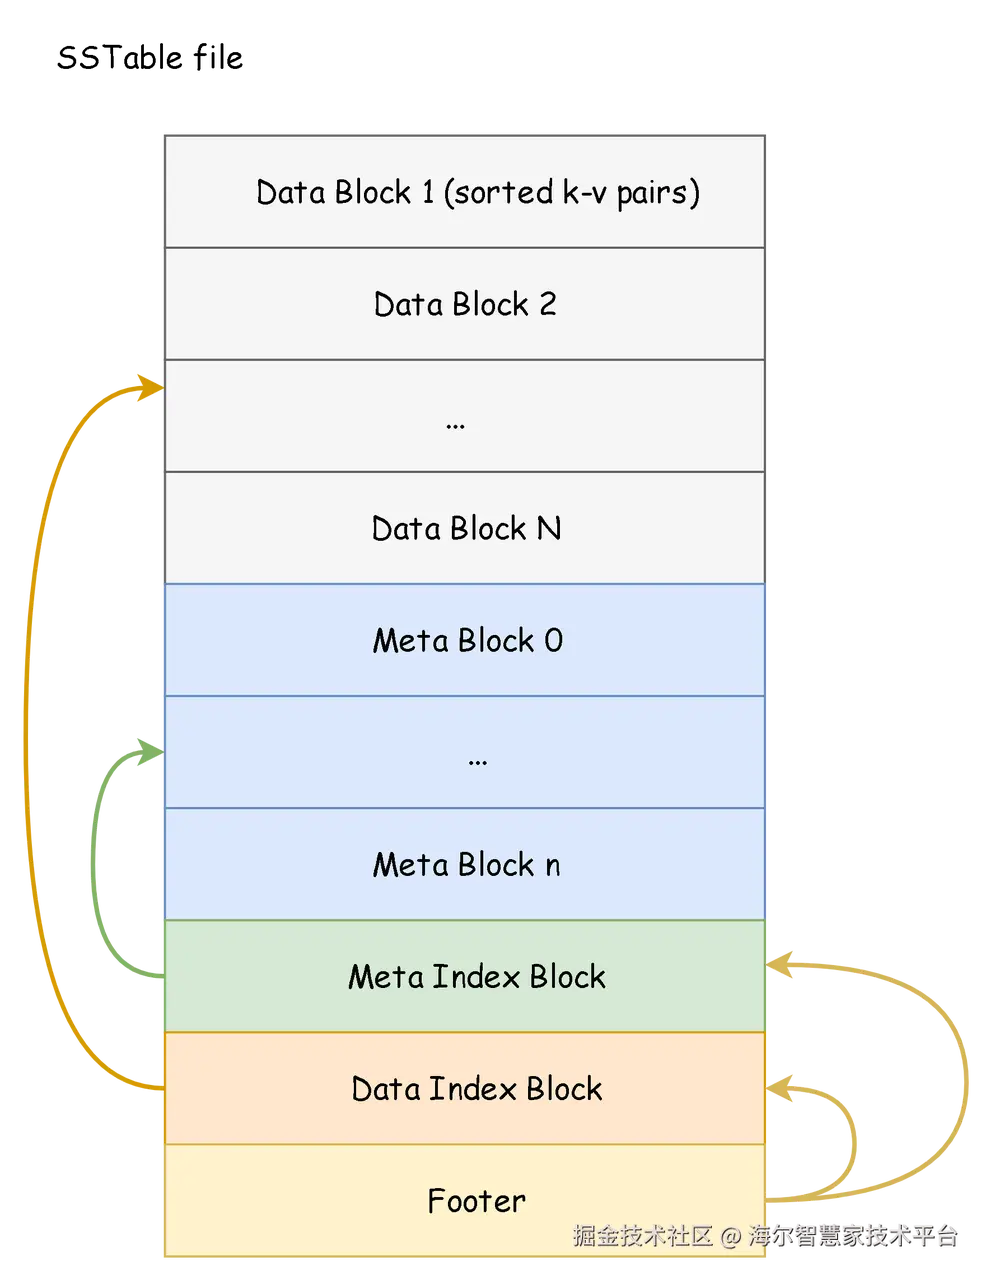
每个 SST 文件内部结构精巧,包含:
- Data Block:存储实际的键值对。
- Index Block:记录每个 Data Block 的偏移量和键范围,用于快速定位。
- Meta Block:其中最重要的是 Filter Block,它存储了布隆过滤器的位数组。
- MetaIndexBlock: 存储各个 meta block 在文件中的索引信息,用于快速定位。
- Footer:固定大小,用于索引 meta index block 和 data index block,以及存储用于解析校验文件的magic number、版本号
优化机制:
-
布隆过滤器 (Bloom Filter):一个概率数据结构,用于快速判断一个 Key 肯定不存在于某个 SST 文件中,存储在 filter block 中。能避免绝大多数对无效 SST 文件的昂贵磁盘访问。
-
索引: 利用 Index Block 进行二分查找,快速定位 Key 可能位于哪个 Data Block。
-
缓存 (Cache):
- Block Cache:缓存解压后的 Data Block,避免重复磁盘 I/O。
- Index/Filter Block Cache:将文件的索引和布隆过滤器缓存在内存中,加速定位过程。
通过这些优化,RocksDB 极大地弥补了 LSM-Tree 在读取路径上的先天不足,实现了读写性能的良好平衡。
2.4 LSM-Tree 的"平衡之术":Compaction
2.4.1 为何需要Compaction?
LSM-Tree 的"只追加"模式是一把双刃剑。它在带来写入高性能的同时,也导致了数据冗余(同一 Key 的多个版本)和空间放大。Compaction(压缩合并)正是解决这一问题的核心机制,它负责:
- 回收空间:清理被覆盖或删除的无效数据。
- 优化读取:减少需要查找的 SST 文件数量,提升读性能。
- 数据沉降:将数据从上层整理并移动到下层。
2.4.2 Compaction的核心过程与策略
Compaction 的核心是将有键范围重叠的 SST 文件进行多路归并排序,生成新的、有序的 SST 文件到下一层,并丢弃重复和已删除的旧数据。
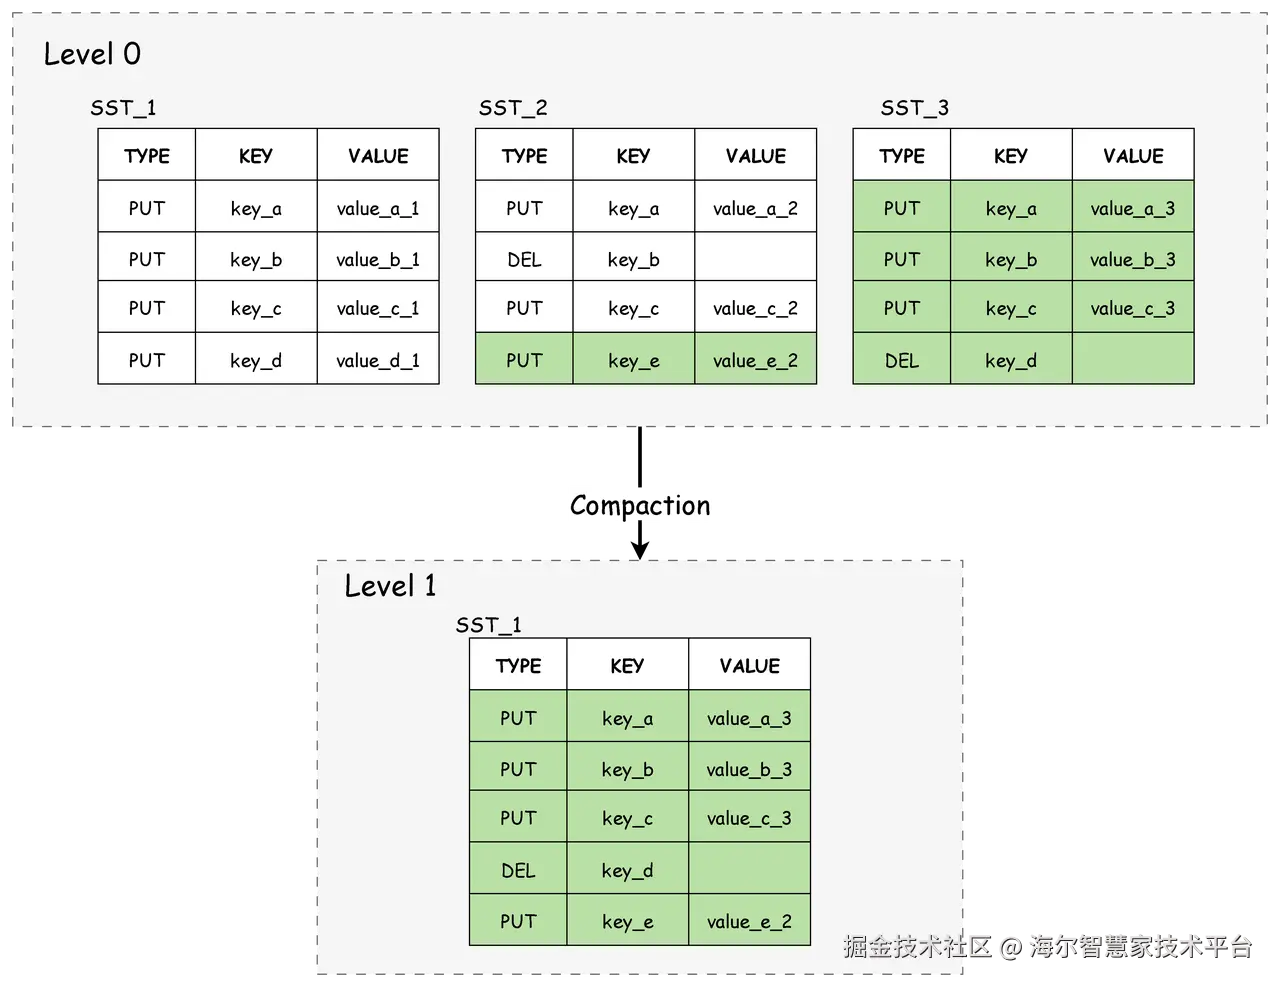
RocksDB 提供了多种不同的compaction策略,其中Leveled Compaction是默认的 Compaction是其默认策略。
使用Leveled Compaction时,除 L0 层中不同 SST 文件键范围会有重叠外,L1 及下层的SST文件在同层级内,键范围上没有交叠,并且SST文件之间有序。在进行 Compaction 时,会选择性地将某层的 SST 文件与下一层的有重叠键范围的 SST 文件进行合并。
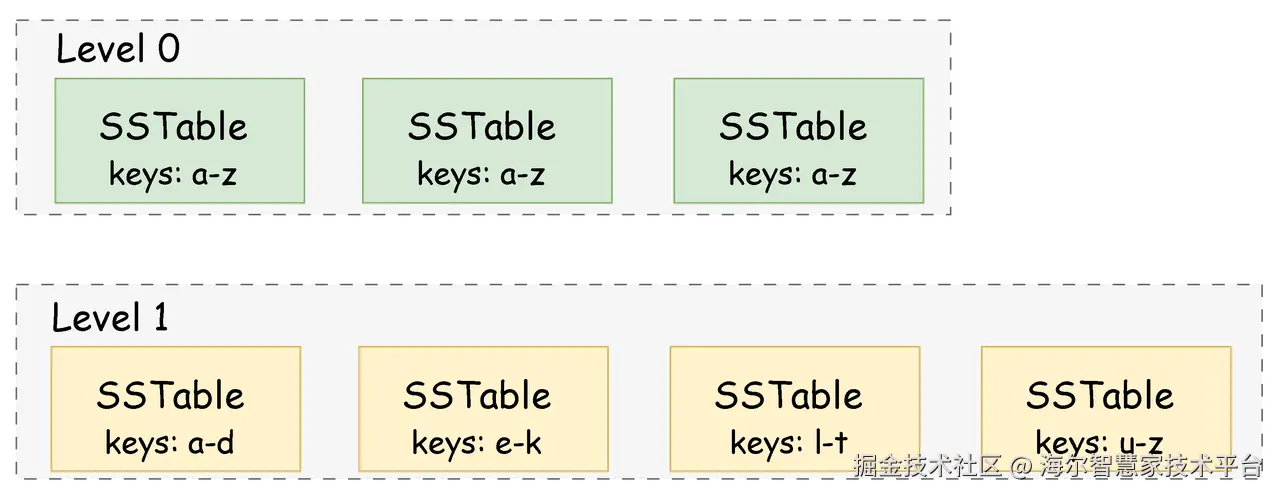
具体流程可从以下示例来看:
-
L0 到 L1 层进行 Compaction 时,L0 中 SST 文件的键范围覆盖了 L1 层的所有SST文件,此时需要对所有 L0 和 L1 的 SST 文件进行 Compaction。
- 在 Compaction 过程中,L0 的 SST 文件按照时间先后顺序,保留最新key,去除重复key,L1 中与 L0 重复的key 也一并删除。
- Compaction完成后生成的 SST 放置到 L1,原来 L0 和 L1 的 SST 文件被清理掉。
-
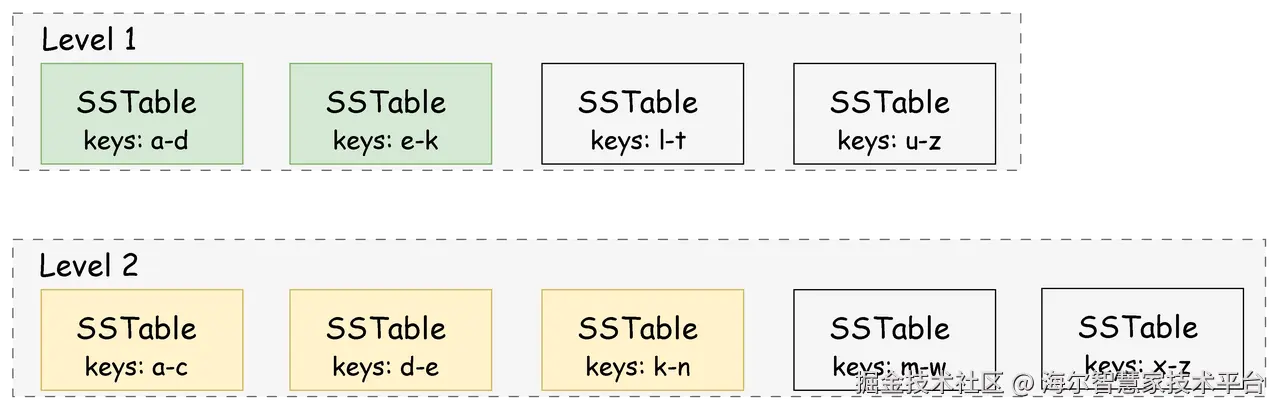
从 L1 到 L2 进行 compaction 时,根据选择的 L1 中 sst 文件的键范围,挑选出 L2 中与该键范围存在重叠的 sst 文件,依然是 L1 更新的数据覆盖 L2 中冗余的数据。
Compaction 由专用后台线程池执行,其触发条件(如层数、文件大小和数量)均可配置,以实现资源消耗与性能之间的平衡。
2.4.3 性能的双刃剑:写放大与资源抖动
Compaction 最大的副作用是写放大(Write Amplification) 。用户写入 1KB 数据,在 Compaction 过程中可能会被反复读取和重写,最终导致存储设备实际写入 10KB 甚至更多。这不仅是性能问题,也会缩短 SSD 的使用寿命。
写入放大(Write amplification) 是指写入存储的字节数与写入数据库的字节数之间的比率,量化了存储系统为适应用户写操作而产生的额外I/O操作。写入放大率反映了数据写入底层存储的效率,写入放大率过高会增加存储设备的磨损,影响系统性能。
此外,密集的 Compaction 会占用大量 CPU 和 I/O 资源,可能引起应用读写延迟的周期性抖动。
业界对此的优化思路主要分为两类:
- KV 分离(如 Wisckey 思路,RocksDB 的 BlobDB):将大 Value 从 LSM-Tree 中分离出来单独存储,LSM-Tree 内只存 Key 和小尺寸的 Value 指针,显著减小了 Compaction 的数据量。
- LSM-Tree 分片(如 PebblesDB):通过引入"Guards"将每层切分为多个碎片,使得 Compaction 可以更细粒度地进行,控制单次操作的影响范围。
这些方案在降低 Compaction 开销的同时,也引入了诸如范围查询性能下降、实现复杂性增加等新挑战,是需要根据业务场景权衡的工程选择。
3. 存储思想的融合与演进
在深入了解了 RocksDB 之后,回看 MySQL 和 Redis 等常用组件,我们会发现其中许多设计思想殊途同归。现代数据库的发展,正是一个不断相互借鉴与融合的过程。
3.1 MySQL: 缓存设计与存储引擎的演进
3.1.1 共通的基石:WAL与缓冲池
尽管架构迥异,但 MySQL(InnoDB) 与 RocksDB 在保证数据可靠性与提升写入性能的核心思想上高度一致,都采用了经典的 Write-Ahead Logging (WAL) 和 内存缓冲 机制。
-
InnoDB 的"内存缓冲 + Redo Log":
- 数据修改并非直接写盘,而是在内存的 Buffer Pool 中完成,并将数据页标记为"脏页"。
- 同时,事务的修改会先被顺序写入 Redo Log 文件,事务提交即保证 Redo Log 落盘。
- 脏页由后台线程在适当时机刷回磁盘数据文件(随机IO)。
-
思想的交融:
- InnoDB 的
Redo Log本质上就是 RocksDB 的 WAL。 - InnoDB 的
Buffer Pool扮演了类似 RocksDB MemTable 的缓冲角色。 - 两者的核心思路都是:利用顺序追加写的日志保证持久化,利用内存缓冲承接随机写入并批量刷盘,以此在保证可靠性的前提下,最大化I/O效率。
- InnoDB 的
3.1.2 存储引擎的实践:MyRocks
为解决 InnoDB 在大规模写入场景下的瓶颈,Facebook 推出了 MyRocks------一个将 RocksDB 作为 MySQL 存储引擎的项目。它对应用层基本透明,相较于 MySQL,MyRocks 存在的主要优势和劣势也都体现在底层存储引擎的不同:
-
优势:
- 存储空间利用更高效:没有 B+Tree 节点填充率的问题,不存在空间碎片
- 写放大更低:写入仅需写内存缓冲和 WAL,后台 Compaction 批量合并 SST 文件,避免了每次写入都要修改整个数据页的开销(随机更新场景,写放大为页大小/记录大小),提高磁盘使用寿命
- 写入性能更高:所有更新操作都以顺序写的方式落盘,避免了B+Tree原地更新节点导致的磁盘随机写,写入速度更快。
-
劣势:
- 点查性能较低:尽管通过缓存、索引、布隆过滤器的方式加速了查询,但极端情况下可能需要扫描所有SST,P99延迟高。
- 范围扫描性能低:B+Tree中叶子节点可通过以双向链表组织的方式实现高效的范围扫描,而 LSM-Tree 范围扫描需要组合多层多 SST 文件数据,扫描效率低。
总体来说,相比使用 InnoDB 的 MySQL,MyRocks占用更少的存储空间,能够降低存储成本;更小的写放大比,延长了磁盘使用寿命;将随机写变为顺序写,提高了写入性能。因此,在数据量大、写入密集、对读取延迟不敏感的业务场景下(如日志采集、用户行为统计、物联网数据)非常适用。
3.2 探索Redis:AOF与冷热数据分离的实践
3.2.1 AOF Rewrite:Redis 的 "Compaction"
Redis 的 AOF(Append-Only File)持久化模式,是 WAL 思想的又一个经典体现。它通过顺序记录每一条写命令来保证数据安全。但如同 LSM-Tree 需要 Compaction,AOF 文件也会因不断追加而膨胀,包含大量过期操作。
Redis 的解决方案是 AOF Rewrite。其过程与 LSM-Tree 的 Compaction 神似:
- fork 子进程,基于当前内存数据快照,构建一个新的 AOF 文件。这个过程将多个操作合并为最终状态,清除了冗余命令。
- 重写期间的新写操作,不仅写入原有 AOF,还会被缓存起来。
- 重写完成后,将缓存的新操作追加到新 AOF 文件,然后原子替换旧文件。
这正是一种 "归并"与"清理" 的思想,目的是将多个增量更新合并为最终状态,以空间换取后续的读取效率。
3.2.2 冷热数据分离:Redis On Rocks 实践
Redis 的核心价值在于其内存级的访问速度,但内存的成本与容量限制也成为其天花板。随着高性能 SSD(如 NVMe)的普及,其延迟已接近 Redis 本身的网络处理延迟,这为架构创新提供了可能。
以 Redis on Rocks(如携程的实现)为代表的冷热分离架构应运而生,其核心思想如下:
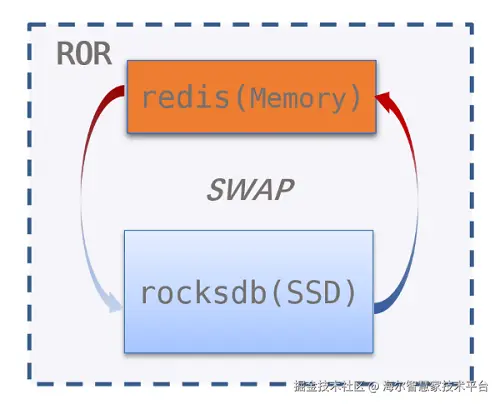
- 热数据:驻留内存,保持原生 Redis 数据结构,提供极致访问速度。
- 冷数据:溢出于 RocksDB 中,以键值形式存储在 SSD 上,成本大幅降低。
- 自动交换:系统自动管理数据在内存与 SSD 之间的换入/换出。访问冷数据时,将其提升至内存;当内存满时,将部分数据降级到 RocksDB。
这种设计巧妙地结合了 Redis 的内存速度与 RocksDB 的大容量低成本存储优势,实现了 性能与成本的平衡,是 LSM-Tree 在现代缓存系统中扮演新角色的典范。
4. Java API与快速入门
RocksDB 为 Java 生态提供了完整的原生绑定 ------ RocksJava。通过 Maven 等构建工具,可以轻松将 RocksDB 集成到 Java 应用中。
4.1 项目依赖与初始化
首先,在项目的 pom.xml 中添加官方依赖即可引入 RocksJava:
xml
<dependency>
  <groupId>org.rocksdb</groupId>
  <artifactId>rocksdbjni</artifactId>
  <version>6.6.4</version>
</dependency>
4.2 核心API与使用示例
下面的示例完整演示了 RocksDB 的打开数据库、写入、读取、删除和关闭资源的基本生命周期。
java
import org.rocksdb.Options;
import org.rocksdb.RocksDB;
import org.rocksdb.RocksDBException;

import java.util.Arrays;

/**
 * RocksDB 快速入门示例
 * 演示了数据库的基本操作:创建、写入、读取、删除。
 */
public class RocksDBSample {
    static {
        // 初始化并加载 RocksDB 的本地共享库
        RocksDB.loadLibrary();
    }

    public static void main(final String[] args) {
        if (args.length < 1) {
            System.out.println("usage: RocksDBSample db_path");
            System.exit(-1);
        }
        final String db_path = args[0];

        // 使用 try-with-resources 确保 Options 和 RocksDB 对象被正确关闭,防止资源泄漏
        try (final Options options = new Options().setCreateIfMissing(true)) {
            // 在指定的路径下打开数据库
            final RocksDB db = RocksDB.open(options, db_path);

            // 示例键值对
            final byte[] key = "hello".getBytes();
            final byte[] value = "world!".getBytes();

            // 1. 写入操作 (Put)
            db.put(key, value);
            System.out.format("Successfully put key: '%s'\n", new String(key));

            // 2. 读取操作 (Get)
            final byte[] result = db.get(key);
            assert(result != null);
            assert(Arrays.equals(result, value));
            System.out.format("Get key : %s, value: %s\n", new String(key), new String(result));

            // 3. 删除操作 (Delete)
            db.delete(key);
            System.out.format("Successfully deleted key: '%s'\n", new String(key));

            // 验证删除
            final byte[] resultAfterDelete = db.get(key);
            assert(resultAfterDelete == null);
        } catch (RocksDBException e) {
            System.out.format("Caught rocksdb exception: %s\n", e.getMessage());
        }
        // try-with-resources 块结束,db 和 options 会自动调用 close() 方法,安全释放资源
    }
}
4.3 核心对象与最佳实践解析
Options:数据库配置容器。通过.setCreateIfMissing(true)可在数据库不存在时自动创建,这是最常用的配置之一。RocksDB.open():根据配置和路径打开(或创建)数据库实例。这是一个重量级操作,应复用该实例。- 资源管理:
RocksDB和Options都实现了AutoCloseable接口。建议使用try-with-resources语法,以确保数据库句柄和底层资源(如缓存、文件锁)能被正确释放,避免内存泄漏和数据损坏。 - 异常处理:
RocksDBException是几乎所有操作都可能抛出的受检异常。 - 字节数组操作:RocksJava API 直接使用
byte[]进行键值传递,赋予其极大的灵活性,开发者需自行处理序列化与反序列化。
通过这个简单的例子可以掌握集成和使用 RocksDB 的基本方法。在实际生产中,还需要根据业务场景配置更复杂的选项,如合并操作、列族、压缩策略等,以充分发挥其性能。
5. 总结
RocksDB 作为高性能嵌入式键值存储引擎,依托 LSM-Tree 架构的核心优势,将随机写入转化为顺序追加,实现高吞吐写入、大容量存储与持久化低延迟读写,成为现代应用存储技术栈的关键补充组件。
作为生产级 KV 存储,RocksDB 提供了内存控制、数据压缩等丰富的定制化配置,适配从微型到大型系统的多样化场景。适合作为应用内高性能本地存储,或在其基础上构建功能更加丰富的数据存储、分布式系统。
6. 参考资料
GitHub - ctripcorp/Redis-On-Rocks: Redis in CTRIP
团队介绍
「智慧家技术平台-应用软件框架开发」主要负责设计工具的研发,包括营销设计工具、家电VR设计和展示、水电暖通前置设计能力,研发并沉淀素材库,构建家居家装素材库,集成户型库、全品类产品库、设计方案库、生产工艺模型,打造基于户型和风格的AI设计能力,快速生成算量和报价;同时研发了门店设计师中心和项目中心,包括设计师管理能力和项目经理管理能力。实现了场景全生命周期管理,同时为水,空气,厨房等产业提供商机管理工具,从而实现了以场景贯穿的B端C端全流程系统。