做导航站的技术门槛不高,难的是两件事:让搜索引擎抓到内容,以及别让收录的链接死掉。
这篇写我做 123工具箱(www123.net)时踩过的几个坑,代码层面的东西居多。
技术栈是 NestJS + TypeORM + MySQL 做后端,Nuxt 3 做前台,Vue 3 + Element Plus 做管理后台,PM2 托管三个进程。
一、为什么必须做 SSR
导航站最怕的是首页一堆异步加载。搜索引擎爬虫拿到 HTML 时列表还是空的,收录页就是一张白纸。
我用 Nuxt 3 的 SSR,首页、分类页、详情页的列表都在服务端渲染完再返回。
验证方法很简单:
perl
curl -s https://www123.net/ | grep -c "category/"返回 0 就说明列表没直出。如果 HTML 里只有 <div id="app"></div>,那基本等于没做 SEO。
检查的时候别只看首页,分类页和详情页也要抽查,这两个页面才是长尾流量的入口。
配套的还有 sitemap 和 robots。
sitemap 里跳过不存在的分类和未发布的详情页。robots 里屏蔽 /admin、/api/、/search? 和 /go/。搜索页和跳转页放进来会让爬虫陷进无限 URL。
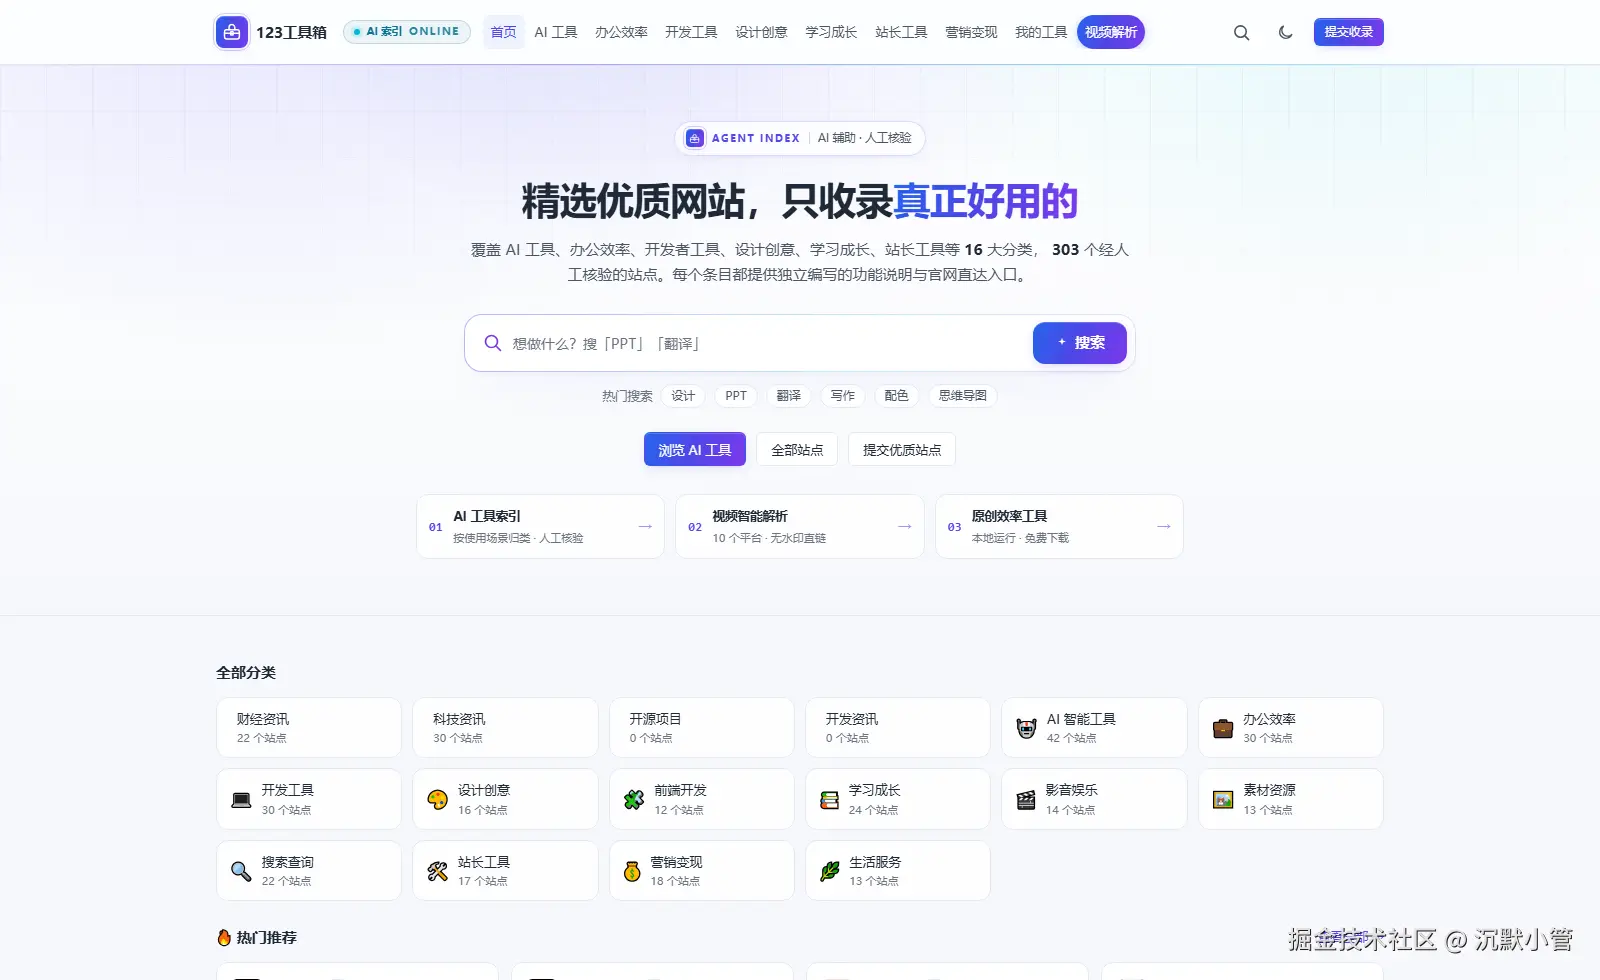
传图说明:这张是 SSR 直出后的首页,
curl拿到的 HTML 里已经有这些分类链接。
二、收录状态要能下架,但不能直接删
链接失效是导航站的慢性病。
我的做法是给每个站点加状态字段,定期跑一遍 HEAD 请求:
php
// 简化后的检查逻辑
const res = await fetch(site.url, {
method: 'HEAD',
signal: AbortSignal.timeout(8000),
redirect: 'follow',
}).catch(() => null);
if (!res || res.status >= 400) {
site.failCount += 1;
if (site.failCount >= 3) site.status = 'pending_review';
}连续失败三次标记为待复核,人工确认后下架,而不是直接删。
为什么不当场删:直接删会让已有外链变成 404,反而损失权重。下架是保留详情页但返回 410,告诉搜索引擎这个页面永久移除了,比 404 干净。
三、视频解析为什么只敢标「尽力解析」
这块是自研的,没有用第三方解析 API。
抖音 :短链要先 302 拿到 aweme_id,再请求分享页拿 _ROUTER_DATA。
这里有个坑。不带 ttwid 只能拿到一个几十 KB 的验证壳,带上移动端 UA 和 ttwid 才是完整的页面,能差出十几 KB 的真实内容。
ttwid 可以自己注册,不用登录:
php
const reg = await fetch('https://ttwid.bytedance.com/ttwid/union/register/', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({
    region: 'cn',
    aid: 1768,
    needFid: false,
    service: 'www.ixigua.com',
    migrate_info: { ticket: '', source: 'node' },
    union: true,
  }),
});
const ttwid = reg.headers.getSetCookie()
  .find(c => c.startsWith('ttwid='))
?.split(';')[0];B站:走的是 WBI 签名。
nav 接口返回的 wbi_img 里是完整 URL,签名用的 key 要从文件名里截,不是直接取 img_key 字段。这一步错了会一直返回 403,而且报错信息不会告诉你是签名问题。
ini
const { wbi_img } = await fetch('https://api.bilibili.com/x/web-interface/nav').then(r => r.json());
const imgKey = wbi_img.img_url.split('/').pop().split('.')[0];
const subKey = wbi_img.sub_url.split('/').pop().split('.')[0];
// 再用这两个 key 走标准的 mixinKey 流程
拿到直链还不能直接用。
平台有 Referer 防盗链,浏览器也不能跨域请求。所以下载走的是后端流式代理,域名白名单只放平台 CDN,防止 SSRF。转发时补上 Referer,透传 Range,支持断点续传。
白名单这块别偷懒。只校验域名后缀不够,evil-douyin.com 这种也能过。要么用精确后缀匹配,要么解析出主机名再做白名单。
四、最坑的是假成功
有些链接返回 200,内容却是个 ZIP 或者占位图。
我一开始看到 200 OK 就当成功了,结果用户下载下来是个打不开的压缩包。后来加了文件头校验:
vbscript
const res = await fetch(url, { headers: { Range: 'bytes=0-31', Referer } });
const buf = Buffer.from(await res.arrayBuffer());
// ftyp = MP4, 1A45DFA3 = WebM, #EXTM3U = HLS
const ok = buf.subarray(4, 8).toString() === 'ftyp'
|| buf.subarray(0, 4).toString('hex') === '1a45dfa3'
|| buf.subarray(0, 7).toString() === '#EXTM3U';
// PK = ZIP, 一律拒绝
if (buf.subarray(0, 2).toString() === 'PK') return false;宁可返回失败,也不能给用户一个下载下来打不开的文件。这个判断标准比成功率重要。
十个平台里,抖音、B站、微博是稳定的,另外七个标「尽力解析」。平台一改版就可能失效,这个没法承诺。
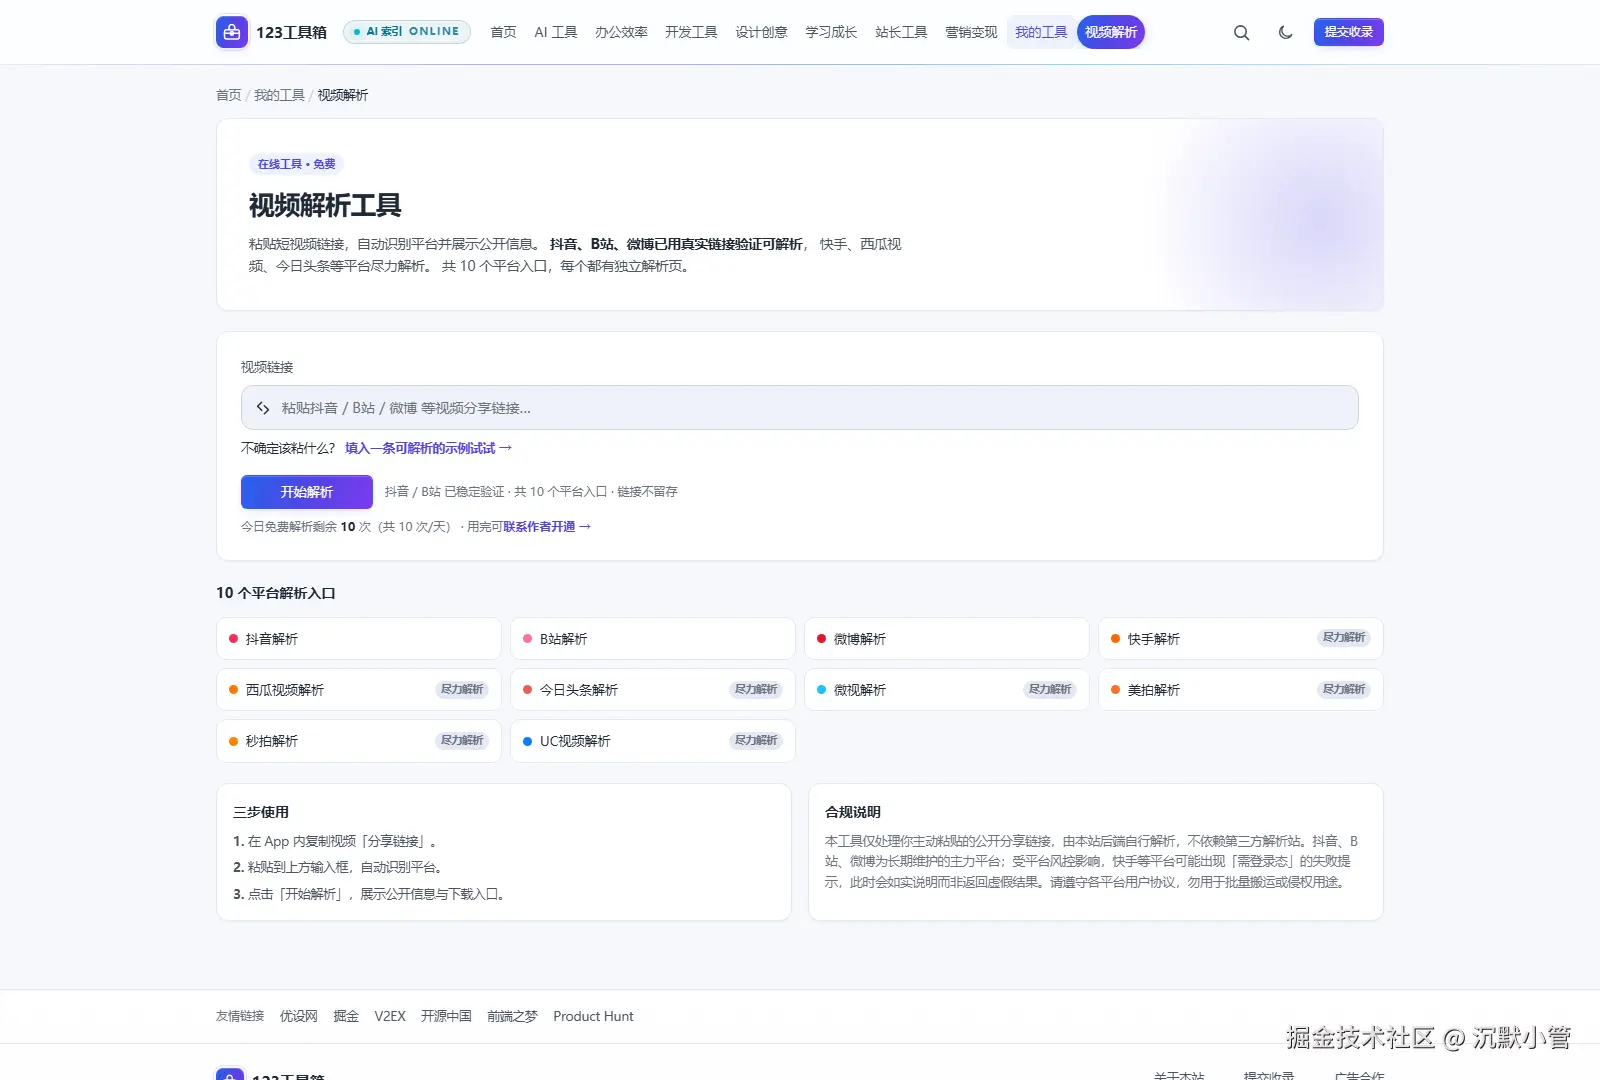
传图说明:页面右侧能看到十个平台入口,三个紫色标「稳定」,七个灰色标「尽力解析」。
五、内容运营比技术难
站里现在十六个分类,每个站点的简介都是手写的。
这件事没法自动化,也没法外包。AI 能帮你写,但写出来全是「一站式解决方案」,用户看完还是不知道这工具干嘛的。
我的判断标准是:简介里必须出现一个具体场景。
写不出来,说明这个站我自己都没用过,那就不收录。
技术能解决「让搜索引擎找到你」,解决不了「让人留下来」。后者只能靠一个个条目手写。