10000 个请求、800 QPS、数据库 300 QPS,三种缓存故障跑下来,数据库峰值最高冲到 800,失败请求最多 8393 个。
我把这套对照做成一个离线网页,9 组配置一屏跑完,页内 12 条断言全部通过。
在线案例与源码:gitcode.com/OPCTeam/dem... 成品只有一个 index.html,双击就能打开。
一、为什么值得看:三种崩法不是同一个问题
缓存穿透是查不存在的数据,缓存永远不命中。
缓存击穿是一个热 key 过期,所有请求同时回源。
缓存雪崩是一批 key 在同一秒过期,数据库瞬间被压满。
名字像,修法完全不同:空值缓存、互斥重建、TTL 抖动。
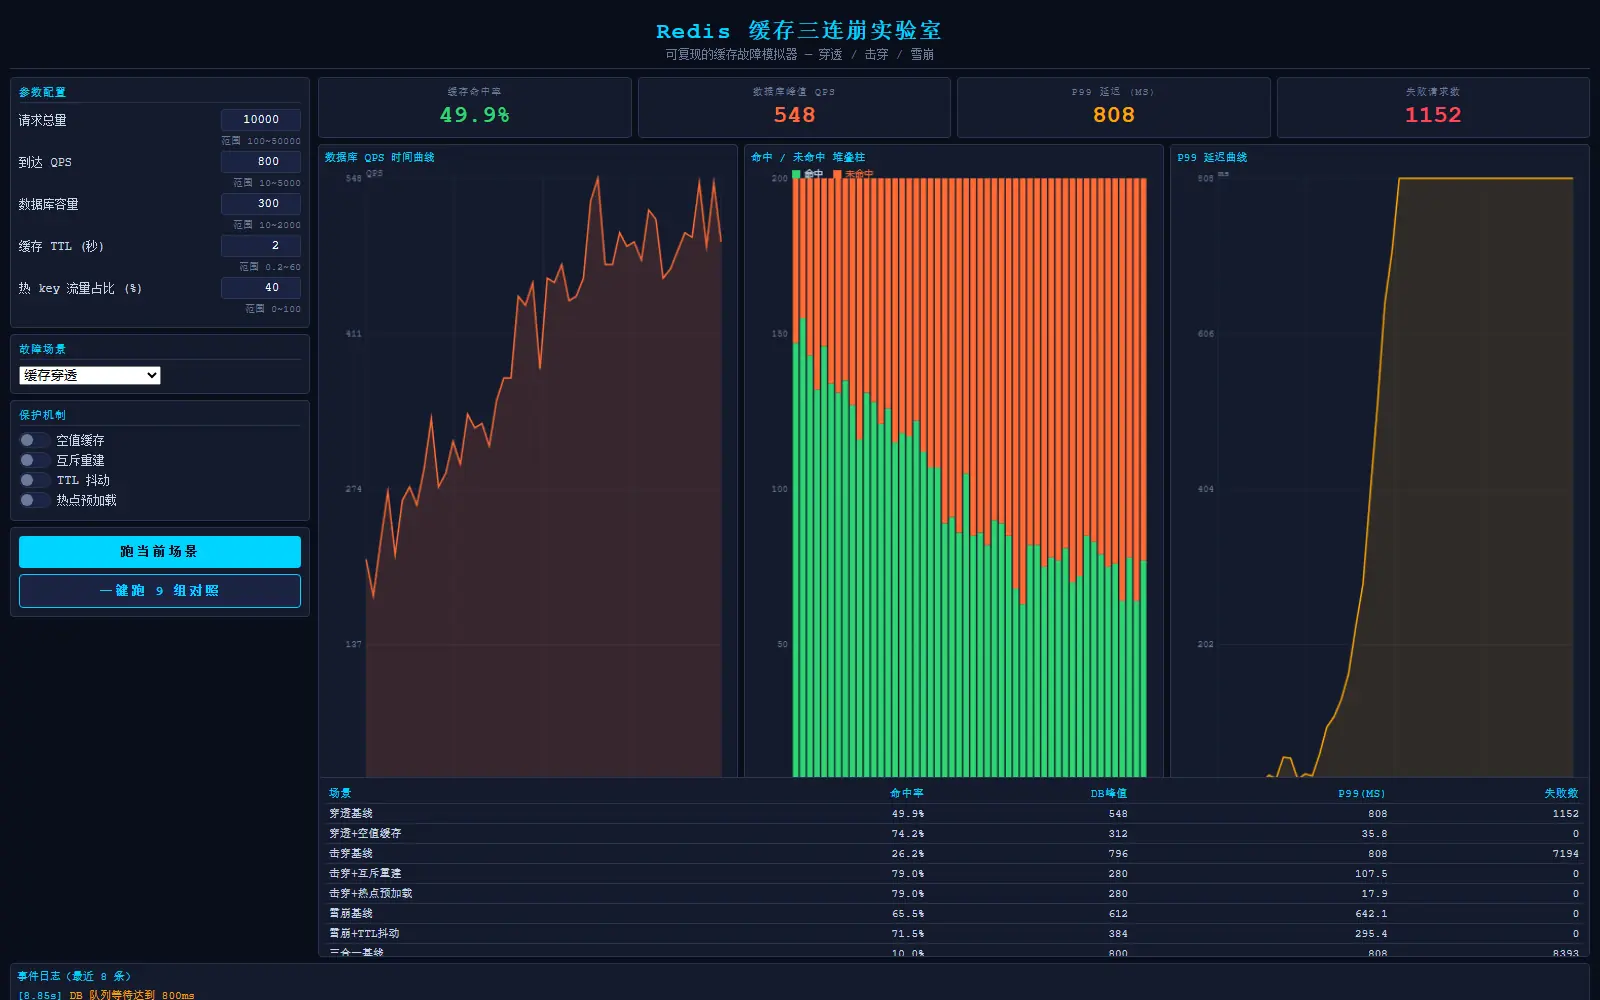
我拿同一套 10000 请求跑三遍,数据库峰值分别是 548、796、612 QPS。
三个数字差出一截,说明它们根本不是同一种病。
二、准备环境:进入码道 Web
登录后在对话框里写需求,不用装软件。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
三、需求原文:把模拟规则写死
我把五个参数写进需求:请求总量 10000、到达 800 QPS、数据库 300 QPS、TTL 2 秒、热 key 占比 40%。
随机数用 mulberry32,种子固定 20261113,每次运行都从同一条序列开始。
数据库按单队列算,服务能力等于容量,排队超过 800ms 记失败。
热 key 重建按一次 120ms 的慢查询算,这个假设后面会单独说。
第一版交回来只有 5/12,问题不在界面,在模型。
四、实测:9 组流量跑出来的数字
| 场景 | 命中率 | 数据库峰值 QPS | P99 (ms) | 失败请求 |
|---|---|---|---|---|
| 穿透基线 | 49.9% | 548 | 808 | 1152 |
| 穿透+空值缓存 | 74.2% | 312 | 35.8 | 0 |
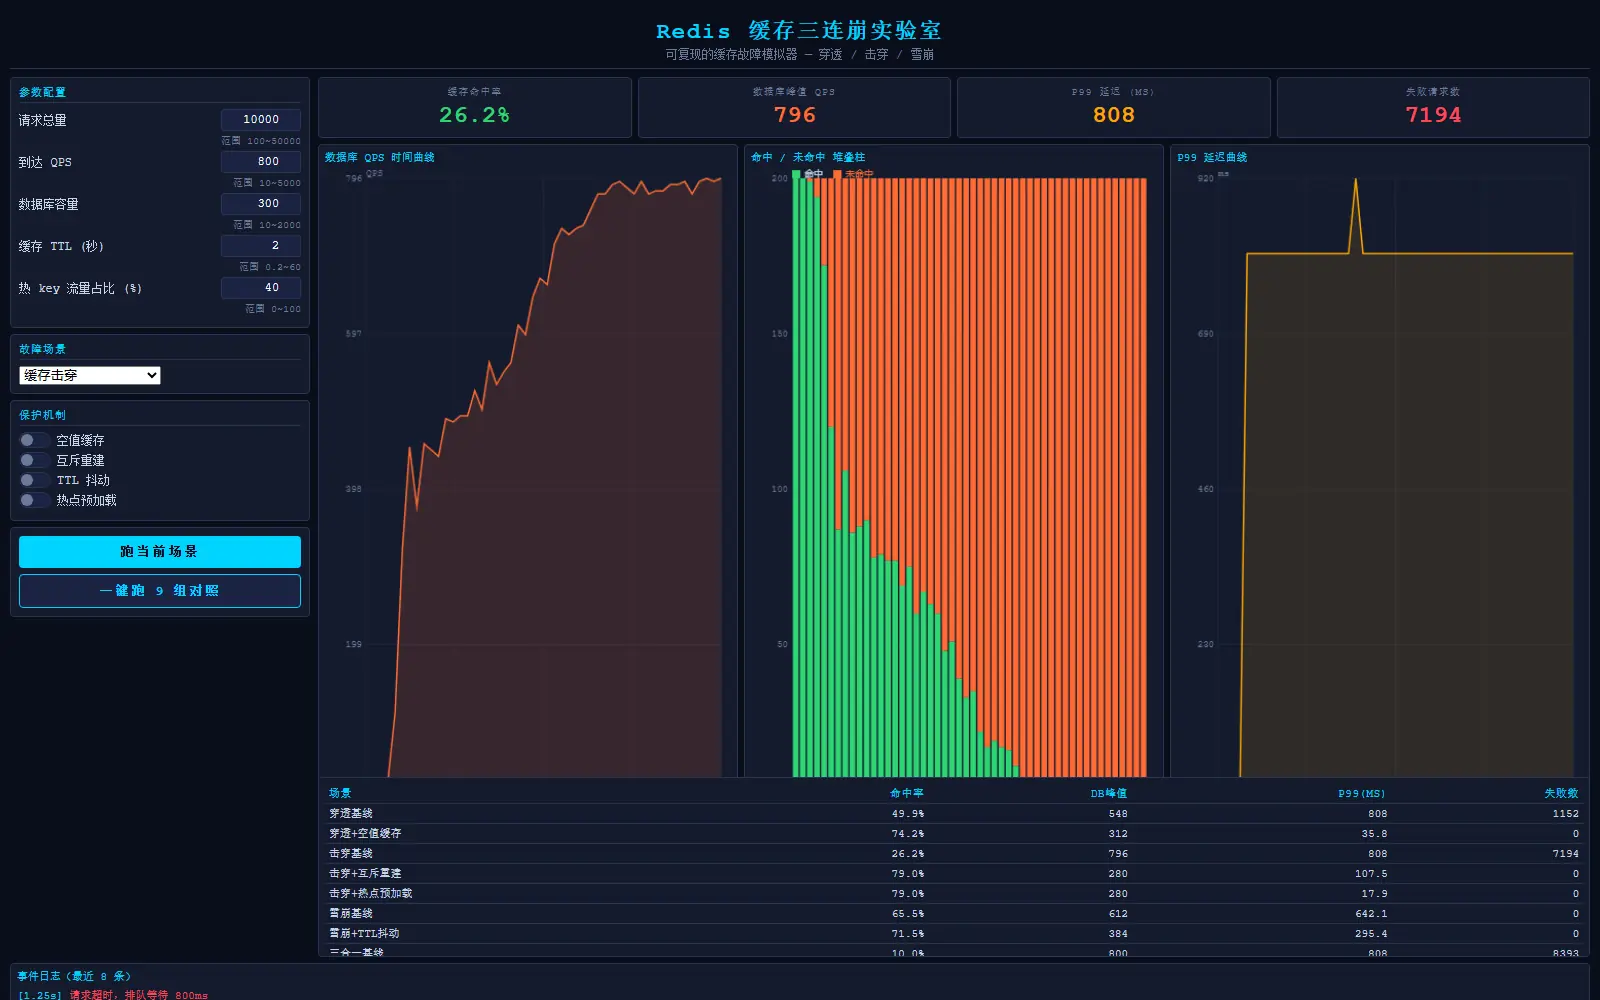
| 击穿基线 | 26.2% | 796 | 808 | 7194 |
| 击穿+互斥重建 | 79.0% | 280 | 107.5 | 0 |
| 击穿+热点预加载 | 79.0% | 280 | 17.9 | 0 |
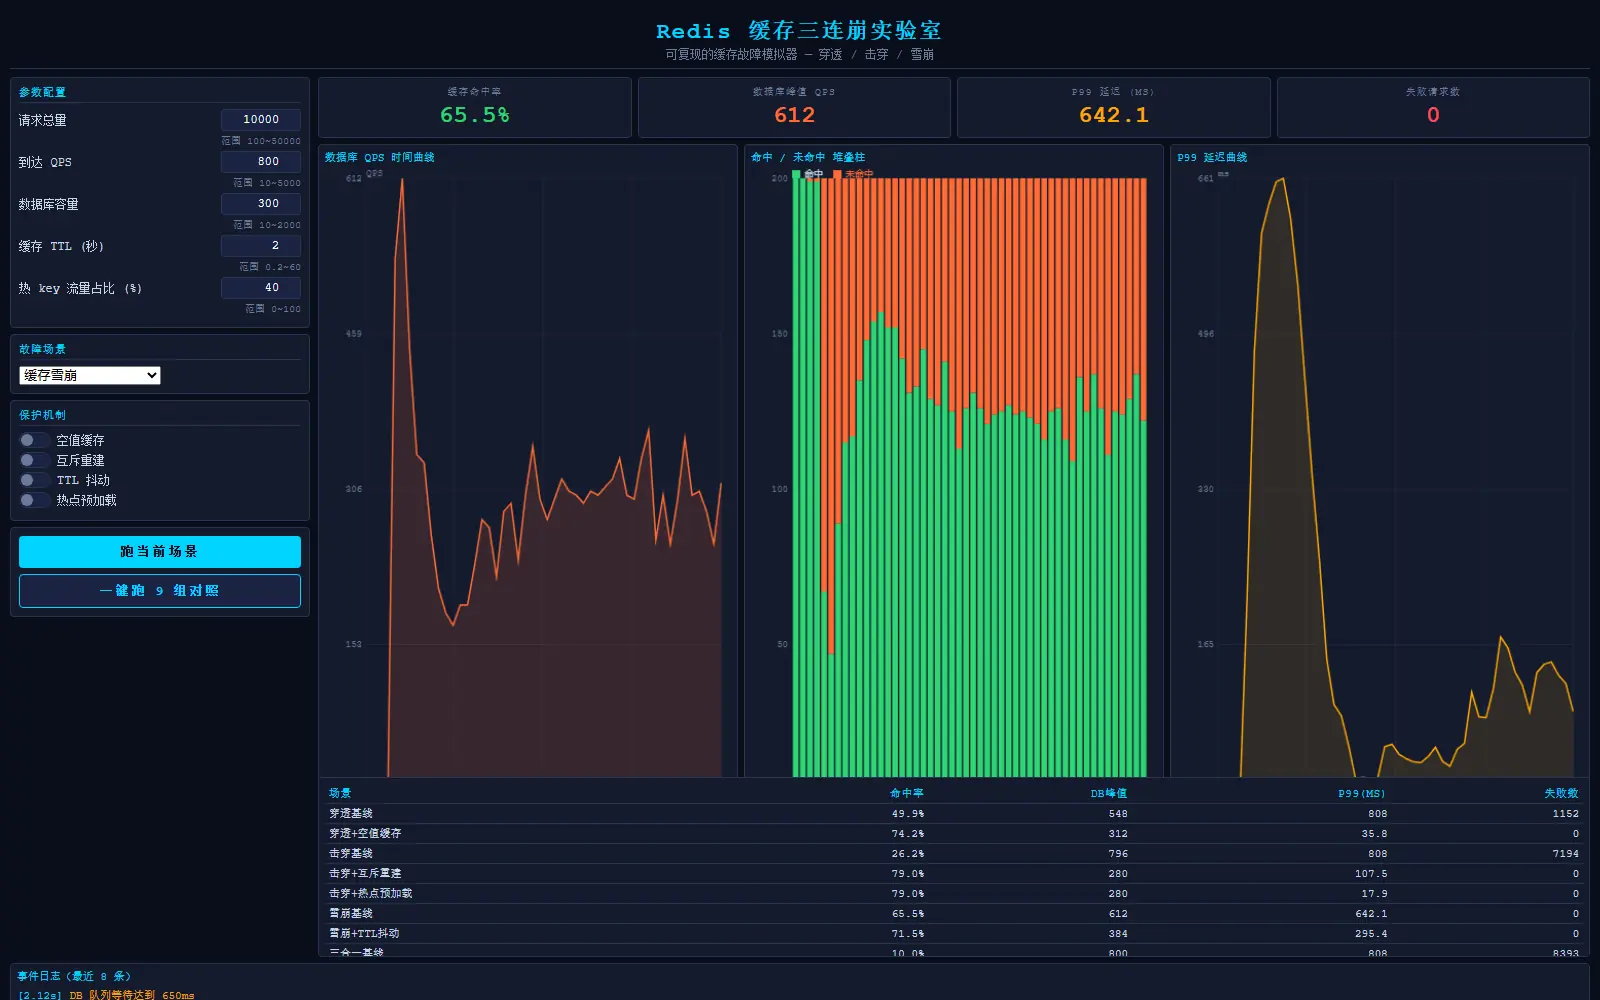
| 雪崩基线 | 65.5% | 612 | 642.1 | 0 |
| 雪崩+TTL 抖动 | 71.5% | 384 | 295.4 | 0 |
| 三合一基线 | 10.0% | 800 | 808 | 8393 |
| 三合一+全部保护 | 78.3% | 300 | 13.7 | 0 |
击穿基线最难看:命中率 26.2%,数据库峰值 796 QPS,7194 个请求排队超过 800ms。
打开互斥重建,峰值掉到 280 QPS,失败清零。
只开热点预加载也能把 P99 从 808ms 压到 17.9ms,但那是把热 key 的寿命拉长,不是重建变快。
雪崩基线峰值 612 QPS,P99 642.1ms,失败数是 0,但延迟已经很难看。
TTL 抖动把峰值压到 384 QPS,P99 降到 295.4ms。
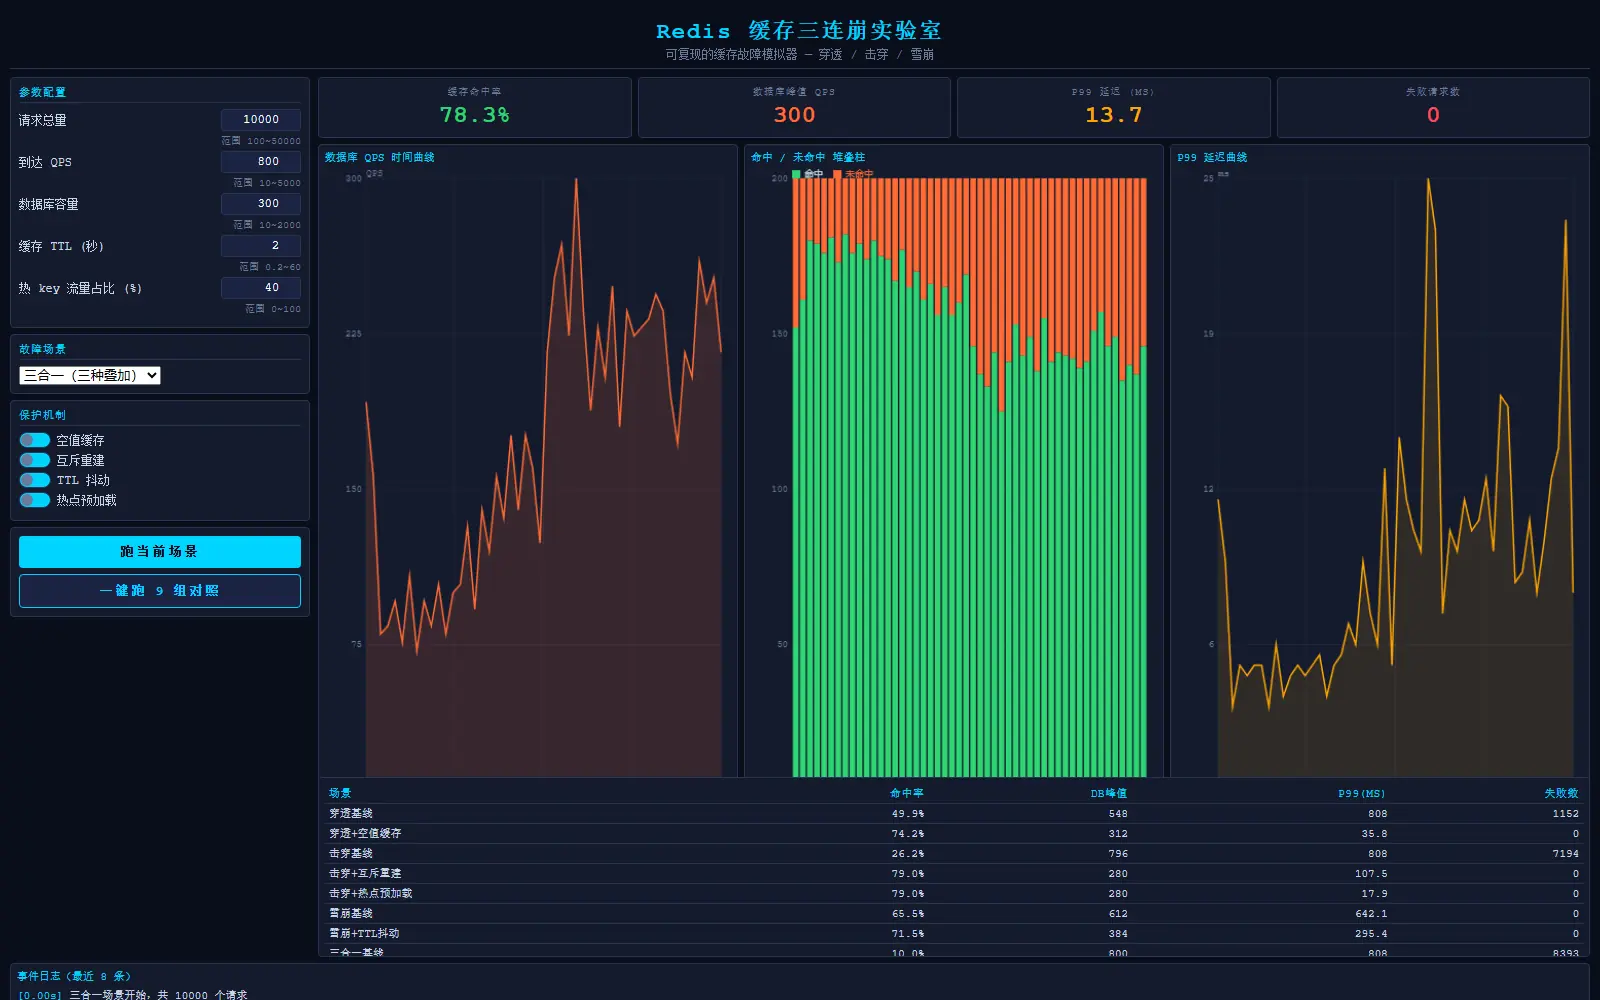
三种故障叠在一起,命中率只剩 10.0%,8393 个请求失败。
四个保护全开,命中率回到 78.3%,数据库峰值 300 QPS,失败清零。
五、怎么读这张表:三个数字背后的机制
穿透场景里,25% 的请求去查 200 个不存在的 key。
不开空值缓存,这 2500 次请求全部落到数据库,命中率只有 49.9%。
开了空值缓存,第一次查库后写入 NULL 标记,TTL 30 秒,后续请求直接命中。
命中率从 49.9% 升到 74.2%,失败请求从 1152 降到 0。
击穿场景里,40% 的流量打同一个热 key。
它在 1.2 秒过期,重建一次要 120ms,这 120ms 里后续请求继续 miss。
不开互斥,每个 miss 都自己查库,队列越排越长。
开互斥,只放一个请求去重建,其余请求等 120ms 后命中缓存。
数据库峰值从 796 掉到 280 QPS,P99 从 808ms 降到 107.5ms。
雪崩场景里,85% 的 key 在 1.0~1.1 秒集中过期。
TTL 抖动把过期时间打散到 0.8~7.2 秒,峰值从 612 降到 384 QPS。
它不是让数据库变快,只是把同一秒的活分到后面几秒。
三合一基线把三种问题叠在一起,数据库 QPS 顶到 800,8393 个请求失败。
四个保护分别管一段:空值缓存挡住穿透,互斥重建挡住击穿,TTL 抖动挡住雪崩,热点预加载把热 key 的寿命拉长。
六、验证与踩坑:第一版 5/12 是怎么修到 12/12 的
第一版把数据库容量当成 300 个并发窗口,每个查询 8ms。
300 除以 0.008 等于 37500 QPS,怎么打都打不穿。
我把它改成单队列,服务时间等于 1000 除以容量,队列才真的会堵。
第二版所有 key 的初始过期时间都写成 2 秒。
开场 2 秒所有 key 一起过期,穿透场景也跑出了雪崩。
我把初始过期时间打散到 0.4~8.4 秒,三种故障才分得开。
第三个坑在穿透的 key。
第一版每次随机 0~99999,空值缓存写完也命中不了第二次。
改成 200 个固定的不存在 key,空值缓存才有意义。
第四个坑在互斥重建。
第一版缓存一写完就算命中,重建的 120ms 根本没挡住请求。
我加了 readyAt,缓存要等重建完成才可用,互斥才真的只放一个请求进去。
改完重跑,12 条断言全部通过。
失败路径也跑了:把请求总量改成 50,控制面板下方出现一行红字「请求总量需在 100~50000 之间」。
上面的 548 QPS、808ms、1152 个失败没有被清空,上一次结果还在。
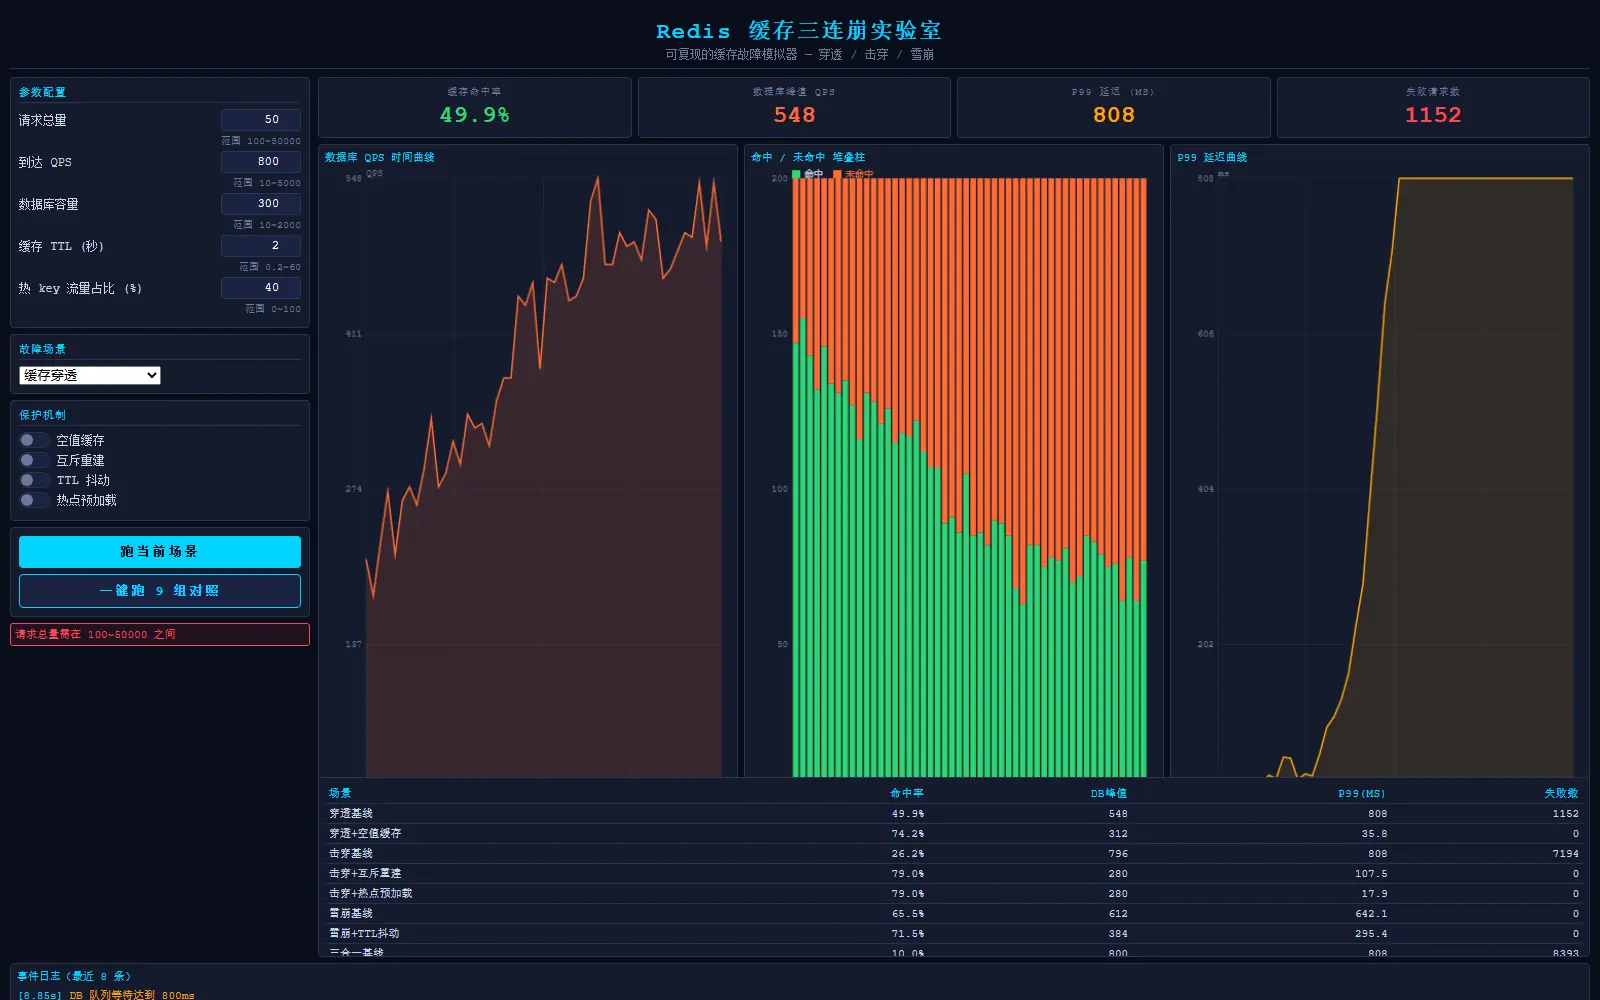
本地复现命令:
bash
python -m http.server 8000打开 http://localhost:8000/index.html,点「一键跑 9 组对照」就能看到同一张表。
七、边界:这是模拟器,不是 Redis 压测
所有数字来自页内模拟,不是线上 Redis 集群的压测结果。
请求按均匀分布到达,key 空间固定 1000 个,没有网络抖动,也没有 Redis 单线程模型。
热 key 重建固定 120ms,真实业务可能 5ms,也可能 2 秒。
数据库按单队列算,真实数据库还有连接池、慢查询隔离和主从延迟。
所以这张表适合比较三种故障的相对关系,不适合拿绝对值去做容量规划。
如果你的 QPS、TTL、热 key 占比不同,把参数改掉再跑一遍,结论可能反过来。
八、使用码道体会
- 模拟规则写进需求,模型就没有自由发挥的空间。
- 断言要带实测值,不能只写一个 true。
- 先让模型跑出 9 组对照,再让页面自己算,数字才对得上。
- 第一版 5/12 不可怕,怕的是没人去看是哪 7 条挂了。
- 错误路径也要留截图,读者才知道输入错了会怎样。
- 把 120ms 这类假设写在页面上,读者才能判断结论能不能搬。
九、结果与下一步
三种故障里,击穿对数据库最狠:796 QPS,7194 个失败。
穿透靠空值缓存,击穿靠互斥重建,雪崩靠 TTL 抖动。
三种一起上,才把 8393 个失败压到 0。
成品和源码在这里:gitcode.com/OPCTeam/dem...
下一步想补 Redis Cluster 分片下的热 key、多级缓存的回源顺序,以及真实 Redis 的压测对照。