不是教你用 REA,而是借 REA,看懂现代 AI 开源项目为什么能高速进化。
REA
GitHub 全球 Star 第 4
2026 年增长最快的 AI 开源项目
过去几个月我的排名
| Merged PR | Top Contributors |
|---|---|
| 37 | 第 10 |
(真人 PR Contributor 中排 第 8)
这是我第一次,以 Contributor 身份,而不是使用者身份,讲这个项目。
第一章 我错得很彻底
我第一次给 REA 提 PR,觉得自己写得挺好。
改动很小,逻辑清楚,测试也跑了,门禁也过了,描述里还写了一张对照表。我提交完就放在那里,等着被合并。
几分钟后,机器人来了。
它说 P1。
csharp
Reject truncated wide caches before accepting 28-byte headers

If a valid 32-byte cache is truncated by exactly four bytes at EOF,
bytes.length - declaredPayload becomes 28 and this allow-list accepts
it as the narrow layout.
我盯着这段话看了很久。
我的第一个念头是:它错了。
因为我的 PR 里有一份"证据"。我跑了真实的 Node,把一个 64 位的 V8 code cache 取出来,把它末尾的四个填充字节删掉,然后交给 V8 自己判断。
php
new vm.Script(src, { cachedData: narrow }).cachedDataRejected
→ false
V8 接受了。 所以这份字节是合法的。所以我的实现是对的。
这套推理看起来无懈可击。
然后我决定"证明它错了",于是我把三种情况都跑了一遍。
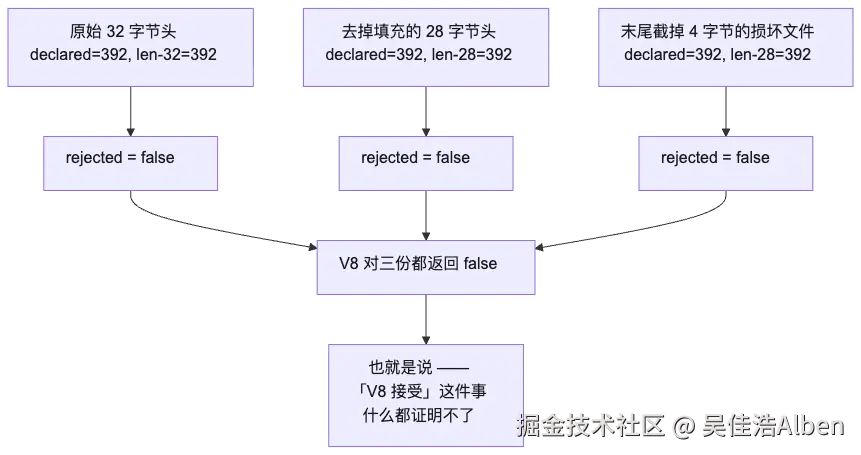
V8 连被截断的坏文件都接受。
我拿着一个什么都不证明的实验,当成了关键证据,还写进了 PR 描述。
那一刻的感觉不是"我被冤枉了",而是 "我做的事,比我想象的要浅。"
后面我又花了几个小时,才找到真正的判据。我跑了六个不同的源码,量出两个常量:
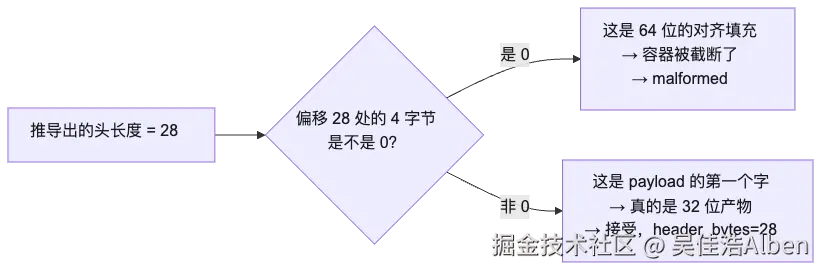
x64 的填充字,偏移 28   恒为 0x00000000
payload 的第一个字,偏移 32  恒为 0x03542401
只有那个 0 能区分「真的 28 字节头」和「被截断的 32 字节头」。
因为这个 0 是 V8 的对齐填充,而一个真正的 28 字节头,在那个位置放的是 payload 的第一个字。
这个 PR 最后是这么写的:
| container | before | after | | 真 32 字节头 | accept | accept | | 真 28 字节头 | accept | accept | | 32 字节头截 4 字节 | accept |
malformed|
两行没有变化的行,和一行变化了的行,同等重要。
那天我学到的东西,比我过去一年自己写代码学到的都多。
所以这个系列的第一句话,我想这么写:
我不是来教你怎么用 REA 的。 我是来告诉你,在一个几十万 Star 的项目里,一个人的判断能错到什么程度,以及它怎么把你掰回来。
第二章 为什么全世界都在讨论它
先回答一个最朴素的问题:这到底是个什么量级的项目?
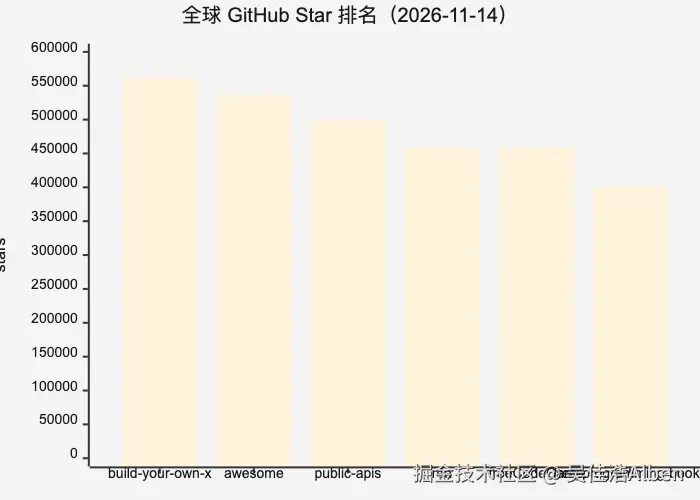
2.1 全球第 4
bash
1  codecrafters-io/build-your-own-x          562,490
2  sindresorhus/awesome                      536,805
3  public-apis/public-apis                    498,972
4  morluto/rea                                459,260   ←
5  freeCodeCamp/freeCodeCamp                  459,128
6  EbookFoundation/free-programming-books     401,586
第 4 和第 5 只差 132 星。
这个位置随时会换。所以"全球第 4"是一个动态快照,并非既成事实。我可能下周就得改这句话。
2.2 但它只存在了 7 个月
这才是真正离谱的部分。
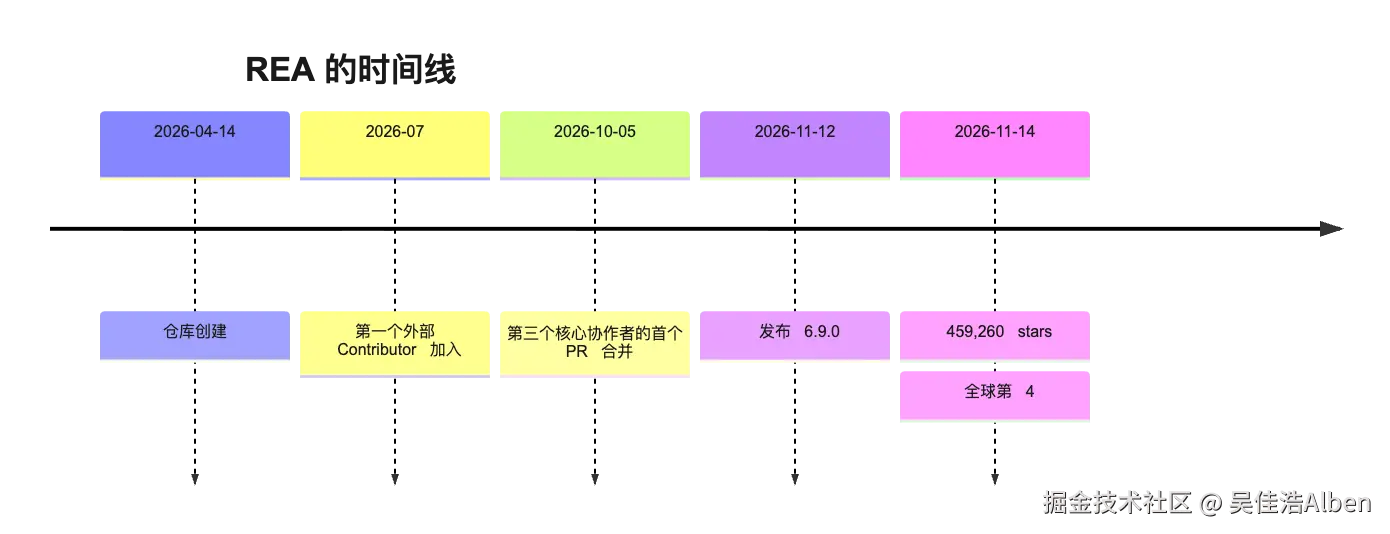
我把 2026 年创建的所有仓库按星数拉了一遍:
yaml
1  morluto/rea                     459,260   created 2026-04-14
2  mattpocock/skills                324,301   created 2026-02-03
3  affaan-m/ECC                     302,782   created 2026-01-18
它是唯一突破 40 万的 2026 年新仓库。
而且注意那个时间差:第二名比它早创建两个月,星数还少 13 万。
所以这句话可以写得更硬:
按"创建后 7 个月的星数"算,REA 是目前全球第一。
2.3 一个反直觉的比例
yaml
459,260 stars
112,585 forks
──────────────
≈ 4.1 : 1
大多数"网红项目"的 star/fork 比是 20:1 甚至 50:1,因为大量人只是点星收藏,不会额外做事。
1:4 意味着每四个点星的人里,就有一个真的把它 fork 下来动手了。
这是"看热闹"和"真在用"的分界线。
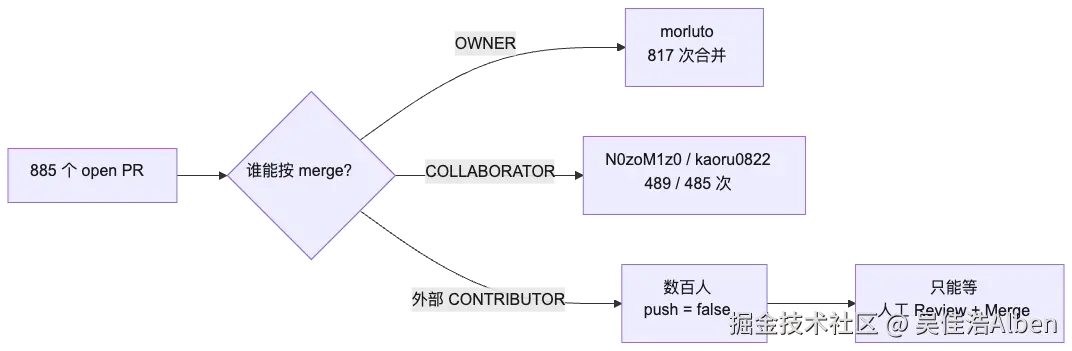
2.4 但它同时也是拥堵的
arduino
885 个 open PR
837 个 open Issue这其实是一个瓶颈信号,未必代表健康。
第三章 我为什么选它,而不是别的
2026 年的 AI Coding 赛道不缺水项目。Continue、OpenHands、Roo Code、Aider,还有每周冒出来的新 Agent 框架。
我评估过其中几个。最后把时间投在 REA 上,理由不是"它最火"。
我的判据
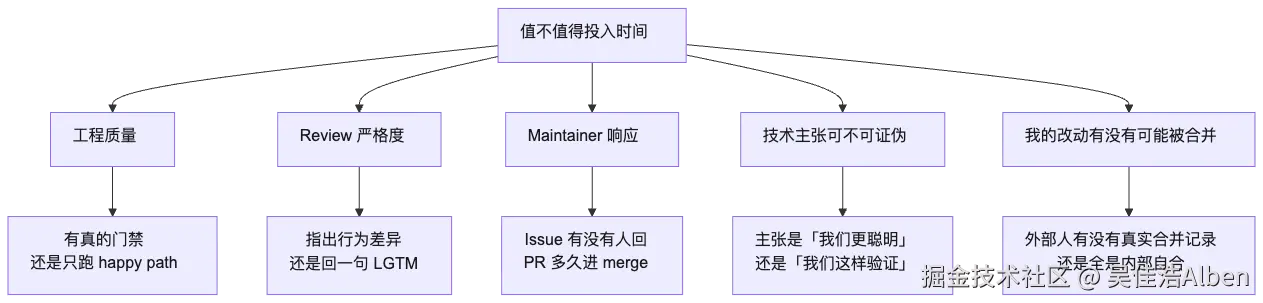
它在这五个维度上的实际表现
工程质量:极高,而且可验证。
我每次提交要过的是这些:
bash
npm ci                    # 锁定依赖
npx tsc --noEmit -p .     # 全量类型检查
npm run lint              # 0 error
npm run knip              # 死代码 / 未用导出
npm run format:check      # oxfmt
npm run docs:check        # 文档一致性
CI 还分 lane。我动 hopper 代码时触发的那个:
yaml
apple-artifacts:
  name: Real Apple artifact CLI/MCP E2E
  runs-on: macos-15
  timeout-minutes: 15
我真实踩过一次坑:那个 job 跑了 15 分 23 秒 ,被自己的 timeout 砍掉,GitHub 记成 cancelled 而不是 failure。
我一开始判断是"并发取消",写了半天,最后对着时间戳才发现:started 10:24:57,completed 10:40:20,正好 15 分 23 秒。
这种细节,只有里面提交过几十次 PR 的人才知道。
Review 严格度:这是我留下来的头号原因。
这个项目的 Review Bot 在你 push 之后几分钟内就会贴意见,而且经常一次贴好几条 P1/P2。我一开始觉得是噪音。
后来我数了一下:我有 21 条未清的评论线程,分布在 7 个 PR 上。其中有一个 PR 累计 54 条。
它从来不写"你错了"。它写的是:
When a crafted link has no
LinkInfoand recordshttps://example.test/app.exe.inRelativePath,targetPathsmakes that raw value the first target and this fallback strips the terminal dot, publishing.exe; an HTTP target preserves that dot and can address a different resource.
它构造一个具体输入 → 顺着我的代码路径走一遍 → 给我一个具体输出 → 指出这个输出和现实不符。
它不先做立场判断,只把证据摆出来。
Maintainer 响应:慢,但真实。
我 37 个 PR 的中位合并耗时是 18.7 小时。而且带 issue 链接的明显更快:
带 issue 链接的 PR    中位 5.8h
不带 issue 链接的 PR  中位 8.2h
为什么不是别的项目
只说一个可验证的判据:去看外部贡献者的实际合并率。
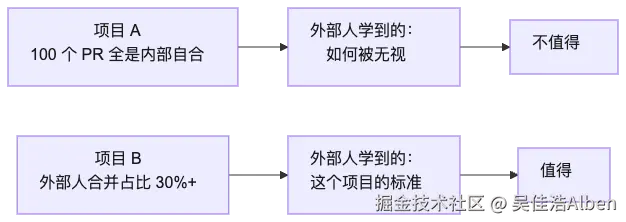
REA 的外部占比是 5%。
这是个真实问题,我必须承认。 从纯投入产出的角度看,它不是理想的标的。
但我还是留下来了,原因很具体:
在那 5% 里,每一个都是因为代码本身正确而被合并的。没有一个是靠关系。
有个叫 Plastic-time 的人,和我一样是 CONTRIBUTOR、push = false。他 36 个 PR 全部由仓库所有者手动合并,自己一个都没合过。
在那个 5% 的通道里,规则是干净的。
这就是我判断的依据。
第四章 四轮
第三章我说 Review 严格。第四章我把这件事讲完。
4.1 一个改动的四种死法
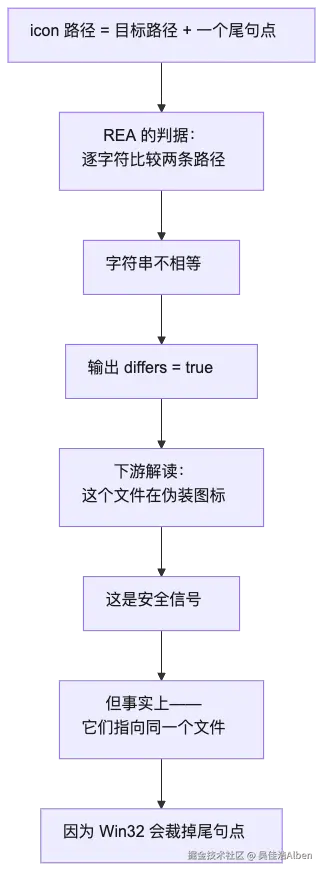
我有个 Windows 快捷方式解析的 PR。改的是:Win32 会裁掉路径末尾的句点和空格。
起因很简单:一个 .lnk 文件的图标路径,是目标路径加了一个尾句点。REA 逐字符比较,判成"不相等",然后输出:
ini
icon_location_differs_from_target = true下游看到这个字段会怎么理解?"这个快捷方式在伪装自己的图标。"
这是一个安全信号。
而事实是:它们指向同一个文件。
我在本机验了:
python
Test-Path 'C:\Windows\System32\shell32.dll'      → True
Test-Path 'C:\Windows\System32\shell32.dll.'     → True    ← 同一个文件
Test-Path 'C:\Windows\System32\shell32.dll '     → True    ← 同一个文件
Test-Path 'C:\Windows.\System32\shell32.dll'     → True    ← 同一个文件
Test-Path '\\?\C:\Windows\System32\shell32.dll.' → False ← 设备路径跳过规范化代码没算错------两个字符串确实不相等。但结论错了,它报出了一个不存在的安全威胁。
4.2 然后我被连续打回四轮
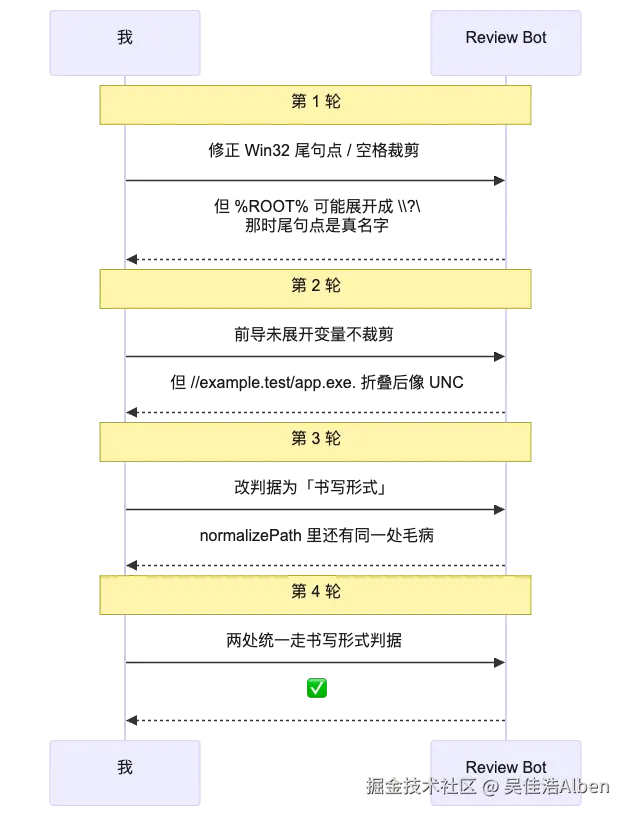
四轮之后我才明白一件事:
我一直在按"文本内容"打补丁,而正确的判据是"书写形式"。
Win32 会打开的文件系统路径,用反斜杠写 (C:\... 或 \\server\...)。URL 保留正斜杠。而 //example.test/... 折叠之后,和 UNC 路径一模一样------只有原始写法能区分它们。
4.3 但我第一版还是写错了
我第一版的规则是:"用反斜杠写的才算文件系统路径。"
它立刻被一个既有测试抓住:
ts
expect(await iconFor("C:/Tools/bin/../\\app.exe", "c:/tools//app.exe"))
  .toBe(false);
c:/tools//app.exe 是正斜杠,但它是文件系统路径------Windows 两者都接受。
所以规则必须拆成两条:
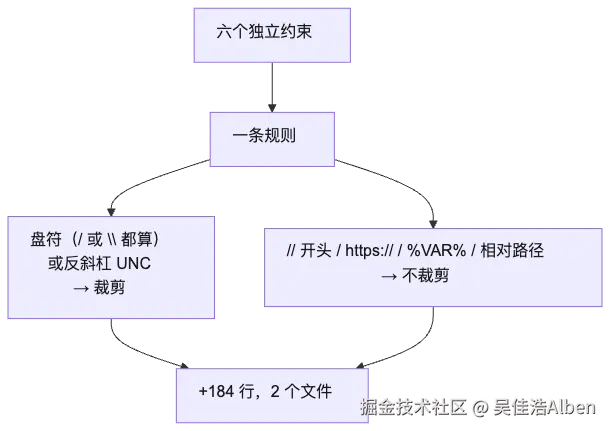
六个约束,最后压成两行判断。
这就是这个项目里"小改动"的真实成本结构:行数小,约束密度大。
第五章 我走进这个代码库,被三件事砸了一下
震撼一:它不复杂,它啰嗦
我原以为,这种几十万 Star 的项目,代码应该像 Linux 内核一样------模板元编程、几百层抽象、我读不懂的"黑魔法"。
结果打开第一份源码,我愣住了。
没有。全都没有。
真正让我震惊的,是注释。
比如这个函数,干了 6 行的事:
ts
// In `u` mode a well-formed surrogate pair is one code point outside this
// range, so the class matches only unpaired surrogates.
const UNPAIRED_SURROGATE_PATTERN = /[\uD800-\uDFFF]/u;

/**
 * Reject unpaired UTF-16 surrogates without advertising a pattern.
 *
 * ECMA-262 spells the surrogate block only as `\uD800-\uDFFF`. RE2 has no `\u`
 * escape and Rust's `regex` and `jsonschema` crates refuse non-scalar code
 * points, and a client that cannot compile one advertised pattern refuses the
 * complete tools request rather than the affected call. The issue keeps the
 * `invalid_format` regex shape an advertised `.regex` raises, so input issue
 * projection still reports `message`.
 */
export const rejectUnpairedSurrogates = <Schema extends z.ZodString>(
  schema: Schema,
  message: string,
): Schema =>
  schema.superRefine((value, context) => {
    if (UNPAIRED_SURROGATE_PATTERN.test(value))
      context.addIssue({
        code: "invalid_format",
        format: "regex",
        message,
        input: value,
      });
  });
上面那段注释,解释的是:
- 为什么不能直接用
.regex() - 为什么是 RE2 的限制
- 为什么是 Rust 的
regex/jsonschemacrate 不肯接受非标量码点 - 为什么一个人编译不了,会导致整个 tools 请求被拒,而不是单个调用失败
- 为什么还要保留
invalid_format的错误形状
一段 6 行的实现,配 15 行"为什么不能是别的写法"。
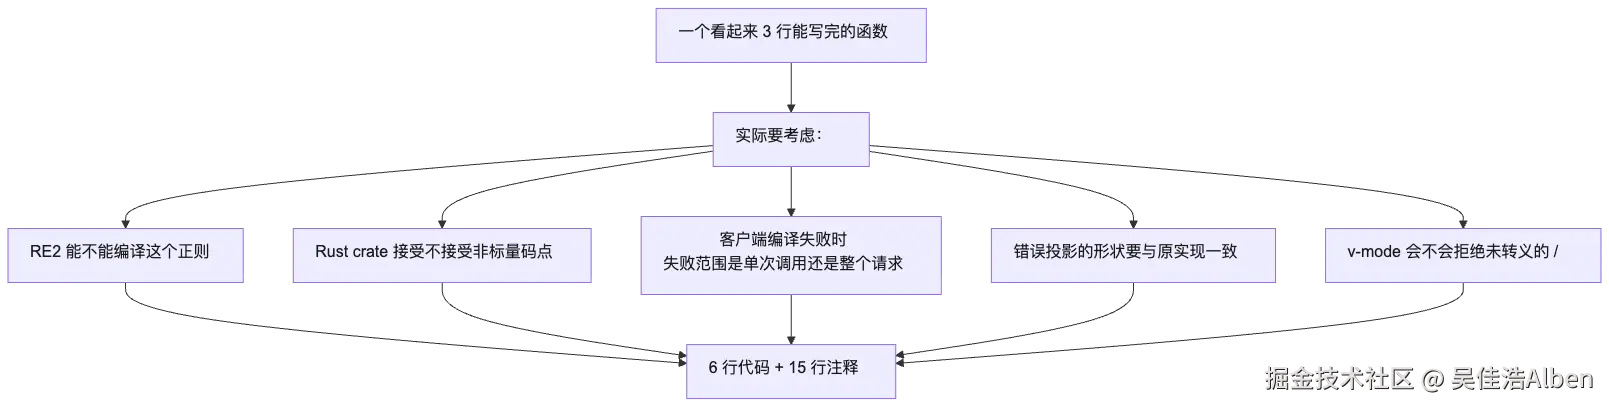
复杂不在算法,复杂在约束的密度。
震撼二:Schema 就是产品
这一条彻底改变了我对"写 AI 工具"的理解。
我原以为 Prompt 是 Prompt,代码是代码。
在 REA 里不是。工具的 JSON Schema,就是你交付给模型的全部语义。没有别的。
有一条数据我记到现在:
ts
// Moonshot's function-calling API rejects requests while any single tool
// parameters schema exceeds its literal serialized size cap. Community
// measurements bound the cap between ~13.7 KB (accepted) and ~15 KB
// (rejected); 13 KiB leaves margin under the lower bound.
export const COMPACT_INPUT_SCHEMA_BUDGET_BYTES = 13 * 1024;
一个第三方 API 的 13.7KB 上限,直接决定了这个项目的 schema 设计。
而且它是个开关:
ts
export const resolveMcpInputSchemaProfile = (
  profile: McpInputSchemaProfile | undefined,
): McpInputSchemaProfile => profile ?? "compact";
compact 从 10 月 22 日起就是服务器默认值。
然后这条链条就开始了:
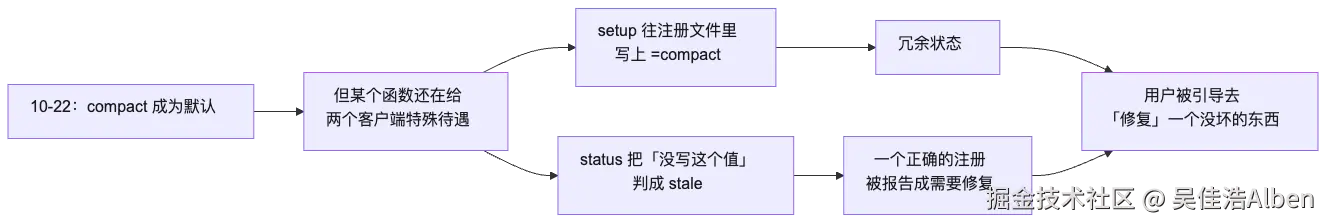
一个默认值改动,一路传到"用户的配置文件被判为过时"。
我修的那个 PR,就是把那个函数和它的两个消费者删掉:
省略一个等于默认值的设置,是"一致",不是"过时"。
震撼三:大部分 Bug 不是代码 Bug
这是最颠覆我认知的一条。
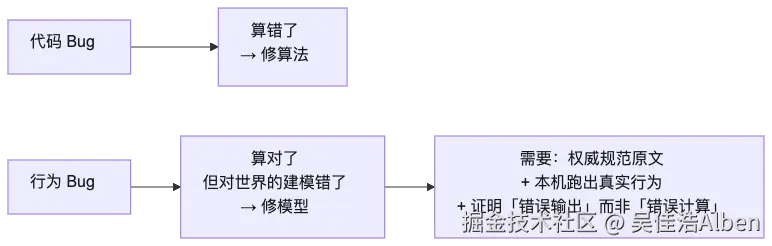
传统软件里,Bug 是"这段代码算错了"。
在 REA 里,大量 Bug 是:代码算得完全正确,但它对世界的建模错了。
回到那个快捷方式的例子:
所以这个项目的 PR 描述里,你看到的不是"我改了什么",而是:
- 实测数据表
- 权威文档引用
- 修复前后对照
- 哪些情况保持不变
"哪些情况不变"和"哪些情况变了"同等重要。 这是我在这个项目里学到的第一条工程纪律。
第六章 一个 Contributor 的一天
真实的循环
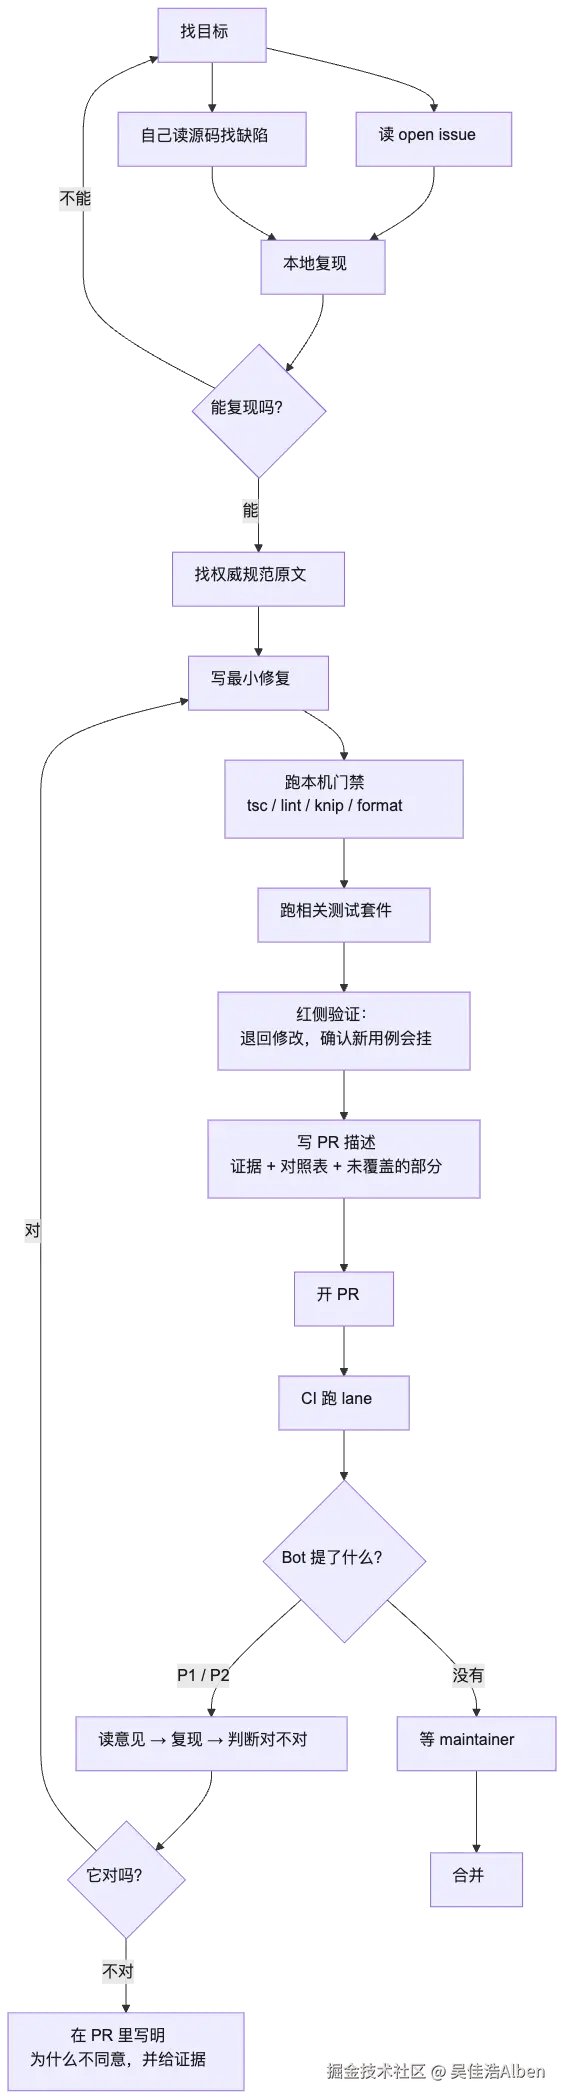
三个真实体感
体感一:CI lane 是分区的,你的 diff 决定你等多久
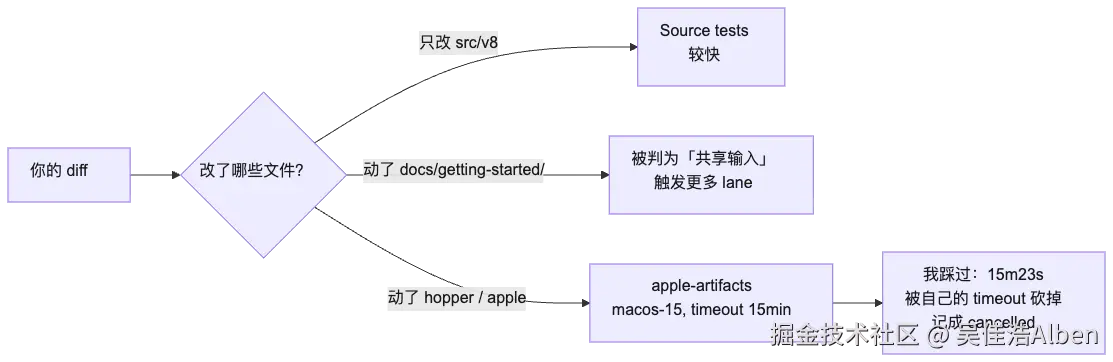
体感二:最大的坑不是代码,是"分支落后于已修复的 main"
我有两个 PR 连续几天 Source tests 红。我以为是自己代码有问题,查了半天。
结果:失败的那 3 个用例在 JavaScriptAnalysisWorkerServer.test.ts,我一行都没碰过那个文件。
再查------main 自己在同一时间是红的。上游在 14:17 修好了,我的分支落后 41 个 commit,还带着旧的失败。
rebase 到最新 main 之后,同一个测试本机 6 passed。
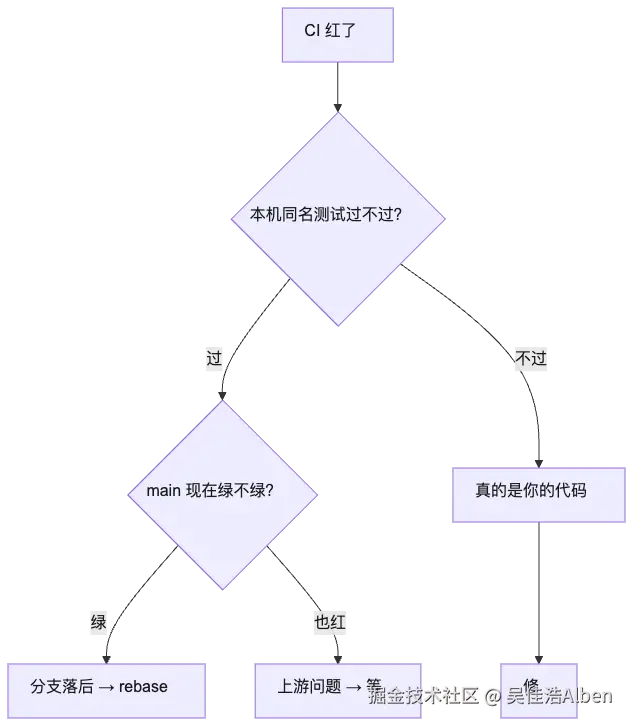
这条我记进了笔记:CI 红有三类原因------代码问题、flake、以及"分支落后于已修复的 main"。第三类最容易被误判成第一类。
体感三:和人共享分支,比开新 PR 危险得多
我有个 PR 是和仓库所有者共享分支 的。他 13 个 commit,我 13 个 commit,26 个 commit 全部只存在于那个分支上------一个都没进 main。
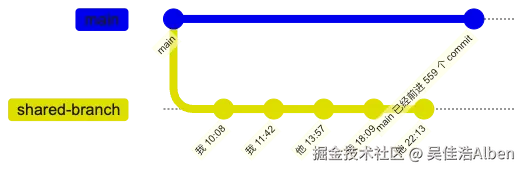
现在这个分支 rebase 不动了------第一个 commit 就冲突,因为那个文件后来被另一个 44 文件的 PR 重写了(+2084/−603)。
这是我在这个项目里学到的最贵的一课。
第七章 为什么一个小改动要讨论四轮
这一章是我最想写的,也是别人写不了的。
一处路径比较,需要几个约束
我那个 +184/−6、两个文件的 PR,修复的是"Win32 会裁掉路径末尾的句点和空格"这件事。
看起来是 path.replaceAll("/", "\\") 之后加个 .replace(/[. ]+$/, "")。
实际上它需要的约束是:
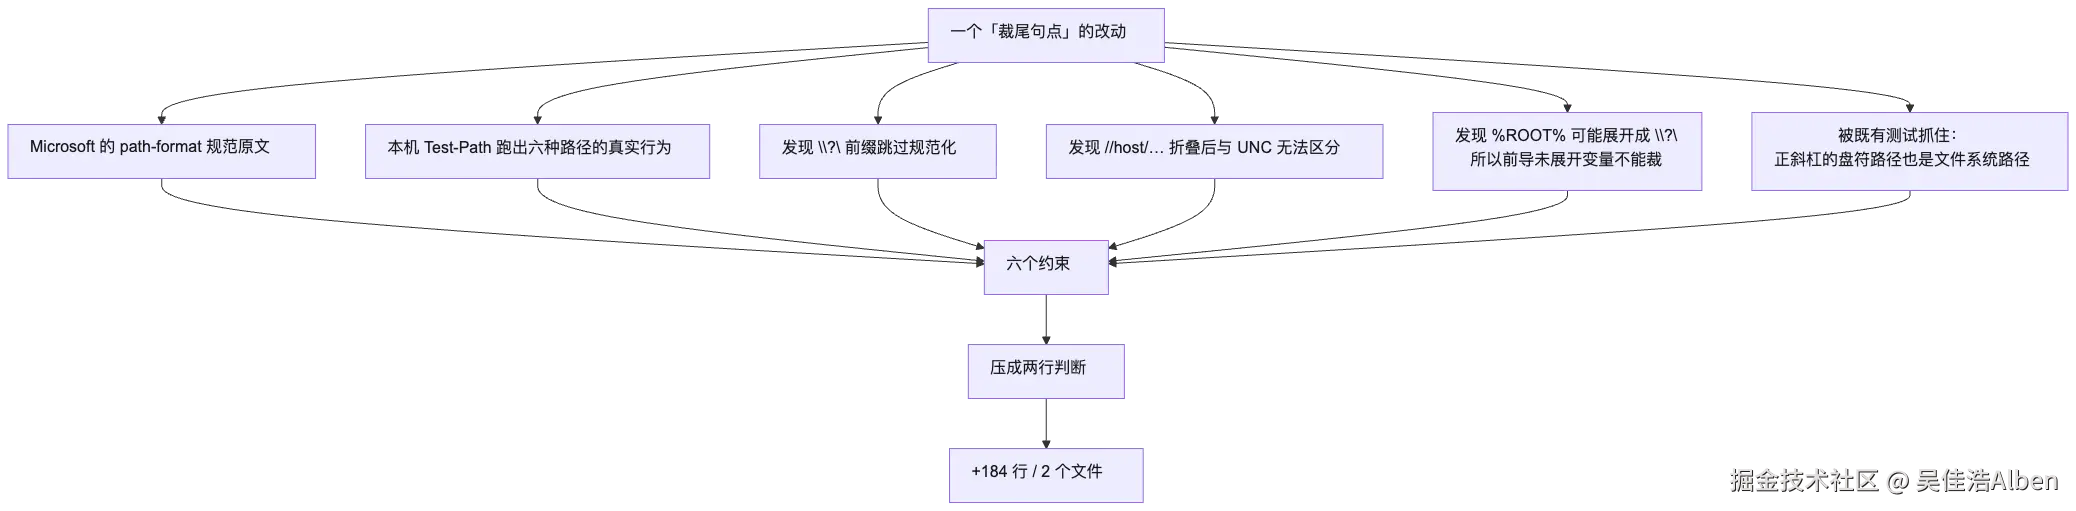
我从中学到的三条
第一条:先证伪自己。
在说"这是 bug"之前,先构造一个能让自己的解释失败的反例。我那个 V8 的 PR 就是没做这一步,被机器抓了。
第二条:区分"错误计算"和"错误输出"。代码算对了但结论错了,比代码算错了更危险------因为它看起来是对的。这个项目里大量 bug 属于这一类。
第三条:把"哪些情况不变"写进 PR。只写"修了什么"的 PR,读者无法判断你有没有引入回归。写了"下表保持不变"的 PR,读者一眼就能看出你的边界。
还有第四条,关于 AI 时代的代码
在这个项目里,我把"我验证过了"和"我验证的方式是对的"彻底分开了。
我原来的证据是 cachedDataRejected === false。实测发现:V8 连被截断的损坏文件都返回 false。
也就是说------我的验证方式本身是无效的,而我完全不知道。
那一刻我理解了为什么这个仓库的代码里全是那种注释。
"我这样做可以工作"和"我这样做是因为别的都不可行",是两种完全不同的知识。 前者会被时间淘汰,后者不会。
这就是 REA 给我的最大冲击:在一个所有人都急着交付结论的领域里,它坚持证明自己的结论方式。
结语
37 个 PR、第 10 名、全球第 4 的项目------这些全都是动态快照。
rea 现在离第 5 名只差 132 星。我和一个自动化账号并列 37 次提交。下周这些数字就都不一样了。
能被时间留下的只有三样东西:
- 它验证问题的方式------先构造反例,再下结论
- 它把约束写进注释的习惯------解释"为什么不能是别的写法"
- 它对"没解决的问题不许集成"的坚持------哪怕代价是 885 个 open PR
如果这一季最后只让你记住一句话,我希望是这句:
在一个所有人都急着交付结论的领域里,一个坚持证明自己结论方式的代码库,是最值得花时间读的。
第二期,我们从 885 个 open PR 开始。
数据截至 2026-11-14。Star 数、排名、PR 合并数均为实时快照,会随时间变化。