MIT 6.S081 Lab3 页表实验笔记:ugetpid、vmprint、pgaccess 与一个链接器坑
实验环境:Windows 11 + WSL2(Ubuntu 24.04),riscv64-linux-gnu 工具链,QEMU riscv64。
本文记录 Lab3 三个任务的实现思路,以及一个由链接器引发的 RWX 权限问题。后者是我做完这个 lab 之后觉得最值得记录的部分。
一、Lab3 要做什么
xv6 的页表 lab 有三个任务:
- ugetpid:在用户页表里映射一个只读共享页,把进程 pid 放进去,让用户态不用系统调用就能读到 pid;
- vmprint:实现一个函数,按树状结构打印当前进程的页表;
- pgaccess:实现系统调用,报告从某个用户地址开始的若干页是否被访问过。
另外还有两道思考题:
- 哪些系统调用可以用共享页加速?
vmprint的输出如何对应教材里的用户地址空间图?
二、任务一:用共享页加速 getpid
2.1 思路
getpid 是系统调用,每次调用都要走完整路径:
用户 → ecall → 内核 → sys_getpid → 返回值放进 a0 → 用户如果频繁获取 pid,陷入内核的开销不划算。
改进思路:
- 每个进程创建时,内核分配一页,把 pid 写进去;
- 这一页以只读 方式映射到用户地址空间,地址是
USYSCALL; - 用户态
ugetpid()直接读这一页,不陷入内核。
pid 在整个进程生命周期内不变,所以只需要在 allocproc() 时写一次。fork 出的子进程有自己的 pid,也有自己的页。
这里顺便纠正一个常见误解:
getpid不经过 copyout 。它只是返回一个整数,通过p->trapframe->a0带回用户态。copyout 用于"内核把数据复制到用户指针指向的内存",比如sysinfo、read。
2.2 allocproc:分配页并写入 pid
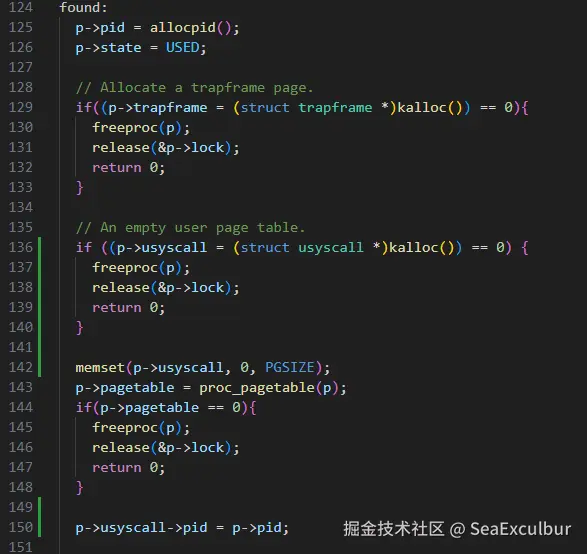
要点:
- 在
p->pagetable = proc_pagetable(p);之前分配,因为映射时页必须已经存在; kalloc()失败要走完整错误路径:freeproc(p); release(&p->lock); return 0;- 分配后
memset清零; - 写入
p->usyscall->pid = p->pid;
2.3 结构体声明
struct usyscall 已经在 kernel/memlayout.h 里定义好了(在 #ifdef LAB_PGTBL 中):
arduino
struct usyscall {
  int pid;
};
所以 kernel/proc.h 里不要重复定义,只需要前置声明 + 加字段:
arduino
struct usyscall;
struct proc {
...
struct usyscall *usyscall;
};2.4 proc_pagetable:只读映射
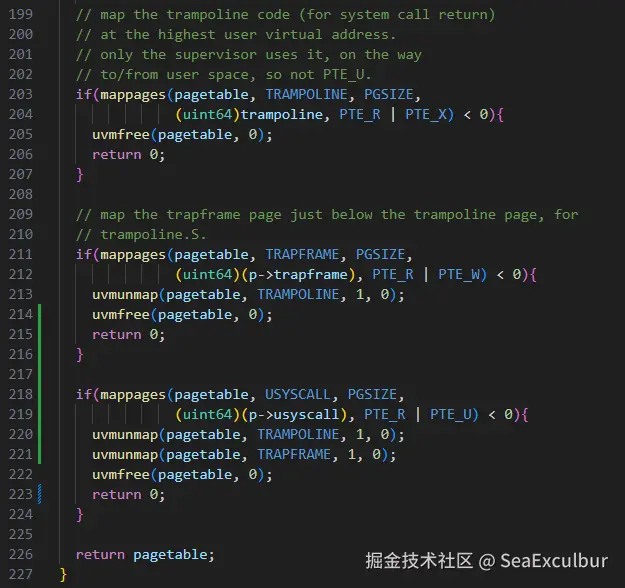
在映射完 TRAMPOLINE 和 TRAPFRAME 之后,增加 USYSCALL 映射:
scss
mappages(pagetable, USYSCALL, PGSIZE,
         (uint64)(p->usyscall), PTE_R | PTE_U);
要点:
- 权限必须是
PTE_R | PTE_U,不能加PTE_W,否则用户可写共享页; - 映射失败时,要清理之前已经成功 的映射:unmap
TRAMPOLINE和TRAPFRAME,再uvmfree; - 不要 在失败路径里
uvmunmap(USYSCALL):mappages 失败说明这条映射根本没建立,uvmunmap遇到未映射的 PTE 会 panic。
2.5 释放:先 unmap,再 kfree
proc_freepagetable() 里增加:
scss
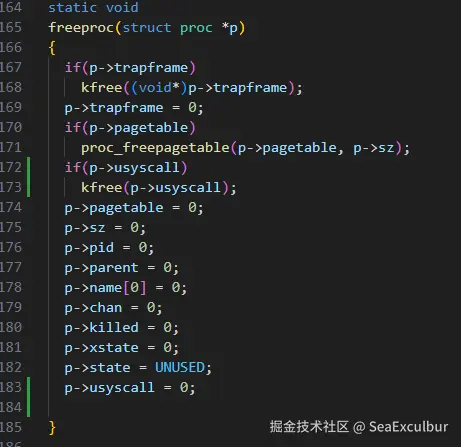
uvmunmap(pagetable, USYSCALL, 1, 0);freeproc() 里增加:
ini
if(p->usyscall)
  kfree(p->usyscall);
p->usyscall = 0;顺序很重要:先解除页表映射,再释放物理页 。如果先 kfree,页表里还留着指向已释放页的映射。
【图 3:freeproc 中释放 usyscall 页并置 0 ------ 发布前插入截图】
2.6 易错点
- 忘了
PTE_U:用户访问USYSCALL会 page fault; - 加了
PTE_W:共享页变成可写,违反只读约定; - 只 unmap 不
kfree:物理页泄漏; - 只
kfree不 unmap:页表里留下指向已释放页的映射; - 在
exec里释放 usyscall 页:exec 会新建页表,但 usyscall 页属于进程,不应该在那里释放。
三、任务二:实现 vmprint
3.1 三级页表
RISC-V Sv39 的页表是一棵三级树:
- 每级 512 个 PTE;
- 非叶子 PTE 只设置
PTE_V,它的 PPN 指向下一级页表页; - 叶子 PTE 设置
PTE_R/PTE_W/PTE_X中的一个或多个,指向真正的数据页。
所以递归判断是:
scss
if ((pte & (PTE_W | PTE_R | PTE_X)) == 0)
    // 没有 R/W/X,说明它指向下一级页表页,继续递归
反过来,只要 R/W/X 有一个为 1,就到达叶子层,停止递归。
可以参考答案里的 freewalk(),它就是递归遍历三级页表的例子。walk() 是"查单个虚拟地址"的迭代函数,和这里的遍历目标不同。
3.2 地址转换宏
scss
PTE2PA(pte) = (pte >> 10) << 12   // PTE → 物理地址
PA2PTE(pa) = (pa >> 12) << 10 // 物理地址 → PTE,低 10 位为 0PTE2PA()取出 PPN,再左移 12 位,还原成物理页基地址;PA2PTE()只填 PPN,权限位默认为 0;PTE_V由mappages()另外加上。
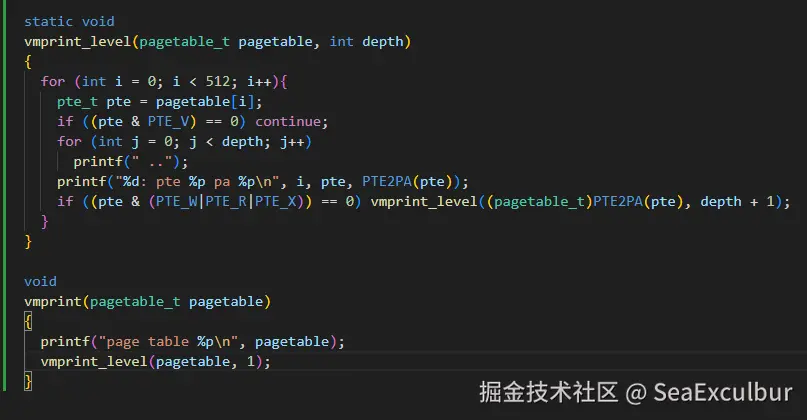
3.3 输出格式
- 第一行:
page table %p - 每个 PTE:
%d: pte %p pa %p - 每深一层多一个
" .."前缀; - 只打印
PTE_V为 1 的项; - 用
%p打印 64 位十六进制,避免%x截断。
3.4 调用点
在 kernel/exec.c 的 return argc; 之前:
scss
if(p->pid == 1)
  vmprint(p->pagetable);
这样第一个用户进程 exec 完 init 后,会打印它的页表。
四、任务三:实现 pgaccess
4.1 目标
实现系统调用:
arduino
int pgaccess(void *start, int npages, void *bitmask);- 从
start开始,检查npages个页; - 位图第 i 位对应第 i 页是否被访问过;
- 返回 0 表示成功,-1 表示失败。
实现里可以把扫描页数限制在 32 页 以内,因为测试的位图是 unsigned int(4 字节)。
4.2 PTE_A
在 kernel/riscv.h 增加:
arduino
#define PTE_A (1L << 6)注意:
- A 位是 RISC-V 硬件规定的(bit 6),不是软件随便选的;
- 宏只是给内核一个名字,方便检查和清除;
- 检查到 A 位后必须清除,否则下次调用会一直认为该页被访问过。
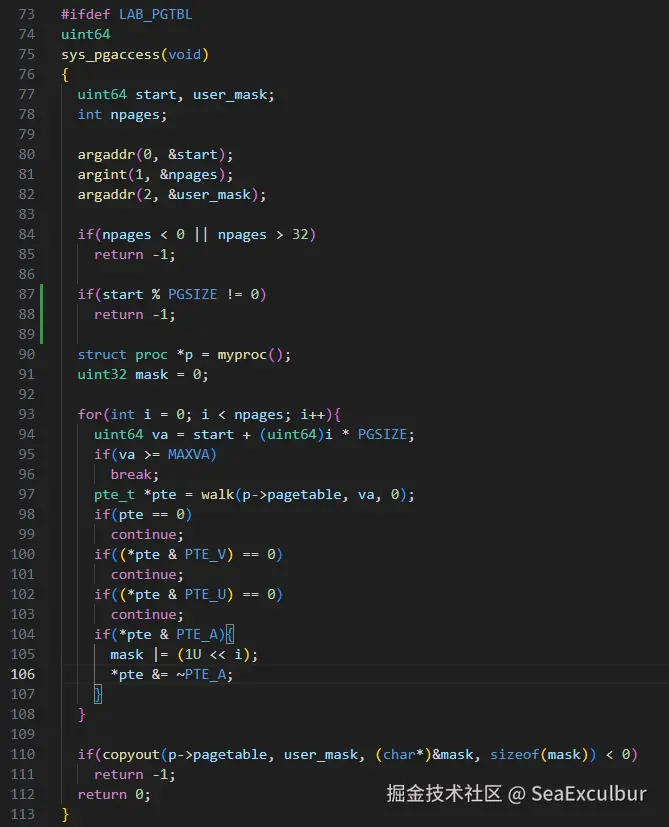
4.3 实现步骤
-
取参数:
scssuint64 start, user_mask; int npages; argaddr(0, &start); argint(1, &npages); argaddr(2, &user_mask); -
限制页数:
kotlinif(npages < 0 || npages > 32) return -1; -
逐页查表:
inifor(int i = 0; i < npages; i++){ uint64 va = start + (uint64)i * PGSIZE; if(va >= MAXVA) break; pte_t *pte = walk(p->pagetable, va, 0); if(pte == 0) continue; if((*pte & PTE_V) == 0) continue; if((*pte & PTE_U) == 0) continue; if(*pte & PTE_A){ mask |= (1U << i); *pte &= ~PTE_A; } } -
copyout写回 4 字节位图:scsscopyout(p->pagetable, user_mask, (char *)&mask, sizeof(mask)); -
可选:增加
start % PGSIZE != 0的检查。测试用例保证了页对齐,但内核里做检查会更健壮。
4.4 为什么放在 sysproc.c
sys_pgaccess() 放在 kernel/sysproc.c 是合适的,因为:
- 它是系统调用处理函数,统一放在
sysproc.c; - 需要
myproc()拿到当前进程的p->pagetable; - 需要
argaddr/argint从用户 trapframe 取参数; - 需要
copyout把位图写回用户地址; walk()在vm.c,sysproc.c可以直接调用。
注意:C 语言并没有"vm.c 不能调用 proc.c"这种限制,
vm.c也能通过defs.h调用proc.c的函数。放到sysproc.c主要是职责划分。
4.5 易错点
| 问题 | 后果 |
|---|---|
用 walkaddr() 而不是 walk() |
拿不到 PTE,无法检查 A 位 |
忘记清除 PTE_A |
下次调用仍然报告"被访问" |
PTE_A 位写错 |
必须 bit 6 |
copyout 写 8 字节 |
测试的位图是 4 字节,会踩坏用户栈 |
不检查 PTE_V / PTE_U |
可能访问无效页或非用户页 |
不检查 MAXVA |
start + npages*PGSIZE 越界,walk 可能 panic |
五、思考题一:哪些系统调用可以用共享页加速?
先问几个问题:
- 系统调用返回后,内核里的数据会不会改变?
- 会不会阻塞?
- 会不会写其他用户内存?
- 返回值是不是每个进程固定不变,或者用户态能不能自己算出来?
如果返回值是每个进程固定不变的数据,或者内核可以把它写进一块共享页,就适合用共享页加速。
uptime 是一个合适的候选:共享页里放 ticks 的 4 字节副本,用户态通过一个固定虚拟地址(类似 USYSCALL)直接读,不调系统调用。页表权限设为 PTE_R | PTE_U,用户只读。
不能"直接读内核全局变量"------ticks 是内核数据,用户页表里没有映射,用户态访问会触发 page fault 并被杀掉。这不是效率问题,是根本不通。
更新策略有两种:
- 每进程副本 :
clockintr每 tick 遍历proc[]写每个进程的共享页,代价是每 tick O(NPROC) 次写;或者scheduler()在进程被调度时更新自己的副本,代价是每次调度一次写,但用户读到的值滞后一个调度周期。 - 全局共享页 :因为
ticks是全局数据,更合理的做法是分配一个全局只读页,所有进程映射同一个物理页,clockintr每 tick 只写一次。写入次数从 NPROC 降到 1,所有进程读到的值一致,最多滞后一个 tick(约 100ms),对uptime语义可接受。
收益可以粗略写成:
bash
加速收益 = 每次读省掉的 trap 路径 × 读次数
         - 内核写入成本 × 更新次数
是否划算取决于用户读的频率:读频繁时收益显著;读很少时,更新成本可能超过收益。
六、思考题二:vmprint 与用户地址空间
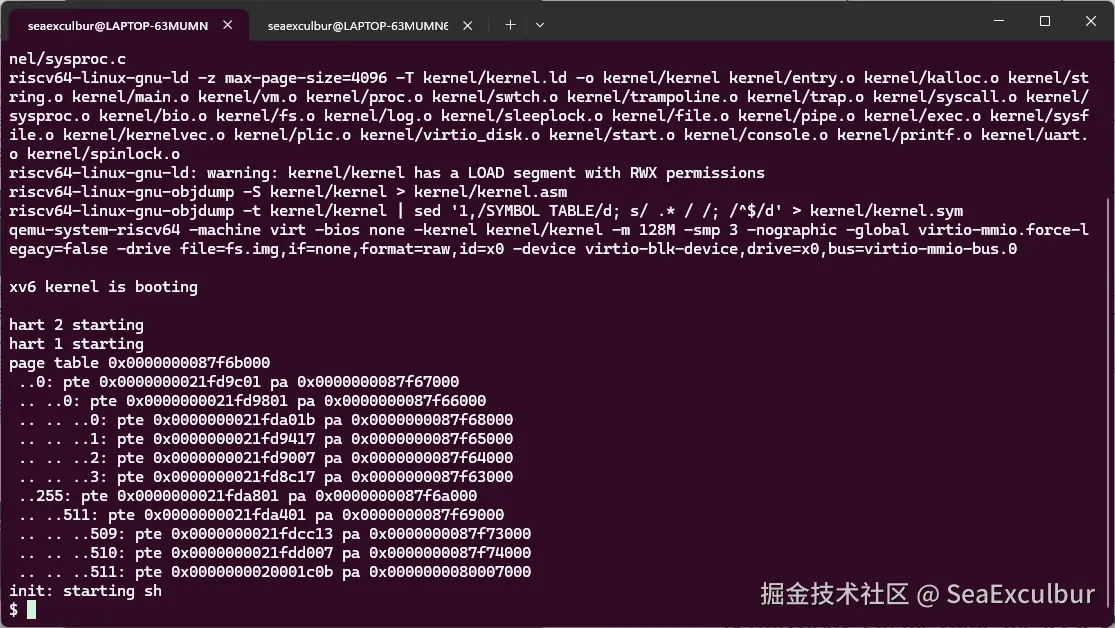
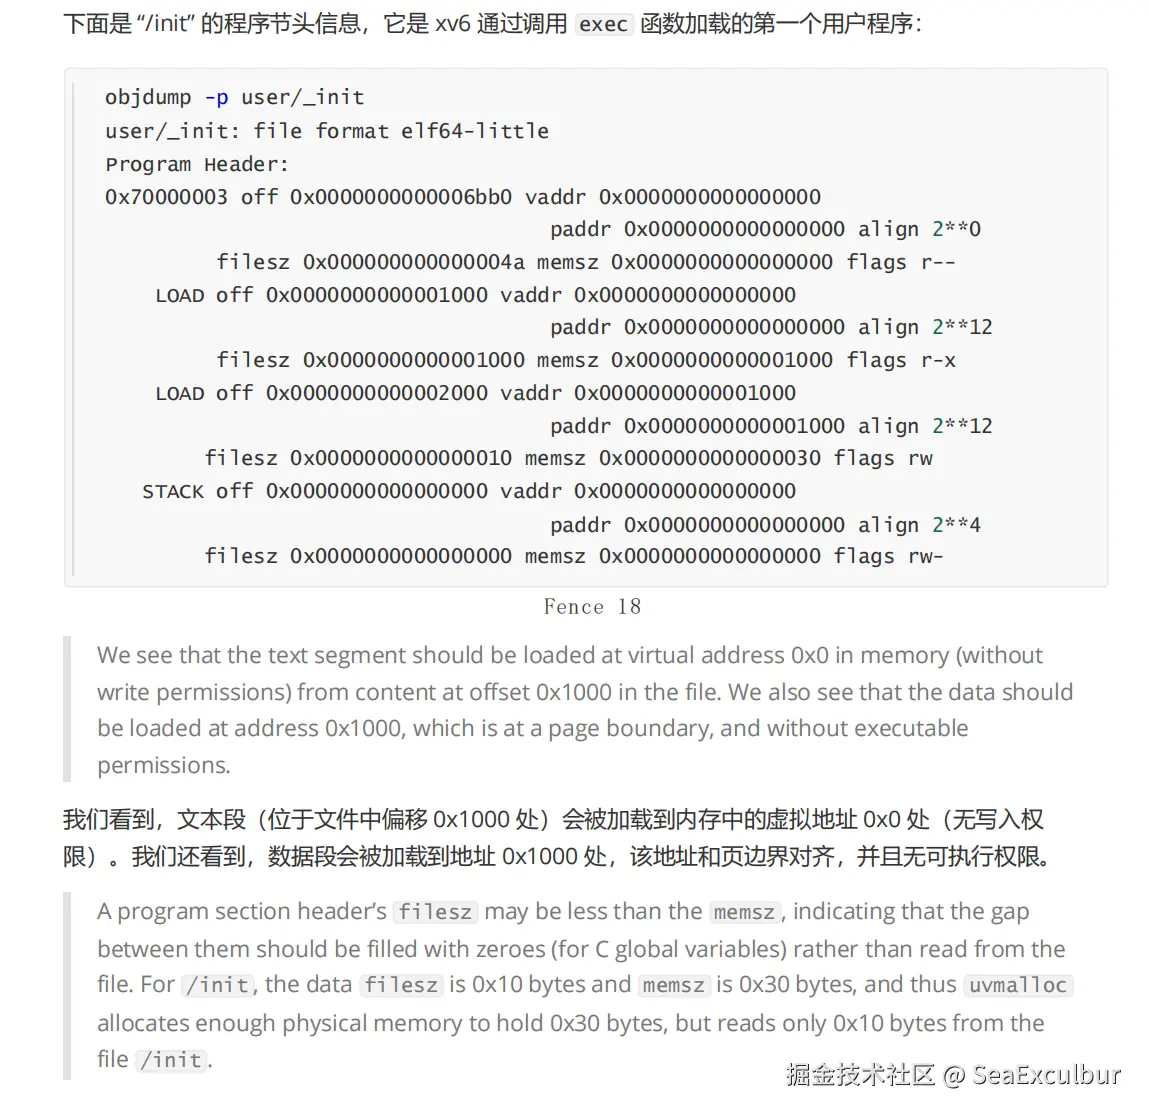
教材 Figure 3.4 的标题是 "A process's user address space, with its initial stack" ,也就是用户地址空间布局:
arduino
低地址
  text
  data
  guard page
  stack
  heap
  ...
  trampoline
  trapframe
高地址
vmprint 输出的结构和它对应:
- 低地址的 L0 叶子项:用户程序的 text、data、guard、stack;
- 高地址的 L0 叶子项(本 lab 是 509/510/511):
USYSCALL、TRAPFRAME、TRAMPOLINE。
注意:TRAPFRAME 和 TRAMPOLINE 是用户页表里的特殊页,但只有内核能访问(PTE_U=0),不要把它们说成"内核地址空间"。
四个页的权限:
| 页 | 虚拟地址 | 内容 | PTE | 用户态能否访问 | |||
|---|---|---|---|---|---|---|---|
| 0 | 0x0 |
text(代码) | 0x1b = V |
R | X | U | 可读、可执行,不可写 |
| 1 | 0x1000 |
data(数据) | 0x17 = V |
R | W | U | 可读、可写 |
| 2 | 0x2000 |
guard page | 0x07 = V |
R | W | 不可访问(没有 U) | |
| 509 | USYSCALL |
共享 pid 页 | 0x13 = V |
R | U | 只读 |
- 页 0 是文本段,文件内容在 ELF offset
0x1000处; - 页 1 是数据段,用户态可以合法读写;
- 页 2 是保护页,
exec用uvmclear()清掉PTE_U,防止栈溢出悄悄覆盖数据; - 倒数第三页 509 是任务一新增的
USYSCALL共享页。
七、深挖:链接器把代码段变成了 RWX
这是整个 lab 里我认为最值得记录的一个坑。
7.1 现象
运行 usertests 时,copyout 测试失败:
ini
test copyout: usertrap(): unexpected scause 0x000000000000000c pid=6
sepc=0x0000000000056e0a stval=0x0000000000056e0a
FAILED
scause = 0xc:取指令时页错误;sepc = stval = 0x56e0a:CPU 想从这个地址执行,但该地址不可执行。
用干净的 origin/pgtbl 分支对比,基线也会以完全相同的方式失败,说明不是 lab 代码的 bug。
7.2 原因
链接器把代码和数据合并成了一个"可读 + 可写 + 可执行"的 LOAD 段:
ini
[.text][.rodata][.data][.bss] → 一个段,flags = R-W-X内核 exec 照着这个标签,把整段每一页都设成了:
ini
V|R|W|X|U = 0x1f于是地址 0 的代码页也可写。usertests 的 copyout 测试故意调用 read(fd, (void *)0, 8192),期望内核拒绝写入;现在内核检查到 W=1,认为可以写,就把文件内容复制到了地址 0,覆盖了用户代码。CPU 随后执行被改坏的指令,跳到非法地址,触发指令页错误。
7.3 权限链
exec.c 读取每个 program header:
scss
uvmalloc(pagetable, sz, ph.vaddr + ph.memsz, flags2perm(ph.flags));flags2perm() 只读取 ELF 的 X(bit 0)和 W(bit 1):
scss
if(flags & 0x1) perm |= PTE_X;
if(flags & 0x2) perm |= PTE_W;
uvmalloc() 再补上 R 和 U:
scss
mappages(pagetable, a, PGSIZE, (uint64)mem, PTE_R | PTE_U | xperm);mappages() 最后补上 V:
ini
*pte = PA2PTE(pa) | perm | PTE_V;所以:
| PTE 位 | 来源 |
|---|---|
PTE_W / PTE_X |
链接器写的 ELF p_flags,经 flags2perm 翻译 |
PTE_R |
内核 uvmalloc 无条件加 |
PTE_U |
内核 uvmalloc 无条件加(用户程序页) |
PTE_V |
内核 mappages 加 |
关键点 :ELF 里的 PF_R 并没有被 flags2perm 使用;R 是内核固定加的。链接器真正能影响的是 W 和 X。
7.4 修复
给用户程序的链接命令加 -z separate-code,让代码和数据分成两个段:
ruby
$(LD) $(LDFLAGS) -z separate-code -T $U/user.ld -o $@ $^效果:
LOAD ... R E   ← 代码段
LOAD ... RW    ← 数据段
地址 0 的 PTE 恢复成 0x1b(V|R|X|U),copyout 测试就能通过。
7.5 更深一层:W^X 需要内核策略和段粒度配合
如果在内核里强制 W^X:
scss
if(perm & PTE_X)
  perm &= ~PTE_W;
会有两种结果:
| 链接方式 | 结果 |
|---|---|
| 单段 RWX | 强制 W^X 后,数据段也变成 R-X,用户程序写全局变量会 fault |
-z separate-code |
代码段 R-X,数据段 RW,程序正常运行,W^X 成立 |
这说明:
W^X 不只是内核策略,还要求链接器把代码和数据分到不同的页/段;粒度不对,策略就无法落地。
7.6 可以带走的结论
- 链接器在 ELF 里写的是段标签:W / X;
- 内核
exec读标签,补上 R / U / V; - 内核保留最终解释权,可以强制 W^X、限制某些权限;
- 栈、guard page、trampoline、trapframe 等特殊页的权限完全由内核硬编码;
- 内核和用户程序的隔离靠独立页表、
PTE_U和特权级,不是靠"内核能识别 ELF 的内容"。
八、总结
这个 lab 表面上是在写三个功能,实际把"权限从哪来"这件事讲透了:
bash
链接器(ELF 段标签:W/X)
        ↓
内核(exec:加 R/U/V,特殊页硬编码,可选 W^X)
        ↓
MMU(按 PTE 执行)
一句话:
ELF 只是"申请",内核是"审批",MMU 是"执行"。
理解这一点之后,再看 mappages() 就不会误以为"内核自己决定了所有权限";它只是流水线上的执行者,真正的决策分散在链接器、exec 和内核策略里。