关键词:PDF 转图片、图片转 PDF、pdf.js、pdf-lib、JSZip、Canvas、本地处理、纯前端、JavaScript
一、背景与需求
日常工作中,PDF 与图片互相转换是高频需求:提取 PDF 某一页作为图片发给同事,或把多张证件照片、发票合并成一个 PDF 提交审核。
现有的在线转换工具普遍存在以下问题:
- 文件需上传到第三方服务器,合同、发票、证件等敏感文档泄露风险高;
- 多数工具加水印、限制转换次数,或要求注册登录 / 安装桌面客户端;
- PDF 转图片时缺乏清晰度与格式选择,图片转 PDF 时缺乏顺序调整与页面尺寸控制。
基于此,我开发了 Toolion PDF 转图片 / 图片转 PDF 工具 (项目地址:toolion.cn/pdf-img-con... 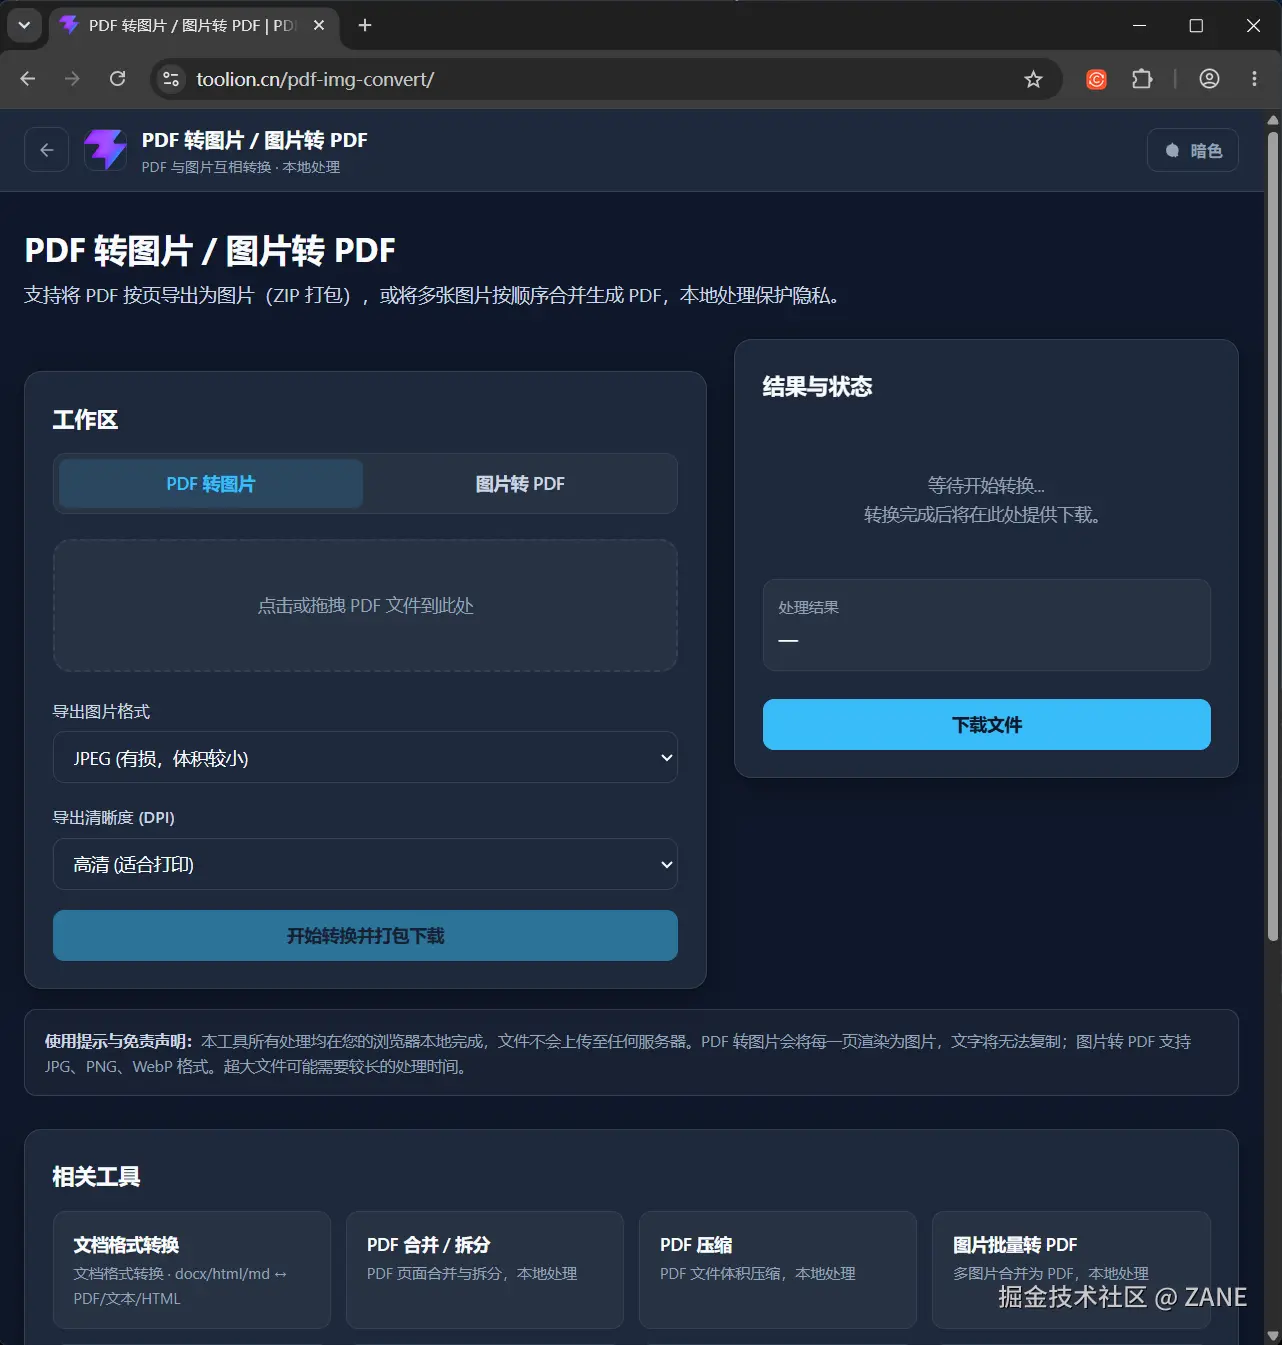
二、核心功能
| 功能 | 说明 |
|---|---|
| PDF 转图片 | 将 PDF 每一页渲染为独立图片,支持 PNG / JPEG 格式,标准 / 高清 / 超清三种清晰度 |
| ZIP 打包下载 | 转换出的所有页面图片打包成一个 ZIP 文件,方便统一管理与下载 |
| 图片转 PDF | 将多张 JPG / PNG / WebP 图片合并为一个 PDF 文件 |
| 拖拽调整顺序 | 图片转 PDF 时支持拖拽调整图片在列表中的位置,合并时按最终顺序生成页面 |
| 页面尺寸可选 | 支持"自动适应图片尺寸"或"统一为 A4 尺寸(居中留白)" |
| 按比例缩放居中 | 图片尺寸不一致时自动按比例缩放并居中,避免变形 |
| 纯前端本地处理 | 所有处理在浏览器内存完成,文件不上传服务器,支持离线运行 |
| 免登录免费无水印 | 打开页面即用,无需注册,不加水印,不限制转换次数 |
| 深色/浅色主题 | CSS 变量适配深色模式 |
三、技术实现
3.1 整体架构
该工具是一个纯前端单页面应用,未引入 Vue/React 等前端框架,全部逻辑使用原生 JavaScript 实现:
css
浏览器端(纯原生 JavaScript)
├── 输入层:PDF 文件 / 图片文件选择、转换模式、格式、清晰度、页面尺寸
├── PDF→图片层:pdf.js 渲染页面到 Canvas → 图片 Blob → JSZip 打包 ZIP
├── 图片→PDF层:pdf-lib 创建 PDF → 嵌入图片(WebP 经 Canvas 转 JPEG)→ 保存输出
└── 渲染层:文件列表、拖拽排序、进度条、结果面板、下载按钮
3.2 依赖库
页面通过 CDN 引入四个关键库:
html
<script src="https://unpkg.com/pdf-lib@1.17.1/dist/pdf-lib.min.js"></script>
<script src="https://cdnjs.cloudflare.com/ajax/libs/pdf.js/3.11.174/pdf.min.js"></script>
<script src="https://cdnjs.cloudflare.com/ajax/libs/jszip/3.10.1/jszip.min.js"></script>
<script src="https://cdnjs.cloudflare.com/ajax/libs/FileSaver.js/2.0.5/FileSaver.min.js"></script>- pdf.js 3.11.174:解析 PDF 文件,逐页获取页面视图并渲染到 Canvas;
- pdf-lib 1.17.1:创建新 PDF 文档,嵌入图片,添加页面并保存输出;
- JSZip 3.10.1:将 PDF 转图片生成的多张图片打包成一个 ZIP 文件下载;
- FileSaver.js 2.0.5 :将生成的 Blob 保存为文件,非 HTTPS 环境下降级为
a.download原生下载。
使用前会检测所需依赖是否加载成功,并设置 pdf.js 的 Worker 资源路径:
javascript
const DEPS = {
  pdfjsLib: typeof pdfjsLib !== 'undefined',
  PDFLib: typeof PDFLib !== 'undefined',
  JSZip: typeof JSZip !== 'undefined',
  saveAs: typeof saveAs !== 'undefined'
};

if (DEPS.pdfjsLib) {
  pdfjsLib.GlobalWorkerOptions.workerSrc = 'https://cdnjs.cloudflare.com/ajax/libs/pdf.js/3.11.174/pdf.worker.min.js';
}

function ensureDeps(required) {
  const missing = required.filter(name => !DEPS[name]);
  if (missing.length > 0) {
    alert('核心依赖库加载失败:' + missing.join('、') + '。请检查网络后刷新页面重试。');
    return false;
  }
  return true;
}
3.3 PDF 转图片(核心流程)
PDF 转图片使用 pdf.js 逐页渲染,输出为图片后用 JSZip 打包下载:
javascript
const arrayBuffer = await pdfFile.arrayBuffer();
pdf = await pdfjsLib.getDocument({ data: new Uint8Array(arrayBuffer.slice(0)) }).promise;
const numPages = pdf.numPages;

const zip = new JSZip();
const folderName = (pdfFile.name.replace(/\.pdf$/i, '') || 'images')
  .replace(/[\/\\:*?"<>|]/g, '_');  // 清理文件名中的非法字符
const folder = zip.folder(folderName);

for (let i = 1; i <= numPages; i++) {
  const page = await pdf.getPage(i);
  let viewport = page.getViewport({ scale });  // scale 由清晰度选项决定:1.5 / 2.0 / 3.0

  // 限制最大尺寸,防止超长页面导致 Canvas 过大
  const MAX_DIM = 3000;
  if (viewport.width > MAX_DIM || viewport.height > MAX_DIM) {
    const fixScale = Math.min(MAX_DIM / viewport.width, MAX_DIM / viewport.height);
    viewport = page.getViewport({ scale: scale * fixScale });
  }

  const canvas = document.createElement('canvas');
  const ctx = canvas.getContext('2d', { alpha: false });
  canvas.width = Math.round(viewport.width);
  canvas.height = Math.round(viewport.height);

  await page.render({ canvasContext: ctx, viewport }).promise;

  // Canvas 转图片 Blob(PNG 或 JPEG)
  const blob = await new Promise(resolve => canvas.toBlob(resolve, format, 0.9));
  if (!blob) {
    throw new Error('第 ' + i + ' 页渲染失败');
  }
  const imgData = await blob.arrayBuffer();

  folder.file(`page_${String(i).padStart(3, '0')}.${ext}`, imgData);

  // 释放 Canvas 内存
  canvas.width = 0;
  canvas.height = 0;

  // 让出执行时间片,避免页面卡死
  await new Promise(r => setTimeout(r, 10));

  updateProgress(Math.round((i / numPages) * 100), `正在渲染第 ${i} / ${numPages} 页...`);
}

const content = await zip.generateAsync({ type: 'blob' });
关键点:
- 清晰度选项:标准(scale 1.5,约 108 DPI)、高清(scale 2.0,约 144 DPI)、超清(scale 3.0,约 216 DPI),清晰度越高体积越大;
- 格式选项:PNG(无损,体积较大)或 JPEG(有损,体积较小);
- 最大尺寸限制 :
MAX_DIM = 3000px,超长或超宽页面按比例缩小,防止 Canvas 过大导致内存溢出; - 逐页处理 + 内存释放:每页渲染完后将 Canvas 宽高置零,避免多页累积占用内存;
- 让出时间片 :
await new Promise(r => setTimeout(r, 10))让浏览器有机会更新进度条,避免长时间阻塞主线程; - 文件名安全处理 :清理 ZIP 文件夹名中的
\ / : * ? " < > |等非法字符; - 资源释放 :
finally块中调用pdf.destroy()释放 pdf.js 资源。
生成的 ZIP 文件内按 page_001.png、page_002.png 等命名,方便按页查找。
3.4 图片转 PDF(核心流程)
图片转 PDF 使用 pdf-lib 创建文档,将每张图片嵌入为独立页面:
javascript
const pdfDoc = await PDFLib.PDFDocument.create();

for (let i = 0; i < img2pdfFiles.length; i++) {
  const file = img2pdfFiles[i];
  const arrayBuffer = await file.arrayBuffer();

  let image;
  if (file.type === 'image/png') {
    image = await pdfDoc.embedPng(arrayBuffer);
  } else if (file.type === 'image/jpeg' || file.type === 'image/jpg') {
    image = await pdfDoc.embedJpg(arrayBuffer);
  } else {
    // WebP 等 pdf-lib 不直接支持的格式,经 Canvas 转为 JPEG 再嵌入
    const img = new Image();
    const url = URL.createObjectURL(file);
    img.src = url;

    await new Promise((resolve, reject) => {
      img.onload = resolve;
      img.onerror = () => reject(new Error('图片加载失败:' + file.name));
      setTimeout(() => reject(new Error('图片加载超时:' + file.name)), 15000);
    });

    const canvas = document.createElement('canvas');
    canvas.width = img.width;
    canvas.height = img.height;
    const ctx = canvas.getContext('2d');
    ctx.fillStyle = '#ffffff';  // 填充白底,防止透明区域变黑
    ctx.fillRect(0, 0, canvas.width, canvas.height);
    ctx.drawImage(img, 0, 0);

    const jpgBlob = await new Promise(resolve => canvas.toBlob(resolve, 'image/jpeg', 0.95));
    if (!jpgBlob) {
      throw new Error('图片转换为 JPEG 失败(可能图片过大):' + file.name);
    }
    const jpgBuffer = await jpgBlob.arrayBuffer();
    image = await pdfDoc.embedJpg(jpgBuffer);

    URL.revokeObjectURL(url);  // 释放对象 URL
  }

  const imgW = image.width;
  const imgH = image.height;

  if (pageSizeMode === 'auto') {
    // 页面尺寸自动适应图片原始尺寸
    const page = pdfDoc.addPage([imgW, imgH]);
    page.drawImage(image, { x: 0, y: 0, width: imgW, height: imgH });
  } else {
    // 统一 A4 尺寸,根据图片方向选择横向/纵向 A4
    const isLandscape = imgW > imgH;
    const pageW = isLandscape ? 841.89 : 595.28;
    const pageH = isLandscape ? 595.28 : 841.89;
    const page = pdfDoc.addPage([pageW, pageH]);

    // 等比缩放并居中
    const scale = Math.min(pageW / imgW, pageH / imgH);
    const drawW = imgW * scale;
    const drawH = imgH * scale;
    const x = (pageW - drawW) / 2;
    const y = (pageH - drawH) / 2;

    page.drawImage(image, { x, y, width: drawW, height: drawH });
  }

  updateProgress(Math.round((i / img2pdfFiles.length) * 100), `正在处理第 ${i + 1} / ${img2pdfFiles.length} 张图片...`);
}

const pdfBytes = await pdfDoc.save();
const blob = new Blob([pdfBytes], { type: 'application/pdf' });
关键点:
- 格式嵌入 :PNG 用
embedPng,JPEG 用embedJpg;WebP 等 pdf-lib 不直接支持的格式,先通过 Canvas 绘制并填充白色背景(避免透明底变黑),再toBlob('image/jpeg', 0.95)转为 JPEG 嵌入; - 页面尺寸 :
auto模式按图片原始尺寸生成页面;A4模式按图片横纵方向自动选择 A4 纵向(595.28×841.89 pt)或横向(841.89×595.28 pt); - 比例缩放居中 :
scale = min(pageW/imgW, pageH/imgH),保持原图比例,居中放置,避免变形; - 超时与错误处理 :图片加载设置 15 秒超时,
onerror捕捉损坏文件,try-finally确保URL.revokeObjectURL释放对象 URL; - 内存管理:每页处理完后释放 Canvas 与对象 URL。
3.5 图片列表与拖拽排序
图片转 PDF 模式支持多图上传与拖拽排序:
- 按
文件名_大小_修改时间构建唯一键去重,避免重复文件干扰顺序; - 文件列表项设置
draggable="true",利用 HTML5 拖拽 API 实现顺序调整; dragstart记录当前项索引,drop将项从原位置移除并插入到目标位置;- 校验
fromIndex是否为有效数字且不越界,防止外部文件拖入导致parseInt为 NaN; - 文件名在显示前进行 HTML 转义,防止 XSS。
3.6 文件下载
生成的文件(ZIP 或 PDF)转为 Blob 后下载:
javascript
if (typeof saveAs === 'function') {
  saveAs(downloadBlob, downloadName);
} else {
  const url = URL.createObjectURL(downloadBlob);
  const a = document.createElement('a');
  a.href = url;
  a.download = downloadName;
  document.body.appendChild(a);
  a.click();
  document.body.removeChild(a);
  setTimeout(() => URL.revokeObjectURL(url), 1000);
}
优先使用 FileSaver.js 的 saveAs;若库未加载,降级为创建隐藏 a 标签触发浏览器原生下载,并及时 revokeObjectURL 释放内存。
3.7 前端实现要点
- 依赖检测:每个转换按钮点击前检测所需库是否可用,CDN 加载失败时提示用户检查网络并刷新;
- 状态锁:转换过程中禁用按钮并关闭上传区交互,防止重复提交;
- 进度反馈:每处理一页/一张图片更新一次进度条与当前进度,用户可直观了解处理状态;
- 结果面板:转换成功后显示处理结果文本(如"成功导出 N 张图片"),提供下载按钮;
- 内存管理 :
URL.revokeObjectURL及时释放图片与结果 Blob 的对象 URL; - 深色模式:全站使用 CSS 变量定义配色,深色模式下卡片背景、边框、文字颜色自动适配;
- 文件类型校验 :PDF 转图片仅接受
.pdf后缀或application/pdfMIME 类型;图片转 PDF 接受image/png, image/jpeg, image/webp。
所有输入、绘制与转换均在浏览器本地完成,文件内容不上传任何服务器。
四、关键技术挑战与解决方案
| 挑战 | 解决方案 | |
|---|---|---|
| pdf-lib 不直接支持 WebP/GIF/BMP | 通过 Canvas 绘制并填充白底,toBlob('image/jpeg') 转为 JPEG 再嵌入 PDF |
|
| 透明背景图片在 PDF 中可能显示为黑底 | Canvas 绘制前先 fillRect 白色背景,再绘制图像 |
|
| 超长 PDF 页面导致 Canvas 过大、内存溢出 | 限制最大边长 3000 px,超限按比例缩小渲染 | |
超大图片导致 toDataURL 内存溢出 |
改用 toBlob,并在 try-catch 中捕获失败 |
|
| 图片加载挂起导致页面卡死 | img.onload/onerror 配合 15 秒 setTimeout 超时控制 |
|
| 长时间转换阻塞主线程、进度条不更新 | 每页/每张处理后 setTimeout 让出时间片,配合进度条实时反馈 |
|
| 外部文件拖入导致排序索引异常 | 校验 fromIndex 是否为有效数字且不越界,异常时直接返回 |
|
| ZIP 文件夹名含非法字符 | 正则清理 `\ / : * ? " < > | ` 等字符 |
非 HTTPS 环境下 saveAs 不可用 |
FileSaver.js 优先,失败后降级为 a.download 原生下载 |
|
| 第三方库 CDN 加载失败 | 转换前检测依赖可用性,失败时提示检查网络并刷新 | |
| 纯前端无后端依赖 | 所有处理封装在前端,浏览器即可离线运行 |
五、使用示例
场景 1:将一份 10 页的合同 PDF 转为图片,逐页查看
- 打开
https://toolion.cn/pdf-img-convert/,保持"PDF 转图片"模式; - 点击上传区或拖拽 PDF 文件进去;
- 选择导出图片格式"JPEG(有损,体积较小)",清晰度"高清(约 144 DPI,适合打印)";
- 点击"开始转换并打包下载",等待进度条完成;
- 下载 ZIP 压缩包,内含
page_001.jpg至page_010.jpg,逐页查看。
场景 2:将 5 张证件照片合并为一份 A4 PDF,供报销使用
- 切换到"图片转 PDF"模式;
- 点击上传区或拖拽 5 张 JPG/PNG 图片进去;
- 通过拖拽调整图片顺序,确保证件按正反面排列;
- 页面尺寸选择"统一为 A4 尺寸(居中留白)";
- 点击"生成 PDF 并下载",等待进度条完成;
- 下载
images_merged.pdf。
注意事项:
- PDF 转图片会将每一页渲染为图片,文字将无法复制、搜索,适合仅需查看或插入其他文档的场景;
- 清晰度越高,生成的图片体积越大,ZIP 文件也会相应增大;
- 图片转 PDF 支持 JPG、PNG、WebP 格式,WebP 会经 Canvas 转为 JPEG 再嵌入;
- 一次性转换页数很多或图片分辨率很高时,处理可能需要数秒,请耐心等待进度完成;
- 涉及合同、财务报表、个人证件等敏感文件,建议使用本地处理工具,避免上传到第三方服务器。
六、免责声明
本文仅提供技术实现分享,相关工具仅供学习与日常便利使用,不构成任何商业建议。PDF 转图片后文字将无法复制,图片转 PDF 因页面重新组装可能改变原文件结构,重要文档建议生成后检查一遍。本工具在浏览器本地内存中处理文件,文件不会上传到服务器,页面关闭后即从内存释放。
七、总结
本文介绍了一种纯前端实现的 PDF 与图片互相转换方案。核心设计思路:
- 双向转换:PDF→图片(逐页渲染 + JSZip 打包 ZIP)与图片→PDF(pdf-lib 嵌入图片)在同一页面完成;
- pdf.js 渲染:PDF 每页渲染到 Canvas,支持 PNG/JPEG 输出与标准/高清/超清三种清晰度;
- pdf-lib 组装:PNG/JPEG 直接嵌入,WebP 经 Canvas 转为 JPEG 再嵌入,支持 A4/自动页面尺寸与比例缩放居中;
- 拖拽排序:HTML5 拖拽 API 实现图片顺序自定义,合并前灵活调整;
- ZIP 打包:PDF 转图片的多张图片打包成一个 ZIP 文件,方便统一管理下载;
- 隐私优先:全部处理在浏览器本地完成,文件不上传服务器,无需登录,无水印;
- 健壮性 :依赖加载检测、图片加载超时、Canvas 最大尺寸限制、内存释放、try-catch 错误处理、
saveAs降级方案。
该方案适合需要轻量级、纯前端 PDF 与图片互转能力的场景,可作为前端文档处理类工具页面的技术参考。
#PDF转图片 #图片转PDF #PDF与图片互转 #pdf.js #pdf-lib #JSZip #纯前端 #JavaScript #Canvas #本地处理 #隐私安全 #办公工具 #文档处理 #工具开发