为什么会有本系列
本系列【手搓 AI Agent · Python 版】是手搓 Agent 教学项目 Teernage/powercode 的 Python 重实现版本;为什么要做这个系列呢?是因为当我在掘金社区刷到 @不一样的少年_ 大佬的【不用框架,手搓 AI Agent】系列时,感觉写得很好,但是想深入学习时,发现代码都是 Node/TS 实现。想掌握技术细节,但看得似懂非懂,如果先学习 Node/TS,又感觉成本太高。于是就想着实现一个 Python 版本的手搓 Agent 系列,以便让自己能更深入学习 Agent 的相关技术细节。整理成博客,以便那些熟悉 Python 但不熟 Node/TS 的小伙伴能一起进步成长;当然如果你已有 Node/TS 基础,强烈建议去学习 【不用框架,手搓 AI Agent】系列,真的很棒。再次感谢 Teernage 大佬的开源分享。
本系列的源码 powercode-py,本篇对应 commit 390d6c5;如果你觉得对你有帮助,请点个 star ⭐。
上篇回顾:上一篇给 AI 装上了 Plan Mode,先只读着摸清项目、交计划等你签字,批准了才恢复写工具。
本篇目标:让它报错之后别原地打转------把失败分好类、附一句该怎么改的提示,再记两本账,连续失败到上限就自动停火。
一、报错就死磕,Token 白烧
上一期收工后,AI 已经会规划、会动手了。但真让它改起代码,还是有个让人抓狂的毛病。
比如你要把 config.py 里的日志级别调一下,之前 AI 读到的还是:
python
LOG_LEVEL = "INFO"你手动改成了 "WARN",然后让它继续。可 AI 的上下文里还留着旧的那行 LOG_LEVEL = "INFO",于是它调 edit_file 想把这行换掉------结果当然匹配不上,报一句"没有找到 old_text"。
然后它就开始了:加个空格再试 " LOG_LEVEL = \"INFO\"",不行;换个引号 "LOG_LEVEL = 'INFO'",还是不行;再换换行......就这么对着一个过时的值硬猜,连着烧了十几轮,token 哗哗涨,活儿一点没往前推。
你看着终端里一长串 ✗ edit_file,血压都上来了。
问题不在它蠢。是上一版程序给它的反馈太干瘪了------工具一报错,就原样甩回一句"没有找到 old_text",至于错在哪一类、下一步该怎么换路子 ,一个字没提。模型只能瞎猜。更糟的是,程序压根没记它失败了多少次,它想在同一个坑里摔几轮就摔几轮,直到把 MAX_STEPS 那 30 轮全耗光。
这一篇,我们给后厨加两道保险:
- 报错分类 + 恢复提示 :菜做砸了,前台(Harness)不只喊"做砸了",而是说"你这次是盐放多了,先去尝一口,再重新调味"。
- 双账本 + 熔断 :记两本账------"同一道菜你连砸了几次" + "这一桌总共砸了几次",到上限就停火,把锅收走,等老板(你)来。
二、先分清两件事:给建议,还是踩刹车
这里有个容易绕晕的点:报错之后,我们要做的是两件不一样的事,别混成一件事。
第一件,是给模型递一张"补救小抄" 。同样是 edit_file 报错,"找不到旧文本"和"旧文本命中多处"的解法完全相反:
text
找不到 old_text   →  先 read_file 重读文件,拿到最新的真实内容
old_text 命中多处 →  补上相邻上下文,让这段文本变唯一
光甩一句"没有找到 old_text",模型不知道该往哪个方向救;把错误掰开、附上对应的下一步,它才有谱。
第二件,是给程序记两本账,到点踩刹车。因为小抄再好,模型也可能当耳旁风------劝它拐弯,它未必拐。所以程序得自己数着:同一个错误调用连续失败几次了?这一次运行总共失败几次了?数到上限,不管模型还想不想试,直接停火。
用图看是这样:
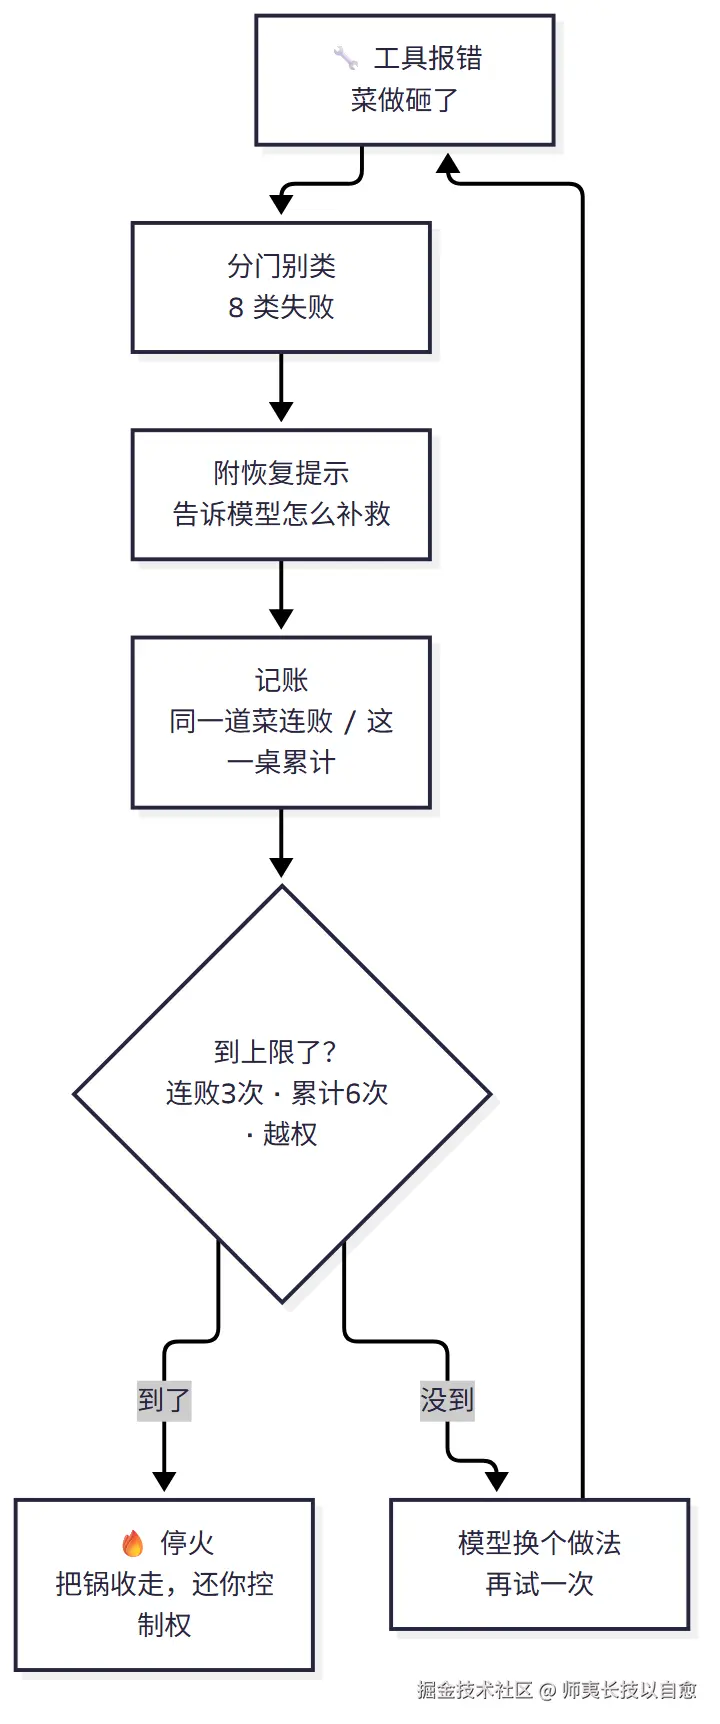
所以这一篇的两大块,一句话概括:**报错要分类、要给建议;失败要记账、要踩刹车。**前者让模型会拐弯,后者让它别死磕。
三、先看效果
改造完,错误输出会从一句干巴巴的报错,变成这样(离线 demo python -m examples.demo_recovery 的确定性输出):
text
✗ edit_file:edit_mismatch
工具执行失败:没有找到 old_text,请先重新读取文件。
[Harness 恢复提示] 类型:edit_mismatch
先 read_file 读取最新内容,再提取准确的 old_text;不要原样重复编辑。
同一调用失败 1/3 次;本次累计失败 1/6 次。

✓ read_file 执行完成
✓ edit_file 执行完成

同一调用失败 3/3 次;本次累计失败 3/6 次。
已暂停本次运行,未验证的 TODO 不能标为完成。
stop=true
看到最后那个 stop=true 了吗?这就是双账本记到上限,程序踩下了刹车。
真机上也跑得通(真实冒烟,2026-11-09):让它把 README 里一句"不存在的文本 XYZ123"替换成别的,它先 read_file + search_files 确认这句压根不存在,然后直接报告"未做修改",没有盲改。
⚠️ 免责:上面离线 demo 是确定性输出、可直接复现;真机那条是 LLM 生成、非确定,关键是看它报错后先查证、而不是瞎改。
为了跑出这个效果,要写的代码串成一条流水线:
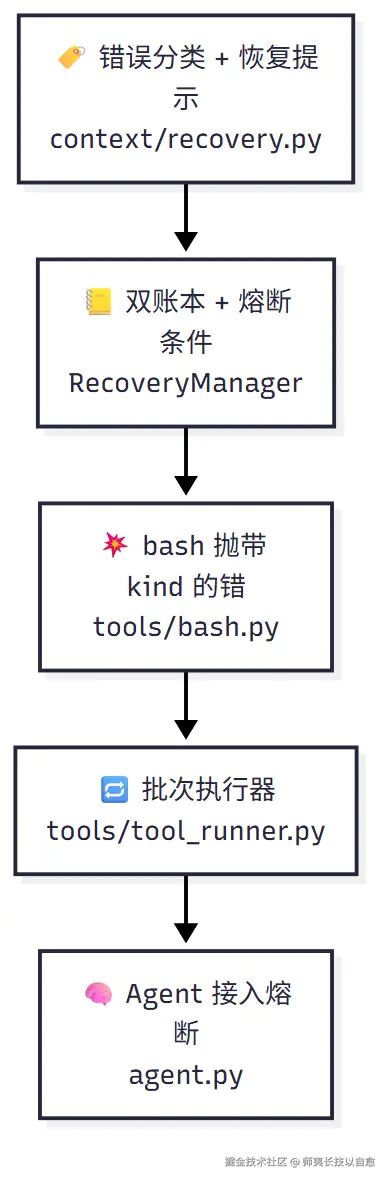
一句话记图:第四节把错误分类 + 配恢复提示(recovery.py),第五节立双账本 + 熔断条件(RecoveryManager),第六节把账本接进 bash 和 Agent 主循环(tool_runner.py + agent.py)。
四、第一步:把"做砸了"分门别类
要让程序能"对症下药",第一步是把报错分成八类,每类配一句该怎么做。新建 powercode_py/context/recovery.py:
python
class ToolExecutionError(ToolError):
    """带失败类型(kind)的工具执行错误。"""

    def __init__(self, kind: str, message: str):
        super().__init__(message)
        self.kind = kind   # 有的工具(比如 bash)抛错时就知道自己是哪类


HINTS = {
    "edit_mismatch": "先 read_file 读取最新内容,再提取准确的 old_text;不要原样重复编辑。",
    "edit_ambiguous": "old_text 命中多处;读取文件并补充相邻上下文,确认唯一后再编辑。",
    "not_found": "先 list_files 或 search_files 确认真实路径,不要连续猜文件名。",
    "permission": "保留当前权限限制,向用户说明被拒绝的操作;不要换工具绕过,也不要自行提权。",
    # timeout / output_limit / command_failed / unknown 省略,同理各配一句
}八类大致是:edit_mismatch / edit_ambiguous(改文件的两类匹配失败)、not_found(路径不对)、permission(越权或受限)、timeout / output_limit(跑太久 / 输出太多)、command_failed(命令退出非零)、unknown(兜底)。
为什么连 edit_file 的报错都要掰成两类?举个具体例子------config.ini 里 [dev] 和 [prod] 两段都写了 debug=true:
ini
[dev]
debug=true

[prod]
debug=true
模型想关掉生产环境的 debug,却图省事只传了 old_text='debug=true',一下命中两处。如果程序随手改掉第一处,就把 [dev] 给误改了。所以"找不到"和"命中多处"的补救方向完全不同:前者重读文件,后者补齐上下文(传 '[prod]\ndebug=true')。
那程序怎么认出这八类呢?靠 classify_failure,思路是"显式类型优先,文案兜底":
python
def classify_failure(name: str, error) -> str:
    if isinstance(error, ToolExecutionError):
        return error.kind          # 工具自己说了是哪种,直接信
    message = str(error)
    if "当前模式不允许" in message or "只能操作当前项目" in message:
        return "permission"        # 越界 / 违反 Plan Mode 限制
    if "文件不存在" in message:
        return "not_found"
    if name == "edit_file" and "没有找到 old_text" in message:
        return "edit_mismatch"
    if name == "edit_file" and "old_text 出现了" in message:
        return "edit_ambiguous"
return "unknown" # 都不沾边,兜底注意两条边界:ToolExecutionError 直接返回自带 kind(bash 抛错时就知道自己是超时还是命令失败);普通错误才靠匹配报错文字认------所以 edit_file 报错文案里那几句"没有找到 old_text""old_text 出现了",其实是靠匹配报错文字认出来的------改了文案,分类函数里的匹配条件也得跟着改。
五、第二步:立两本账,到上限停火
光分类还不够。模型可能在同一道菜上反复撞墙,得记账。RecoveryManager 维护两本账:
python
class RecoveryManager:
    def __init__(self):
        self._failures = {}       # 同一道菜的连败次数(按指纹)
        self._total_failures = 0  # 这一桌累计做砸的次数

    def on_success(self, name, args):
        self._failures.pop(call_key(name, args), None)  # 这道菜做成了,销它的账

    def on_failure(self, name, args, error):
        kind = classify_failure(name, error)
        key = call_key(name, args)
        count = self._failures.get(key, 0) + 1
        self._failures[key] = count
        self._total_failures += 1
        stop = kind == "permission" or count >= 3 or self._total_failures >= 6
        # ...拼出"原始报错 + 类型 + 提示 + 失败进度",返回 RecoveryDecision
熔断条件就一条 stop = ...,三选一:
text
permission(越权)       → 立刻停,不等账本
同一调用连败满 3 次       → 停
本次运行累计失败满 6 次   → 停
为什么费劲记两本账?各管一摊:
- 单调用账本:抓"同一道菜反复做砸"。哪怕中间成功做了别的菜,也不替它销账------只要这道菜成功之前连砸满 3 次,就停。
- 总账:防"换着花样砸"。模型要是学精了,每次都改一点点参数(加个空格、换个写法),指纹每次都不一样,单账本攒不够;但总账只增不减,累计 6 次照样拦下。
那"同一道菜"怎么认?靠指纹 call_key------用"工具名 + 参数"算一个 sha256:
python
def call_key(name: str, args: str) -> str:
    normalized = args
    try:
        normalized = json.dumps(_canonical(json.loads(args)), sort_keys=True)
    except (json.JSONDecodeError, TypeError):
        pass
    payload = json.dumps([name, normalized], ensure_ascii=False).encode("utf-8")
    return hashlib.sha256(payload).hexdigest()
这里藏着一个小坑:模型第一次可能传 {"path":"a","old_text":"x"},第二次传 {"old_text":"x","path":"a"}------字段顺序颠倒了,但其实是同一道菜。所以 _canonical 会先把 JSON 对象的键排个序再算哈希,才能认出是重复点菜。(哈希只认字面、不懂路径语义,a.txt 和 ./a.txt 还是会算成两个指纹,这也正是总账存在的意义。)
六、第三步:把账本接进后厨
6.1 bash 抛错时带上自己的类型
bash 工具最清楚自己是怎么失败的,所以超时、命令失败直接抛带 kind 的错。powercode_py/tools/bash.py 的关键改动:
python
except subprocess.TimeoutExpired as exc:
    output = _truncate(_format_output(exc.stdout or "", exc.stderr or ""))
    if output:
        raise ToolExecutionError("timeout", f"命令执行超时:{command}\n\n{output}") from exc
    raise ToolExecutionError("timeout", f"命令执行超时:{command}") from exc

if proc.returncode != 0:
    output = _truncate(_format_output(proc.stdout, proc.stderr))
    raise ToolExecutionError("command_failed", f"命令执行失败(退出码 {proc.returncode})\n\n{output}")
这样 classify_failure 一看到 ToolExecutionError,直接取它自带的 kind,不用再猜。(顺带一提:之前第 5 篇修过的 GBK 编码坑,这里 text=True 的解码逻辑沿用上一版,没动。)
6.2 批次执行器:先验货再动手,停火就跳过剩余
模型一次可能打包调好几个工具。新建 powercode_py/tools/tool_runner.py 的 run_tool_batch:
python
def run_tool_batch(calls, registry, allowed_names, recovery) -> dict:
    for call in calls:
        if call.type != "function":
            raise ToolError(f"暂时不支持工具类型:{call.type}")  # 先整批验类型,再动手

    messages = []
    stop = False
    stop_reason = ""
    for call in calls:
        if call.type != "function":
            continue
        name = call.function.name
        args = call.function.arguments
        if stop:
            output = "本次运行已暂停,此工具调用未执行。"   # 停火后,剩余调用只补占位
        else:
            try:
                output = registry.execute(name, args, allowed_names)
                recovery.on_success(name, args)
                print(f"✓ {name} 执行完成")
            except Exception as error:
                decision = recovery.on_failure(name, args, error)
                output = decision.output
                stop = decision.stop
                if stop:
                    stop_reason = output
                print(f"✗ {name}:{decision.kind}")
        messages.append({"role": "tool", "tool_call_id": call.id, "content": output})
    return {"messages": messages, "stop": stop, "stop_reason": stop_reason}
两个地方得盯紧:
- 先整批验类型,再动手 :万一前面几个工具已经把文件改了,执行到一半才发现后面混着不支持的调用,就晚了。所以代码先用第一个
for循环把整批调用验一遍------非function的直接raise;后面真正执行的那个for循环里,又留了一道if call.type != "function": continue兜底。 - 停火后,剩余调用也要补一条占位消息 :模型接口要求------assistant 消息里只要有
tool_calls,历史里就得给每个tool_call_id补一条tool结果,少一个下次请求就报错。所以跳过的调用塞一句"本次运行已暂停,此工具调用未执行",只为凑齐格式,不代表它真跑了。
6.3 Agent 主循环:每次 run 独立记账,停火就返回
最后改 powercode_py/agent.py。两处改动:
python
def run(self, prompt: str) -> str:
    ...
    self.session.append({"role": "user", "content": prompt})
    recovery = RecoveryManager()          # 每次 run 新建账本,跨轮不累计

    for step in range(1, MAX_STEPS + 1):
        ...
        batch = run_tool_batch(tool_calls, self.registry, allowed, recovery)
        self.session.append(*batch["messages"])

        if batch["stop"]:
            # 不调 finish_execution:暂停 ≠ 计划已完成
            return f"本次运行已暂停。\n{batch['stop_reason']}\n请检查当前文件和未完成 TODO 后再继续。"

        if self.state.get_status() == "waiting_for_approval":
            ...
两处关键:
RecoveryManager()建在for循环外面 :账本跟着这次run()走,30 轮里一直记着;下次你输入新指令、再次run()时才清零重记。千万别写进循环里,不然每跑一步账就归零。batch.stop时直接return,别调finish_execution()。拿具体场景走一遍:假设计划三步,模型已经改完了第一步(demo.txt改好了),正在跑第二步的测试时因为连败触发熔断。若这时误调finish_execution(),它会做两件事------把status从executing改回idle、把_approved_plan清空。下一轮你输入"继续",_build_system_prompt()一看approved_plan是None,就只拼CORE_SYSTEM_PROMPT,不再带上批准计划和EXECUTION_PROMPT------模型当场"失忆",不知道自己刚才在执行哪个计划、还剩哪两步。所以正确做法是只return不调它:approved_plan原样留着,下一轮提示词照常带计划,模型从断点接着干。另外暂停不回滚------第一步改好的demo.txt会留在磁盘上,继续前先read_file瞄一眼现状,别按旧印象接着改。
七、踩坑:这几个坑,掉进去的人最多
7.1 显式 kind 优先,文案兜底------改文案要两边一起改
edit_file 的报错文案"没有找到 old_text"和分类函数里的匹配条件,是互相咬合 的。哪天你把文案改成"匹配失败:不存在这段旧文本",分类就对不上,只会落到 unknown。改一处,另一处跟着改。
7.2 成功只销自己的账,累计只增不减
同一道菜做成功了,只清它自己的连败记录;total_failures 这个总账只增不减,任何成功都不抵扣。这是刻意的------累计失败代表"这次运行整体有多不顺利",不该因为一次成功就抹掉。
7.3 熔断后要补占位消息,凑齐配对
见 6.2,不补占位消息,下一轮发请求会因为 tool_call_id 配对不齐直接报错。
7.4 停火不等于干完,也不会自动撤销
见 6.3,停火时别调 finish_execution(否则清空批准计划),已经改掉的文件也不会自动回滚。
7.5 别把 shell 日志里的 "permission denied" 当成越权
bash 已经把错误包成 ToolExecutionError("command_failed", ...),classify_failure 第一关就返回 command_failed,不会再去扫日志里的 "permission denied"。permission 这一档,主要拦的是 Agent 越界改文件、违反 Plan Mode 工具限制这类 Harness 规则,不是通用 shell 权限检测器。
八、这期到底干成了啥?
这期没给模型换更聪明的脑子,也没加新工具,就补了两件事:
text
报错分类 + 恢复提示   让它知道"错在哪、下一步怎么改",会拐弯
双账本 + 熔断         让它别死磕,连败到上限就停火,把控制权还你
以前,报错只是一句冷冰冰的话甩回模型,它要么瞎猜、要么死循环;现在,前台会告诉它"哪类错 + 怎么补救",还会记着它失败了几次,到点就停火。
最关键的分界是这一句:**报错是信息,不是终点。**把错误分类、给建议、记账、踩刹车,这几样一补齐,Agent 才从"会调工具"真正走向"会自己收拾烂摊子"。
九、下集预告
到这,咱们的 Agent 已经会读、会写、会规划、会自救、会熔断了,全是用 for 循环手搓出来的。
下一篇是大结局------把这套手搓的 Agent Loop,用 LangGraph 的 StateGraph 重写一遍:for 循环变成"节点 + 条件边",能力一模一样,但表达方式从"手写循环"换成了"画流程图"。同一个 Agent,两种写法,对照着看最清楚。