【上期回顾】
上一篇讲了动态规划:策略评估、策略改进轮流做,就能算出最优策略。可它每一步都要用环境模型,也就是转移概率 p 和奖励 r。在第 3 篇的算法地图上,它属于左半边:基于环境模型(model-based)。
现实里,模型往往是不知道的:上一篇代码里的 model 函数,智能体其实看不到,只能做个动作、看看结果。
所以从这一篇开始,系列转到地图的右半边:不基于环境模型 (model-free)的方法。第 3 篇说过,这是本系列的重头戏,后面会一个个讲。打头的是右半边"基于价值"里的蒙特卡洛方法:不用模型,只靠一个个真的走出来的回合来学。
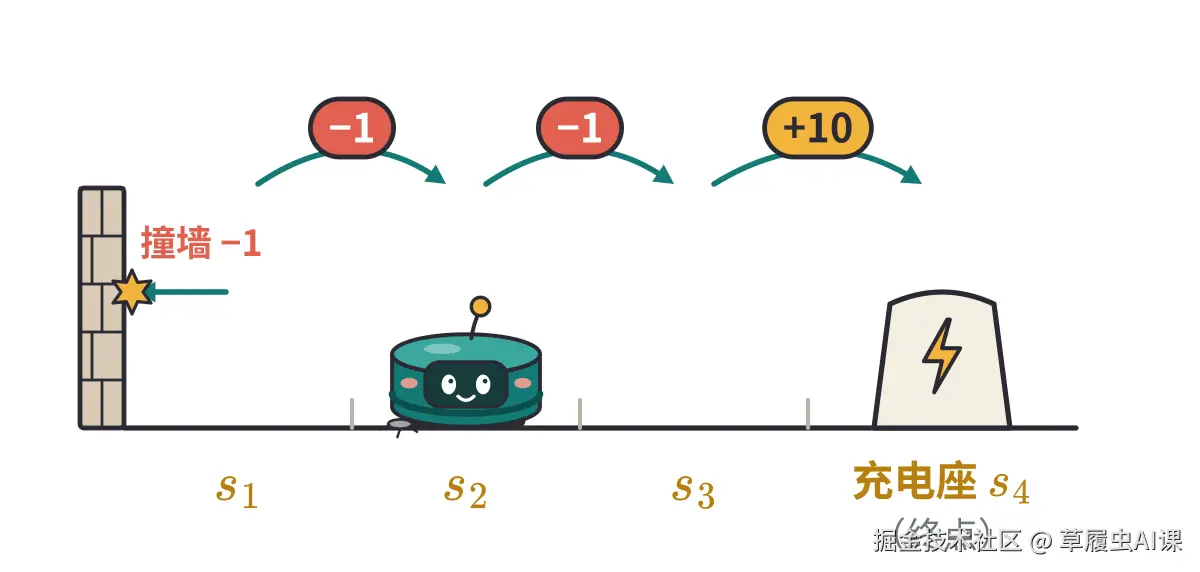
▲ 图 1 本篇例子:走廊里的扫地机器人(规则同前几篇)
【设定】走廊的规则(小扫不知道)
- 状态 :三个格子 s1,s2,s3,加上充电座 s4。进了充电座,这一回合就结束。
- 动作 :往左 ←、往右 →,结果是确定的;在 s1 按 ← 会撞墙,原地不动。
- 奖励:每走一步 −1,撞墙那一步也一样;走进充电座的那一步 +10。
- 折扣因子 : γ=0.9。
- 策略 B:每个状态都随便走,往左、往右各一半。
这些规则是写给读者看的。小扫并不知道,它只能在某个状态做一个动作,再看到自己到了哪、得了几分。
【说法对照】漫画说大白话,正文用正式说法
- 漫画里的说明书 = 环境模型 ( p 和 r);账本 = 价值 V、 Q;手册 = 策略 π;
- 漫画里"跑一趟" = 一个回合:从出发一直走到进充电座。
正文、例题和插图都用正式说法,漫画里还是老样子。
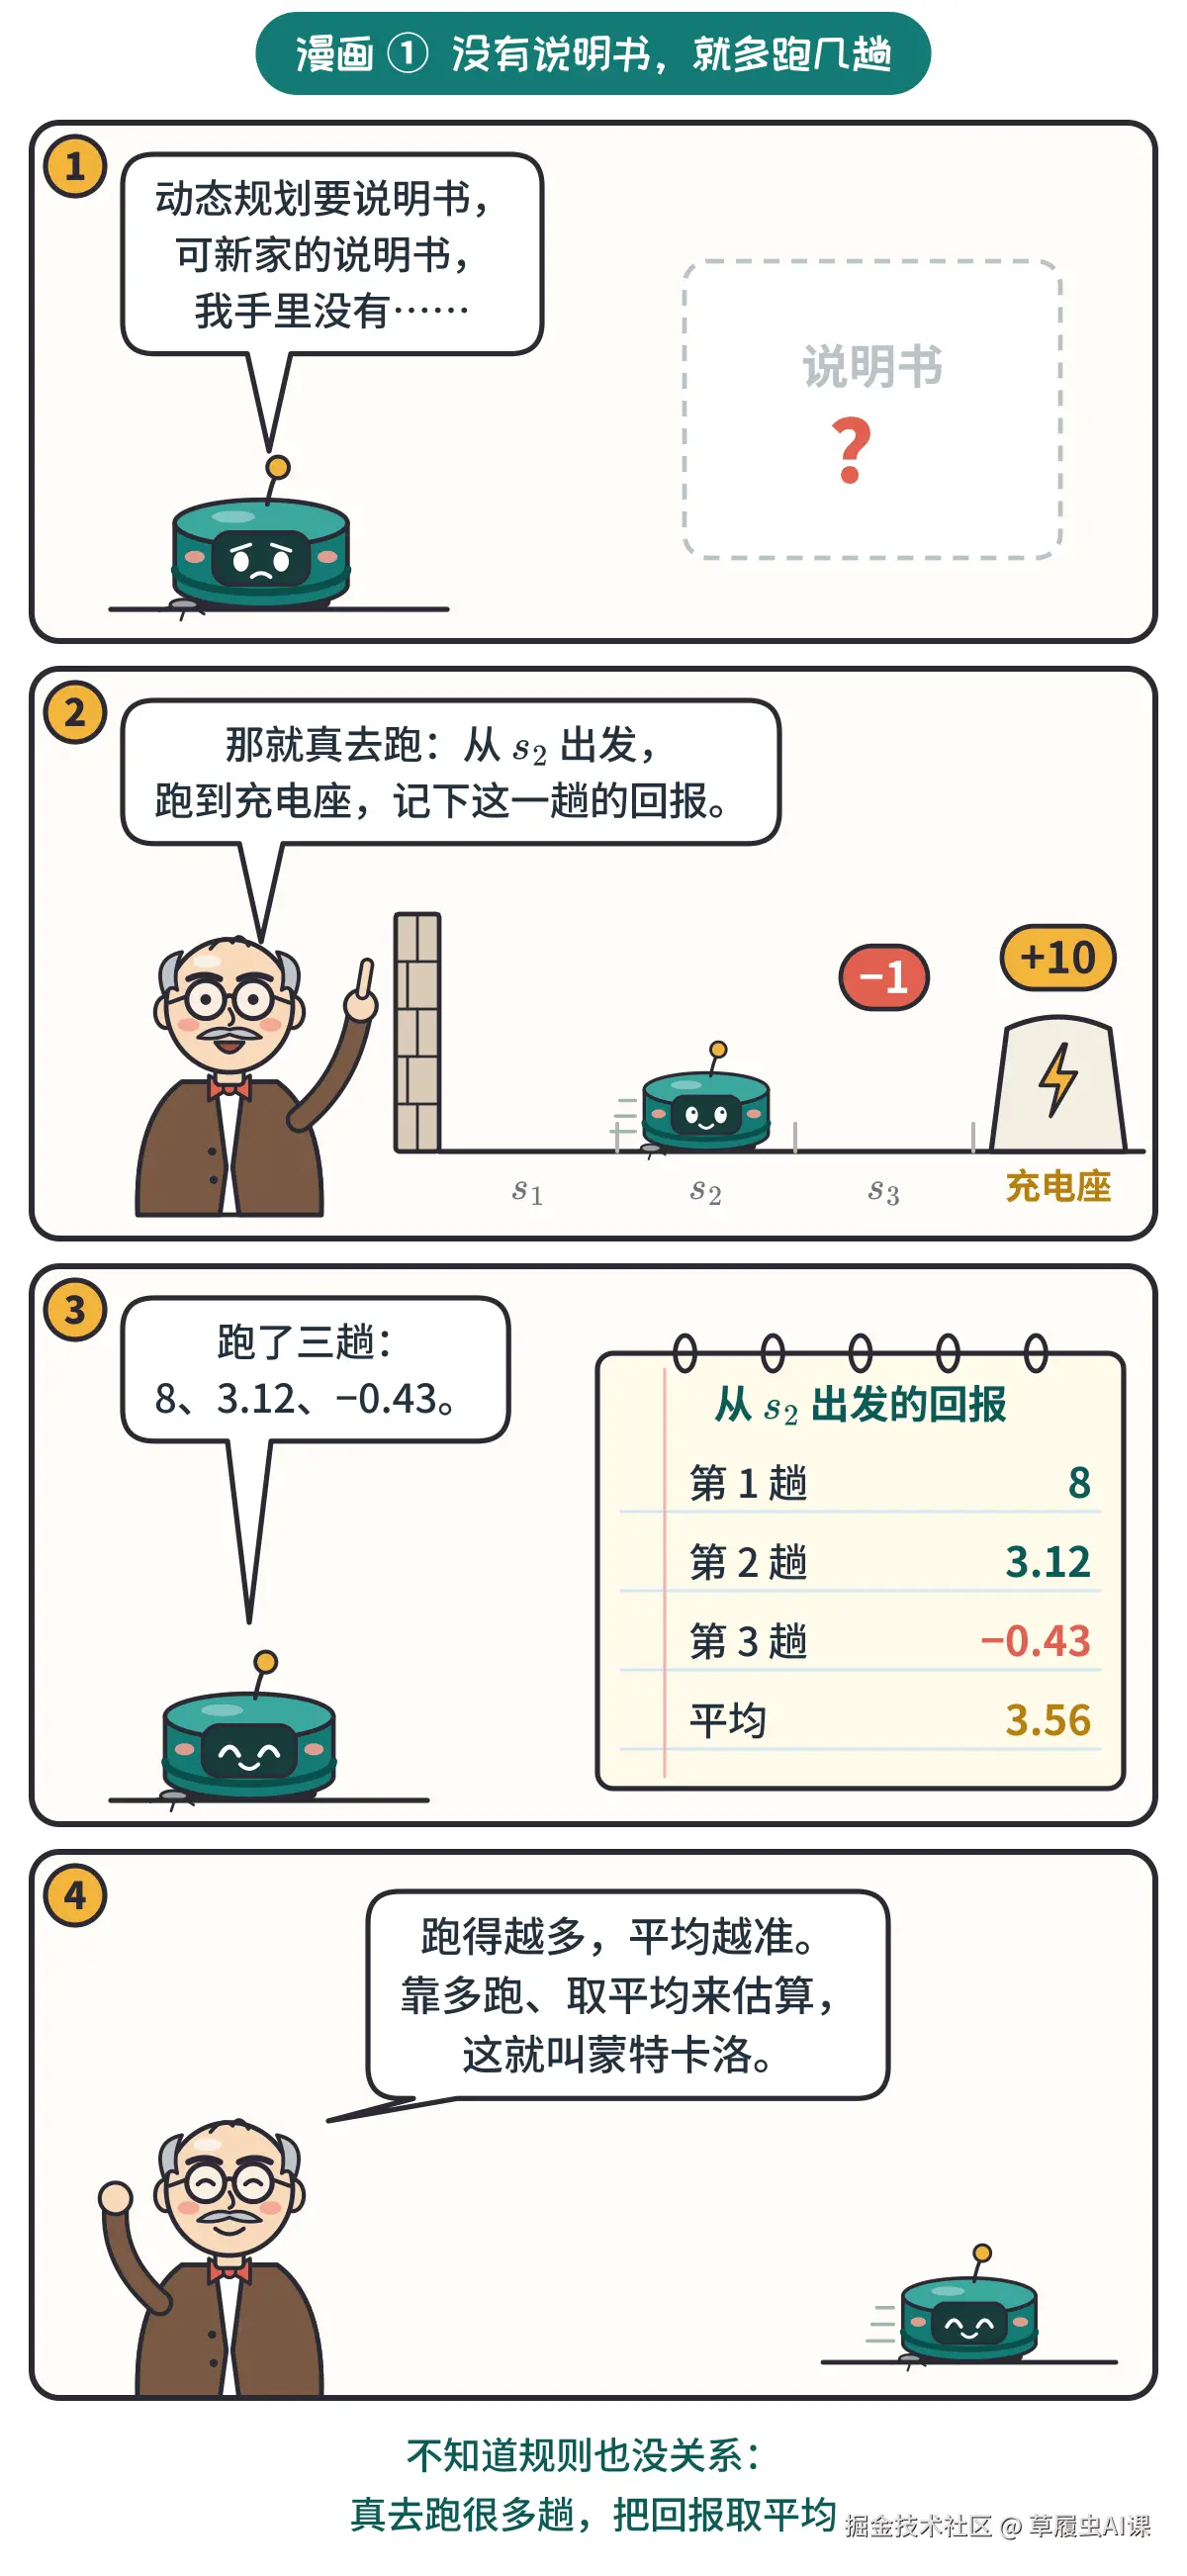
▲ 图 2 漫画 ① 没有说明书,就多跑几趟
一、蒙特卡洛:用抽样来估算
蒙特卡洛方法(Monte Carlo method)的思路很朴素:一个数不好直接算,就反复做随机试验,用试验结果的平均(或比例)去估它。试得越多,估得越准。先看一个和强化学习无关的小例子。
【例 1】撒点估算 π
在边长为 2 的正方形里随便撒点。正方形面积是 4,里面那个半径为 1 的圆,面积是 π。点落在圆里的概率,就是两个面积之比 π/4,所以
π≈4×Nm
N 是撒的总点数, m 是落在圆里的点数。下图撒了 600 个点,青色的落在圆里,红色的在圆外:
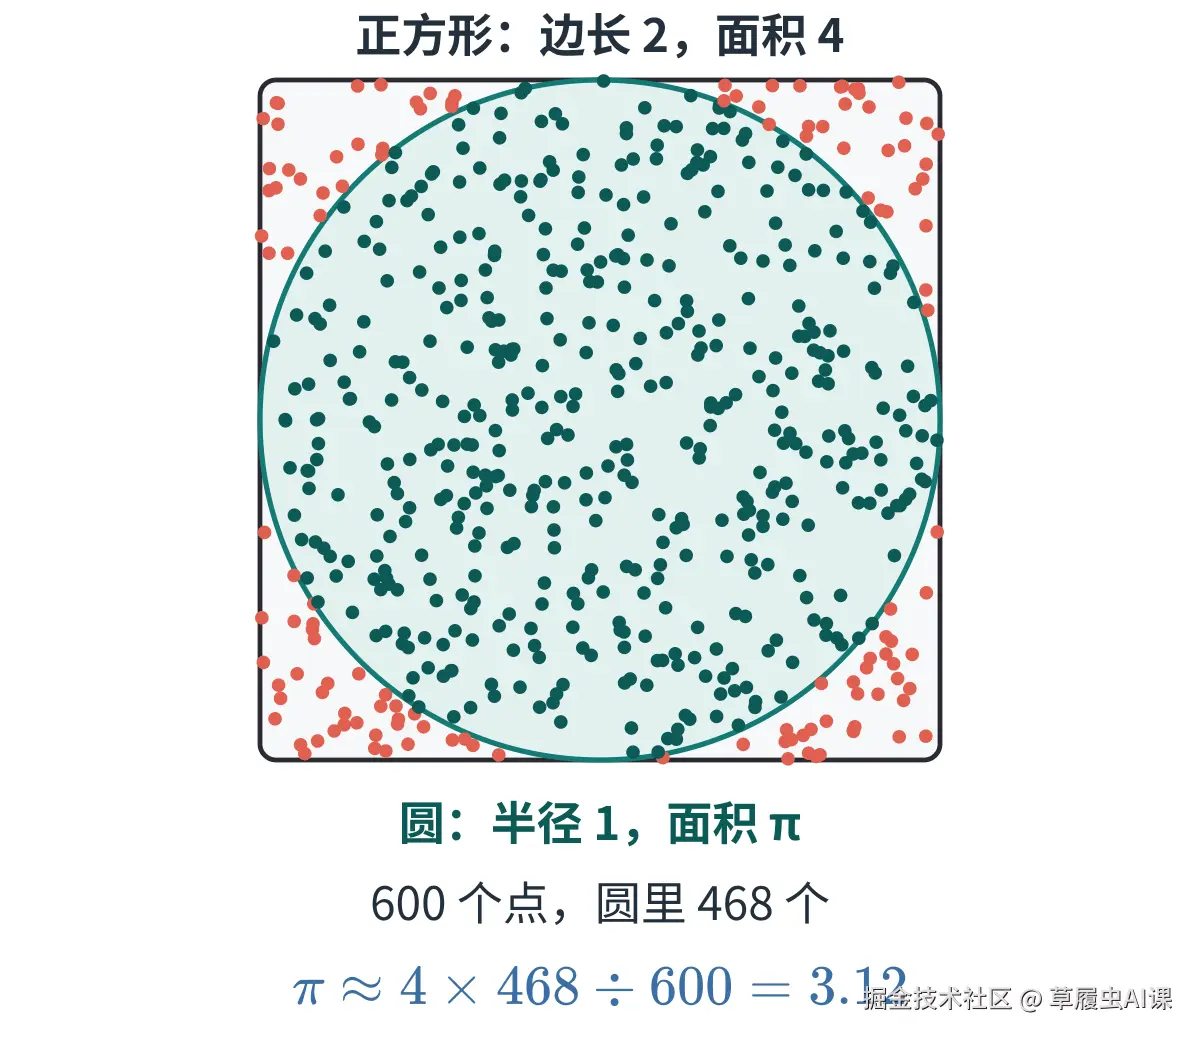
▲ 图 3 例 1 图解:在正方形里随便撒点,数一数圆里有几个
圆里有 468 个, 4×468÷600=3.12,离 3.1416 已经不远。换不同的点数各撒一次:
| 总点数 | 圆里 | π 的估计 |
|---|---|---|
| 10 | 9 | 3.6 |
| 100 | 83 | 3.32 |
| 1000 | 784 | 3.136 |
| 10000 | 7853 | 3.1412 |
| 100000 | 78795 | 3.1518 |
点越多,估计一般越接近 3.1416;但不是每多撒一次就一定更准(10 万个点这次反而偏了一点)。平均来说,误差大约和 1/N 成正比:点数翻 100 倍,误差才缩小到 1/10。这就是蒙特卡洛的脾气:简单、通用,但要大量样本。
【档案】
1946 Stanislaw Ulam(乌拉姆)等
美国 · 洛斯阿拉莫斯实验室
研究中子扩散时,常规的确定性算法算不动,乌拉姆提议用大量随机试验来估算。同事 Nicholas Metropolis(梅特罗波利斯)借摩纳哥的蒙特卡洛赌场给它起了名字(乌拉姆的叔叔常去那里赌)。1949 年两人发表论文《蒙特卡洛方法》。
二、用回合估价值
搬到强化学习里:第 2 篇说过,状态价值 Vπ(s) 就是从 s 出发、照策略 π 走的平均回报 。期望不会算,那就照 π 真的跑很多个回合,把从 s 出发拿到的回报取平均:
V(s)≈nG1+G2+⋯+Gn
Gi 是第 i 次从 s 出发拿到的回报, n 是一共统计了几次。第 2 篇例 2 让小扫跑 1 万个回合估策略 B 的价值,用的就是这个办法。具体做法:
- 照策略 π 跑一个完整的回合,记下每一步的状态、动作、奖励;
- 从最后一步往前,算出每一步的回报:回报 = 这一步的奖励 + 0.9 × 下一步的回报;
- 回合里出现的每个状态,都把它的回报记下来;
- 跑很多回合,每个状态把记下的回报取平均,就是它的价值估计。
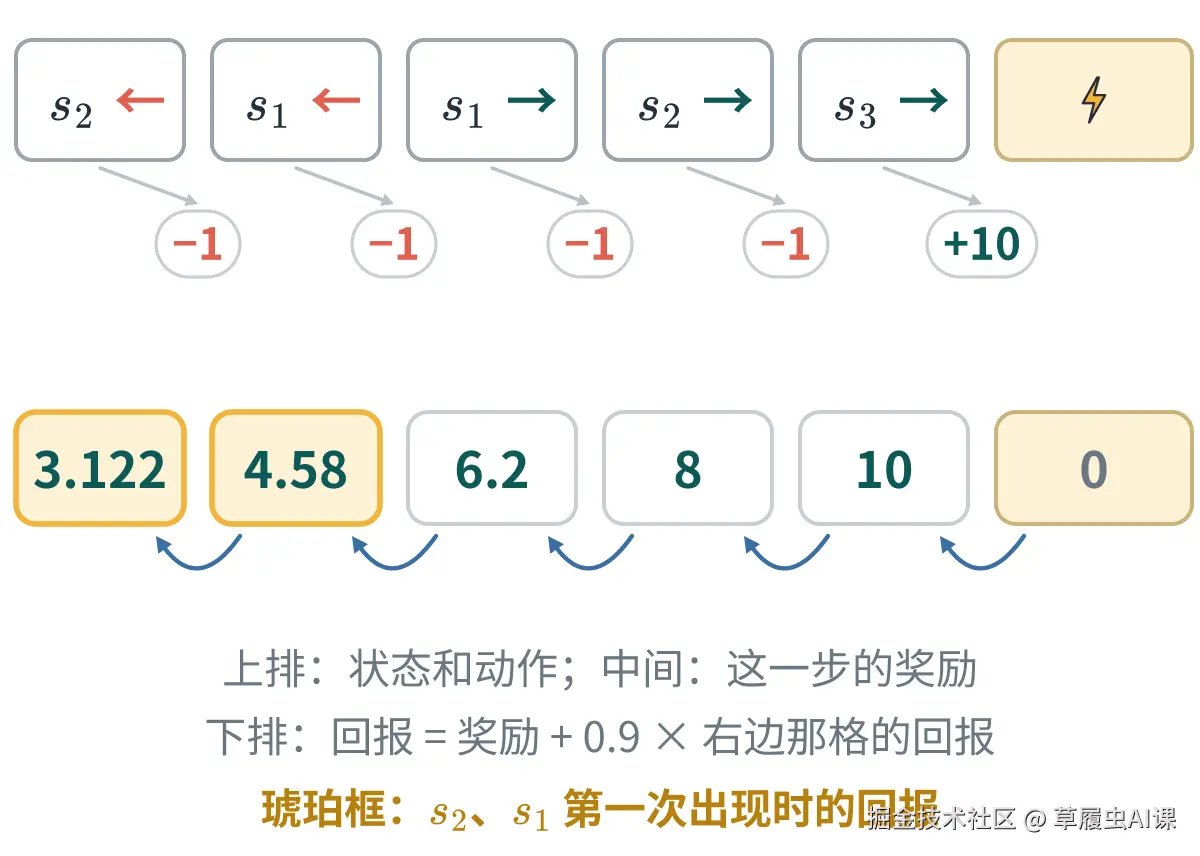
▲ 图 4 一个回合里,每一步的回报都从终点往前算(第 1 篇的回合 B)
蒙特卡洛有个前提:回合必须能结束。回报要等走到终点才算得出来,回合不结束,一个回报也拿不到。
【要点】首次访问和每次访问
一个回合里,同一个状态可能出现好几次(上图的 s1、 s2 都出现了两次)。只记第一次 出现时的回报,叫首次访问 (first-visit);每次出现都记,叫每次访问 (every-visit)。两种做法在回合足够多时都会得到真实的价值。本篇都用首次访问:上图里 s2 记 3.122, s1 记 4.58。
实际编程时,不用把所有回报都存下来再平均。每来一个新回报 G,把旧的平均往 G 那边挪一点就行,这叫增量更新:
V(s)←V(s)+n1(G−V(s))
n 是这是第几个回报,箭头 ← 表示用右边算出的数替换左边的旧值。
【例 2】增量更新和直接求平均是一回事
第 1 篇从 s2 出发跑了三个回合,回报分别是 8、3.122、−0.434。从 V(s2)=0 开始,每来一个回报更新一次。下图每一行是一个回合:空心圆是旧估计,方块是新回报,琥珀圆是更新后的新估计。
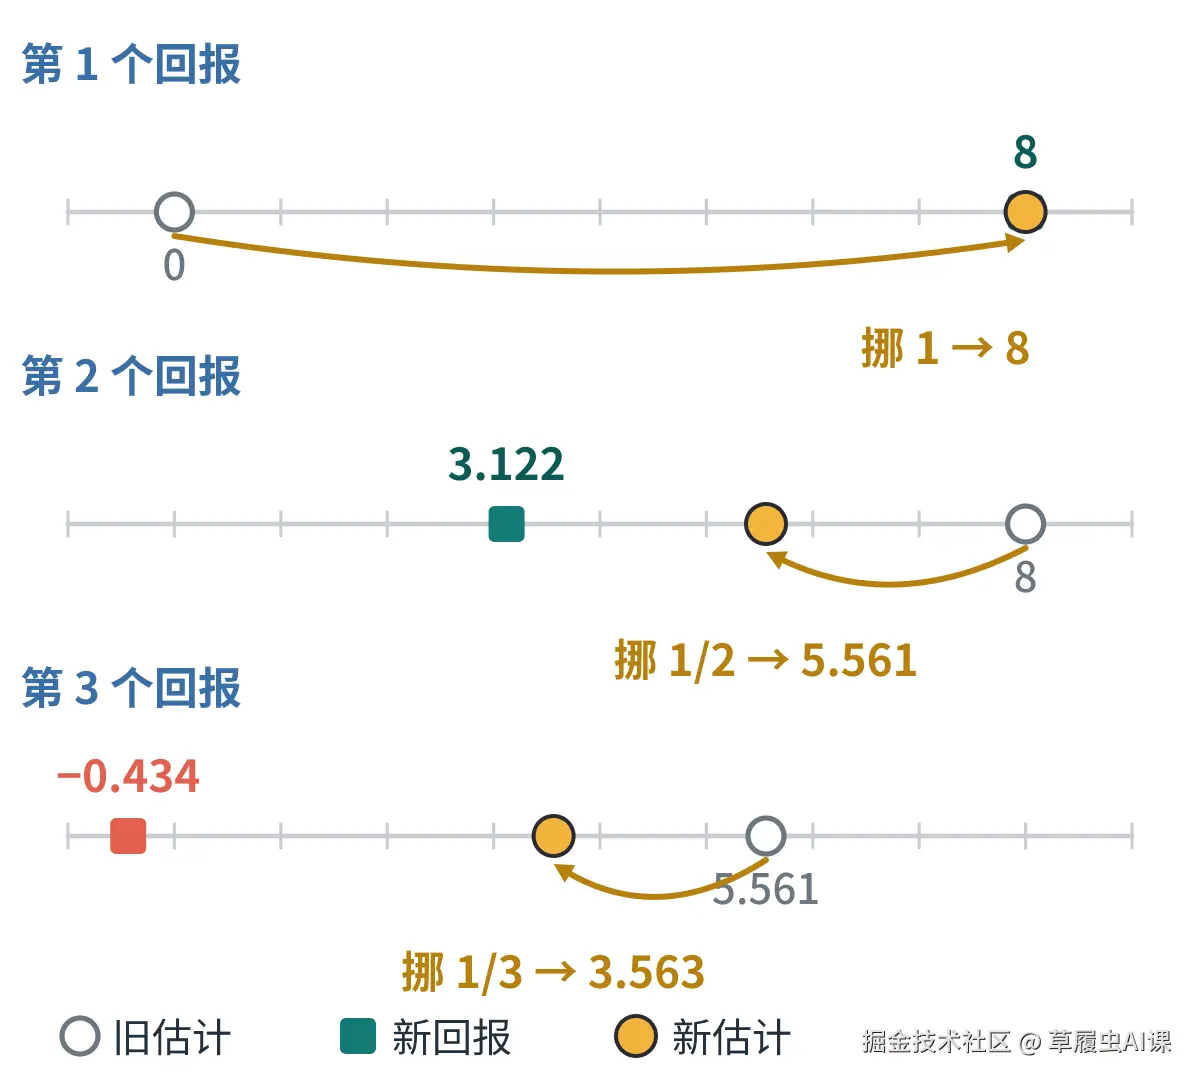
▲ 图 5 例 2 图解:每来一个回报,旧估计往它那边挪 1/n 的距离
- 第 1 个回报 8 : 0+1×(8−0)=8,步长 1,挪满全程。
- 第 2 个回报 3.122 : 8+21×(3.122−8)=5.561,步长 1/2,挪一半。
- 第 3 个回报 −0.434 : 5.561+31×(−0.434−5.561)=3.563,步长 1/3,挪三分之一。
和直接平均 (8+3.122−0.434)÷3=3.563 完全一样。
每次挪的比例 1、1/2、1/3,也就是公式里的 1/n,叫步长 :步长越大,新回报的话越算数。所以增量更新可以写成"新估计 = 旧估计 + 步长 ×(目标 − 旧估计)",这里的步长是 1/n,目标就是新回报 G。这个样子,后面的时序差分、Q-learning 里还会反复出现,只是步长常换成一个固定的小数。
三、只有 V,挑不了动作
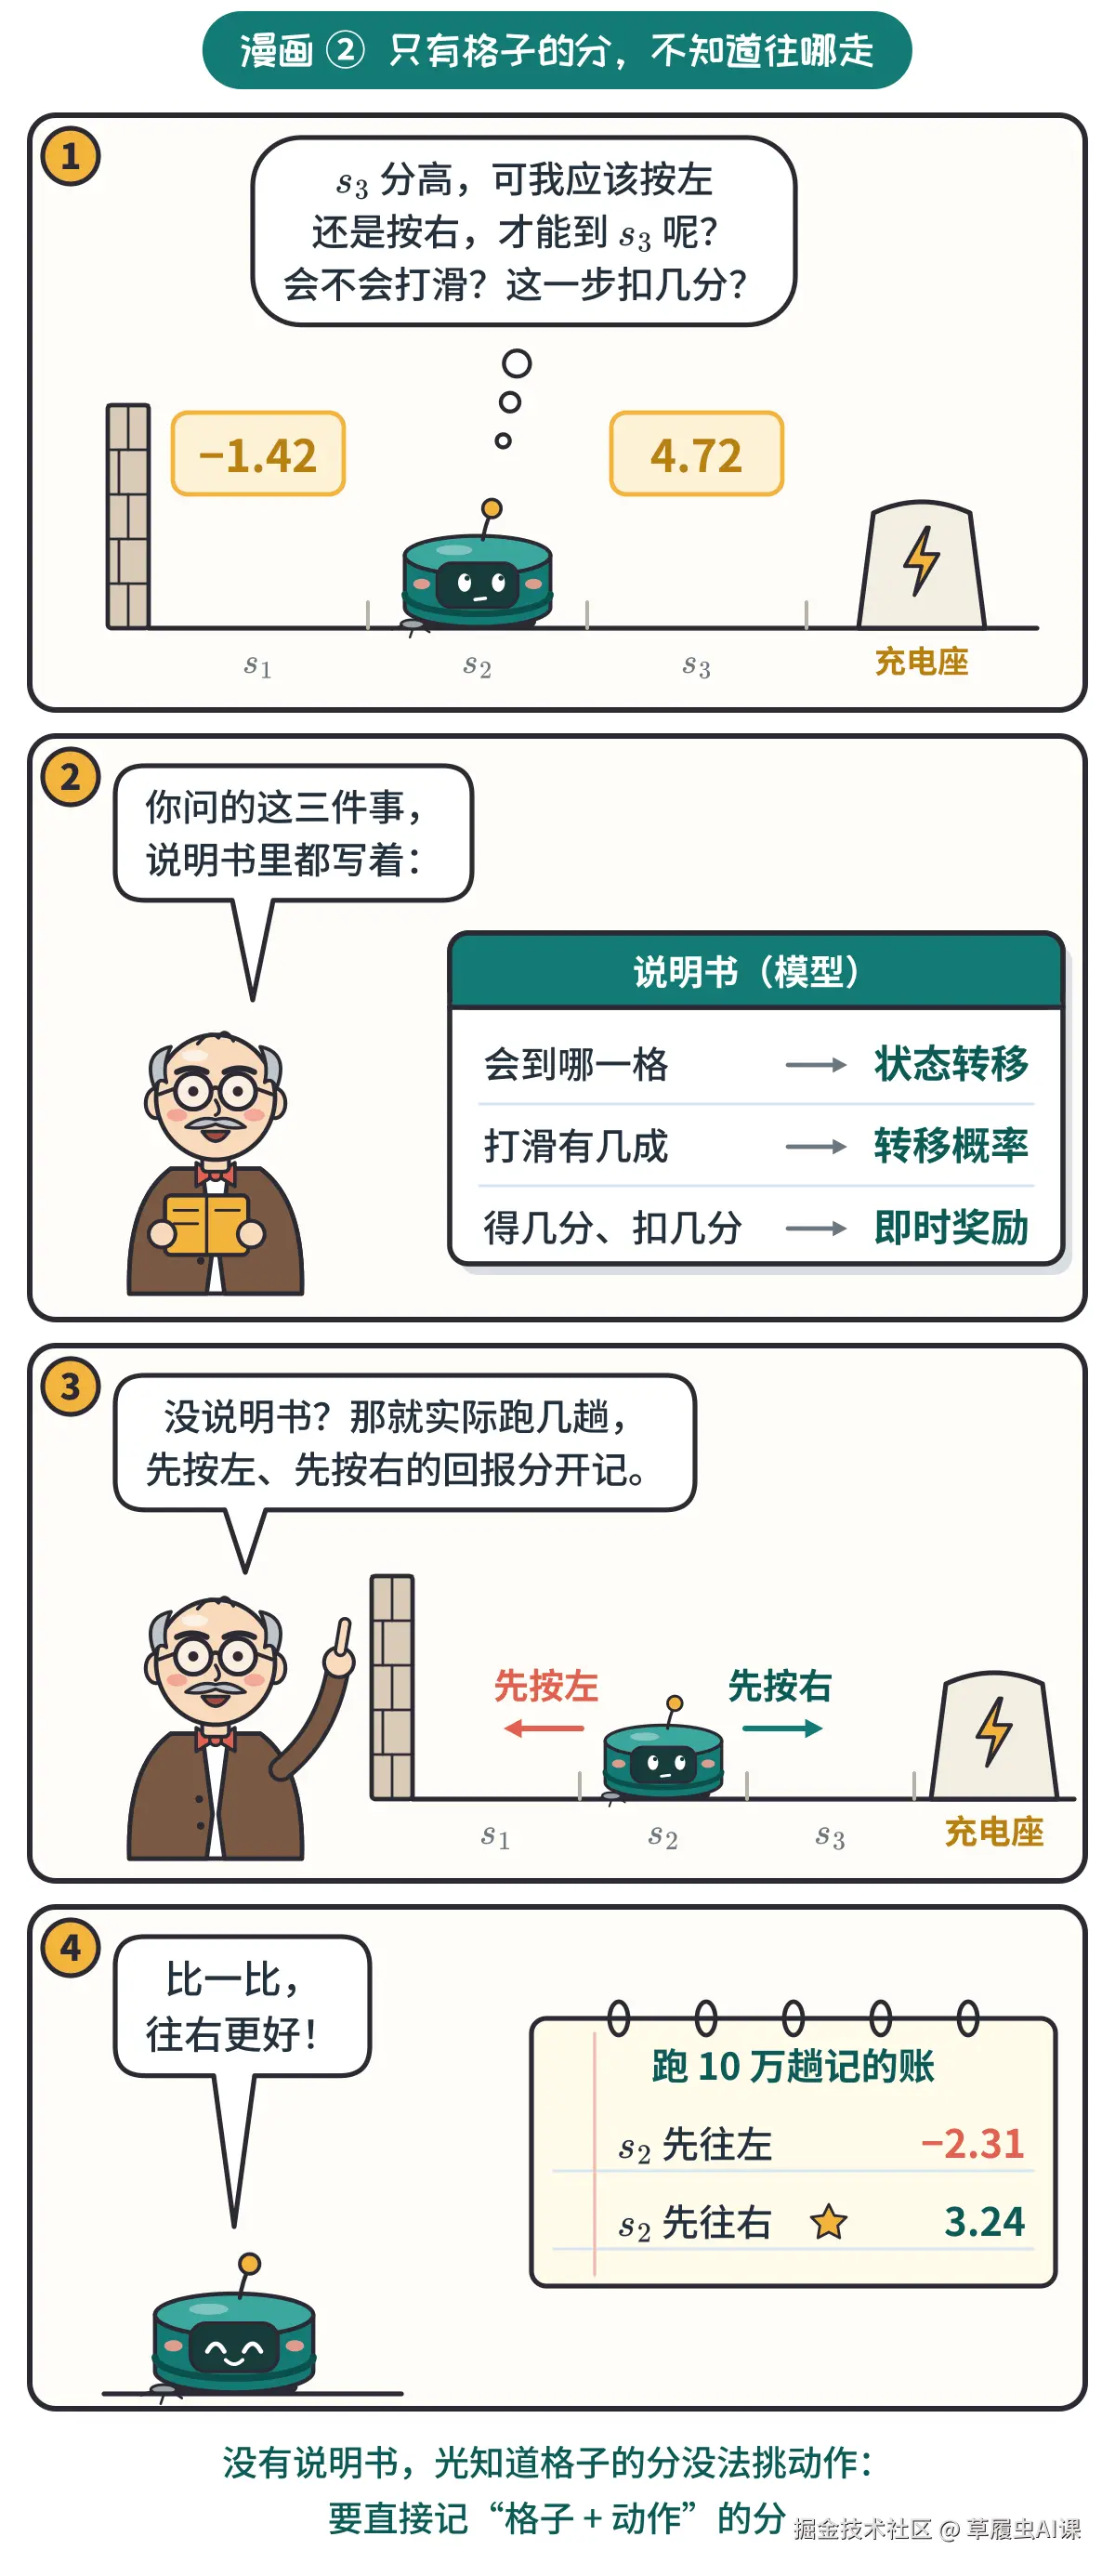
▲ 图 6 漫画 ② 只有格子的分,不知道往哪走
第二节估出了每个状态的价值 V。可要改进策略,得在每个状态挑一个动作。第 4 篇的策略改进是这样挑的:先用环境模型把每个动作的 Q 算出来,再挑最大的。
Q(s,a)=s′∑p(s′∣s,a)r+γV(s′)
对每个可能到达的状态,把即时奖励和折扣后的下一状态价值加起来,再按转移概率取加权平均。式子里的 p 和 r,就是漫画里老评说的说明书:按一下会到哪一格(状态转移)、各有几成可能(转移概率)、得几分(即时奖励)。只有 V 没有模型,这个式子就算不出来。
【例 3】在 s2 该往哪走
假设已经估出策略 B 的价值: V(s1)=−1.42, V(s3)=4.72。现在想在 s2 比一比往左、往右:
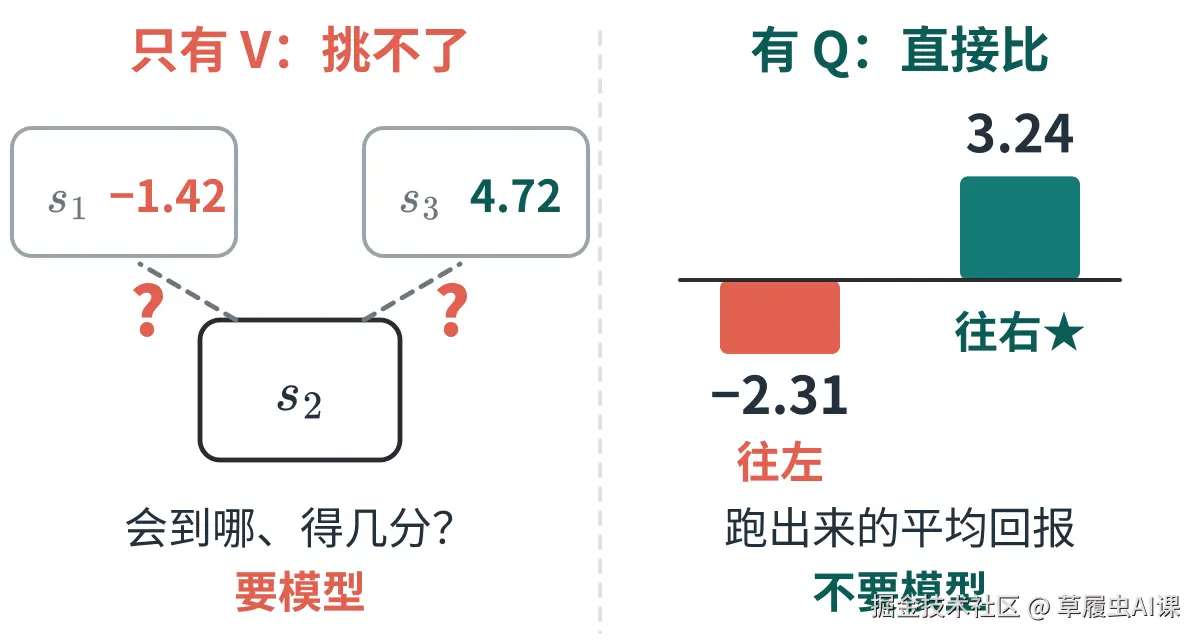
▲ 图 7 例 3 图解:只有 V 要模型;有 Q 不要模型
- 只有 V :读者知道走廊的规则,可以算出往右 −1+0.9×4.72≈3.25、往左 −1+0.9×(−1.42)≈−2.28,往右更好。可"往右会到 s3、这一步得 −1"正是模型里的东西,小扫不知道。要是地板打滑(第 4 篇的滑地板),按"→"还可能留在原地,只看下一格的分就更算不准了。
- 有 Q :手里直接有 Q(s2,→) 和 Q(s2,←),比大小就行,不用知道按下去会发生什么。下一节会看到,跑 10 万个回合估出来的是 3.24 和 −2.31,往右更大。
挑动作的规则写成式子,就是每个状态选 Q 最大的动作:
π′(s)=argamaxQ(s,a)
没有模型、只有 V,要拿到 Q 有两条路:
- 补上模型,从 V 推出 Q。 先从回合里把模型数出来:比如在 s2 按右 100 次,80 次到了 s3、20 次留在原地,就把转移概率估成 80% 和 20%。再把估出的模型和 V 一起代进上面的式子,算出 Q。第 3 篇说过,这条路仍属于基于模型的方法。
- 不从 V 推,直接估 Q。 既然缺的是模型,干脆不走" V + 模型"这一步,直接从回合里估每个动作的 Q。本篇的蒙特卡洛方法走这条路,下一节细讲。
四、用回合估 Q
Q(s,a) 是在 s 先做动作 a、之后照策略走的平均回报。所以估 Q 和第二节估 V 的做法一样,只是把回报按第一步的动作分组 :记账的单位从"状态"换成了"状态 + 动作"。比如在 s2,把从这里开始的回报分成"先按左"和"先按右"两组,各自取平均。
打滑、扣分、后来走到了哪,都已经算进回报里了,所以不用单独估转移概率,也不用拿模型反复扫表。具体做法:
- 照当前策略跑很多完整的回合;
- 回合里每一个 (s,a),算出从这一步开始的回报;同一个 (s,a) 在一个回合里出现多次,只记第一次;
- 每个 (s,a) 把记下的回报取平均(或用增量更新),就是 Q(s,a) 的估计。
【例 4】三个回合,手算 Q 表
小扫从 s2 出发,跑了下面三个回合。每一格是这一步的"状态 + 动作",格子下面是从这一步算起的回报,都是从回合末尾往前算出来的(算法同第二节的图)。
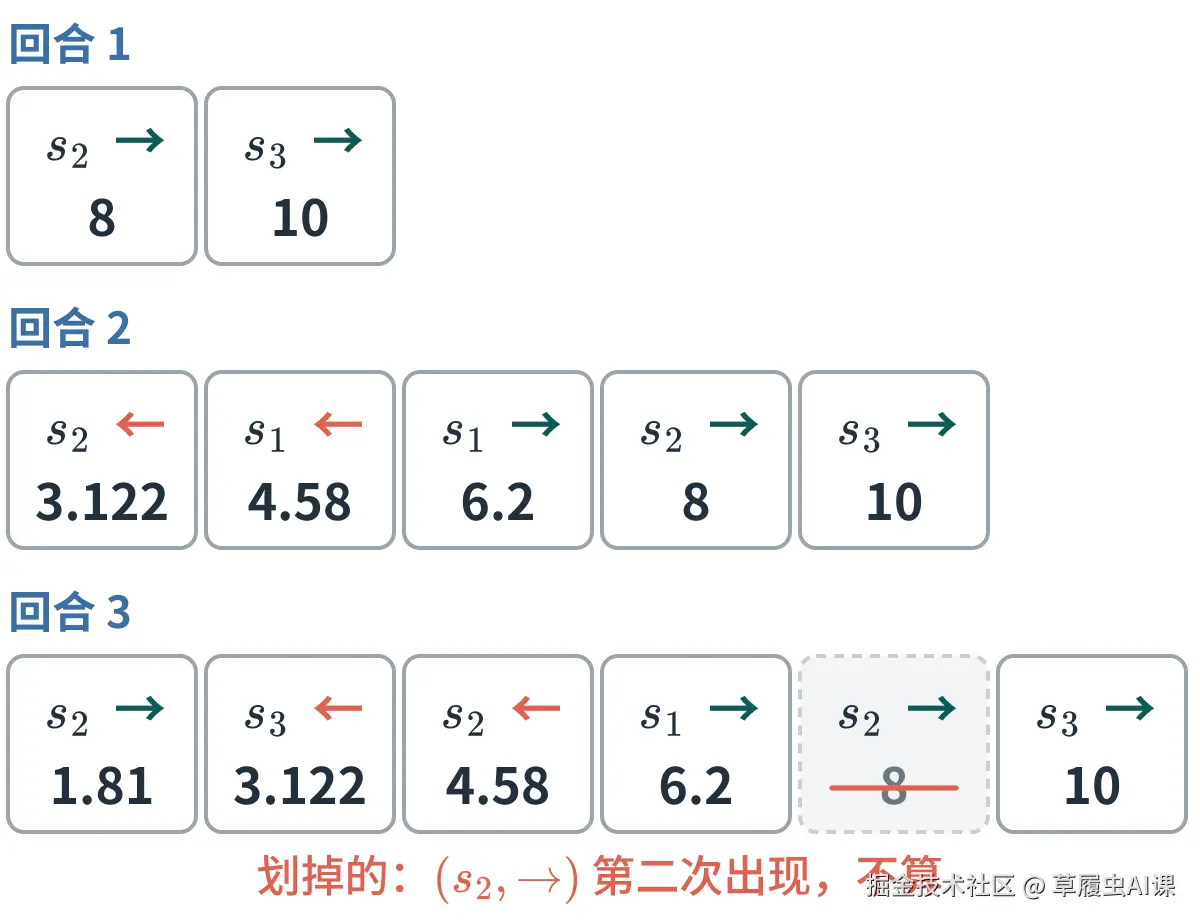
▲ 图 8 例 4 图解(一):三个回合,每一步的回报
比如回合 3:最后一步进充电座 10;往前一步 −1+0.9×10=8;再往前 −1+0.9×8=6.2......一直到第一步 1.81。回合 3 里 (s2,→) 出现了两次,按首次访问只记第一次的 1.81,后面那个 8 不算。
再把每个 (s,a) 的回报收集起来取平均:
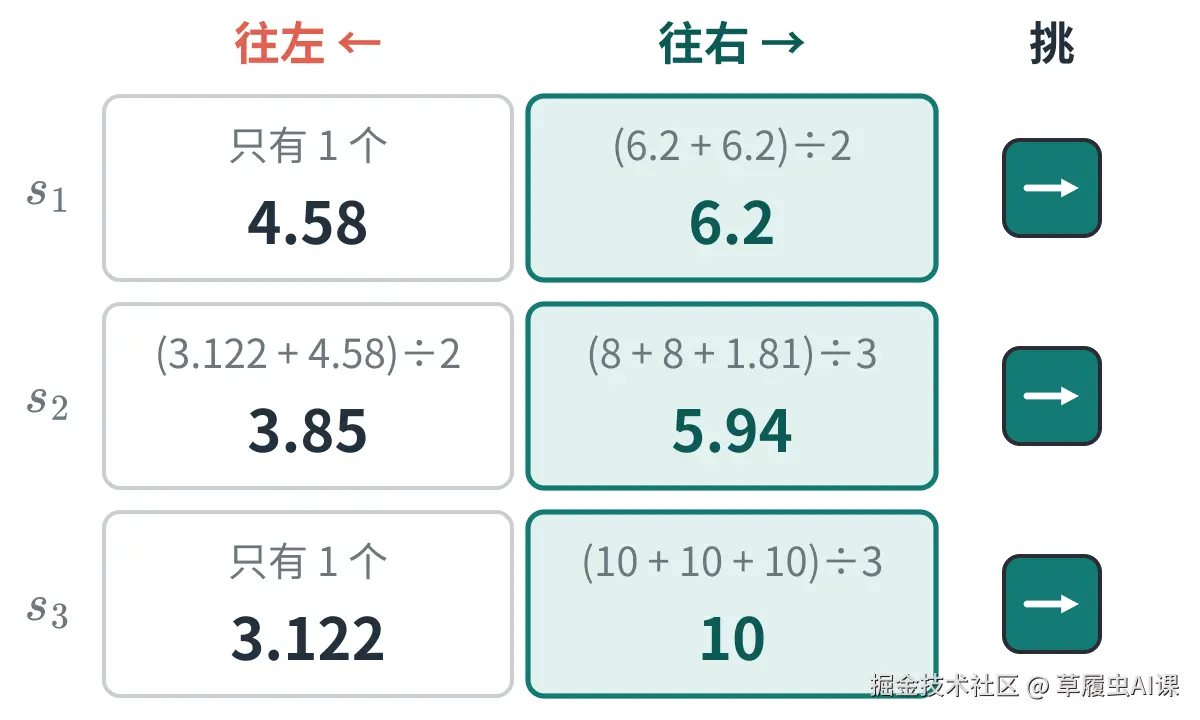
▲ 图 9 例 4 图解(二):每格把用到的回报取平均,最右是每个状态挑出的动作
比如 (s2,→) 用到了三个回报:回合 1 的 8、回合 2 的 8、回合 3 的 1.81,平均 5.94。三个回合样本太少,这些数离真值还差得远,只是演示怎么算。
回合跑多了会怎样?照策略 B、每个回合都从 s2 出发,只看 s2 的两个动作。两个动作都得试到,试得少的那一组,估出来的分数就容易波动;跑的回合越多,估计越稳:
| 回合数 | Q(s2,→) | Q(s2,←) |
|---|---|---|
| 10 | 1.26 | −4.29 |
| 100 | 2.73 | −1.76 |
| 1000 | 3.33 | −2.40 |
| 10000 | 3.22 | −2.43 |
| 100000 | 3.24 | −2.31 |
| 真值 | 3.245 | −2.282 |
真值是第 4 篇用模型算出的。跑到 10 万个回合,估计已经很接近,往右明显更大。模型的信息其实已经"藏"在这些回报里了,只是不用单独拆出来。
五、蒙特卡洛控制
有了不用模型估 Q 的办法,就能照搬第 4 篇的策略迭代:评估一次、改进一次,轮流做下去。用蒙特卡洛方法找最优策略,叫蒙特卡洛控制(Monte Carlo control):
- 评估 :按当前策略 π 跑一批回合,用回报的平均更新 Q;
- 改进 :每个状态挑 Q 大的动作,得到新策略。
【要点】先准备一张初始的 Q 表
蒙特卡洛控制开始之前,要先给每个 (s,a) 填一个初始的 Q 值,本篇都填 0。一开始的策略就按这张表挑动作,几个动作一样大时随便挑一个。
用增量更新时,某一格第一次拿到真实回报,步长是 1,初始值会被整个换掉(见例 2 的第一步)。所以初始值只留在还没试过 的格子里:一个动作要是从来没被试过,它的 Q 就一直是初始值,贪心挑动作时照样拿它来比。第六节的探索问题就出在这里。
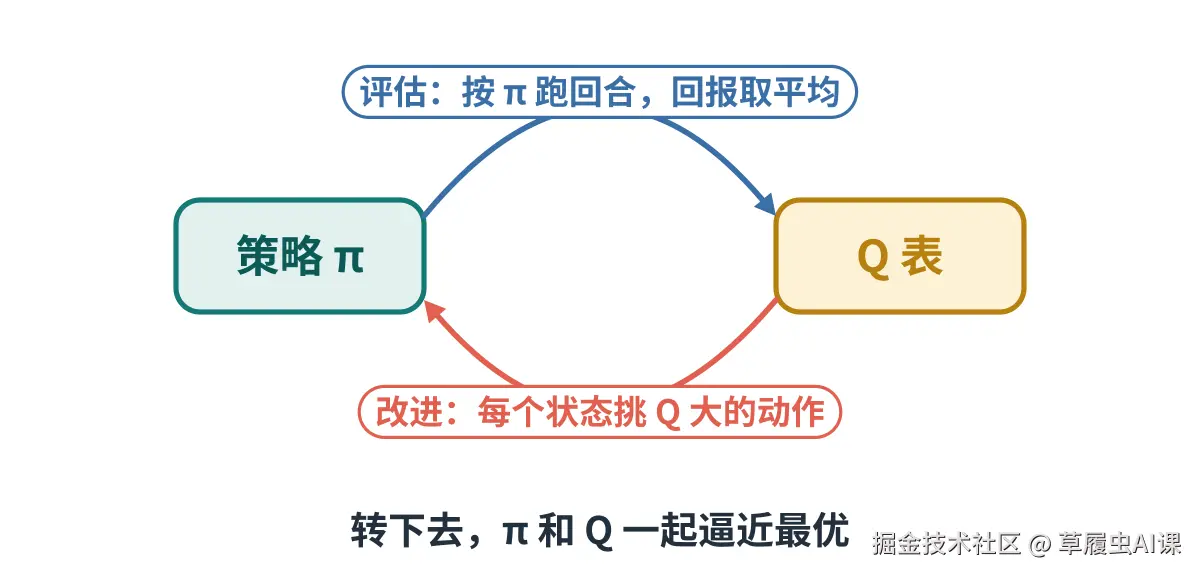
▲ 图 10 评估和改进轮流做,策略和 Q 一起逼近最优
这里的"一轮"是:跑一批回合、更新 Q,再改进一次。和第 4 篇不同, Q 不是用模型精确算出来的,而是拿有限个真实回报取的平均,回合少的时候会偏离真值,所以每次改进只是"很可能变好"。
也不必每轮都把 Q 估到很准:按第 4 篇第六节的广义策略迭代,每跑完一个回合就改进一次 也行。本篇后面的例子和代码都这样做:每跑完一个回合,就用它更新 Q;下一个回合直接按新的 Q 挑动作。
【例 5】用例 4 的 Q 表改进一次
看例 4 图解(二)最右一列: s1 是 6.2 > 4.58, s2 是 5.94 > 3.85, s3 是 10 > 3.122,三个状态都是往右大。改进一次,就得到"一路向右"。
不过这里有运气:三个回合碰巧把每个动作都至少试了一次。要是某个动作从来没试过,它的 Q 就一直是初始值,会怎样?这就是下一节的探索问题。
六、探索问题:探索性启动
▲ 图 11 漫画 ③ 只挑分高的,会学错
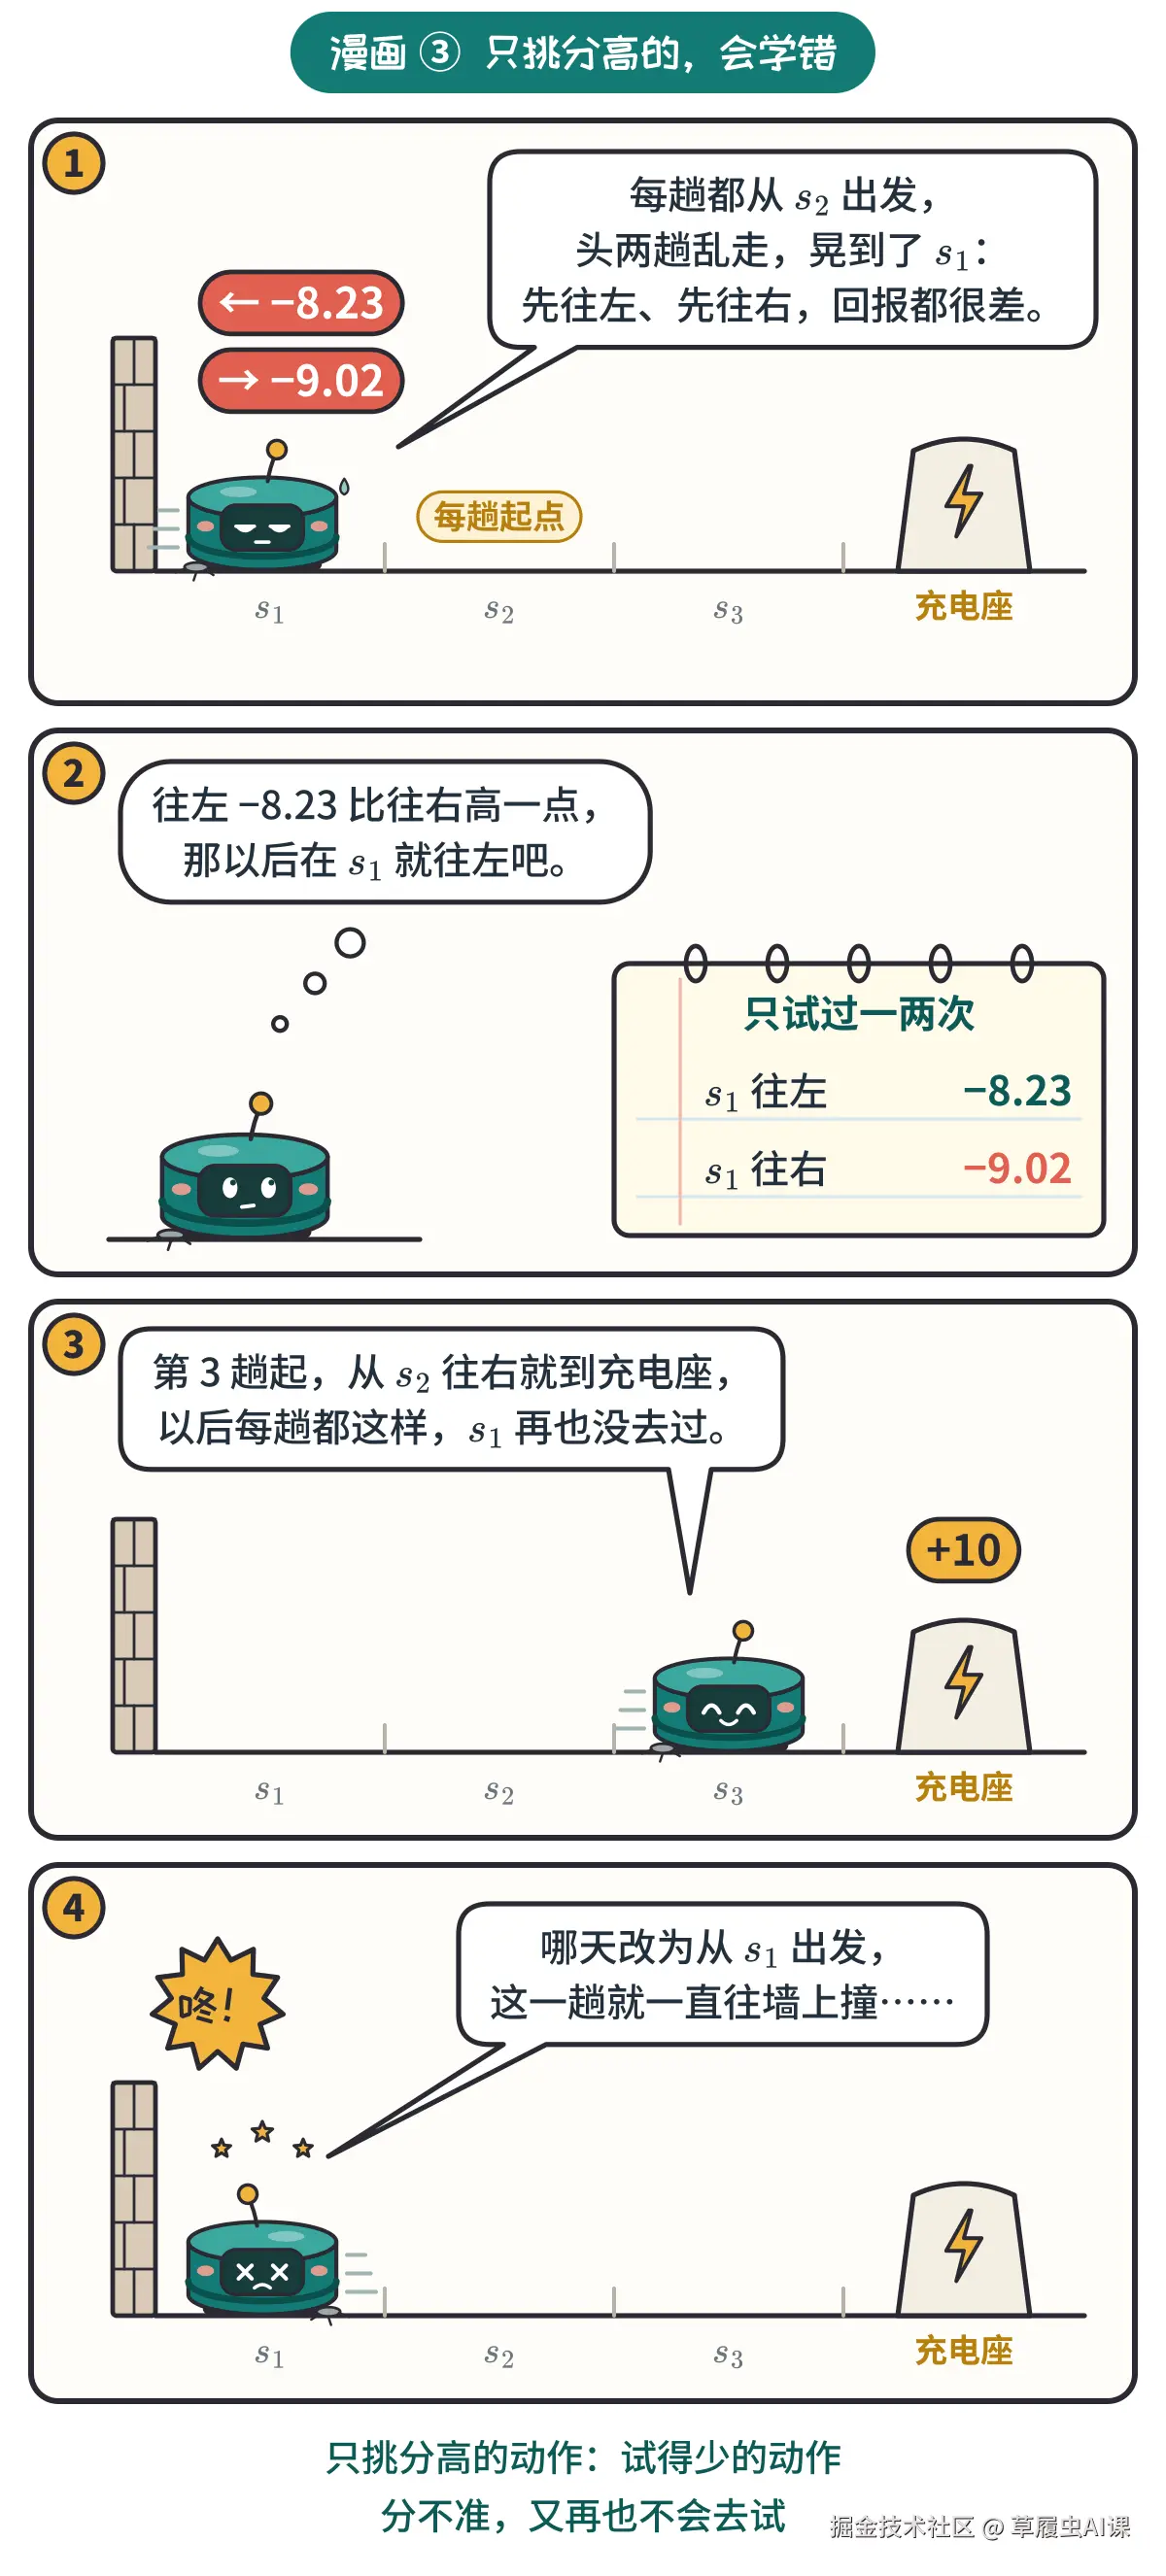
改进时总挑 Q 最大的动作,叫贪心 。只贪心有个毛病:试得少的动作, Q 估不准;估低了就不会再选它,也就再没机会改过来。
【例 6】只贪心会学错什么
每个回合都从 s2 出发, Q 全部从 0 开始;每一步都贪心,两个动作 Q 一样大时随便挑一个;每跑完一个回合就更新 Q。跑 2000 个回合,结果如下(每格是 Q 的估计和这个动作被试过几次):
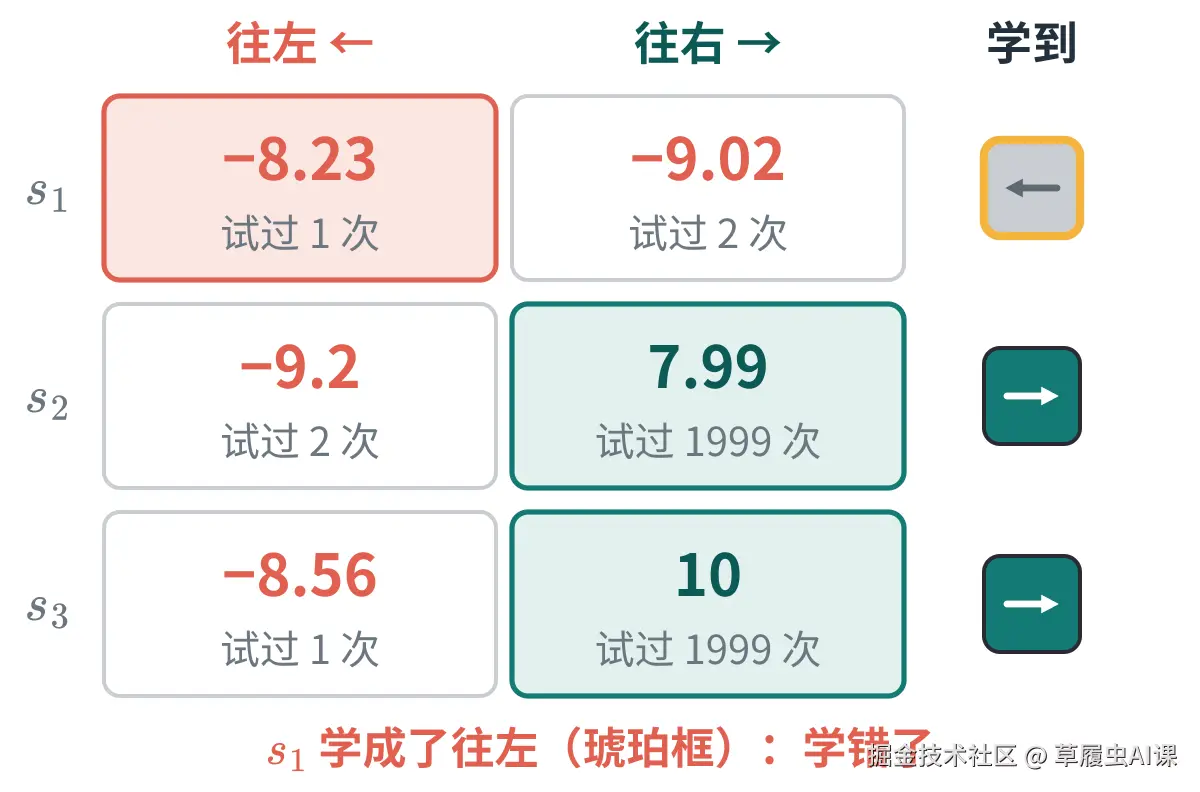
▲ 图 12 例 6 图解:只贪心跑 2000 个回合后的 Q 表
- s2、 s3 学对了 :往右试了一千九百多次, Q 分别是 7.99 和 10,接近真值 8 和 10。
- s1 学错了 :头两个回合乱走时, s1 往左拿到 −8.23,往右拿到 −9.02,往左稍高,于是贪心选了往左撞墙。
- 再也改不过来 :之后每个回合都从 s2 一路往右,再也不经过 s1,这两个数就停在那里。
其实 s1 往右的真值是 6.2,比往左的 4.58 大得多,只是只试了两次,运气不好。
哪天改为从 s1 出发,这一趟会一直往墙上撞:蒙特卡洛要等回合结束才更新 Q,可撞墙的回合自己结束不了(第二节说过,回合必须能结束)。附一的代码规定一个回合最多走 100 步,到了就强行截断。截断后, s1 往左的平均降到 −9.11,比往右的 −9.02 低,下一趟就改成往右,几趟之后 s1 往右的 Q 就涨上来了。
可见换个起点,没试够的动作就有机会再被试到。这正是下面探索性启动的思路。
探索性启动
一个直接的办法是探索性启动 (exploring starts):每个回合随机挑起点的状态和第一个动作 ,之后再按当前策略走。这样每个 (s,a) 都有机会被当成起点试到。
【例 7】探索性启动下的 Q 表
用探索性启动跑 2 万个回合,策略最后稳定在"一路向右"。每个 (s,a) 都被当成起点试过, Q 表六个格子都估准了:
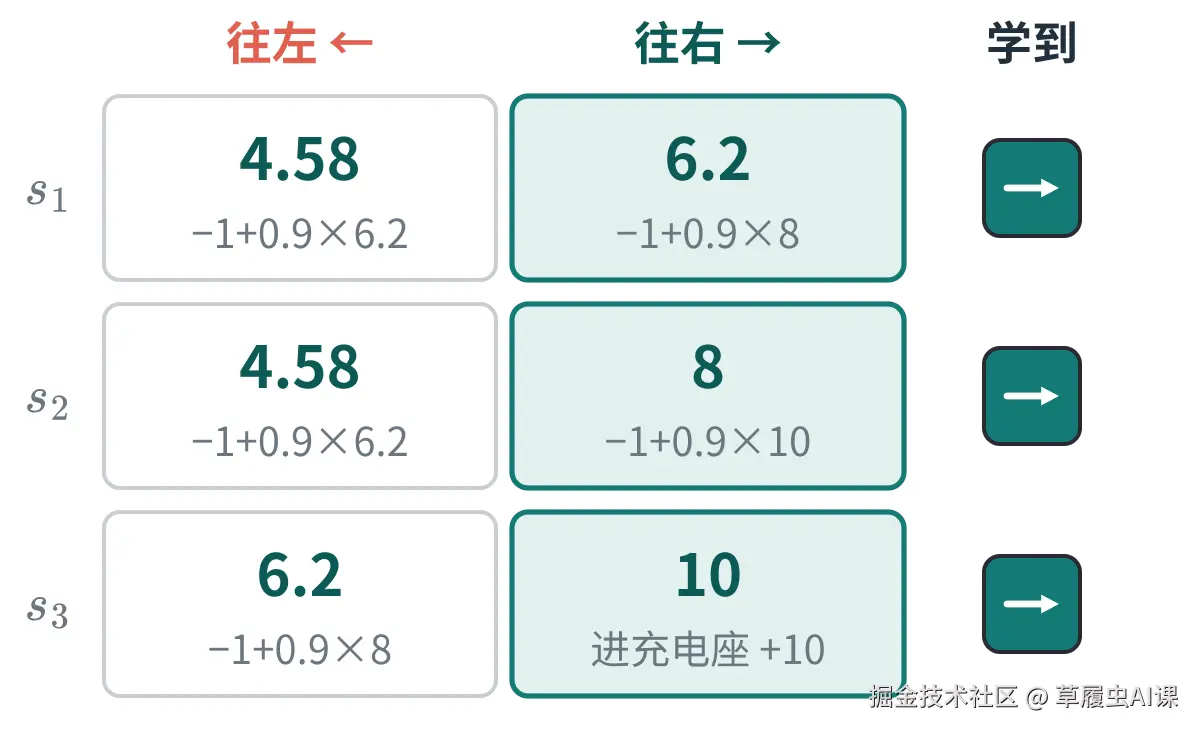
▲ 图 13 例 7 图解:每格是"先做这个动作,之后一路往右"的回报
- 从 (s3,←) 起步 :先到 s2,之后一路往右, −1+0.9×8=6.2。
- 从 (s1,←) 起步 :先撞墙留在 s1,之后一路往右, −1+0.9×6.2=4.58。
这正是第 2 篇算出的最优动作价值 Q∗。每一行都是往右大,最优策略得到确认。
【注意】探索性启动的局限
- 往往做不到:真实环境里,没法把机器人随意"传送"到任意状态,再逼它做某个动作。
- 数据和真实使用对不上 :随机起点造出的数据里,约四分之一来自 s1、近两成是往左的动作;可真正从 s2 出发一路往右时,这些一次都碰不到。表格里每格各记各的,影响不大;后面用神经网络近似 Q 时,网络会分心去拟合这些用不上的数据,真正常走的那几步反而学得不够准。
七、ε-贪心:自带探索
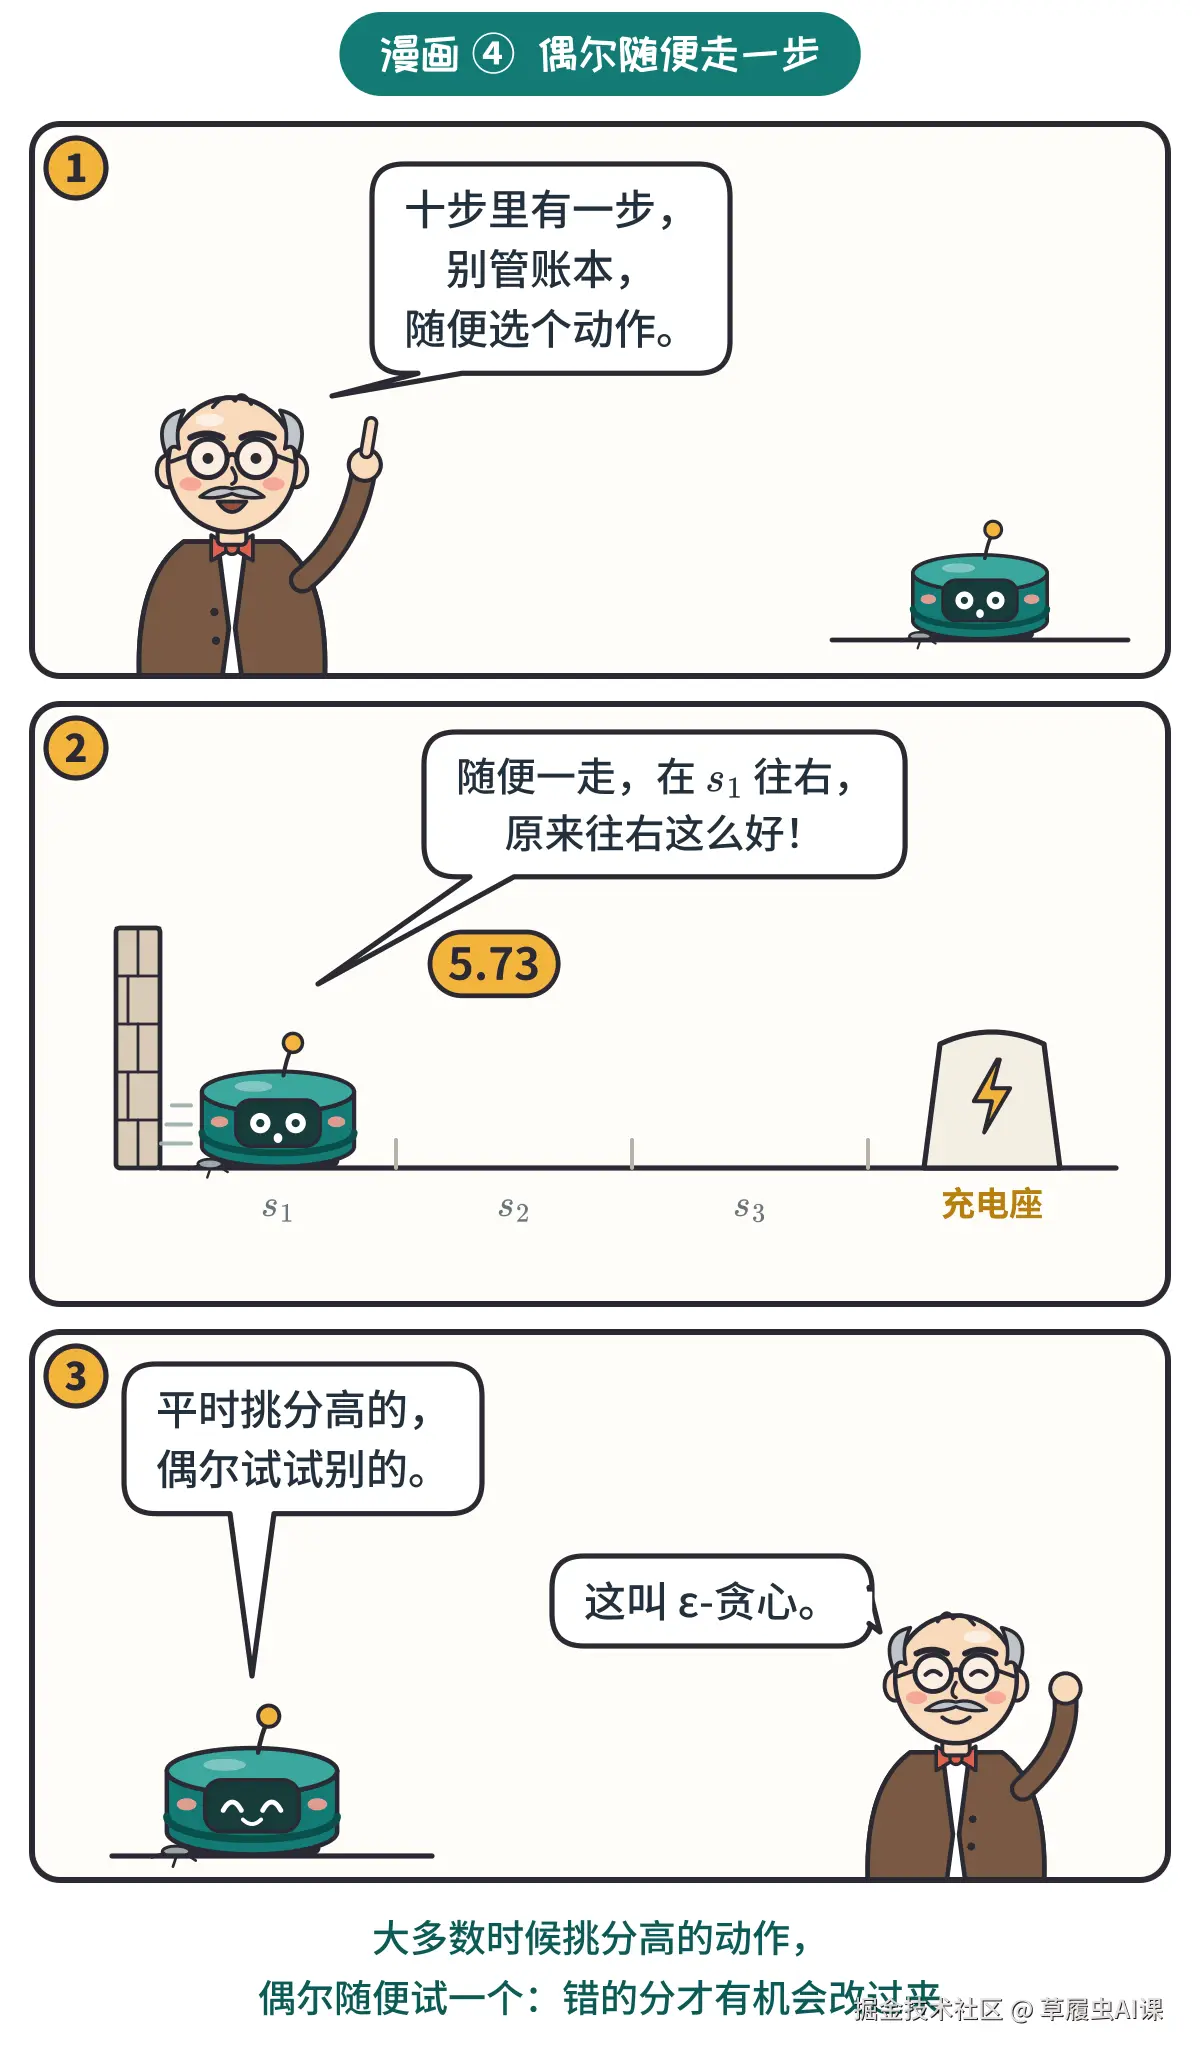
▲ 图 14 漫画 ④ 偶尔随便走一步
更常用的办法是不改起点,让策略自己留一点随机性。ε-贪心 (ε-greedy)策略:以 1−ε 的概率挑 Q 最大的动作,以 ε 的概率在所有动作里随便选一个。随便选也可能选中 Q 最大的那个,所以每个动作的概率是:
π(abest∣s)π(aother∣s)=1−ε+∣A∣ε=∣A∣ε
∣A∣ 是可选动作的个数, abest 是 Q 最大的动作, aother 是其他动作。 ε 越小,越依赖已经估出的 Q; ε 越大,越常去试没怎么试过的动作。
改进时不再变成严格贪心,而是变成 ε-贪心,蒙特卡洛控制照样成立:新策略不会比旧策略差(只是"最好"的范围变成了带 ε 随机性的策略)。
【例 8】走廊里的 ε-贪心
走廊每个状态有 2 个动作,取 ε=0.1。假设当前 Q 大的是往右:
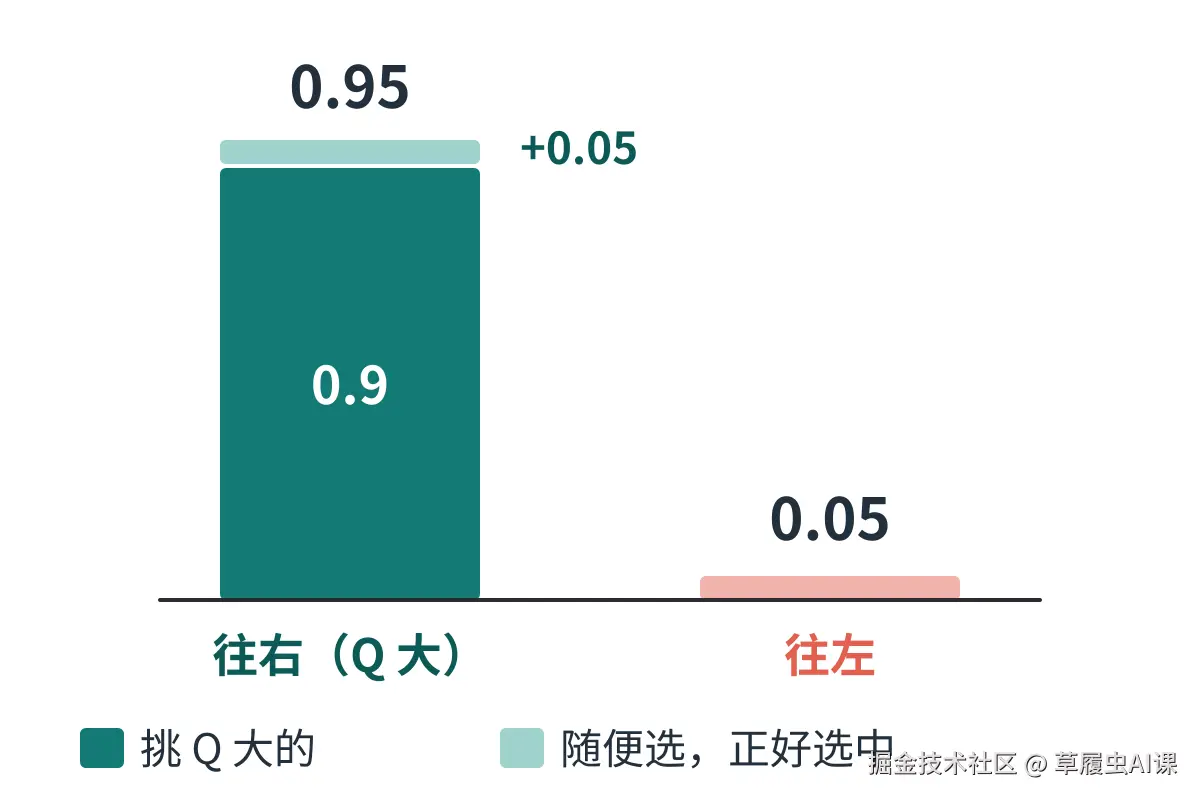
▲ 图 15 例 8 图解(一):往右 0.95,往左 0.05
- 往右 : 1−0.1+0.1÷2=0.95(0.9 是挑 Q 大的,0.05 是随便选正好选中);
- 往左 : 0.1÷2=0.05。
和例 6 的条件完全一样,只把"只贪心"换成"ε-贪心",再跑 2000 个回合,看 s1 往右的 Q 怎么变:
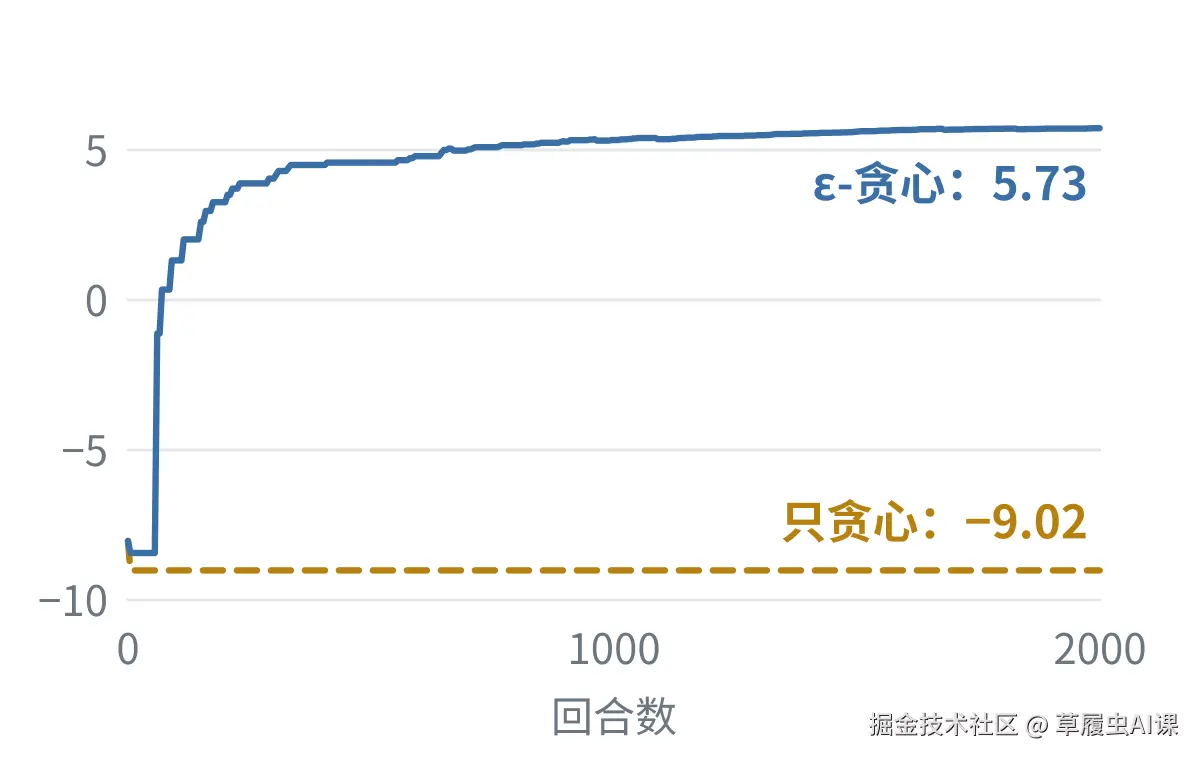
▲ 图 16 例 8 图解(二):ε-贪心(实线)偶尔走到 s₁ 试往右,估计一路涨上去;只贪心(虚线)一直卡在 −9.02
ε-贪心偶尔会随便走到 s1、在那里试往右, Q(s1,→) 一路涨到 5.73,超过往左的 −0.66, s1 也学会了往右。 s2、 s3 也都学会往右(附一的运行结果)。
【注意】探索是有代价的
ε-贪心永远留着 ε 的随机性,每一步都有一点概率"走错",所以它学到的是"带随机性的策略里最好的那个",不是严格的最优策略。在走廊里,一路向右的 ε-贪心版本, s2 的价值是:
ε 越大,价值越低。实际常让 ε 随训练慢慢变小:前期多探索,后期多利用已经学到的 Q。
| ε | 0(最优) | 0.05 | 0.1 | 0.2 |
|---|---|---|---|---|
| V(s2) | 8 | 7.82 | 7.63 | 7.21 |
八、小结
把这一篇的内容串起来,就是下面这张蒙特卡洛控制的流程图。蓝框是评估,红框是改进,每个框右上角的小签标着在第几节讲过;右边的虚线框是只估价值 V 的那条岔路。
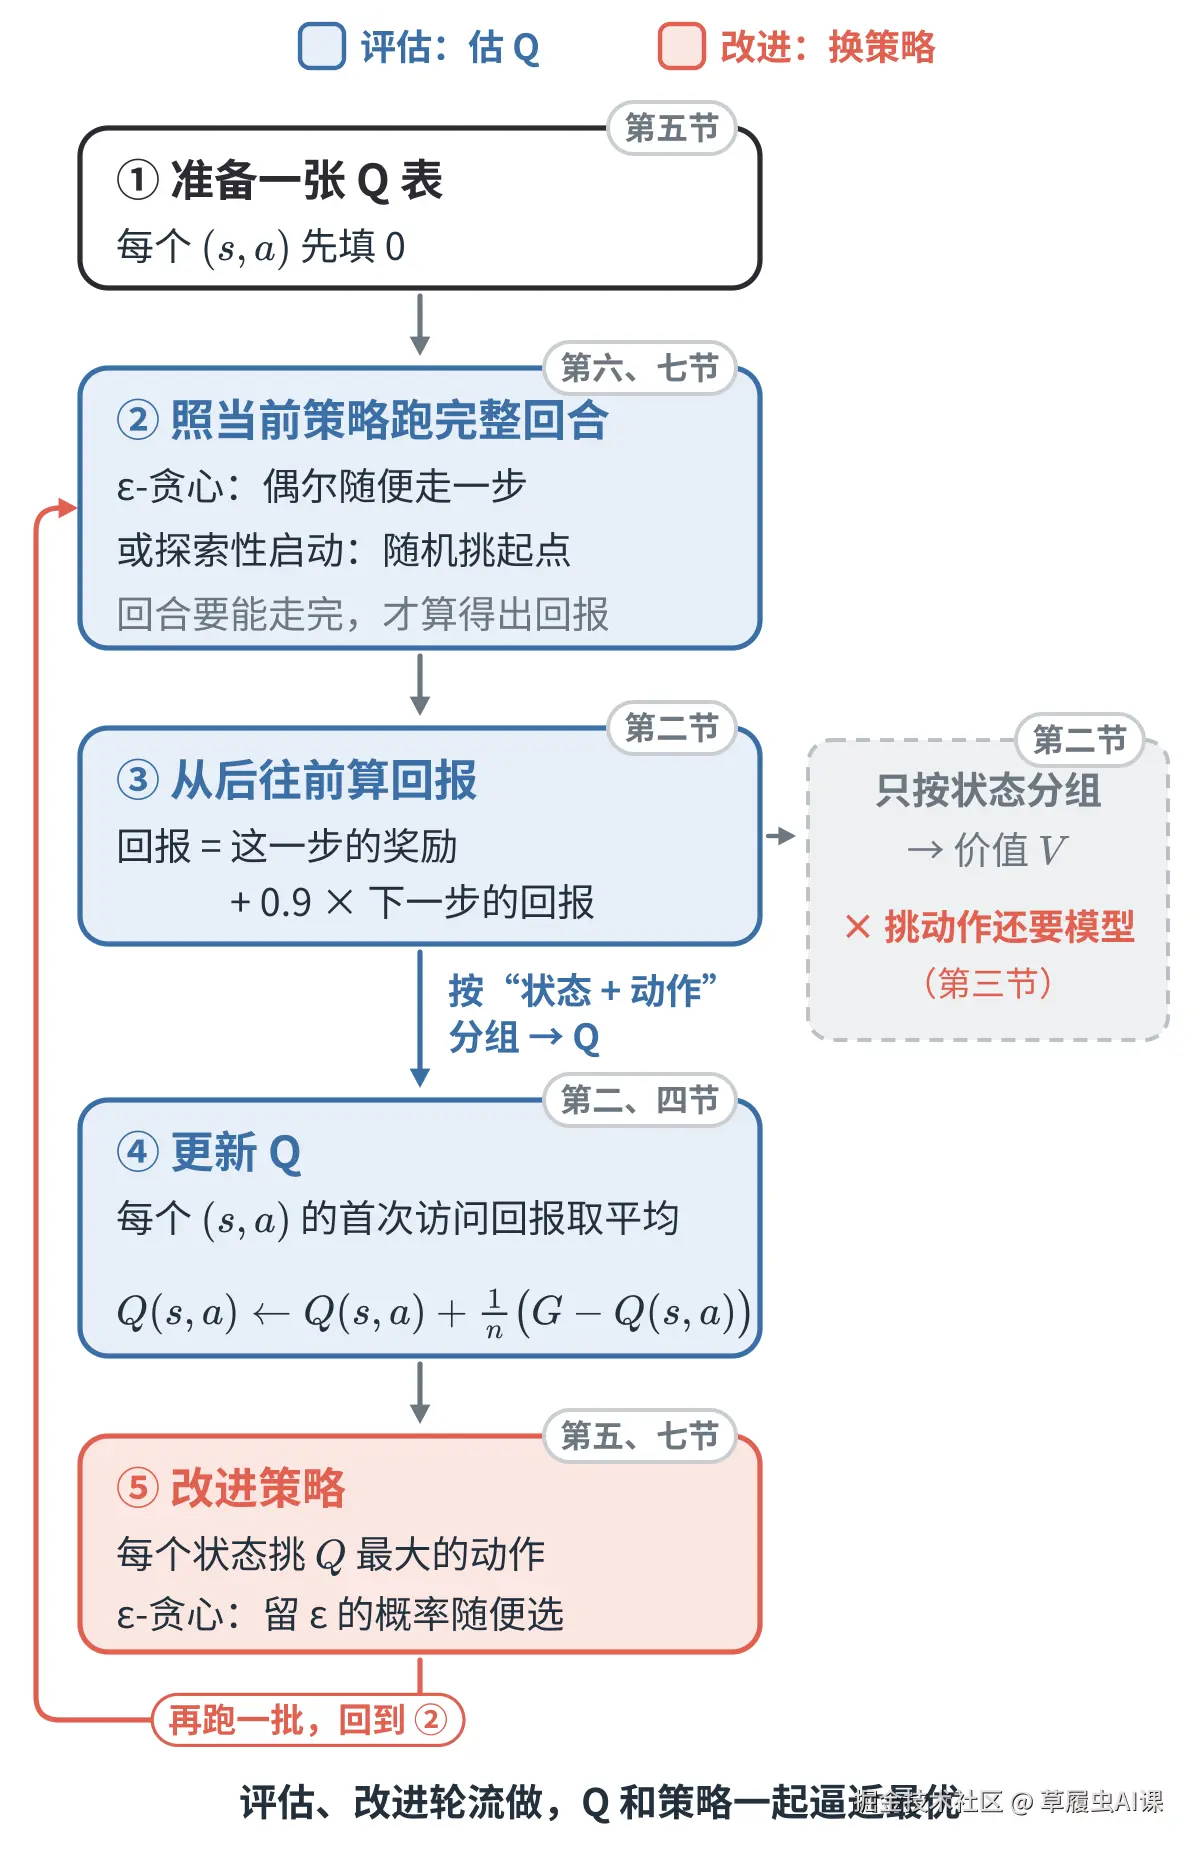
▲ 图 17 蒙特卡洛控制全流程:准备 Q 表 → 跑回合 → 算回报 → 更新 Q → 改进策略,再回到跑回合
各个概念的一句话总结:
| 概念 | 一句话 | 走廊里 |
|---|---|---|
| 蒙特卡洛 | 多做随机试验,取平均来估算 | 撒点估 π |
| 估价值 | 跑很多回合,回报取平均 | 增量更新得 3.563 |
| 改估 Q | 改进不用模型,直接比 Q | s2:3.24 > −2.31 |
| 蒙特卡洛控制 | 评估 Q、贪心改进,轮流做 | 三个回合得一路向右 |
| 只贪心 | 试得少的动作估不准,改不过来 | s1 学成往左撞墙 |
| 探索性启动 | 随机挑起点和第一个动作 | 得到完整的 Q∗ |
| ε-贪心 | 以 ε 的概率随便选 | s1 学会往右 |
蒙特卡洛是本系列讲的第一个不基于模型(model-free)的方法。一句话串起来:没有模型,就照策略跑回合、把回报取平均 ;为了不用模型也能改进,直接估 Q ;评估和改进轮流做就是蒙特卡洛控制 ;为了每个动作都有机会被试到,要探索 :探索性启动,或者 ε-贪心。
附一 动手算一算
下面是首次访问、ε-贪心的蒙特卡洛控制,只用标准库。智能体只通过 step 函数和环境打交道,并不读里面的规则。取 eps=0 就是例 6 的只贪心,eps=0.1 就是例 8。
python
import random

GAMMA = 0.9
S = (1, 2, 3)
ACTS = (-1, 1)  # 往左、往右

def step(s, a):
    # 环境:智能体只能调用,看不到规则
    if a < 0:
        s2 = max(1, s - 1)  # s1 撞墙
    else:
        s2 = s + 1
    r = 10 if s2 == 4 else -1
    return s2, r

def learn(eps, seed=5, n=2000):
    rng = random.Random(seed)
    Q = {(s, a): 0.0
         for s in S for a in ACTS}
    N = {k: 0 for k in Q}

    def policy(s):
        if rng.random() < eps:  # 随便选
            return rng.choice(ACTS)
        m = max(Q[(s, a)] for a in ACTS)
        best = [a for a in ACTS
                if Q[(s, a)] == m]
        return rng.choice(best)

    for _ in range(n):
        # 1. 从 s2 出发跑完一个回合
        s, traj = 2, []
        for t in range(100):  # 最多 100 步
            a = policy(s)
            s2, r = step(s, a)
            traj.append((s, a, r))
            s = s2
            if s == 4:
                break
        # 2. 从后往前算回报(首次访问)
        G, first = 0.0, {}
        for s, a, r in reversed(traj):
            G = r + GAMMA * G
            first[(s, a)] = G
        # 3. 增量更新 Q
        for k, g in first.items():
            N[k] += 1
            Q[k] += (g - Q[k]) / N[k]
    return Q

for eps in (0.0, 0.1):
    Q = learn(eps)
    print("eps =", eps)
    for s in S:
        L, R = Q[(s, -1)], Q[(s, 1)]
        print(s, round(L, 2),
              round(R, 2))
回合最多走 100 步,免得只贪心时在 s1 一直撞墙、回合永远不结束。从后往前算回报时,同一个 (s,a) 越靠前的回报会覆盖后面的,留下的正好是首次访问的回报。
附二 参考文献
- Metropolis N, Ulam S. The Monte Carlo method. Journal of the American Statistical Association, 1949, 44(247): 335--341.
- Sutton R S, Barto A G. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018. 第 5 章.
【下期预告】同策略与异策略
要探索,策略就得带点随机性;可我们真正想学的,往往是不带随机性的最优策略。能不能用一个负责探索的策略去收集数据,同时学习另一个策略?下一篇讲同策略 (on-policy)和异策略(off-policy)。
【关注】谢谢您看到这里这个系列会一直更新下去。关注我,新文章一发布就会出现在您的关注动态里,不会错过后面的内容。
也可以收藏本系列专栏,全部文章按顺序排在一起,随时回看。
感谢关注和支持!有问题也欢迎在评论区聊聊~
------ 强化学习从零到一 · 第 5 篇 · 完 ------