SmartPerfetto 1.19.0 已发布。 相比上一篇更新记录覆盖的 1.15.1,这段时间最大的变化是分析引擎统一到 Pi Agent Core;同时升级了 Perfetto、补了新的数据分析能力,也围绕 TraceDemo 的多轮测试修了不少实际问题。
先把这次值得关注的内容列出来:
- 分析引擎统一:从多套 Agent runtime 转向默认使用 Pi Agent Core,Web、CLI、API 共用取证与交付能力;旧的模型声明与 claim-verification 流程已移除。
- 分析过程更好用:分析中途可以补充上下文,源码选择按会话保存;长会话的证据回读、预算收尾、连接中断和错误提示都有修复。
- 能读到的证据更多:Perfetto 升到 v59.1,增加进程生命周期、JobScheduler 等观察;Bitmap、Doze、CPU PMU、相机和渲染分析也有更新。
- 多轮验证留下了具体结果:合成样本、真实 trace、定向复测和最终发布包分别验证。哪些完成了,哪些只测了部分,后面会展开。
- 不想装完整产品,也可以用 Perfetto-Skills:把独立 Skill 装进自己的 Codex、Claude Code 或 OpenCode,在已有 Agent 环境里分析 trace。
下载 1.19.0 · SmartPerfetto · Perfetto-Skills
这是一篇独立更新,接着上一篇更新记录往后写,范围是 1.16.0 到 1.19.0。尤其要说明:Pi 成为默认引擎发生在 1.18.0,1.19.0 是这次迁移之后继续补能力、修问题的一版。
先看版本:这一个多月改到了哪里
| 版本 | 这次文章要交代的变化 |
|---|---|
| 1.16.0---1.16.2 | 强化单位、证据与答案交付;修复 HTML 报告的完整内容、离线交互和身份恢复。期间还在维护声明与语义核验流程,后续于 1.18.0 移除 |
| 1.16.3---1.16.4 | 修复历史消息渲染、闲置 trace processor 回收、CPU/FPS 目标身份;整理 AI Assistant 的停靠、缩放、窄面板和主题表现 |
| 1.17.0 | Perfetto UI、Wasm、trace processor 与 SQL 知识同步到 v59.1;补充进程启动/退出和 JobScheduler 等证据 |
| 1.18.0 | 默认引擎切换到 Pi Agent Core;支持运行中补充信息;移除 OpenCode/Qoder 执行引擎和模型声明核验流程 |
| 1.18.1 | 源码选择按会话保存;可主动导入本机 Claude Code/Codex 的网关配置;npm 包携带 Node 24 的 SQLite 原生绑定 |
| 1.19.0 | Bitmap、Doze、PMU 能力,以及相机/渲染证据改进;继续修复 Pi 预算、工具结果、SQL 指导、身份诊断和 CLI 报告交付 |
完整列表见 1.19.0 Changelog。我下面主要讲用户能感受到的变化,以及为什么要这样改。
新架构:统一模型循环,把分析能力留在产品里
一次 trace 分析包含不少不同性质的工作。模型要理解问题、决定接下来查什么;Skill 和 SQL 要实际取数;进程身份、时间窗口和数据来源要保持一致;最终还要把结论、HTML 报告和会话结果交付出来。
之前同时维护多套模型 SDK/runtime,这些工作需要跨不同执行方式接起来。现在默认由 Pi Agent Core 负责模型请求和工具循环,SmartPerfetto 继续拥有策略、工具、Skill、SQL、身份与权限、报告和会话。Web、CLI 和 API 使用同一套后端分析能力。
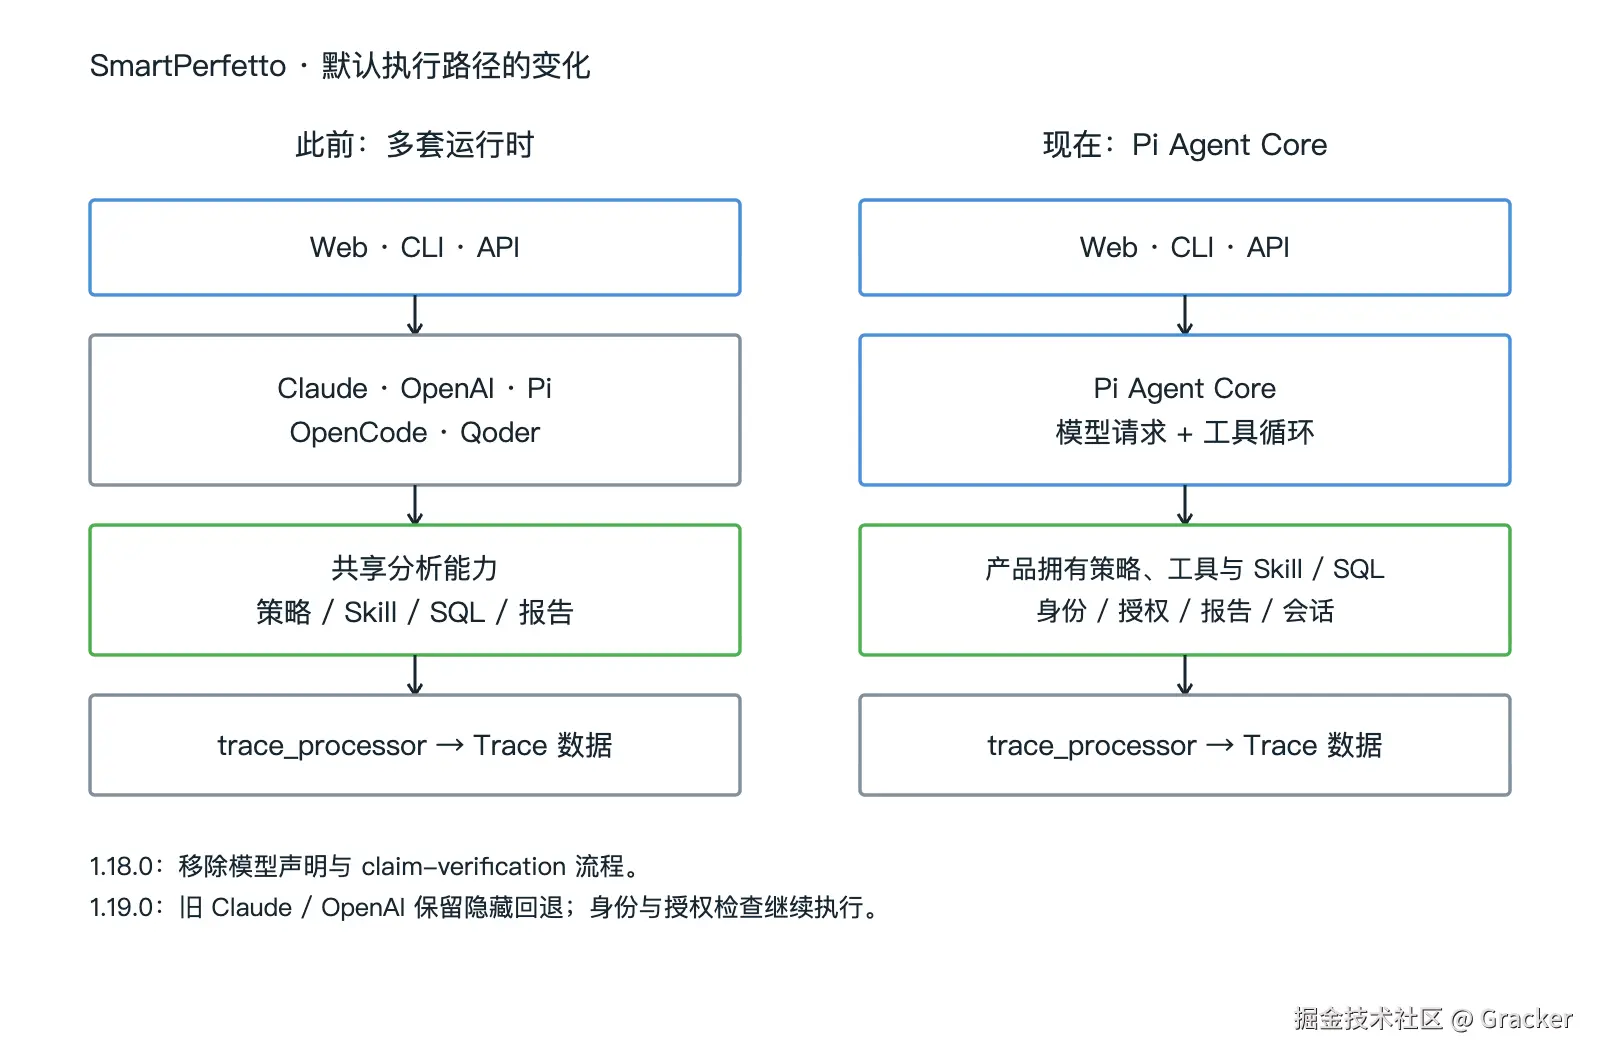
图中展示默认执行路径的变化。1.19.0 仍保留旧 Claude/OpenAI 引擎的隐藏回退;它们不再是日常配置界面的可选项。
Provider 仍决定 API、endpoint、模型和凭据。切换引擎时,已有配置需要保留原来的请求目标;恢复旧会话,也不能因为后来换了 active provider,就把会话悄悄发到另一家服务。无法迁移的旧配置会明确报错。源码授权、进程身份和 trace 归属检查也继续由产品控制。
Pi 在这里不会自动获得任意文件和 shell 权限。SmartPerfetto 使用的是自己的分析工具集合,源码读取仍需要对应授权。具体模块关系见当前 runtime 架构。
这次还撤掉了一套曾经投入很多精力的流程
如果看过上一篇文章,会记得当时花了很多篇幅讲"答案声明与核验":模型需要把结论和证据关系按特定格式声明,产品再解析、修复和核验。
1.16.x 还在继续修这套流程,包括声明格式、预算耗尽后的恢复和不完整引用。但真实模型运行里,声明、修复和最终正文之间仍然有交付摩擦;1.17.0 的发布记录也明确保留了启动、滑动探索运行未完成报告的限制。到了 1.18.0,运行时模型声明与 claim-verification 流程被移除。
当前方向是把可确定的工作放到取证阶段:Skill/SQL 给出数据,生产者尽量说明单位、范围和语义,模型据此组织调查和解释。后端依然要守住身份、授权、预算和交付合同,但不能把"生成了一篇报告"包装成"每句话都完成了因果证明"。
我觉得这段取舍值得单独留下来。更新记录如果只写新增了什么,读者就会误以为旧文中的核验能力一直累加到现在;实际上这里发生过一次明确的架构调整。
分析中途补信息,长调查也能继续看证据
分析已经开始后,用户常常才想起一条关键信息,比如"只看第二次启动""这个进程刚刚重启过"。现在可以在运行中补充上下文,界面会显示这条补充是排队、已送达,还是未能应用。它不保证回溯修改已经完成的分析步骤,但用户能知道信息有没有进入本次运行。
源码选择也改成按会话保存,新会话从最近一次选择开始。用户主动发起时,可以导入本机 Claude Code/Codex 的第三方网关配置;导入只读指定配置文件,并通过系统对话框确认。这不等于 Claude Code 订阅登录就能直接配置 SmartPerfetto,仍需要有效的 API 凭据。
长调查里,证据管理也影响体验。模型可能先查一个总览,几十次工具调用后又要回看最早的几行。我们扩大了有上限的工件工作集,同时限制直接送进模型上下文的行数,保留按需分页和回读的入口。这样能减少过早驱逐证据造成的中断,同时控制上下文体积。缓存依然有容量与生命周期限制。
Pi 的预算收尾和连接恢复也做了多轮修复:轮数或上下文接近上限时给最终结论留出空间;对可重试的服务错误和空闲流中断按次数、时间、轮次及已知费用约束恢复;保留已经完成的工具结果。费用上限只对有已知定价的模型有效,不能把它理解为对所有第三方网关都生效的硬性账单保证。
新的分析能力,先说清能看到什么
Perfetto v59.1、进程生命周期与后台任务
1.17.0 同步了 Perfetto v59.1,包括 UI/Wasm、固定版本 trace processor 和生成的 SQL 知识。上游的 FrameTimeline 图层分组、堆视图导航和 CPU 时间等变化也进入产品。
分析侧增加了进程启动上下文、启动延迟、退出原因和状态转换;JobScheduler 同时利用 framework track events 与已有 ATrace 视图。缺少等待时长、取消任务或归属信息时,会保留对应限制,不能把未知直接写成零。
Bitmap、Doze、CPU PMU
Bitmap 分析补了进程内已记录对象的 live set 形态、大小分布和大对象。排查图片内存时,可以从"占用比较多"继续看具体分布。不过,记录到的 Bitmap 对象与整个进程内存是不同口径。
Doze 分析增加 light/deep idle 的状态标签和转换时间线。快速切换值得继续调查,但单凭"切换频繁"不能证明异常耗电。
CPU PMU 分析增加计数器增量、事件比值和可用的进程归属信息,前提是 trace 录到了所需计数器。没有采集的硬件事件不会在升级后凭空出现,归属不足时也不能硬算到某个应用头上。
相机、渲染和显示之间的区别
相机分析开始更明确地测量观察到的帧节拍,并统一 SurfaceFlinger 绑定判断。Buffer/Transaction 分析区分帧生产、事务活动和呈现证据;WebView、React Native、浏览器合成等路径有各自的条件。
这一点对"看起来有渲染活动,所以画面肯定显示了"的推断很重要。生产端活动只能支持对应阶段的观察,要确认显示,还需要绑定和呈现证据。产品中的渲染解释也改为维护中的教学卡,和管线目录一起校验。
TraceDemo 跑了几轮,具体修到了什么
测试里发现的问题,很多不表现为"完全跑不起来"。模型可能已经交付了报告,但中间绕了弯路:回读证据失败、把发现工具当成 Skill 调用、参数猜错、身份拒绝原因被长结果挤掉,或者 SQL 用了不存在的列。
这些问题直接影响一次调查能否顺利推进,所以我们保留了不同轮次的账本和定向复测。表中的 P1--P5 是五项过程修复,F1--F6 是 fresh50 调查后归纳的六项诊断与调用问题。
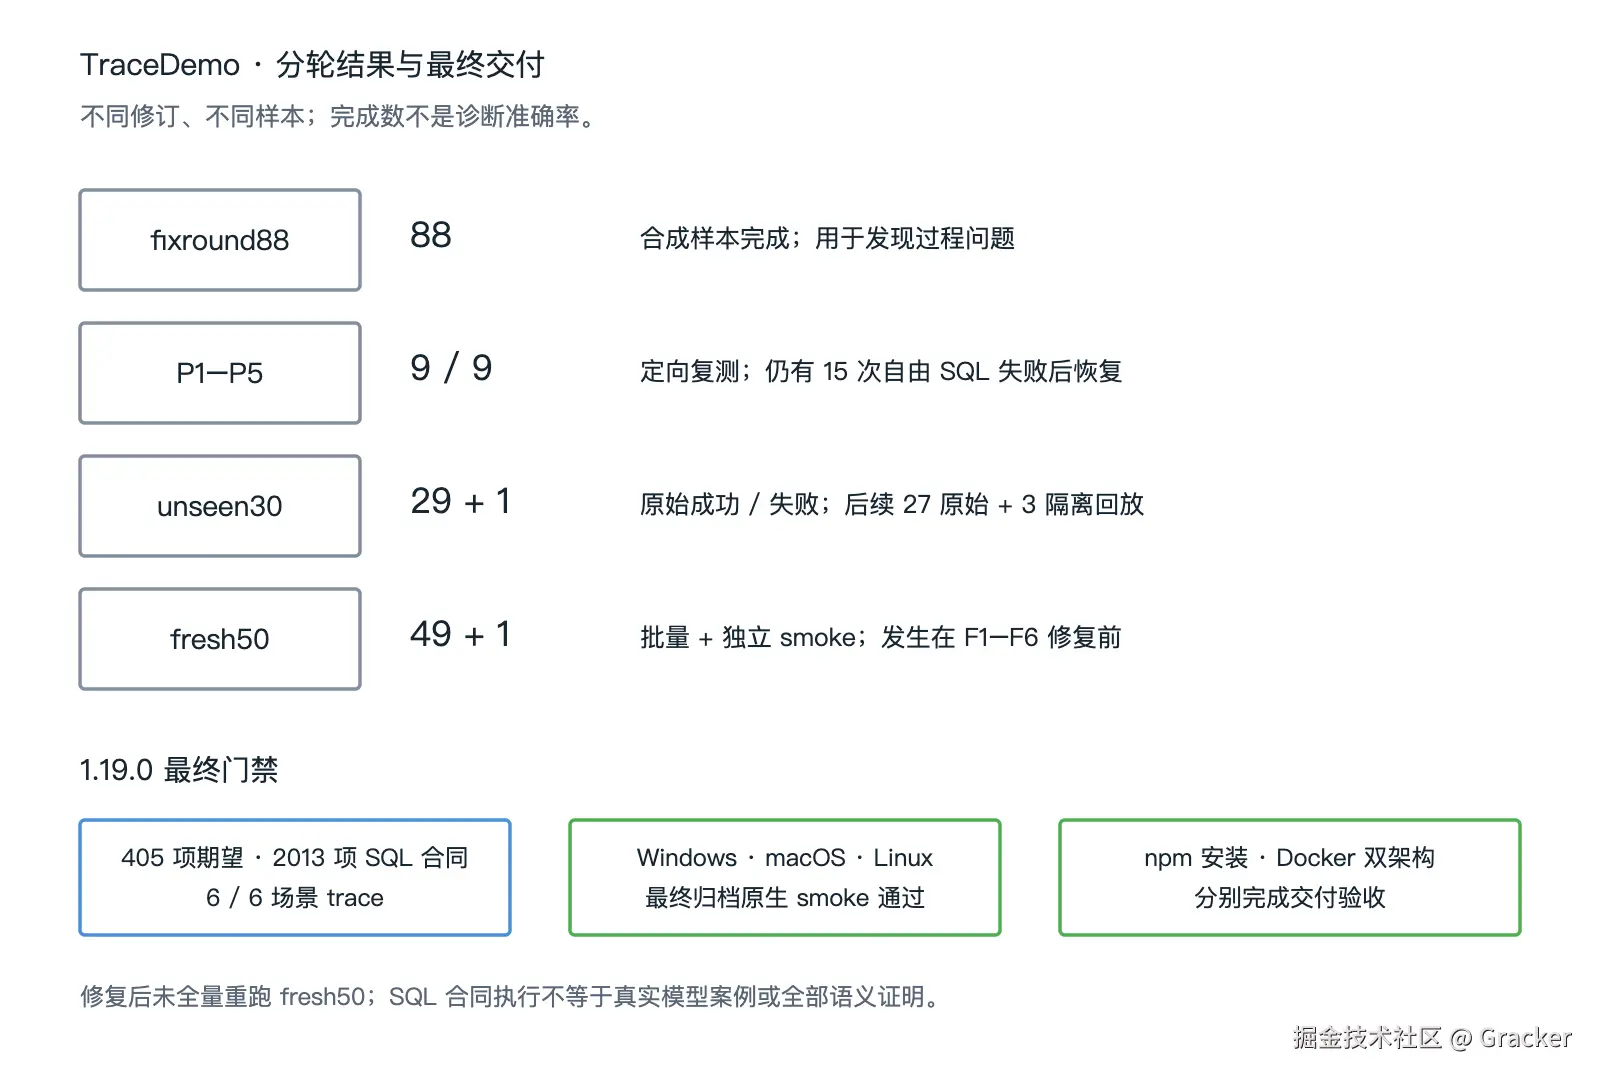
不同批次使用不同代码修订和样本。图中的完成数不是诊断准确率,定向复测也不等于重新跑完整批次。
| 记录 | 观察与结果 | 能说明的范围 |
|---|---|---|
| fixround88 | 88 个合成样本记录为完成 | 暴露分析过程中的工具使用问题;没有逐句重算所有结论 |
| P1--P5 定向复测 | 9/9 交付完成,对应用例的目标错误串消失 | 仍有 15 次自由 SQL 失败并恢复,不能写成全部工具零失败 |
| unseen30 | 原批次 29 成功、1 失败;汇总证据为 27 个原始完成 + 3 个隔离回放 | 一次并发资产修改导致 dist 与运行时资产不一致;原 29/1 账本保留 |
| fresh50 | 49 条批量记录 + 1 条独立 smoke 完成 | 发生在 F1--F6 修复之前;修复后没有重跑完整 50 例 |
| fresh50 修复验证 | 相机、thermal 自然复跑,加受控诊断探针 | 验证对应修复,不代表对所有场景的整体收益 |
这些数据来自 TraceDemo runner 产物及 SmartPerfetto 的本地验证记录。可公开复核的发布信息见 1.19.0 Release;完整 trace 与本地会话不作为本文附件发布。
几个实际例子
错误信息要让人知道错在哪里。 一次身份拒绝的关键原因,曾被很长的参数合同挤出结果摘要。现在优先保留安全的原因和下一步动作。SQL 日志也可以给出受限制的缺表、缺列、缺函数标识和查询哈希,帮助诊断,同时避免输出整段原始 SQL。
模型的 SQL 先验也会过时。 sched.is_idle 就是一个具体例子:正确做法是通过 thread join 使用 thread.is_idle。我们补了按内置 schema 核对过的核心列速查、slice/thread 关联和窗口函数指导。相机单例复跑里 SQL 失败从 3 次变成 1 次,但两次查询总数不同,一个样本不够证明普遍降低了多少百分比。
大数时间戳需要明确单位。 thermal 案例曾出现错误秒量级。现在只从单位明确为 ns、可以精确处理的值派生秒预览,保留原始单元格和时钟起点。定向检查中的 394361.352 s → 394406.092 s 对应 44.74 s。当时记录中的另一处频率单位标签问题仍未解决,不能一起算作修好。
证据不足时,计划要解释缺什么。 阶段反馈会列出缺失调用、已成功调用和带真实 tool-call ID 的失败调用。模型可以补查,或引用失败说明无法取证;这不会自动把未解决的调查项变成成功。
语义复核也留下了边界:多个并行线程的 CPU 时间相加,不能直接证明端到端关键路径;SurfaceFlinger 走 HWC,也不能推出全局 GPU 工作都来自目标应用。我希望读者能看到这些问题的存在,而不是只看到一串绿色完成标记。
最终发布包又单独验了一遍
1.19.0 的完整 verify:pr 通过,包含 405 项 corpus 期望、2013 项 SQL 合同执行、6/6 场景 trace 回归。
2013 中有正常生产路径、强制上下文、隔离探针和精确 UPID 绑定;只有部分包含正向语义断言,不能把它们当成 2013 个真实模型案例。SQL 覆盖为 0 skipped / 0 unavailable,其他测试保留既有 skip。
交付也分别验收了:Windows/macOS/Linux 最终归档原生 smoke、npm Trusted Publishing 与公共安装、Docker 双架构构建。
macOS 包完成 Developer ID 签名、公证和 staple;npm 在无凭证、禁用 install scripts 的环境中检查了原生 SQLite 和真实 trace 查询;Docker 的版本、latest、SHA tag 指向同一份双架构 manifest。
已经在用自己的 Agent?直接装 Perfetto-Skills
不想运行 SmartPerfetto 的完整界面和后端,也完全可以。Perfetto-Skills 是独立的 Agent Skill,面向有文件与终端能力的 Agent,提供分析工作流、SQL、证据规则和确定性 runner。
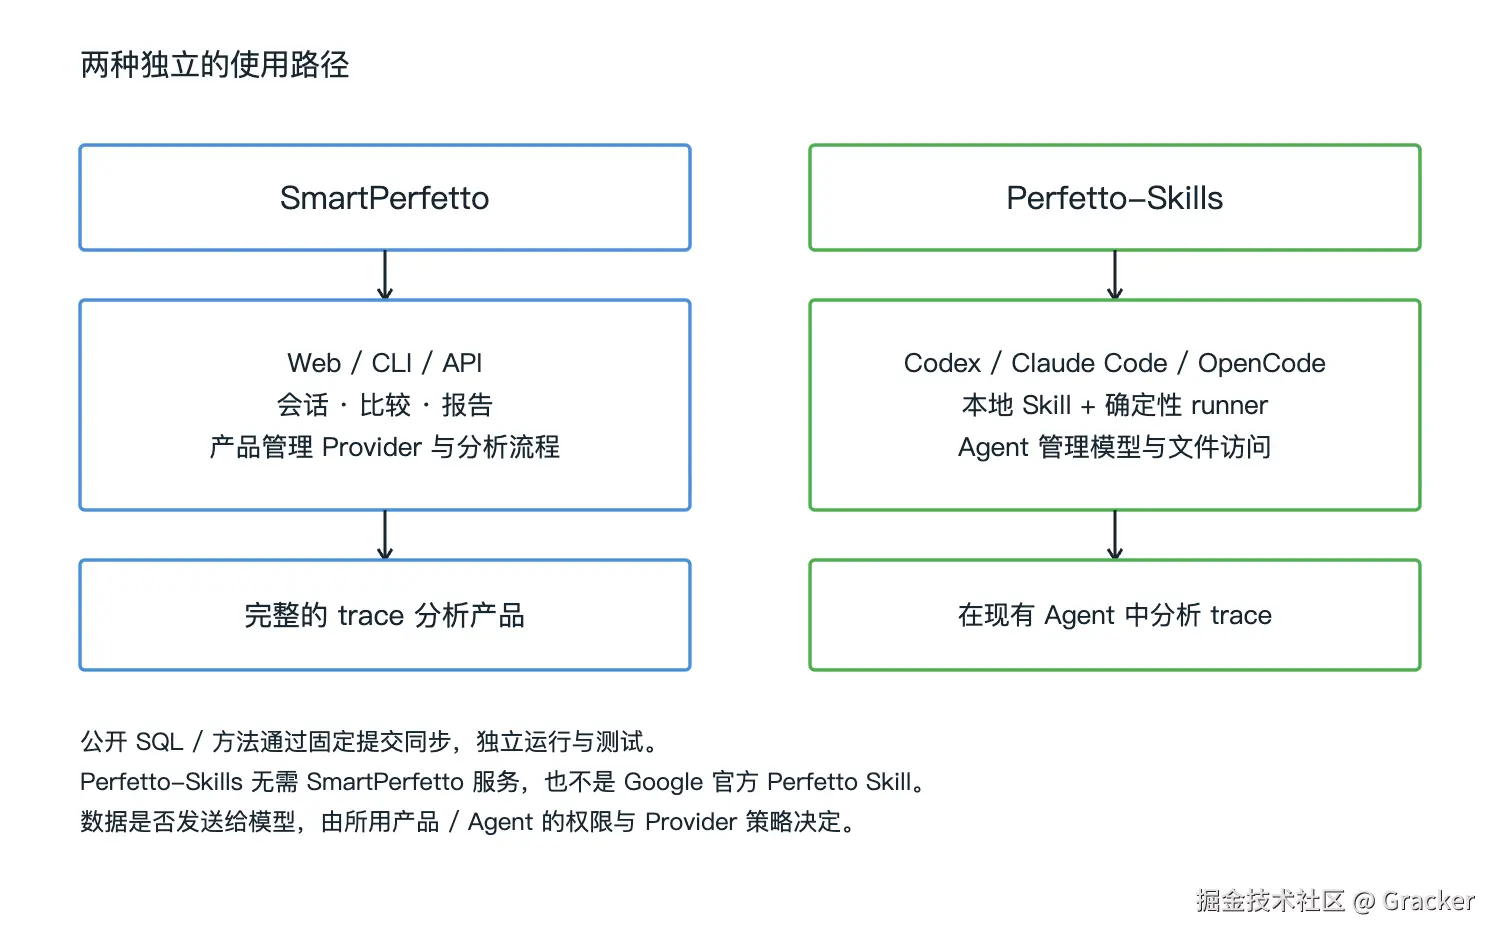
| 你希望怎样工作 | 更适合的入口 |
|---|---|
| 打开 trace,在界面里调查、保存会话、导出报告、做比较 | SmartPerfetto |
| 在现有 Codex、Claude Code 或 OpenCode 里,让 Agent 按方法分析本地 trace | Perfetto-Skills |
它不需要 SmartPerfetto backend、Provider runtime、UI 或 MCP 服务。公开的 SQL 和方法资产通过固定提交同步,同时有自己的原生代码、独立真实 trace fixture 和完整门禁。这次来源固定到 1.19.0,公开仓库提交为 070053917,完整门禁记录为 514 tests、1 skipped。
按仓库当前 README 的安装方式,在项目目录中执行:
bash
npx skills@1.5.16 add Gracker/Perfetto-Skills \
  --skill perfetto-performance-analysis \
  -a codex -a claude-code -a opencode -y
只保留你使用的 -a 即可;需要用户级安装时添加 -g。运行脚本需要 Python 3.11+,首次使用按 Skill 指引准备固定版本 trace processor。上面的 skills CLI 是方便安装的生态工具,并非 Agent Skills 规范本身要求的安装器。
可以从这样一个问题开始:
使用 perfetto-performance-analysis 分析这个 trace 中目标应用的启动。先确认进程实例和时间窗口,再列出关键证据、无法确认的原因,以及建议补采的数据。
SmartPerfetto 移除的是自身内嵌的 OpenCode 执行引擎;在独立 OpenCode 中使用 Perfetto-Skills 仍是另一条使用路径 。另外,这个项目也不是 Google 官方 Perfetto Skill:它提供自己的领域工作流与执行器,官方 Skill 是独立的上游选择。安装与使用细节见 Perfetto-Skills README。
这里仍有同样的限制:SQL 能执行,不等于某个因果结论已验证;本地有 trace,也不代表可以忽略发送给模型服务的数据范围。Agent 的文件权限与 Provider 数据策略需要由使用者管理。
下载与升级
GitHub Release 提供 Windows x64、macOS arm64、Linux x64 免安装包,自带运行时。npm CLI 需要 Node.js 24:
bash
npm install -g @gracker/smartperfetto@1.19.0
smp --version
smp doctor --format json
没有配置 Provider 时,doctor 会指出 AI runtime 未就绪,需要补齐凭据。Docker 可使用 w553000664/smartperfetto:1.19.0,latest 也已更新;它不读取宿主机 Claude Code 登录态。
这次发布整理没有新增历史数据回填。旧 Provider 按现有迁移规则处理,已经退役且无法映射的配置需要重新填写有效 endpoint;过往 trace 没采集到的 PMU、堆对象或呈现信息,升级也无法补出来。最终版本没有重新跑所有真实 Provider 的全量验收,文中的历史 GLM/DeepSeek 测试范围不能推广到所有模型与云服务。
这次我想记录下来的,既有新引擎和新能力,也有测试中那些看似细小、却会打断调查的问题。你想用完整分析产品,就下载 SmartPerfetto;希望继续留在自己的 Agent 工作环境里,就试试 Perfetto-Skills。