一条消息处理的流程图
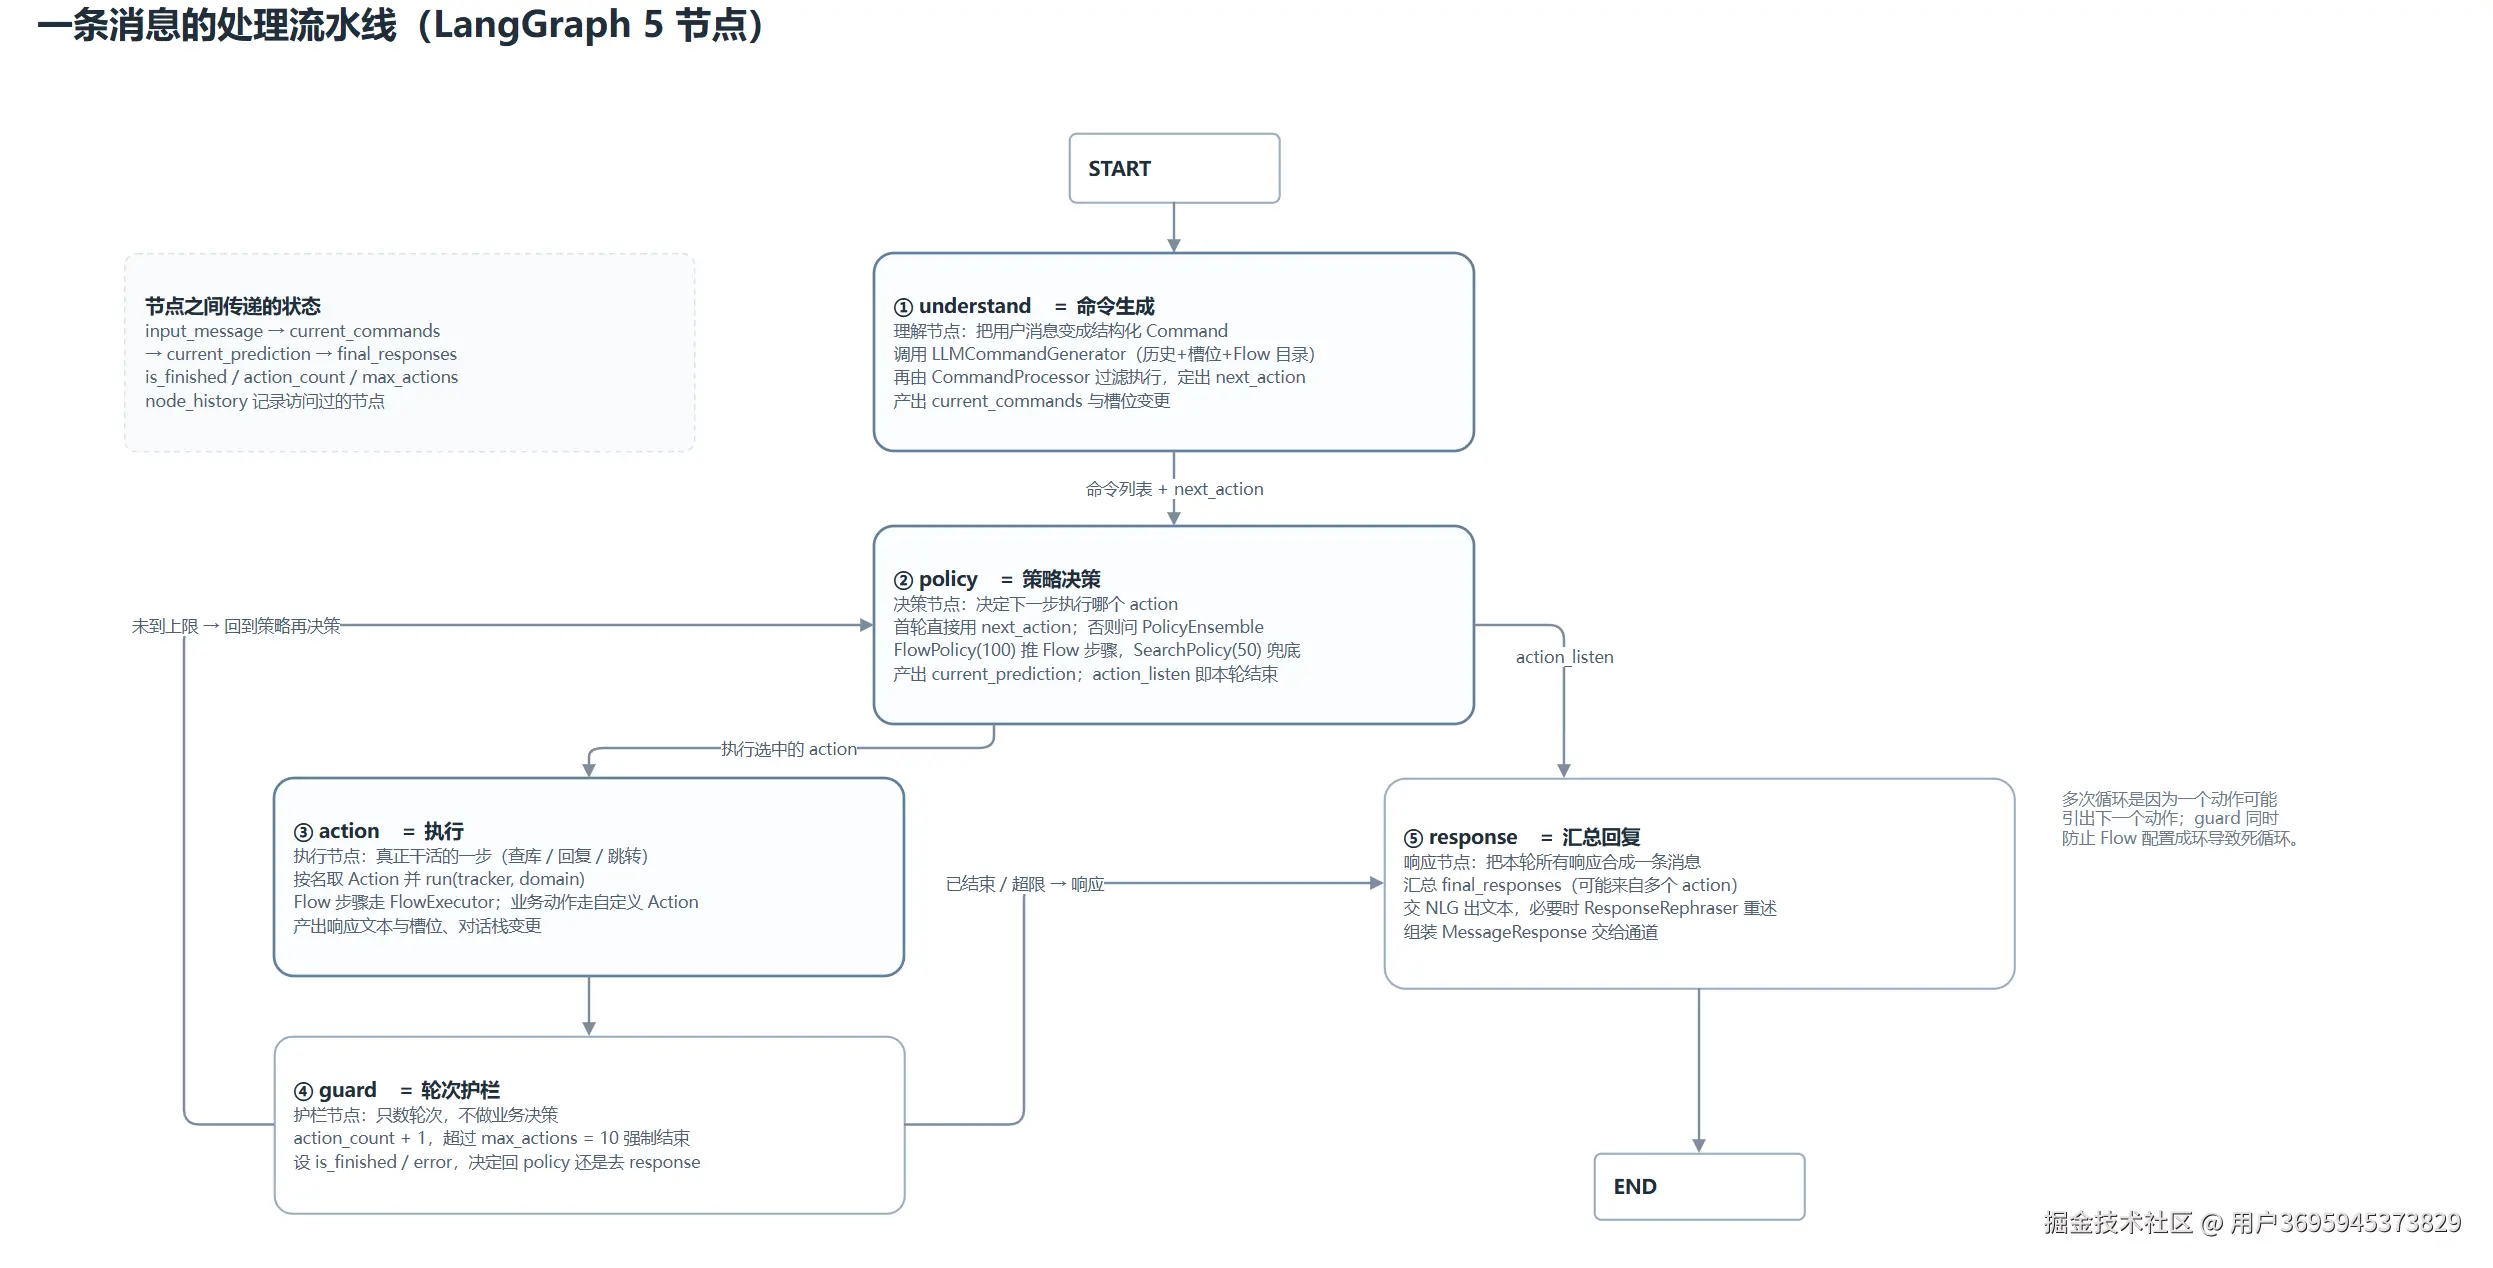 上一篇拆了分层,讲清系统由哪几块组成。但分层图有个天生的毛病:它是静态的。你能看到"理解与决策层"和"执行层"并排摆着,却看不出用户发一句话进去,里面到底转了几圈、在哪一步停下。 图不长,五个节点:
js
START → understand → policy ⇄ action → guard → response → END- 真正的信息不在节点名里,在三条边上:
policy后面有个条件判断,action之后必经guard,guard又能拐回policy。这三条边决定了"一轮消息"可能是一次请求响应,也可能是十次动作循环 policy ⇄ action是个循环。用户说"我要退那个上周买的鞋",系统可能先执行一个动作打开订单列表,再执行一个动作让用户选,选中之后再执行一个查详情的动作,最后才轮到回复。这些动作都在同一轮 里跑完,中间不返回给用户。所以response节点不是"每轮必到"的收尾,它是"这一轮攒够了、可以说话了"的出口。
各个节点的具体功能
1. understand:把话变成命令
它是唯一调用大模型的节点。输入是用户那句话,输出是一串结构化命令(开始流程、填槽、转人工之类)。这里有个实现上的细节挺有意思:它有一条绕过 LLM 的捷径。 如果输入以 /SetSlots( 开头,节点不走模型,直接用正则解析成槽位命令。
python
if input_message.strip().startswith("/SetSlots("):
    commands = parse_set_slots_payload(input_message)
为什么要留这条路?因为前端按钮点击不是自然语言。用户在卡片上点了"订单 12345",前端传过来的是确定的结构化数据,没必要再让模型猜一遍,既慢又可能猜错。这条捷径省掉一次模型调用,也避免了"模型把 12345 看成 12346"这种低级错误。
2. policy:决定下一步做哪个动作
它有两种决策来源,顺序不能反:
- 第一轮 (
action_count == 0)优先用CommandProcessor算出的next_action - 否则交给
PolicyEnsemble,按优先级问各个策略
为什么只有第一轮用 next_action?因为那是"理解阶段"顺手定下的第一步,比如命令里说了"开始订单查询流程",那第一步就该进流程。但第二步以后不能再听它的了,得看当前对话走到哪,这只有策略知道。
代码里还有一行容易被忽略的过滤:
python
if not next_action.startswith("action_run_flow_"):意思是有一种伪动作叫 action_run_flow_xxx,它不是真的要执行什么,而是"该让 FlowPolicy 去推流程了"的标记。这种动作不会直接进 action 节点,会被跳过,让下面的策略集合接管。policy 结束时会写一个 is_finished。判断标准很简单:预测出来的动作是 action_listen,或者压根没预测出动作,就认为这轮不用再干了。action_listen 这个词值得单独记一下。它的字面意思是"等用户说话",在架构里等于"本轮到此为止"。整套流转的终止条件,一半靠它。
3. action:真正干活,顺手计数
按名字找到动作实例,跑 run(tracker, domain),把返回的响应塞进 final_responses,再写一条机器人消息进 Tracker。这里有个常被误解的点:动作计数是在 action 节点里加的,不是 guard。 guard 只负责读这个数、判断有没有超。
python
"action_count": action_count + 1,4.guard:只做一件事,防止转晕
它做的事情少得可怜:读 action_count 和 max_actions(默认 10),超了就设 is_finished 加一条 error,没超就只往 node_history 里追加一个 "guard"。
python
if action_count >= max_actions:
    return {"is_finished": True, "error": f"达到最大动作数限制: {max_actions}", ...}
为什么非要有这个节点?因为 policy ⇄ action 是循环,而循环的终止条件全靠策略自己保证。策略写错了、Flow 配成环了、两个动作互相触发,都可能转不出来。guard 是最后一道保险,用最笨的办法兜底。它写在 action 之后、policy 之前,位置不能换。放前面就成"执行前检查",那第十一次动作还是会跑;放后面才是"执行完就核账"。
5. response:把攒的东西说出来
汇总 final_responses(可能来自好几个动作),组装成 MessageResponse 交给通道,顺便把 node_history 和 error 带出去。
它不做业务判断,只做打包。这个职责边界很清楚,也意味着"回复说什么"是在 action 阶段就定好的,response 改不了内容。
状态流转
五个节点不通过函数返回值串起来,而是共享一个 MessageProcessingState。字段随流程推进一段段被填上:
| 阶段 | 主要字段 |
|---|---|
| 入口 | input_message、tracker、max_actions |
| understand 后 | current_commands、process_result |
| policy 后 | current_prediction、is_finished |
| action 后 | current_action_result、final_responses、action_count |
| 全程 | node_history、error |
这个设计的好处是每一步都能回放 。node_history 记下访问过的节点顺序,出问题时不用猜,看一眼就知道这轮是 understand → policy → action → guard → policy → response 还是别的路径。 | |
真实场景用例
用户:"我想查订单 12345"
understand生成命令:开始订单查询流程 + 填order_id=12345,process_result.next_action指向流程第一步policy(第一轮,action_count=0)用next_action,预测出"执行查订单动作"action查库,产出"订单 12345 已发货,预计明天到",action_count变成 1guard检查 1 < 10,放行policy(第二轮,action_count=1)不再看next_action,问PolicyEnsemble;FlowPolicy 看栈顶帧,发现流程还没走完,预测下一步- 如果下一步是"等用户确认",预测出
action_listen,is_finished=True response把前面攒的回复打包发出去
node_history 会是:["understand", "policy", "action", "guard", "policy", "response"]。
六步里面有两次 policy。这就是分层图上看不出来、但实际发生的事:同一轮里 policy 会被调用多次,每次都可能换一个决策依据。