引子
先说说我现在的日常。
比如要开发一个新功能,不用打开编辑器,也不用打开项目------在对话里把需求说清楚就行。剩下的是 WorkBuddy 在干活:自己去读代码摸清项目结构,从 release 分支拉一个新分支,写页面、接接口,改完主动跑验收门禁,发现阻断问题就自己修掉、复跑验证,最后给我一份报告------改了哪些文件、怎么验证的。
我干的事只有两件:把 需求 说清楚,和最后拍板合并。修 bug、重构、样式调整,也都是同一个节奏------平常的开发工作,大部分已经是在这样做了。
更"离谱"的是它在持续沉淀:我们协作过的一切都在留下痕迹------聊定的规范、踩过的坑、各项目的业务知识,它都替你归档。对话会结束,但东西都留下了。 随着时间推移,它越来越像我们团队的一员。
半年前不是这样的。那时候我也在用 AI,Copilot 顶着,对话式补全确实提效,但有几个问题越用越难受。这篇文章就聊聊我是怎么从「AI 协同、人主导」走到现在这个模式的,以及这套做法里我认为最有参考价值的三个支柱:自学习、自主验收、多项目协作。
一、Copilot 时代:提效是真的,痛也是真的
那时候的工作模式:左边代码编辑器,右边对话窗口。需求丢给它,改完我再逐个文件看它改了什么,一一验收------代码验收、页面验收都得过一遍,验收成了我的主要工作。过程中有值得沉淀的,就喊它把经验写进指令文件。
日常会同时开好几个会话窗口并行开发。就算这样,测试环境还是会冒出一些奇怪的 bug------AI 改 A 的时候碰坏了 B,这种遗漏光靠人眼验收兜不住。
跨项目更麻烦:别的项目已经踩过的坑、已经有过的经验,我只能靠复制粘贴搬运,多项目之间关联不起来,经验知识也没法融合。
这样干了一段时间,三个问题越来越清楚:
- 沉淀靠人:指令文件是静态的,不会自己生长------聊定的约定、踩的坑,全得我记着更新进去。为什么 AI 不能自主学习?用过一次就多懂一分,多好
- 验收靠人肉兜底:AI 生成代码的速度远超我 review 的速度,验收全压在人身上,还是会漏
- 多项目是孤岛:知识和经验绑死在单项目里,复制粘贴搬运,关联协作、融合都谈不上
这三条,正好对应后面要讲的三个支柱:自学习、自主验收、多项目协作。
二、现在的模式:我们到底有什么
一句话说清分工:WorkBuddy 负责把能力跨项目、跨会话地持续运转起来,ai-harness 负责验收和资产。整体架构三层:
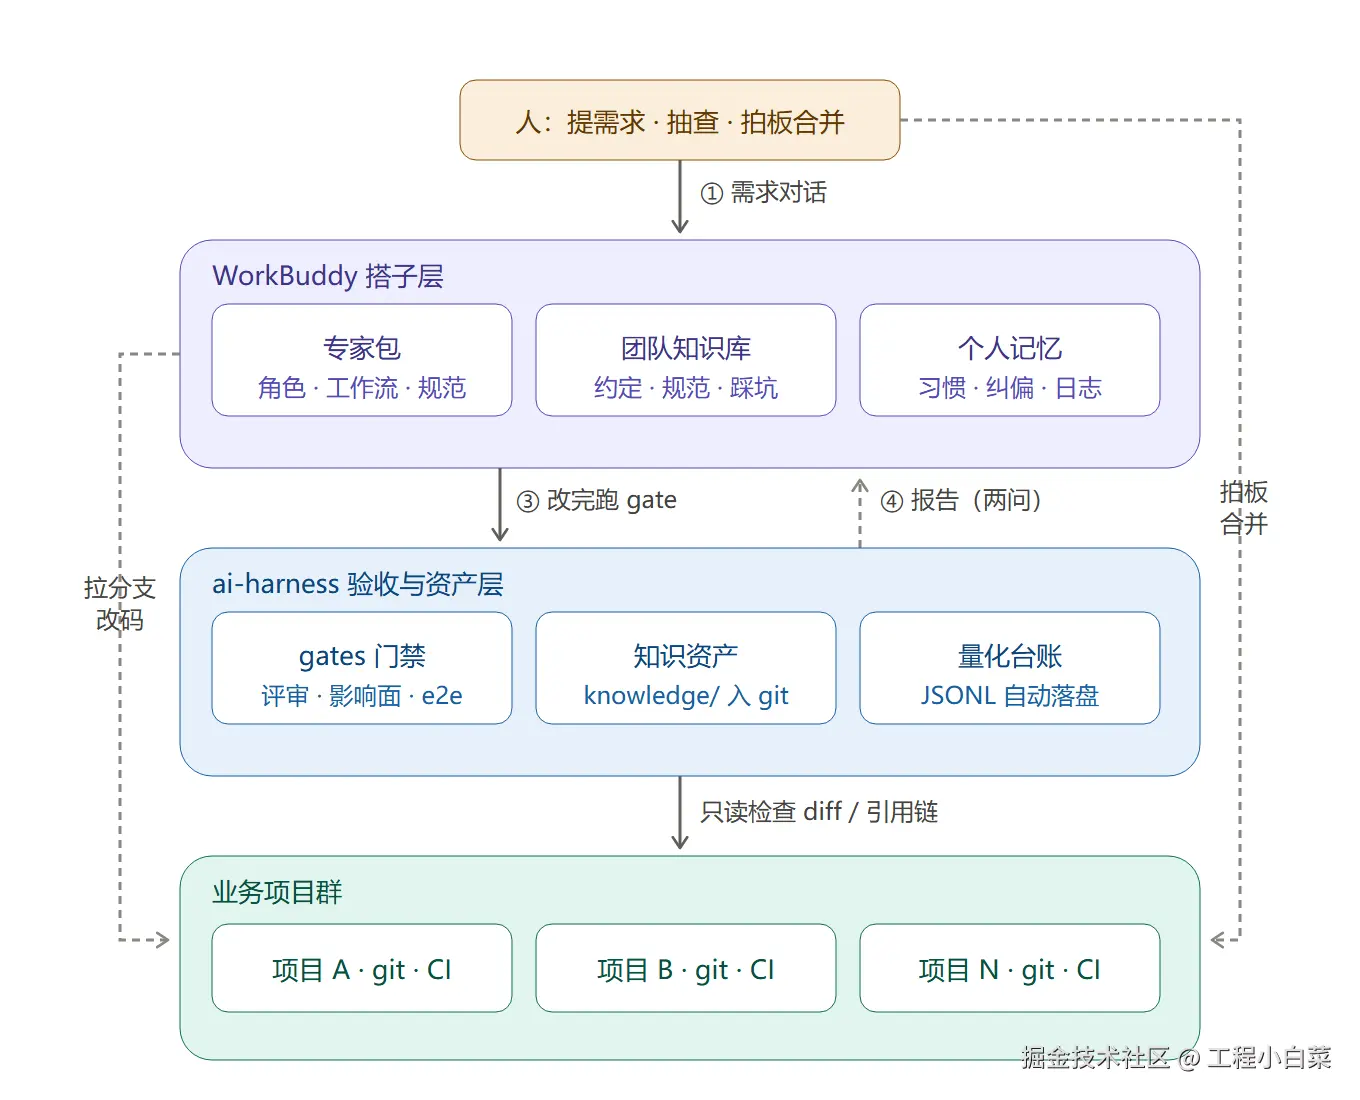
- 业务项目群(底层):多个前端项目,各自有 git 仓库和 CI 流水线
- WorkBuddy 搭子层(日常协作):专家包定义角色与工作流,加载团队知识库和个人记忆------所以换项目不用重新教、换会话不用重新记;日常的读码、改码、分支管理都在这层发生
- ai-harness 验收与资产层:门禁管线、知识资产(入 git)。它不参与日常对话,只对接「改完的代码」
两条关键流向:干活流向 ------需求对话 → WorkBuddy 拉 fix/feat 分支改码 → 改完跑 gate → 报告(怎么验证的)→ 自主验收 → 人抽查、拍板合并;沉淀流向------对话中产生的经验,双写进个人记忆和团队知识库,下次会话直接生效。
这套东西落到文件上,长这样。
ai-harness 仓库------就是一个普通的 git 仓库,一个 Node 工程:
bash
ai-harness/
├── AGENTS.md               # 给 AI 看的仓库说明(入口)
├── knowledge/              # 团队知识库
│   ├── team-conventions.md #   团队拍板的约定:分支、部署、编码规范
│   ├── system-registry.md  #   系统档案:中英文名、端口、生产地址
│   ├── test-env.md         #   测试环境与登录方式
│   └── ...                 #   业务知识、SOP,按需增长
├── gates/                  # 门禁:tsc/build + 红线正则必跑,AI 验收/e2e 按需
├── cases/                  # e2e 用例库,按 项目/页面 组织
├── config/                 # 项目注册与密钥(密钥文件不入 git)
├── report/metrics/         # 门禁台账,JSONL 自动落盘
└── scaffold/               # 新项目脚手架
WorkBuddy 专家包------所谓「专家」,核心就一个 markdown 提示词文件。总体逻辑如下:
角色:你是前端开发搭子,工作区就在项目目录;要动脑判断的活------问题在哪、方案怎么选、页面做成什么样------在对话里和人一起定,不自己拍板;定下来之后的落码交给你
开工第一件事:读取团队约定文档(分支约定、编码规范、门禁口径),以其为最高准则
红线:最容易犯的几条直接写死在提示词里------请求必须集中走公共封装、业务不明确先问人不猜;完整规范在团队知识库,写完还有门禁正则兜底一道
工作流:接需求 → 定位根因 → 实现 → 自验 → 主动跑验收门禁并自己解读报告(阻断问题必修掉复跑,警告逐条判断)→ 汇报(改动清单 + 验证方式 + 验收动作)
整个专家就这一个文件:角色、约定入口、红线、工作流,没有一行代码。
下面按三根支柱逐个拆开讲。
三、支柱一:自学习------让沉淀发生在系统里,而不是我身上
现在的机制是这样的:我和 WorkBuddy 对话中产生的新约定------比如某天拍板「分支前缀按变更类型区分,新功能用 feat/ 修 bug 用 fix/」------它会自动把这条经验蒸馏成两份:
-
个人记忆:记我的习惯、偏好、纠偏。下次会话它记得我喜欢什么样的汇报格式
-
团队知识库:写进 git 管理的约定文档。任何同事、任何 AI 会话开工前先读它
沉淀有四层:
| 层 | 沉淀什么 | 落在哪 |
|---|---|---|
| 经验 | 团队约定、编码规范、踩坑 | knowledge/ 目录,入 git,团队可分发 |
| 项目 | 系统档案(中英文名/端口/地址)、业务知识、可复用测试用例 | knowledge/ + cases/<项目名>/,项目自己的资产 |
| 习惯 | 我的个人偏好、纠正反馈 | WorkBuddy 的长期记忆,跨会话生效 |
| 日志 | 每次门禁运行的耗时/token/拦截记录 | 自动落 JSONL 台账,统计提效时用 |
项目这层的大头是项目档案和业务知识------代码结构、系统端口地址、业务约定等,跟着项目长期维护。项目文档我最终选了「代码生成文档」这条路线:文档从真实代码里长出来,天然不会过期------这也是项目档案能一直跟着项目走的原因。可复用测试用例也在其中:某个页面跑通一次 e2e 自测,验收标准蒸馏进用例库,改版时拼进回归清单接着跑。
最后一层很多人想不到:协作过程本身也在被记录。要做提效汇报的时候,数据是现成的,不用人工填报。
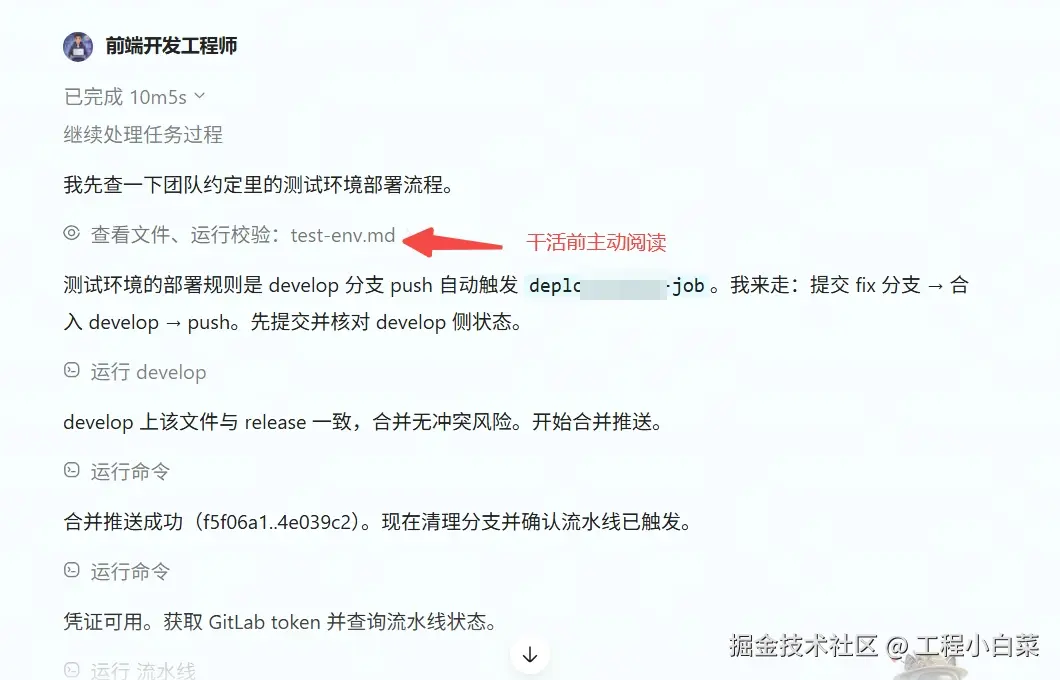
这些沉淀最后长成了一个知识库 :团队约定、编码规范、设计基线、CLAUDE 项目模板、服务器档案、测试环境与登录配方......20+ 篇文档,入 git。干活前它会自己找到对应的那几篇读一遍------下图就是它接了个部署任务,开工前先去查测试环境的部署流程。这本来就是我的目的之一:把自己蒸馏------把我脑子里的经验,变成任何同事、任何 AI 会话开工前自动加载的公共资产。
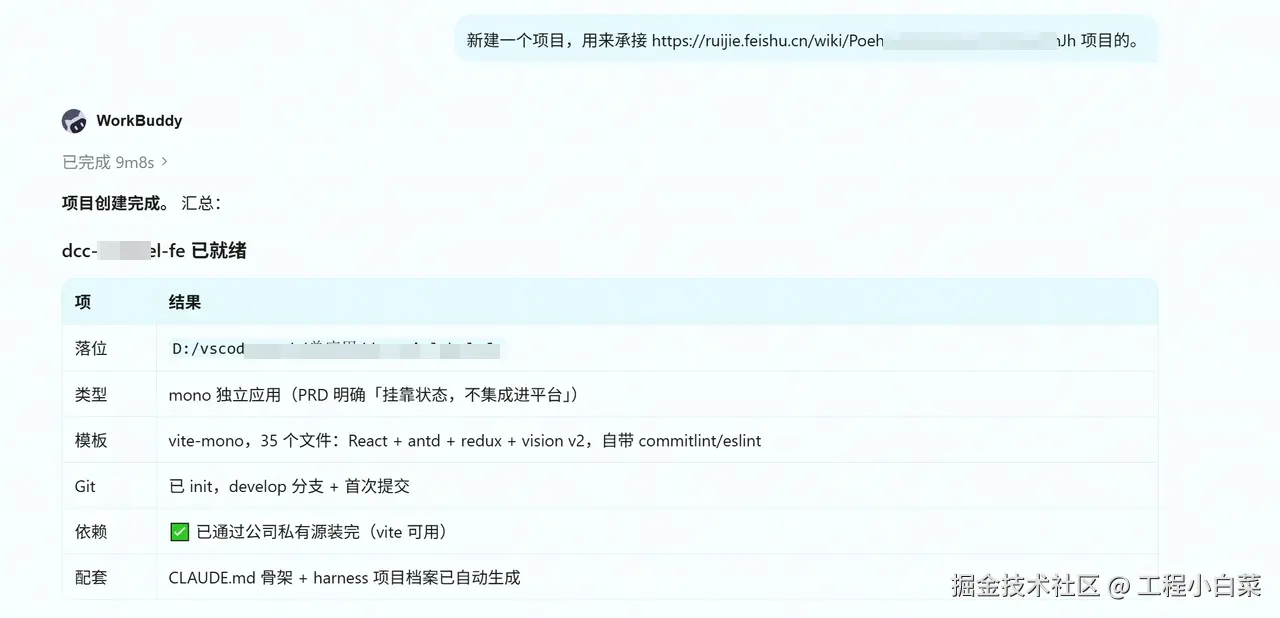
沉淀的知识不只被遵守,还会被拿去干活。举个例子:现在新建一个项目,AI 会按团队规则自动选择项目模板,并完成模板渲染、目录归类、Git 初始化、GitLab 远程建仓,连 CLAUDE.md 都按项目类型生成好骨架------项目自己的知识有了归处,团队公共约定通过引用接上公共知识库,新项目出生即接入这套体系,不用从零搭。
不过看到这里肯定有人想问:AI 直接建 GitLab 仓库,权限是不是给太大了?
它的权限是刻意收窄的。GitLab 这边:AI 用的是我的开发者账号,推 fix/feat 分支、建仓都在权限内;但推 develop 这种会触发部署的分支,需要我在对话里明确授权;合并主干的按钮,永远在人手里。API 操作用的 token 只存在本地不入 git 的配置文件里,不进仓库、不进文档。页面这边:它只拿得到测试环境的地址和账号密码,生产环境它没有账号、没有入口------想越权也没有门。
AI 的自主不是放出来的,是权限框出来的。 它能做什么,取决于我们给了什么权限------把边界画清楚,自主才敢给。
四、支柱二:自主验收------运动员/裁判分离
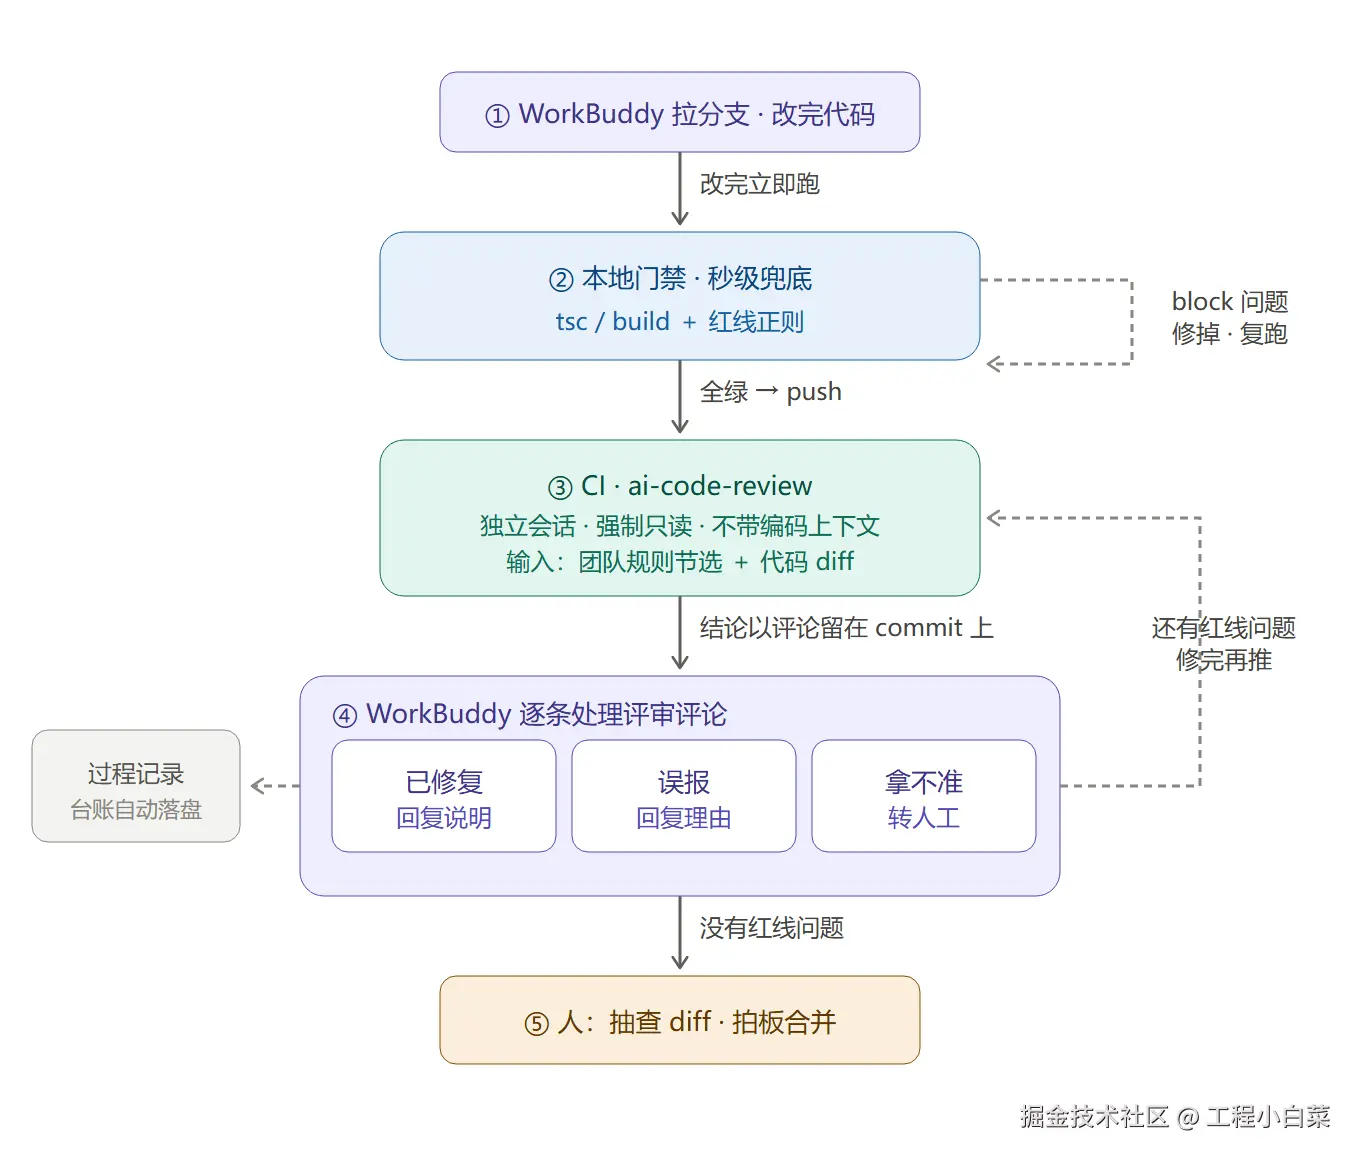
AI 生成的质量验收,是一直让我头疼的点:AI 生成速度很快、需求也越来越多,怎么减少 AI 犯错的流出,就显得格外重要。所以我引入了 AI 代码评审------该评审借鉴了运动员/裁判分离的原则,拿着团队规则和代码 diff 独立做代码审查,写代码的 AI 自己说了不算。
具体是这么运转的。评审 AI 是全新的独立会话,不带编码会话的任何上下文,权限强制只读,只能拿到团队规则节选和代码 diff------分离是代码保证的,不是口头约定。跑的位置按成本分层:本地只留秒级兜底(tsc/build + 红线正则,改完立即跑,block 问题当场修掉复跑);LLM 语义评审不跟着每次本地改动跑------不是每次改动都值得烧一次 LLM,它被嵌进 CI,push 后 ai-code-review 自动触发,结论以评论的形式留在 commit 上。
评审结论回到 WorkBuddy 手里,它逐条处理:能修的修掉并回复「已修复」,是误报的给出理由,拿不准的转人工------一轮轮调整,直到没有红线问题,全程都有记录。
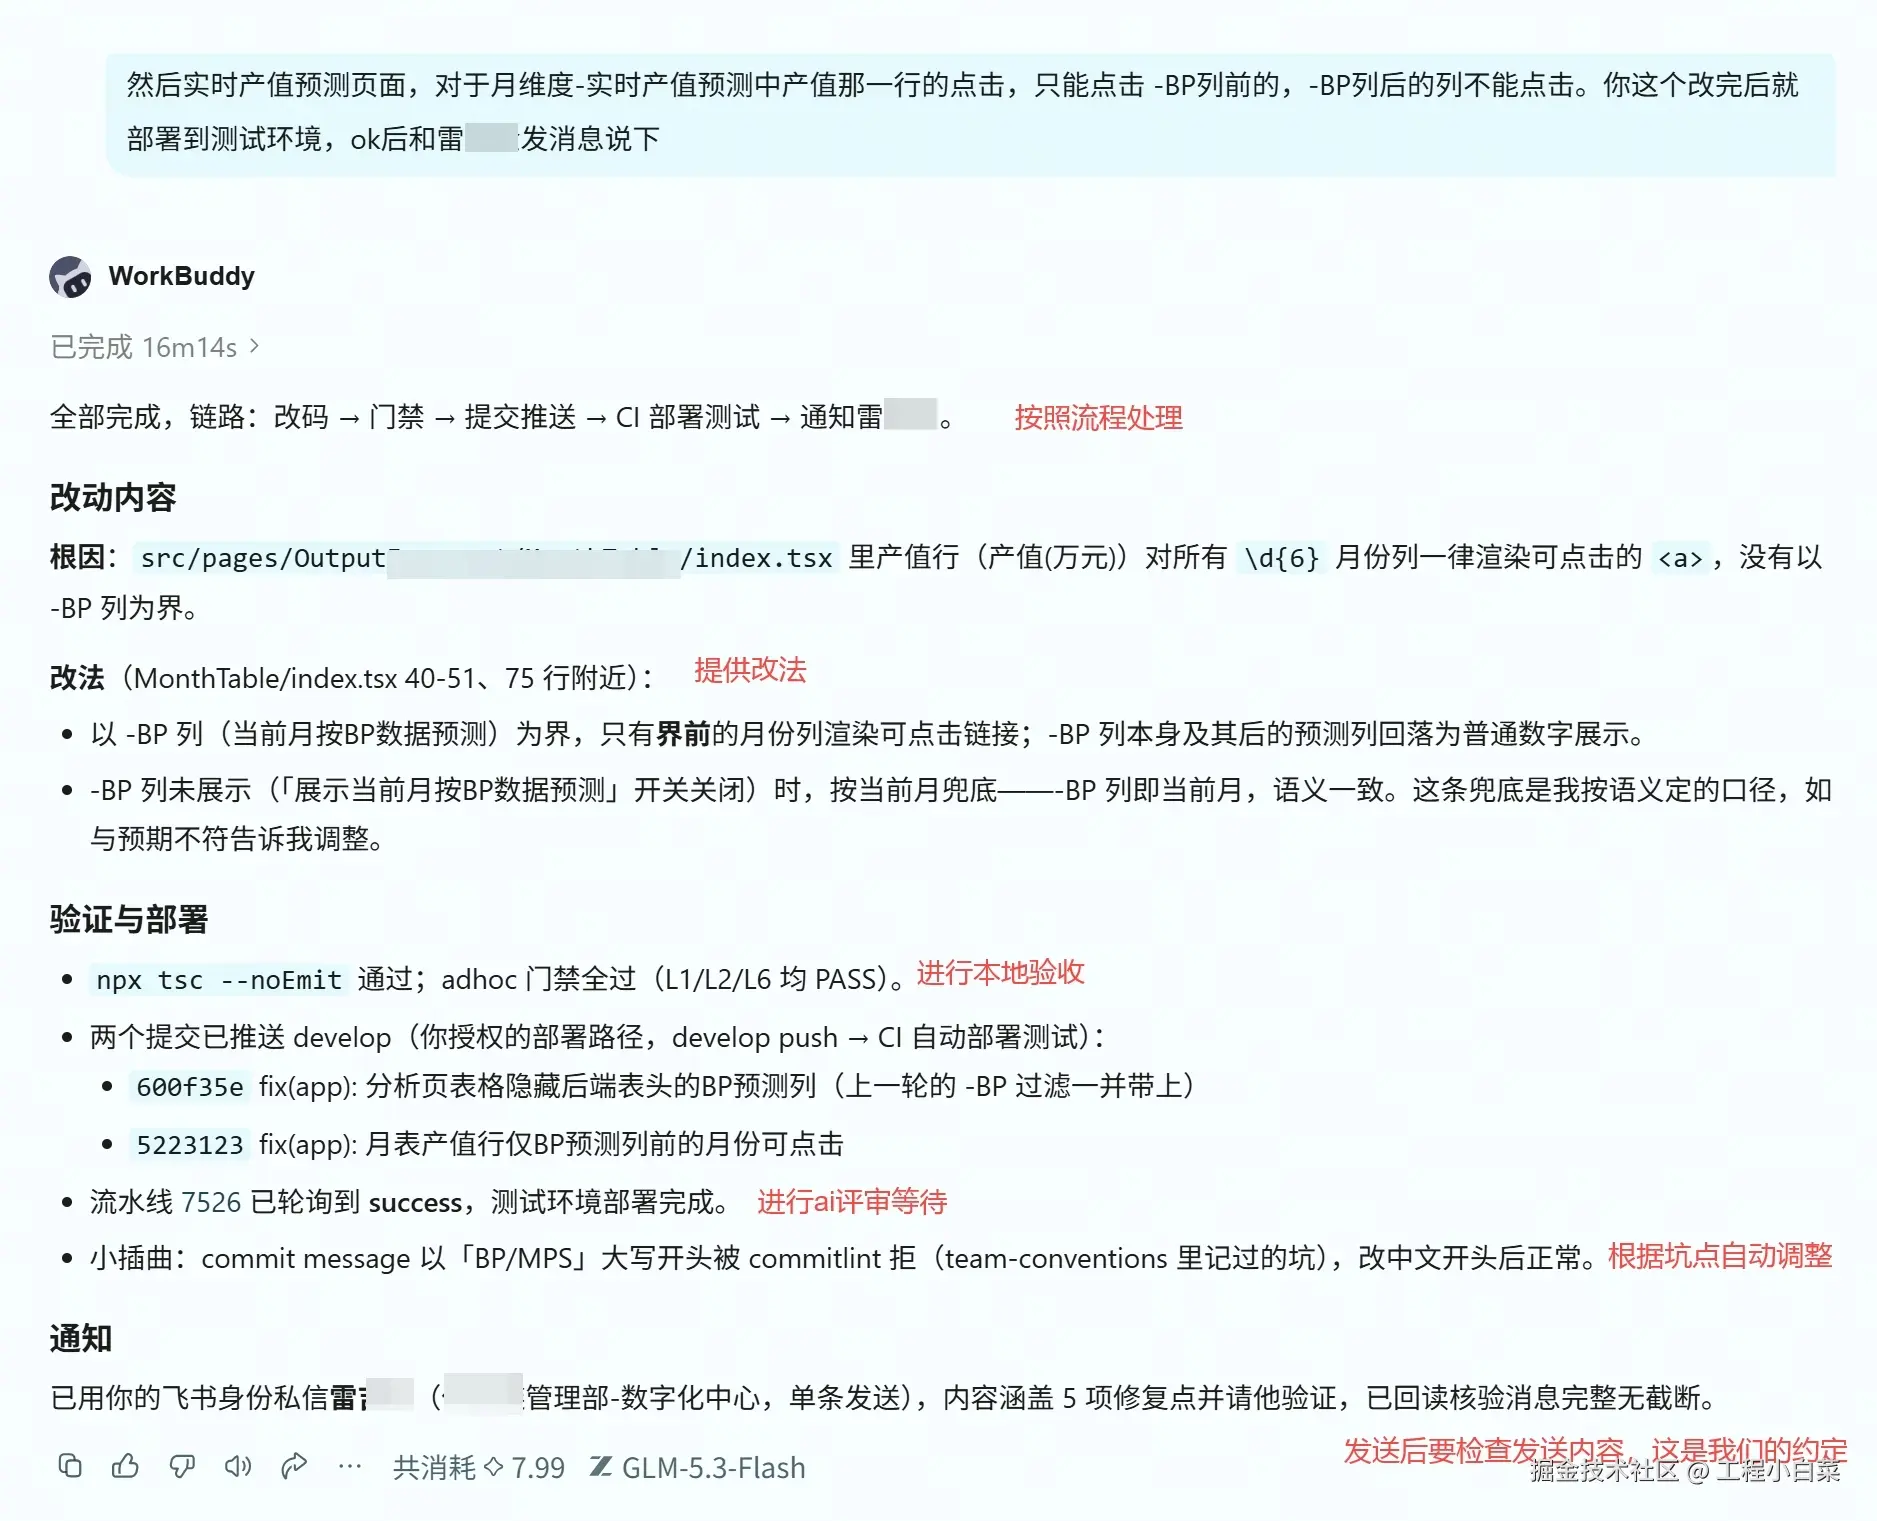
看一次真实运行的收尾汇报------需求一句话丢进来,WorkBuddy 自己定位根因、改码、跑本地门禁(tsc + 红线全过)、推送触发 CI 部署测试环境,最后把根因、改法、验证结果、部署状态一次性交代清楚;发给同事的通知,发完还要回读核验一遍,确认内容完整无截断。
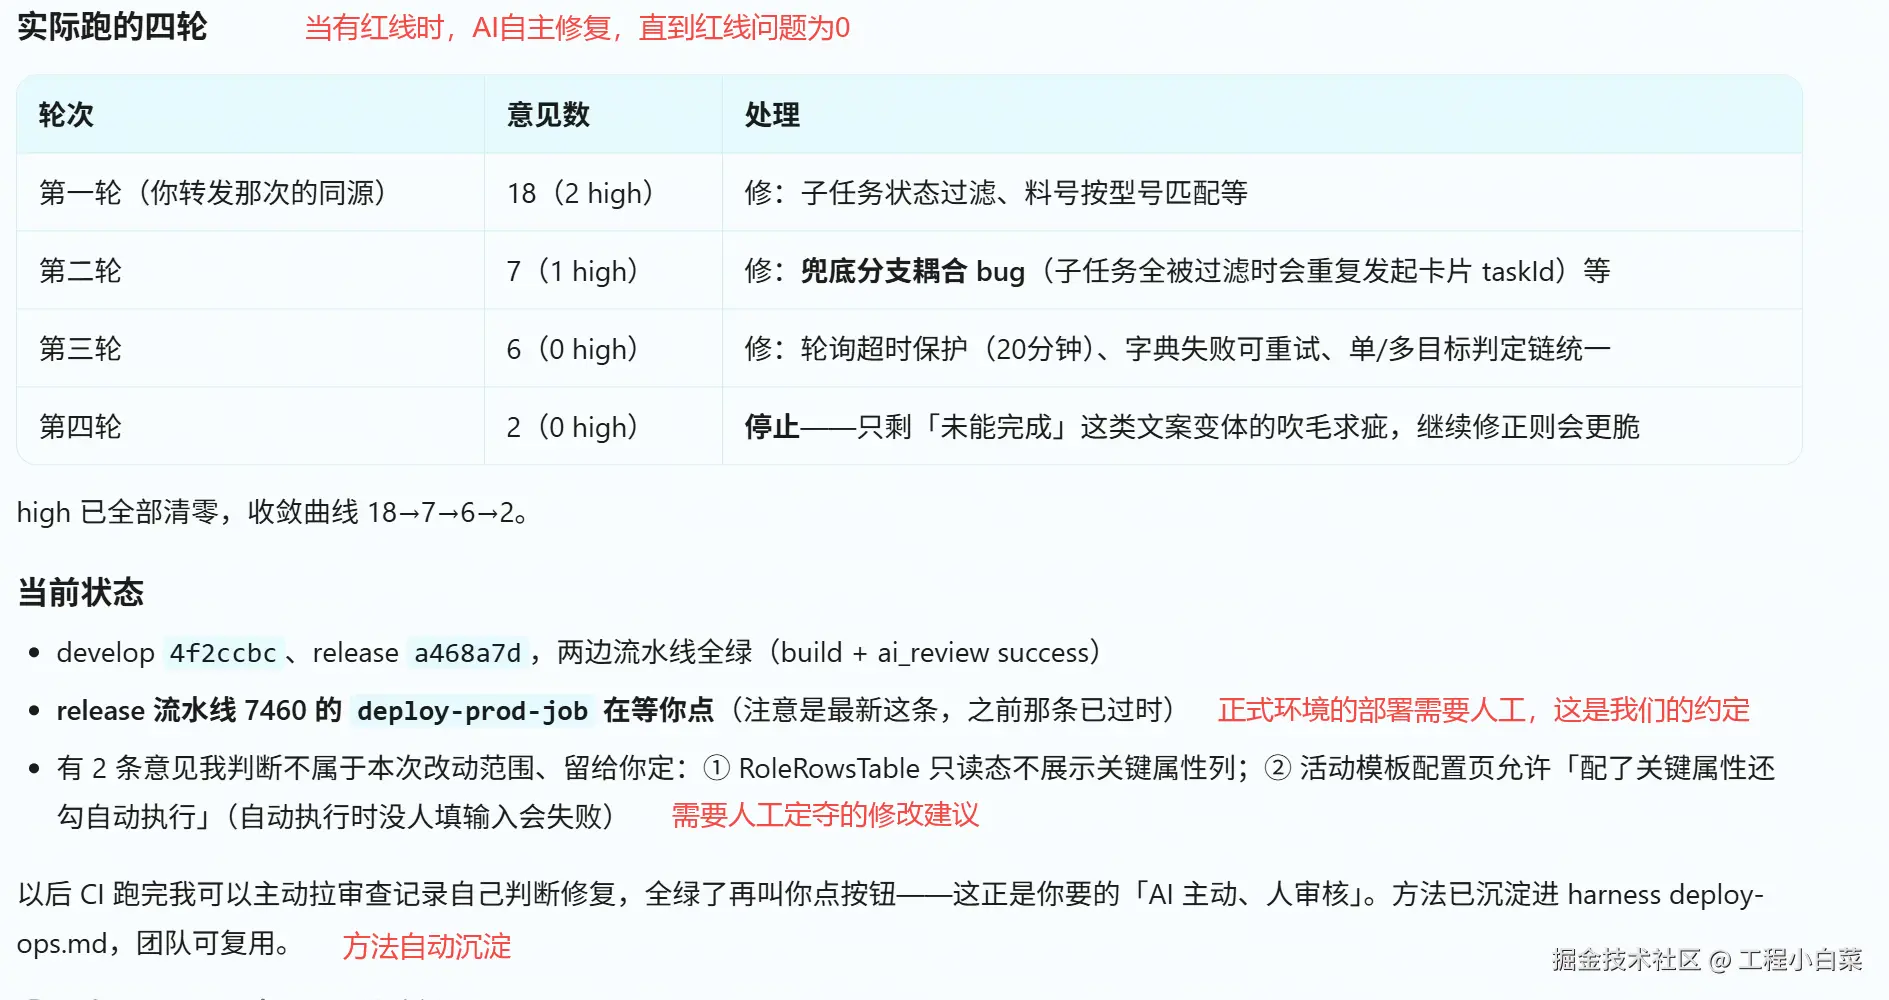
再看 CI 评审的多轮收敛实录:第一轮 18 条意见(2 条 high),AI 逐条处理------能修的修掉,不属本次改动范围的转人工留给我定夺;四轮下来 18→7→6→2,high 清零,到只剩文案变体级的吹毛求疵时主动停止,不为修而修。全程有记录,正式环境的部署按钮始终留给人。
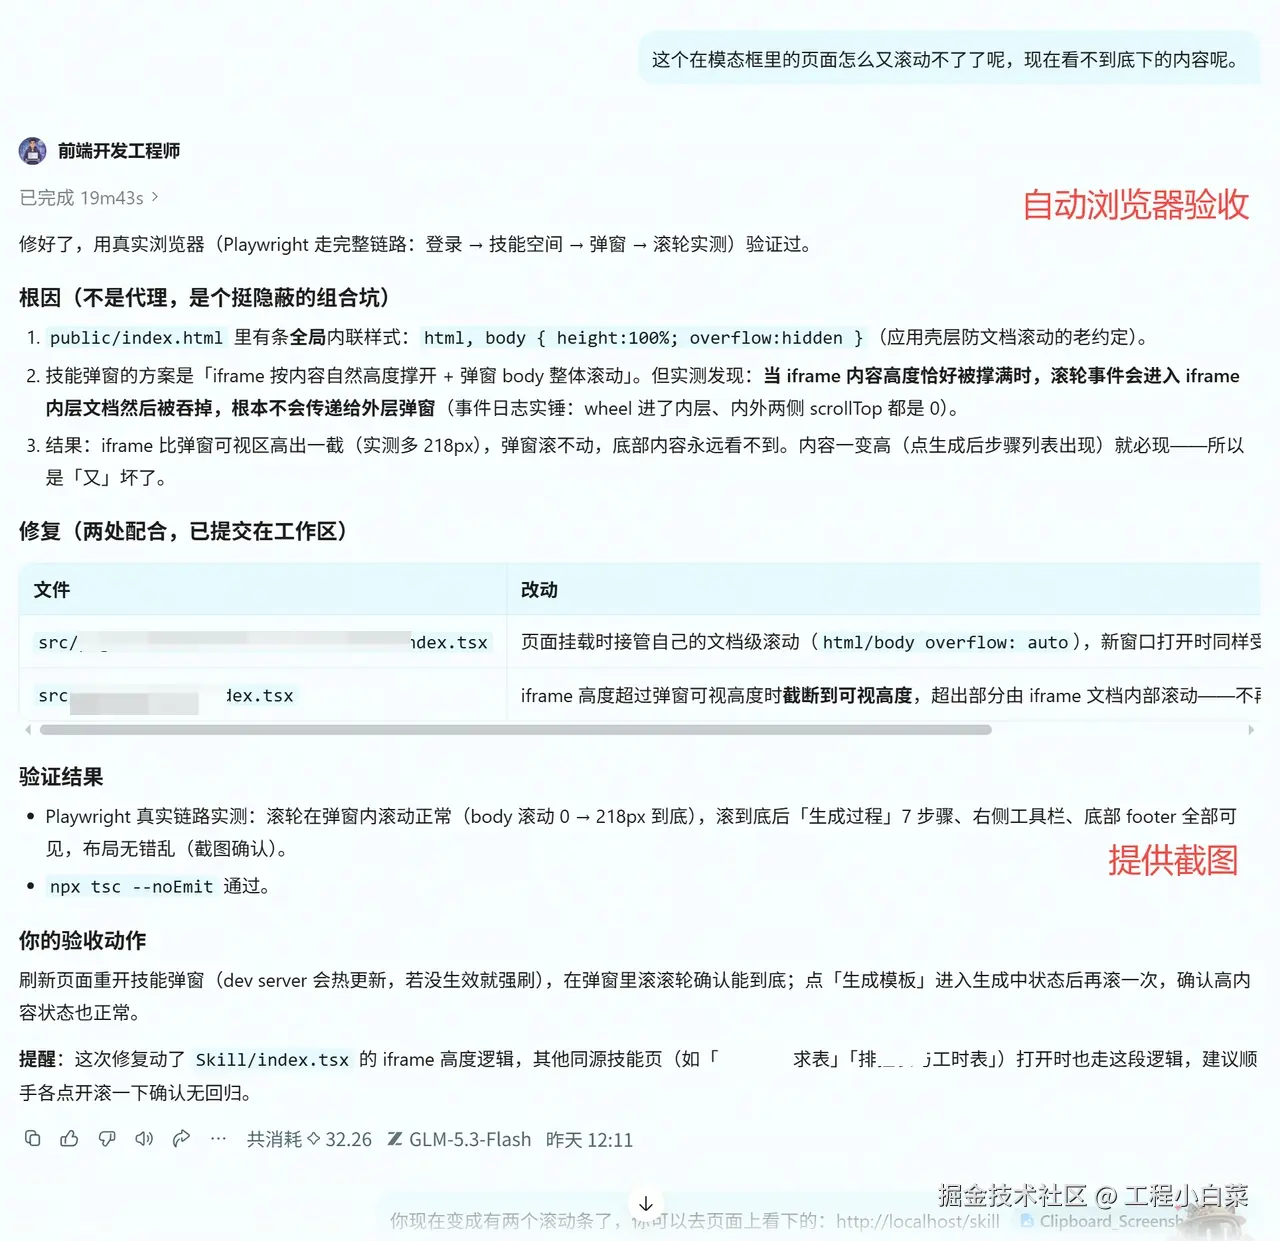
修 bug 也不止是修:改完不报完事,挂真实浏览器把完整链路实测一遍(登录 → 进页面 → 开弹窗 → 滚动),并提供验收截图
五、支柱三:多项目------从「一个项目的配置」到「团队的能力」
前两个支柱解决质量和沉淀,这个支柱解决规模------这也是我从 Copilot 切过来的最大原因。
现在的模式是:一个 AI 搭子 + 一个团队知识库,服务我手头所有项目。几个关键设计:
-
项目自动发现 :工作区目录下包含
.git和package.json的项目自动可用,不用每个项目去注册、配置 -
公共知识单一事实源:微前端机制、请求层约定、组件库用法这些跨项目通用的知识,只在团队知识库维护一份,每个项目保证都是最新的知识源
-
约定带着历史,不会变成隐蔽知识:知识库记的不只是「现在用什么」,还有「什么时候变的、为什么变」------比如内网某域名废弃,约定里写明旧地址、替代地址和拍板时间,WorkBuddy 在任何项目里看到旧地址都知道该替换、替换成什么。这类变化如果只留在聊天记录和人脑里,半年后就成了只有当事人知道的隐蔽知识;沉淀这个动作,就是把它们全部公开化
体感上的变化:以前是「我在项目 A 里有一个调教好的 AI」,现在是「我有一个懂所有项目的 AI」。前者是配置,后者是能力。
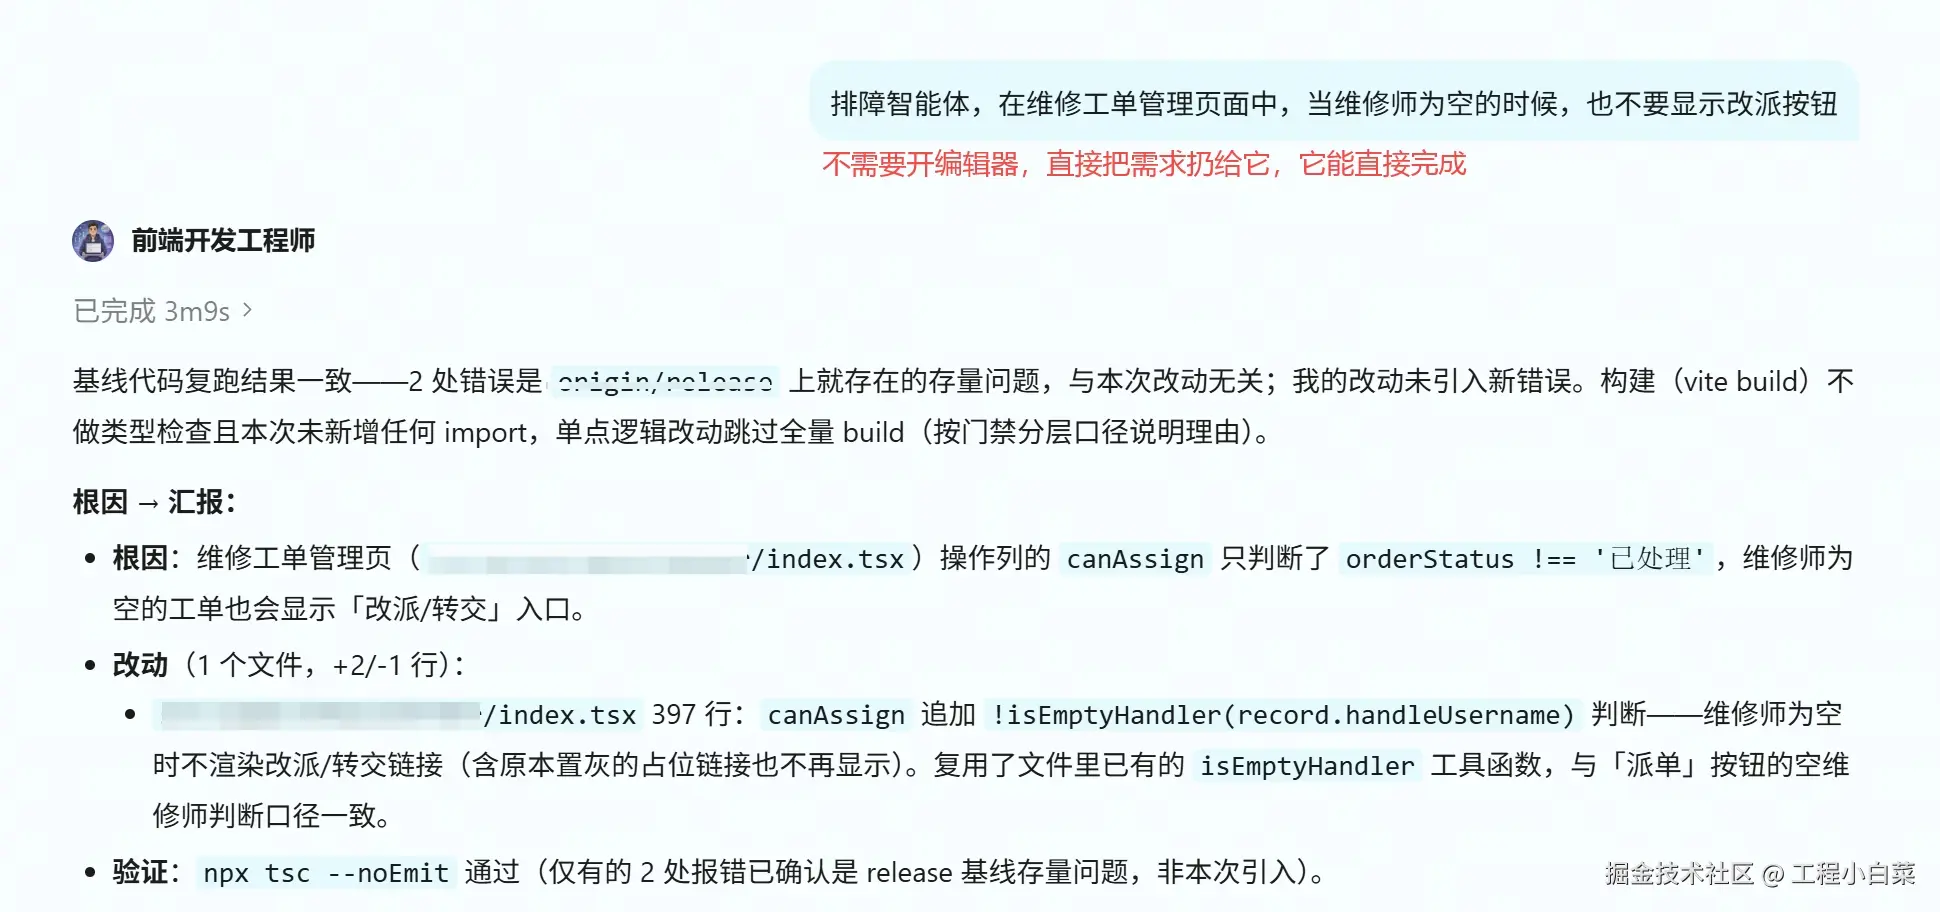
换个项目,还是同一个节奏:维修工单管理页面,「维修师傅为空时不要显示改派按钮」------不开编辑器,需求一句话丢进对话,3 分钟改完:自己定位到具体行,复用文件里已有的工具函数。这就是项目自动发现的体感:换项目不用教,直接开工。
六、总结:现在的完整工作流
- 我把现象丢给搭子,它读代码定位到具体文件和行号;业务规则有歧义会先来问我,不猜
- 确认后它从 release 分支拉新分支实现,遵循团队规范
- 改完主动跑验收门禁------不用我提醒,这是约定好的闭环:block 必修掉并复跑,warn 逐条判断,不改的要写明理由
- 报告出来:改动清单、验证方式。全过它才来找我
- 我抽查 diff,点合并。生产发布的权限始终在人
要动脑的活在对话里定,落码交给 AI,验收交给独立裁判,合并权握在人手里------这就是我们现在的全部工作流。
这套流程也跑了有一阵了:到现在已经用它完整开发过至少五个项目,日常小需求根本不用我自己操刀。有同事开玩笑说,以后干脆开个数字人,把需求直接扔给他------是不是就能越过我了 hh。(放心,合并按钮还在我手里。)
这篇只讲了骨架,还有几个点每个都够单独成文,后面会陆续写:
- AI 现场自测:验收不止看 diff------AI 会挂真实浏览器按验收标准逐条操作核对并截图,跑通的用例沉淀进用例库,改版时直接拼进回归清单复用
- ai-code-review 实现:评审 AI 怎么做到独立、结论怎么回到 WorkBuddy 手里形成修复闭环
- 量化闭环:门禁只要跑过,数据就自动存档------耗时、token、拦截记录全部落盘,提效数据有据可查
- 给 AI 立行为规矩:大任务必须先出「拆解方案 + 成本预估」才能动手------约束的不是代码,是 AI 的行为模式
这套流程也还在演进,它不是一个"完成品",更像一个持续生长的过程------而生长本身,靠的正是支柱一的自学习。
写在最后
回到开头那个反差:为什么我愿意把平常的开发都交给它?
这个问题的答案,前面的支柱里都写了。但写这篇文章的过程中,我对趋势的判断也越来越清晰:AI 的应用正在从单个项目 ,走向单个人 ,再走向团队------从帮某个项目写代码的工具,到跨项目、跨会话持续工作的搭子,再到团队模式的智能体、智能体和智能体之间的协作。这些形态已经在发生。
但不管形态怎么变,有一条不会变:头脑里的经验、聊天记录里的约定、团队里口口相传的规范,都得完成「转化为数据」这一步,AI 才接得住。这篇的三个支柱其实就是在做这件事:自学习沉淀经验,自主验收沉淀质量标准,多项目把沉淀下来的能力规模化。
所以我越来越确信一件事:AI 提效的瓶颈从来不是生成能力,而是沉淀、验收和规模化的能力。生成能力各家都差不多,差的是围绕它建立的工程体系。等 AI 走到「团队核心」那一步,比拼的还是同一件事------谁的团队知识先完成数据化,谁的 AI 就先成为真正的团队成员。
最后回到那个数字人玩笑------短期内还越不过我:接下来的主旋律大概率仍然是人机协同 。而协同里人的角色很明确------为 AI 的结果负责:AI 能干活,但担不了责,出了问题最后落在人头上。所以验收不是可有可无的流程,是人担责之前必过的关口。
有问题欢迎评论区交流。