先介绍下这次的主角。 SoduWork 的品类定义是「企业级 AI 原生引擎」,它是一个开源的企业 AI 协作工作台: 人和 AI 在同一个需求池里接活、交接、验收------对话里派活,AI 在你指定的工作区里直接读写文件、跑命令,产出和过程留在工作目录里可查可验收;团队还能把做事方法沉淀成有版本、可审查、可分发的插件。MIT 协议,客户端、服务端、管理端完整开源,模型底座自己配------我这次接的就是自备的 Aiping 接口(OpenAI 兼容)+ GLM-5.3-Flash,没被绑死在任何一家模型上。
官网首页,开源、可自部署、模型底座自备是它反复强调的几个词:
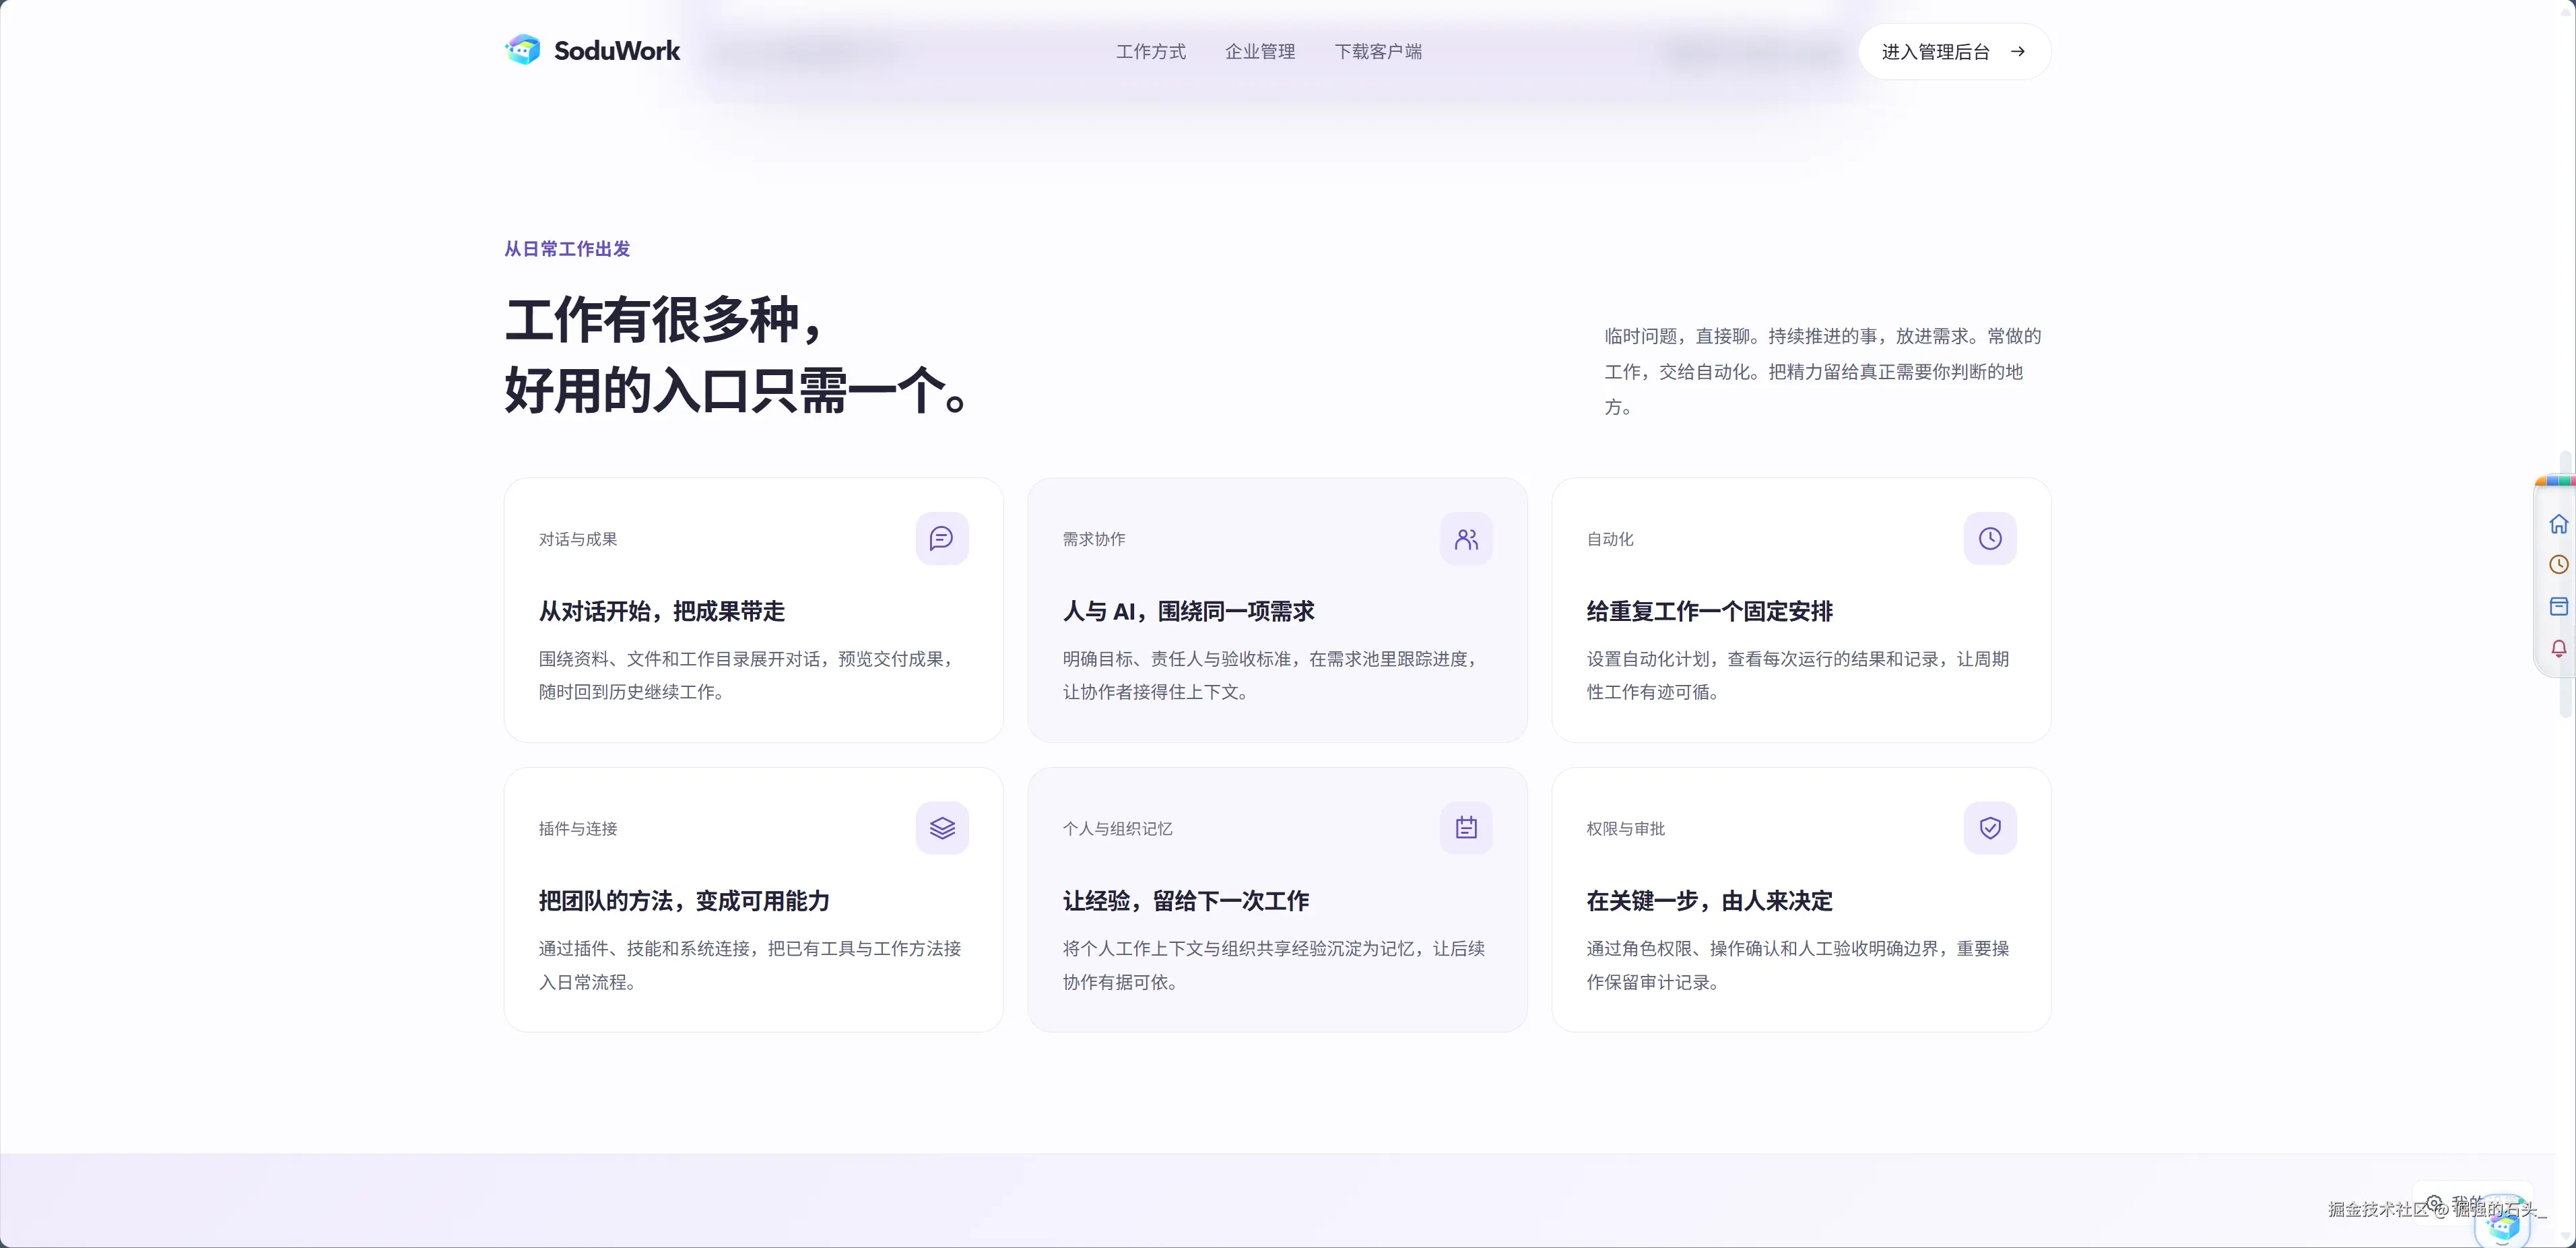
官网列出的六大能力里,我这次实测主要用到的是"对话与成果""插件与连接"和"权限与审批"三块:
我把仓库 Fork 了一份、顺手点了个 Star,全部实测都在自己的 Windows 笔记本上完成:
一、结论摘要
先说结论:这次实测验证了我最关心的一件事------一个老员工脑子里的排坑经验,能不能变成团队里人人可用的资产,而不是散落在聊天记录里的一次性技巧。
我用开源企业 AI 协作工作台 SoduWork 做了一个对照实验:同一份季度考勤复核任务,让三个"角色"分别完成------
| 指标 | ① 新人(一句话) | ② 老员工(630 字完整叮嘱) | ③ 新人 + 老员工经验插件(一句话) |
|---|---|---|---|
| 提示词长度 | 约 35 字 | 约 630 字 | 约 50 字 |
| 初筛标出缺勤超标员工 | 8 人 ✓ | 8 人 ✓ | 8 人 ✓ |
| 通知信数量 | 3 封 ✗(官方标准答案为 1 封) | 1 封 ✓ | 1 封 ✓ |
| 关键员工调整后缺勤数 | 0 ✗(标准答案为 2) | 2 ✓ | 2 ✓ |
| 用时 | 未记录(见文内说明) | 12 分 05 秒 | 8 分 51 秒 |
| 过程留痕 | 自建脚本,无统一底稿 | 40 项独立校验 | 三道关卡全过 + 工作底稿 + 参数出处表 |
一句话总结:老员工写 630 字叮嘱才能做对的活,新人用一句话加上一个插件就做到了,而且更快,每一步都有据可查。
这个结果不是我编的理想剧本,三个组的完整输出文件、计算明细 JSON 都还在我的测试目录里。下面从头讲怎么做到的。
这篇文章适合谁看:想给团队搭"AI 干活、人验收"流程的团队负责人;被"每个人的 AI 用法都没法交接"困扰过的管理者;以及想把自己积累的工作方法变成可复用资产的个人用户。如果你只想找个聊天机器人,这篇文章帮不到你。
二、评测环境与任务
环境说明(写清才能复现):
- 设备与系统:Windows 11 笔记本
- 部署方式:本地安装(客户端 + 服务端 + 管理端一体,
start.cmd一键拉起,服务跑在127.0.0.1:18989) - 模型:通过 Aiping(OpenAI 兼容接口)接入 GLM-5.3-Flash,配置为公司级模型服务,客户端显示"当前使用公司凭据/公司统一额度"
- 测试时间:2026 年 11 月 13 日
- 实测任务:季度考勤复核(源自公开评测集 JobBench 的行政助理任务,任务要求把每日考勤记录与已批准请假记录逐日对照,处理 FMLA 保护、追认批准、两张工作表数据矛盾等陷阱,产出汇总报告、通知信、核对表三份交付物。数据集来源:HuggingFace
JobBench/job-bench,MIT 许可)
事实分层说明:SoduWork 的产品介绍(多底座接入、方法型/流程型插件、人在验收等)来自官方资料;本文所有分数、用时、对错判定均为我本人实测;评测集数据来自上述公开数据集,官方案例说明中的参考成绩(如"74.6 分/183 秒")为项目方口径,仅作背景引用,本文表格里的数字全部是我的实测口径------我没用统一评分器打分,而是把每组的关键判定(发信名单、每人调整后缺勤数)与评测集自带的标准答案逐一核对。
三、安装与配置:两次网络坑,一句话带过
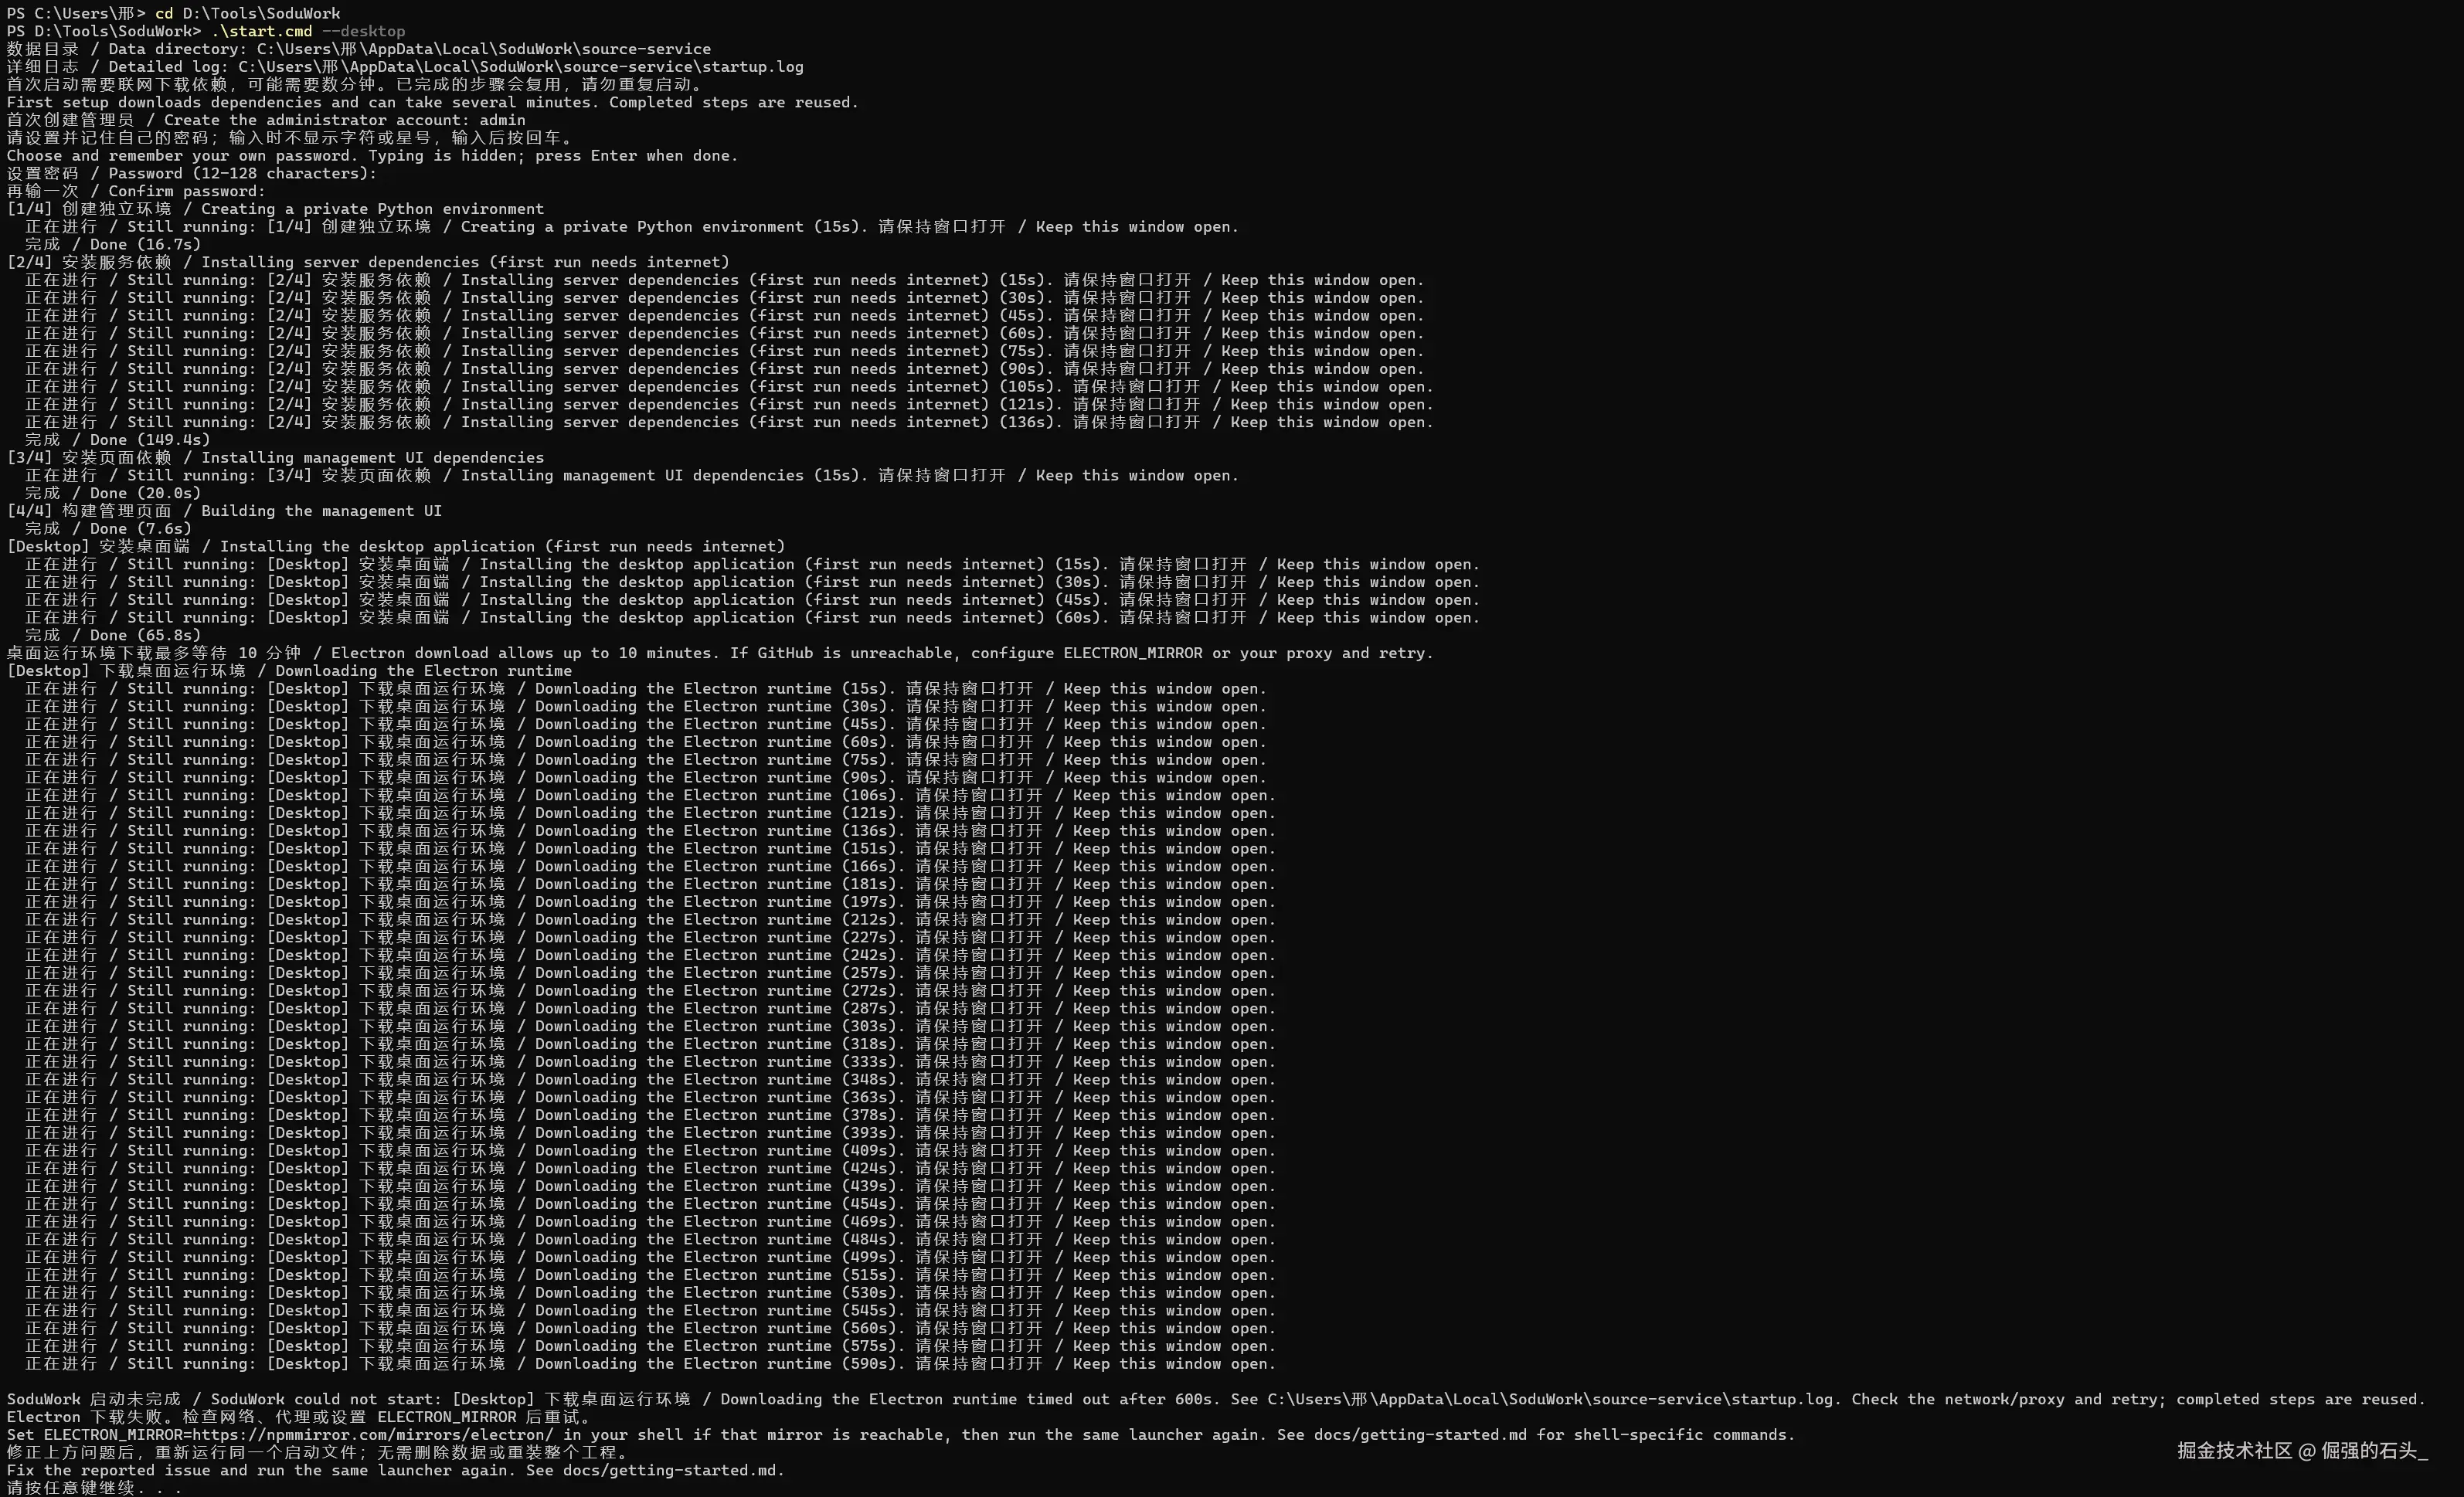
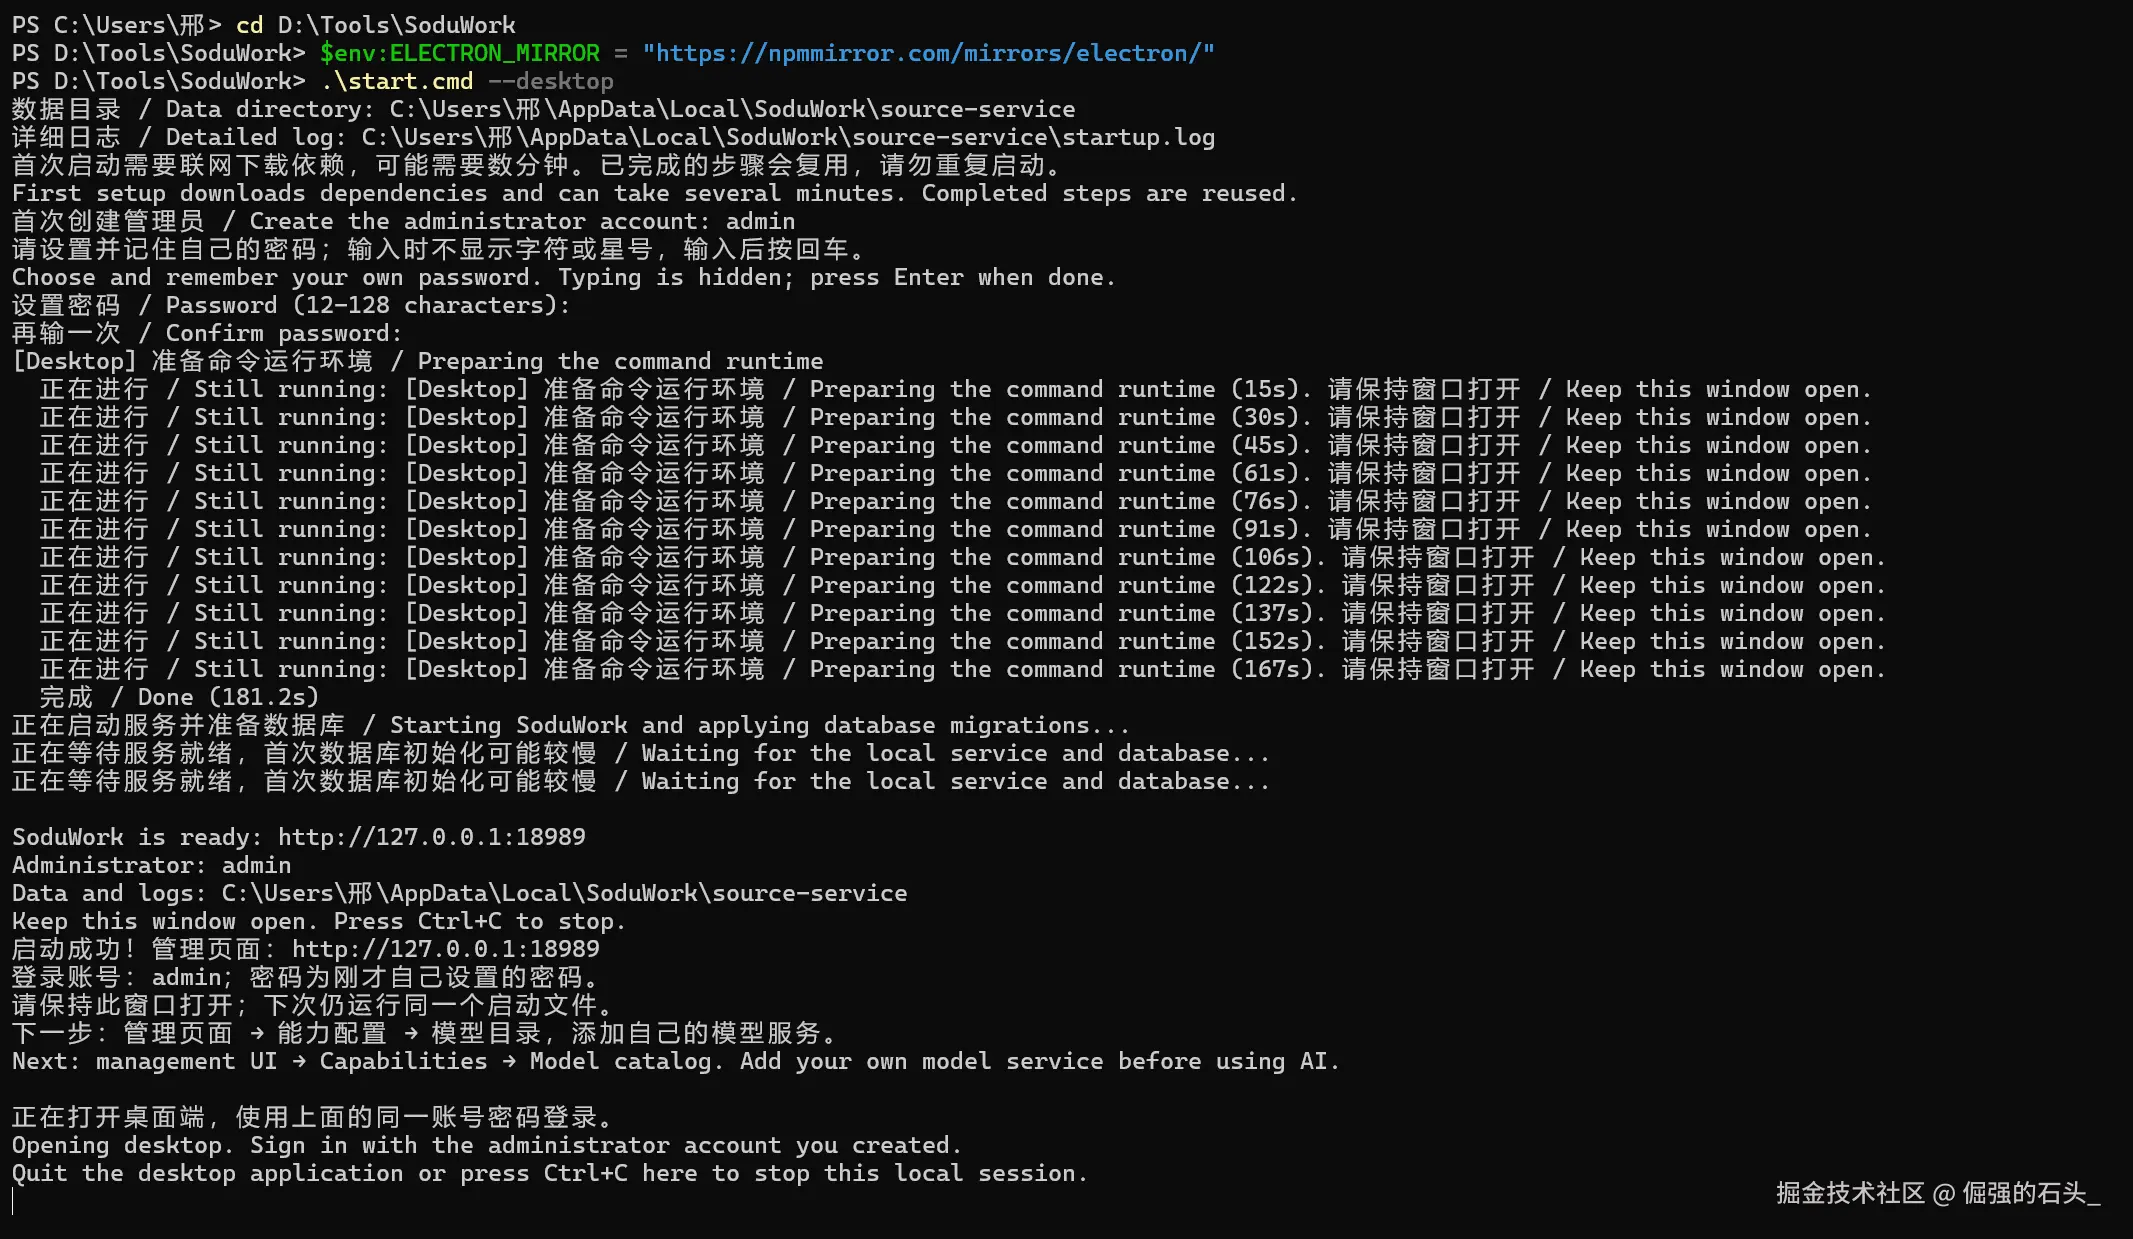
安装整体是"双击 start.cmd → 设管理员密码 → 等运行时就绪"。国内网络环境下我在两个下载步骤上卡过:Electron 运行时下载超时(设镜像环境变量后 22 秒解决),PortableGit 下载缓慢(用加速前缀预下载到缓存目录、校验 SHA-256 通过后重跑即跳过)。都是网络问题,不展开。下面按实际操作顺序过一遍。
第一次跑 start.cmd,卡住的就是这一幕------Electron 运行时下载超时。设好镜像环境变量重跑即可,不用改任何代码:
网络过了之后,启动脚本一路跑完,控制台把三个入口的地址都打了出来:本地 Hub 服务、浏览器管理后台、桌面客户端:
打开桌面客户端
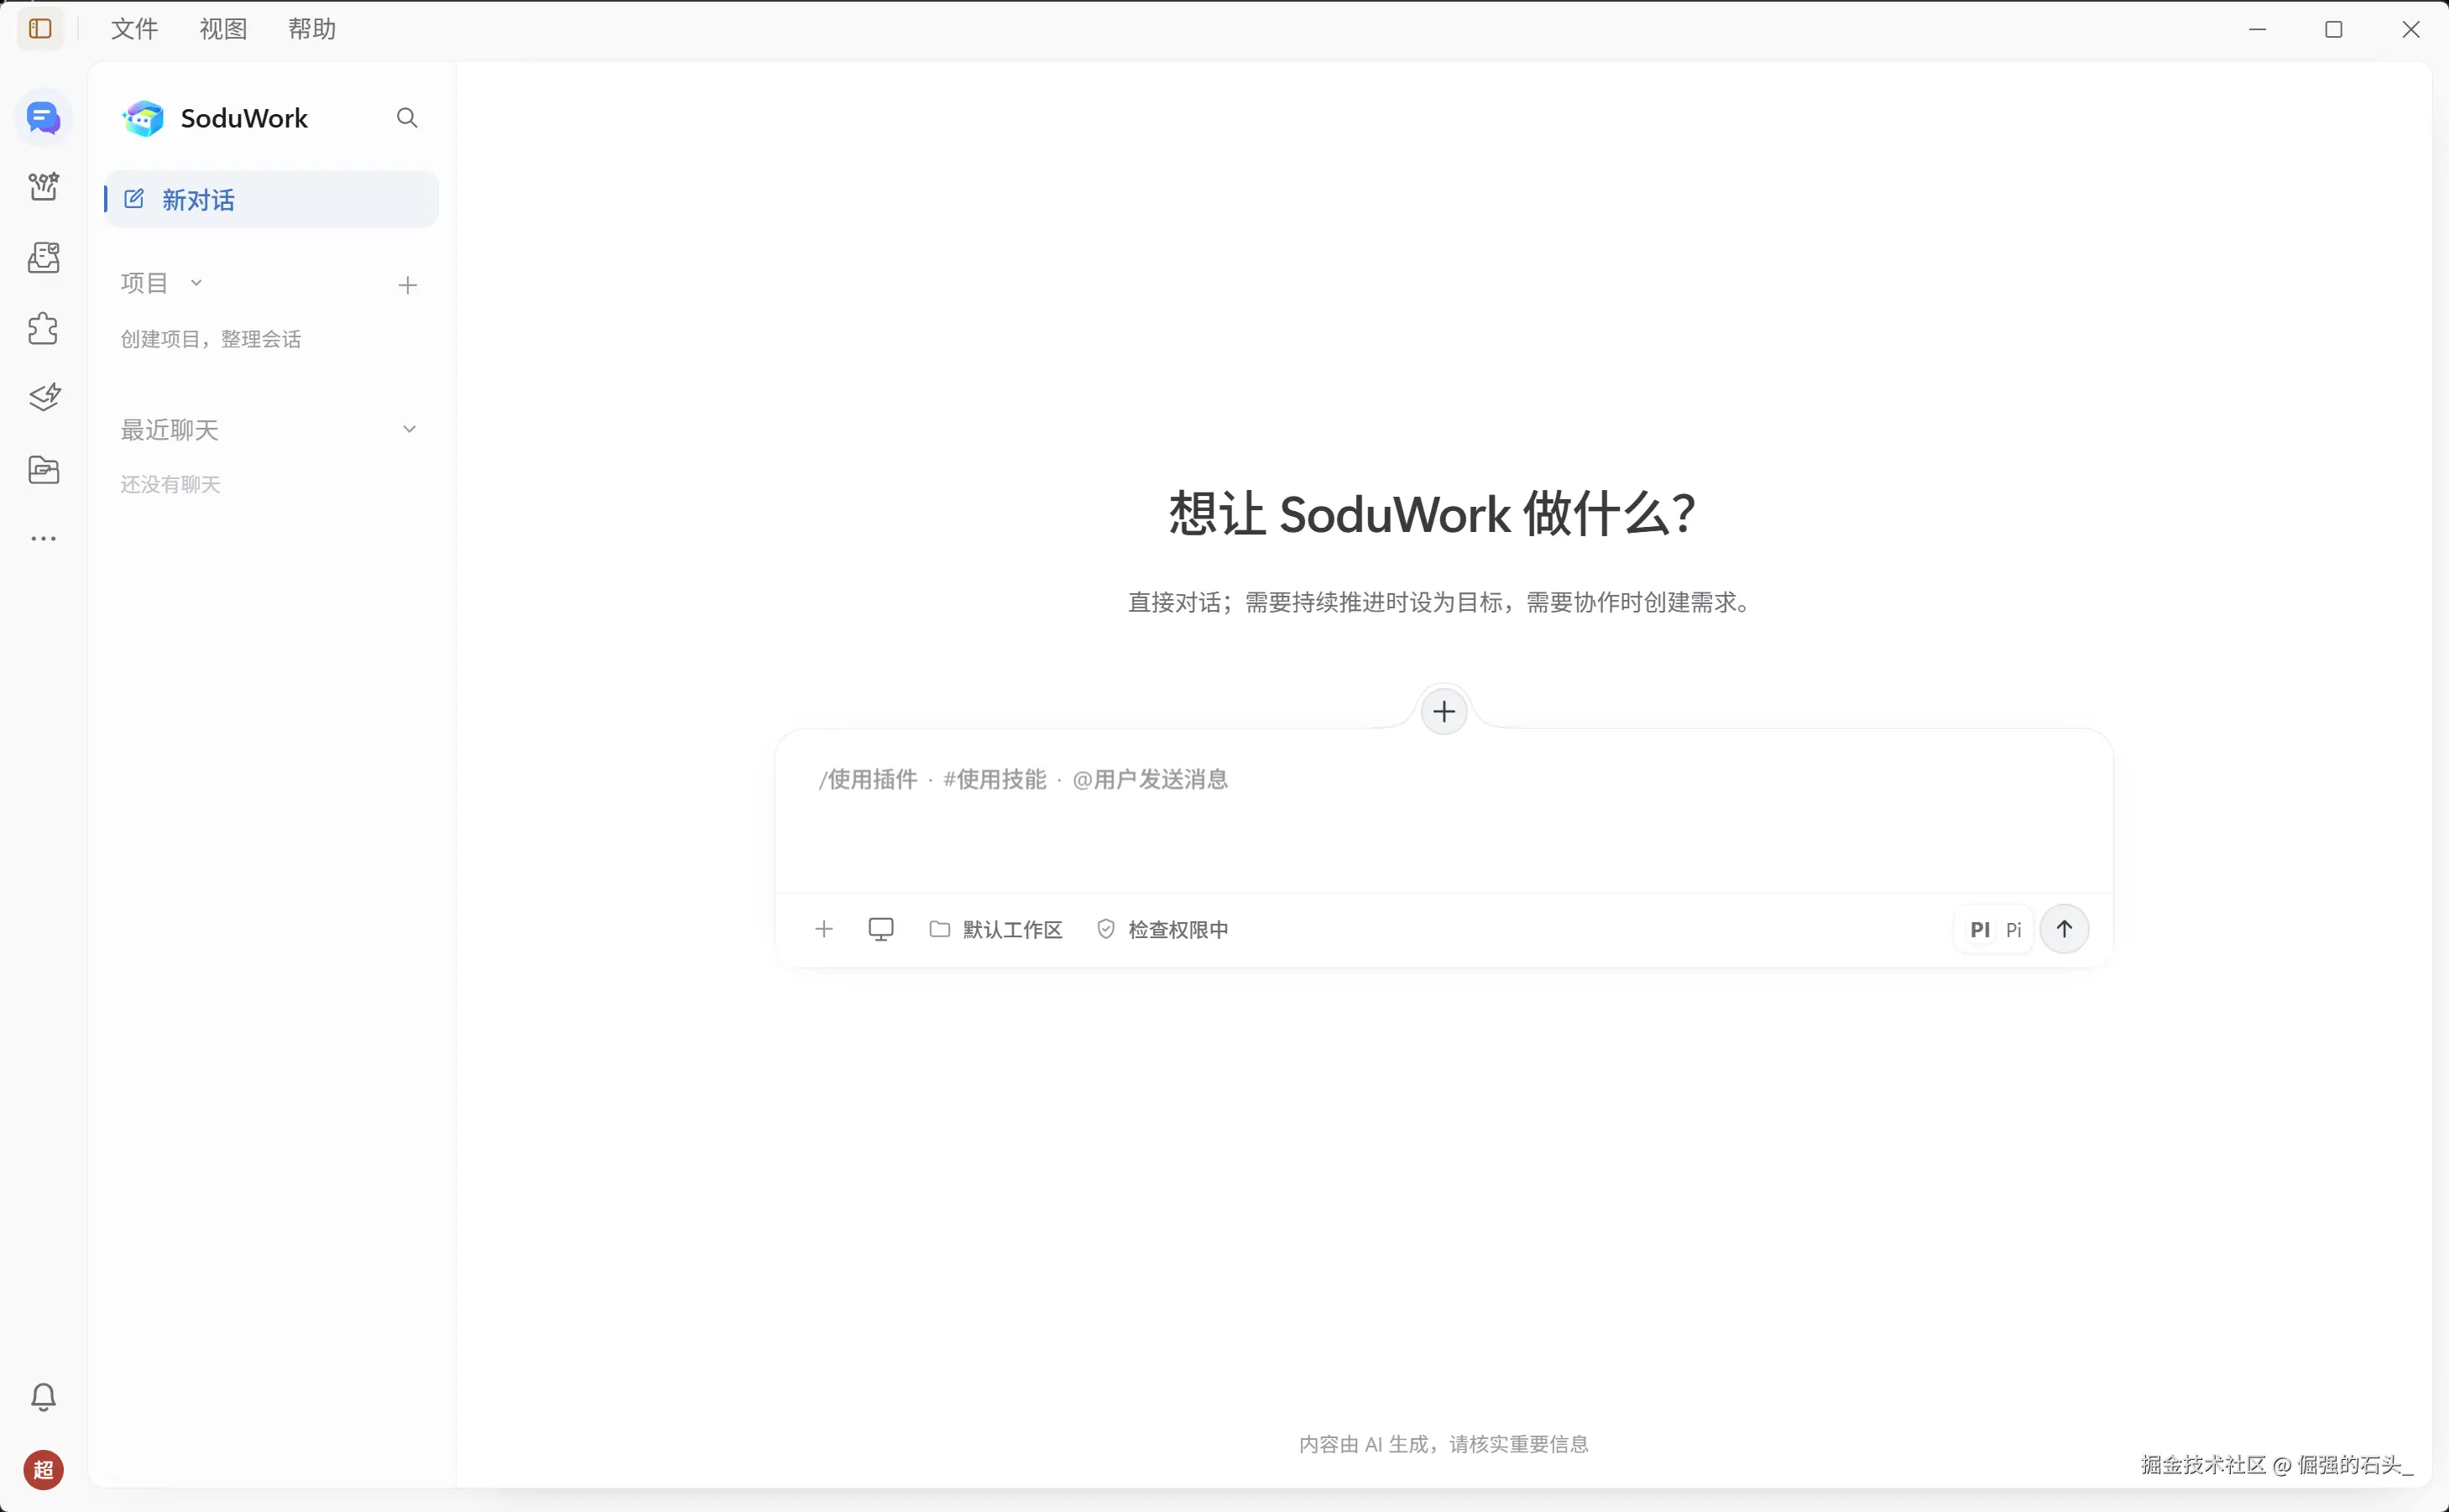
登录之后就进入这个首页------对话、需求池、插件、自动化、资料库,主功能都在左侧一栏:
这里有个值得写下来的小细节:重跑 start.cmd 会要求重新设置 admin 密码,不是只设一次。第一次遇到时我以为是装坏了,其实不是。
接下来配模型。浏览器打开管理后台,用刚才设置的 admin 密码登录:
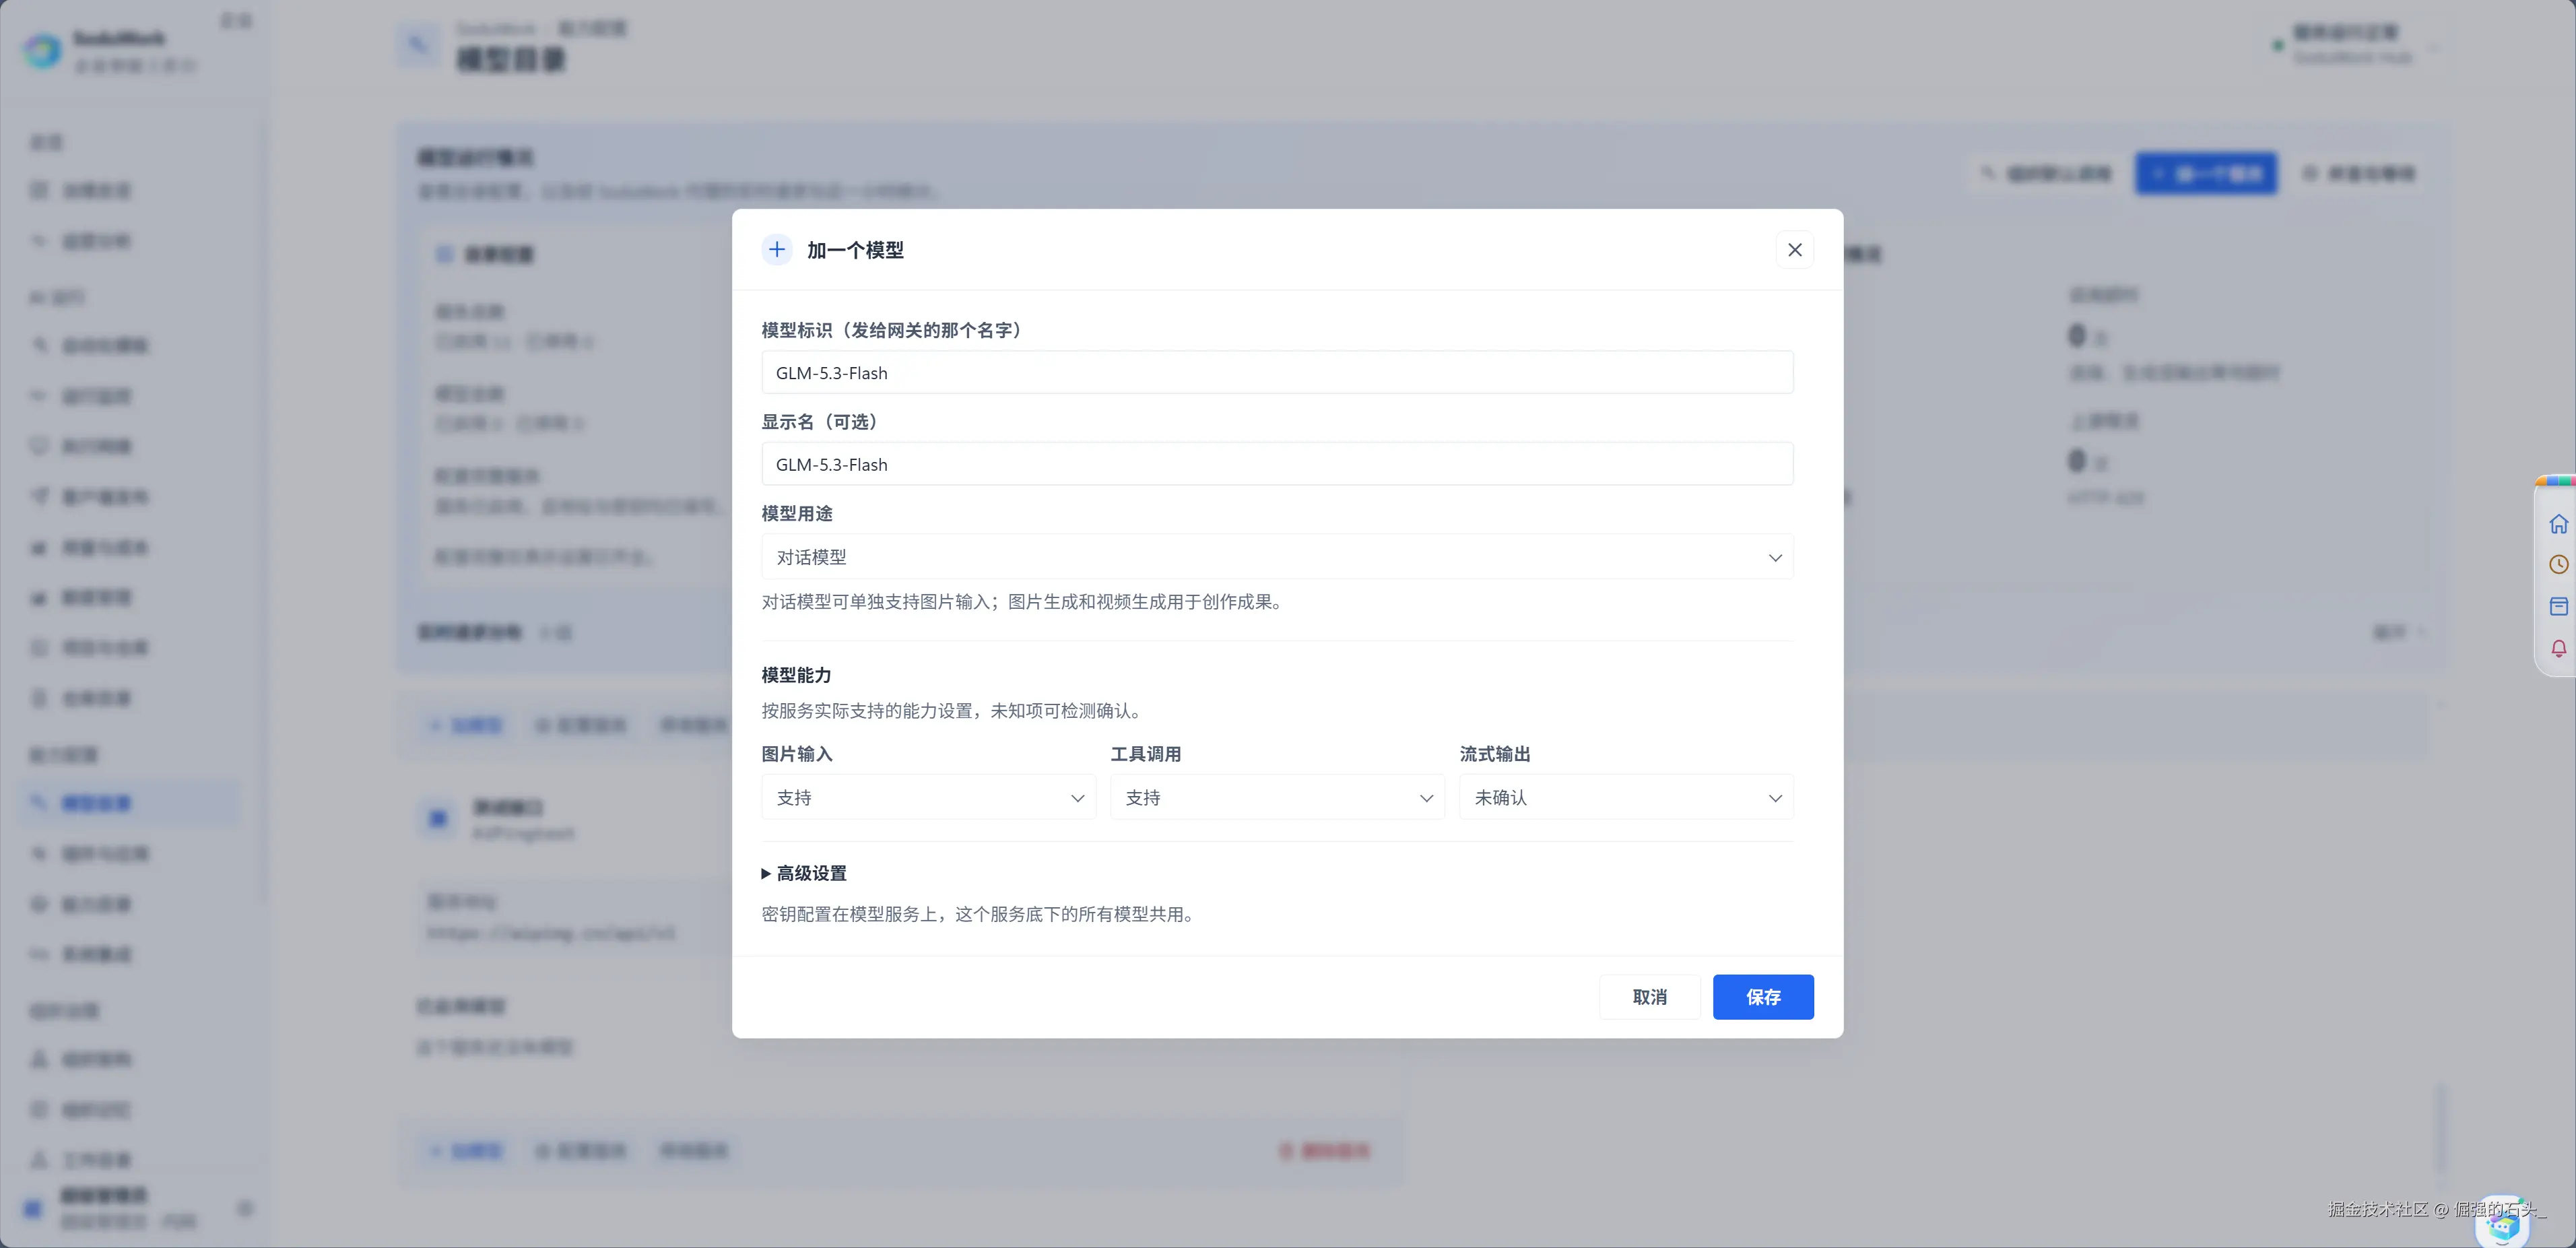
在"模型服务"里新建一个 OpenAI 兼容服务,填入服务商地址和 API Key。这里有个容易踩的空子:存了 API 凭证 ≠ 有模型可用 ,必须在服务下再点"添加模型"、照抄服务商的模型 ID 才行。我把它配成了公司级模型服务:
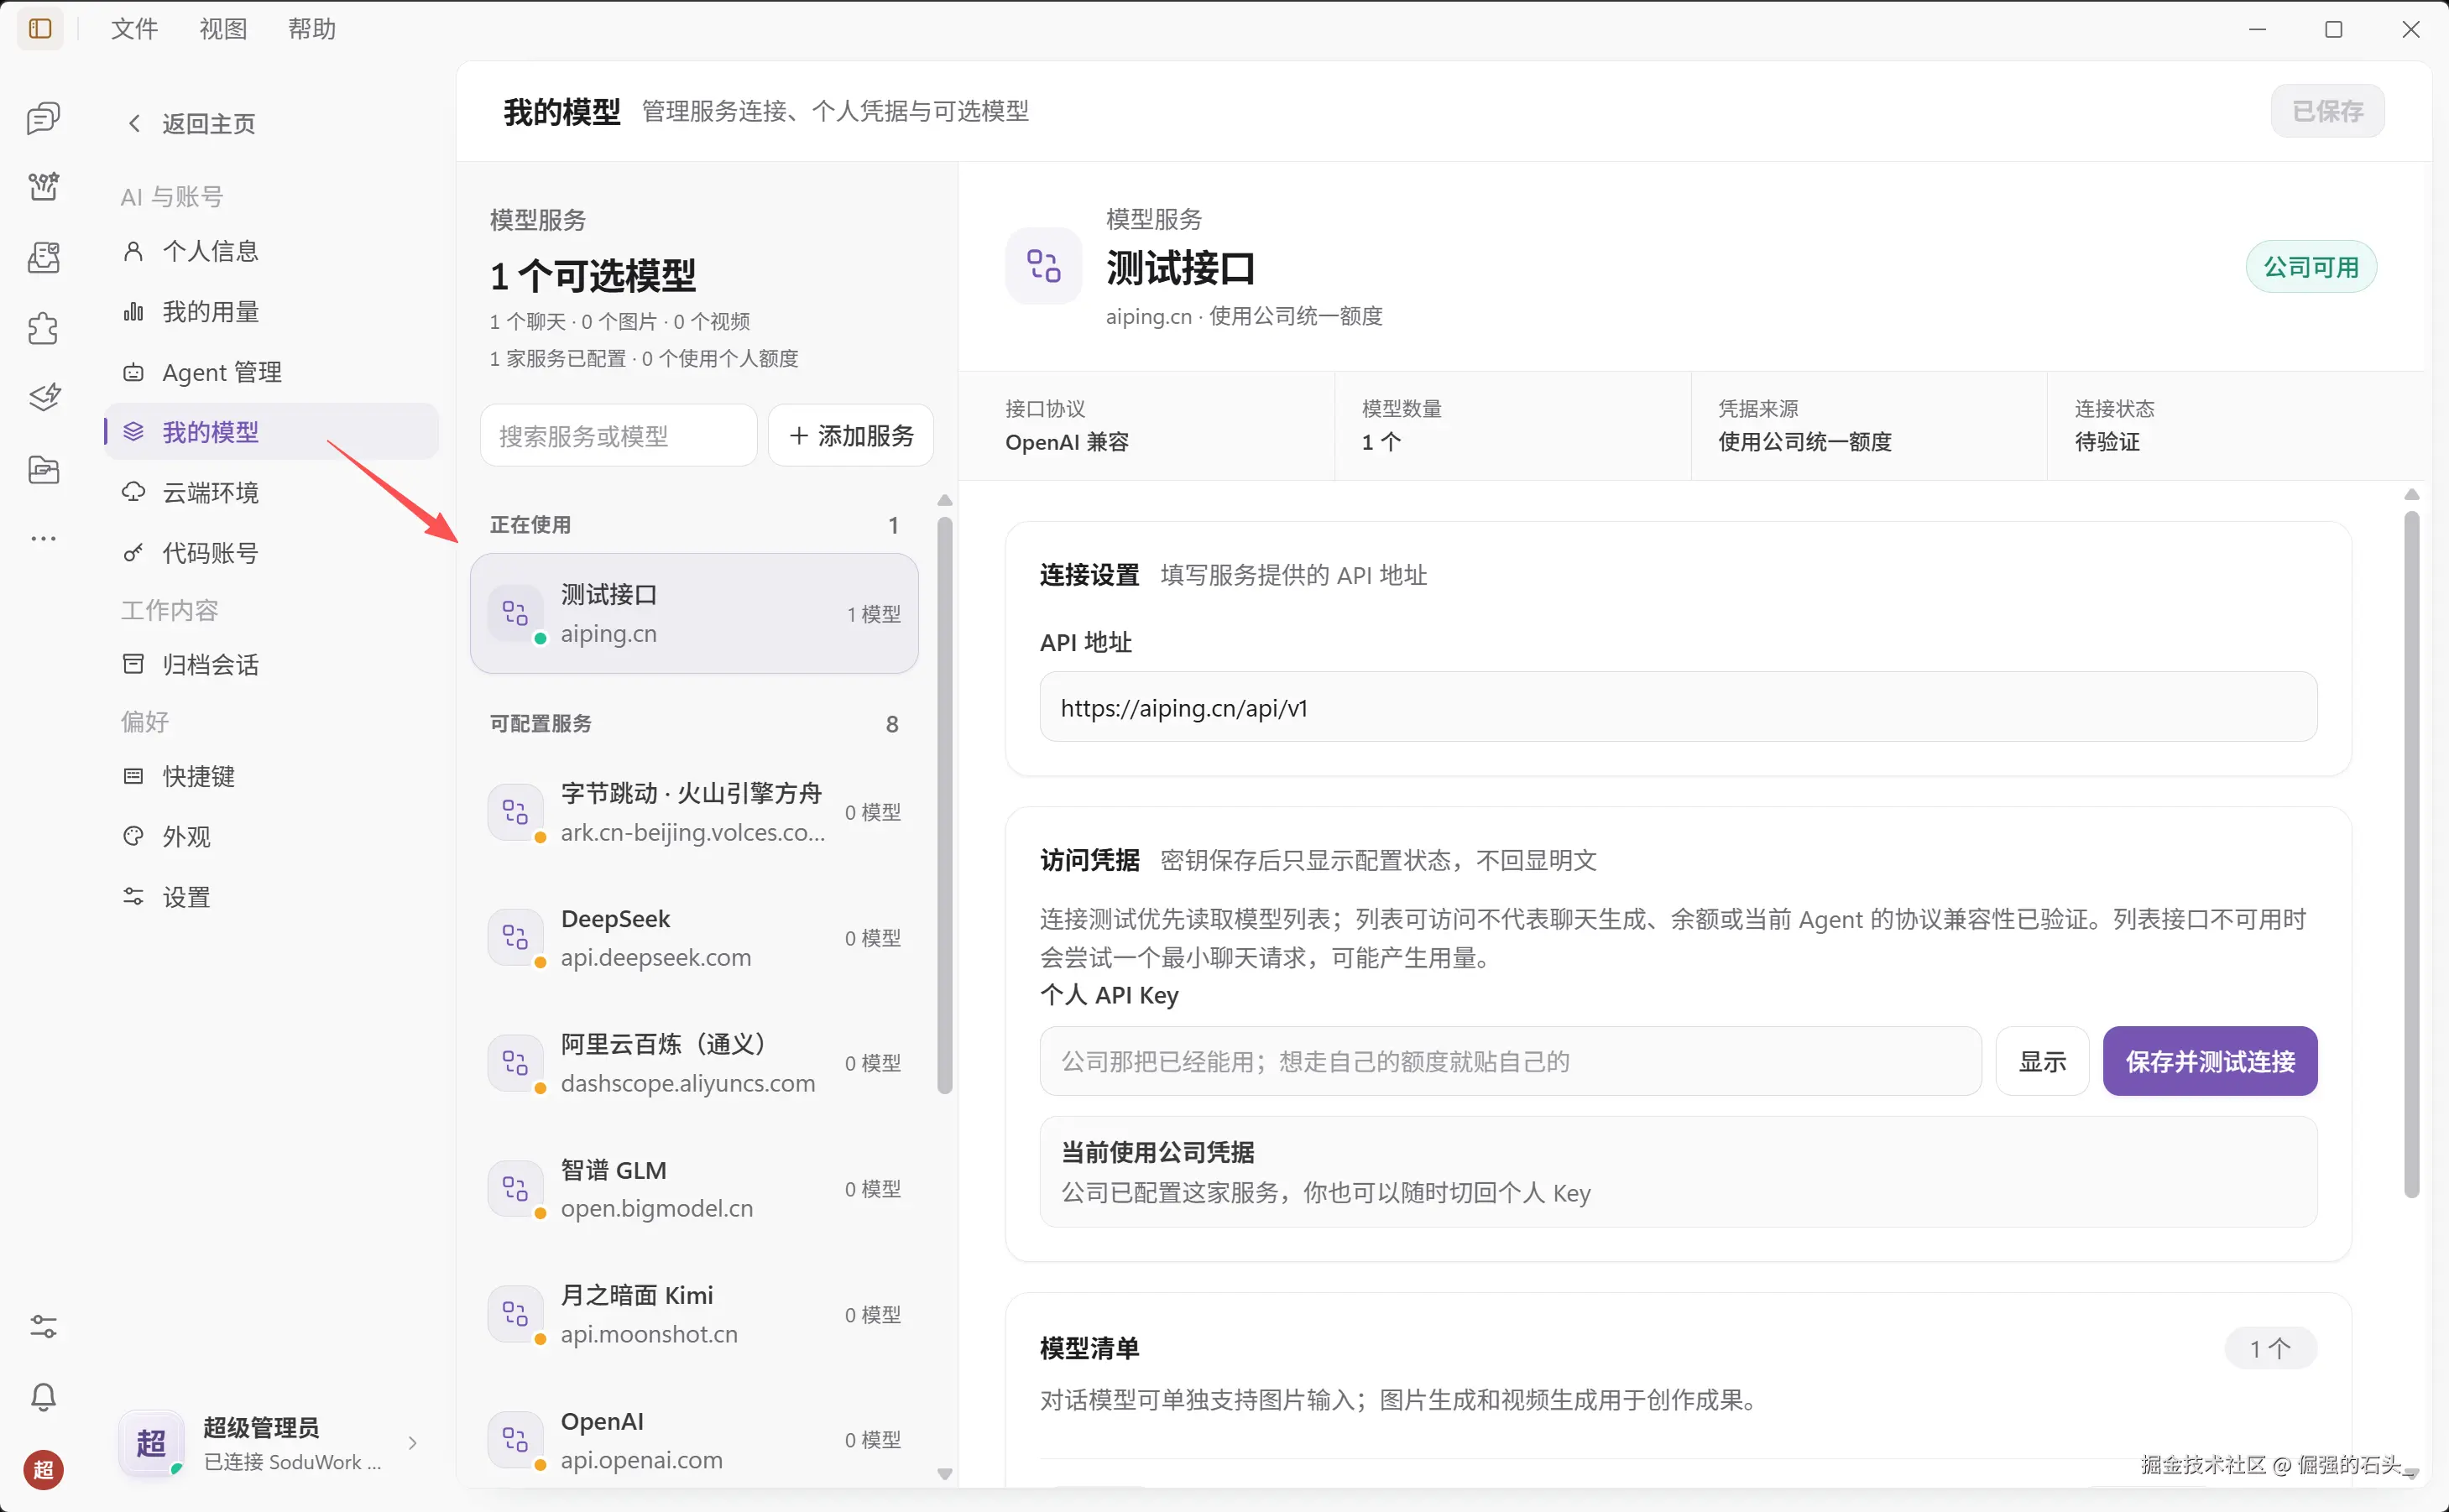
回到客户端,登录账号的模型一栏直接显示"当前使用公司凭据/公司统一额度"------团队成员不需要各自申请 Key,这一点在后面的换账号测试里起了关键作用:
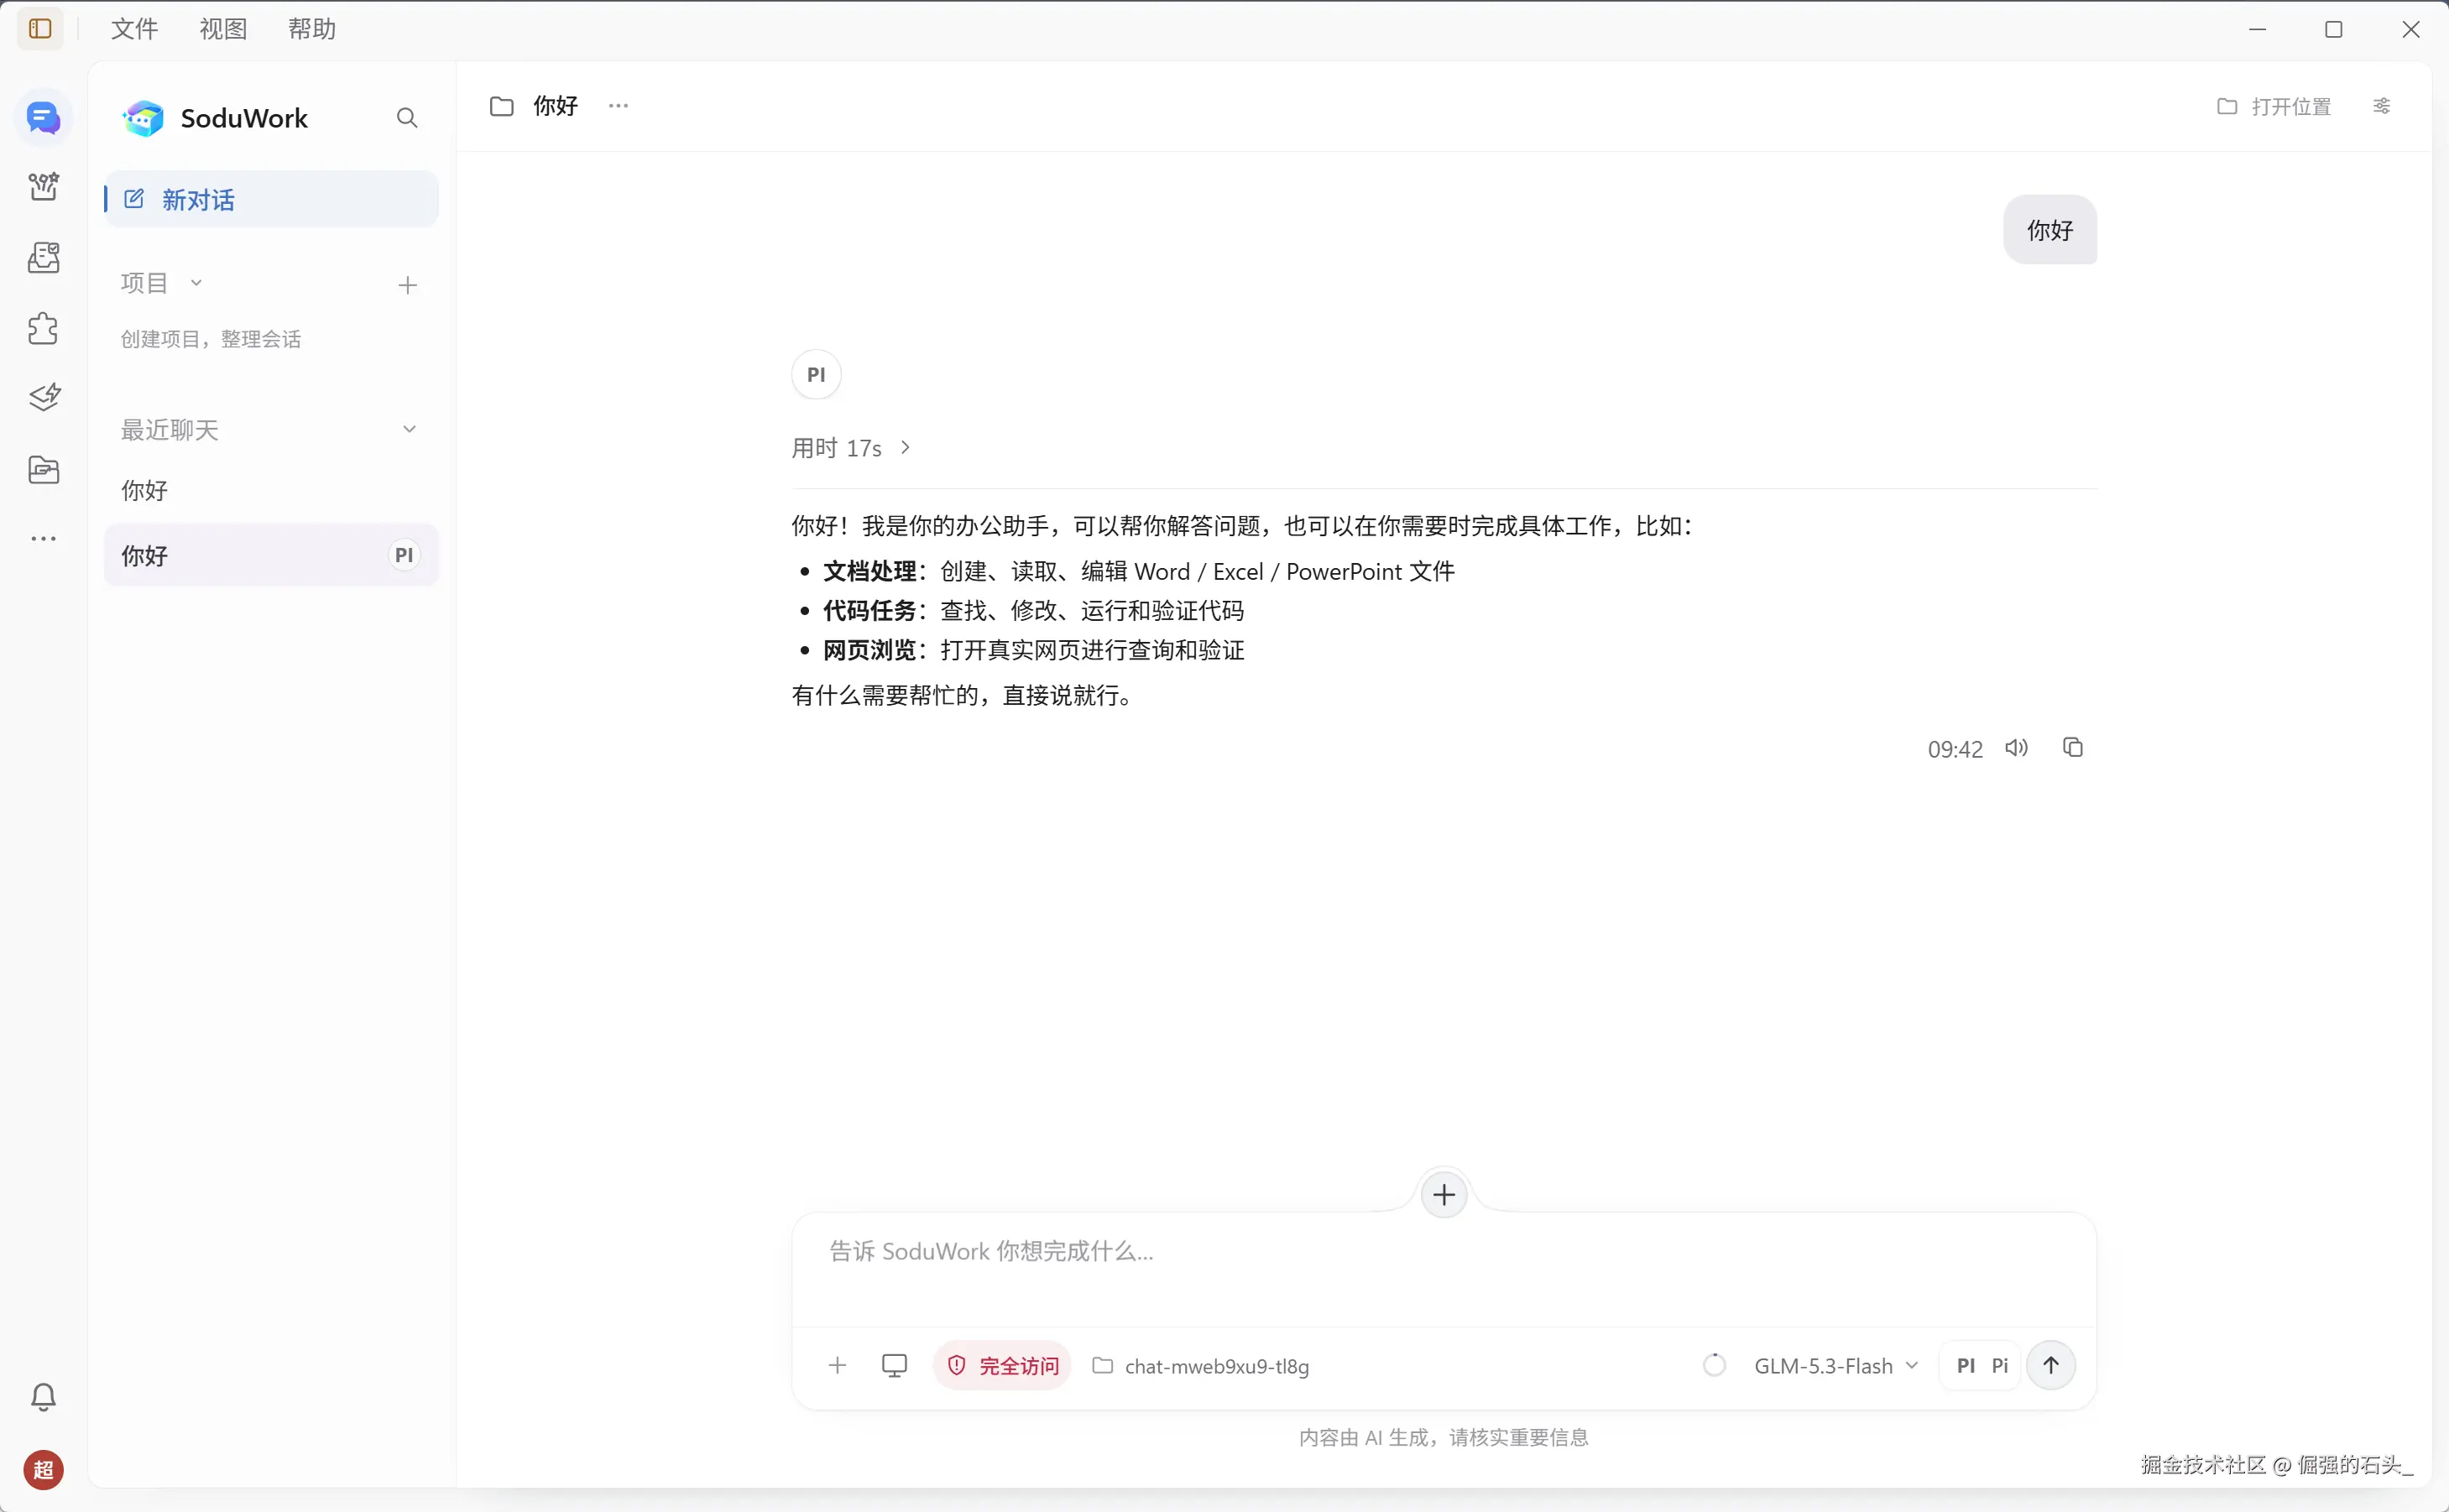
随手发第一条对话,模型正常回话,安装配置到此完成:
四、核心流程体验:从对话到插件
SoduWork 的界面结构是:对话、需求池、插件、自动化、资料库。日常用法就是开对话派活;AI 在你指定的工作区目录里直接读写文件、跑命令。
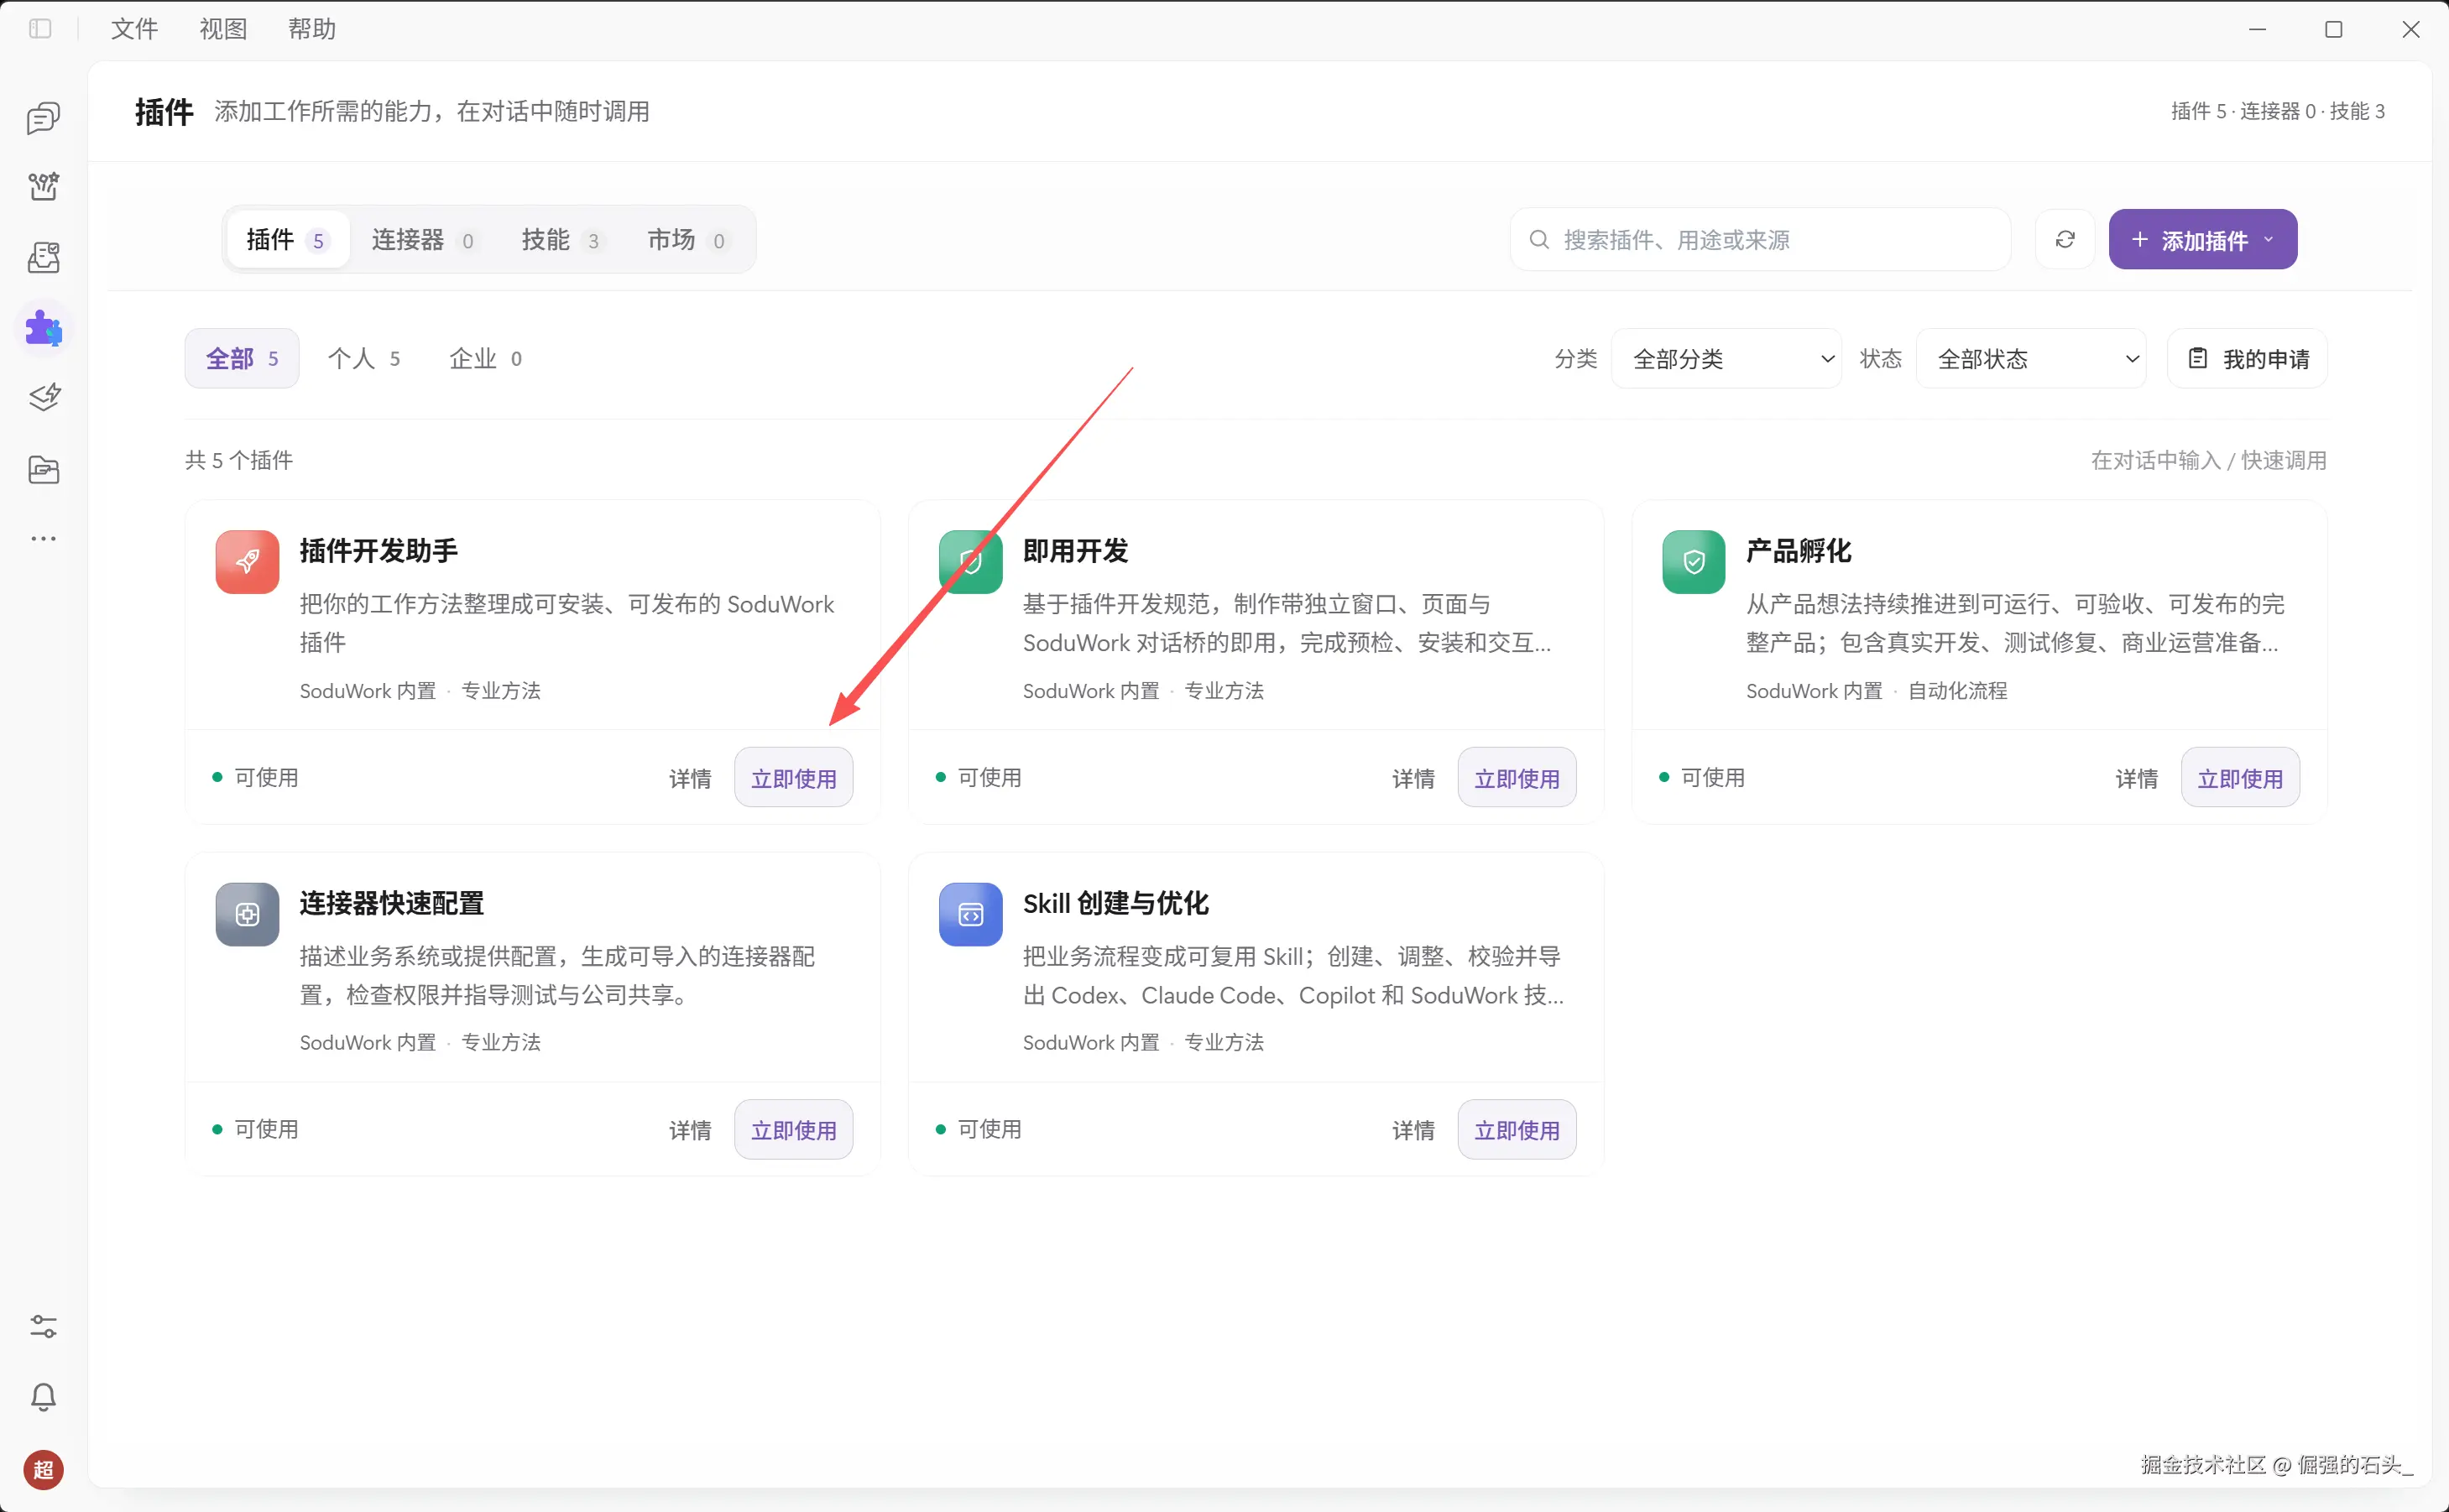
真正让我决定做这次实验的,是它的插件 概念:插件分方法型(步骤/关卡/脚本)和流程型(多节点、审查不过就停),有版本号、可以审查、可以分发给团队。也就是说,"老员工怎么把这件事做对"本身可以被存成一份可执行的资产。
五、场景实测(上):和 AI 一起把活干对,沉淀成插件
5.1 准备材料:用"上一季度"防背答案
要验证插件是真的会做事、不是背答案,材料设计上有个关键动作:搭建插件用 Q4 2024 的练习数据,正式考试用 Q1 2025 的全新数据------同一家公司、同一批员工、同样的文件结构,但缺勤模式、请假陷阱、阈值规则完全不同。
我让 AI 帮我设计了一套 Q4 练习数据(25 名员工、64 个工作日、约 1600 条考勤记录),里面故意埋了四类坑:落在"部分缺勤"日但不能抵扣的请假申请、48 小时内追认的假期、间歇性 FMLA 只保护医疗原因缺勤、请假余额汇总表与逐条申请记录的三处矛盾。练习数据的标准答案我单独存放,绝不放进工作区。
5.2 搭建过程:AI 的"不编造"和"自修复"
材料放进工作区后,我在对话里挂上内置的"插件开发助手",把插件定义草稿、方法手册、三个配套脚本和 Q4 练习数据的路径交给它,权限开"完全访问"。
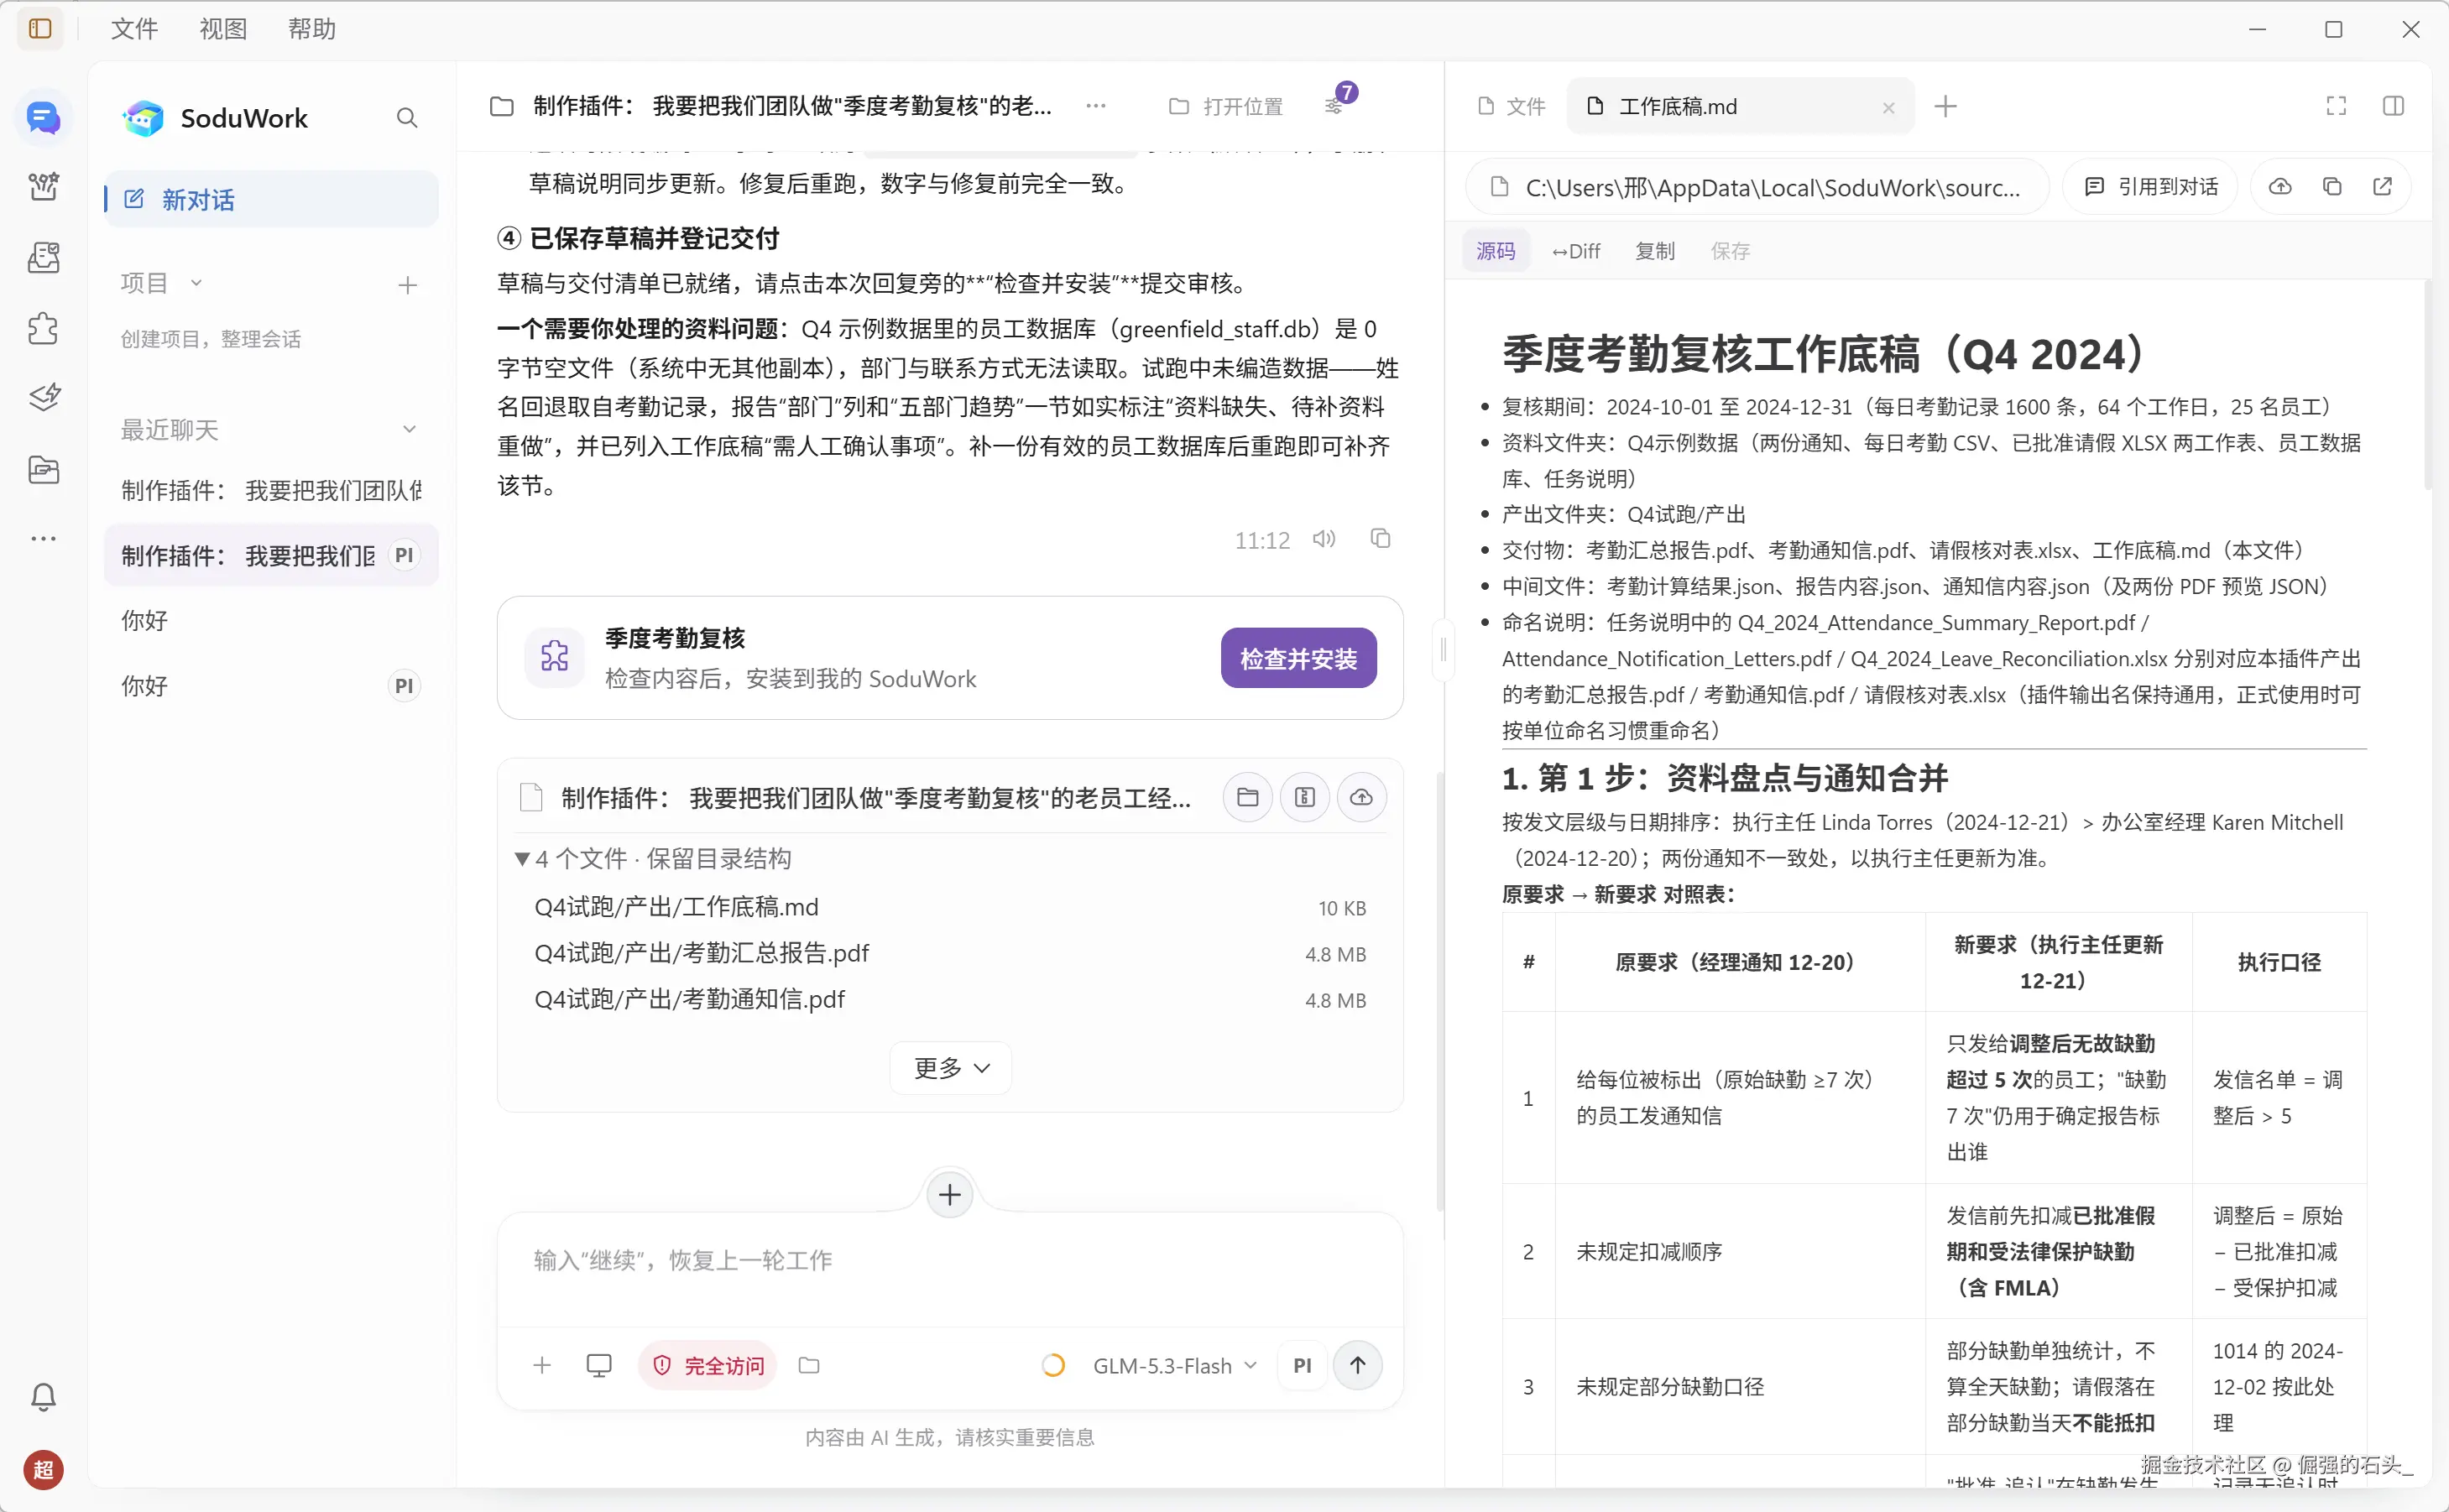
第一个踩坑细节来了:AI 检查材料时发现员工数据库是 0 字节空文件 (我后来查证是自己复制文件时的失误)。它没有悄悄编造部门数据把报告填满,而是如实标注"部门与联系方式无法读取,姓名将回退到考勤记录中的姓名列,绝不编造",并把这事项列进了工作底稿的"需人工确认事项"。我把有效数据库补进工作区让它重跑,结论与首次完全一致。
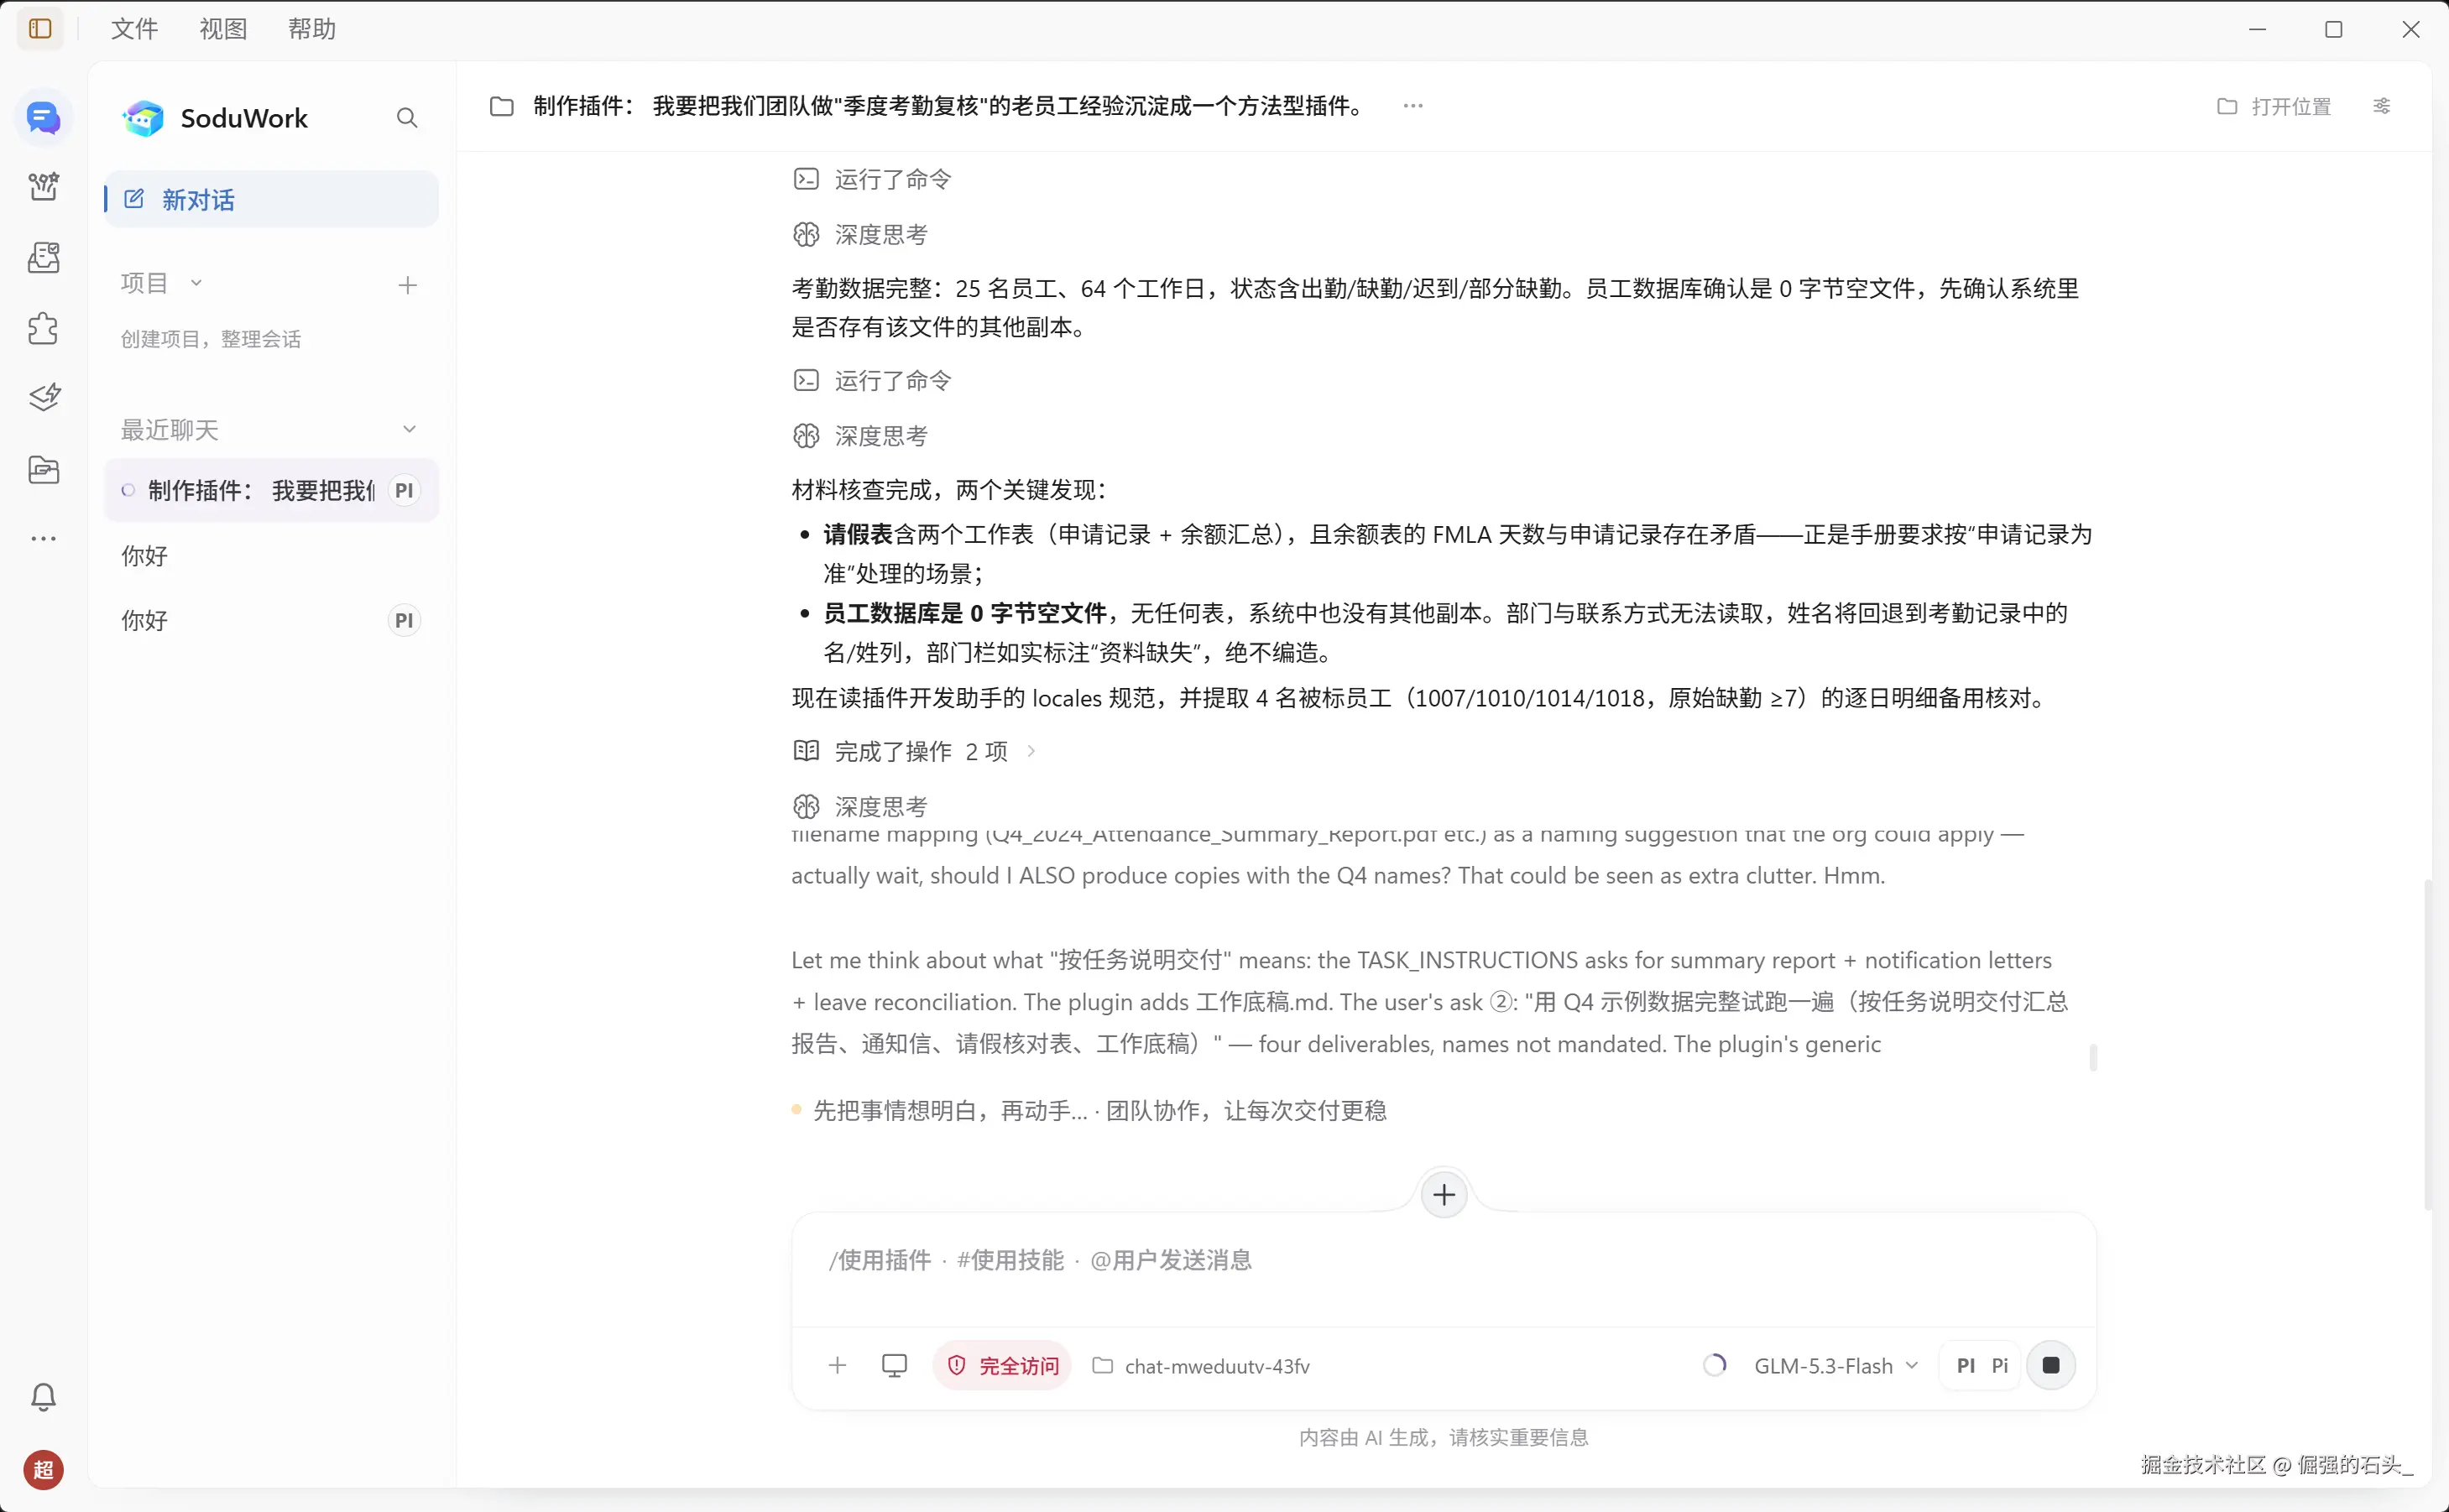
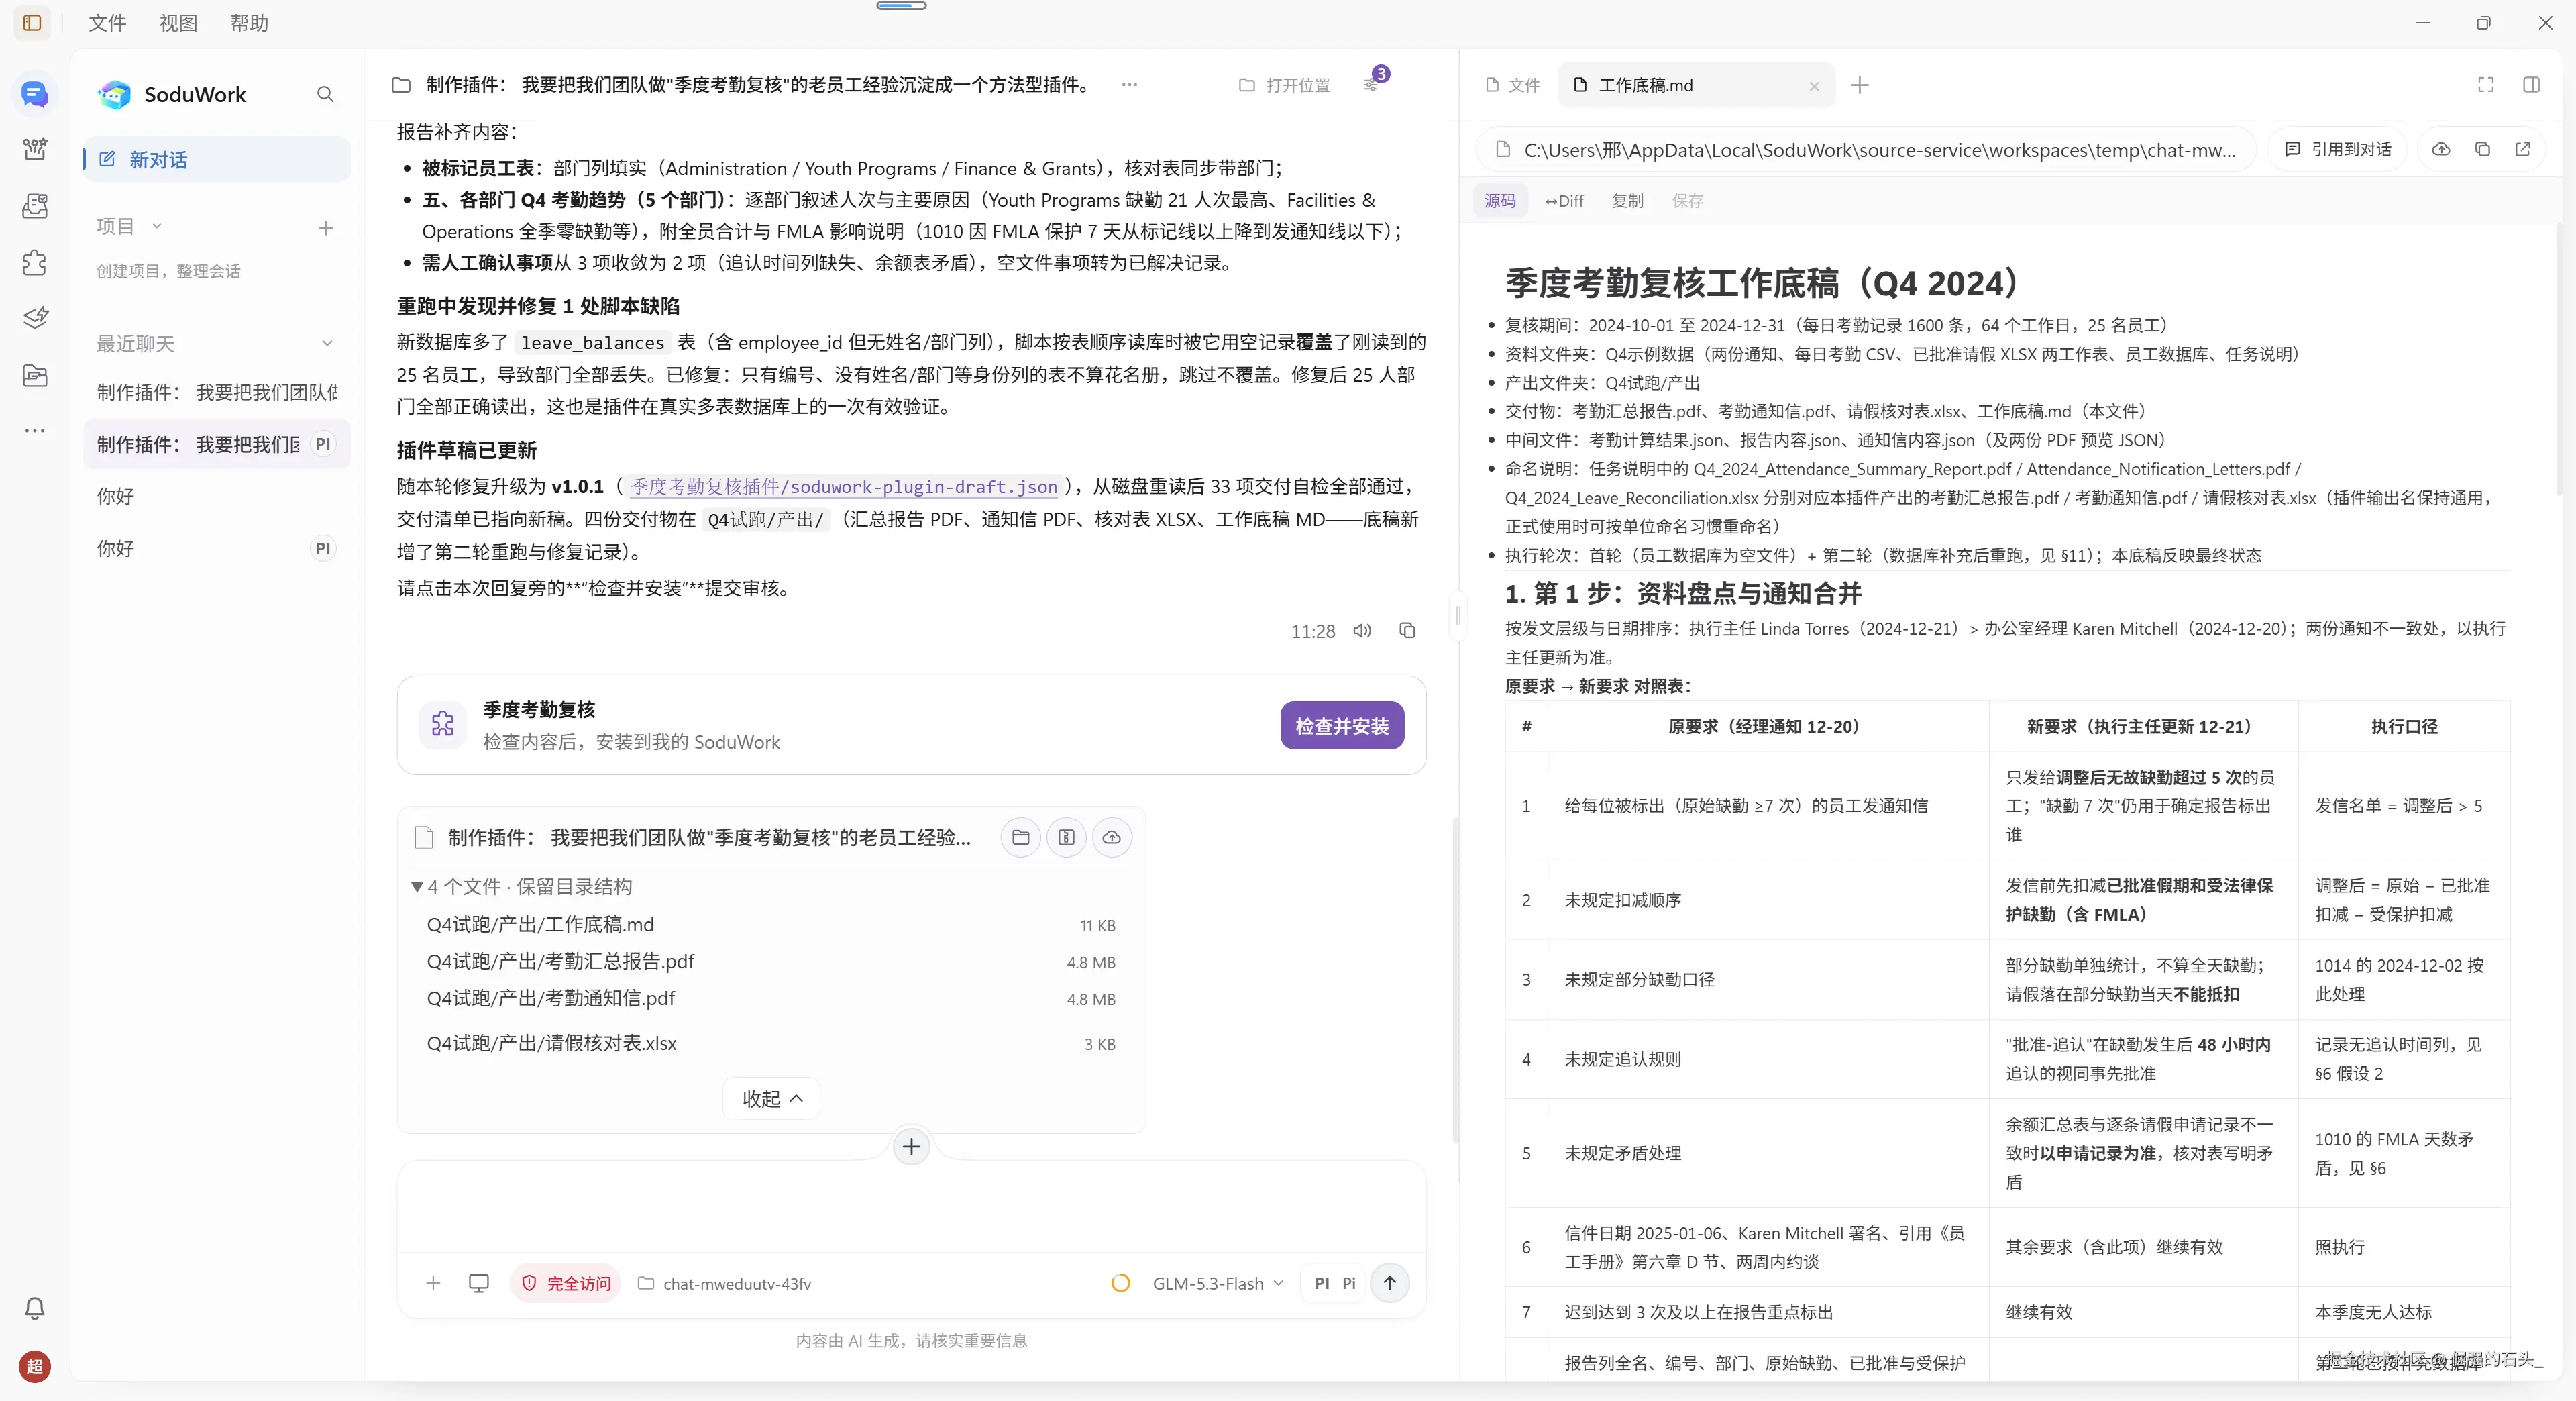
第二个细节更有意思:补数据重跑时,AI 发现并修复了自己脚本的一个缺陷 ------新数据库多了个 leave_balances 表(只有员工编号、没有姓名/部门列),脚本按表顺序读库时被它覆盖了花名册,导致部门全部丢失。修复方式是把判定改成"只有编号、没有身份列的表不算花名册"。修复后 25 人部门全部正确读出,插件草稿升级到 v1.0.1,33 项交付自检全部通过。用官方的话说,这是插件"在真实多表数据库上的一次有效验证";用我的话说,这一段对话本身就值回票价。
重跑通过后,插件搭建完成,试跑的三份交付物------汇总报告、通知信、核对表------也都实实在在产出了:
下面这张是修复脚本缺陷那轮对话的过程记录,插件草稿也在这里升级到了 v1.0.1:
试跑结果与我预埋的标准答案逐项一致:4 人被初筛标出、只有 2 人该发通知信、部分缺勤陷阱和追认陷阱全部按规则处理。
5.3 审核与安装
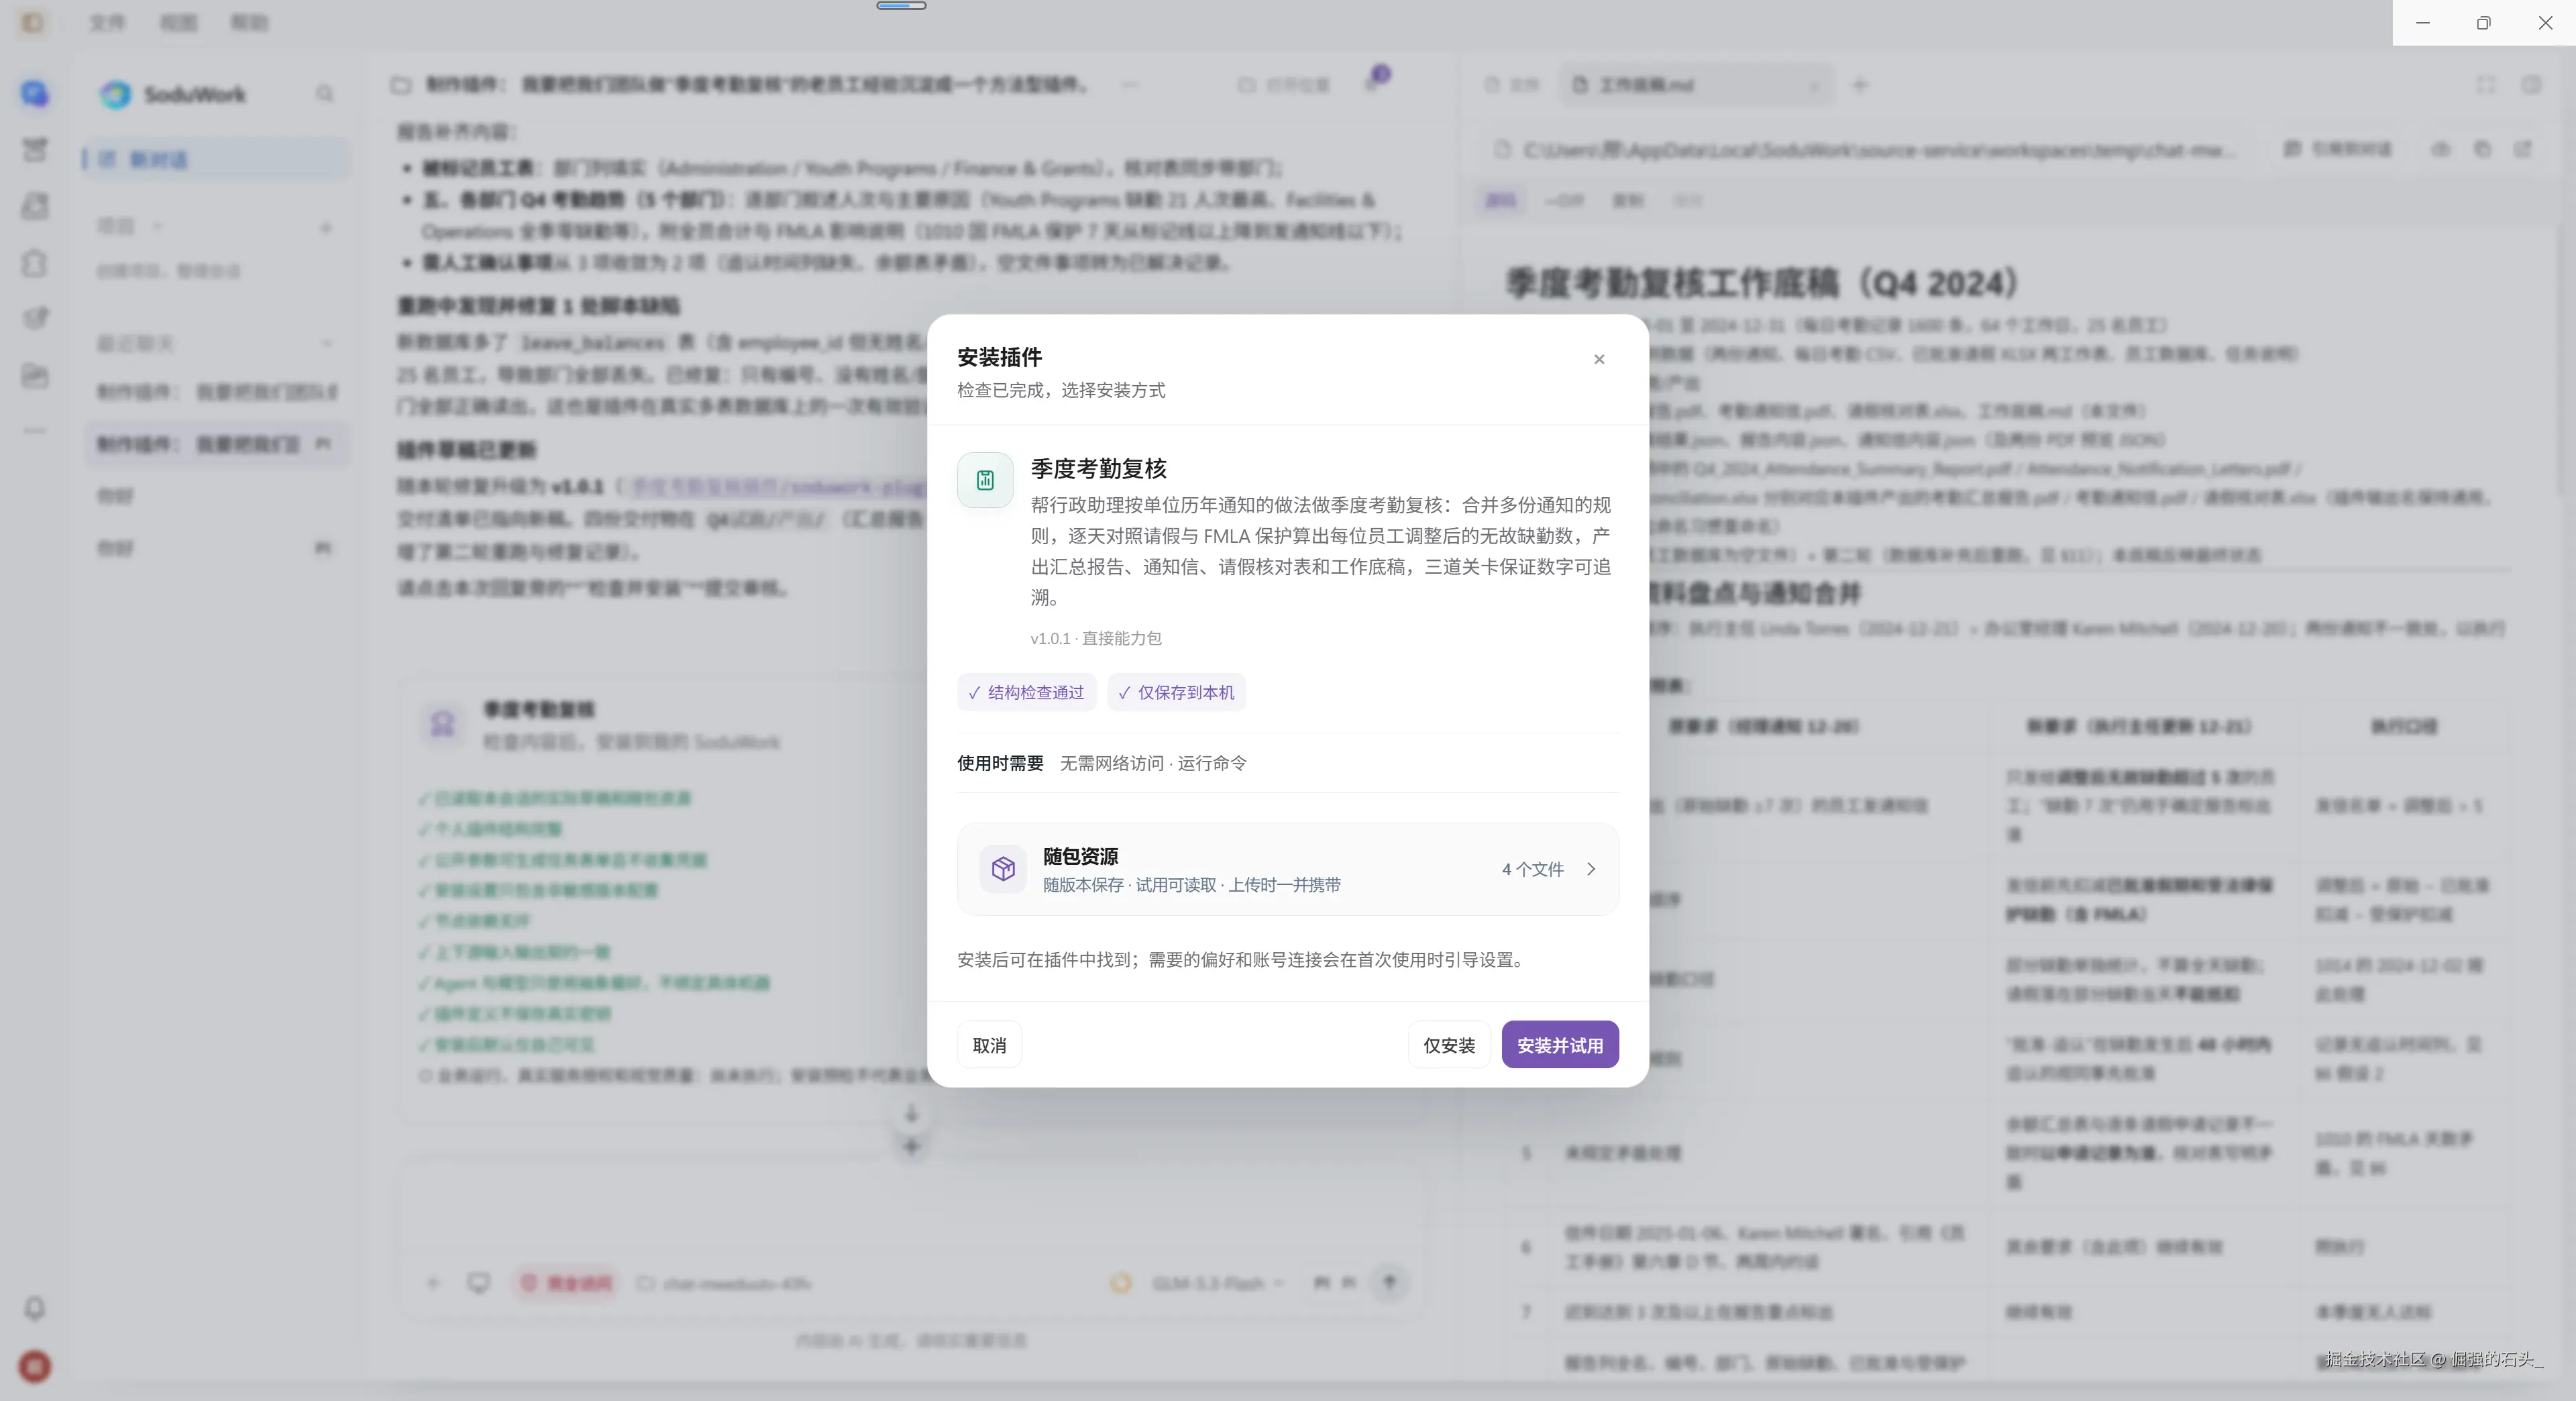
点击"检查并安装",会弹出审核对话框:插件描述、版本(v1.0.1)、能力声明(无需网络访问、运行命令)、随包资源清单都列得很清楚,看明白再点确认:
确认之后,插件就出现在客户端的插件列表里,随时可以在对话中挂载:
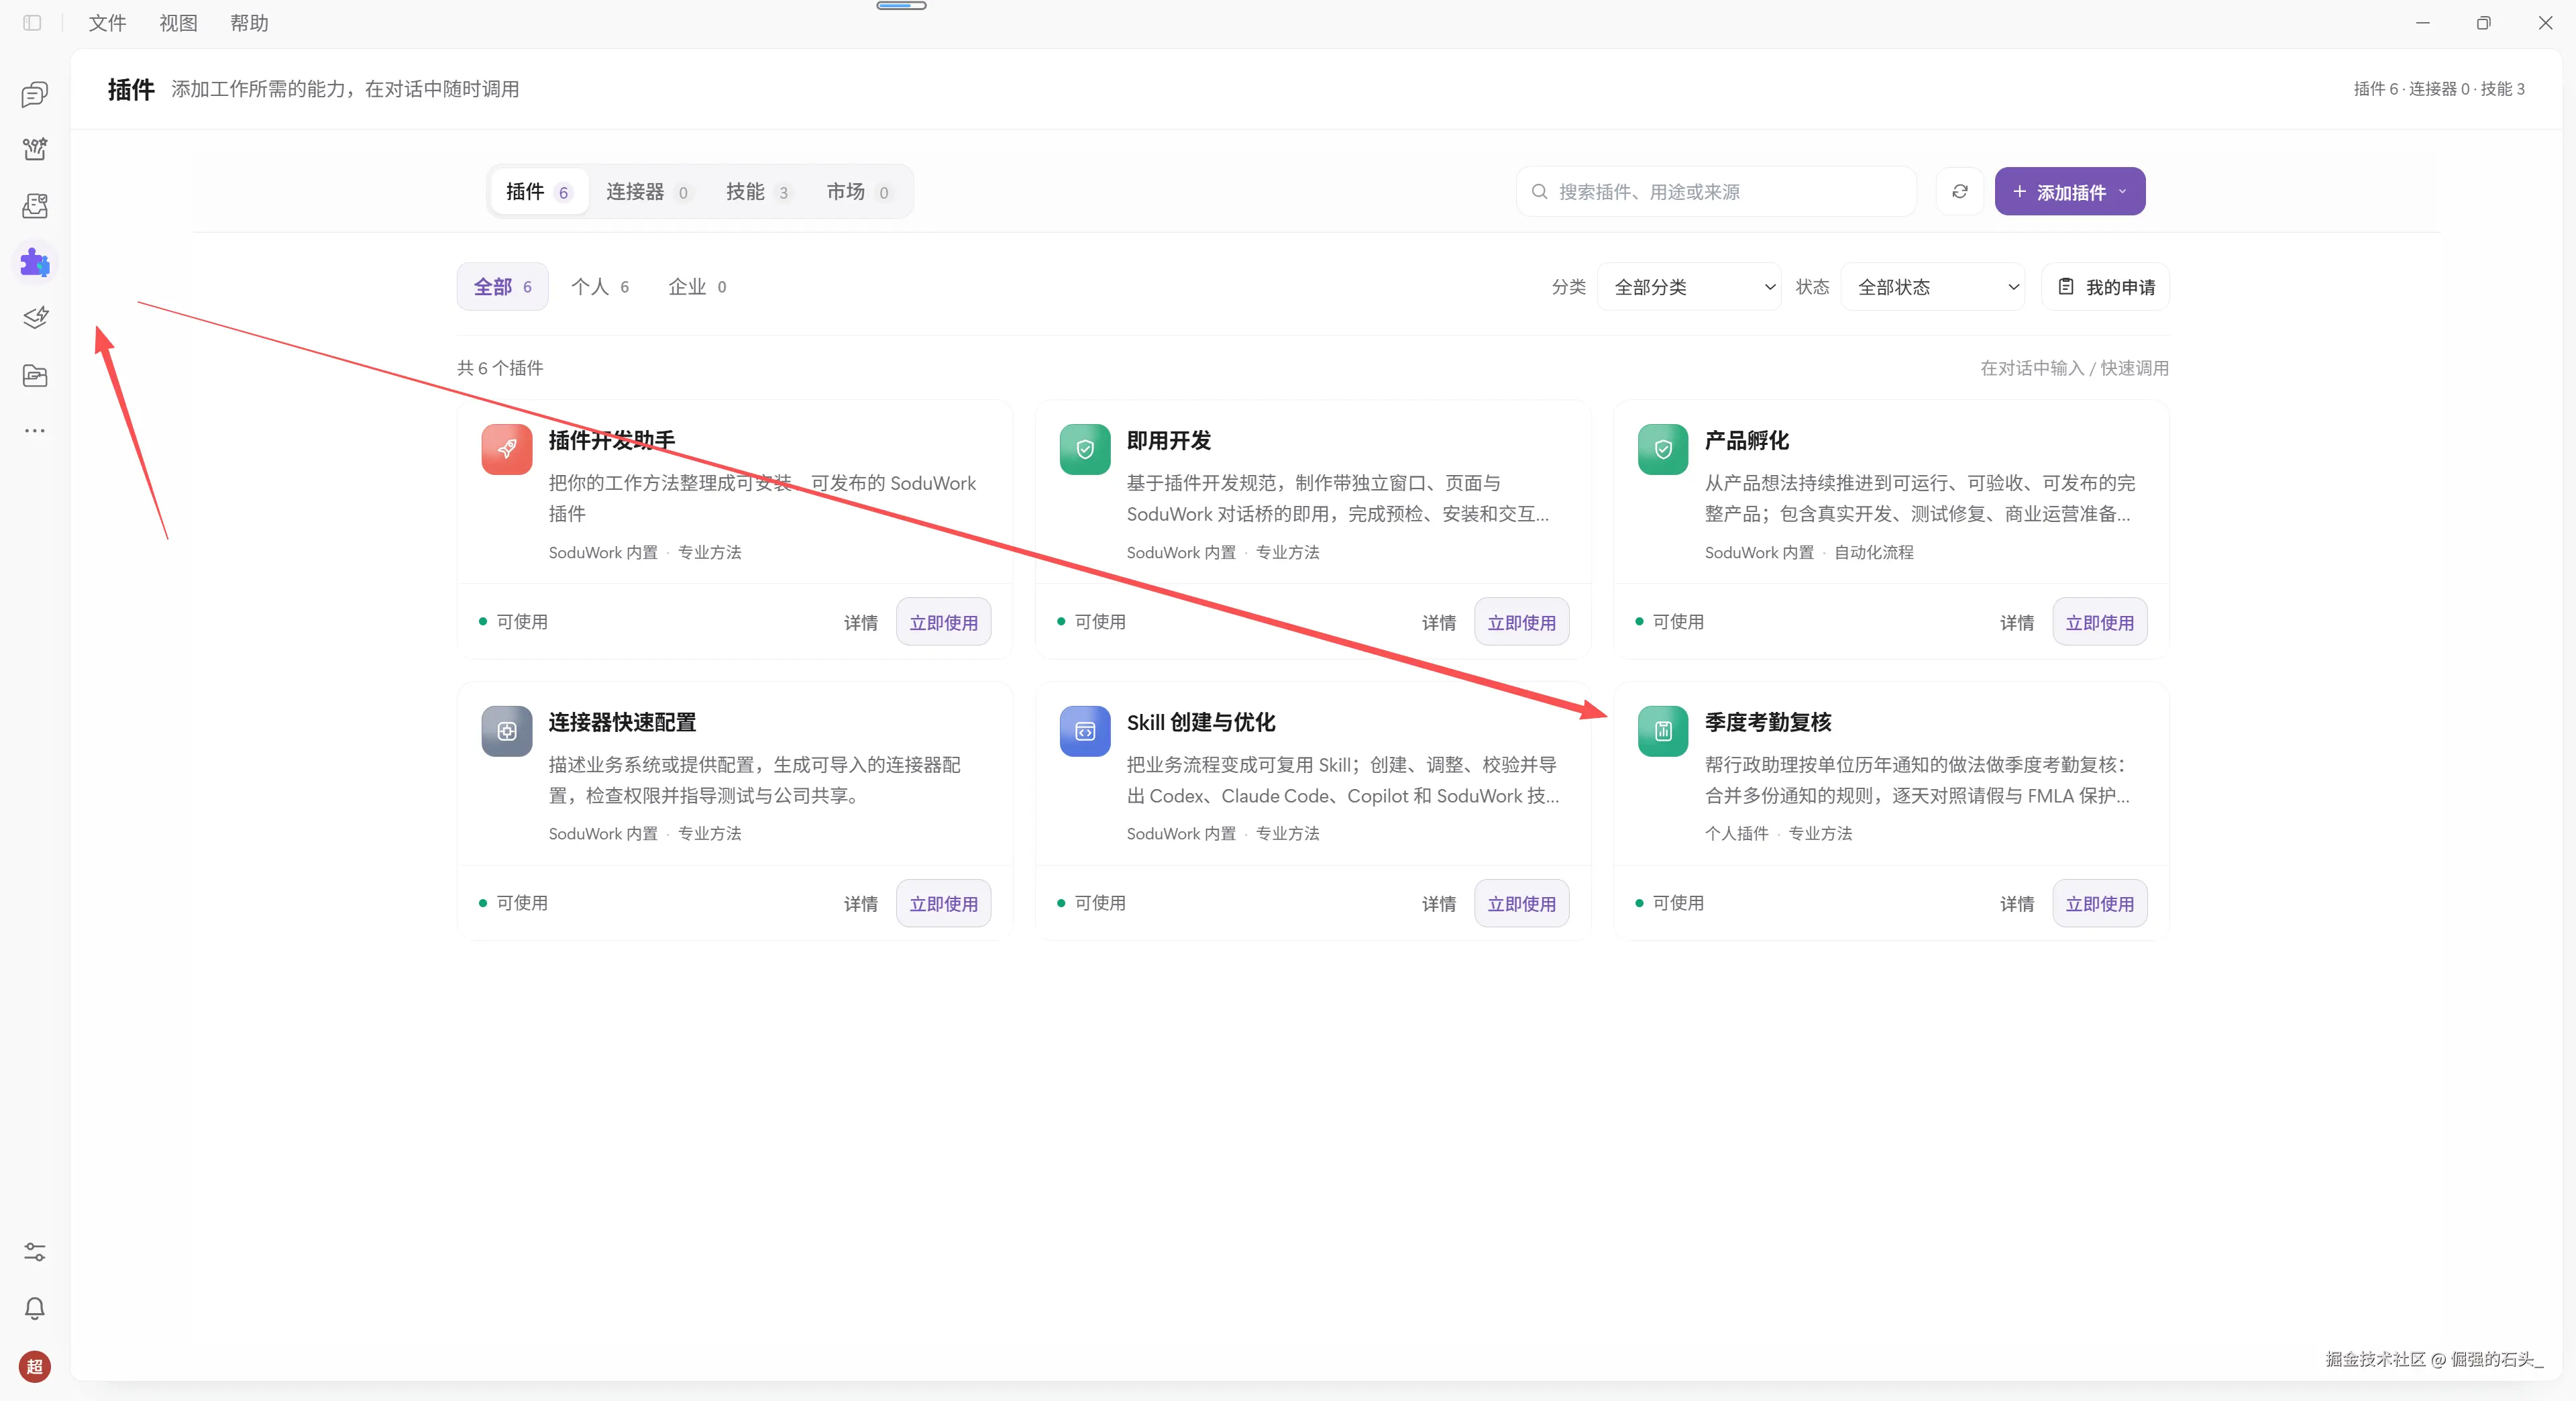
六、场景实测(下):三组对照
正式考试开始。Q1 2025 全新数据(同样 6 个文件:两份通知、每日考勤 CSV、已批准请假 XLSX 双工作表、员工数据库、任务说明)放进一个干净的工作区,三组分别在全新对话里跑,互不可见彼此产出(每跑完一组我都把产出文件移走)。
6.1 第一组:新人一句话
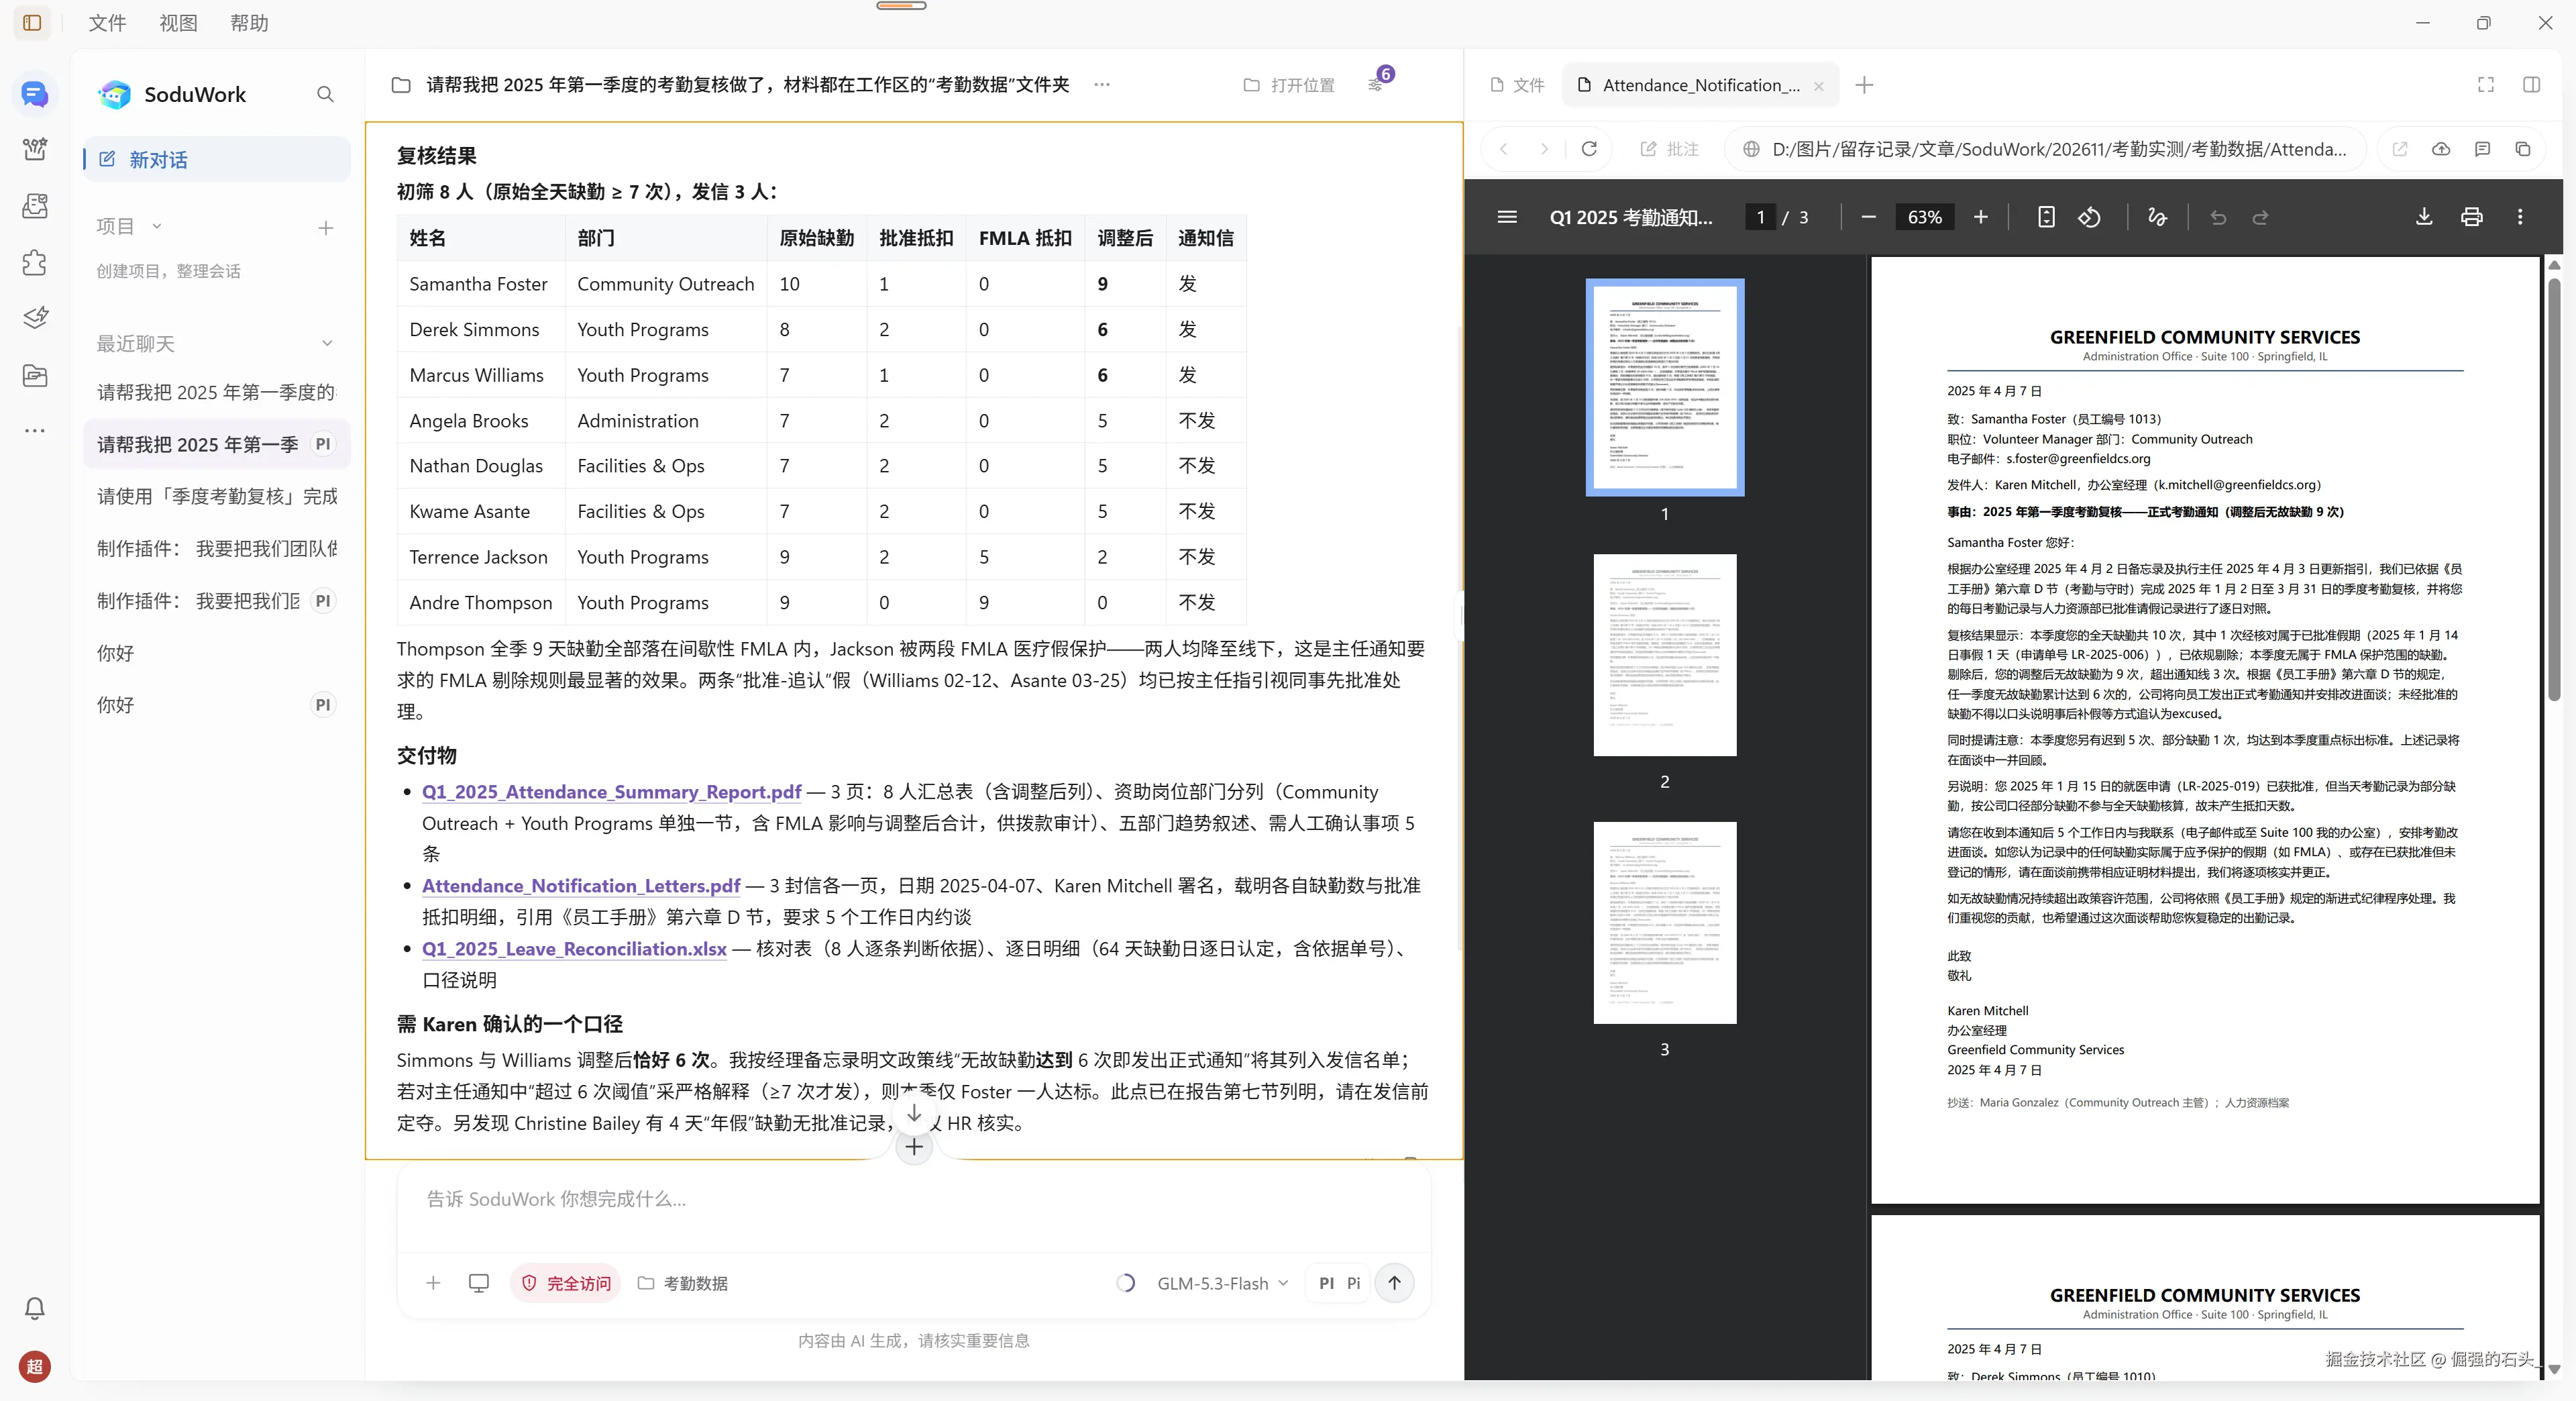
"请帮我把 2025 年第一季度的考勤复核做了,材料都在工作区的'考勤数据'文件夹里。"
结果:大框架基本对,细节坑踩了一半 。初筛 8 人正确,也自己发现了"恰好 6 次算不算超过阈值"的口径模糊并主动请示(这点超出我预期);但它按经理通知的"达到 6 次即发出"口径发了 3 封信------标准答案是只发 1 封(主任通知的口径是调整后超过 6 次,另外两名员工恰好 6 次,不应发信)。在真实 HR 场景里,给不该通知的员工发考勤警告信,是实打实的合规事故。它还把一名间歇性 FMLA 员工的 9 天缺勤全部算成了保护范围(事假不受保护),报表数字直接出错。
(诚实记录:这一组的对话被我手滑删了,完成截图和全部产出文件还在,用时没记上,表中如实标注"未记录"。)
6.2 第二组:老员工 630 字完整叮嘱
第二组我把老员工脑子里的坑逐条写进提示词,一字未改全部贴出来------这 638 个字符就是"老员工经验"本身的模样:
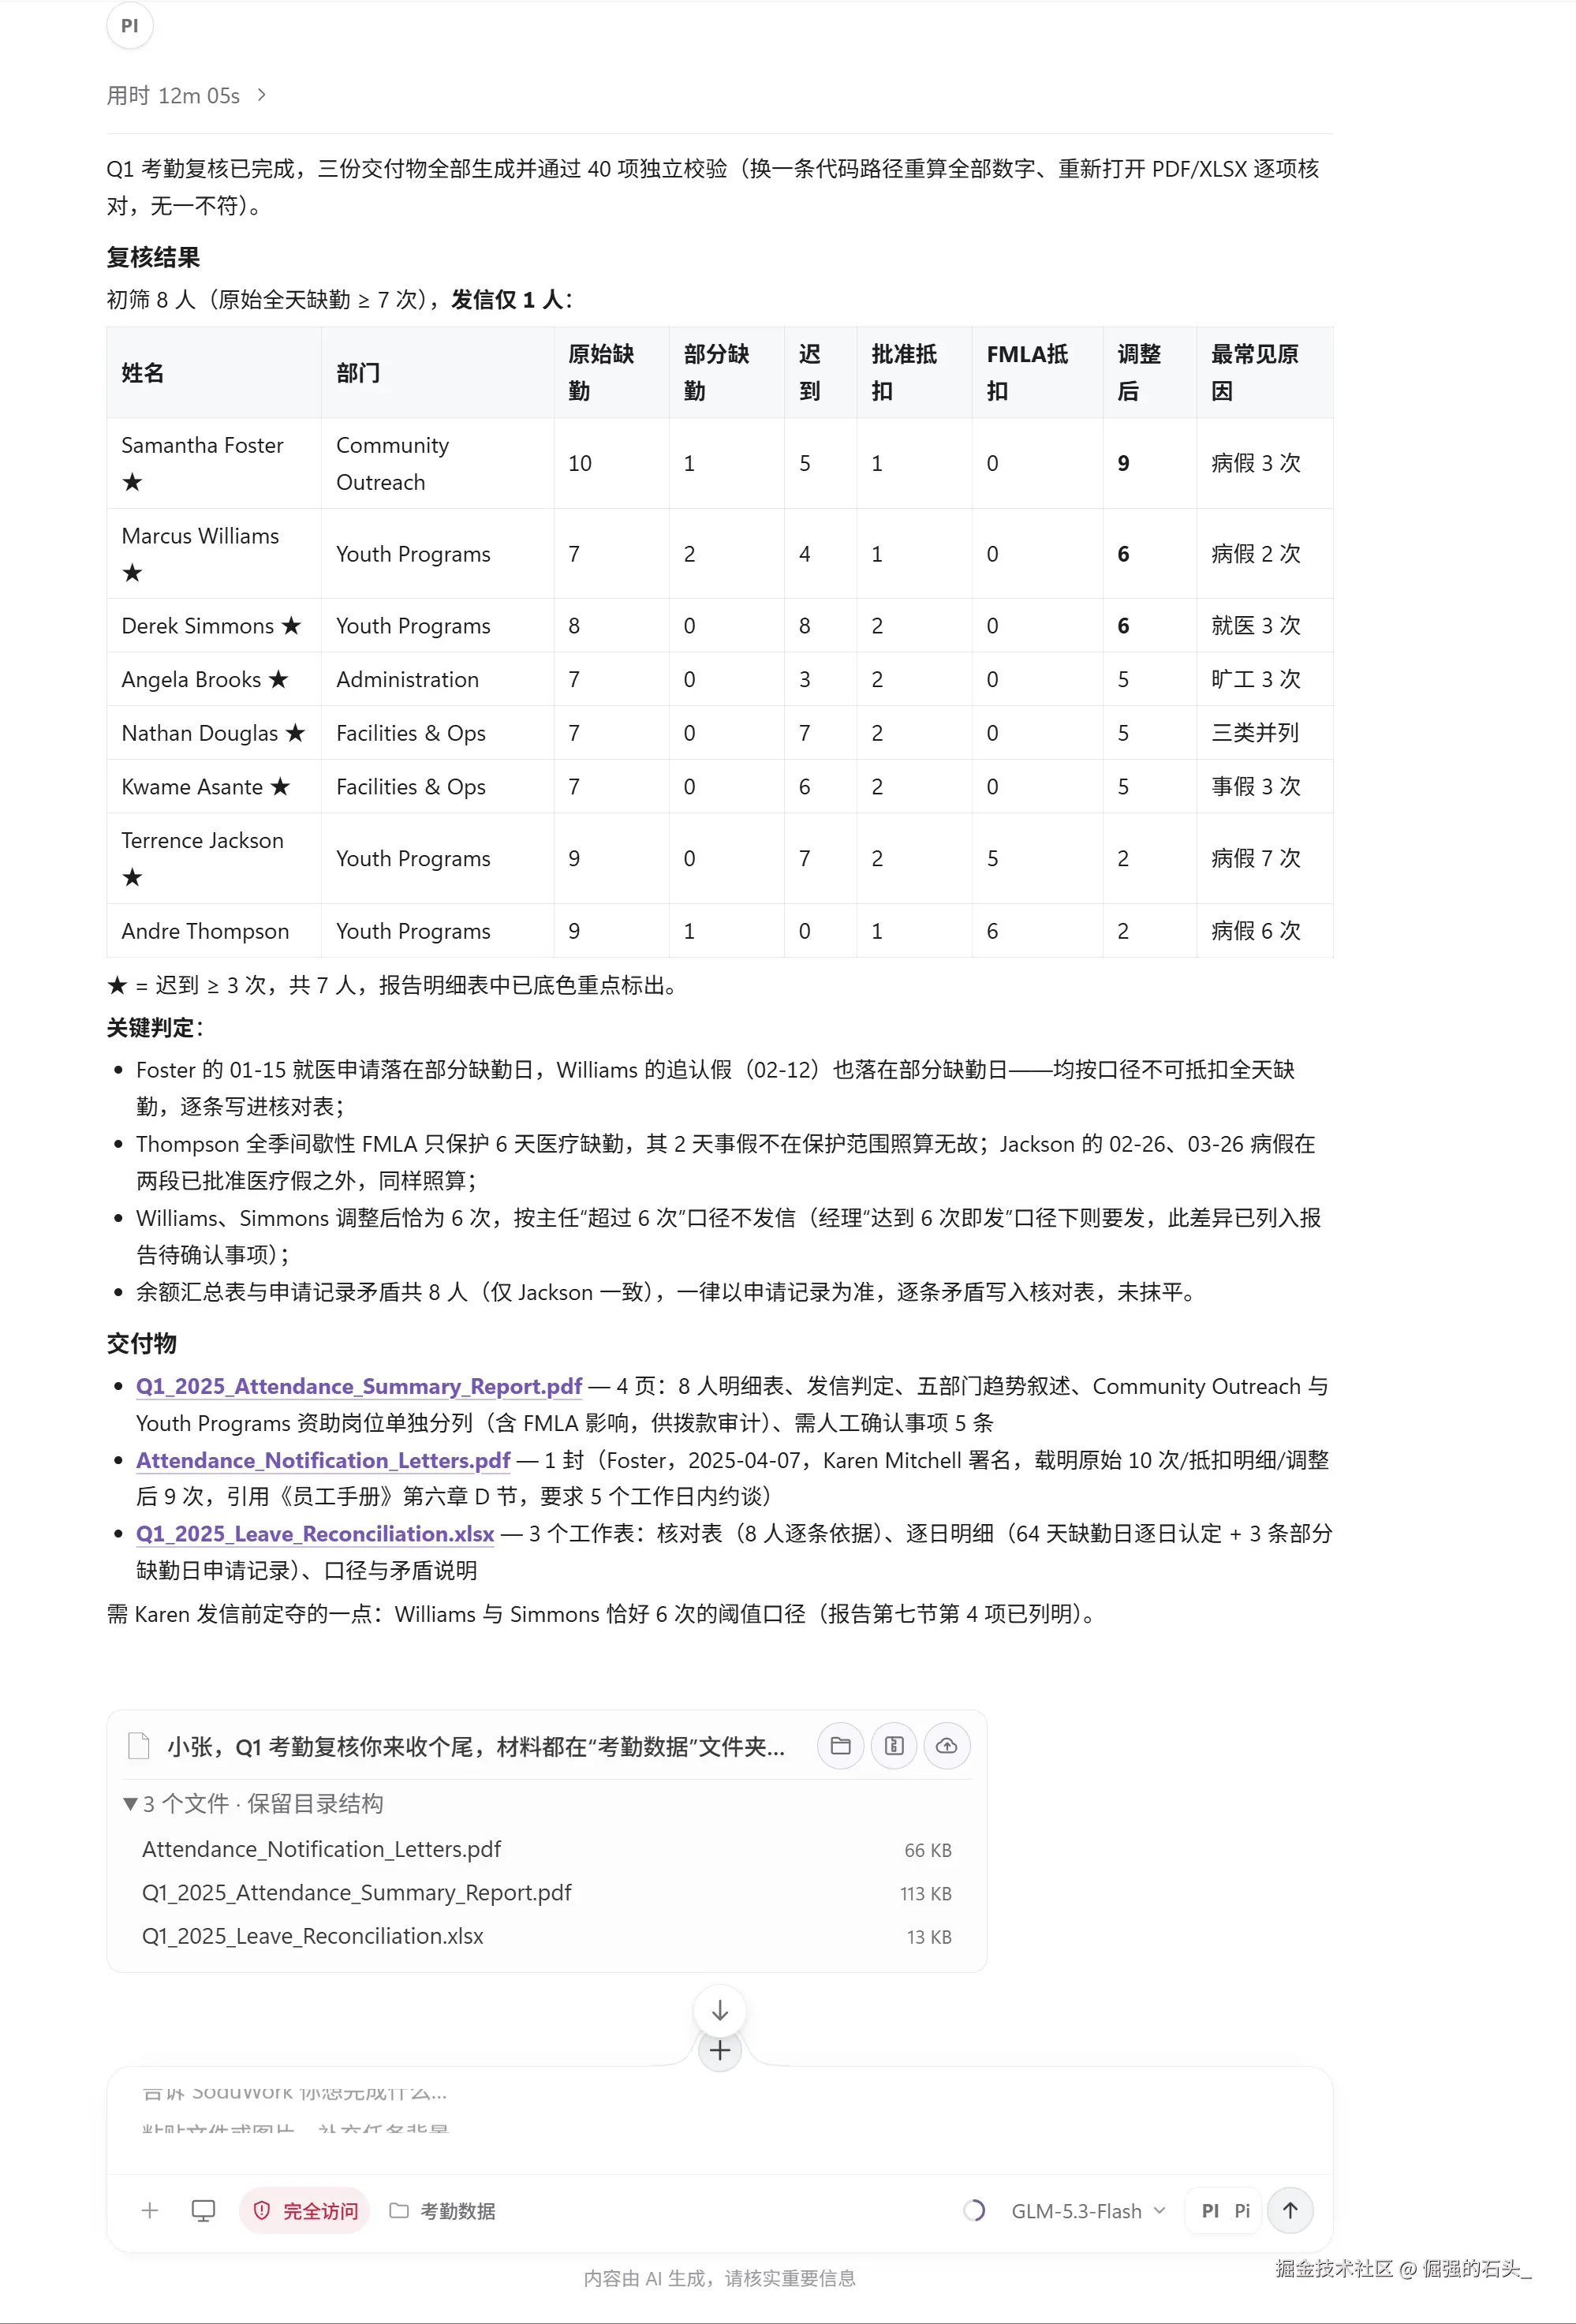
小张,Q1 考勤复核你来收个尾,材料都在"考勤数据"文件夹:两份通知、每日考勤 CSV、已批准请假 XLSX(两个工作表)、员工数据库。注意:1)经理通知和主任通知都要读,两份不一致的地方以主任的为准(后发、职位更高);2)先按经理口径把原始全天缺勤达到 7 次的员工标出来,只统计状态为"缺勤"的记录,"部分缺勤"单独统计、不能抵扣全天缺勤,请假申请落在部分缺勤那天的也不能抵;3)发通知信前先做抵扣:已批准的假期要减掉,标注"批准-追认"且在缺勤发生后 48 小时内完成追认的视同事先批准,同样减掉;FMLA 保护的缺勤也减掉,但 FMLA 只保护病假、就医这类医疗原因的缺勤,事假不受保护,要逐条判断每个人的每一次缺勤;4)通知信只发给调整后无故缺勤超过 6 次的员工,不要把按 7 次标出来的所有人都发;5)请假余额汇总表和逐条申请记录对不上时,以申请记录为准,并且要把矛盾明确写进核对表,不许悄悄抹平;6)交付三样东西:汇总报告 PDF,含被标出员工表(姓名、员工编号、部门、原始全天缺勤、部分缺勤数、迟到次数、已批准扣减、调整后无故缺勤、最常见缺勤原因)和各部门考勤趋势叙述,其中 Community Outreach 和 Youth Programs 两个部门要单独列一节,拨款审计要看;通知信 PDF,每封写明具体缺勤次数、引用《员工手册》第六章 D 节、由 Karen Mitchell 署名、日期 2025 年 4 月 7 日;请假核对表 XLSX,逐人写明抵扣依据。另外被标出员工里迟到达到 3 次及以上的,在报告里重点标出。
结果:全对 。发信 1 封、每人的调整后缺勤数与标准答案一致,用时 12 分 05 秒,还自己做了 40 项独立校验。代价也很直白:这 600 多字不是新人写得出来的,每一条都是老员工上次踩过的坑。
6.3 第三组:新人一句话 + 插件
提示词只比第一组多了半句:
"请使用「季度考勤复核」完成下面的工作:帮我做 2025 年第一季度的考勤复核,材料在工作区的'考勤数据'文件夹里。"
结果:全对,而且最快 (8 分 51 秒)。发信仅 Samantha Foster 一人(调整后 9 次);Thompson 的 7 天医疗缺勤受 FMLA 保护、2 天事假照算------正是第一组算错的那个点;两处"请假落在部分缺勤日不抵扣"的陷阱全部按口径处理;余额表 3 处矛盾逐条写进核对表。插件方法里的三道关卡(脱离脚本重读考勤 CSV 逐日比对、独立重算核对、交叉校验三项 PASS)全部通过,最后还留了一份工作底稿,里面是通知合并对照表和每个阈值参数的出处。
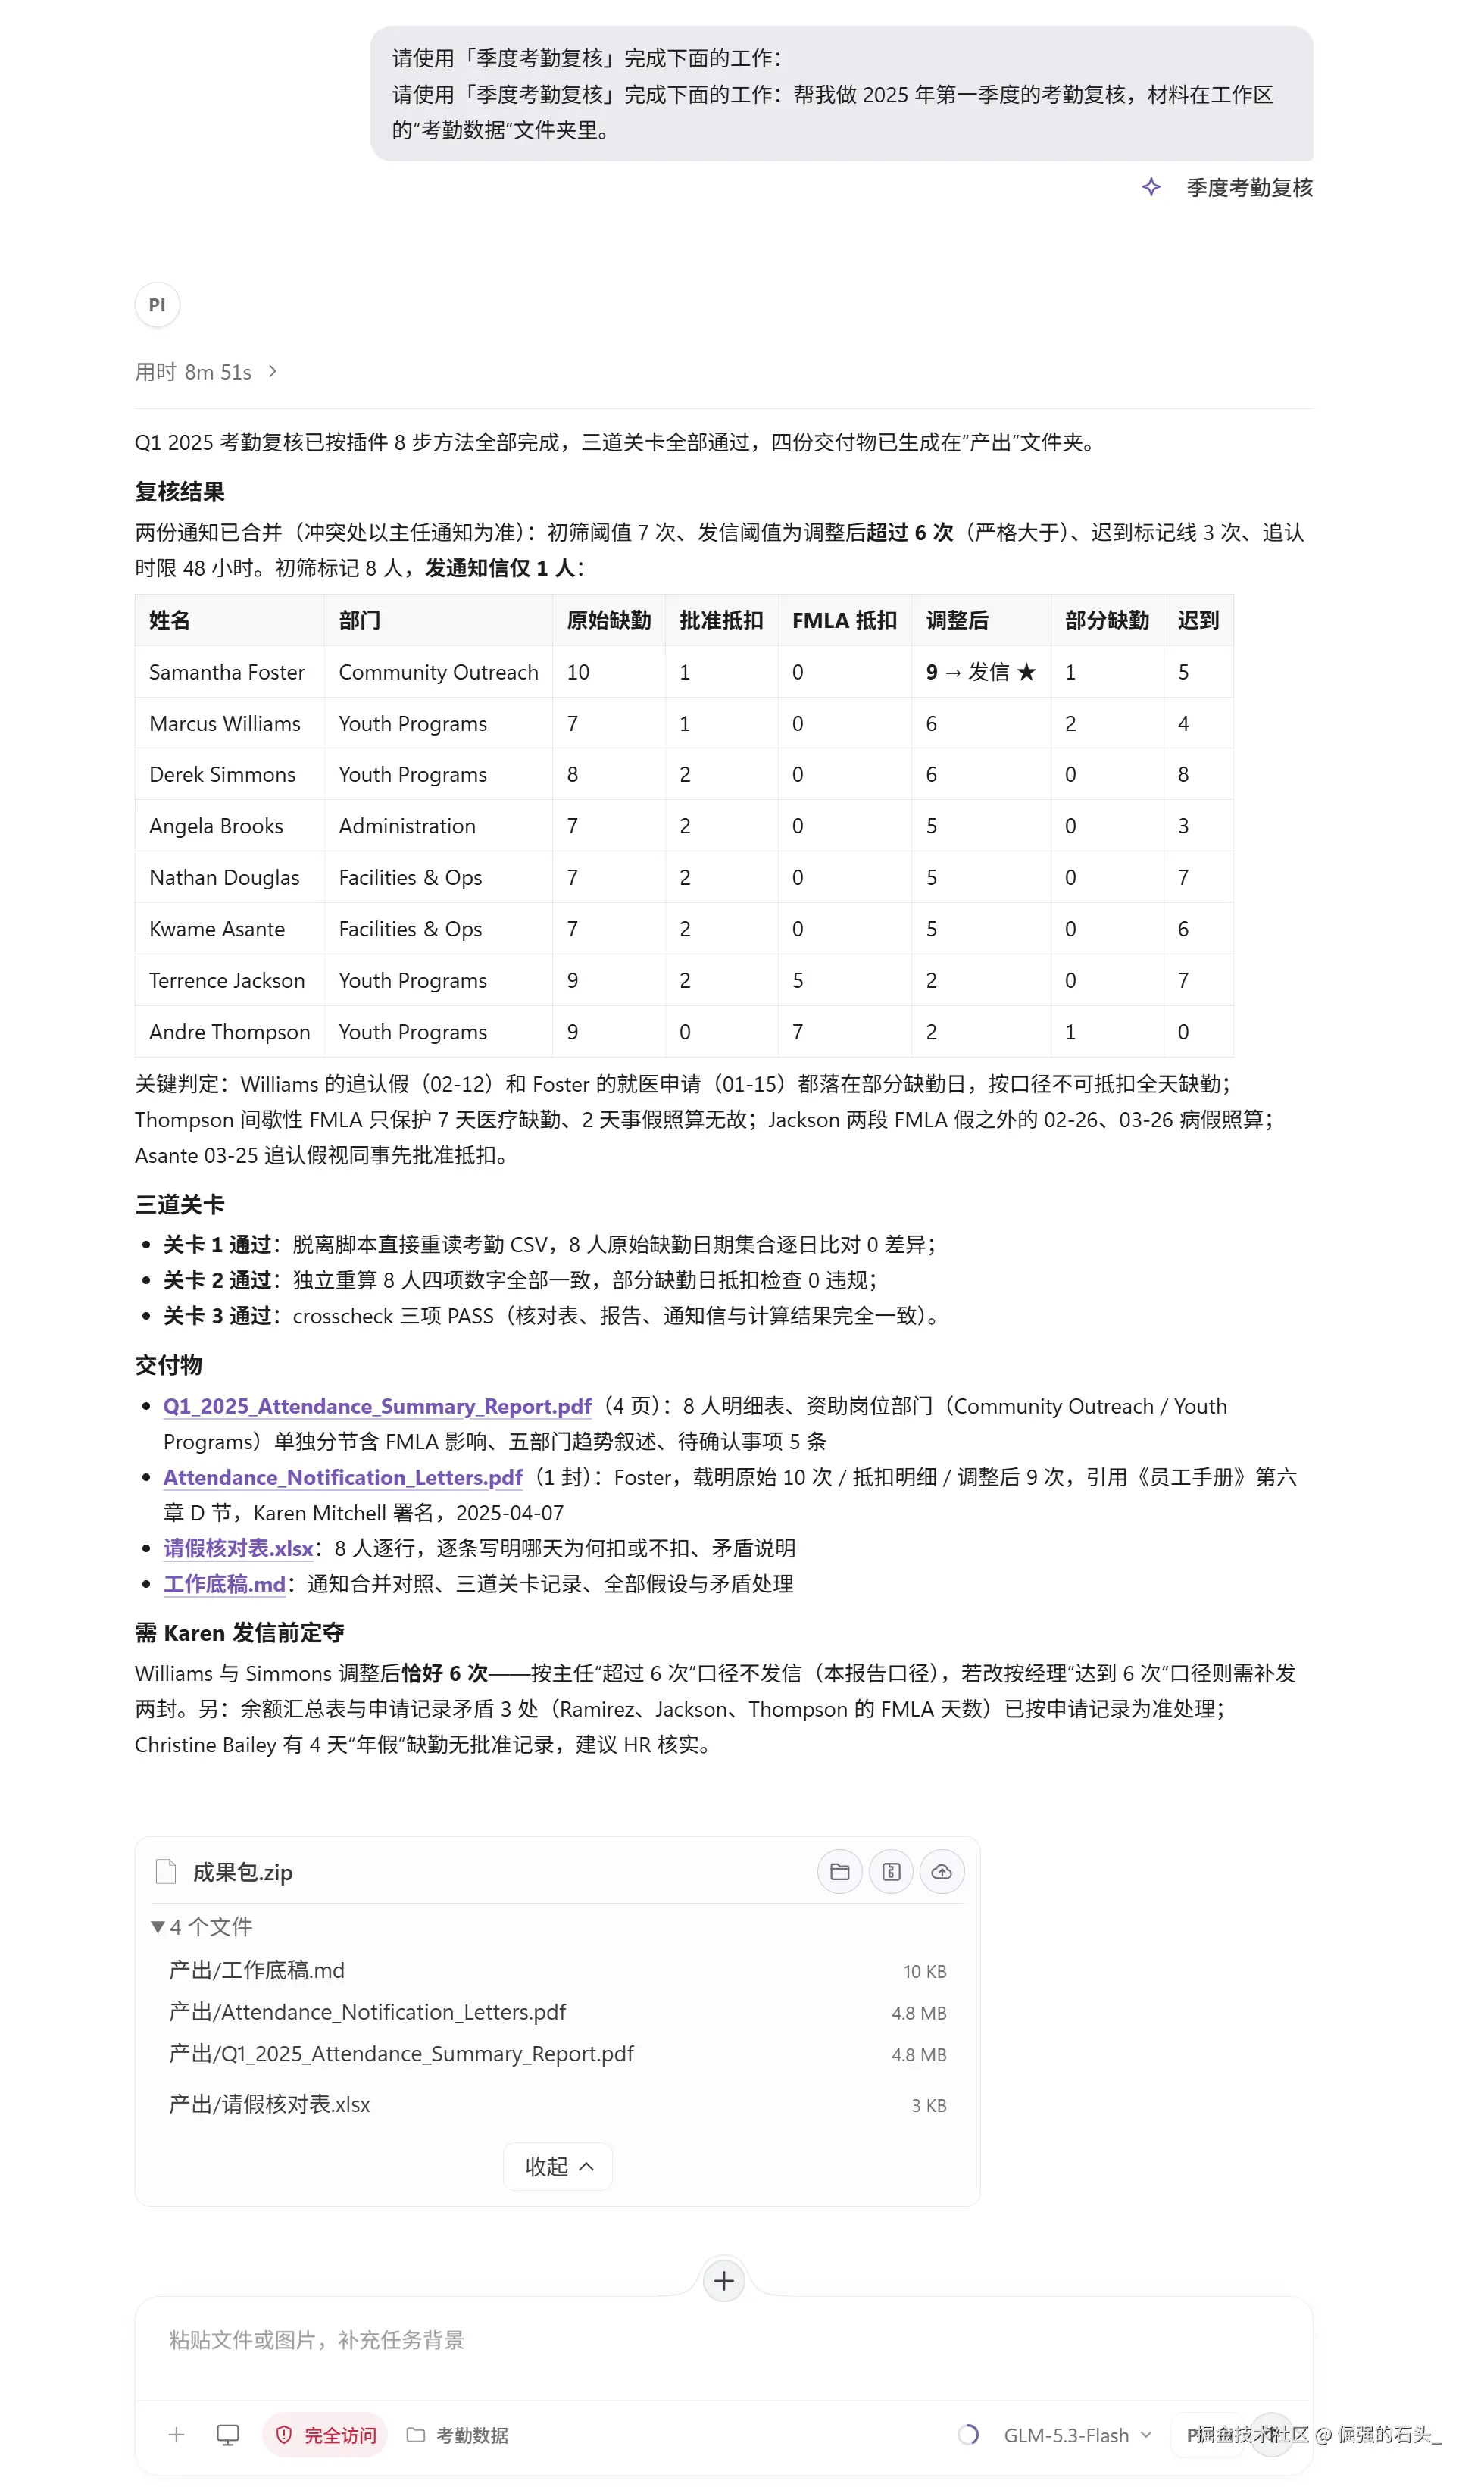
三组对比放在一起,方向 B 的题眼就出来了:经验资产化的价值不是让 AI 更聪明,而是让"老员工怎么把事做对"变成新员工一句话就能调用的标准流程,且每一步可审计。
七、换账号验证:资产要能给别人用才算数
插件装在我自己的账号里,别的同事能用吗?我在管理后台新建了一个普通成员账号(无管理角色),退出登录用新账号进来。
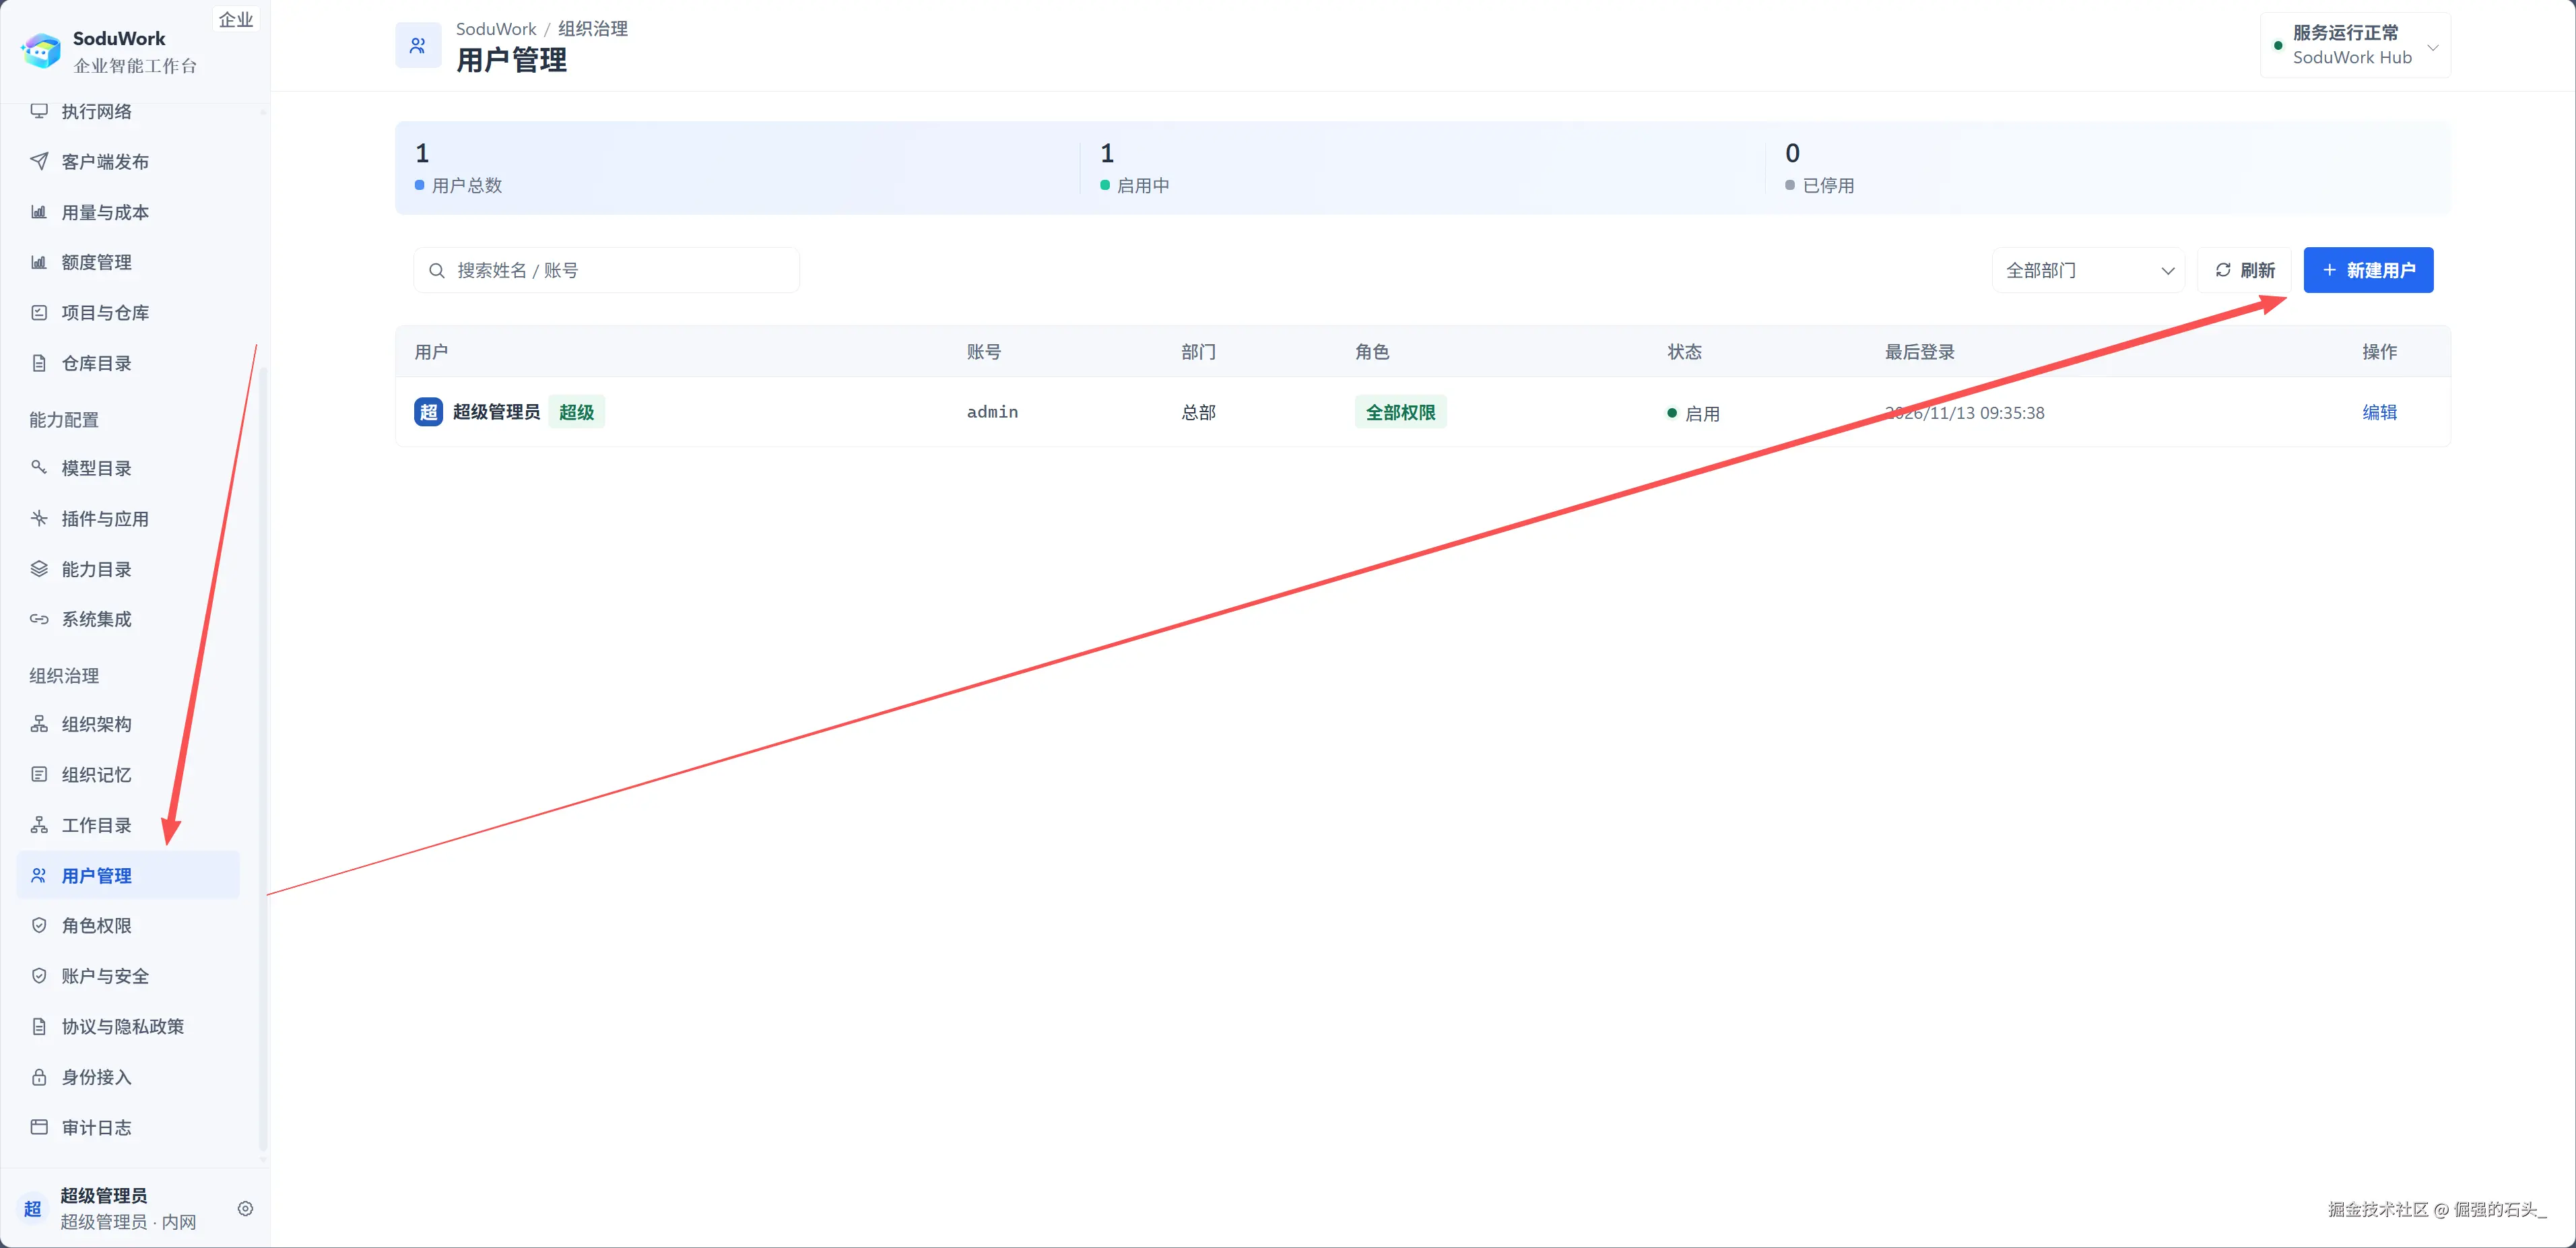
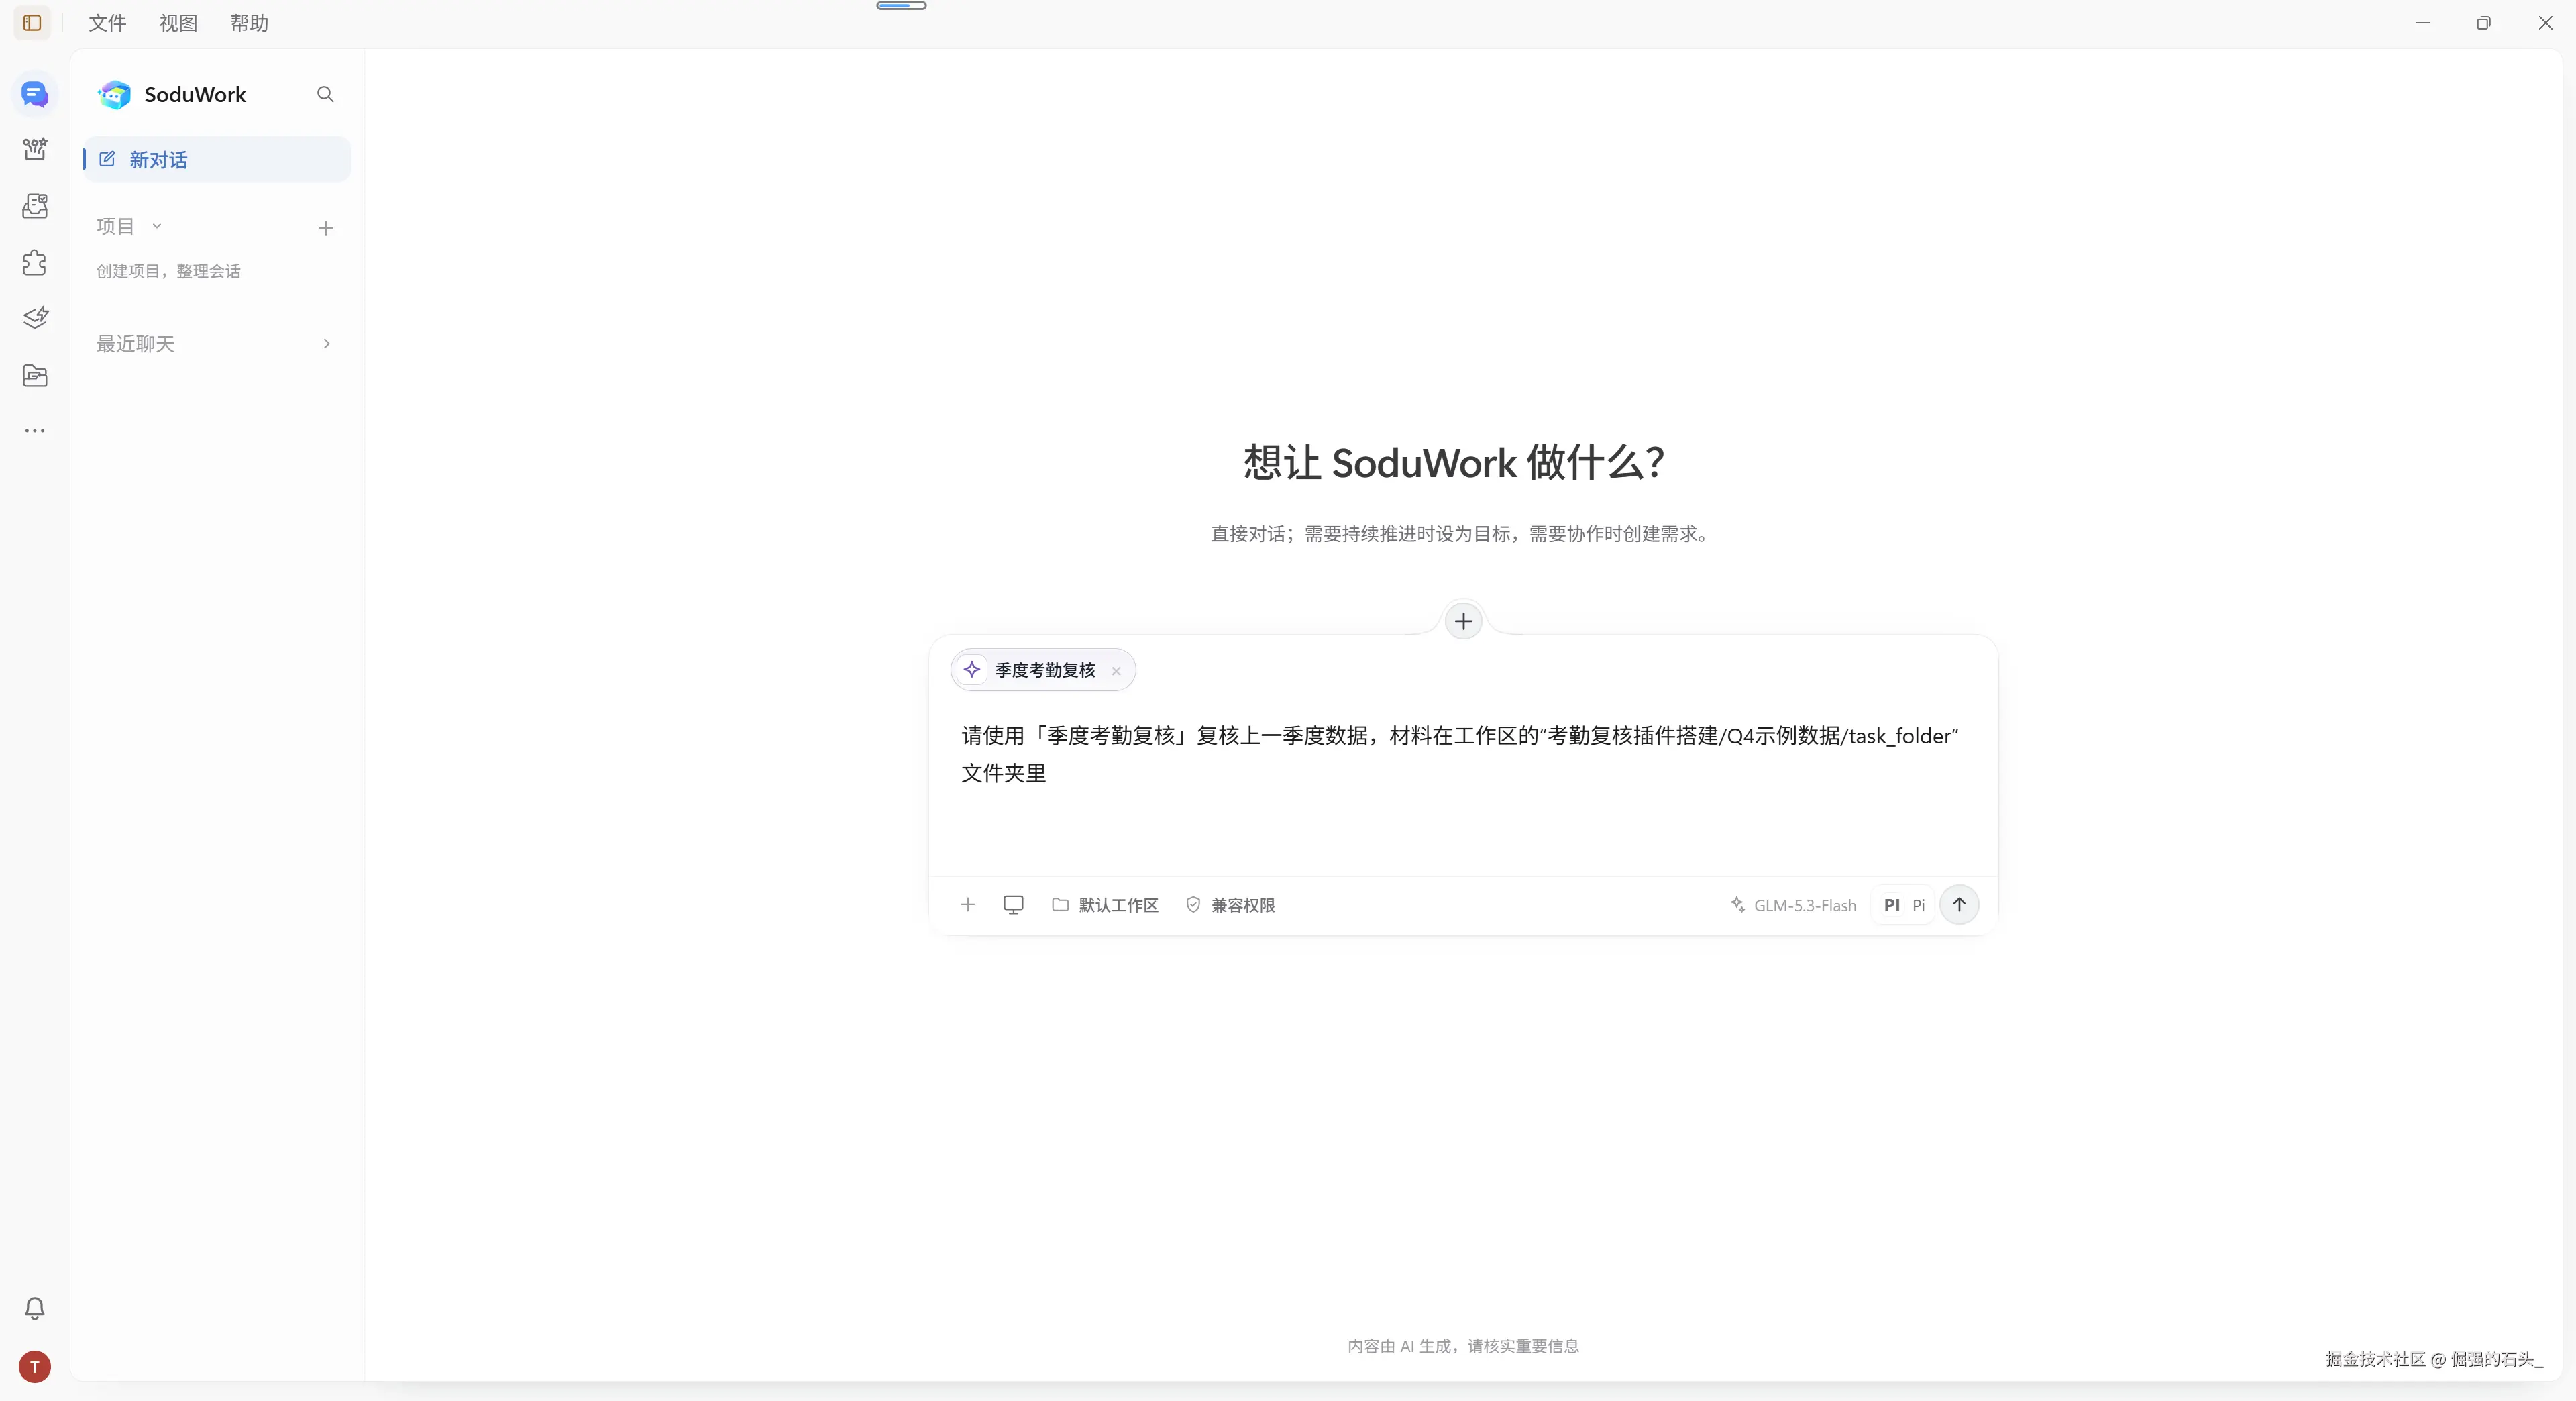
新账号登录后打开对话,插件一栏里同样能看到并挂载"季度考勤复核":
我把上一季度的练习数据交给它,6 分 05 秒跑完:发通知名单 2 人(编号 1007、1014),与练习数据的标准答案完全一致;三道关卡全部通过;"需人工确认的假设"也如实列出(请假记录无追认时间列,按 48 小时内视同事先批准处理):
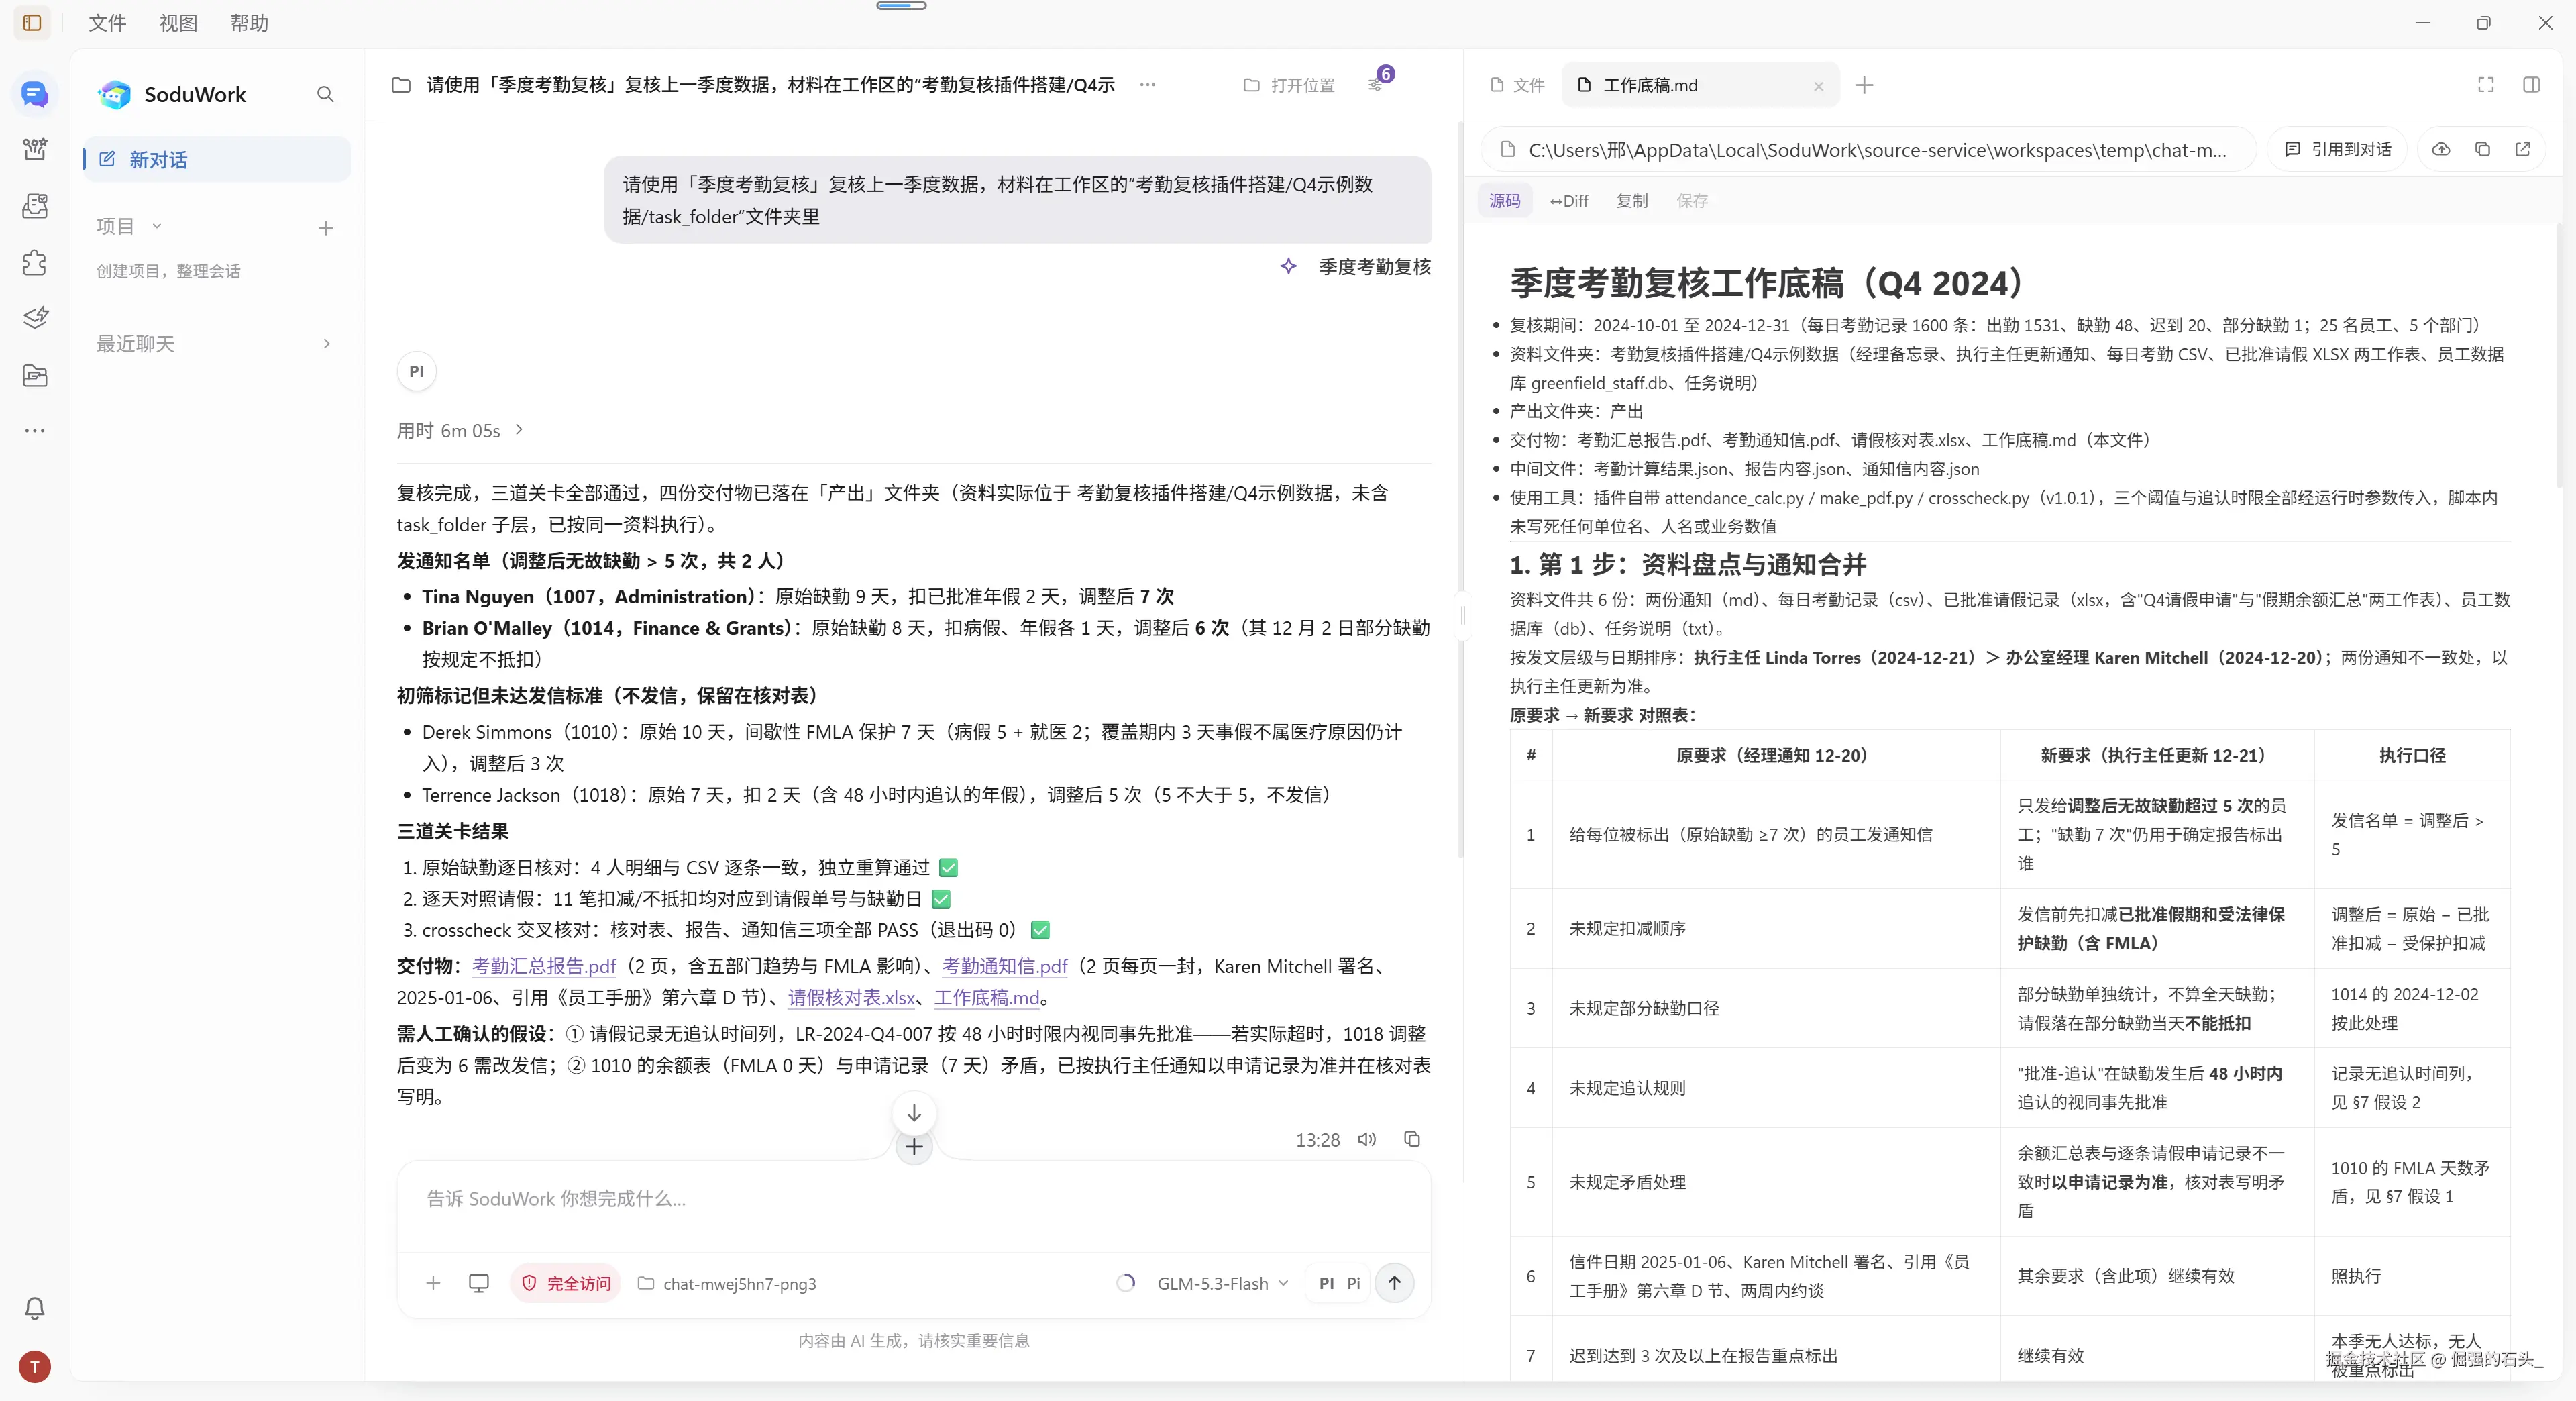
一个插件,两批数据、两个账号,四次运行,关键判定全部与标准答案一致。这就是我理解的"经验资产":人不在线,方法在线。
八、问题与建议
如实说几个我在意的问题:
- 文件操作层面没有防呆。我自己复制员工数据库时产生过 0 字节文件,AI 这次发现了,但如果遇到不主动检查的场景,坏文件会被静默带进任务。建议对"关键输入文件为空"给出硬性警告。
- 插件目前以个人安装为主,团队分发路径(个人插件 → 组织审核 → 全员可见)我这次没有完整走完,流程细节有待熟悉;这是下次想补的实测。
九、适合谁 / 不适合谁
适合:有重复性专业流程(复核、对账、巡检、周报口径)的团队;想把自己或老员工的方法沉淀成组织资产的人;需要 AI 产出可审计、可交接(工作底稿、参数出处、关卡记录)而不是"看起来做完了"的场景。
不适合:只想随手问答、不关心流程沉淀的个人轻量使用;对交付过程没有验收要求的场景------那用任何对话工具都一样,体现不出差别。
十、结尾
模型半年一换代,员工一调岗,散在聊天记录里的技巧就跟着清零。这次实测给我的启发是:值得沉淀的不是某次对话的答案,而是"这件事怎么做才算做对"的判断标准------它比任何单一模型都活得久。
如果你也想试试"AI 干活、人验收"这套流程:
- GitHub 仓库:
https://github.com/mdiri-ai/SoduWork(MIT 协议,客户端、服务端、管理端完整开源)
觉得思路有意思可以先 Star 一个,跑通之后有任何问题直接提 Issue,作者在看。README 里有快速上手指引,照着走大概一杯咖啡的时间就能跑起你的第一个对话。
附:数据与许可声明
- 本文为受邀评测,观点基于实际体验;文中所有实测数据、截图均来自本人在自己设备上的真实操作记录
- 官方案例说明中的参考成绩(74.6 分/183 秒等)为项目方口径,本文所有成绩、用时均为本人实测口径,两者未混用