数据库性能优化:一次慢查询背后,可能不只是SQL的问题
做数据库相关开发,有一个现象其实挺有意思:项目刚上线的时候,大家都觉得数据库没什么问题。接口响应快,SQL 执行也正常,平时除了备份和简单的监控,基本不需要花太多时间关注数据库。
但运行一段时间之后,情况就不一样了。
订单表从几十万条涨到几千万条,后台多了几个统计页面,原本每隔几分钟执行一次的批处理任务也开始频繁运行。某天业务人员突然反馈,订单列表打开要等好几秒。开发人员看了一下日志,发现接口没有报错,数据库连接也正常,就是查询时间明显变长了。
这种问题其实很难通过一个简单的操作解决。
有时候是索引没有建好,有时候是统计信息发生变化,还有些情况,SQL 本身没有明显问题,但数据库正在等待磁盘完成数据读取。甚至还有一种情况,数据库执行得并不慢,真正拖慢接口的是应用程序反复查询数据库。
所以,遇到数据库性能问题,我不太建议第一时间就去调整内存参数。先把整个查询过程弄清楚,往往比直接修改配置更有效。
这篇主要聊几个实际项目中比较容易碰到的问题,也结合电科金仓 KingbaseES 的使用场景,整理一下从 SQL 到存储层的排查思路。 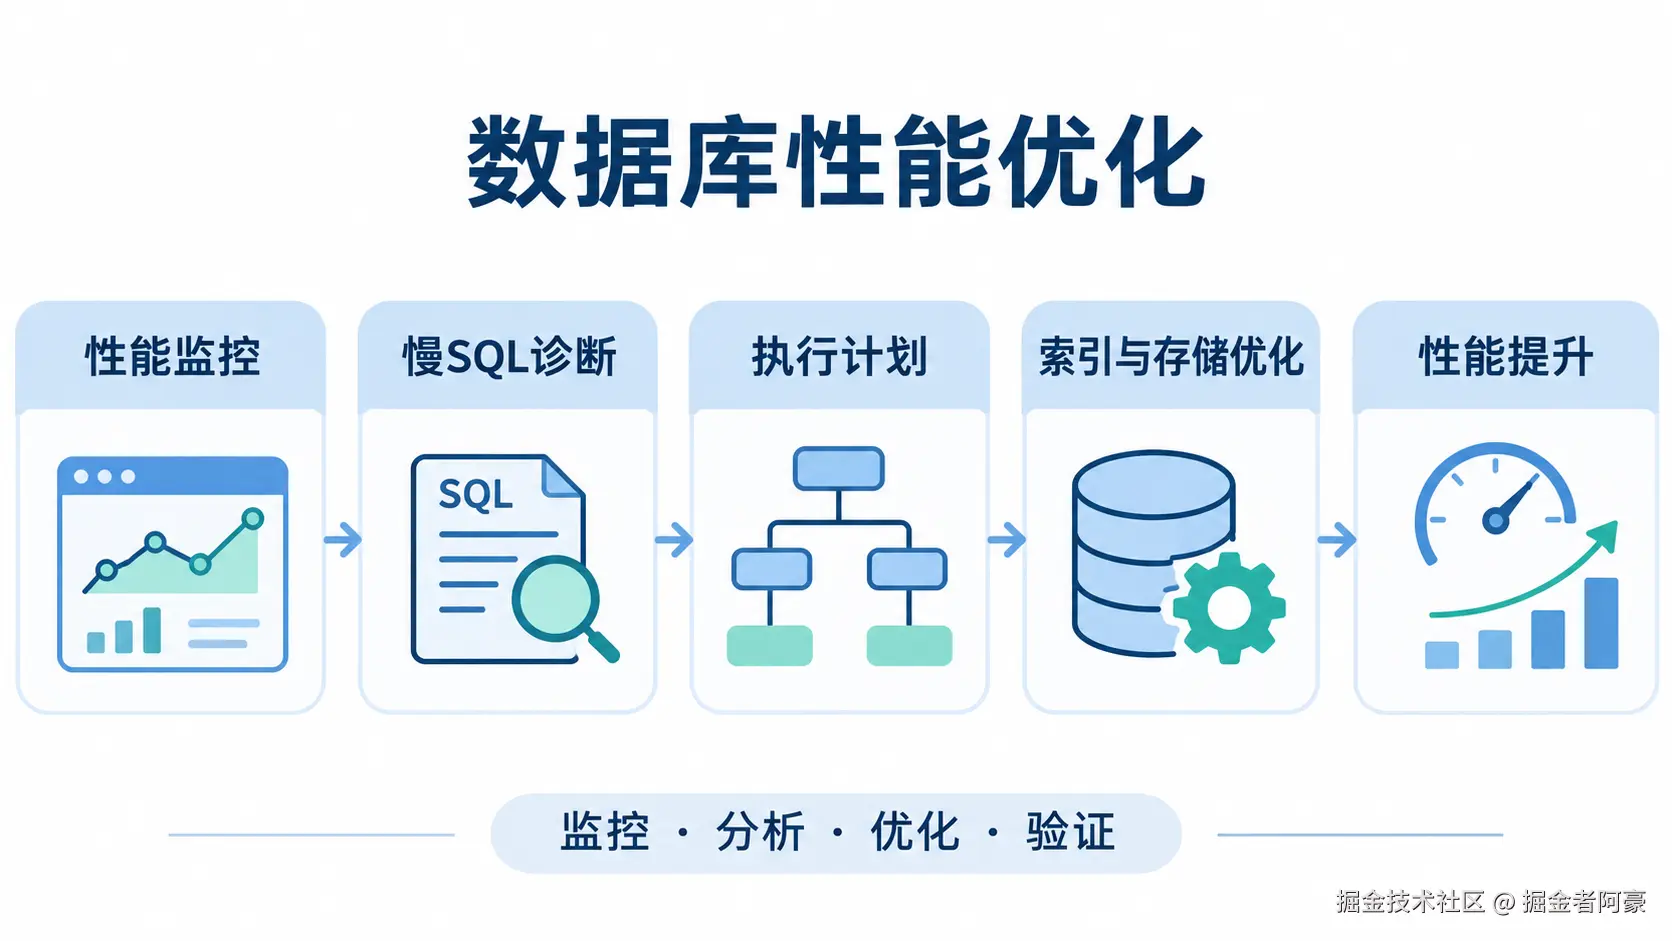
一、同一条SQL,为什么数据量增加后就不一样了?
先看一个比较普通的订单查询:
sql
SELECT
    id,
    order_no,
    user_id,
    amount,
    create_time
FROM orders
WHERE user_id = 10001
ORDER BY create_time DESC;
这条 SQL 没有什么特别复杂的地方。
如果 orders 表只有几千条数据,即使没有针对 user_id 创建索引,查询也可能很快完成。但当数据增长到几千万条,数据库需要处理的数据量就完全不同了。
这里有个容易被忽略的地方:SQL 没变,不代表数据库实际执行的工作量没变。
假设最初表里只有5000条订单,后来增长到了5000万条。原来一次顺序扫描就能完成的操作,现在可能需要读取大量数据页。
这时候有人会直接给 user_id 加索引:
sql
CREATE INDEX idx_orders_user_id
ON orders(user_id);
确实有可能解决问题,但我一般不会只做到这里。
因为这条 SQL 还有一个排序条件:
sql
ORDER BY create_time DESC如果查询返回的记录比较多,数据库可能还需要额外执行排序操作。
因此,可以进一步评估组合索引:
sql
CREATE INDEX idx_orders_user_time
ON orders(user_id, create_time);
对于 user_id 等值查询,并按照 create_time 排序的场景,这种索引设计通常更有针对性。
不过,索引是否真正生效,不能只看创建语句有没有执行成功。还要看优化器最终选择了什么执行计划。
二、我更习惯先看执行计划,而不是先改SQL
有时候一条 SQL 看起来很普通,真正的问题却藏在执行计划里。
在 KingbaseES 中,可以通过 EXPLAIN 查看优化器选择的执行路径:
sql
EXPLAIN
SELECT
    id,
    order_no,
    amount,
    create_time
FROM orders
WHERE user_id = 10001
ORDER BY create_time DESC;
如果需要了解实际执行情况,可以使用:
sql
EXPLAIN ANALYZE
SELECT
    id,
    order_no,
    amount,
    create_time
FROM orders
WHERE user_id = 10001
ORDER BY create_time DESC;
这里我比较关注几个地方。
一个是扫描方式。有没有出现不必要的大范围顺序扫描?
另一个是排序。查询明明已经有合适的索引,为什么执行计划中还出现了额外的 Sort?
还有一个经常被忽略的地方,就是优化器估算的记录数和实际返回的记录数是否接近。
例如,执行计划预计返回20条记录,实际却返回了几万条,那么后续执行节点的成本估算就可能出现偏差。
这类问题有时并不是 SQL 写得不好,而是数据库掌握的数据统计信息不够准确。
比如一张订单表刚完成批量导入,原来的数据分布已经发生明显变化,但统计信息还没有及时更新。
可以执行:
sql
ANALYZE orders;更新统计信息后,再次查看执行计划。
有些查询在更新统计信息之后,执行路径就会发生变化。
这里需要说明一点:看到 Seq Scan 不要马上认为索引失效。对于小表,或者需要返回大部分数据的查询,顺序扫描本来就可能是更合适的选择。
数据库优化器考虑的是执行成本,不是单纯比较有没有使用索引。
三、有些索引建了也没用,问题出在查询写法上
这个问题在业务系统中比较常见。
尤其是后台管理系统,开发人员为了方便,经常会在 WHERE 条件中对字段进行格式转换。
例如:
sql
SELECT *
FROM orders
WHERE TO_CHAR(create_time, 'YYYY-MM-DD')
      = '2026-11-16';
从业务角度来看,这样写非常直观,查询某一天的订单也很容易理解。
但从数据库执行角度看,查询条件对 create_time 做了函数处理,普通索引不一定能够直接用于原始字段的范围定位。
通常可以改成:
sql
SELECT *
FROM orders
WHERE create_time >= TIMESTAMP '2026-11-16 00:00:00'
  AND create_time <  TIMESTAMP '2026-11-17 00:00:00';
这个写法还有一个好处,就是不会遗漏当天最后一秒之后的高精度时间记录。
如果业务系统中有大量按照日期查询的 SQL,我会优先检查这类条件。
另外,还有一个经常出现在后台管理系统里的问题:分页。
sql
SELECT *
FROM orders
ORDER BY id
LIMIT 20 OFFSET 100000;
刚开始分页很快,翻到后面几千页就明显变慢。
原因在于数据库需要处理前面大量记录,再跳过指定数量的数据,最终只返回20条。
如果业务允许使用唯一且递增的 ID 作为游标,可以改成:
sql
SELECT *
FROM orders
WHERE id > 100000
ORDER BY id
LIMIT 20;
如果按照创建时间倒序查询,最好再加一个唯一 ID 作为辅助排序字段,保证分页顺序稳定。
这类优化在订单列表、操作日志、消息记录等数据量较大的页面中比较实用。
四、索引太多,同样会影响数据库性能
索引优化还有一个容易走向另一个极端的情况:为了提高查询速度,不断增加索引。
刚开始给 user_id 建一个索引,发现某个状态查询慢,又增加 order_status 索引。后来发现日期查询慢,再加一个 create_time 索引。
时间长了,一张业务表上可能有十几个索引。
查询的时候看起来索引很多,但写入数据时,数据库需要同步维护这些索引结构。
例如订单表每天新增几百万条记录,每次 INSERT 不只是写入表数据,还需要维护相关索引。
UPDATE 如果修改了索引涉及的字段,也可能产生额外的索引维护开销。
因此,索引设计最好从真实 SQL 出发。
我通常会先整理这张表最频繁的几类查询:
- 用户查询订单。
- 按订单状态筛选。
- 按创建时间查询。
- 按订单编号精确查询。
- 后台按照用户和时间组合查询。
然后再看哪些查询可以通过同一个组合索引覆盖,哪些查询确实需要单独索引。
还有一点,索引创建完成后,不建议马上把它当作有效优化成果。最好在相近的数据量和业务负载下,对比执行计划和响应时间。
毕竟,索引占用的是实实在在的存储空间,维护成本也是真实存在的。
五、SQL看着正常,数据库却一直在等磁盘
有一次排查数据库性能问题时,最容易让人产生误判的就是这种情况:SQL 没有明显错误,执行计划也没有特别异常,但查询就是快不起来。
这时候需要把排查范围扩大到操作系统。
数据库查询并不意味着所有数据都在内存中。如果需要访问的数据页不在缓存里,就需要从存储设备读取。
如果磁盘本身响应较慢,或者多个业务同时进行大量读写操作,数据库就可能花费大量时间等待 I/O。
Linux 环境可以先执行:
bash
# 查看磁盘I/O状态
iostat -x 1 5

# 查看内存使用情况
free -h

# 查看系统运行状态
vmstat 1 5

# 查看磁盘空间
df -h
这里我会重点关注 await、读写吞吐量、设备队列以及系统是否出现 Swap。
比如数据库运行在云服务器上,磁盘 IOPS 有明确的规格限制。当业务高峰期的读写请求超过存储能力时,数据库就可能出现明显的等待。
这种情况,即使把 SQL 改得再漂亮,也很难完全解决。
还需要检查一个问题:数据库的数据文件、日志文件和其他业务是否共用同一块磁盘。
如果数据库旁边还运行着大量日志采集、文件处理或者备份任务,它们可能在高峰期争抢磁盘资源。
这时候应该从存储布局和资源隔离入手,而不是只调整数据库参数。
六、数据库内存参数,调大不一定就快
KingbaseES 中有几个内存参数,在性能调优时经常会接触到。
比如 shared_buffers、work_mem 和 maintenance_work_mem。
它们分别影响不同的数据库操作,不能简单地理解成统一的缓存空间。
先说 shared_buffers。
它主要用于数据库共享缓冲区。如果热点数据经常需要从磁盘读取,就需要结合缓存情况评估这个参数是否合理。
但也不能因为服务器有64GB内存,就直接把其中大部分都分配给数据库共享缓冲区。操作系统、数据库进程、排序操作以及其他服务都需要内存。
再看 work_mem。
这个参数主要影响排序、哈希连接等操作。
例如:
sql
SET work_mem = '32MB';

EXPLAIN ANALYZE
SELECT *
FROM orders
ORDER BY create_time DESC;
在测试环境中,可以观察调整前后排序是否仍然需要使用临时文件。
不过这里有个细节很容易被忽略:work_mem 不是整个数据库实例共享的一块固定内存。一个复杂查询可能包含多个需要工作内存的执行节点,而且多个会话可以同时执行查询。
如果并发较高,却把这个参数设置得过大,可能会造成严重的内存压力。
maintenance_work_mem 则更多与索引创建等维护操作有关。
比如数据量很大的表需要建立索引,就可以结合维护窗口和服务器资源评估这个参数。
我的看法是,数据库参数不要照搬别人的配置。相同的内存规格,如果一台数据库主要承担高并发短查询,另一台主要运行复杂报表,两者的资源分配策略就可能完全不同。
七、存储过程慢,不能只看接口调用时间
除了普通 SQL,数据库内部的存储过程也值得单独排查。
有些系统为了减少应用层和数据库之间的交互,会把一部分业务逻辑放到存储过程里。
这种方式在某些批量处理场景下有实际价值,但也容易出现一个问题:外部只调用了一次过程,内部却执行了大量 SQL。
例如:
sql
CREATE OR REPLACE PROCEDURE process_orders()
AS
BEGIN
    UPDATE orders
    SET order_status = 'EXPIRED'
    WHERE order_status = 'PENDING'
      AND create_time <
          CURRENT_TIMESTAMP - INTERVAL '7 days';

    COMMIT;
END;
/
这个过程比较简单,主要是批量更新过期订单。
但真实业务中的存储过程可能包含循环、查询、条件判断、函数调用和多次数据更新。
举个常见的情况:
sql
FOR item IN
    SELECT id, user_id
    FROM orders
    WHERE order_status = 'PENDING'
LOOP
    SELECT balance
    INTO v_balance
    FROM account
    WHERE user_id = item.user_id;

    -- 继续处理订单
END LOOP;
如果待处理订单有10万条,内部账户查询就可能执行10万次。
每一次查询单独看起来都不慢,但累积起来,整个过程的执行时间就会非常明显。
这种情况通常可以从减少重复查询、合并批量操作以及缩小事务范围几个方向考虑。
在电科金仓 KingbaseES 的性能诊断场景中,除了查看普通 SQL,也可以结合 SYS_KSH 等诊断能力分析 Top PL/SQL、Top SQL、等待事件和锁等待情况。
这样排查时就不必只盯着外层接口,而是能够进一步了解数据库内部究竟在执行什么操作。
八、线上数据库出现锁等待,先不要急着杀会话
数据库性能问题不一定都来自查询效率。
有时候,某个事务执行时间过长,也可能影响其他业务。
例如,一个订单更新事务开始后,应用程序执行了其他业务逻辑,却一直没有提交事务。
此时其他会话可能需要等待相关锁释放。
可以从数据库会话和锁等待信息入手排查,确认:
- 哪个会话正在等待?
- 哪个事务持有相关锁?
- 事务已经运行多长时间?
- 是否存在程序异常导致事务没有及时提交?
这里不建议一发现等待就直接终止会话。
因为终止事务可能触发回滚,尤其是涉及大量数据修改时,回滚过程本身也可能消耗不少资源。
更稳妥的做法是先确定阻塞关系,再判断是否需要由业务人员确认终止。
对于 Java 应用,还应该检查事务注解和连接使用方式。
例如,是否在一个事务中执行了远程 HTTP 调用,是否在事务提交前进行了耗时文件处理,是否出现连接获取后长时间不释放的情况。
这些问题虽然发生在应用层,但最终都可能表现为数据库锁等待和连接资源紧张。
九、KingbaseES性能诊断,重点还是把信息串起来
前面提到的 SQL、索引、磁盘、内存和锁等待,其实都是数据库性能排查的一部分。
在电科金仓 KingbaseES 的实际运维中,我认为比较有价值的是把这些信息放到同一条分析链路中。
例如,某个订单查询突然变慢。
先通过执行计划确认查询路径有没有变化,再检查统计信息是否准确。如果执行计划没有明显异常,就继续观察数据库资源,看看是否存在磁盘等待或者内存压力。
如果发现数据库内部有大量 PL/SQL 调用,则进一步分析过程执行情况。
KingbaseES 提供的 SYS_KSH 性能诊断能力,可以辅助分析数据库活动情况,包括 Top SQL、Top PL/SQL、会话活动以及等待事件等信息。
对于运行时间比较长的业务系统,这类诊断信息的价值在于能够帮助 DBA 回看某个时间段内数据库的运行情况,而不是只能依赖故障发生时的现场日志。
实际使用时,具体诊断报告的生成方式和可用指标应以所部署的 KingbaseES 版本及对应工具文档为准。
我不太建议在生产环境中看到某个参数就直接修改。尤其是内存、连接数和日志相关配置,最好先在测试环境验证,再结合业务低峰期进行调整。
十、最后说说我对数据库优化的一点看法
数据库性能优化这件事,很多时候并没有想象中复杂。
真正麻烦的是找到问题发生的位置。
一条 SQL 慢,可能是索引问题,也可能是统计信息不准确;数据库整体慢,可能是资源不足,也可能是连接和事务管理不合理。
如果只从 SQL 层面看问题,很容易漏掉存储和应用程序的影响。
反过来,如果一看到数据库 CPU 高就升级服务器,也可能花了钱却没有解决根本问题。
我更倾向于保留每次优化前后的数据。哪条 SQL 有问题,执行计划是什么,调整了哪个索引,磁盘等待有没有变化,接口响应时间是否真正改善,都应该有记录。
这样下一次再遇到类似情况,至少有东西可以参考。
对于使用电科金仓 KingbaseES 的项目来说也是如此。执行计划分析、统计信息维护、索引设计、存储资源监控以及 PL/SQL 诊断,这些能力最终都要落实到具体业务问题上。
数据库优化没有一个通用参数模板,可以让所有系统都变快。
有些系统需要优化查询,有些需要调整存储,有些则应该回到应用程序检查事务和连接使用方式。
把问题找准,比一口气修改十几个参数更重要。