假设你手里有一张表:工单、评论、申请或客户资料。每天都要回答三个问题:哪些要优先看?分别属于哪一类?用户有多满意?
过去要么写关键词规则,要么把数据导出、找算法团队跑一遍、再导回来。Hologres 的 jev 能力把这一步放回数据查询:你写一句业务问题,它给你一个"是/否"、一个标签或一个分数。
它不写作文,也不聊天;更像一个坐在数据表里的业务规则助手,只在你给定的选项和等级里回答。
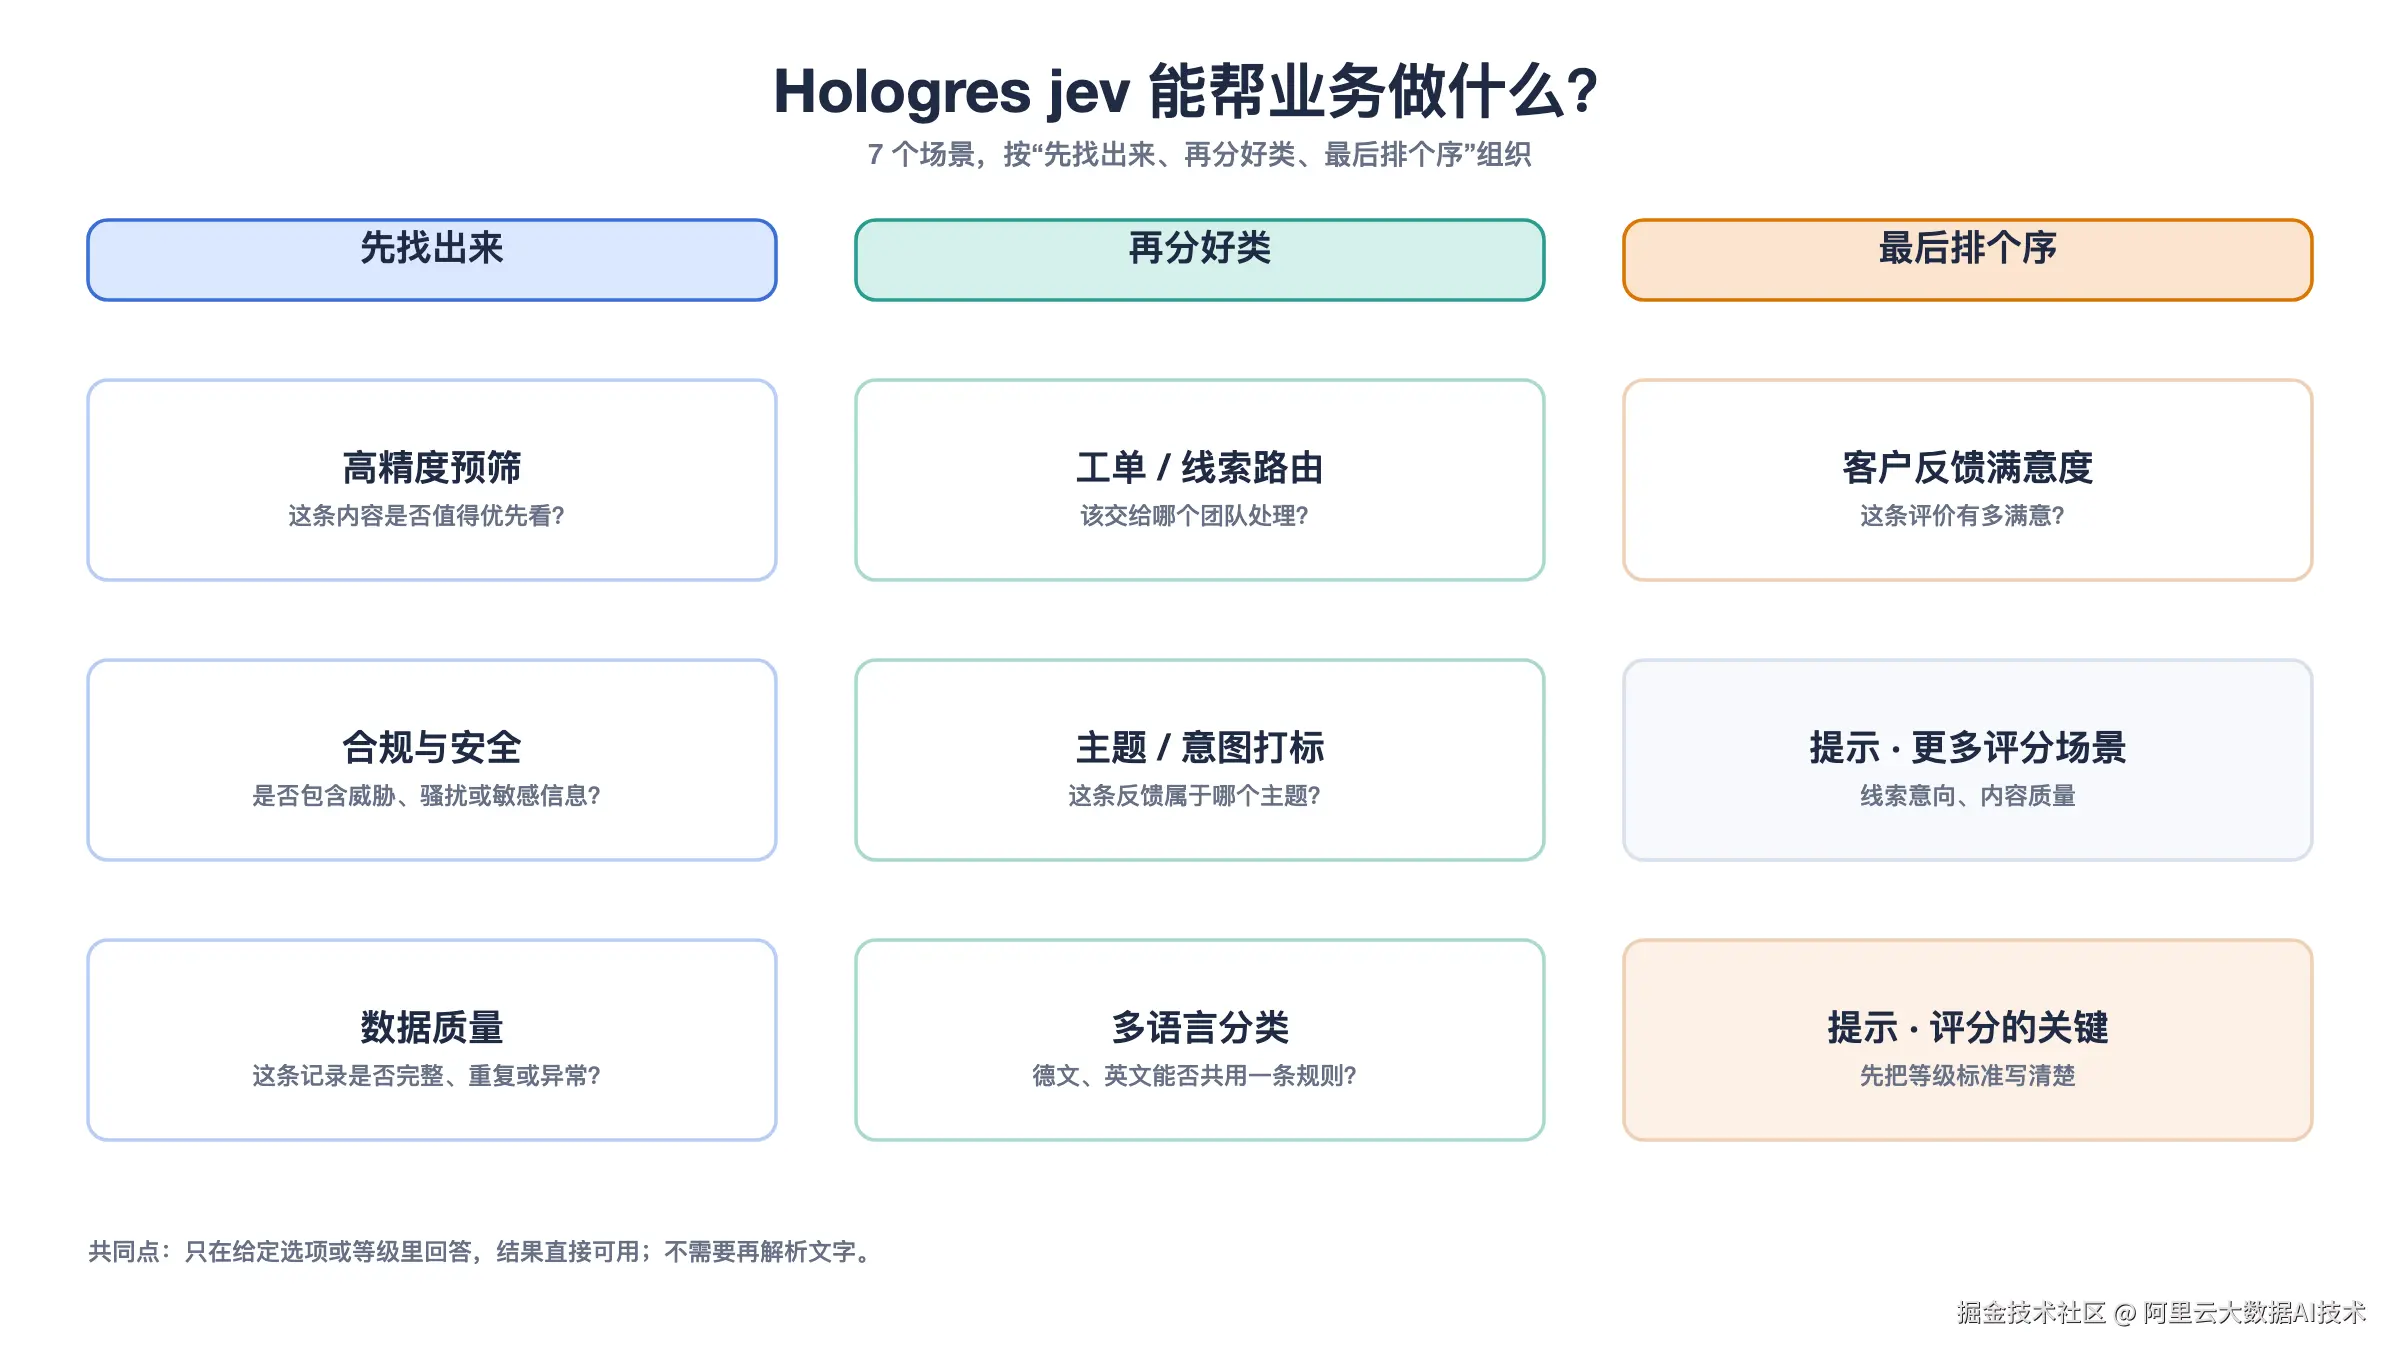
图 1:7 个场景,按"先找出来、再分好类、最后排个序"组织。
一句话理解 jev
jev 只回答三种问题:
| 你想问 | 它怎么回答 | 业务例子 |
|---|---|---|
| 要不要看? | 是 / 否 | 这条工单是不是账单问题? |
| 属于哪一类? | 你给的选项之一 | 该给技术、账务、销售还是其他? |
| 有多满意? | 你给的等级上的分数 | 这条评价有多满意? |
它和聊天机器人最大的区别是不自由发挥:你给几个选项,它只从选项里选;你给等级表,它只在等级上打分。所以结果不用再解析,可以直接用来筛选、分组、排序。
先找出来:从一堆数据里挑出值得看的
这是业务上最容易落地的场景:不要求 100% 准确,只要把人工复核名单缩小到可处理的量。
场景:2,000 条工单,只让 116 条进人工
客服主管每天早上要分配账单问题。用关键词,容易把"退款已经到账,但退件没人取"也抓进来,结果二次转派。
你可以这样问:"这条工单是否与账单、计费或扣款有关?"
它只回答是/否。把标准调严一点,2,000 条工单里只让 116 条进人工,116 条全是真问题;179 条真实账单问题里抓到 116 条,漏掉 63 条。
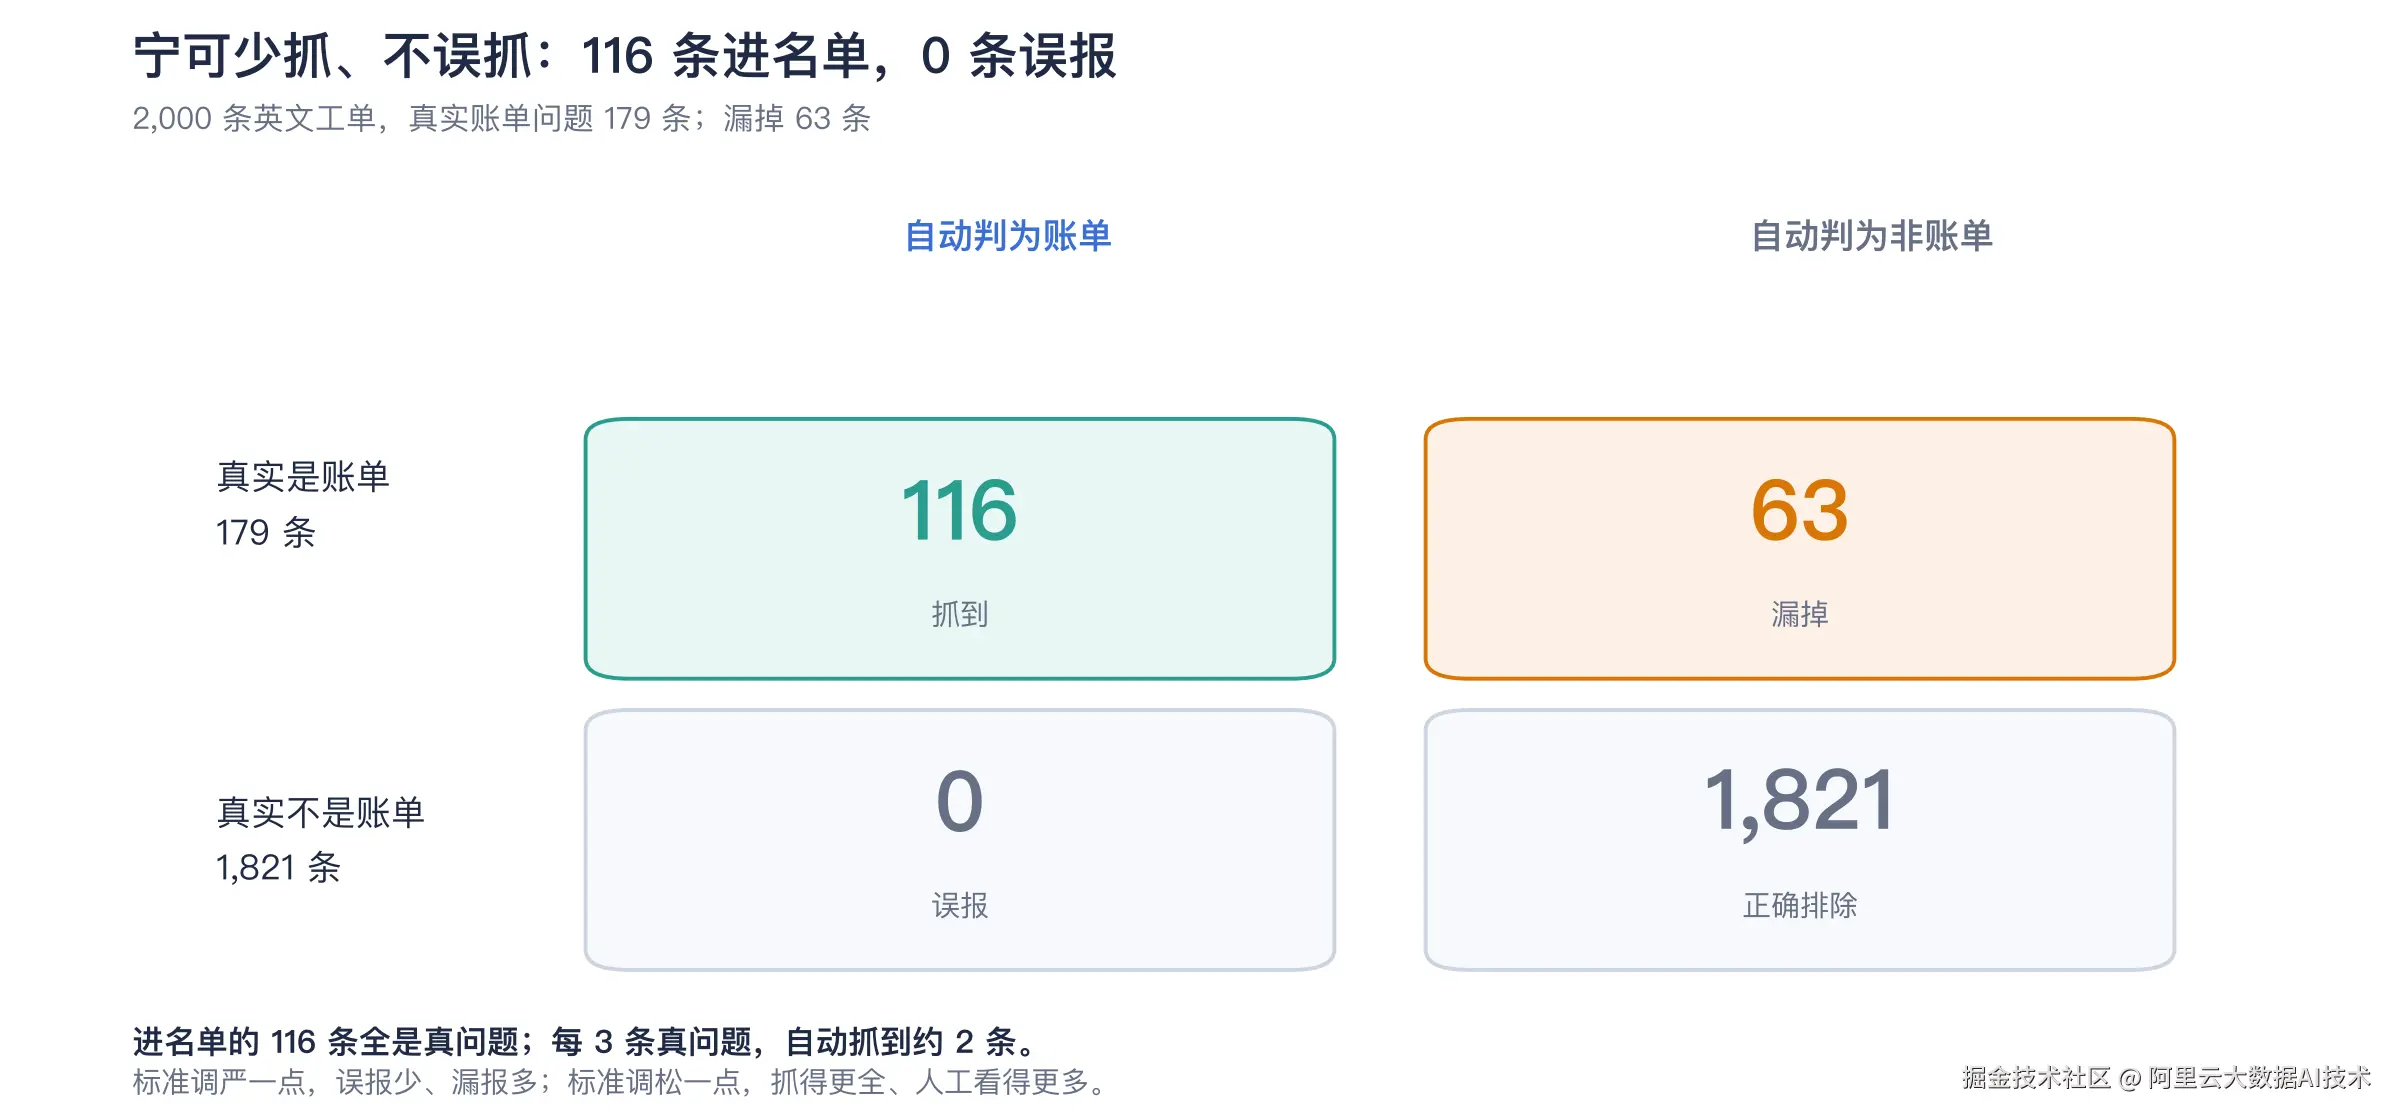
图 2:进名单的 116 条没有误报,漏掉 63 条真实账单问题。
标准严一点,误报少、漏报多;标准松一点,抓得更全、人工看得更多。先算清哪种代价更大。
谁会用 :客服主管、运营;产出:每天需要人工看的账单工单名单。
场景:安全 / 合规风险,先筛一遍再人工看
安全团队不可能逐条读所有工单。以前靠关键词和人工举报,隐含的威胁容易漏。
你可以这样问:"这条消息是否包含威胁、骚扰或敏感信息?"
300 行试点里,进名单的基本都值得看,但仍有 40% 的风险内容不会自动出现。它适合当"预筛",不适合当"唯一闸门"。
谁会用 :安全、合规团队;产出:待复核的风险消息清单。
场景:客户资料一致性检查
CRM 里公司名、地址、联系人经常对不上,运营不可能逐条核对。以前写校验规则,覆盖不全;人工抽查又太慢。
你可以这样问:"这条记录的公司名、地址、联系人和统一社会信用代码是否完整且互相一致?"
它会把"看起来不一致"的记录挑出来,人工再核对。先人工核对 200 行,再决定是否放量。
谁会用 :数据运营、CRM 管理员;产出:可疑客户资料清单。
"先找出来"这件事,关键是标准:松紧调到业务能接受的位置。
再分好类:把文本变成可统计的桶
分类的目的不是炫技,而是让后续能按类别统计、分配和追踪。
场景:工单 / 线索分给正确的团队
10 个队列听起来很细,但技术、产品、IT 在意思上高度重叠。以前靠人工看或关键词,队列一多就容易乱。先分 4 个大类,人工再做细分。
你可以这样问:"这张工单应该交给哪个团队?"选项:技术支持、售后与账务、销售、其他。
在 2,000 条工单上,4 类准确率 56.2% ;同样的数据,直接分 10 个队列只有 24.0%。选项越少、界限越清楚,越准。
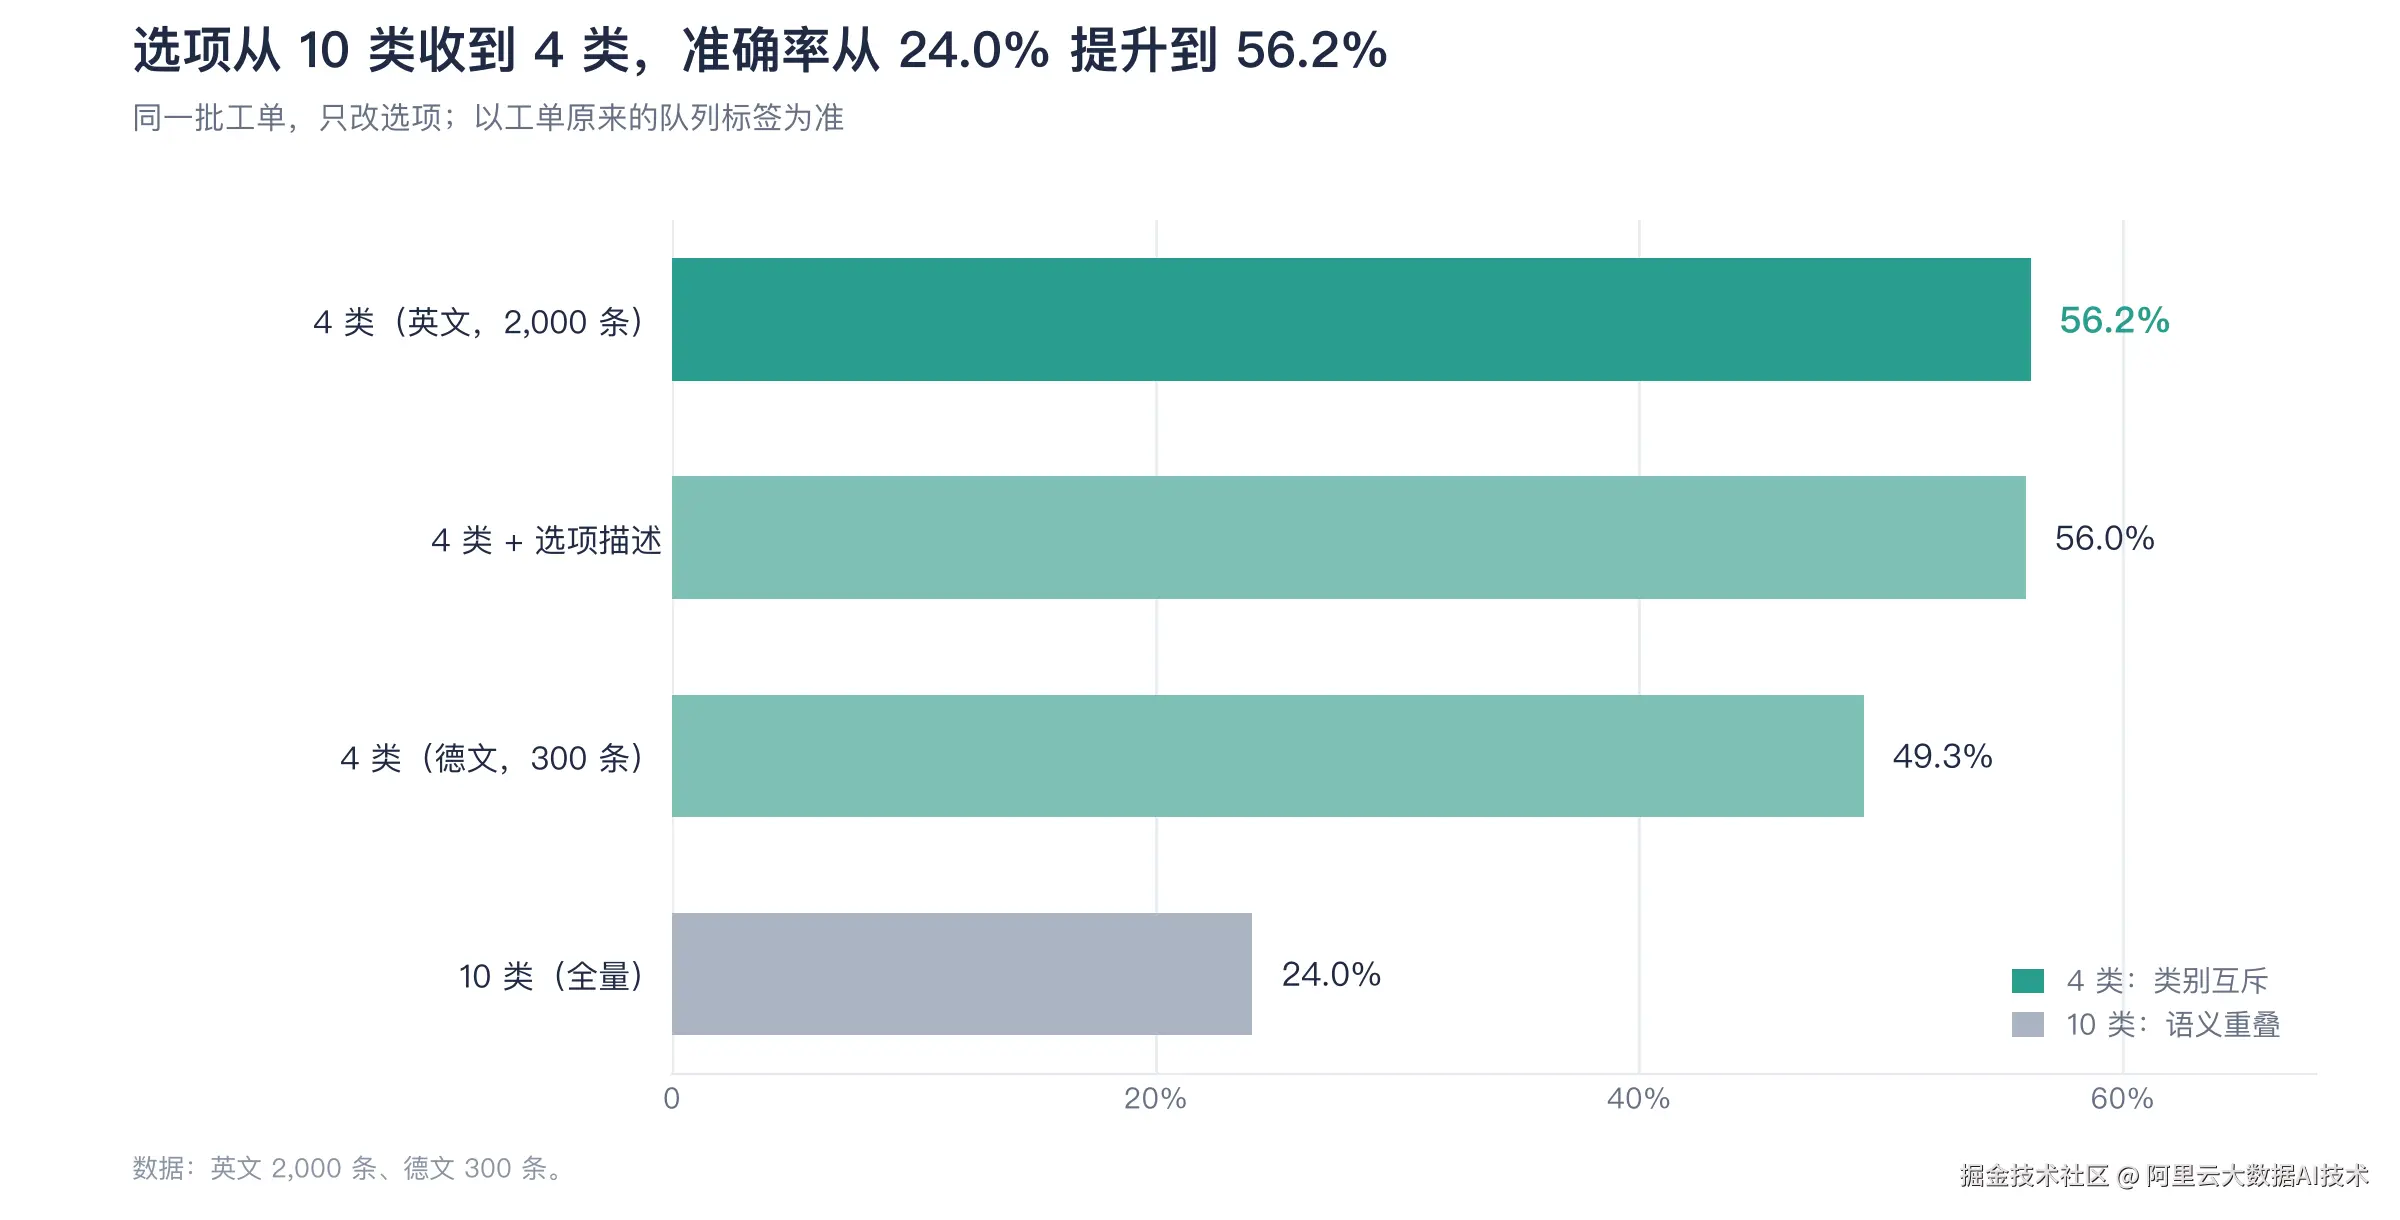
图 3:同一批工单,只改选项。
先用 4--6 个界限清楚的选项;"其他"不要兜底一切,占比过高说明选项要重新设计。
谁会用 :客服运营、销售运营;产出:按团队分好的工单 / 线索。
场景:用户反馈打主题,给 BI 用
运营每周都要看"用户到底在说什么"。以前人工抽样读几百条,很难做全量统计。
你可以这样问:"这条用户反馈主要属于哪个主题?"选项:价格、物流、产品质量、售后服务、其他。
给每条反馈补一个主题标签,BI 就能按主题看趋势、按周对比。主题之间要界限清楚;先抽 100--200 条人工核对,再决定是否扩主题。
谁会用 :产品、运营;产出:按主题统计的反馈看板。
场景:多语言业务,同一套规则
跨境业务有英文、德文工单,不想为每种语言写一套关键词。以前每种语言一套规则,维护成本高。
你可以这样问:"这张工单应该交给哪个团队?"选项:技术支持、售后与账务、销售、其他。
德文 300 条直接测试,4 类准确率 49.3%,和英文 56.2% 在同一水平;不翻译、不用为每种语言单独训练。
谁会用 :跨境客服、海外运营;产出:统一的多语言分类。按语言抽检,低资源语言多留人工复核。
"再分好类"这件事,关键是选项设计:先收敛,再自动化。
最后排个序:把"程度"变成可排序的键
场景:客户反馈按满意度排序,差评先处理
客服团队每天只能跟进一部分差评。以前按时间顺序处理,最不满的客户可能被淹没。
你可以这样问:"这条评价的满意度如何?"等级:非常不满、不满、中立、满意、非常满意。
它会把每条评价放到对应的等级上,你按等级从低到高排,就能先处理最不满的客户。
等级可以很朴素:非常不满 → 不满 → 中立 → 满意 → 非常满意。关键是先把等级边界写清楚;没有标准,分数就不可解释。
谁会用 :客服、客户成功;产出:差评优先跟进队列。
"最后排个序"这件事,关键是标准:先定等级,再打分。
三个跨行业组合
同样的三种判断,换一张表、换一句问题,就能套到你的业务:
| 团队 | 组合 | 产出 |
|---|---|---|
| 客服 | 预筛 + 路由 + 满意度 | 工单自动分诊,差评优先跟进 |
| 风控 / 合规 | 风险预筛 + 人工复核 | 复核名单,降低漏判 |
| 市场 / 运营 | 主题打标 + 满意度评分 | 反馈看板,按主题、情绪聚合 |
这些场景的共同点是:输入是文本或整行资料,输出是是/否、标签或分数,中间不需要另建一套系统。jev 不是替代人工,而是把"先看一遍"的工作变成数据表里的一步。
一条落地路线
先用 300--2,000 行试跑 → 人工核对一批结果 → 确定标准和选项 → 逐步放量 → 结果留档,人工复核结果回流。
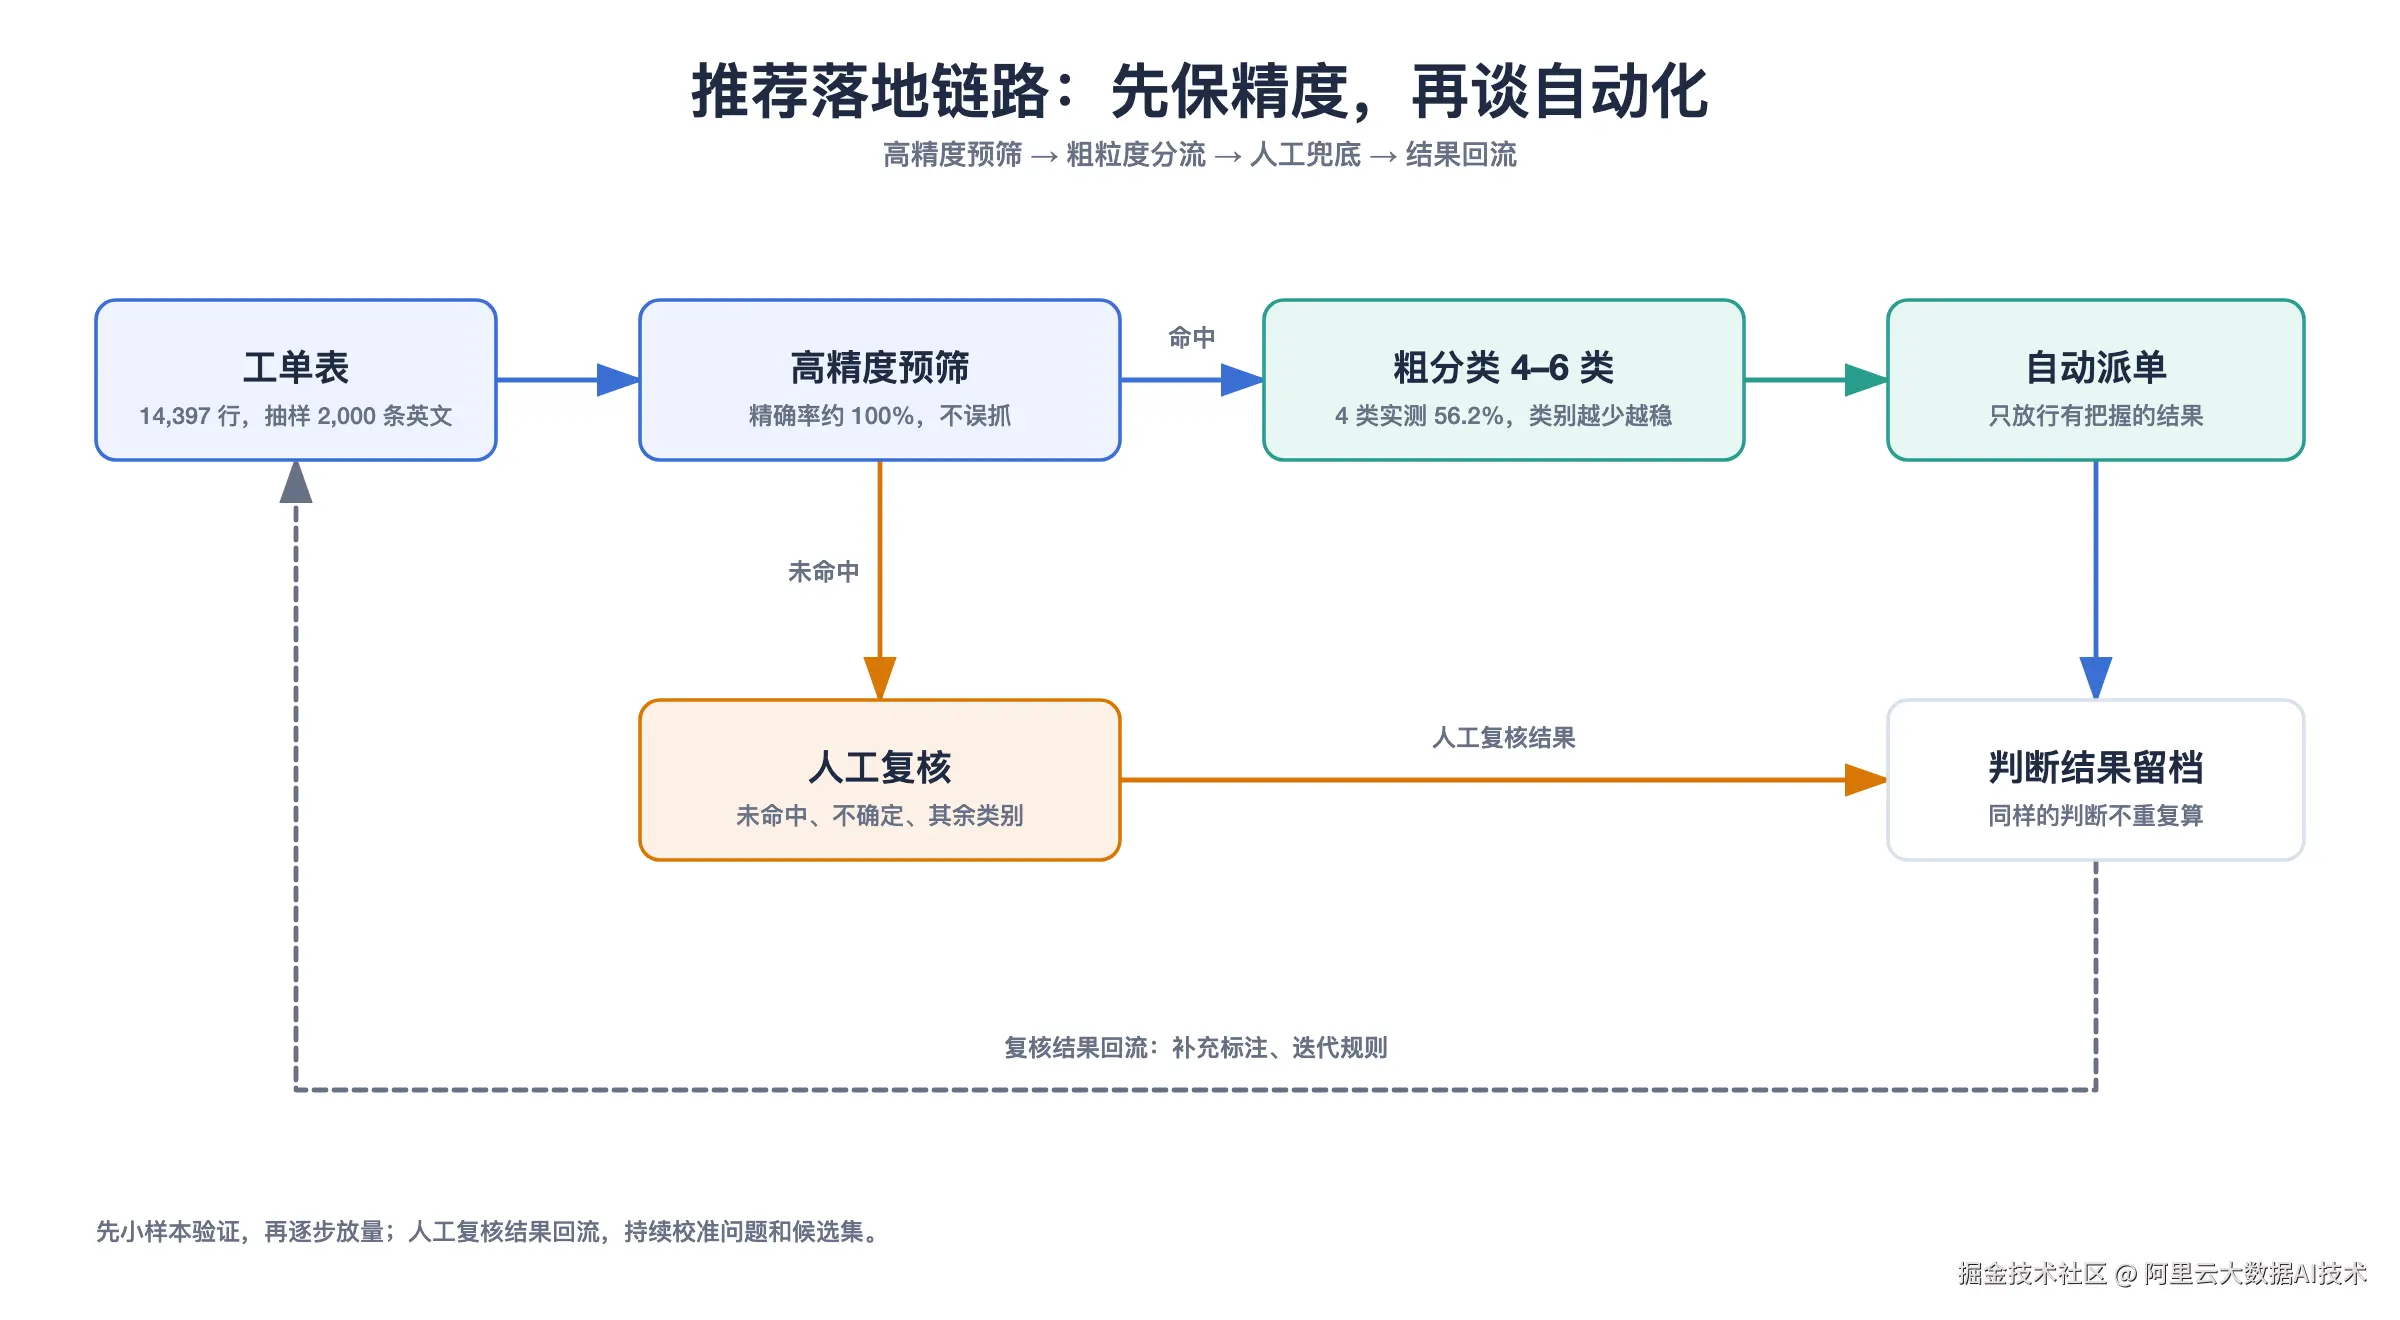
图 4:高精度预筛、粗分类、人工兜底与结果回流。
开始之前,准备三样东西:一批历史数据、一句清楚的问题、一个可接受的误判 / 漏判标准。
想自己跑一遍的技术同学,脚本在 sql/ticket_triage.sql。
延伸阅读
-
jev 与 DuckDB 的官方博文:Jev and DuckDB: Plain-English Conditions in SQL
说明:工单场景的数字来自 2,000 条英文工单和 300 条德文工单的实测;其他场景为写法示例,未逐一跑数。