968 分,539 条评论,2026-11-15 的 HN 当日第一,讨论量是第二名的 2.5 倍。拿下这个位置的不是新模型,是一篇主张「所有 AI 生成的代码都应该开源」的博客檄文,作者 Jakub T. Jankiewicz。
热度不稀奇。稀奇的是它把团队躲着走的话摆上了桌:AI 写的比例越来越高,对外一行不开源,客户合同里还写着「自研」。素材的追问更直接------「90% 代码是 AI 写的,一行都不能开源,怎么自圆其说?」
这是设问,不是哪家公司的自曝。但你手里若有客户合同,它就不是设问了。
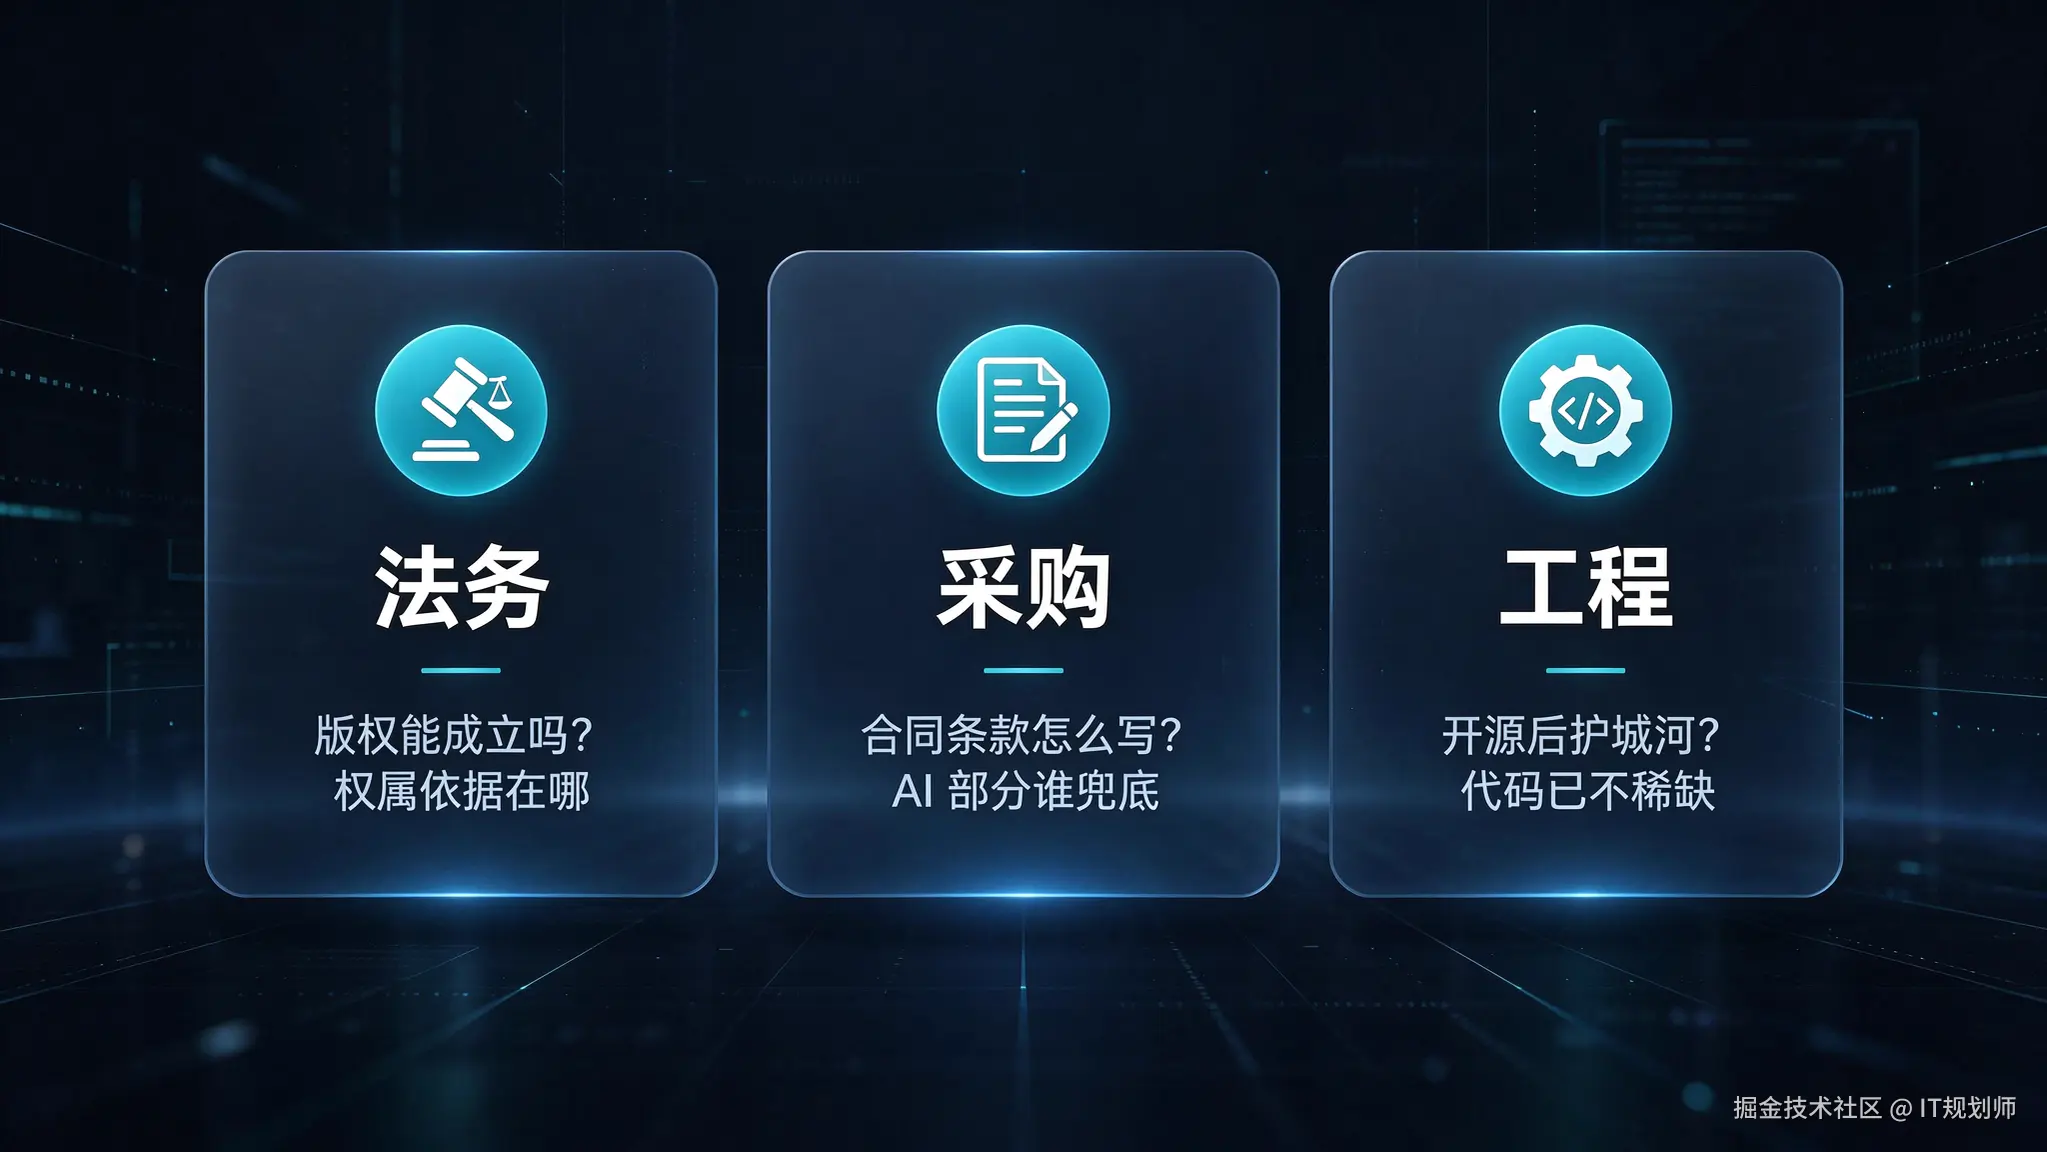
吵的不是开不开源,是三个岗位各有一句答不上来的话
把「该不该开源」当道德题,讨论只会停在立场。素材的角度是把问题压到决策层,拆成三句话。
法务:版权能不能成立。 如果 AI 生成部分不享有版权,「我们拥有完整知识产权」这句,依据在哪。
采购:合同里的知识产权条款怎么写。 AI 生成部分要不要披露、署名谁担、权属争议谁兜底,都不是一句「支持开源」能覆盖的。
工程:开源之后护城河还剩什么。 代码不再稀缺,值钱的是数据还是部署能力,得说清楚。
我的判断是:三句没一句能靠表态回答。它们指向同一处------公司把 AI 代码记成资产,却没说清权利基础。
所以对你意味着:别急着站队,先找出合同里「自研代码」的定义写在哪一页。
作者的三条论据里,第三条最难绕开
素材给的是论证摘要,不是原文全文。以下按素材转述,不补论据,不下法律结论。
第一条讲数据来源。 按素材转述,模型训在未授权抓取的开源代码,以及 CC-BY 系(要求署名)的 Stack 系问答上。把集体知识变成闭源代码,作者叫它「许可证洗白」。
第二条讲作者身份。 按素材转述,纯 AI 生成内容没有人类作者,本不该享有版权。作者援引了美国「猴子自拍」判例、版权局后续立场、Wikimedia 要求纯 AI 图标注公有领域。这些依据本文未核实。
第三条讲边界怎么划。 按素材转述,代码很少 100% 人工或 100% 自动,但只要人只写了 prompt、连看都没看,就该开源或 CC0。这条最难绕开:标准从「用没用 AI」换成「人做了什么」,后者可留痕,也能在尽调里被问出来。
从素材落点上看,推论不在道德层。如果 AI 生成部分不可版权,合同里的「自研」和估值里的「自研代码资产」都得重新找依据。这是条件推论,不是结论------「不可版权」只是作者的主张。
所以对你意味着:该判断的不是「开不开源」,而是「凭什么算作资产」有没有书面依据。
以下没有可靠信息,不写进判断:判例案号与适用范围、版权局立场的文件出处。Wikimedia 政策原文、Stack 系问答授权条款、原文全文,本次也没核到。
不站队,也能先做的三件事
- 给 AI 生成的代码留痕。 在提交记录或交付清单里标出哪些片段由 AI 生成、人做了哪一步复核。留痕正对着素材第三条论据的边界:只写 prompt、连看都没看。
- 翻一份最近签的客户合同,找知识产权条款。 只看两处:有没有「自研」类表述,AI 生成部分有没有被单独约定。不用改,先抄下原文。
- 让法务、采购、工程各写一句话。 题目统一:如果这部分代码不享有版权,我们对外怎么答、合同怎么改、护城河算在哪。三句话摆一起,比开一次立场会更能暴露问题。
以上是建议的自查路径,不是法律意见。具体条款与权属,以合同原文和专业意见为准。
所以对你意味着:三件事今天就能开始,都不需要公司先决定开不开源。
谁该认真看,谁别急着下结论
适合手里有客户合同、要过尽调,或正在给团队定 AI 编码规范的人。
不适合三种读法:想拿「AI 代码有没有版权」定论的------素材是檄文,不是判决;团队还没把 AI 代码纳入交付、只想看热闹的------三个岗位的问题还不存在;打算直接拿它改合同的------文中法律论据未经核实。
我的判断还是那句:先别争开不开源,先把「自研代码资产」在合同和资产表里的依据找出来。找不到,那 968 分吵的就不只是别人的事了。
今天能做的动作:翻开最近那份合同,看「自研」两个字怎么定义。
你们合同里的「自研代码」是怎么写的?评论区聊聊。
信息卡
- 议题:所有 AI 生成的代码都应该开源
- 作者 / 来源:Jakub T. Jankiewicz 个人博客(2026-11-15)
- 链接:jakub.jankiewicz.org/blog/ai-cod... | aihub2022.top/hn/
- 热度:HN 当日第一,968 分 / 539 条评论,讨论量为第二名的 2.5 倍(素材口径,非 HN 官方评级)
- 标签:#AI编程 #开源 #版权 #合规 #技术管理