最近在深钻大模型测试,发现了一个极其割裂的现状:
现在市面上的 AI 测试,大多还停留在"跑分脚本"阶段。写一个 Python 脚本,调一下 API,算个总分,就结束了。
但在真实的企业研发场景里,这根本行不通。
业务主管会问:
- "大模型动不动就胡言乱语,到底是检索搜错了,还是模型瞎编的? "
- "多轮对话的 Agent 动不动就死循环,怎么精准定位是哪一步坏了? "
- "研发提交的代码里一堆漏洞,能不能用 AI 去做门禁拦截,不给过就不准发版? "
为了回答这些问题,作为一个在测试圈摸爬滚打了 18 年的老兵,我花了一段时间,从 0 到 1 手搓了一套企业级 AI 工程效能与质量门禁平台(AI Eval Harness V2.0) 。
今天,我把底层的架构设计和实战踩坑全盘托出,代码已开源。
🛡️ 一、直接上大招:可视化效能大屏
过去,我的框架跑完只吐几个 JSON 文件,极其不直观。为了降维打击,我引入了 Streamlit + Plotly,直接做了一个深色系的极客大屏。
这套系统由三大硬核模块组成:
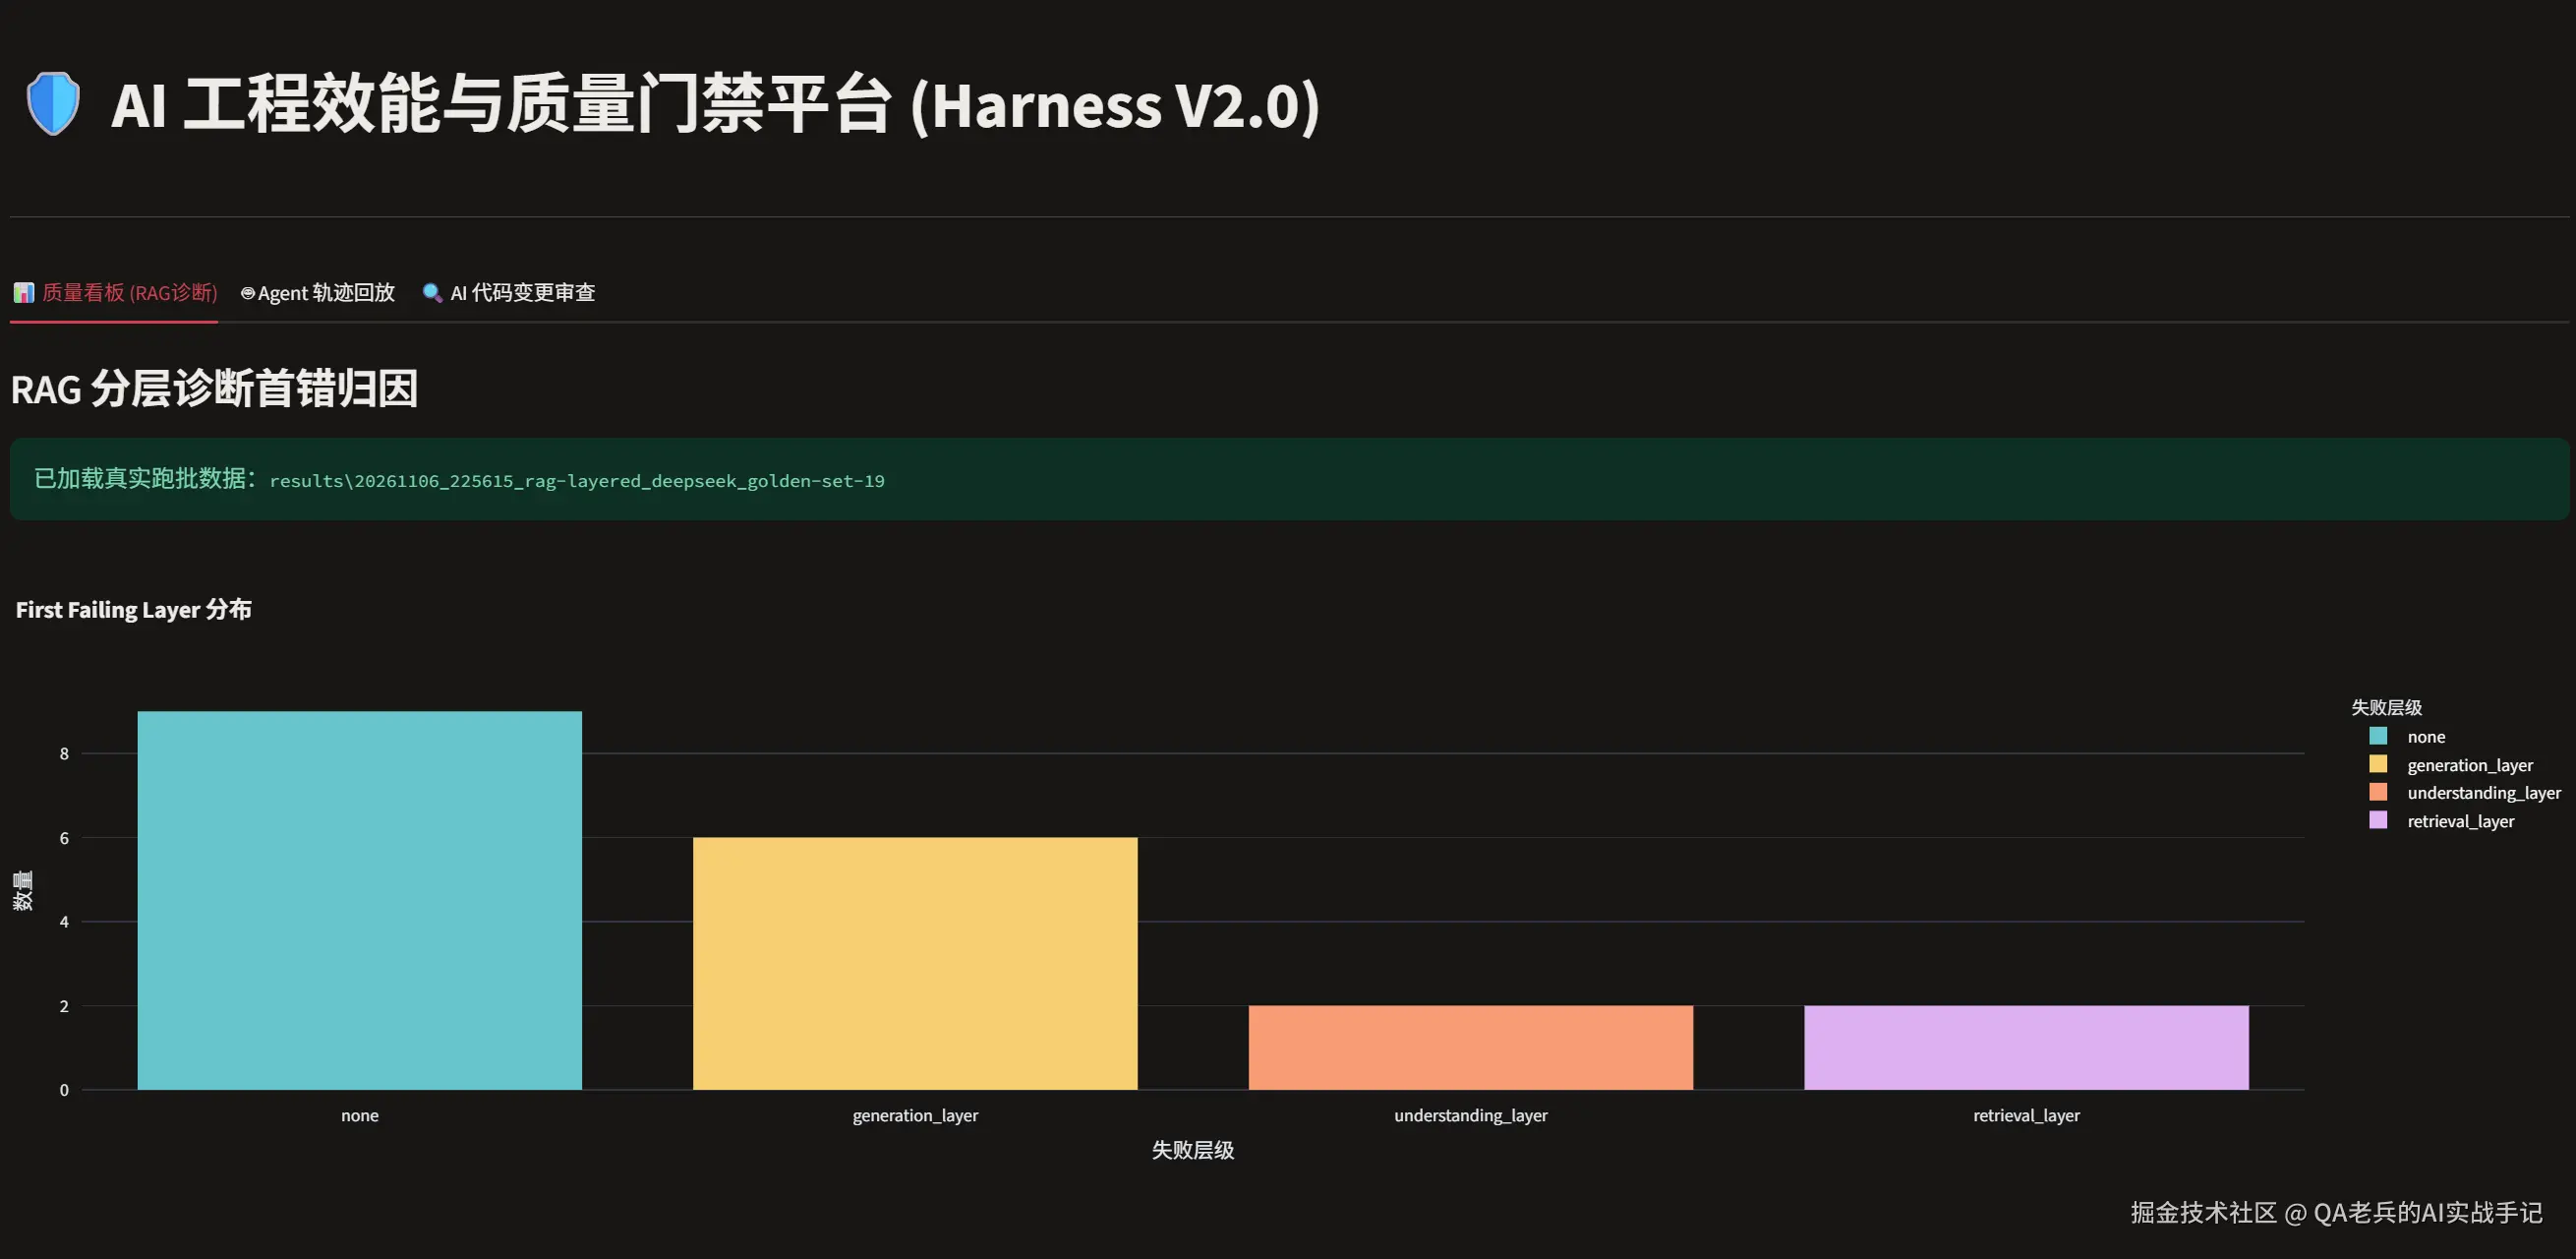
1. RAG 首错归因诊断
大模型瞎编(幻觉),很多时候是因为 RAG 的检索层拉胯。我在框架里做了分层诊断,把大模型的回答拆解为"检索层 -> 理解层 -> 生成层"。
通过真实数据的柱状图,一眼就能看出瓶颈在哪。比如我加入了 TF-IDF 向量检索后,检索层失败数从 10+ 骤降到了 2,直接把研发的锅给分得明明白白。
2. Agent Trace 追踪与死循环拦截
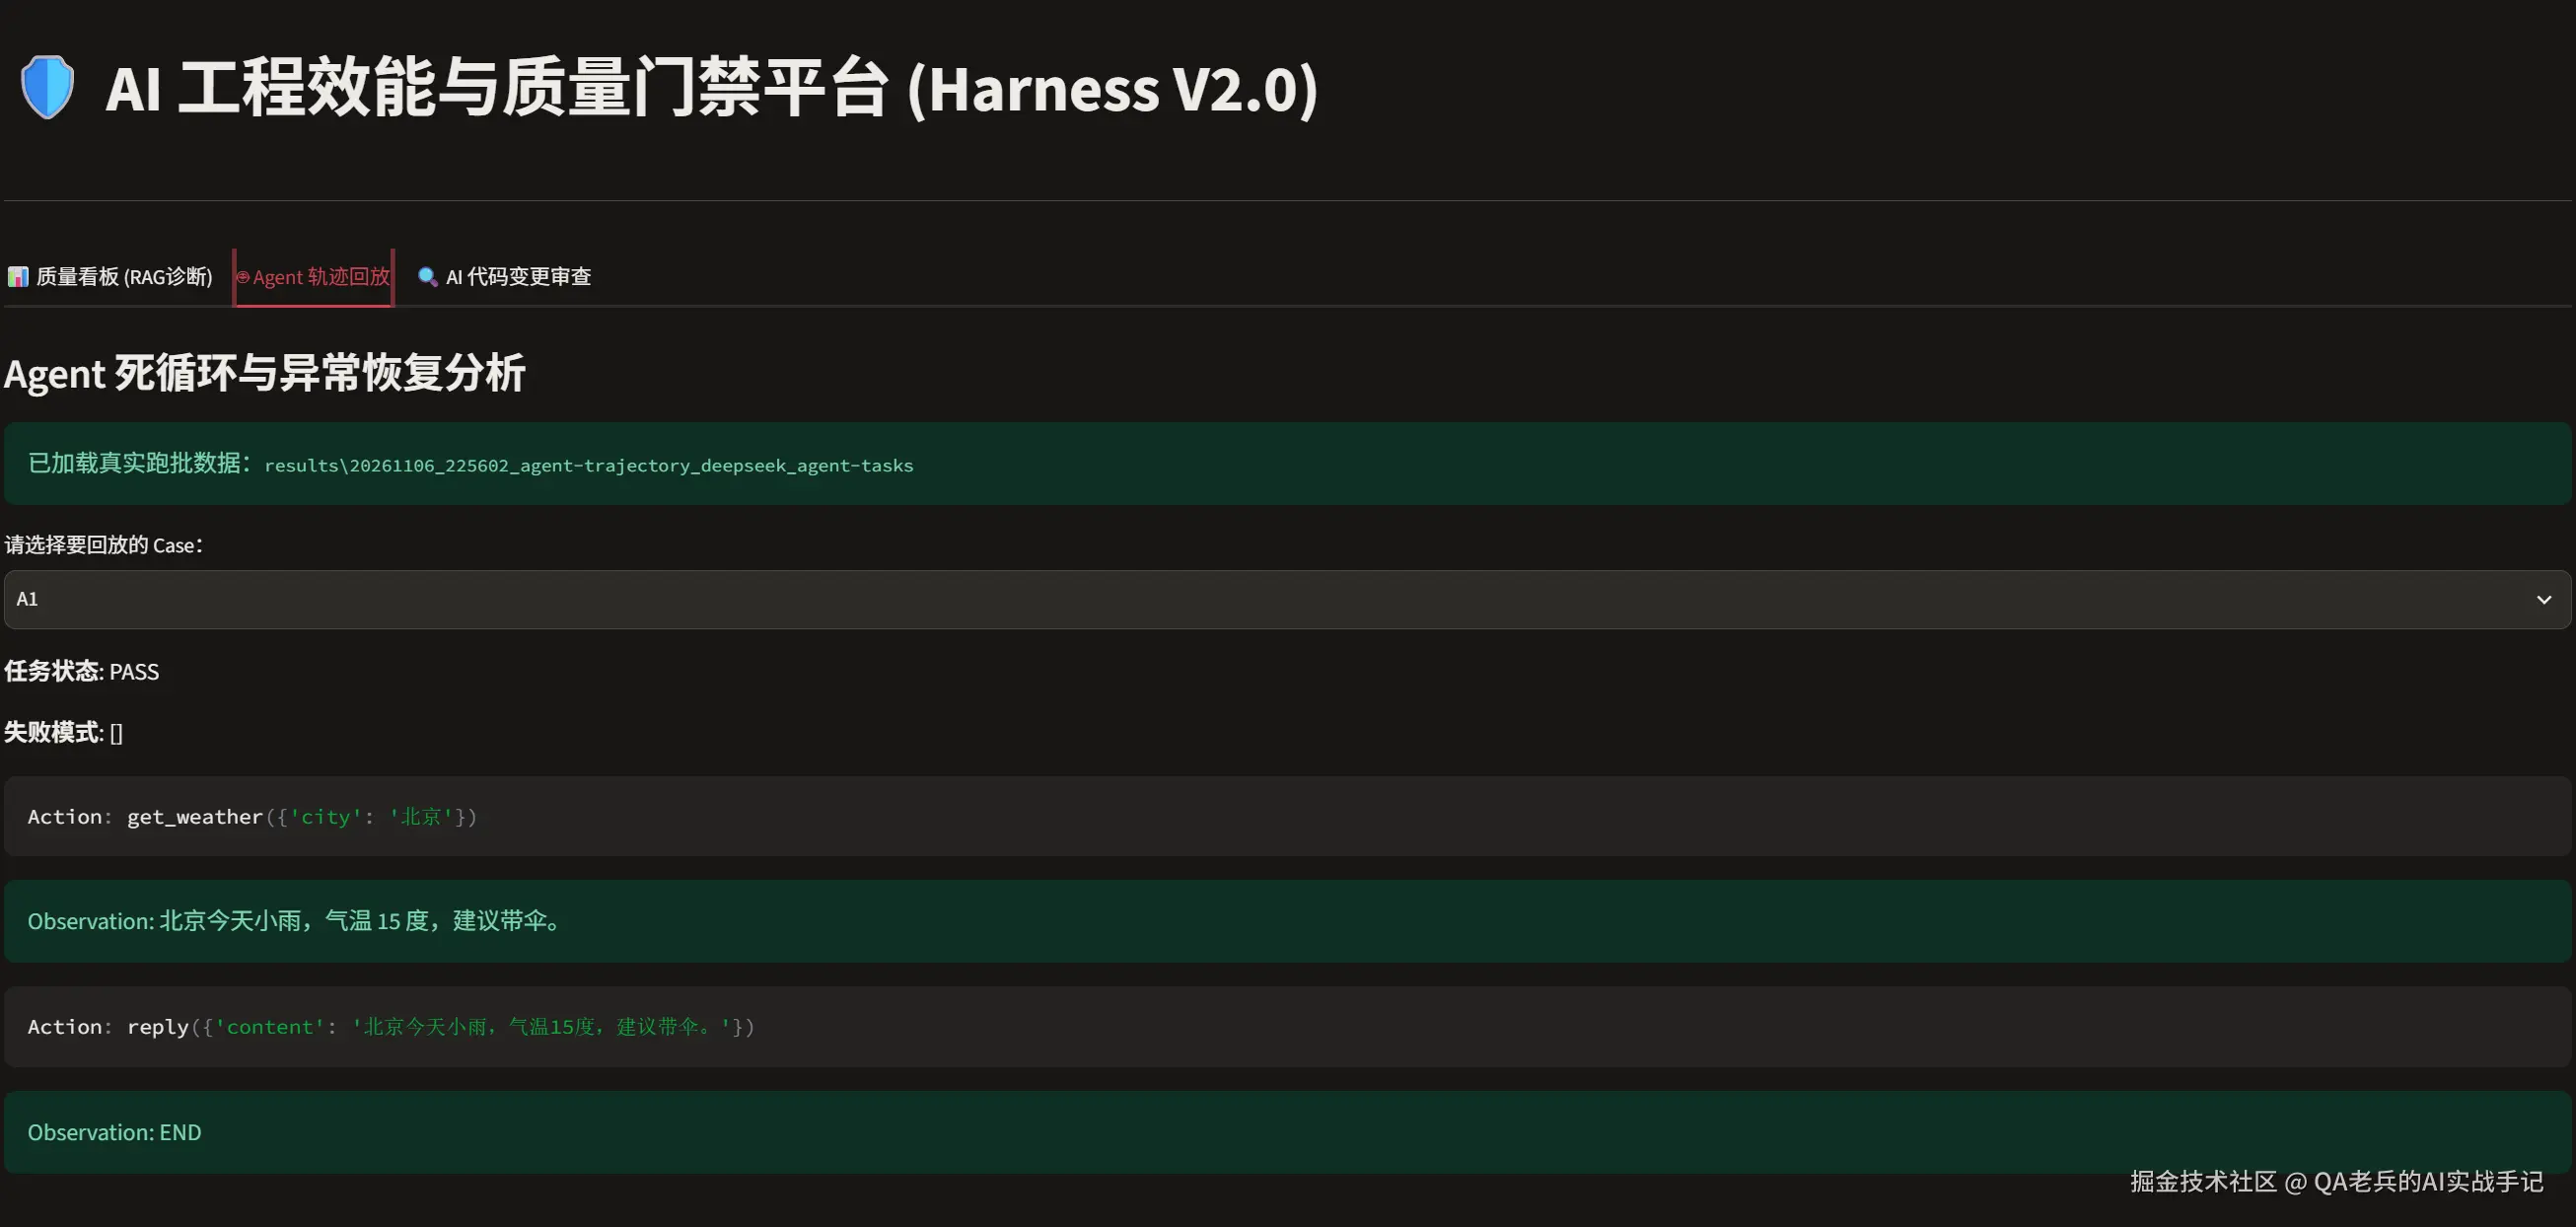
Agent 的最大风险是陷入"死循环"疯狂烧 Token。在真实沙箱里,我故意在工具里注入了 20% 的随机超时异常。
一旦模型拿不到结果,反复用同一个参数去调工具,我的系统只要在 Trace 日志里检测到重复 Action 超过 2 次,立刻亮起红色的拦截警报,强制熔断!
3. 杀手锏:AI 代码变更审查 (AI Code Review)
这是目前大厂(如美团、字节)最看重的 AISDLC(AI 软件开发生命周期)能力。
我实现了一个交互式的代码审查模块,你可以随时粘贴一段烂代码进去。
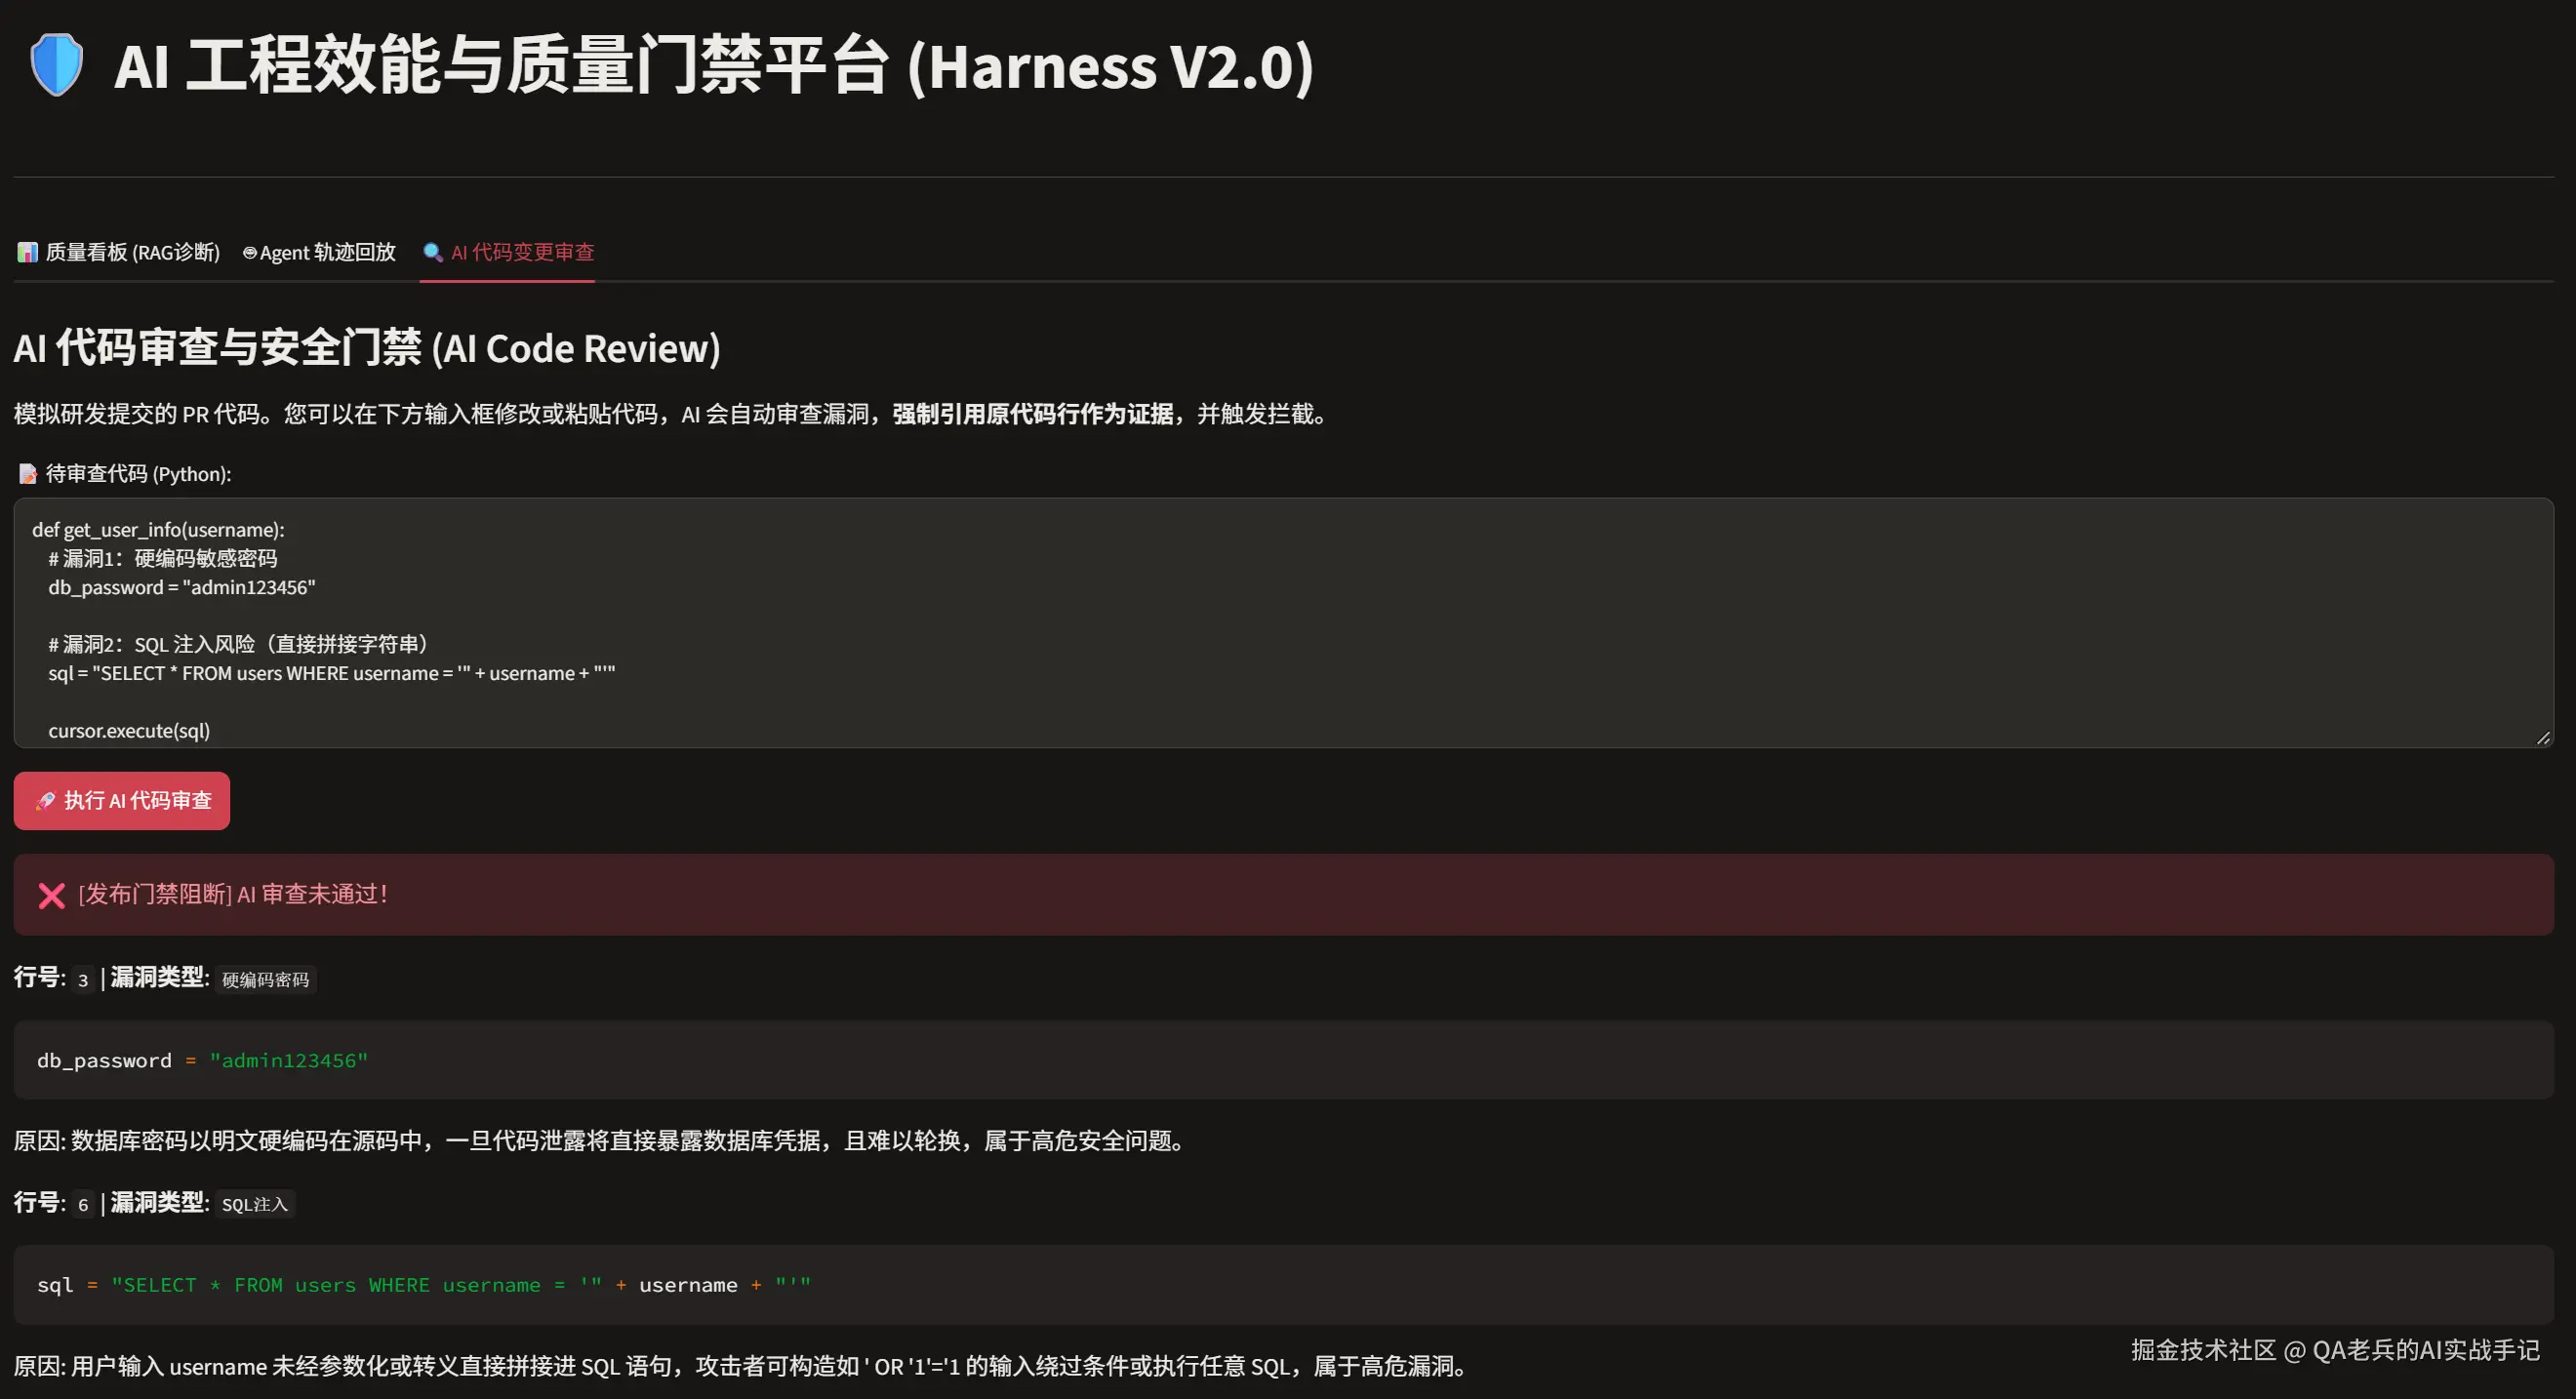
注意看,它不仅仅是告诉你有漏洞,它强制要求大模型引用原代码的行号作为证据,并直接触发发布门禁阻断!研发如果不修这个高危漏洞,连代码都合并不进去。
🔥 二、硬核架构设计:如何防止大模型"瞎搞"?
做 AI 测试,最难的不是调通接口,而是兜底。在这个框架里,我用到了三个非常硬核的架构设计:
1. Judge 防作弊校准(解决大模型打分偏见)
用大模型(LLM-as-a-Judge)给大模型打分,最大的坑就是裁判有偏见。
我的解法是:
- 强制证据约束 :给裁判的 Prompt 里写明,你必须输出
evidence字段引用原文,没有证据直接判 0 分。 - Kappa 统计校验:结合 Cohen's Kappa 系数,把裁判的表面一致率硬生生拉到 94% 以上,确保结果可解释、可复现。
2. AOP 安全网关与流式截断(解决合规风险)
如果大模型面临涉黄涉政或泄露密钥的风险,等它全吐完再拦就晚了。
我在底层 Executor 里写了一个拦截器链(AOP切面)。当开启 stream=True 时,系统边收字边扫敏感词,一旦命中高危词,毫秒级强制熔断 TCP 连接,前端直接降级为"无法回答"。
3. 模型漂移防作弊(防止开发偷换底座)
有时候开发为了跑分好看,会偷偷把 Qwen 换成 DeepSeek,或者偷偷调高温度。
我写了一个指纹校验脚本,利用极低温探针生成文本的 MD5 哈希,对比基线快照。只要底座的哈希变了,系统立刻报警,别想蒙混过关。
💻 三、开发路上踩过的坑
手搓这套系统并不容易,踩了几个极具代表性的坑:
- 多线程并发直接把 API 打挂 :一开始用
threading跑批,直接触发了服务商的 429 限流。后来重构成异步协程,用asyncio.Semaphore做了并发控制,顺利跑通 100 并发。 - 环境变量死活读不到 :用 Streamlit 启动 Web 服务时,底层的
.env死活读不进来。后来通过手动注入load_dotenv()解决,并用@st.cache_resource做了大模型 Client 的单例缓存,防止热更新时疯狂扣费。 - 大模型输出的 JSON 格式错乱 :大模型经常在 JSON 外面包一层 ```````json````,导致解析崩溃。后来我写了一个极其暴力的正则截断提取
response[response.find("{"): response.rfind("}")+1],一招制敌。
🚀 四、结语与开源
这套框架不仅是一套测试工具,更是我对"AI 时代质量保障体系"的思考。
它目前已经接入了 CI/CD 流水线。每一次提交代码,都会自动触发大屏更新和门禁校验。如果关键指标(如幻觉率、安全命中率)跌破红线,直接阻断发版。
代码已经全部开源,欢迎同行交流指正,也欢迎直接拿去公司落地。
👉 GitHub 开源地址:github.com/QA-yilin/ai...