测试、演示、算法训练、合规替身......业务天天都需要数据,但"像真的"业务数据一直很贵:手工造数一眼假、外部爬数不敢用、脚本造数难维护。
DataWorks 数据集成 AI 数据生成 (随 2026-10-08 版本正式发布)彻底改变了这一现状:把造数变成数据集成里的一条流水线。只需一条 JSON 配置,大模型负责编排业务"剧情",规则引擎负责保证"物理"自洽,分钟级产出能通过业务校验、下游即取即用的仿真级业务宽表。
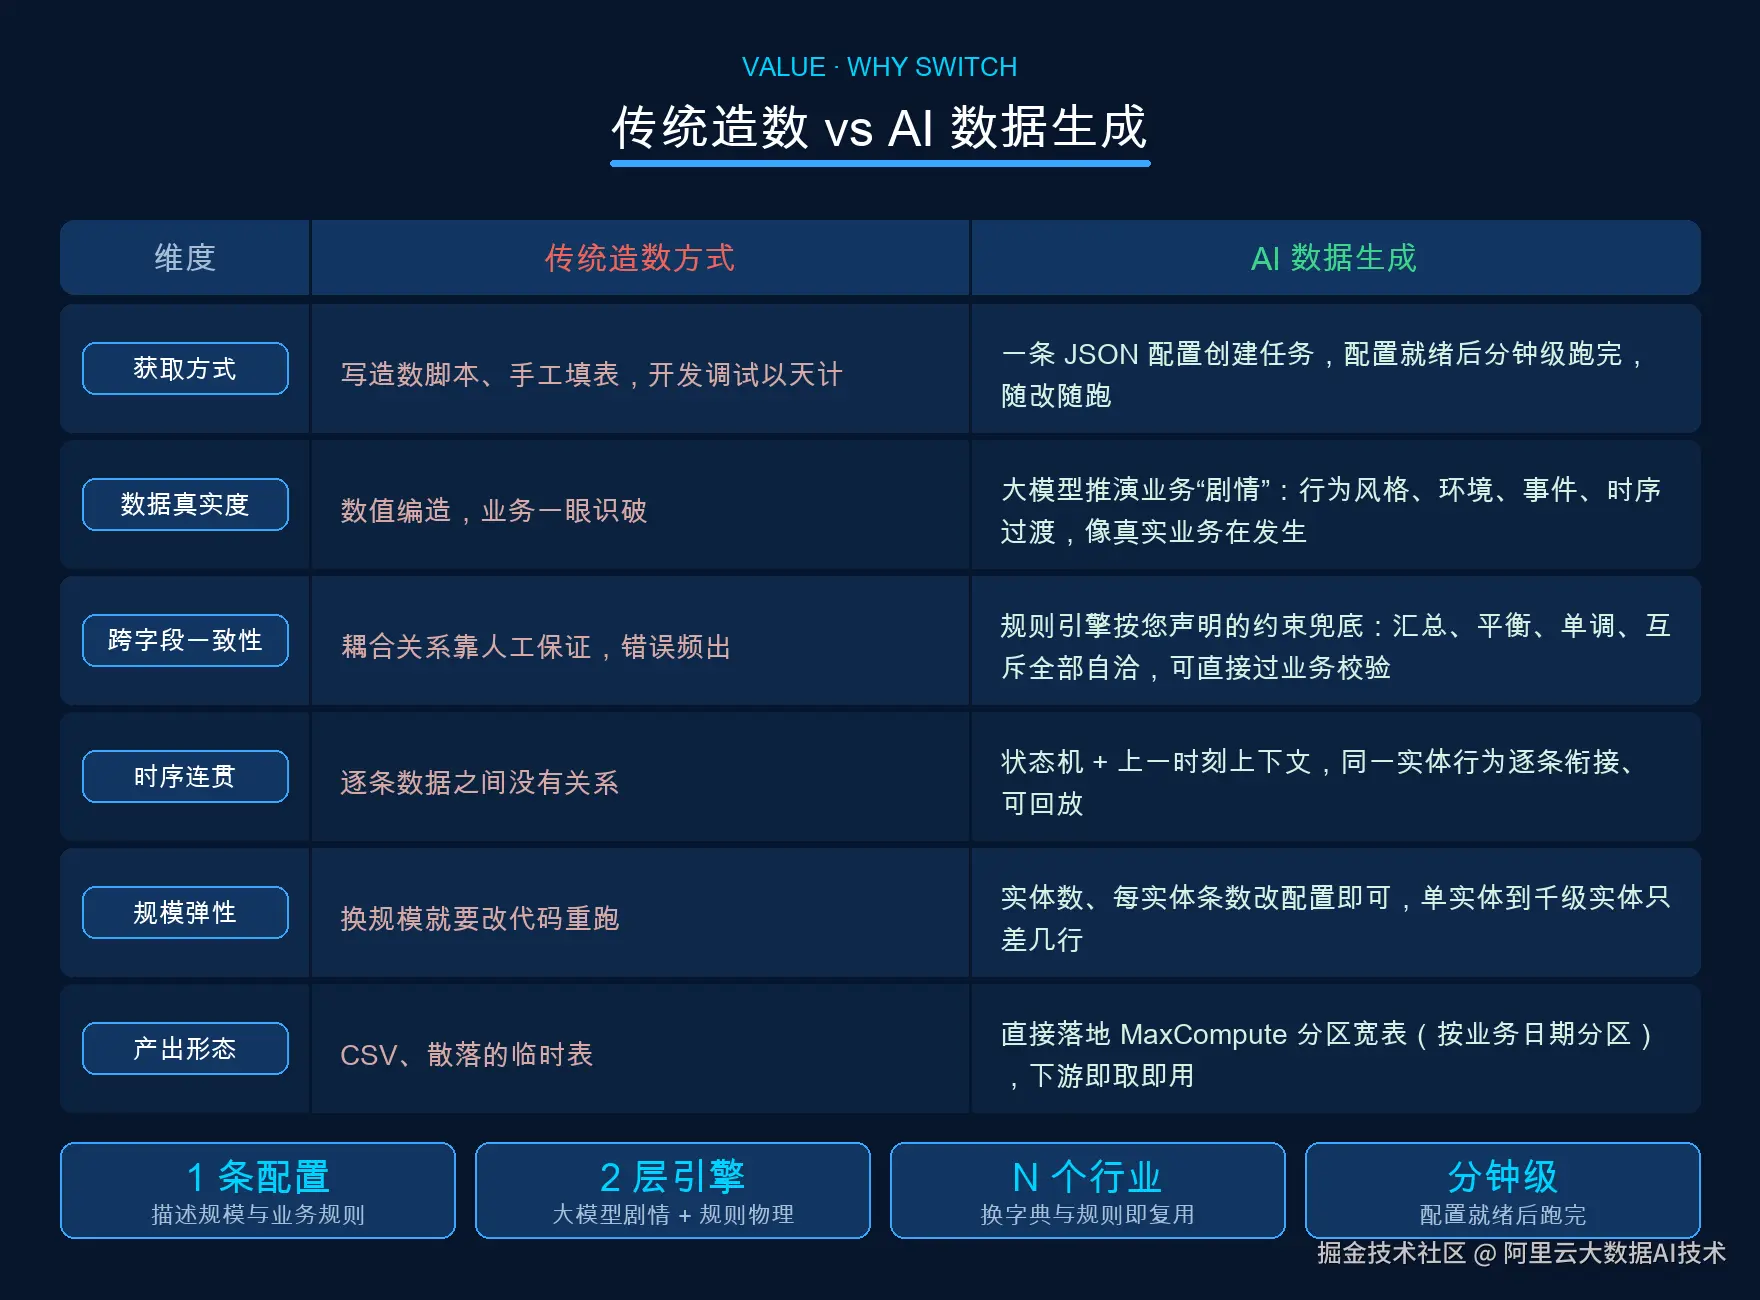
传统造数 vs AI 数据生成
面对复杂宽表,传统造数方式往往陷入"三个老大难":手工填数跨字段对不上、一致性约束(如明细求和、多相平衡)人工无法保证、造数脚本难维护且无法沉淀为团队资产。
AI 数据生成为此而生:剧情由 AI 编排、数值由规则兜底------数据"像真实业务在发生",且"物理上说得通",可以直接通过业务校验、进入下游使用。
-
分钟级交付:一条 JSON 配置创建任务,配置就绪后分钟级跑完,随改随跑;传统方式开发调试以天计。
-
行为像真:大模型推演行为风格、环境、事件、时序过渡的完整"剧情",不再是一眼识破的编造数值。
-
跨字段自洽:规则引擎按声明的约束兜底------汇总、平衡、单调、互斥全部自洽,可直接过业务校验。
-
时序连贯:状态机 + 上一时刻上下文,同一实体行为逐条衔接、可回放。
-
规模弹性:从 1 个到上千个实体只差几行配置,换规模不用改代码。
-
即取即用:直接落地 MaxCompute 分区宽表(按业务日期分区),告别 CSV 与散落的临时表。
通用能力模型:三层抽象,与行业无关
为什么 AI 生成的数据既能"以假乱真",又能"严丝合缝"?核心在于 "三层抽象模型":
-
字段字典(Schema 层):您的宽表长什么样------列名、类型、分组、取值域。它是唯一 schema 来源;
-
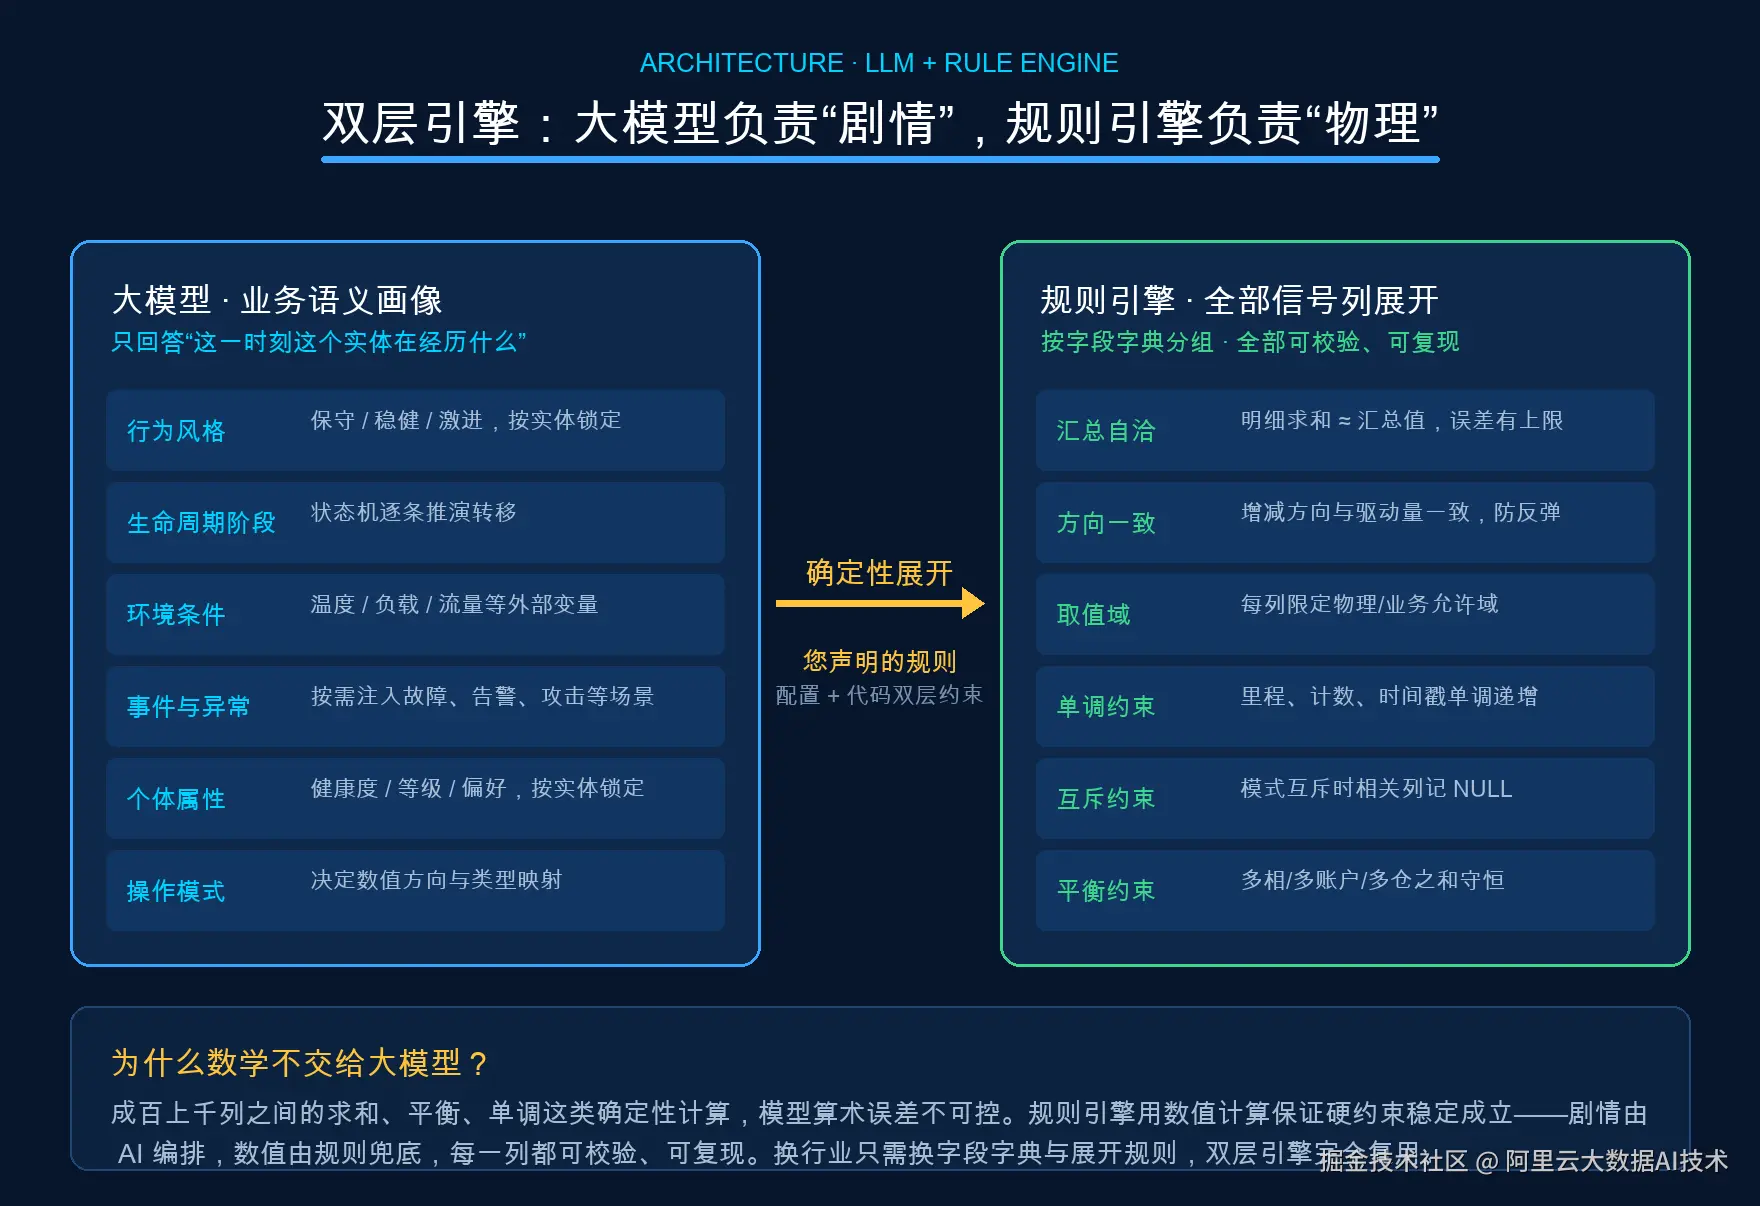
业务语义画像(剧情层):大模型只输出少量"决策"参数,回答"这一时刻这个实体在经历什么"------行为风格、生命周期阶段、环境条件、事件与异常、个体属性、操作模式;
-
规则展开(物理层):规则引擎按用户声明的物理/业务规则,把画像确定性展开为全部信号列------汇总自洽、方向一致、取值域、单调约束、互斥约束、平衡约束。
换行业 = 换一份字段字典 + 一套展开规则。 六步流水线、并发与分区机制、调度运维面完全复用,不需要重新开发。
行业场景矩阵:同一引擎,换字典即复用
只要您的数据是 "实体 × 时序 × 耦合字段" 的宽表形态,就能接入 AI 数据生成。
案例:车联网 800 列宽表(首个内置模板)
以已内置的车联网模板为例,看三层模型如何落地:
-
字段字典:800+1 列,涵盖 BMS、电压采集、电驱、热管理等 7 大分组。
-
语义画像:大模型仅输出 8 个决策参数(驾驶风格、7 态行程相位、路况、故障注入等)。
-
规则展开:执行 14 条物理一致性规则(如:包电压≈Σ单体电压、SOC 变化方向与电流一致、三相电流之和≈0)。
只需一条配置,即可产出"1辆车×200条连续时序"或"100辆车×100条=10,000条"的仿真数据集。
| 行业/场景 | 可生成数据 |
|---|---|
| 具身智能/行为数据 | 多模态传感与动作时序宽表;任务意图、动作基元序列、环境交互事件、力反馈;关节限位、末端轨迹平滑、力-位耦合一致、时间戳单调。 |
| 金融风控 / 反欺诈 | 交易与账户行为流水;消费风格、生命周期、攻击剧本;借贷平衡、限额互斥、时序单调。 |
| 医疗 / 生命体征 | 监护仪时序宽表;活动状态、用药事件、个体基线;生理取值域、指标联动、采样单调。 |
| 工业 IoT / 设备 | 产线传感器时序宽表;工况相位、负载、劣化事件;能量守恒、三相平衡、计数单调。 |
| 零售 / 用户行为 | 埋点与订单行为宽表;人群画像、促销事件、渠道;库存守恒、金额=单价×数量。 |
工作原理:大模型负责"剧情",规则引擎负责"物理"
大模型只回答少量"决策"参数(这一时刻这个实体在经历什么),其余全部信号列由规则引擎按您声明的规则确定性派生。
为什么数学不交给大模型? 成百上千列之间的求和、平衡、单调这类确定性计算,模型算术误差不可控。规则引擎用数值计算保证硬约束稳定成立------因此每一列都可校验、可复现。
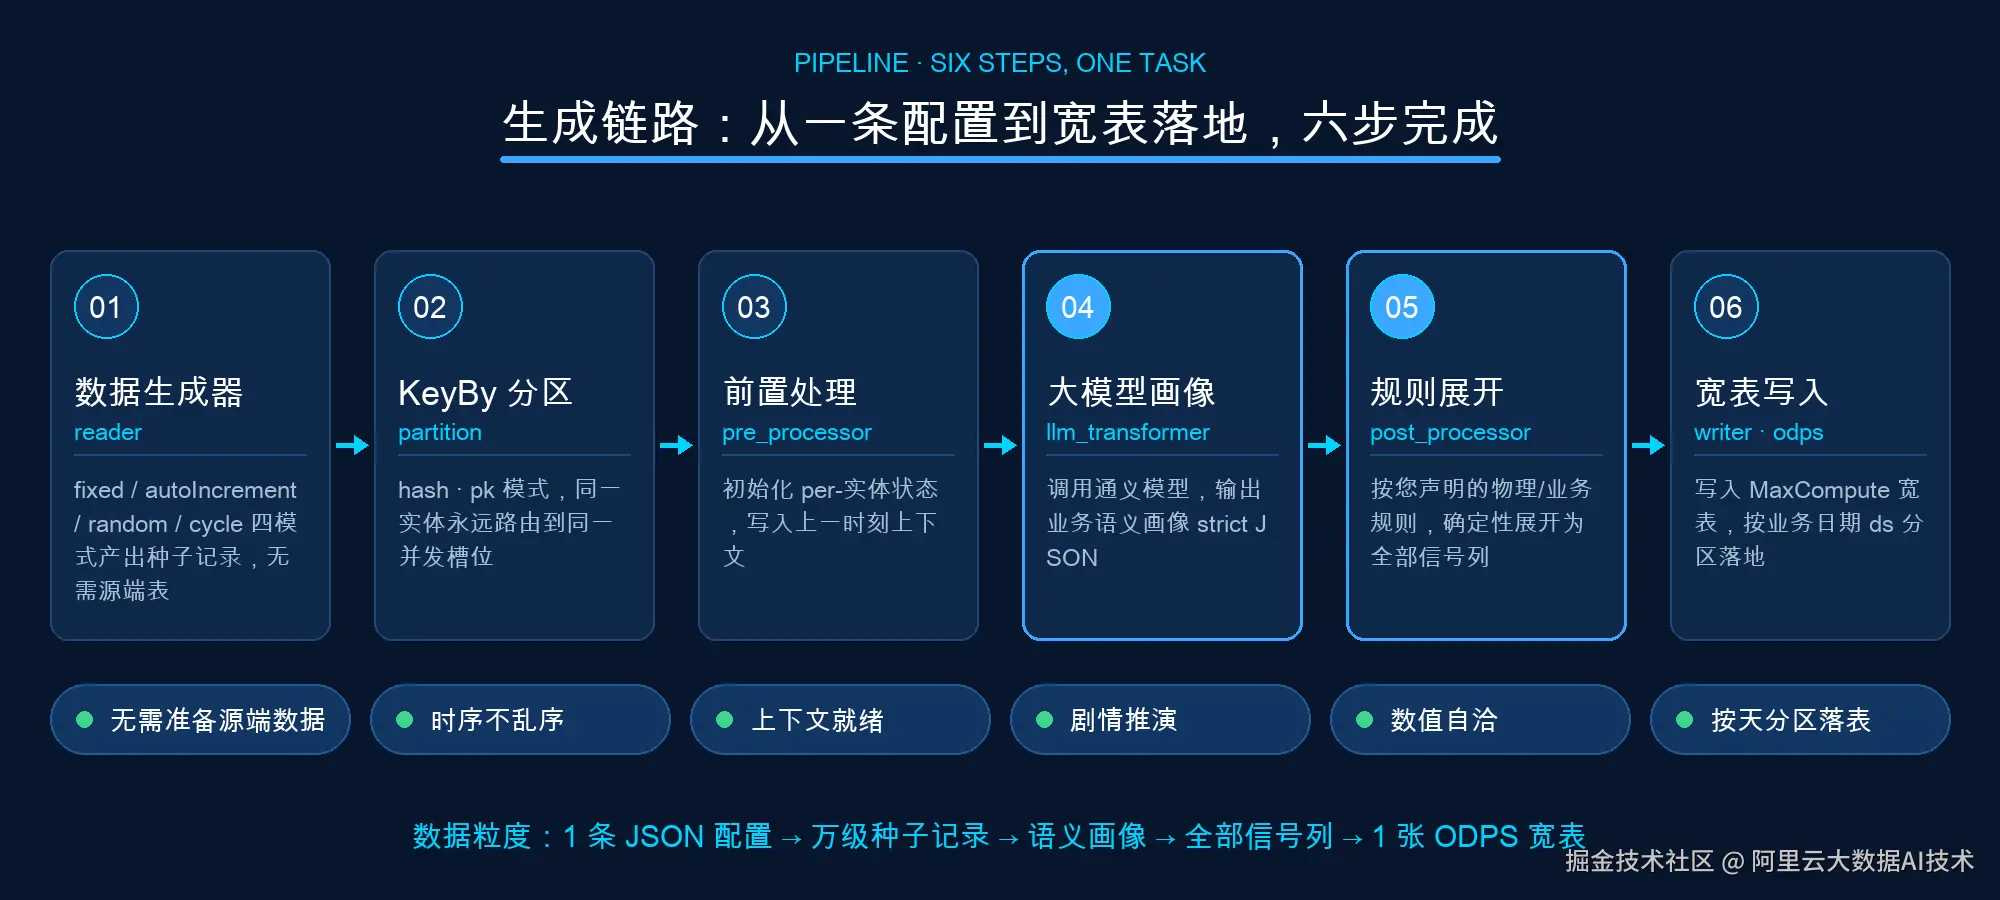
生成链路:六步流水线,一个任务内完成
种子生成、画像推演、规则展开、宽表写入在同一任务内闭环,无需准备任何源端表:
-
数据生成器:四种列生成模式产出种子记录;
-
KeyBy 分区:同一实体永远路由到同一并发槽位,保证时序不乱;
-
前置处理:初始化每个实体的状态与上一时刻上下文;
-
大模型画像:调用通义模型输出业务语义画像(strict JSON);
-
规则展开:按您声明的规则确定性展开为全部信号列;
-
宽表写入:落地 MaxCompute,按业务日期分区。
平台自动注入资源组、CU 与大模型托管鉴权------您不接触任何密钥。
规模弹性与成本可控
两种模式,按需选择:
-
单实体深度时序:画像逐条推演、状态逐条衔接,时序最连贯。适合算法调参、异常场景精细构造。
-
千级实体并发铺量(推荐):实体间并行、实体内串行。适合群体级仿真数据集、大盘统计分析。
-
质量与成本双优:状态机保证同一实体行为不跳变、可回放;大模型 Token 消耗随记录数线性增长,支持分批生成、按天分区覆盖写入,成本透明,重跑不产生重复数据。
(注:本能力专注"时序耦合宽表"仿真,纯静态维表或无时序耦合的简单随机数据非目标场景。画像质量与 Prompt 设计相关,建议先小规模试跑评估。)
现在开始
不写一行造数代码,单实体精细推演、千级实体并发铺量,现在即可体验:
-
写配置:用一条 JSON 配置描述实体规模与业务规则(已有行业模板可直接套用)。
-
建任务:创建 AI 数据生成任务(平台自动注入资源组与大模型鉴权,无需接触密钥)。
-
即用数:分钟级后在 MaxCompute 分区宽表取数,下游即取即用。