原文:mp.weixin.qq.com/s/kbFjNyq6R...(2026年09月17日)
 算法负责"算得准",协议负责"它该以什么身份存在"。
如果你用过"版本对比",大概见过这种场面:在一句话里改了一个字,工具却把整段都涂上颜色,标成"删掉旧的一段、加上新的一段"。满屏红绿,真正动的那一个字,反而被埋住了。
这不是工具的疏忽,是它的出身。绝大多数对比工具是照着英文设计的------英文用空格断词,词与词之间天然有缝;而中文、日文、韩文不用空格,一整段文字在它们眼里就是"一个词"。改一个字,等于整个"词"变了,于是整段重来。
下面这些,是我参照一个开源项目(tiptap-myers-content-diff,一个给 Tiptap / ProseMirror 文档编辑器用的差异对比库)之后,对"内容差异对比"这件事做的梳理。它值得说的,不只是"把中文分词修好了",而是它把"内容差异"当成一个必须同时设计算法 和协议的问题。算法回答"怎么算得又快又准",协议回答"算出来的东西以什么形态存在、谁来读、边界画在哪"。下面就把这两件事讲清楚------不用你懂代码,每节末尾附了几段 TypeScript 伪代码,跳过也不影响理解。
一、先学会下刀:把一段话切开
对比的前提,是先把两边切成可以比较的小块。
英文句子像一盒已经分好格的乐高------空格就是分格线,顺着格取就行。中文是一整块光板,没有格线,你必须自己下刀。刀下在哪里,决定了后面的一切。
举个最小的例子。把
这是一段很长的文字内容旧尾
改成
这是一段很长的文字内容新尾
常见的、按空格分词的旧式工具只会这么标:删掉"这是一段很长的文字内容旧尾",插入"这是一段很长的文字内容新尾"------整段,一起,红绿交织。
而按字切分的做法,会把它标成这样:
这是一段很长的文字内容
旧新 尾
只有那两个字变了。
分词这一步,通常交给系统自带的语言能力来完成:先拿到"词"的边界,对中文这种不用空格的语言,再把词细化到字。这样一套走下来,不需要引入额外的依赖。
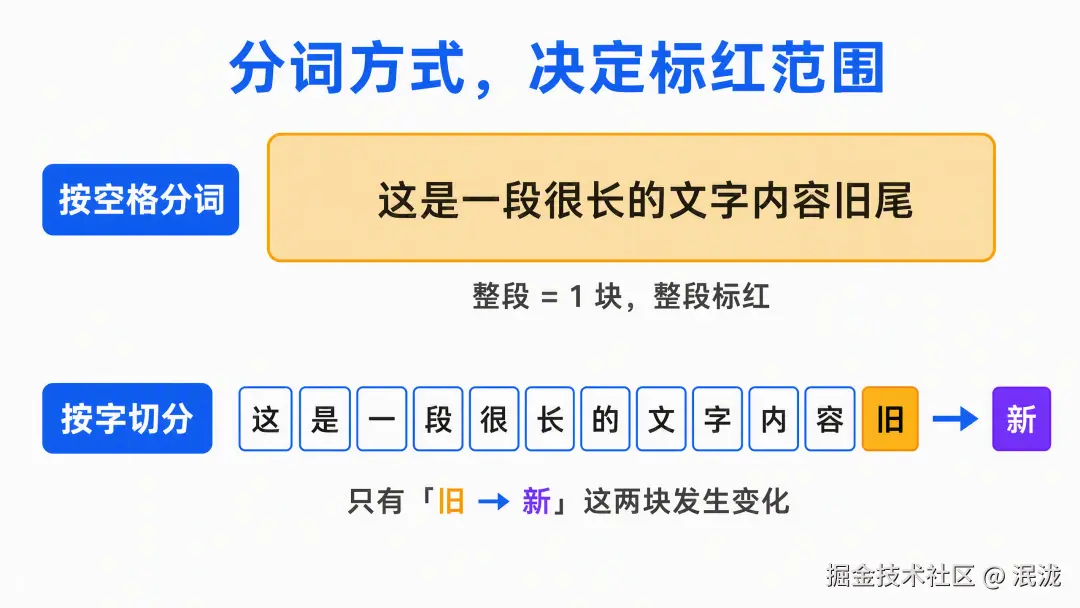 同样的文本:左边被当成一整块(一个 token),右边被拆成许多小块(很多 token),只有两小块是真正变化的。
arduino
TYPESCRIPT
// 把一段文本切成可以互相比较的小块
function

tokenize
(text:
string
):
string
[] {

// 先拿到「词」的边界;判断依据是文本本身,与「读者是谁」无关

const
 words =
segmentByLanguageRules
(text)

// 中文、日文、韩文没有空格,再细化到「字」

return
 words.
flatMap
(word => (
isCJK
(word) ? [...word] : [word]))

// 注意:空格也要保留成独立小块,否则之后所有位置都会错位
}这里还藏着一个容易被忽略、却属于协议层面的约定:切割必须与"读者是谁"无关。 同一对文档,不管谁来比、在哪种设备上比,切出来的块必须一模一样;否则两个人看同一份对比,会数出不一样的"改动数量"。词边界是文本自身的属性,不是读者的属性。
顺带一提,那些空格也被单独保留成一个块。因为后面的每一个"位置"都由这些块累加出来,丢一个空格,之后所有位置都会错位------位置必须能原样复原。
二、再学会配对:找出最短的那条路
切完,你手里有两串小块。接下来要把它们对齐:哪些块两边都有(没变),哪些只在新版里(新增),哪些只在旧版里(删除)。
这是差异对比的核心,也是一道很老的经典题:最短编辑脚本。通俗地说,就是从旧文本走到新文本,用最少的步骤完成------每一步要么删一块、要么加一块,两边相同的块可以"斜着滑过去"。把它想成一张网格地图,你要从一角走到另一角,步子越省越好;相同的文字,就是地图上免费的斜向滑道。
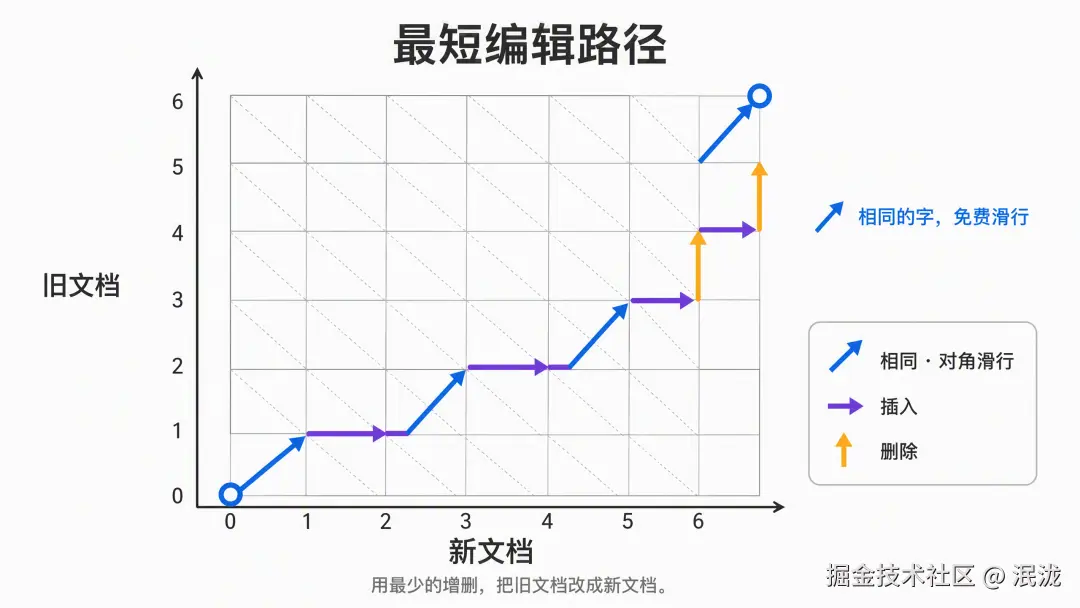 编辑网格里的一条最短路径:蓝色是"相同"的滑道,紫色是"插入"的一步,琥珀色是"删除"的一步。整条路就是"从旧文本到新文本"最省力的走法。
算法是老办法,见功力的是围绕它做的三个工程决定,而它们本质上都是协议。
先把公共的头和尾剪掉。 一份长文档只改了一处,真正的"不同"只在中段很小的一块里。先摘掉明显相同的开头结尾,把力气全花在真正不同的地方------这也让"改一个字"这种日常输入几乎不费力气。
给算法一个预算,算不动就体面地降级。 如果两段内容全无关系、需要计算的步骤会爆炸,就不要硬算到把页面卡死,宁可退化成"整段删 + 整段加"的粗粒度结果。结果粗一点可以接受,界面卡住不行------"不能卡住用户"是一条硬约束。
把"平局"定死。 当存在多条一样短的最优路径时,固定地优先选择"删除"。这看着吹毛求疵,其实是差异对比的命根子:如果不定死,同一对文档、同一个人,刷新一下可能就换了一套标法。一个不可复现的对比,等于没有对比。
typescript
TYPESCRIPT
// 最短编辑脚本:用最少的「增 / 删」把 left 变成 right
type

Edit
<T> = { kind:
'equal'
 |
'insert'
 |
'delete'
; node: T }

function
 diffSequence<T>(left: T[], right: T[], keyOf: (x: T) =>
string
):
Edit
<T>[] {

const
 { head, middle, tail } =
trimCommonEnds
(left, right, keyOf)
// 先剪公共首尾

const
 aligned =
shortestEdits
(middle, {
    maxEditDistance:
1024
,
// 预算:算不动就整体退化成「删光再插回」,不卡住界面
  })

return
 [...head, ...aligned, ...tail]
// 平局时固定优先「删除」,保证结果可复现
}
算法不只是求"对",还得求"稳"和"活"。
三、钻进结构里:不只在字里比,还要在块里比
文档不是一条长绳,它是有层次的:一篇文章里有段落,段落里有加粗、链接、图片,还有表格、列表、引用。
只在最外层"逐字比",会把结构化文档的全貌抹平。一种稳妥的做法是分层下钻:先比"块"(段落、标题、表格的行与格......),配对上的块再钻进它的内部逐词比对;能在块级别说清楚的事,不往内部走,必须精确到词才说得清楚的,才继续向下。像先看整篇文章的骨架,再放大到你真正关心的那一段、那一句、那一个词。
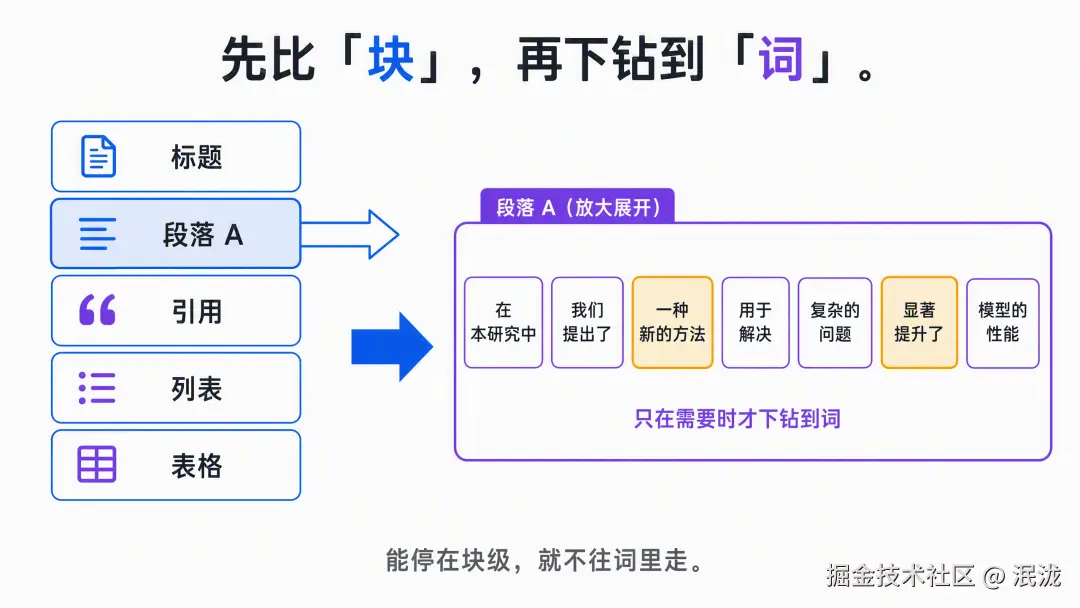 左边是文档的骨架(块),右边把其中一段放大、逐词拆分------只在需要的地方,才下钻到词的粒度。
arduino
TYPESCRIPT
// 先比「块」,配对上的块再钻进内部;能停在块级就不下钻
function

compareChildren
(before:
Node
, after:
Node
, out:
Change
[]):
void
 {

for
 (
const
 pair
of

pairRewrites
(
pairChildren
(before, after))) {

if
 (pair.kind !==
'equal'
) {
      out.
push
(
report
(pair))
// 新增 / 删除 / 改写
    }
else

if
 (pair.hasInlineContent) {

compareInline
(pair.before, pair.after, out)
// 只在需要时下钻到「词」
    }
  }
}
// 两条关键规则:
// 1) 同类型、且够相似的「删 + 增」,认成「同一段的改写」,而不是两次操作;
// 2) 配对时故意忽略样式,配对成功后再单独判定「样式有没有变」。
有两个难题值得单独说,因为它们都是"想清楚比写代码更难"的那一类。
第一个:"改写"和"删了又加"看起来一模一样。 你把一个段落里的一个词换掉,从最朴素的算法看,就是"删掉旧段落、新增新段落",于是整段又被点亮。一种处理是:给同类型、内容又足够相似的一对"删除 + 新增"重新配对,认定它们其实是"同一段的改写",然后继续往里钻,只报真正变动的那几个词。
第二个:改样式,不该被读成"删了普通的它、加了加粗的它"。 你把一个词加粗,期望是"这个词加粗了",而不是"删掉一个词、又插入一个加粗的词"。所以配对时故意不看样式,先用"是不是同一个词"把两边对上,配对成功之后,再单独判一次"样式变没变"。先问"是不是同一件事",再问"它被怎么改了"------这个顺序本身就是设计。
还有一个贯穿全篇的坐标约定:所有位置都记在新文档里,旧文档主要负责"贡献被删掉的内容"这个身份。而且,新旧两份文档甚至可以来自不同版本的"结构定义",算法并不假设两边类型完全一致------因为历史版本,本来就常常和当下长得不一样。
四、怎么画出来:被删的内容,其实没有位置
差异算完,得到一串"改动点"。接下来的问题是:怎么把它显示出来。
在编辑器里,高亮通常是把一层"装饰"贴到对应的文字上。但这里有个根本麻烦:被删掉的内容,在新文档里根本不存在,它没有位置可以贴。
一种直白的解法是:既然贴不上,就把被删的内容重新画出来,作为一个只读的"补丁块",插进它"曾经所在的位置"。而且不是抽成一句平淡的纯文本,而是按它原来的样子重画------加粗的仍是加粗,删掉的表格行仍是表格里的一行,图片仍是图片。用文档自己的渲染器把这段内容"序列化"出来,删掉的东西就保留着它当初的模样。
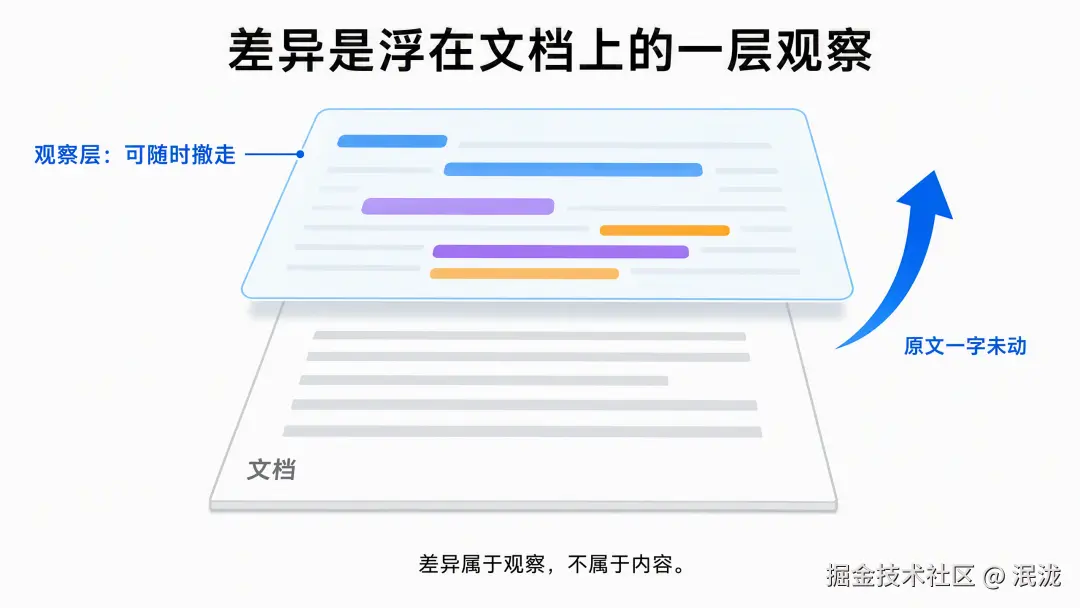 标记是浮在文档之上的一层"观察",不是文档本身的一部分。它可以带多种作者的配色,也可以随时撤走,而不动原文分毫。
php
TYPESCRIPT
// 删除没有位置可贴------把它序列化成只读「补丁块」,插回「它曾在的位置」
function

decorationFor
(doc:
Node
, change:
Change
):
Decoration
 {

if
 (change.kind ===
'deleted'
) {

const
 patch =
serializeWith
(doc.schema, change.deletedContent)
// 按原样重画
    patch.contentEditable =
'false'

// 只读:它不是这一版的内容

return

widgetAt
(change.from, patch)
// 贴在它原来所在的位置
  }

return

inlineMark
(change)
// 其余改动就是普通高亮
}一些"想不到但绕不开"的细节,恰好说明把差异"画对"本身就是一门工程:删掉的如果是一个空段落,画面上本来就没东西,得给它留一个最小的占位,否则你根本不知道"这里删过一段";被删的内容对读者应当是不可选中的,否则复制整页时,会把已经不在这一版的字也一起带走;块级元素(图片、表格)没有"文字"可染色,只能整块淡出加下划线;而表格单元格往往自带底色,会把高亮整个盖住,得再单独补画一层。这些都不是算法的错,是"显示"这件事自带的重量。
五、最重要的一个协议:差异是"观察",不是"内容"
如果这篇文章只让你记住一件事,我希望是这个。
这里有一个极其克制的设计决定:所有差异标记,只活在编辑器的"插件状态"里,永远不写进文档本身。
因为一份差异,描述的是"某个人此刻正在拿这一版和哪一版做对比"------它是一个观察 ,一个视角,而不是文档的内容。
设想把它写进文档会怎样:它会同步给所有协作者,而别人根本没在看这次对比;它会进入撤销历史,于是你按一下撤销,撤掉的可能是一场"对比";它还会被当成正式内容保存下来。三件事全错。
它更像你在打印稿上涂的荧光笔:原件一个字没变,那层荧光也不该被"复印"进正式档案。
csharp
TYPESCRIPT
// 差异只进「插件状态」,从不写进文档
apply
(tr, prev) {

return
 {
    base,
// 在跟哪一版做对比
    changes:
diffDocuments
(base, tr.doc),
// 每次改动都从头重算,而不是平移旧标记
    decorations,
// 只在渲染时贴上去,不落进文档
  }
}
// 文档本身一个字没动:不参与同步、不进撤销栈、不会被保存这个决定,牵出一串连锁的、同样是协议级别的后果。其中一个尤其漂亮:既然标记不进文档、随时可以重算,那么文档每敲一个字,它宁可从头重算一遍差异 ,也不去"把旧的标记平移一下"。为什么不平移?因为位置是"两份文档比对出来的结论 ",不是可以随便挪动的标签------你改动一个字,很可能让原本判定为"整段重写"的地方,变回"其实没怎么变"。这种"结论变了"的事,靠平移表达不出来。重算,是唯一诚实的做法。
六、另一个协议:署名时,"谁改的"不等于"谁写的"
很多协作场景想知道"这处改动是谁做的"。要支持它,就得先立一条很硬的契约:你给的坐标,必须是新文档里的坐标,且必须从那份文档本身推导出来。为什么这么严?因为只要把同一份内容解析两次,中间任何一个规范化规则悄悄变了一点,这些范围就会无声无息地漂到别人头上------不报错,只是名字错了。
更值得说的是"署名"这件事的立场,可以概括成一句话:范围是一份"增量",不是一份"户口普查"。
它要回答的是"从旧版到这一版,这些位置是谁新加进来的",而不是"当前每一个字分别是谁写的"。差别在哪?如果给的是一份"普查",当你在老段落里改了几个字、工具报到"这个段落"头上时,它会去查"这个段落的开头是谁建的"------署名于是给了三年前建这段的人,而真正动笔的人就在一个字之后,根本没被问到。只有"增量",才会在这个老段落上落空,然后顺理成章地问到刚刚动笔的那位。
arduino
TYPESCRIPT
// 署名只认「增量」:这一版里,谁新增了什么
function

authorAt
(position:
number
):
string
 |
null
 {

return
 ranges.
find
(r => r.from <= position && position < r.to)?.author ??
null

// 落在所有范围之外,就返回 null ------ 不知道,就不署名
}
// 删除走单独的通道:删除点常常夹在旧内容之间,范围查询必然落空代价也诚实说出来:删除,几乎没有署名。 因为被删的内容不在这一版里、没有范围;而且大多数协作系统只记录"删了什么",不记录"谁删的"。这里的立场很硬------不知道就不署名,而不是找个"最后保存的人"来凑数。 因为一个猜出来的名字和一个错的名字,是一回事。还有一种情形要单独处理:如果整版是一次性生成的(比如"回滚到上一版"),逐字推演只会把功劳记给原始作者,这时更适合用一种"整版归属"------这一整版,就是按下按钮那位的动作。
七、把算法和协议分开看
回到这一路:切分、配对、下钻、绘制,是算法;标记怎么存在、署名怎么判定,是协议。把它们分开放,会发现一个挺实用的分工:
算法负责"算得准、算得稳、算得完";协议负责"结果长什么样、边界在哪里、该怎么被解读"。
有意思的是,真正难的部分,往往不是那个更快的循环------最短编辑脚本是几十年前就成熟的老办法,社区里不缺实现。真正反复权衡的,全是协议层面的决定:差异不许写进文档;被删的内容要重新画;署名只认增量、不知道就不猜;中文必须单独下刀;连"在服务端数出改动数"这种需求,都得靠把渲染相关的代码隔离在外来满足。这些决定里,没有一个能靠"换一个更快的算法"解决------它们问的都是同一句:这东西到底是什么,它该以什么身份存在。
所以下次,当你再看到工具把整段标红,也许可以想到:它不是坏,只是还没学会下刀,也还没想清楚"差异该以什么身份存在"。而当这两件事都想清楚了,"改一个字",才终于只标出那一个字。