背景信息:
DSH Super-agent:DeepSeek Harness 的开源 Agent 系统原型,本文用它引出事件接入、任务分派与隔离执行。
Matt Pocock 软件工厂:软件工厂设计指引,本文沿用其中 Task、Run、Runner、Trigger 的术语。
Firstmate:多 Agent 协作工具,在个人案例中负责接单、安排并行任务与回收结果。
TreeHouse:本地工作区管理工具,为不同任务创建独立 worktree。
ego browser:Agent 使用的浏览器工具,用于打开业务页面、操作和留存验收证据。
禅道、OMP、dt-proxy:团队工具,分别用于读取任务、查询部署环境和切换本地代理目标。
sdev、dtis ready:项目命令,分别用于启动本地开发服务和执行交付前检查。
OpenTelemetry / OTel:执行轨迹、日志和指标的采集与导出标准,本文用于说明过程观测。
Langfuse:Agent 观测与评测平台,用于汇集执行轨迹、分析失败案例和对比评测结果。
一、引言
最近,DeepSeek Harness 团队发布了 Super-agent 架构文章。它切中的痛点很具体:单个 Agent 已经能独立干活,但同时跑几件事时,人仍要在多个窗口间来回切换,记住每个会话卡在哪里。
他们把交互和执行拆成两层,用常驻入口接收消息,再把任务派给隔离的 Worker。
这套实例跨 IM 和 GitHub 接续同一项开发任务,从群聊反馈中主动排查问题。
核心变化是从"人盯多个会话"转向"系统按事件推进任务"。
外循环就是用事件把多次独立执行串成可重复交付的调度闭环。本文通过结合 hareness / Loop 来看下半年社区对 Agent 的思考。
下面先讲概念,再落到实践,最后看单个 Task 怎么可靠交付和评测。
二、基础架构
外循环讲解主要用 Matt Pocock 的软件工厂词表。DeepSeek Harness 和得物的实践用来对照。
这一章只讲三件事:最小单元、调度,以及怎样用 GitHub 把它们串成一条能跑的流程。
带着软件工程中的分布式设计来看, 你可以更好的理解这里的内容。
1. 最小单元
单次任务内部是模型与工具的闭环,外围由程序提供运行约束。
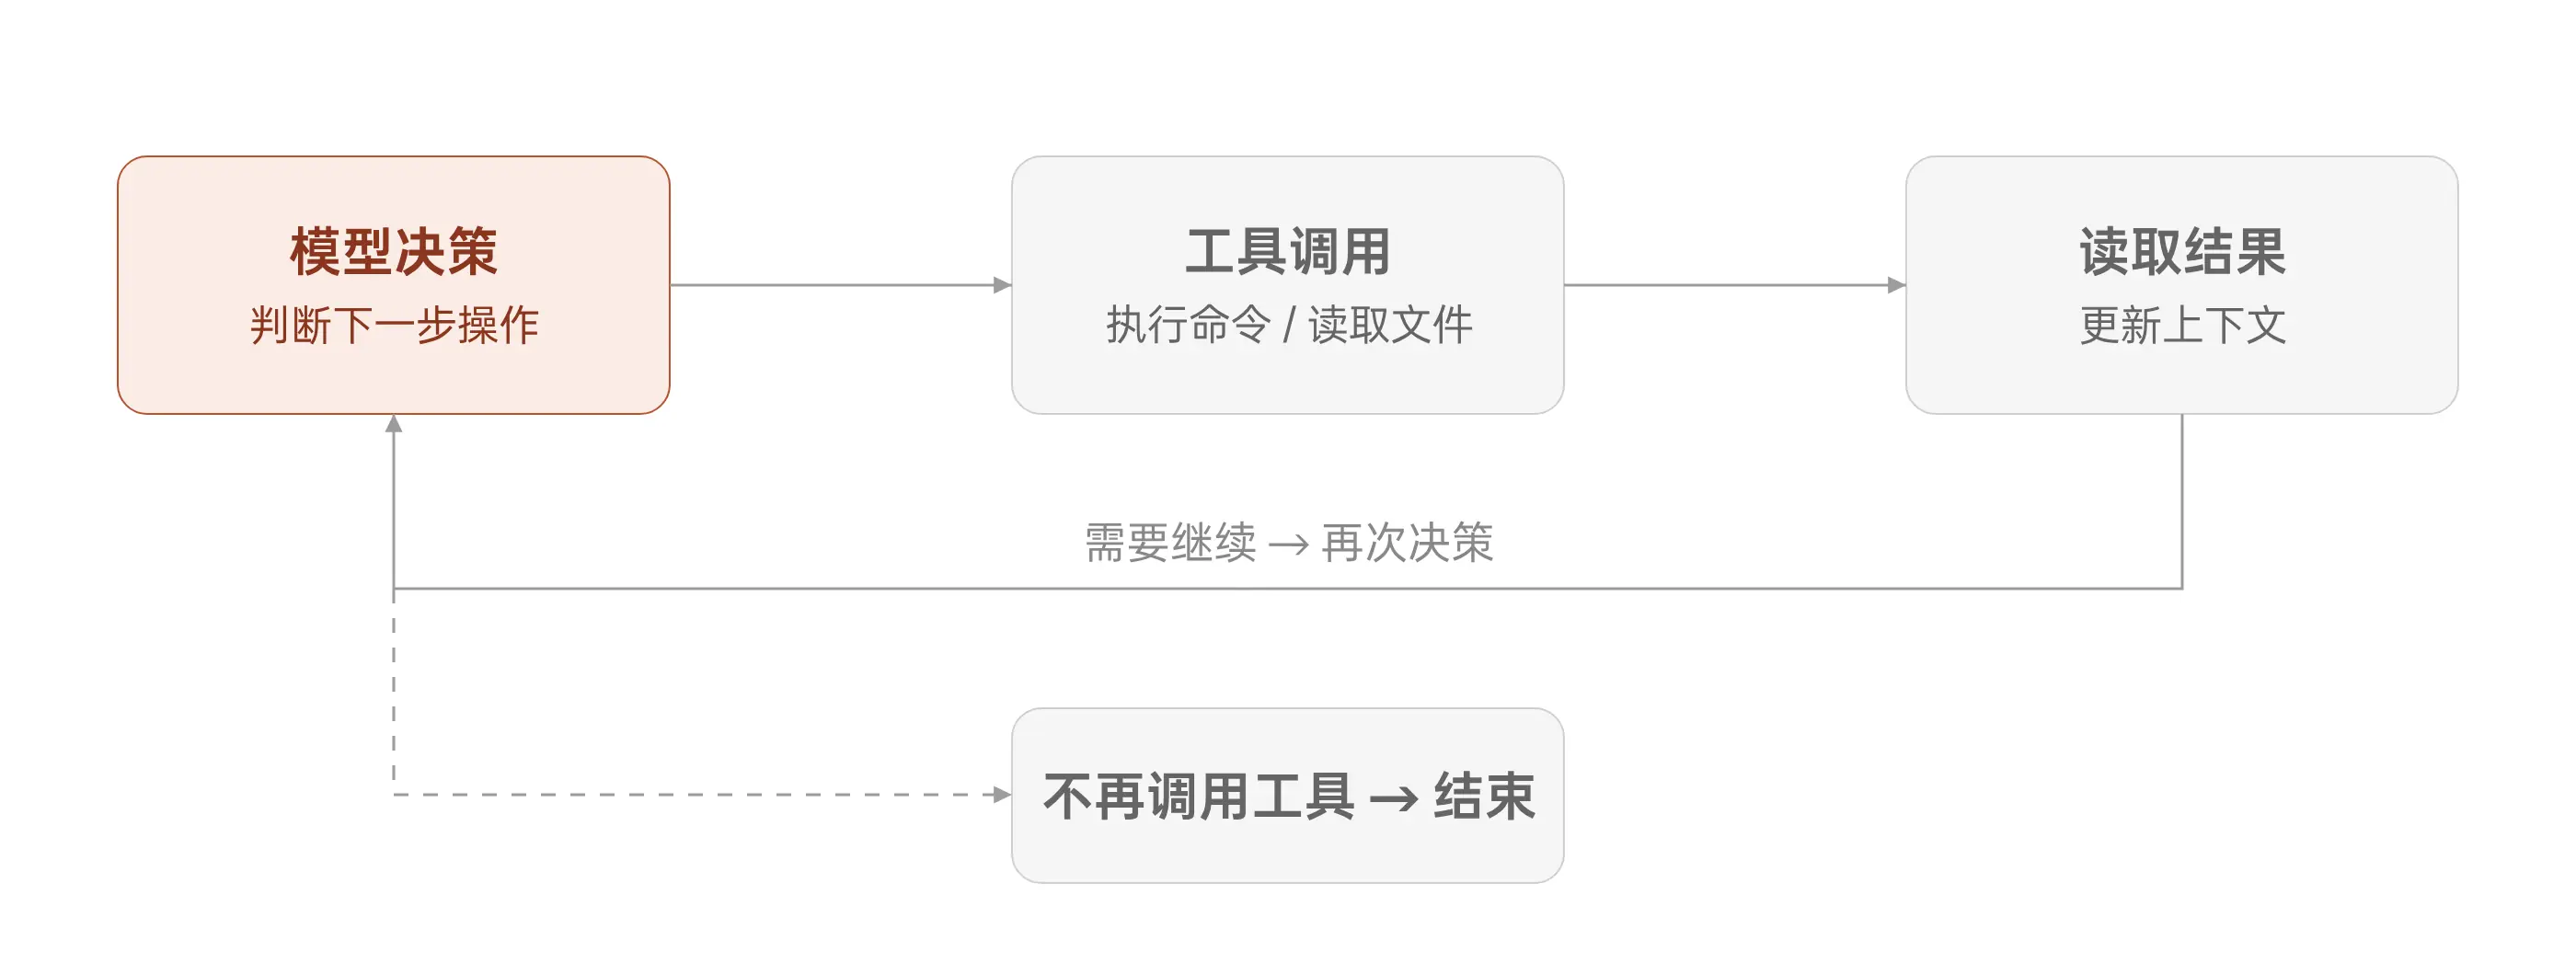
- Agent Loop,模型决定下一步,调用工具,读取结果,再决定是否继续。
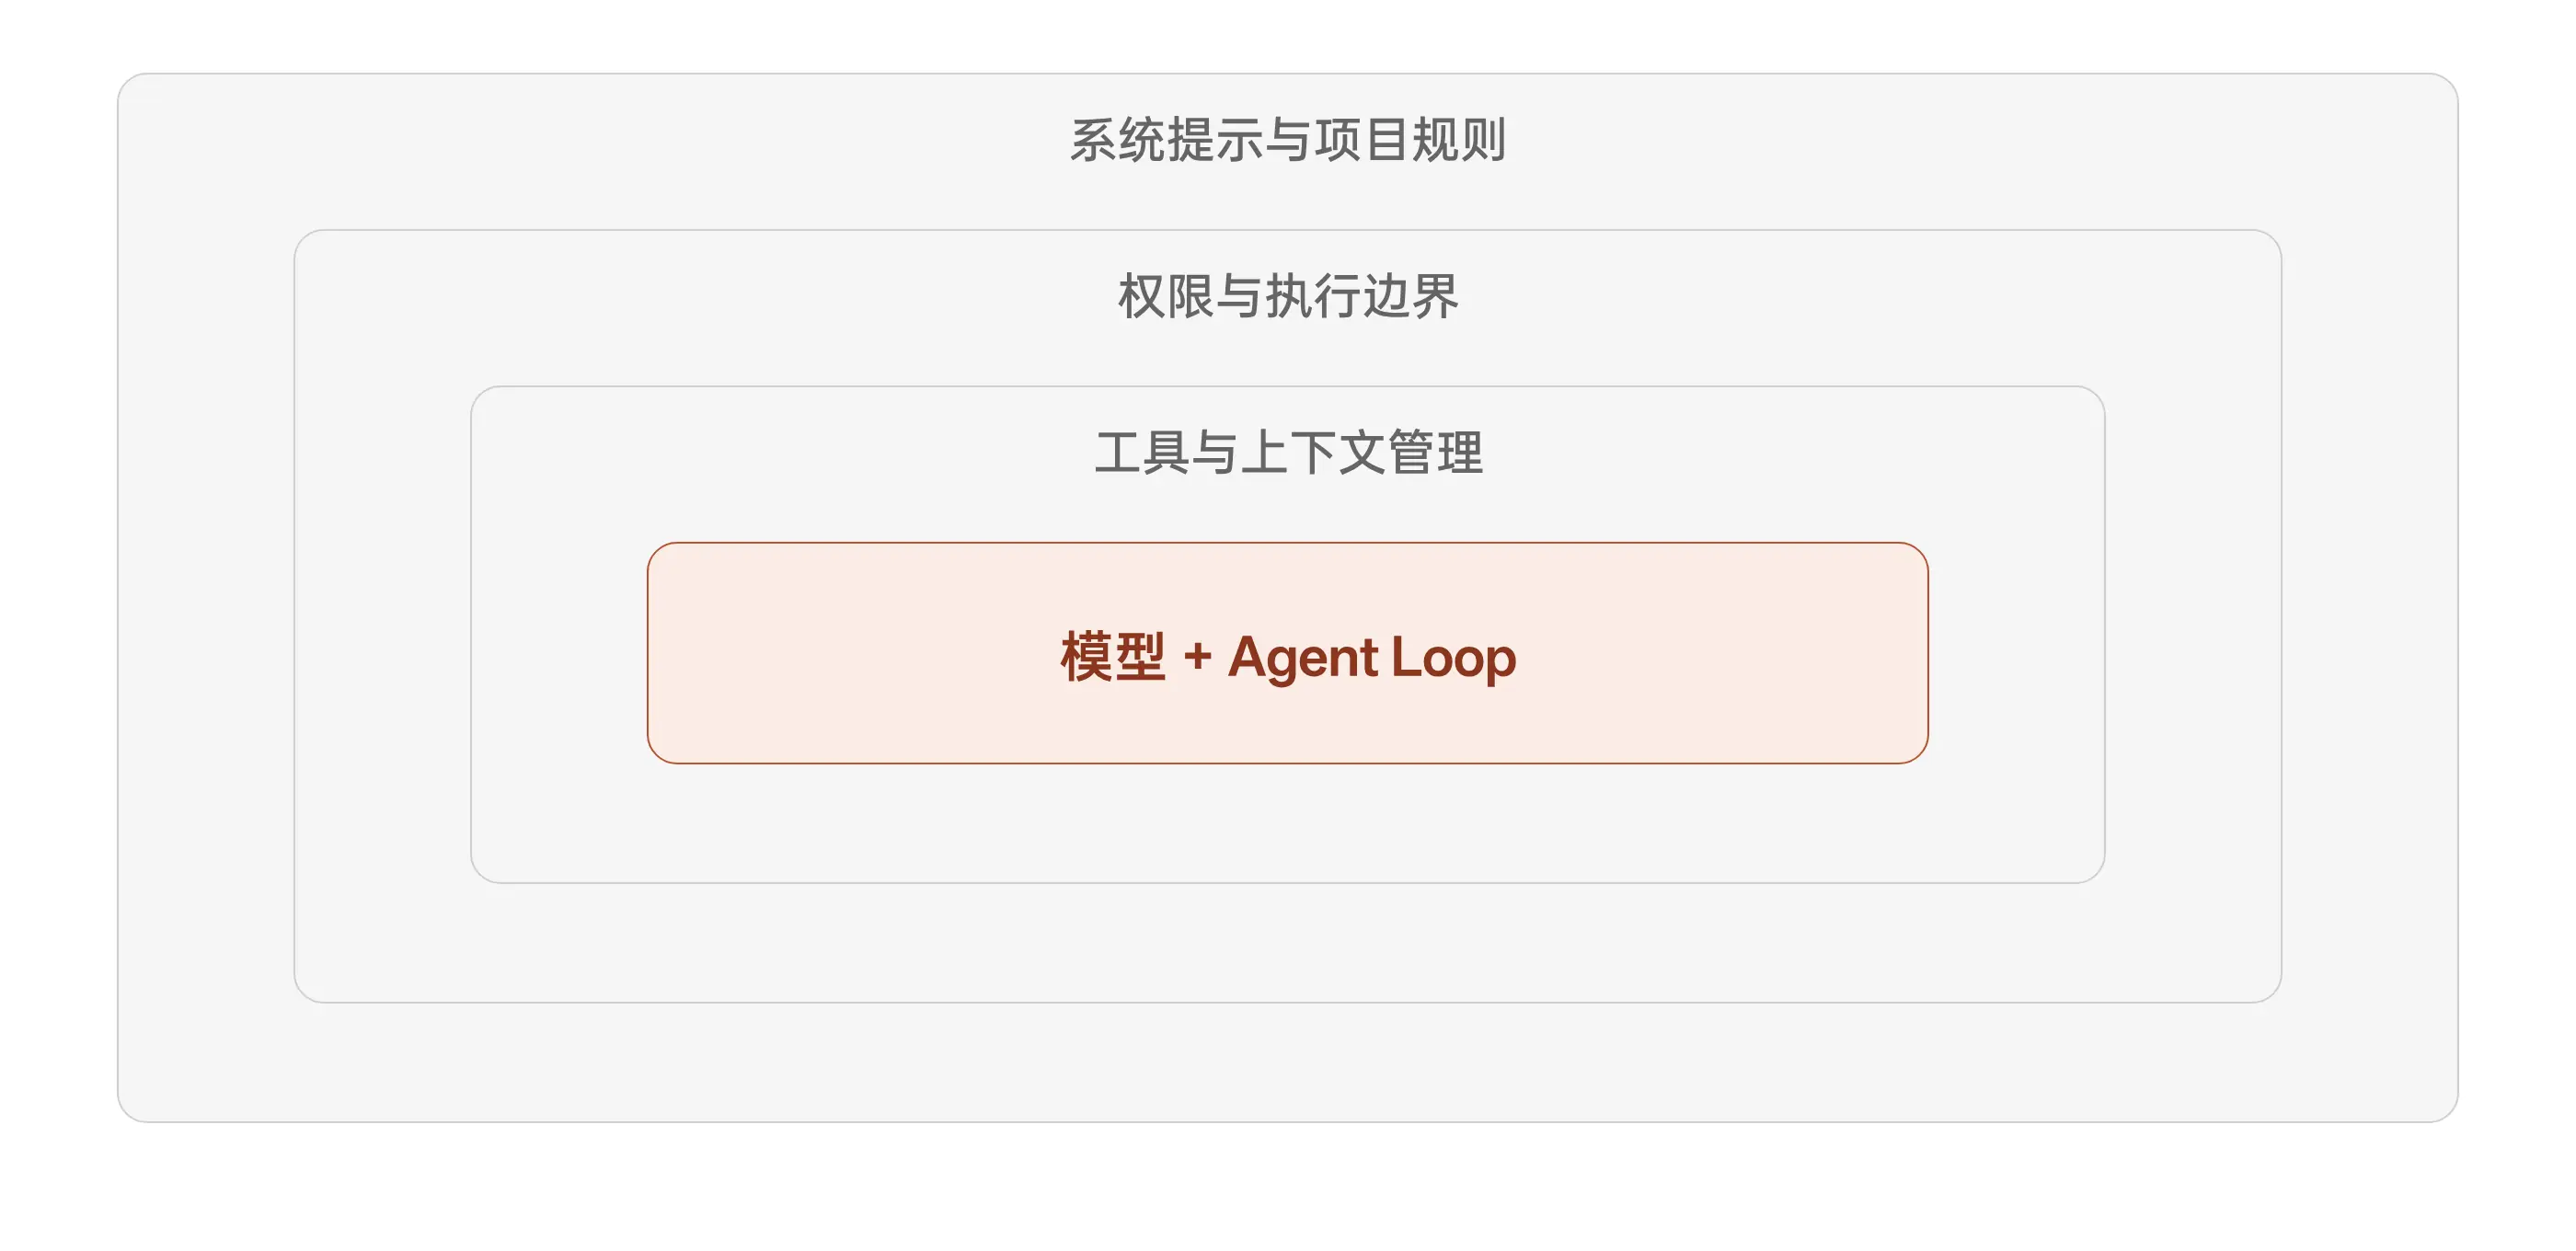
- Harness,围绕模型组织循环、工具、上下文、权限策略和系统提示的程序。
单次 Agent Loop 只覆盖一回执行。一次完整交付通常包含实现、审查、返工等多次执行。外循环用四个对象界定这些执行:
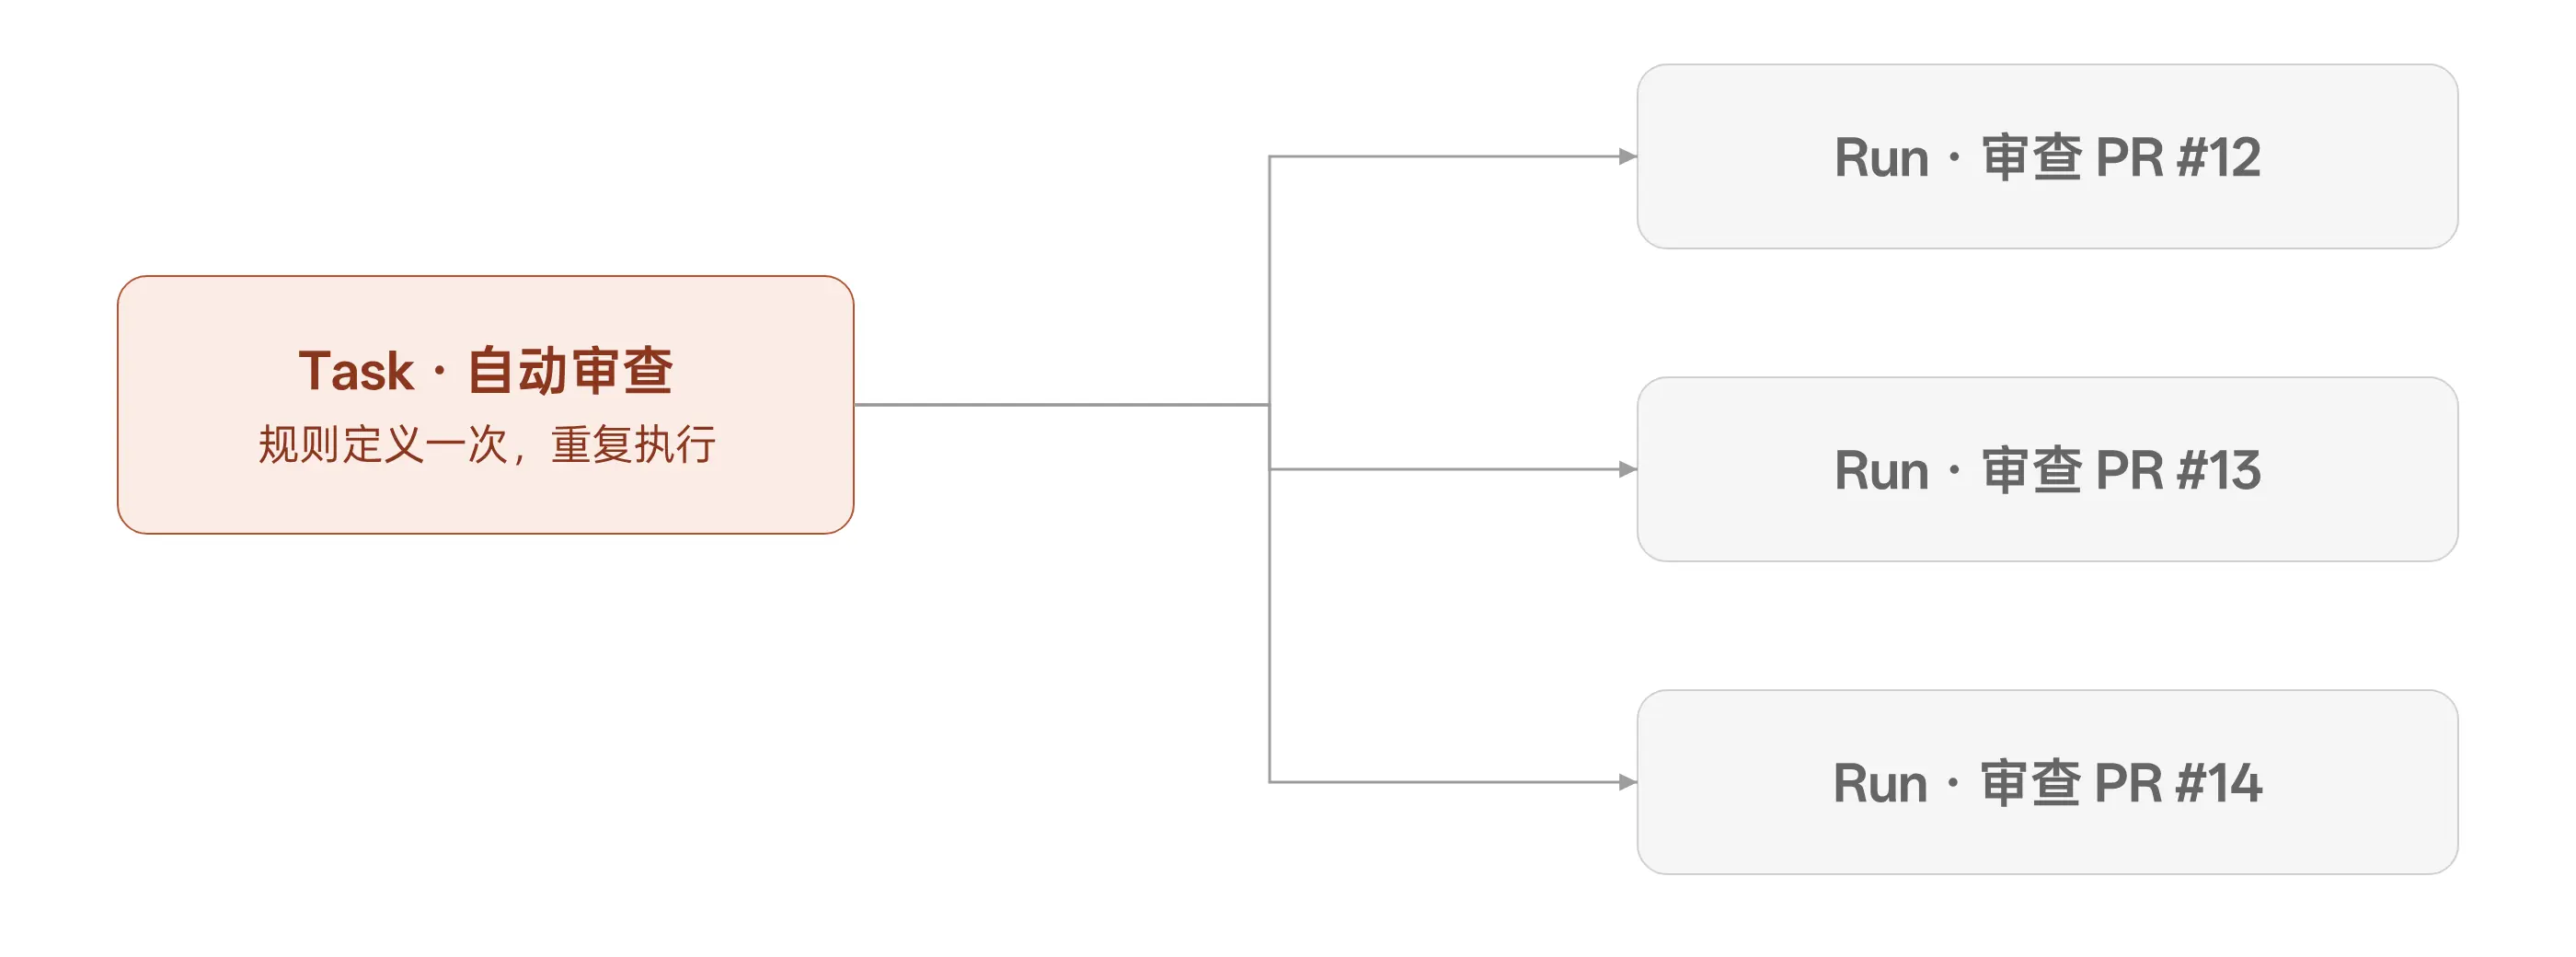
- Task,定义一次、重复执行的工作类型。日常交付里最常用的是实现、自动审查、返工;它们是菜谱,不是某一次具体干活。
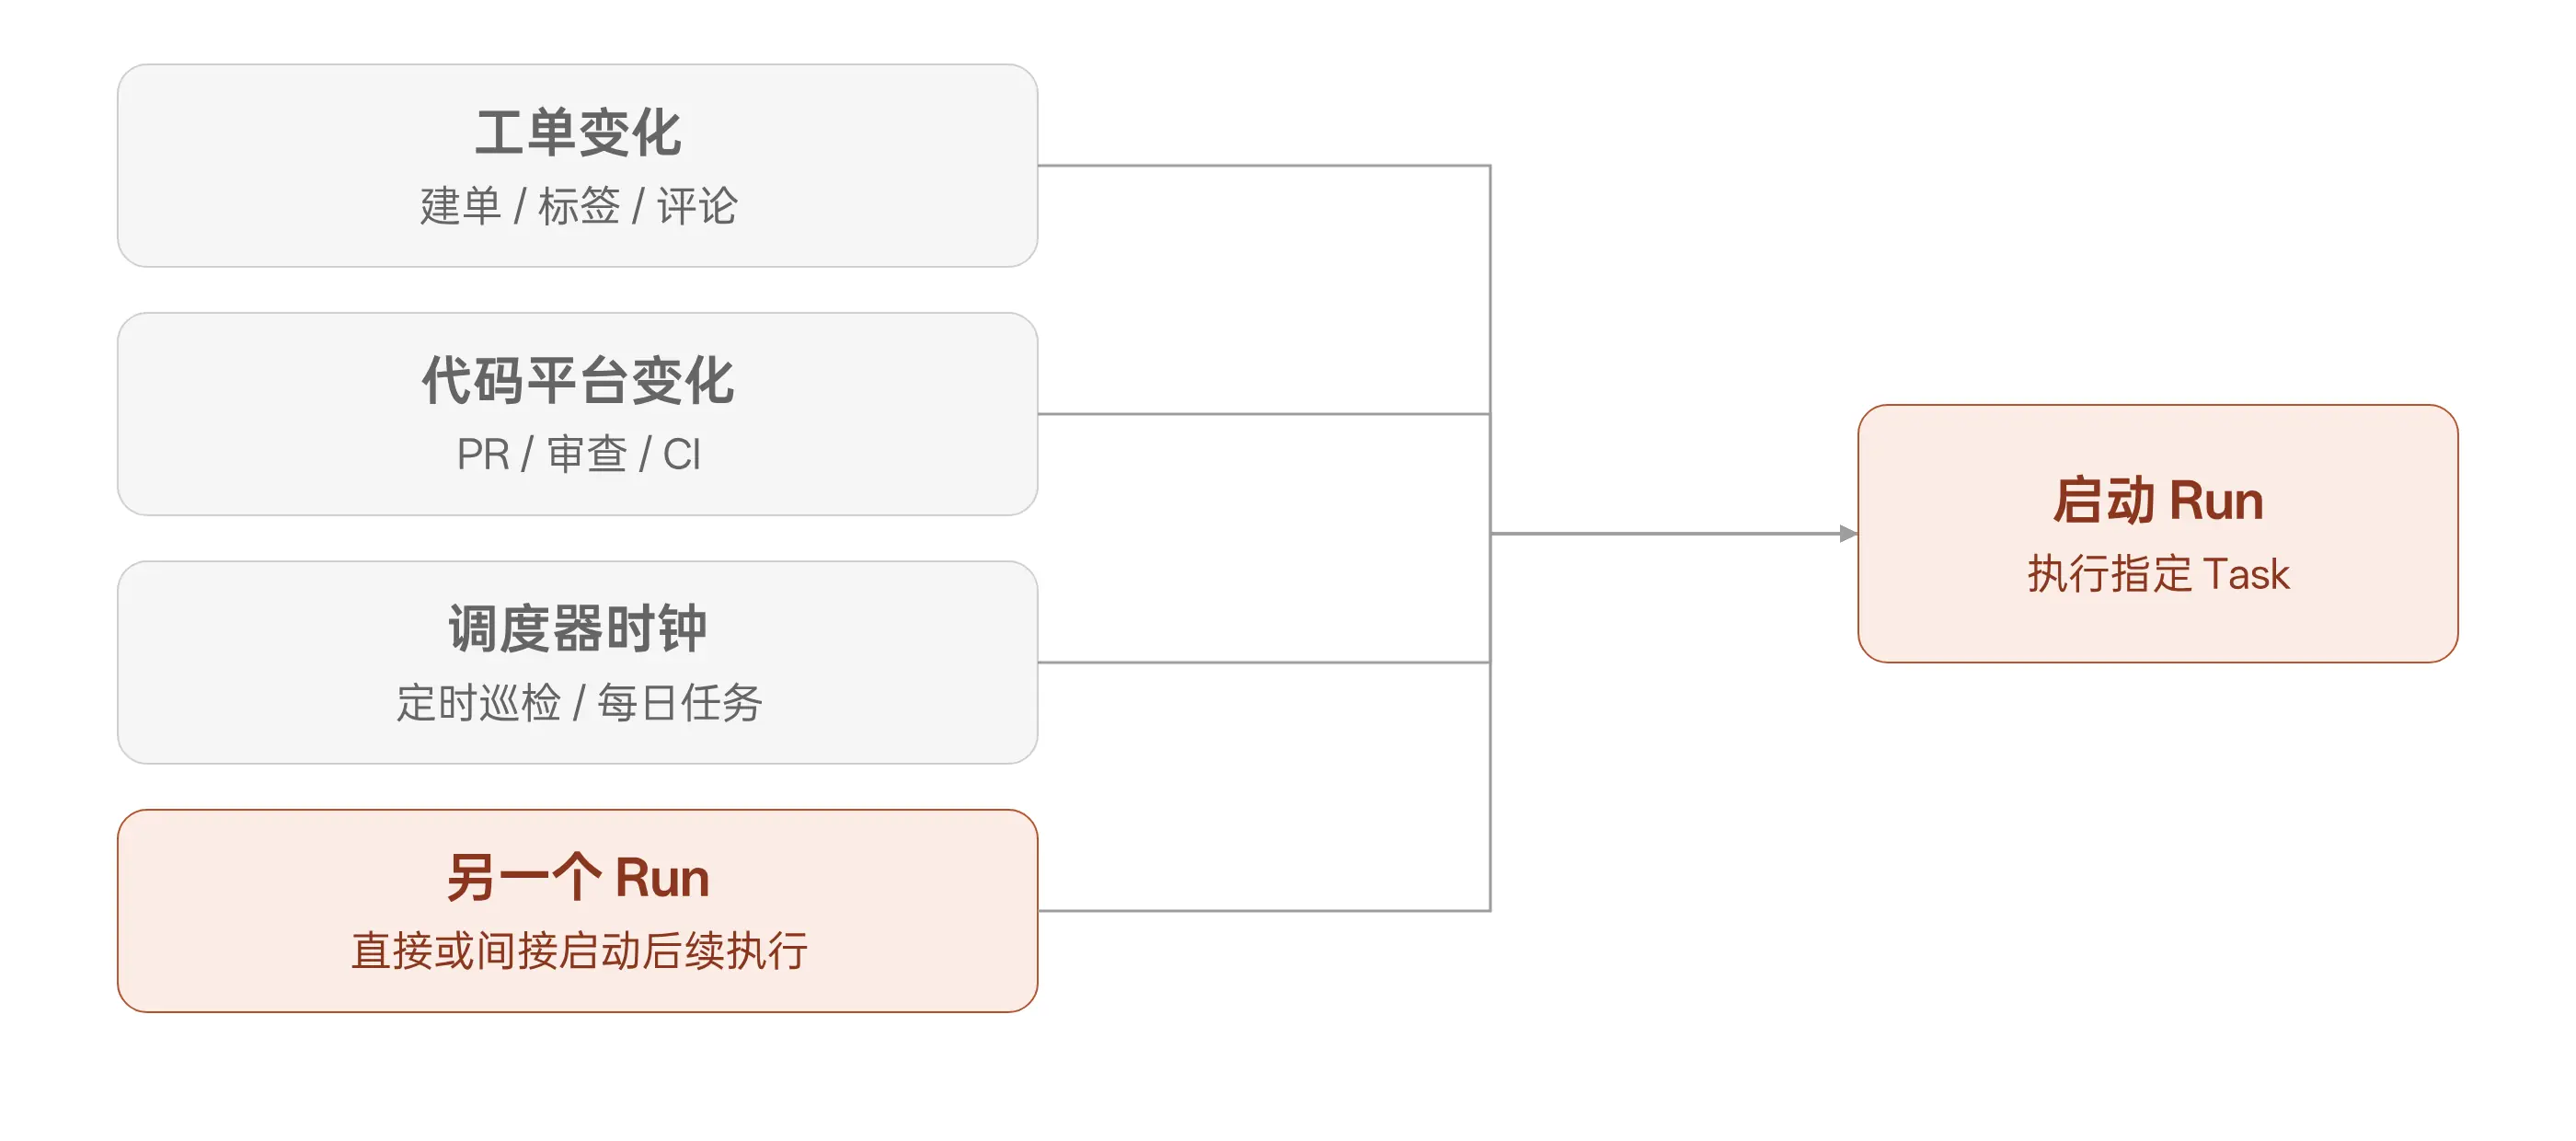
- Trigger,启动执行的事件,来自工单变化、Git 平台变化、调度器时钟或另一次执行。
- Run,一个 Task 在一个 Runner 上的一次执行,从触发到结束视为黑盒,内部可包含多个 Agent Session。
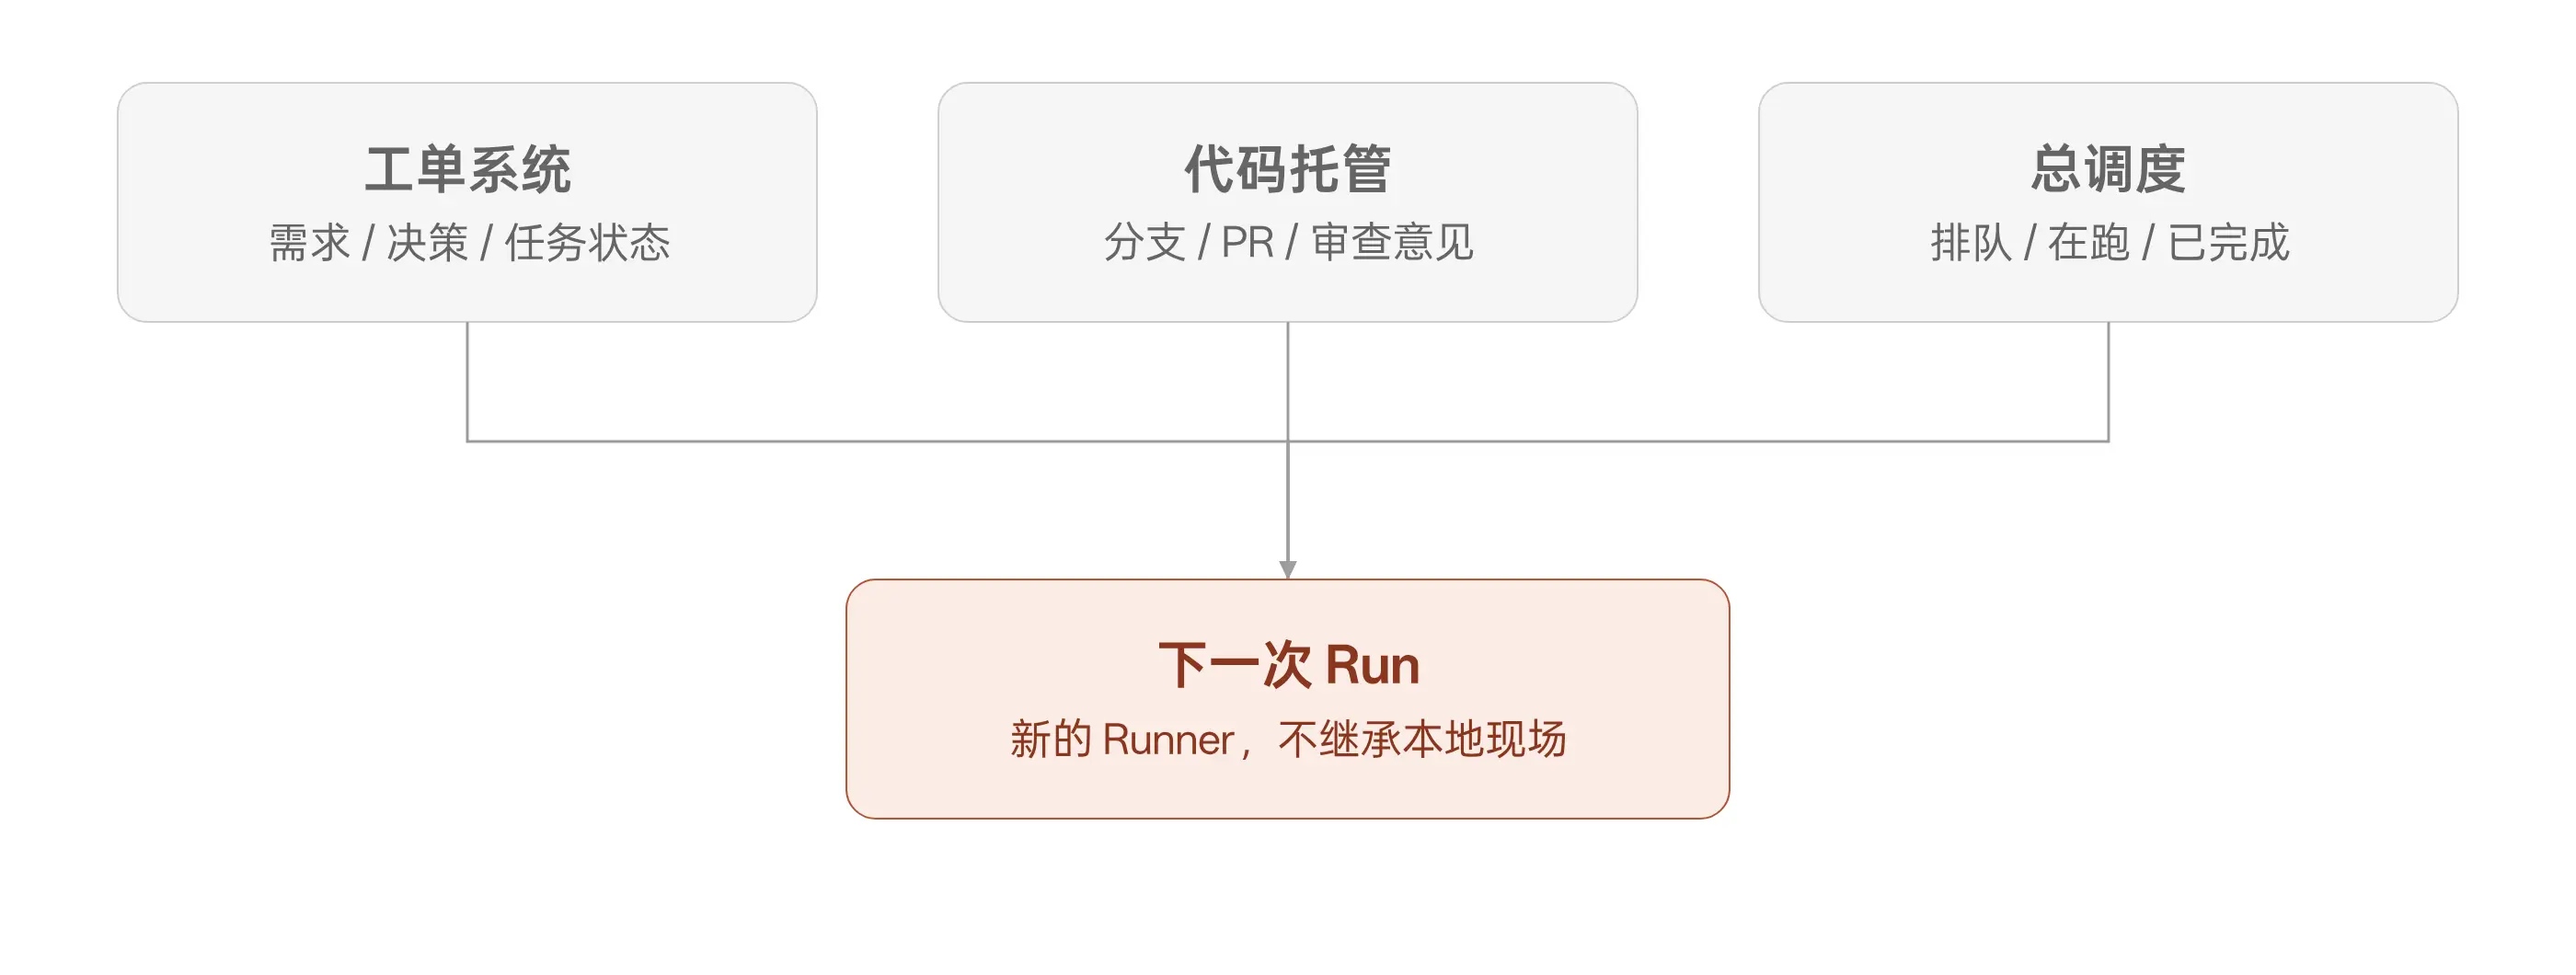
- Runner,一次性执行机器。即使机器长期存在,Run 结束后其执行现场也不保留;历史只能从工单系统、Git 平台和调度器恢复。
Task 定义一次,Run 是这类工作的一次具体执行。后面换的是 Task 种类和触发条件,不是这四个对象。
四类事件都可以启动 Run,不必由人逐次打开会话。
Run 不等待人。需要人工判断时,它记录状态并结束;人的后续工单或 PR 操作触发新的 Run。
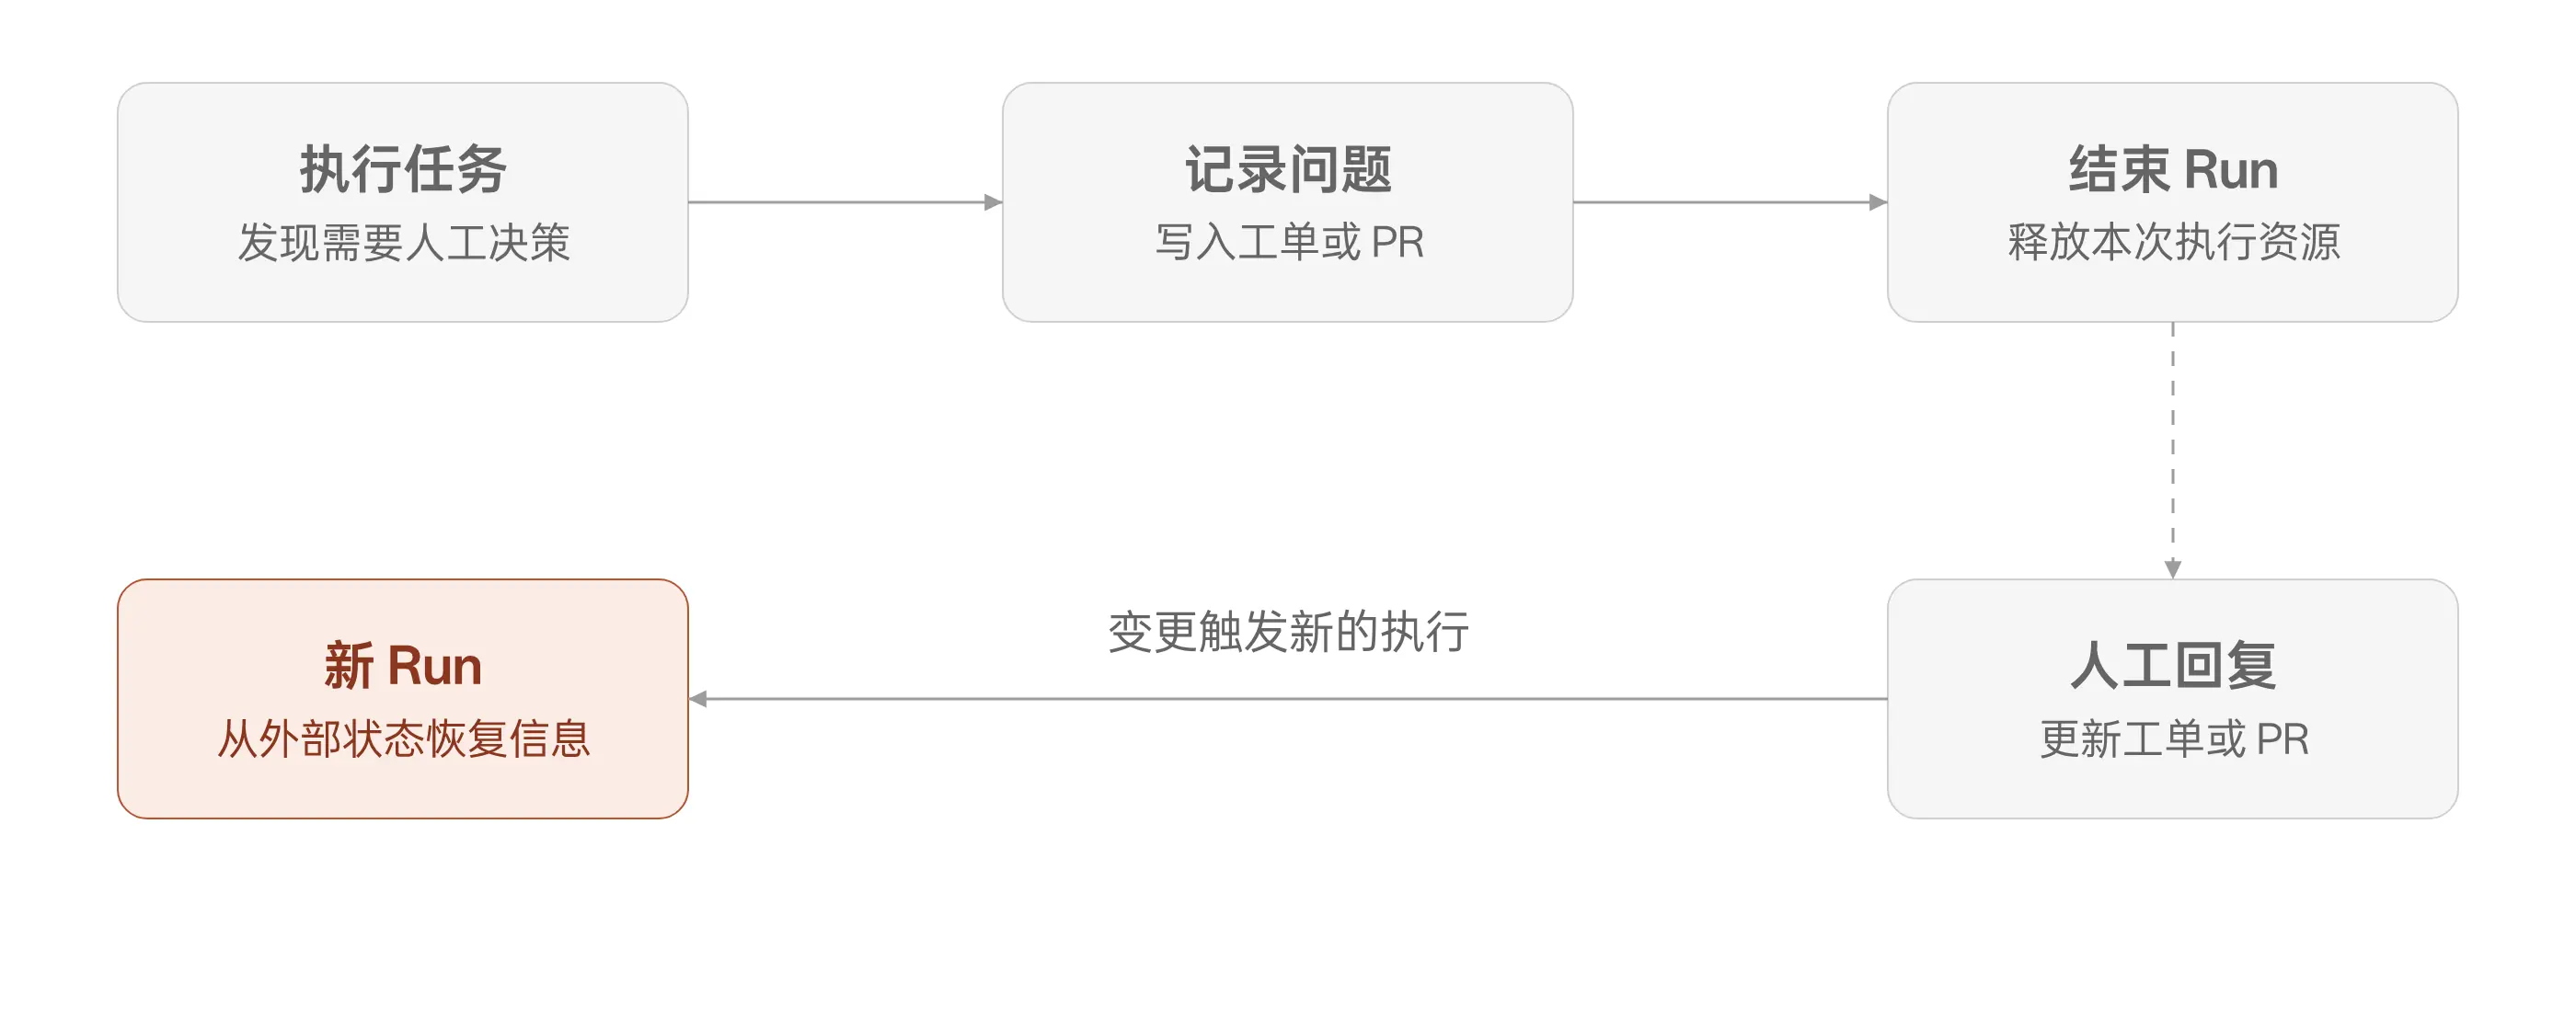
执行现场用后清理。下一次 Run 只从工单系统、代码托管和调度器恢复历史,不继承上一次的本地现场。
2. 调度
最小单元介绍之后,按事件从进到出看调度:Trigger 进来,先过滤,再交给 Orchestrator,最后用确定性规则约束执行、调用 Runner。
这在软件工程里其实已经走了很久,就是分布式那一套。
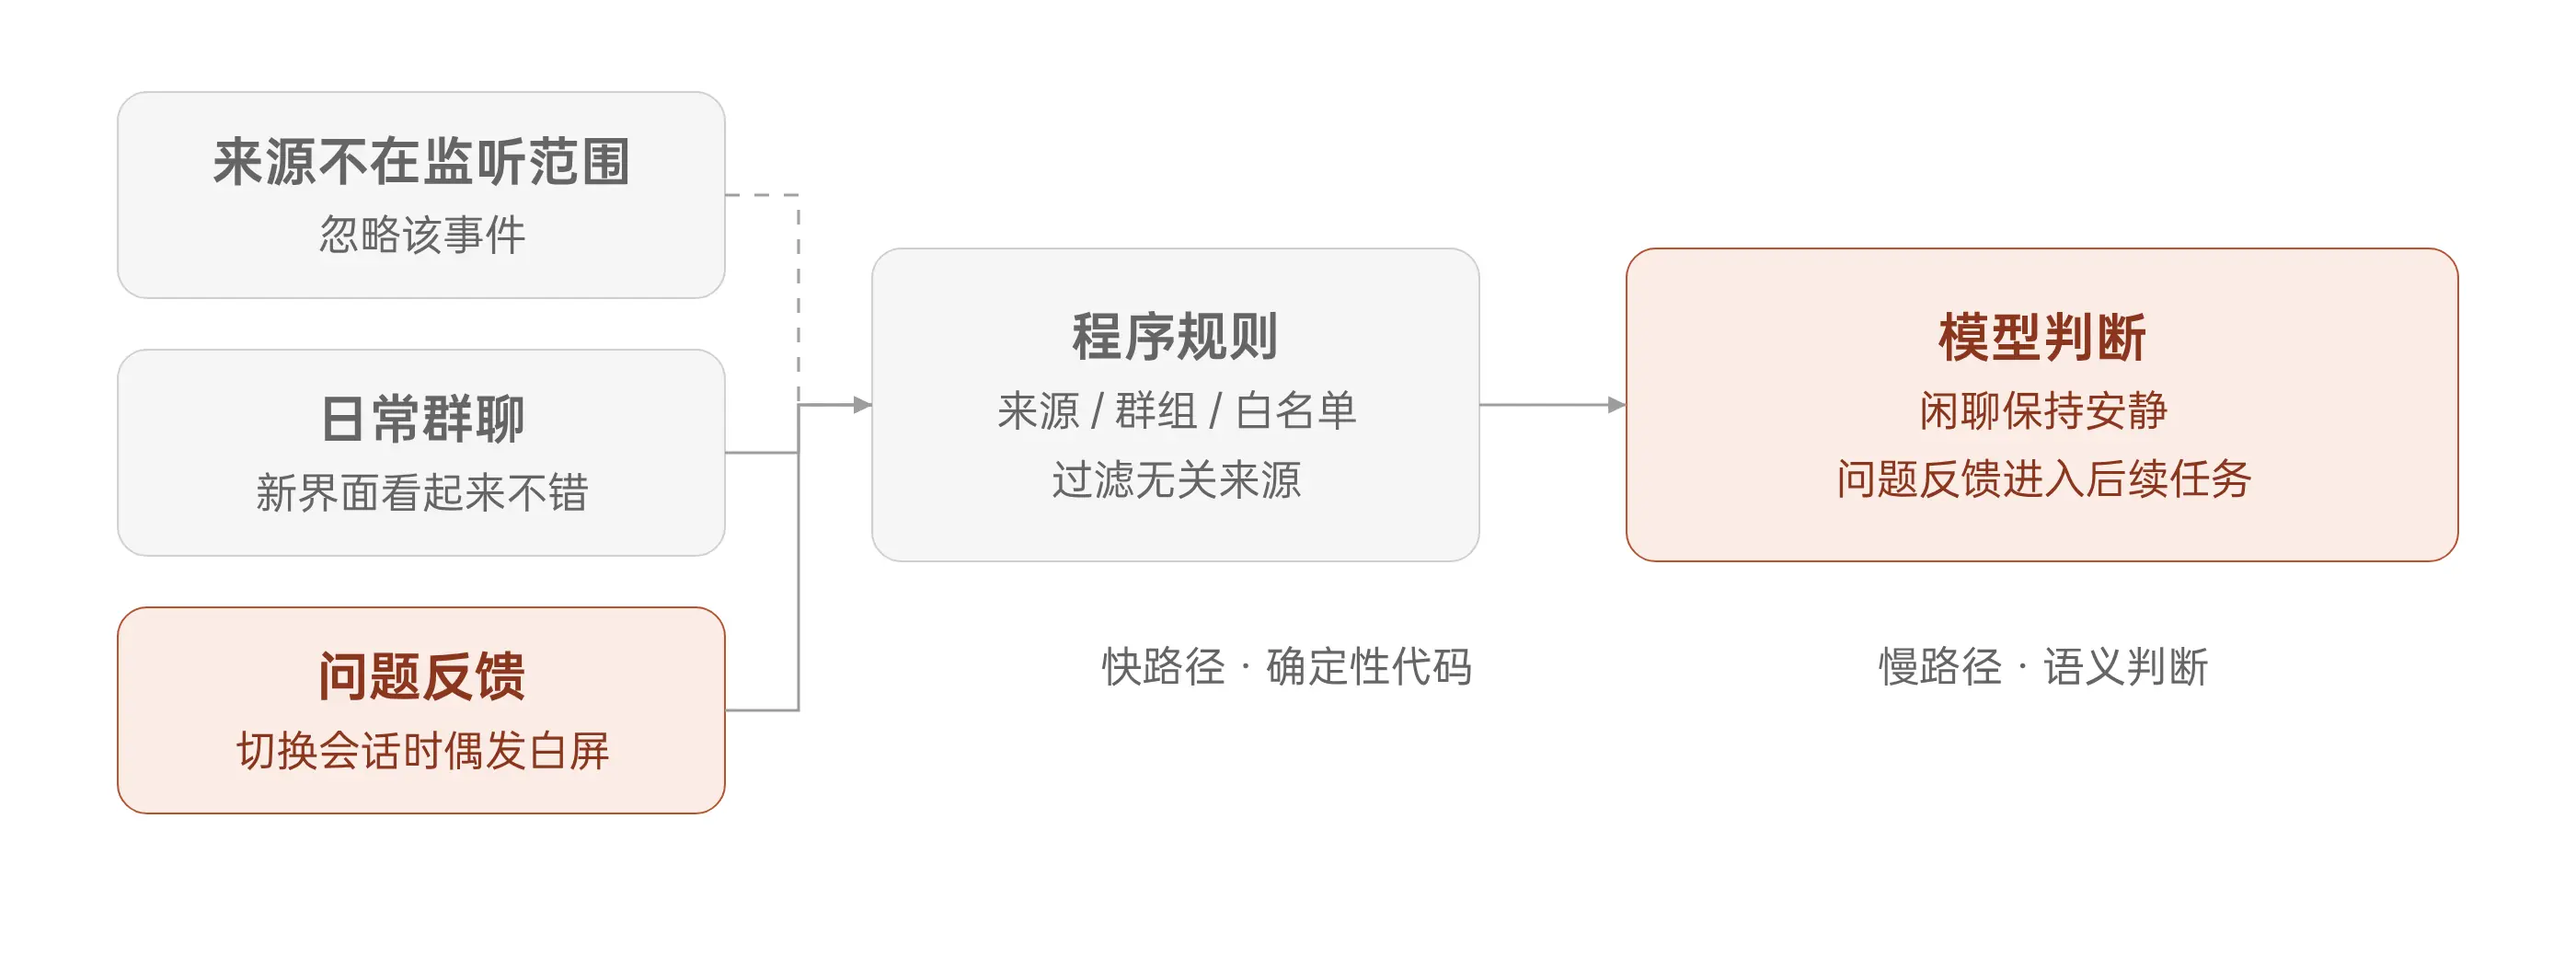
Trigger 进来,先用程序规则丢掉明显无关的,再让模型判断要不要行动。
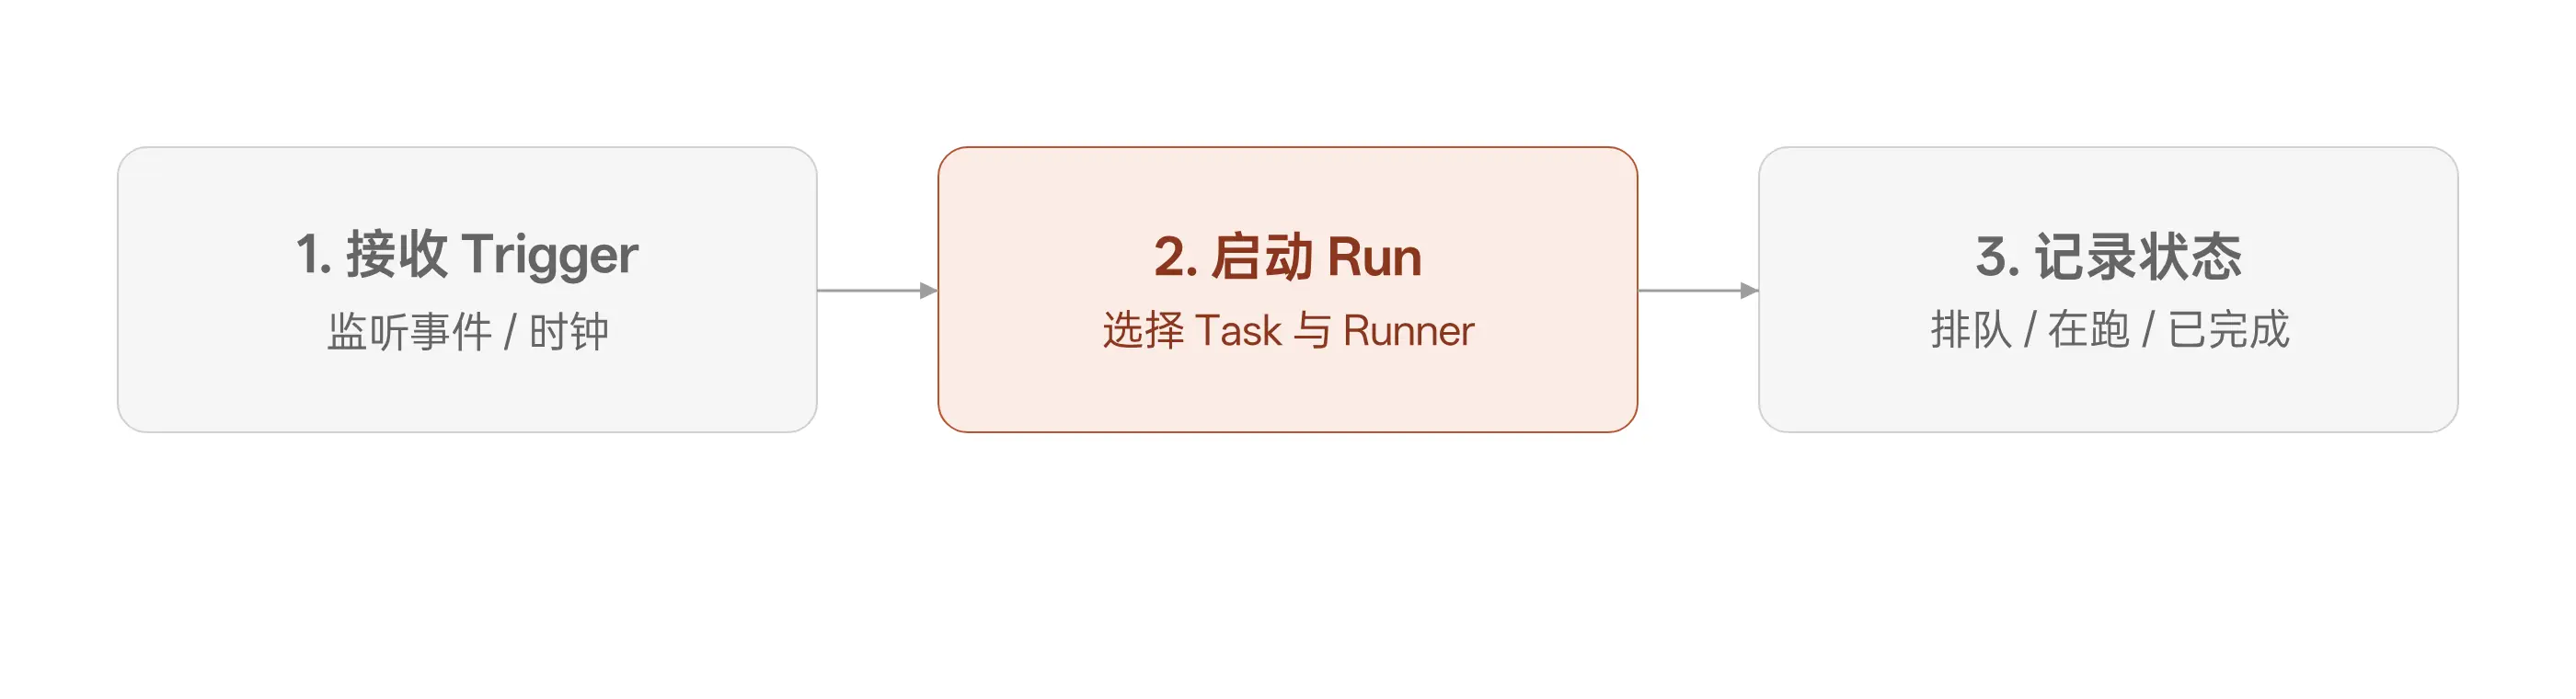
再交给 Orchestrator,它接收任务、在 Runner 上启动 Run,并记录排队与结束状态。
用规则约束执行,去重、并发上限、重试封顶交给代码;工单分诊、是否行动和 Task 选择交给模型。
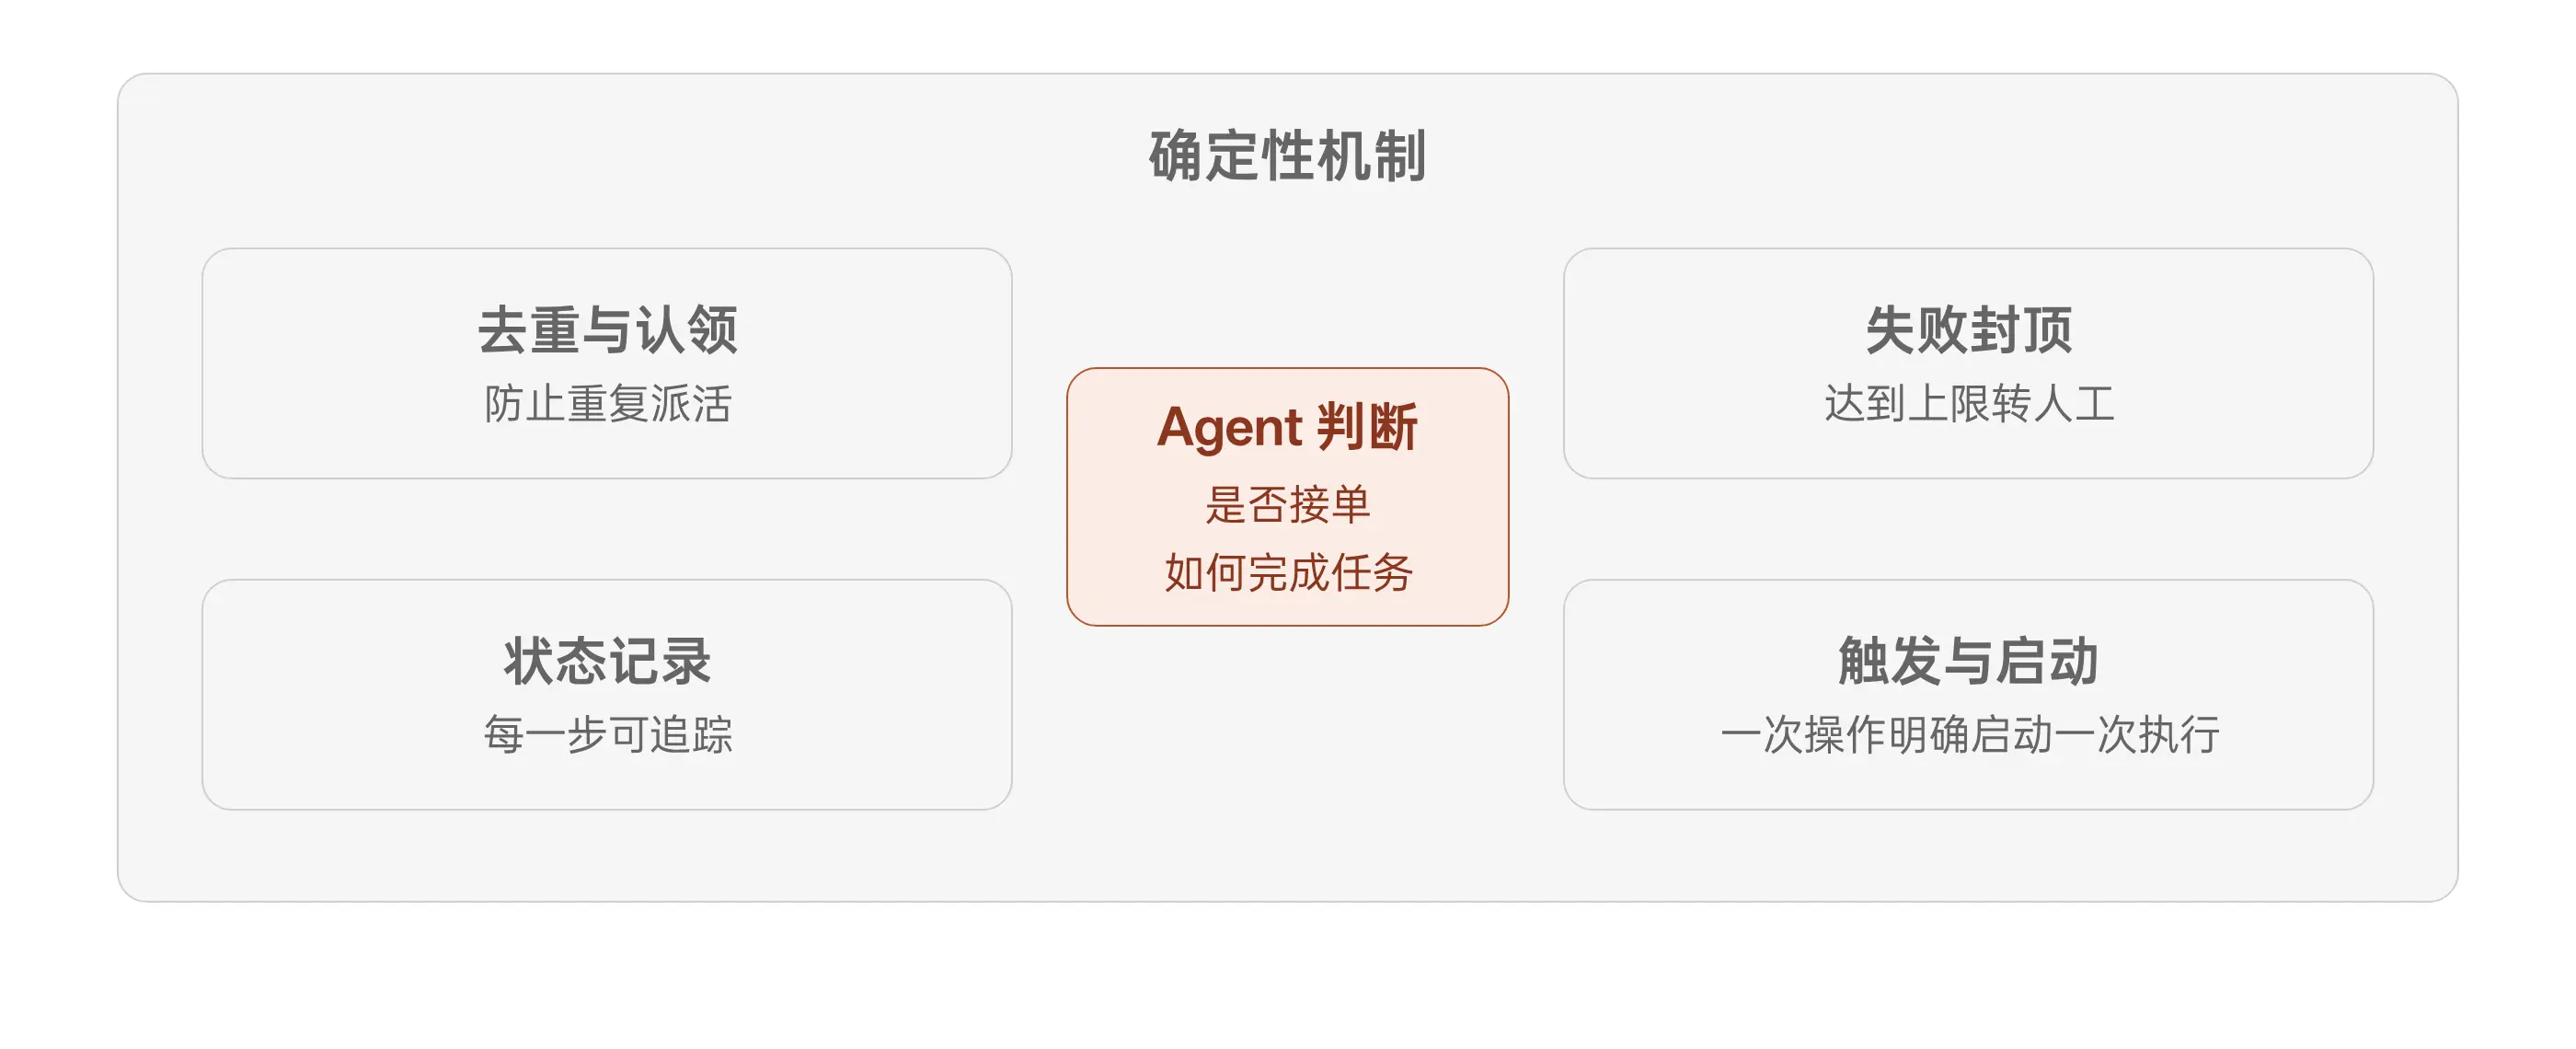
完成后,需求、决策和代码历史留在工单系统与 Git 平台;排队与执行状态留在调度器。 这样每一步都能追踪,保持 SSOT,任务上下文也不丢。
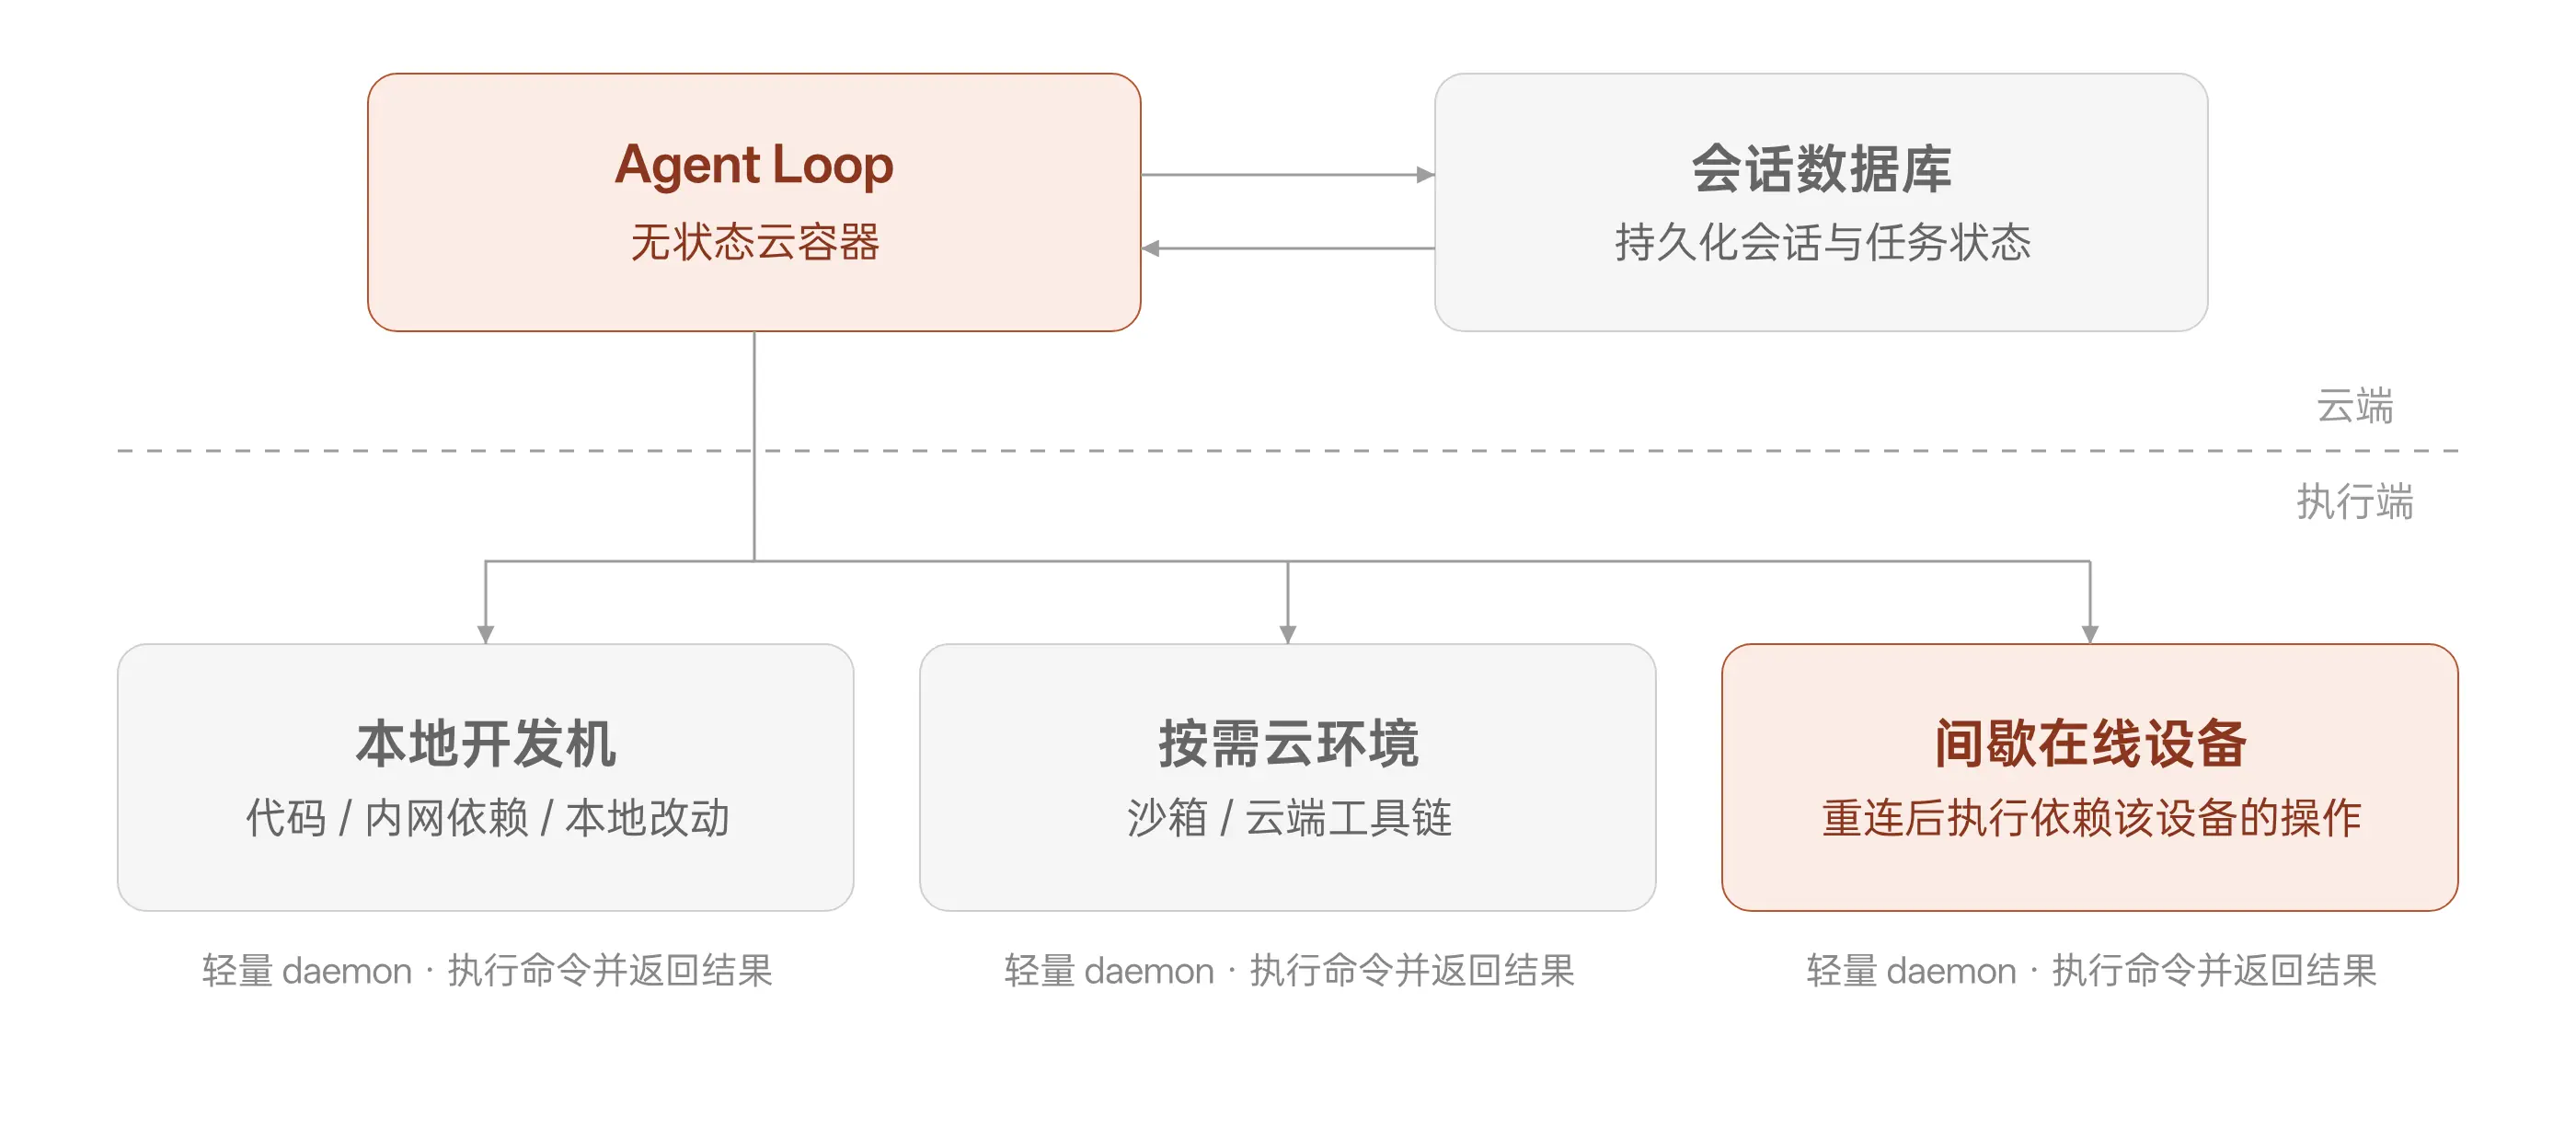
计算也可以和代码环境分开:Agent Loop 与会话状态在一处,仓库、内网依赖和凭据在另一处,经轻量通道执行命令。比如 Cursor 支持 Loop 在云端、环境用用户设备。
3. 编排组装
最小单元和调度齐了,接下来就看工单怎么进来、验证后的代码怎么出去。下面用 GitHub 串一条能跑的链路。
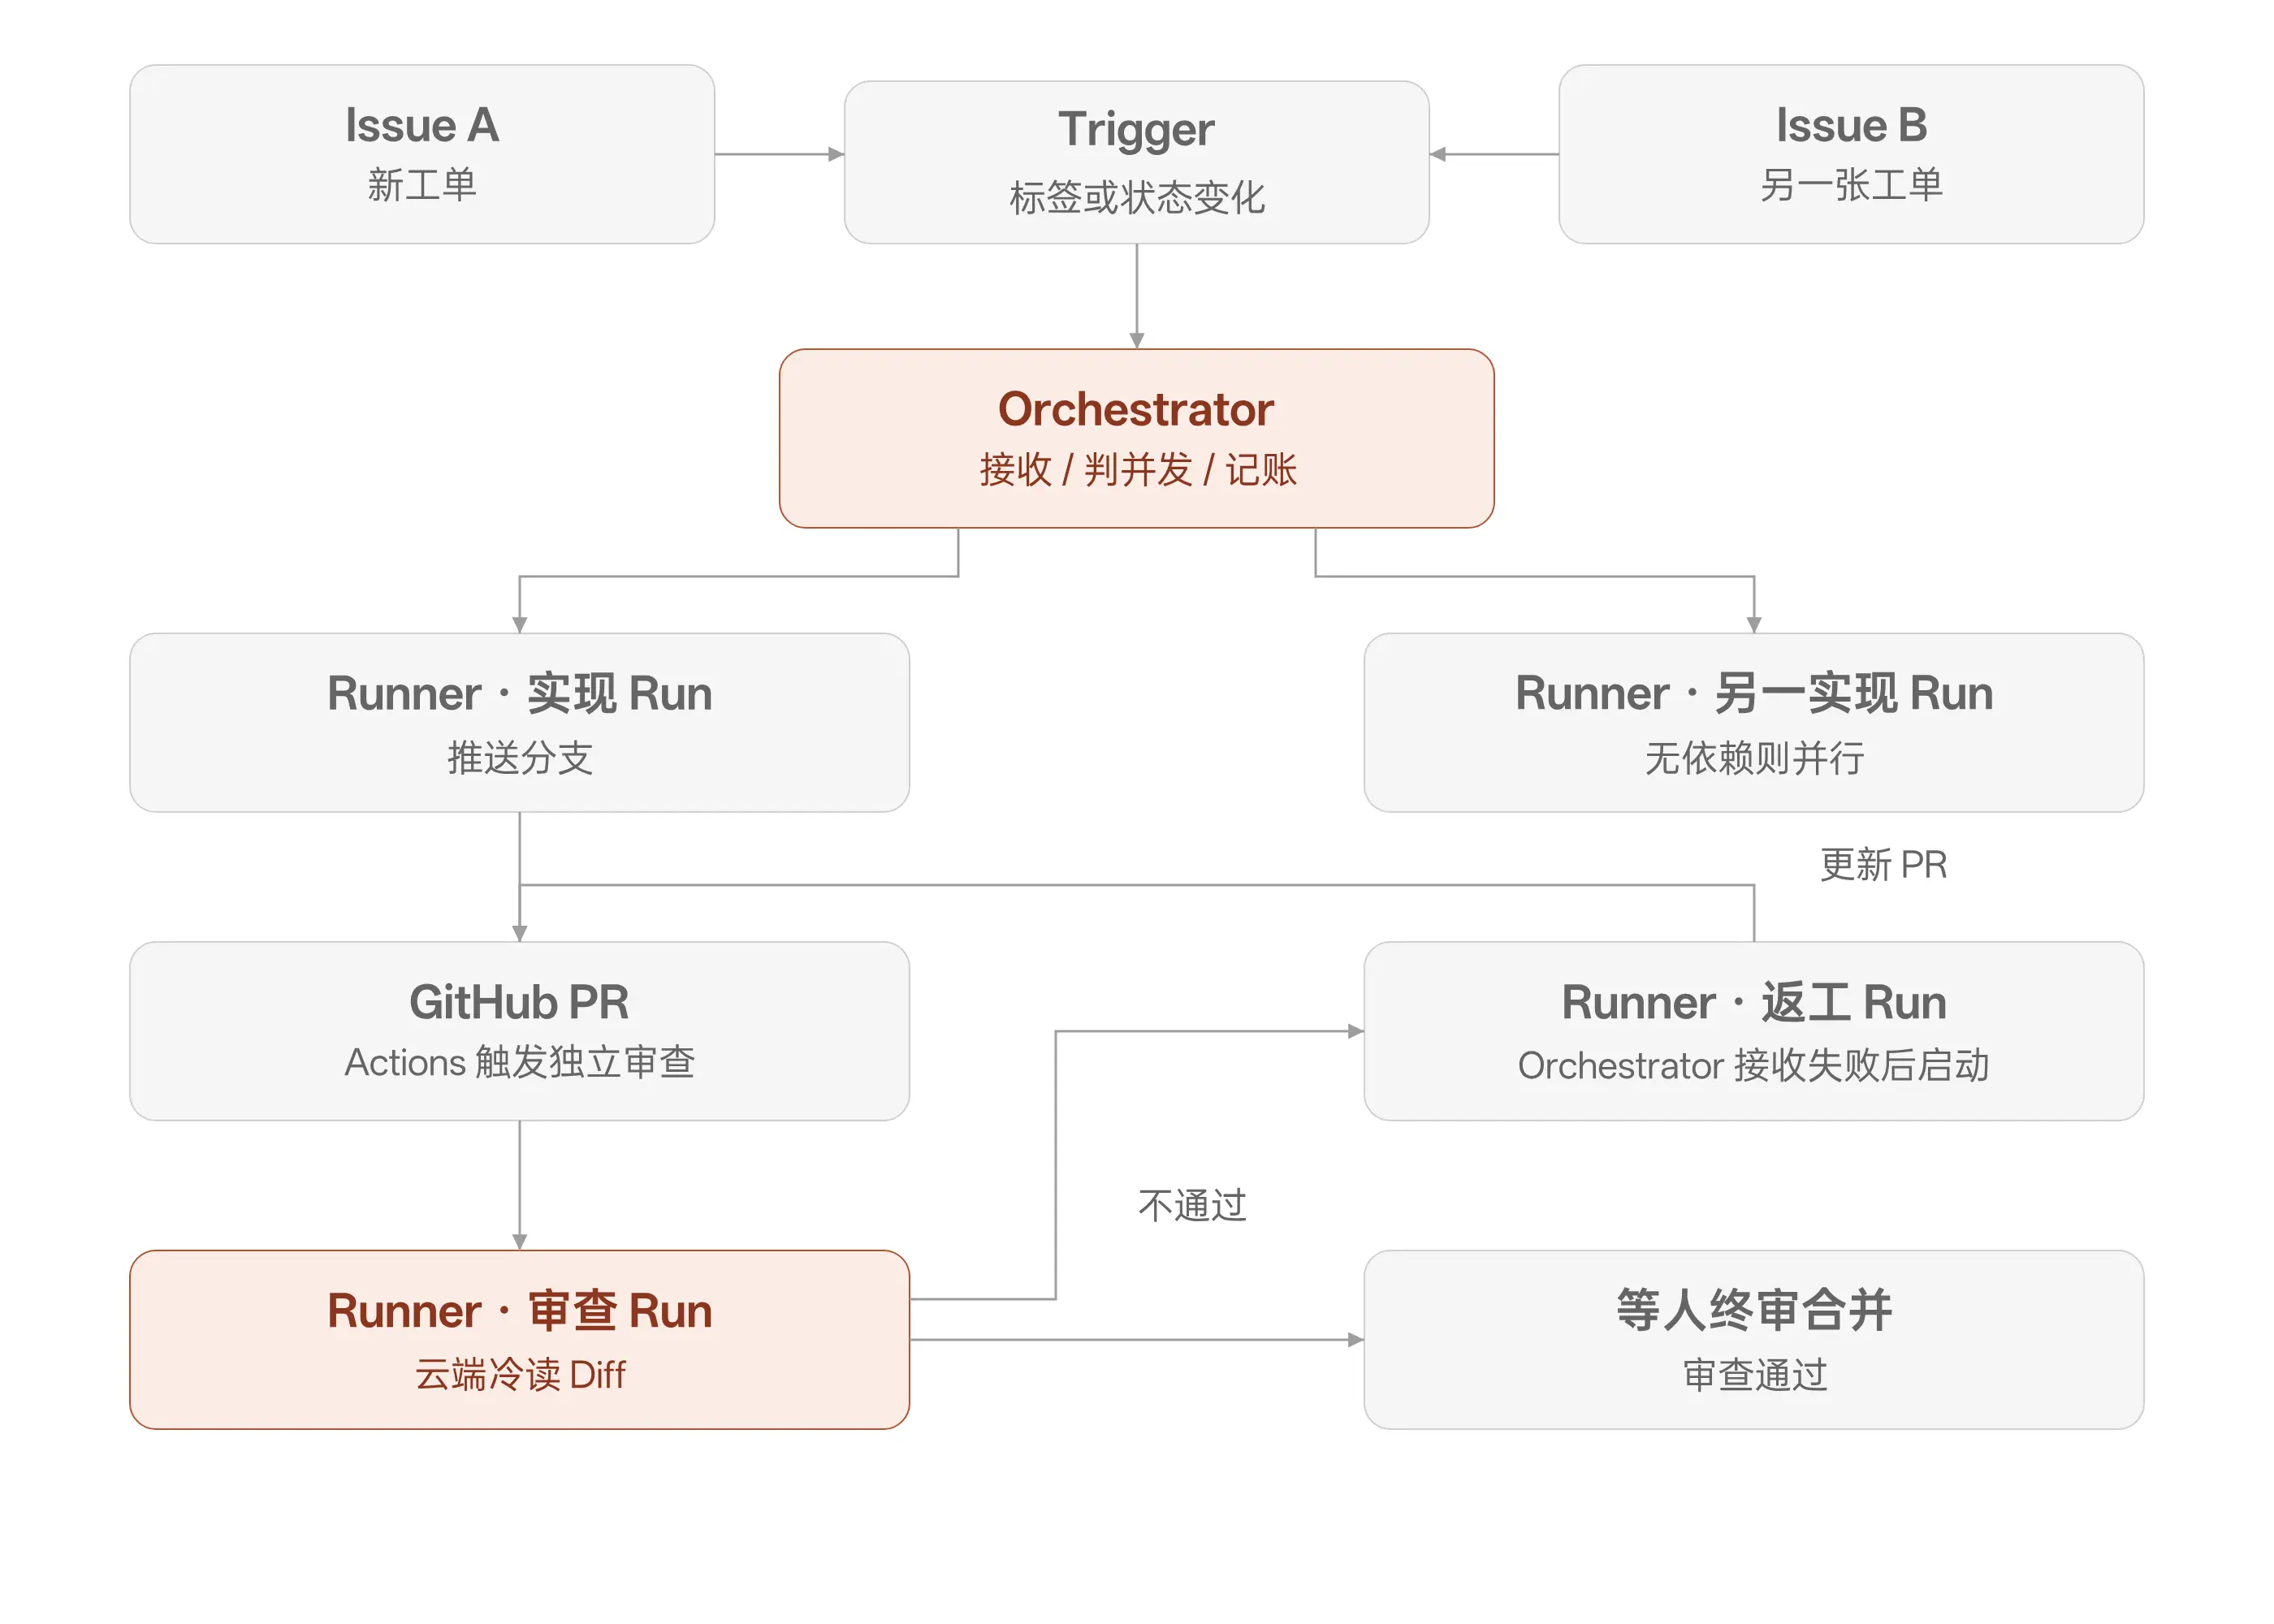
先看这张图里的主路径。
- Issue 就是 Ticket ,一张 GitHub Issue 进入可执行状态,比如打上
ready-for-agent,状态变化本身成为 Trigger。 - Orchestrator 接单,它接收 Trigger,记下排队,按实现 Task 派一个 Runner。Runner 改代码、推分支、开出 Draft PR,然后结束并清理现场。
- PR 触发审查,PR 的创建或更新拉起 Actions;云端再开一个独立的审查 Run,冷读 Diff,对照规范和来源 Issue。
- 不通过就返工,审查失败时,结论写回 PR 或 Issue,Orchestrator 再开一个返工 Run,只修被点名的问题,更新同一条 PR,再次进入审查。通过后才进人终审合并。
这就是用实现、审查、返工三类 Task 转起来的循环。
Orchestrator 同时还能接新的 Issue。第二张单到来时,它要判断两件事:和正在跑的单有没有依赖;没有依赖就并行派另一个 Runner,有依赖就挂起等待。它做的是调度与记账,不代替 Runner 写业务代码。
三、案例参考
同一套模块,可以看到在不同的产品上起到作用。
| 深度 | 例子 | 看什么 |
|---|---|---|
| 个人场景 | Firstmate + GitHub | 本机接单、实现、Actions 审查 |
| 成熟产品 | Cursor Projects | 协调者规划、并行执行、事件订阅 |
| 应用侧调度 | 得物巡检 | Master 路由,组件内自己编排 |
1. 个人场景
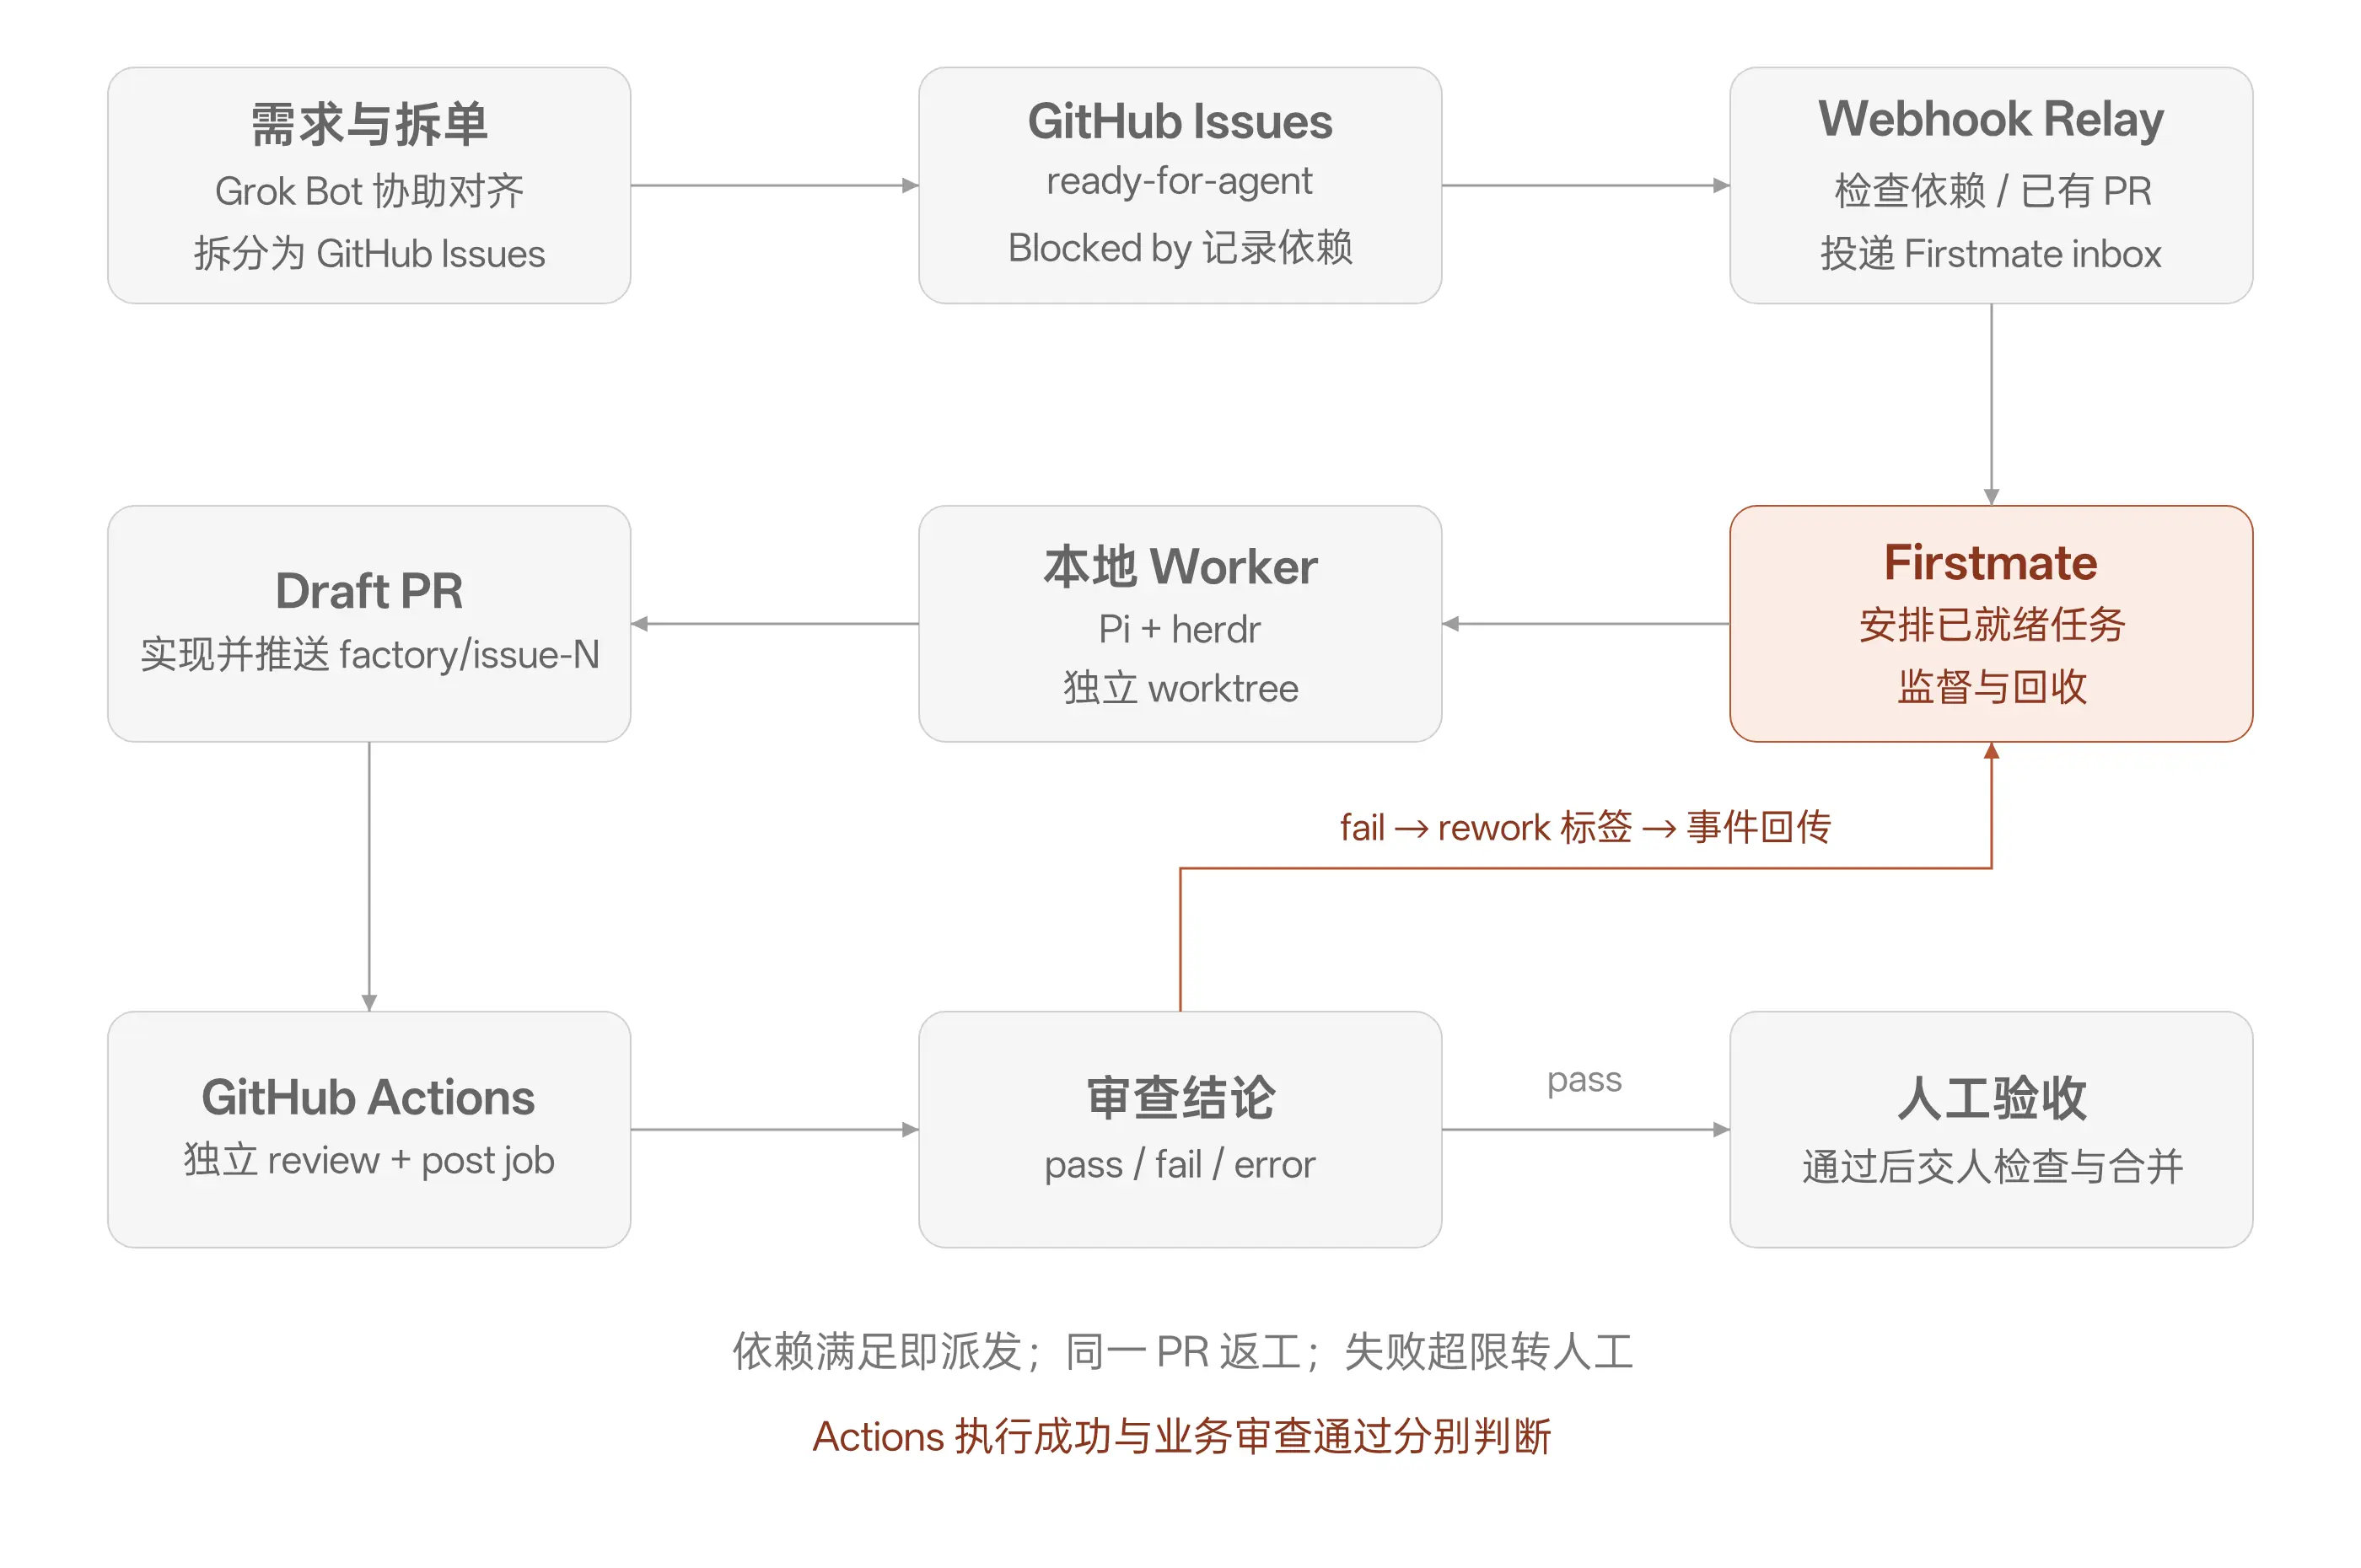
自己搭时,Issue 当 Ticket,Firstmate 做调度,本机 Runner 出 PR,Actions 做独立审查。
同时打通所有的 runner 都使用统一网关来调控额度。
2. 成熟产品
Cursor Projects 把协调者、并行 Agent、共享上下文和事件订阅封进产品。协调者还负责规划,并把任务分发到 cloud agent。
同家的 Grok Bot 也是一样的模式。
3. 应用侧调度
得物巡检把入口收成组件级路由:Master Agent 只认各 Inspector 的能力、输入和入口;指标、拆分和分析留在组件内。下图是单个组件里的执行。
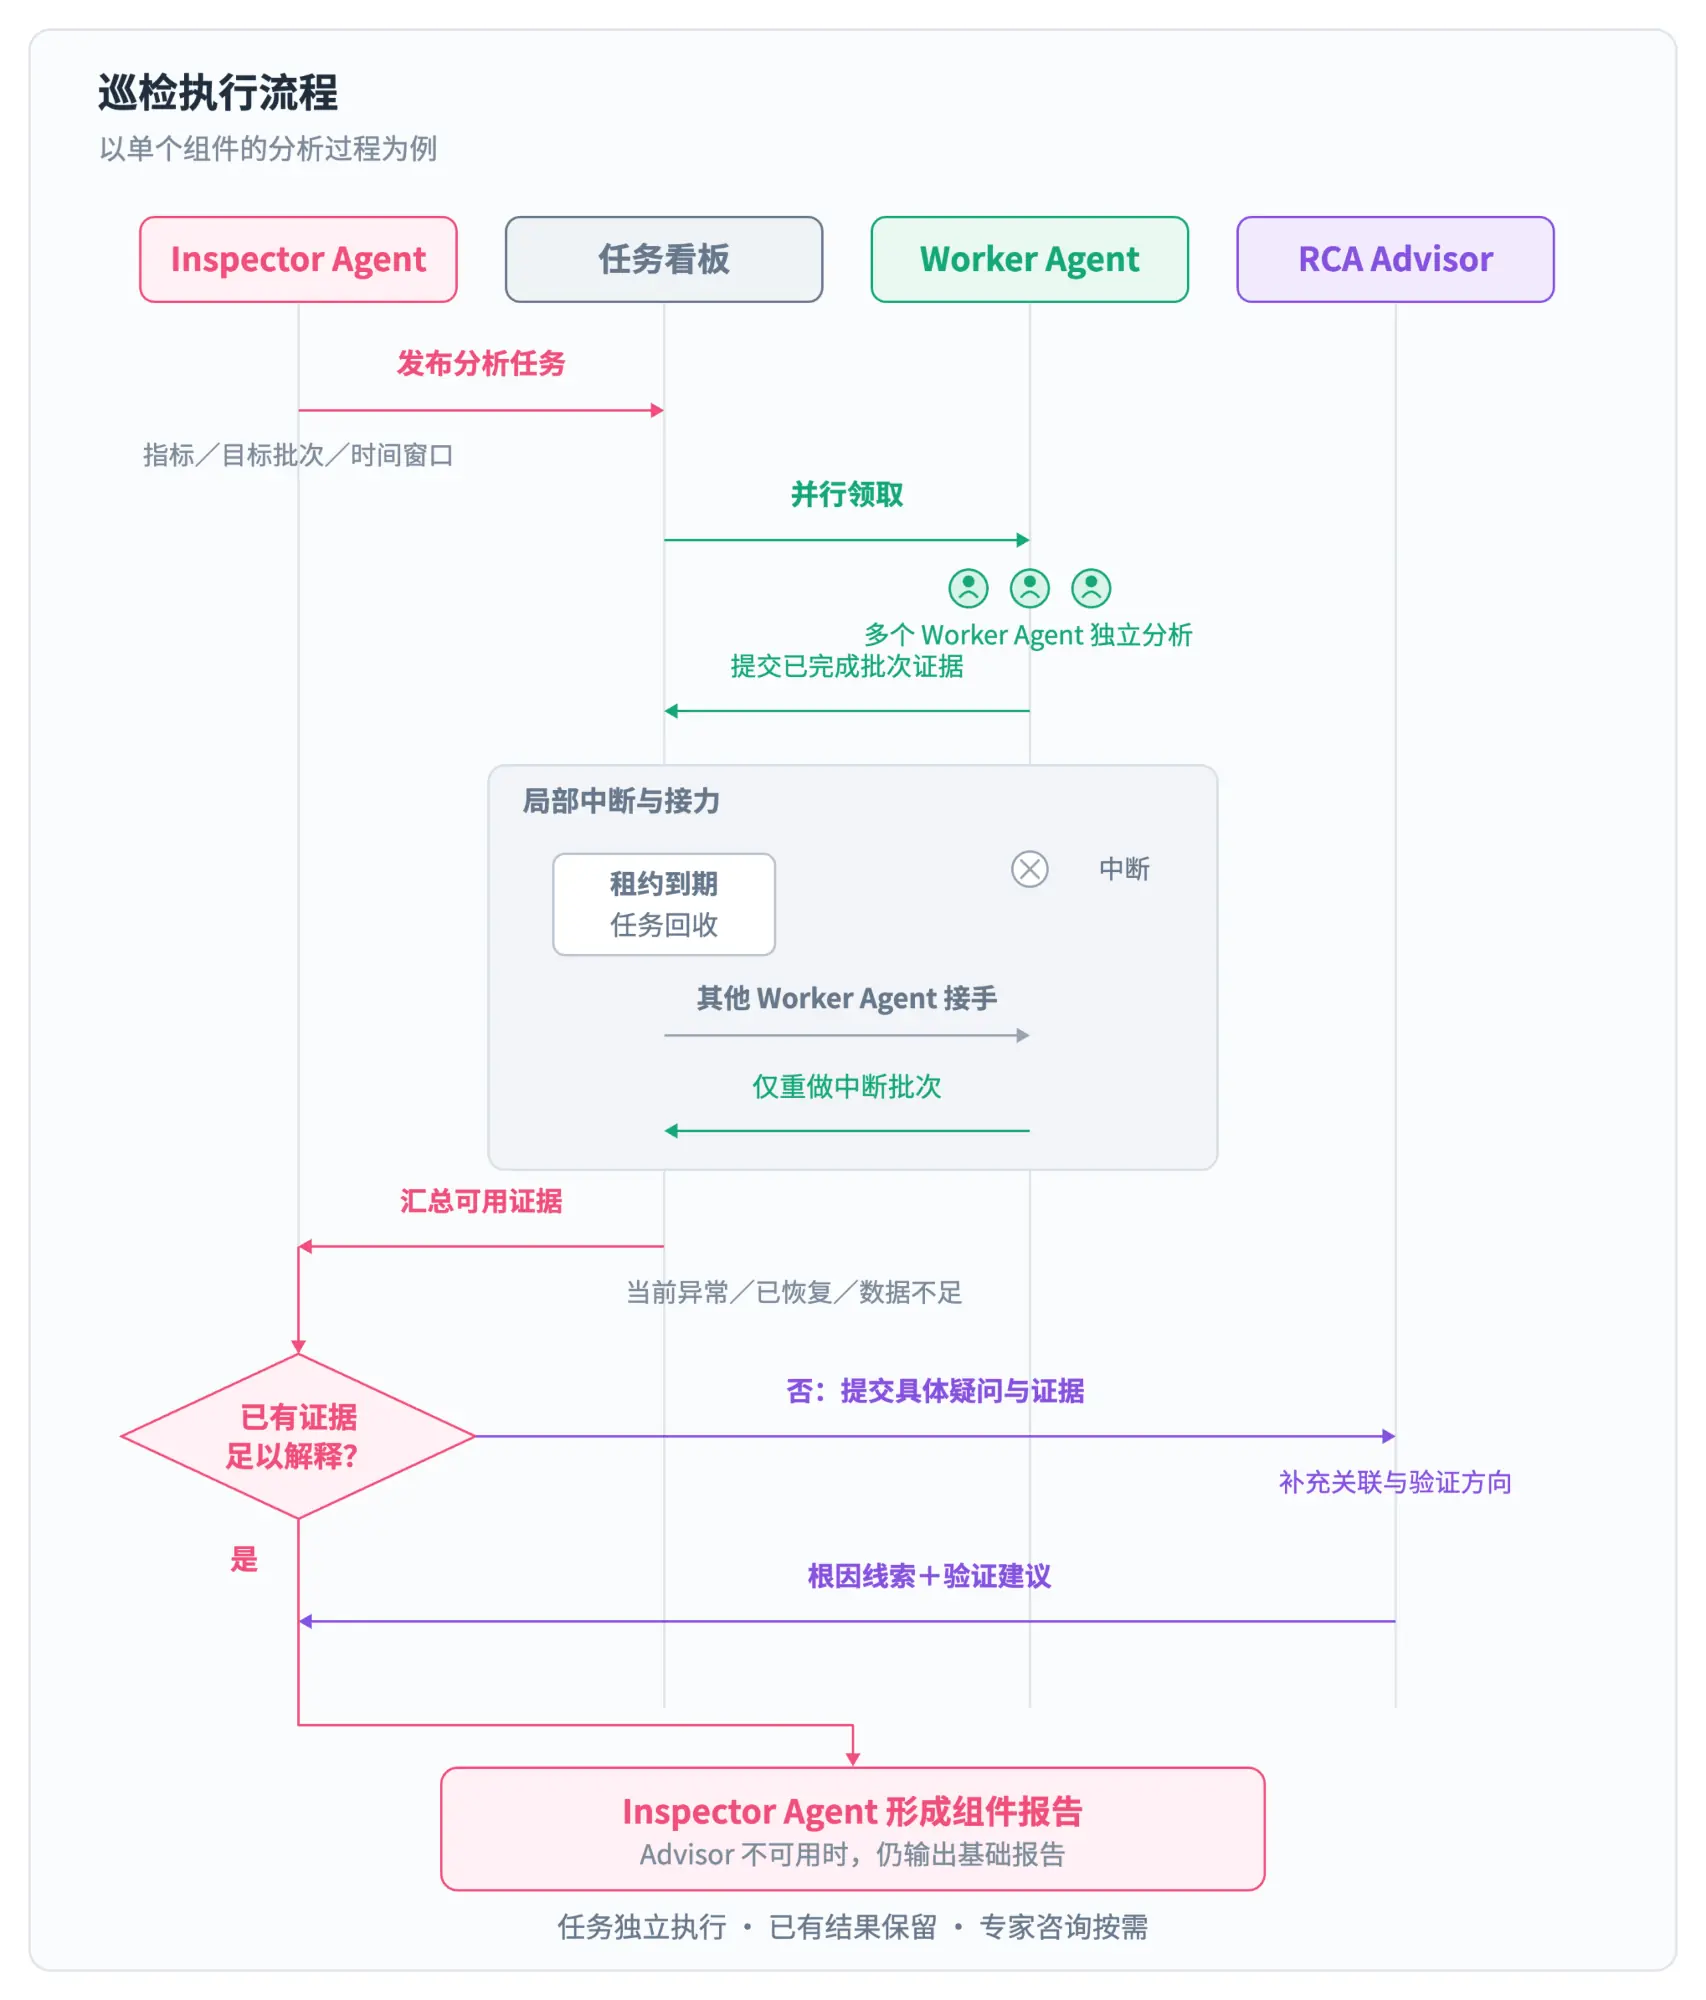
任务看板负责任务与证据,Worker 可并行、可接力;证据不够才问 RCA Advisor,Advisor 不可用仍出基础报告。
四、Task 设计
外循环要可用,单个 Task 先要高可用。如果执行里还要反复跟人确认环境、复现和验收,沟通成本会很大,这类活不适合丢进自动流转。
平时和 Agent 协作往往是:把上下文说完,再提示可能改哪里。
设计 Task 需要更上层的角度:怎样少说话,还能独立交付。如何把人内化的理解写成 Agent 可以直接按序执行的流程或状态流转。
这里可以参考 Bugfix Agent 和 speckit Agent 如何设计。
1. 先看直觉
以需求为例。自己修时,顺序大致是:
- 看禅道,确认产品、环境、分支。
- 改代码。
- 再验收。
- 带着证据开 MR,并把结论回写禅道。
如果把它当成一个 Task,这就跟我们自己上手做完全不同。
2. 再扩展一下
考虑如何稳定处理,
落到工具链,可以收成固定顺序:
- 读单,用禅道能力拉取 Bug,核对备注里的环境和复现信息。缺附件或未授权就停下,不猜。
- 定环境 ,在 OMP(部署环境管理平台)上确认目标环境入口,再用
dt-proxy把本地开发代理切过去,方便和后端联调。 - 隔离代码现场,用 TreeHouse 给本次任务开独立 worktree,用完可回收,避免和别的任务抢同一份代码树。
- 并行启动 ,用
sdev一类本地启动方式占到可并行的端口,拉起本任务的开发服务。 - 浏览器验收,用 ego browser 按目标环境打开页面,改前留下异常证据,改后沿同一路径复验。
- 交付前检查 ,开 MR 前跑
dtis ready:本地 CI,并检查约定目录里是否已有截图或浏览器验收产物。 - 交回与回收,开 MR,把证据回写禅道,再回收本次 worktree 与执行现场。
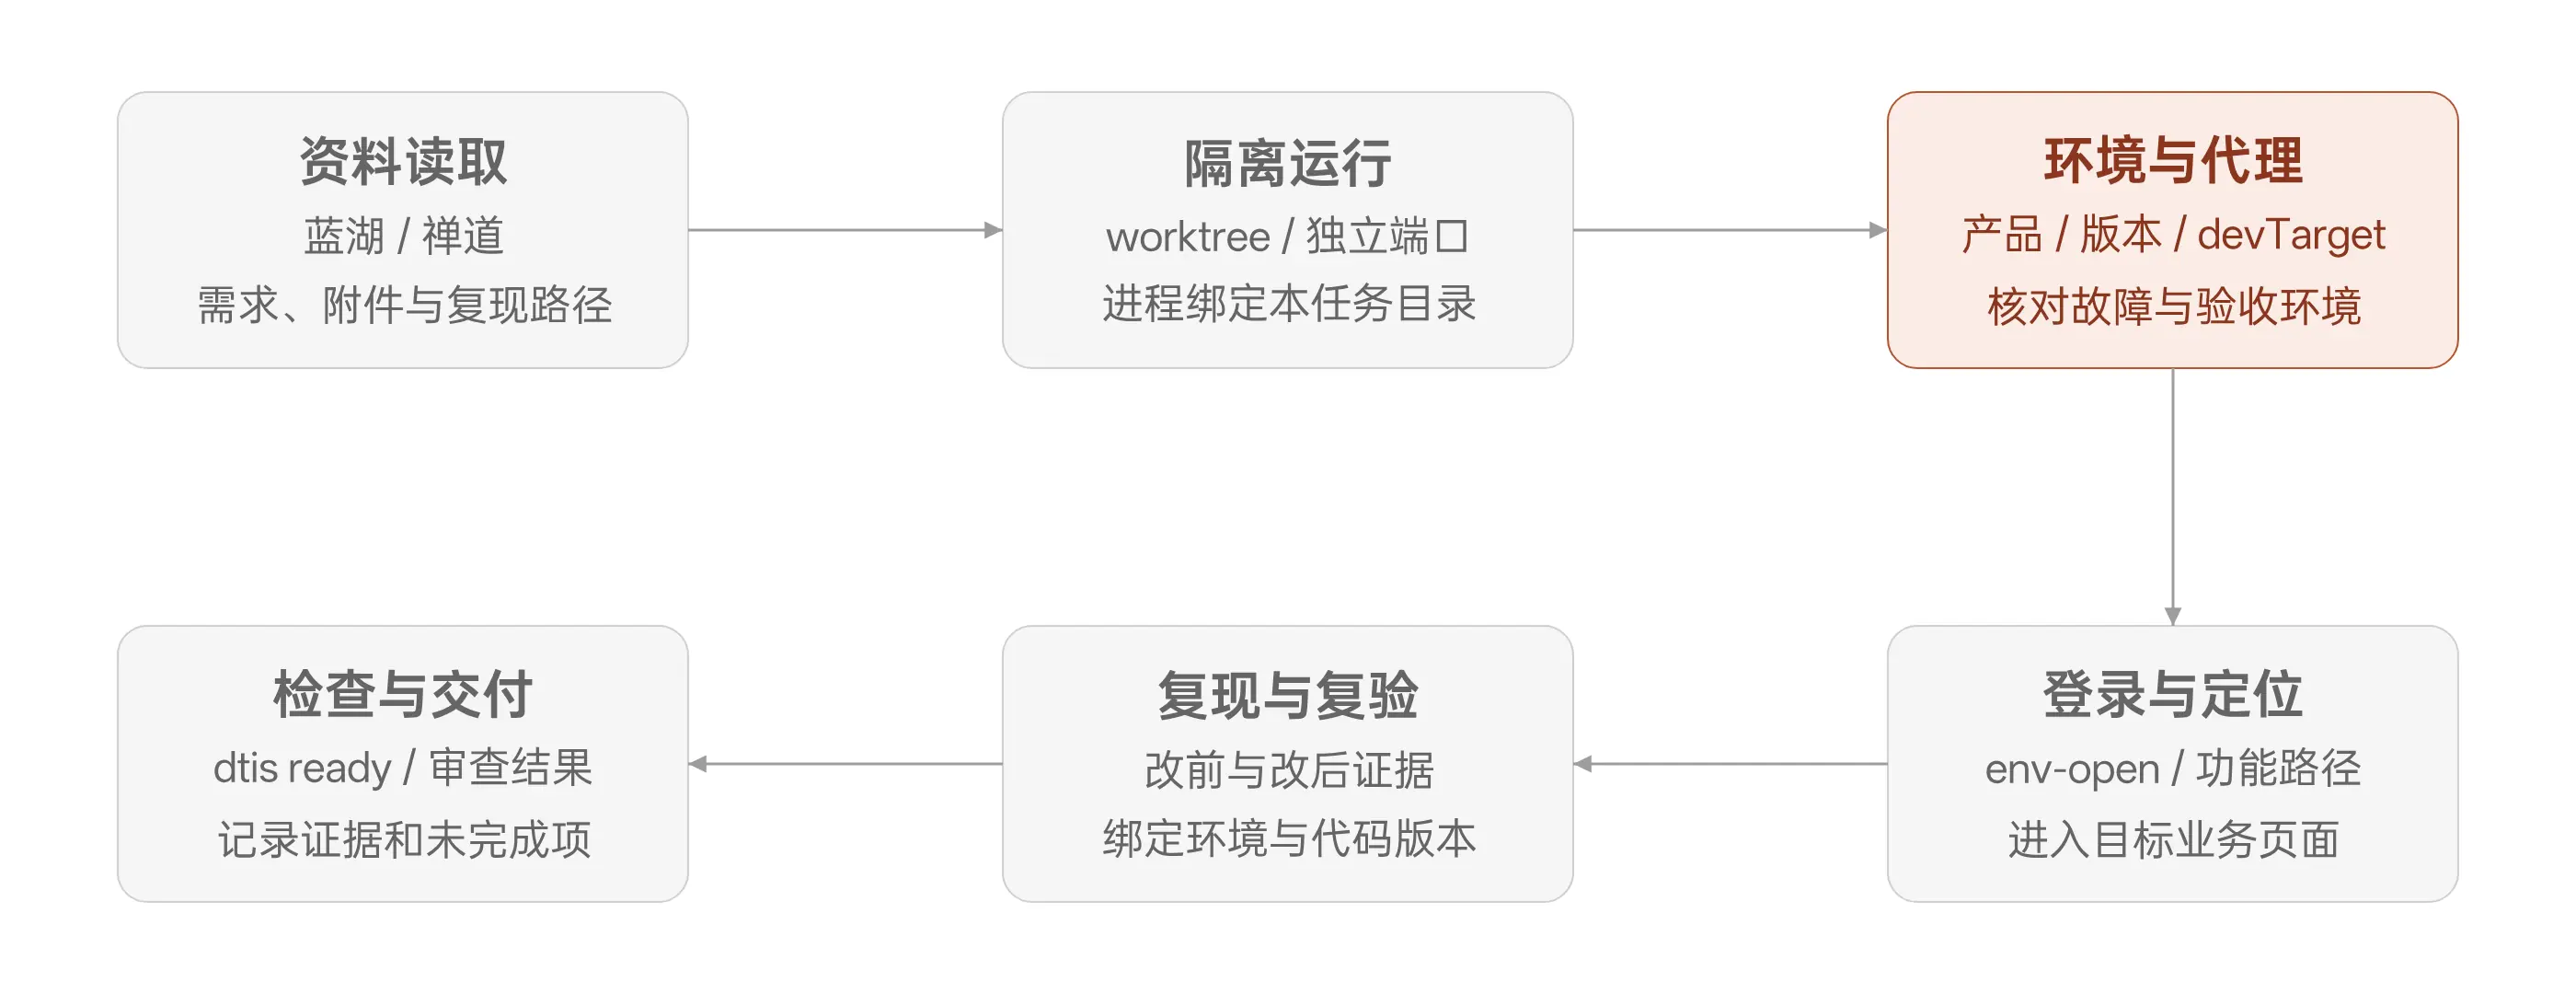
设计 Task,就是反复问:这一步还要人转述吗?能做成工具就做成工具,能写成 Skill 就写成 Skill。写出来不等于稳定, 需要通过 evals 来测试效果。
3. 用 evals 验证
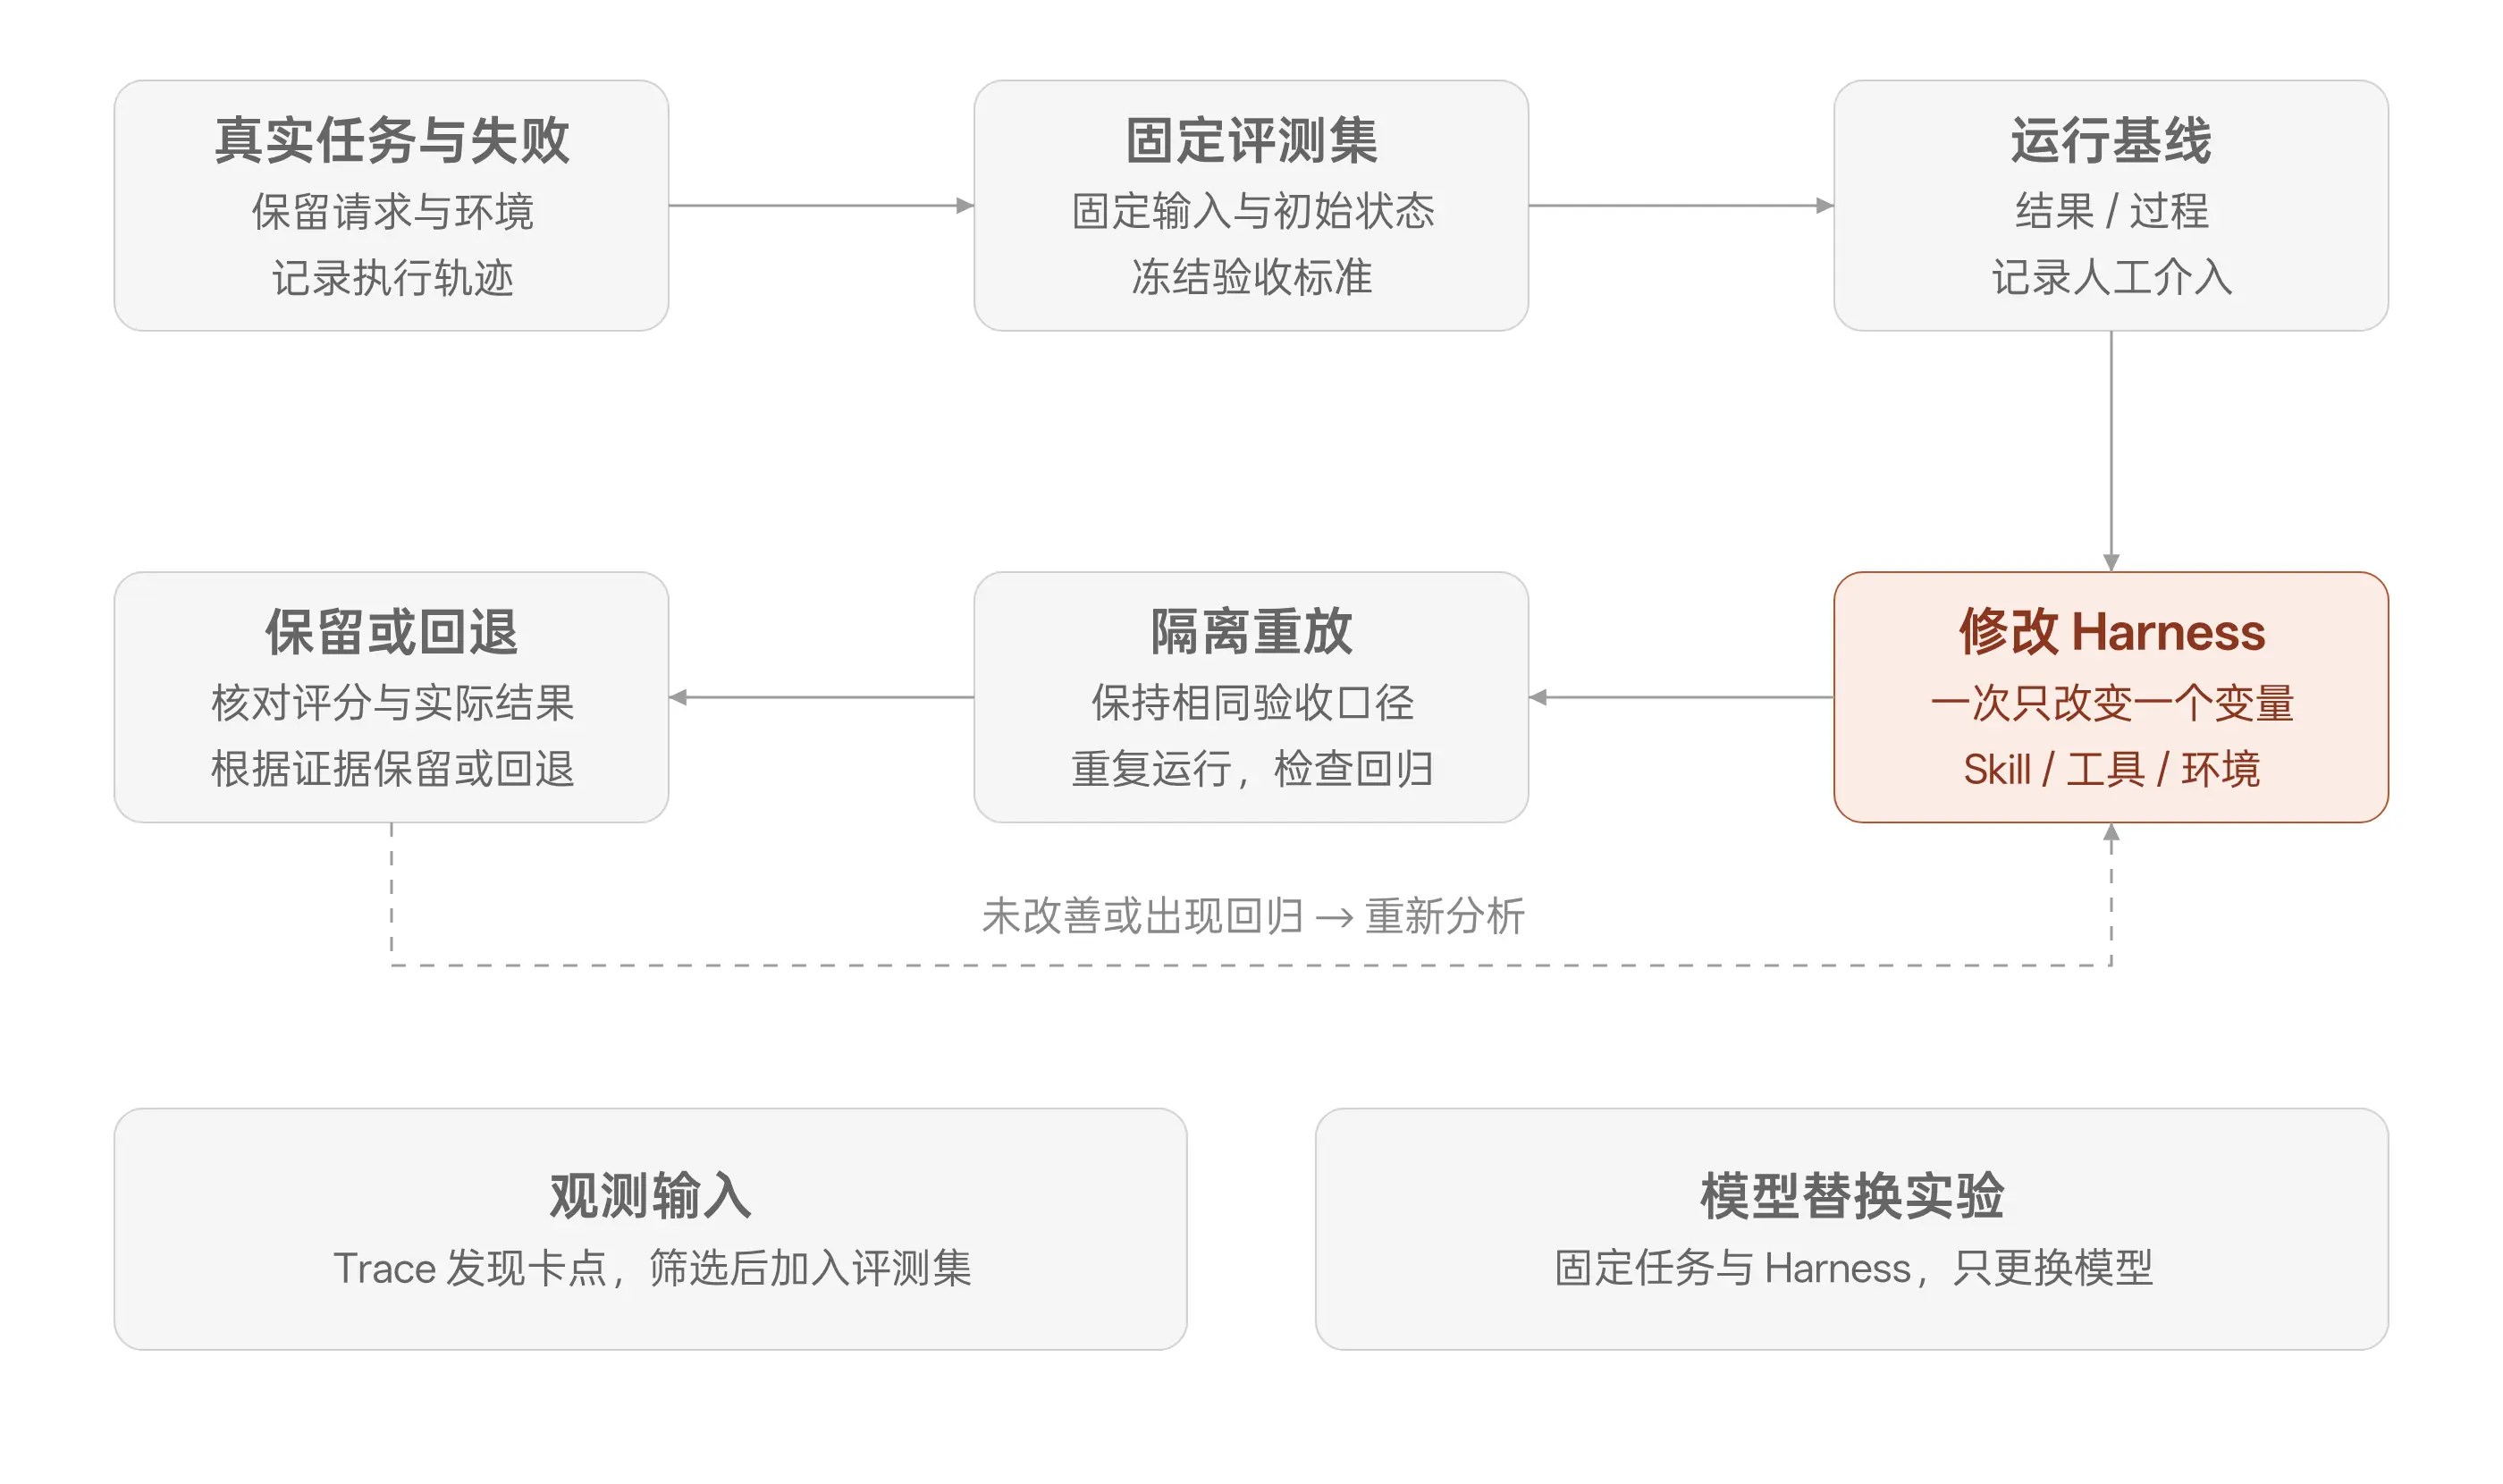
SOP 写完还不够,要证明改 Skill、工具或 Harness 之后交付是否真的更好。
挑真实失败或真人接手过的案例,锁死输入和评分,改一项就重放一次。 同时检查结构:有没有读到单、进对环境、做过复验。没有评测,Task 设计很容易只剩一份好看的流程说明。
过程证据最好统一导出,别散落在各家会话后台。常见接线是 OpenTelemetry 可以用 Langfusej 接收,监控和评测共用同一批轨迹。
OpenTelemetry 早于生成式 AI 出现,它最初是为了解决传统分布式系统的监控和链路追踪问题。
| 产品 | 怎么接到 OTel / Langfuse |
|---|---|
| Claude Code | CLAUDE_CODE_ENABLE_TELEMETRY=1 加 OTEL_*,或用 Langfuse Stop hook 插件 |
| Codex | config.toml 的 [otel],或 Langfuse 插件 |
| Hermes | 按 OpenTelemetry 导出执行过程 |
| Cursor | 产品侧集成页接入观测 |
| Langfuse | 作为 OTLP 后端,聚合监控并沉淀评测案例 |
格式一致,就能在一个地方看卡点、收失败案例、对比改动前后。Codex 把 [otel] 写进正式配置,说明不少 harness 已经认这套接线。
五、局限性
这套外循环适合 Task 已经能稳定交付的场景,也适合负担较轻的个人任务,或 GitHub 这类状态清楚、事件齐全的环境。
环境与工具链仍可按前面的 SOP 来搭;不等于任何编码任务都该整段交给 Orchestrator 代聊。
局限在于:
人只跟 Orchestrator 说话,不跟执行中的 Agent 直接对齐。即使每个任务只需对齐两三次,累积的时间成本也很大,上下文还会在转述里损失。
这里你可以看到, 得物不是编程场景, deepSeek Harness superAgent 例子中的编程场景只是 Mock。 还需要基于实际任务来评测 Agent 是否可以完成。
代码场景尤其难稳定。更稳妥的做法是需要拍板时直接进对应 Agent,或对关键任务做多路运行再收敛;不要默认所有沟通都经一层调度转发。
最后
欢迎关注【袋鼠云数栈 UED 团队】~ 袋鼠云数栈 UED 团队持续为广大开发者分享技术成果,相继参与开源了欢迎 star