一段雨夜加塞视频已经存入 OSS,模型却仍在同类场景中出错。真正的问题是:团队能否在海量历史素材中找出相似片段,知道它们来自哪些车型和模型版本,再把样本交给训练与评测。 阿里云 EMR Serverless StarRocks(Stella)与 Paimon 的组合,正是围绕这条链路组织数据和查询:原始对象留在 OSS,湖表管理样本、标签和版本,Stella 用 SQL 完成检索、关联和分析。
这篇文章从一个具体场景出发,介绍 EMR Serverless StarRocks 与 Stella 的关系,说明 OSS、DLF Paimon 和查询引擎怎样分工,并给出可改造的 SQL。文中 SQL 使用匿名字段和查询向量占位符;实际运行前需按实例版本、Catalog、索引及业务表结构调整。
先看结论:检索只是起点,找到以后还要能分析
多模态平台的常见断点发生在"存储"与"使用"之间。视频和图片有 URI、大小和上传时间,但业务要问的是:有没有行人、是否下雨、发生在哪个道路环境、与哪次模型评测有关。只有把原始文件、内容理解结果和业务记录用稳定的样本 ID 关联起来,后续检索才有业务意义。
对阿里云用户,这条链路可以拆成三个相互配合的层次:
| 层次 | 主要职责 | 在雨夜加塞场景中的数据 |
|---|---|---|
| OSS 原始对象 | 保留视频、图片、音频和其他大文件 | 原视频、关键帧、传感器片段 |
| DLF Paimon 湖表 | 管理样本元数据、描述、标签、向量、快照和索引 | clip_id、车型、时间、场景描述、Embedding、模型版本 |
| EMR Serverless StarRocks(Stella) | 用 SQL 查询湖表,组合标量过滤、全文与向量检索,并关联分析 | 找相似片段、统计覆盖度、解释评测差异 |
核心价值是把"找样本"和"解释样本"放进同一条查询链路。 算法工程师拿到 Top-K 结果后,可以继续按路线、车型、软件版本和问题类型聚合,不必把候选 ID 搬到另一套系统里再拼接。是否获得更低延迟,仍需以自己的数据规模、索引、过滤选择率和并发测试验收。
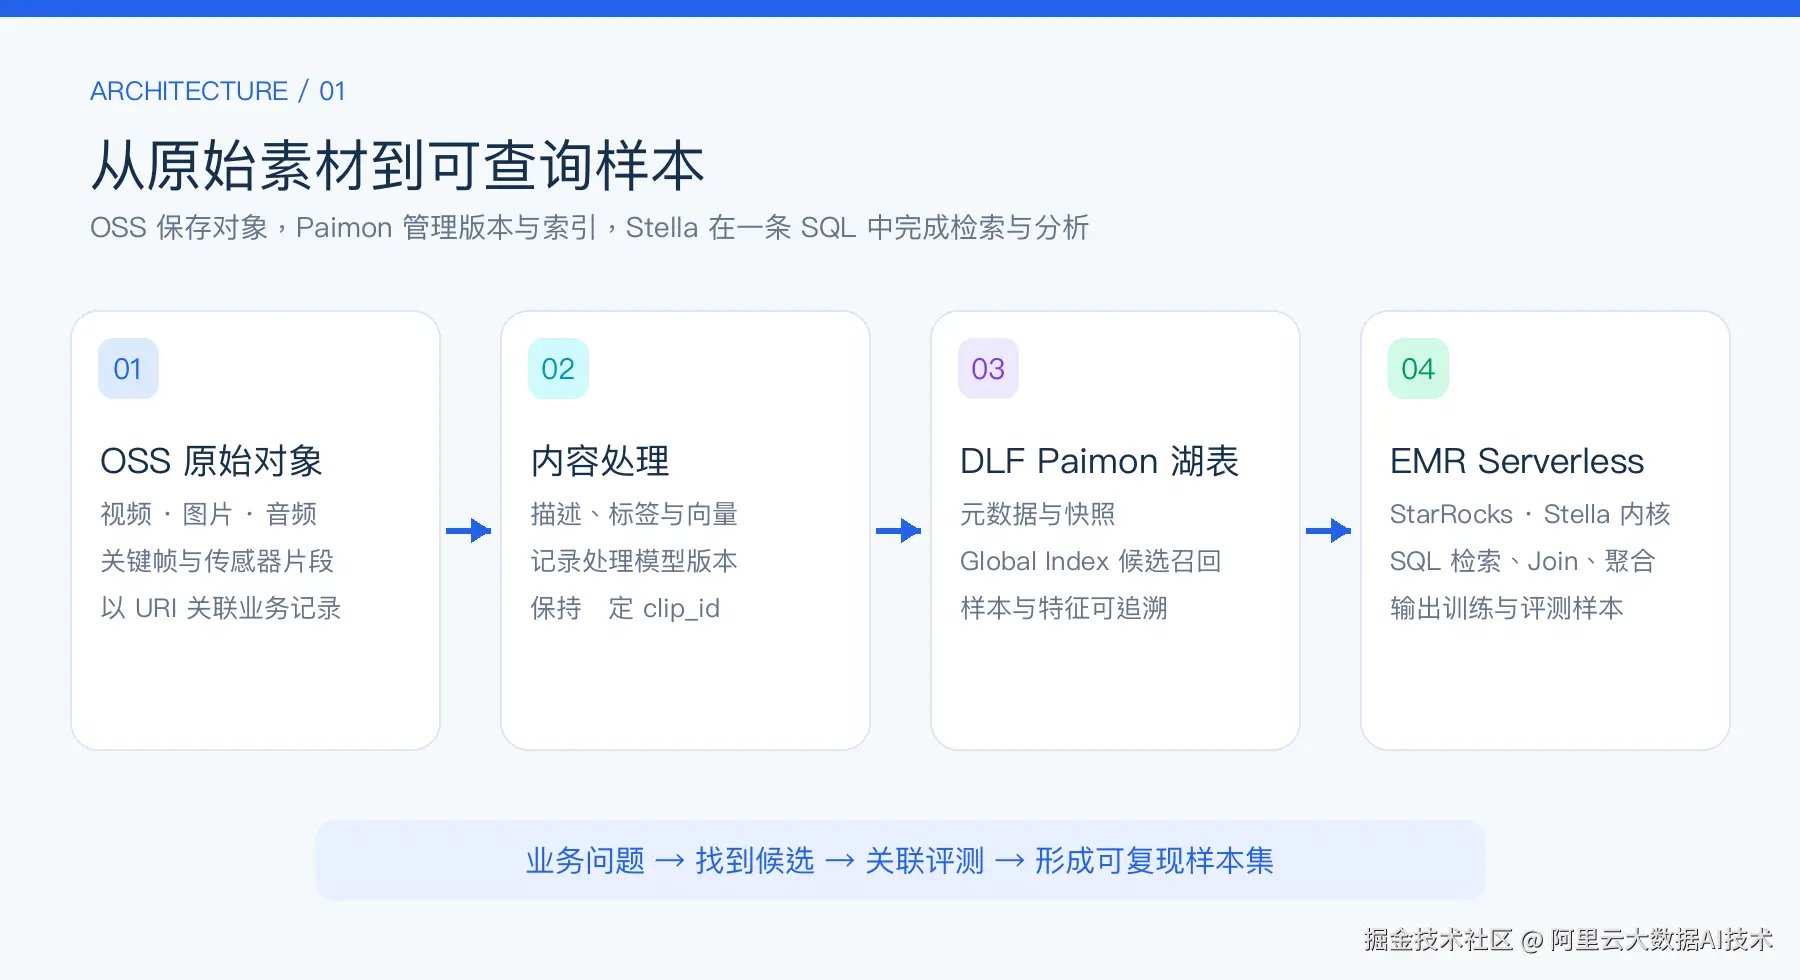
图 1:从原始素材到可查询样本的四层链路。
EMR Serverless StarRocks 与 Stella 分别是什么
StarRocks 是支持 MySQL 协议的分析型数据库,面向实时数据分析、湖仓查询和多维 OLAP。EMR Serverless StarRocks 是阿里云提供的全托管产品形态,负责实例创建、资源管理、监控和运维,并让用户在云上使用 StarRocks 的 SQL 分析能力。Stella 是该产品的企业级内核,不是与 EMR Serverless StarRocks 并列的第二套数据库。阿里云的版本号也单独标出 Stella 内核版本,便于识别企业级优化与功能。
在存算分离实例中,计算节点负责查询和导入,数据位于共享存储;计算组可以把交互式检索、批量数据准备和其他分析任务放到不同资源池中运行,同时共享同一底层数据。这为多模态场景提供了更清晰的资源安排:素材处理可能有批次高峰,在线检索则更关注稳定响应,两类任务的计算需求不必完全同步。
Stella 面向这类云上负载持续增强湖表读取、缓存、查询优化和多模态能力。对于本文主题,最关键的能力是:通过 DLF Catalog 直接访问 Paimon 湖表,在可用的 Global Index 上执行向量检索,并把可下推的结构化条件送入候选召回过程;查询结果随后仍可与业务表 Join、聚合和排序。产品还支持内表向量索引;已有数据若保存在内表,也可以沿着同一 SQL 分析入口构建检索链路。
能力有明确的版本边界。DLF Paimon 湖表向量检索要求 EMR Serverless StarRocks 3.5.16-2.2.0 及以上,并且 Paimon 侧已经构建可用的向量索引;OSS Object Table 从 3.5.16-2.2.2 起提供对象清单访问能力。准备上线时,应以实例实际运行版本与已开放能力为准。
从文件变成可查询的业务资产
视频进入 OSS 后,平台首先需要为它建立可追踪的业务身份。一个 clip_id 应能连接原文件 URI、采集时间、车型、路线、事件、模型版本与评测记录。内容处理任务再生成关键帧、场景描述、标签和向量,并记录模型及处理版本。这样,当同一段视频被重新标注或用新模型提取特征时,团队仍能解释检索结果为何改变。
在阿里云上,可以按数据生命周期安排这几类信息:
-
原始内容留在 OSS。 大文件无需因为要做 SQL 查询就整体复制进分析表;表里保存对象引用以及检索所需的元数据。
-
处理结果进入 Paimon。 DLF 负责统一管理湖表,Paimon 的快照使数据处理、索引构建和下游消费有明确的版本边界。
-
Stella 承接查询与分析。 一条 SQL 同时限定租户、时间、车型,命中文本条件,再按向量相似度取候选,最后关联评测表。
-
AI Function 可参与内容加工。 对已开通相应能力的实例,SQL 可调用模型对对象做描述、分类或向量化;模型输出仍要保存处理版本和质量状态,不能把一次生成结果当作永久不变的真值。
对于已经沉淀在 Paimon 中的数据,Stella 可以通过 DLF Catalog 直接查询;不需要为了检索先把整张表导入内表。对于频繁访问且延迟目标更严格的子集,可以再评估内表与索引。两条路径可以按数据冷热、写入频率和查询 SLA 配合使用。
一次混合检索,执行时究竟做了什么
回到雨夜加塞。检索条件并非只有"与这段视频相似":业务还可能限定某车型、某一时间窗、某个租户,以及描述中出现"雨夜"或"加塞"。查询若先对全量向量计算距离,后续才过滤业务条件,会把大量工作花在无关数据上;如果先取很小的向量 Top-K 再过滤,也可能剩不下足够的样本。
更合适的执行路径是先确定湖表快照,再由优化器识别可下推的标量条件和 Top-K 向量表达式,在 Paimon Global Index 上缩小候选范围。索引返回 Row ID 与分数后,再按需读取业务列和 OSS 对象引用。对于全文、向量和标量条件的组合,实际下推与索引命中情况应通过 EXPLAIN 和 Query Profile 检查,不能只凭 SQL 表面形式推断。
这种"先定位候选、再读取大字段"的顺序尤其适合视频和图片。最终可能只返回几十条片段,真正需要展示的 URI、描述和评测指标,应尽量在候选集合收敛后再读取。一次查询的价值也不仅是速度:它让候选结果和业务维度继续在 SQL 内关联,方便回答"相似问题集中在哪些车型或版本"。
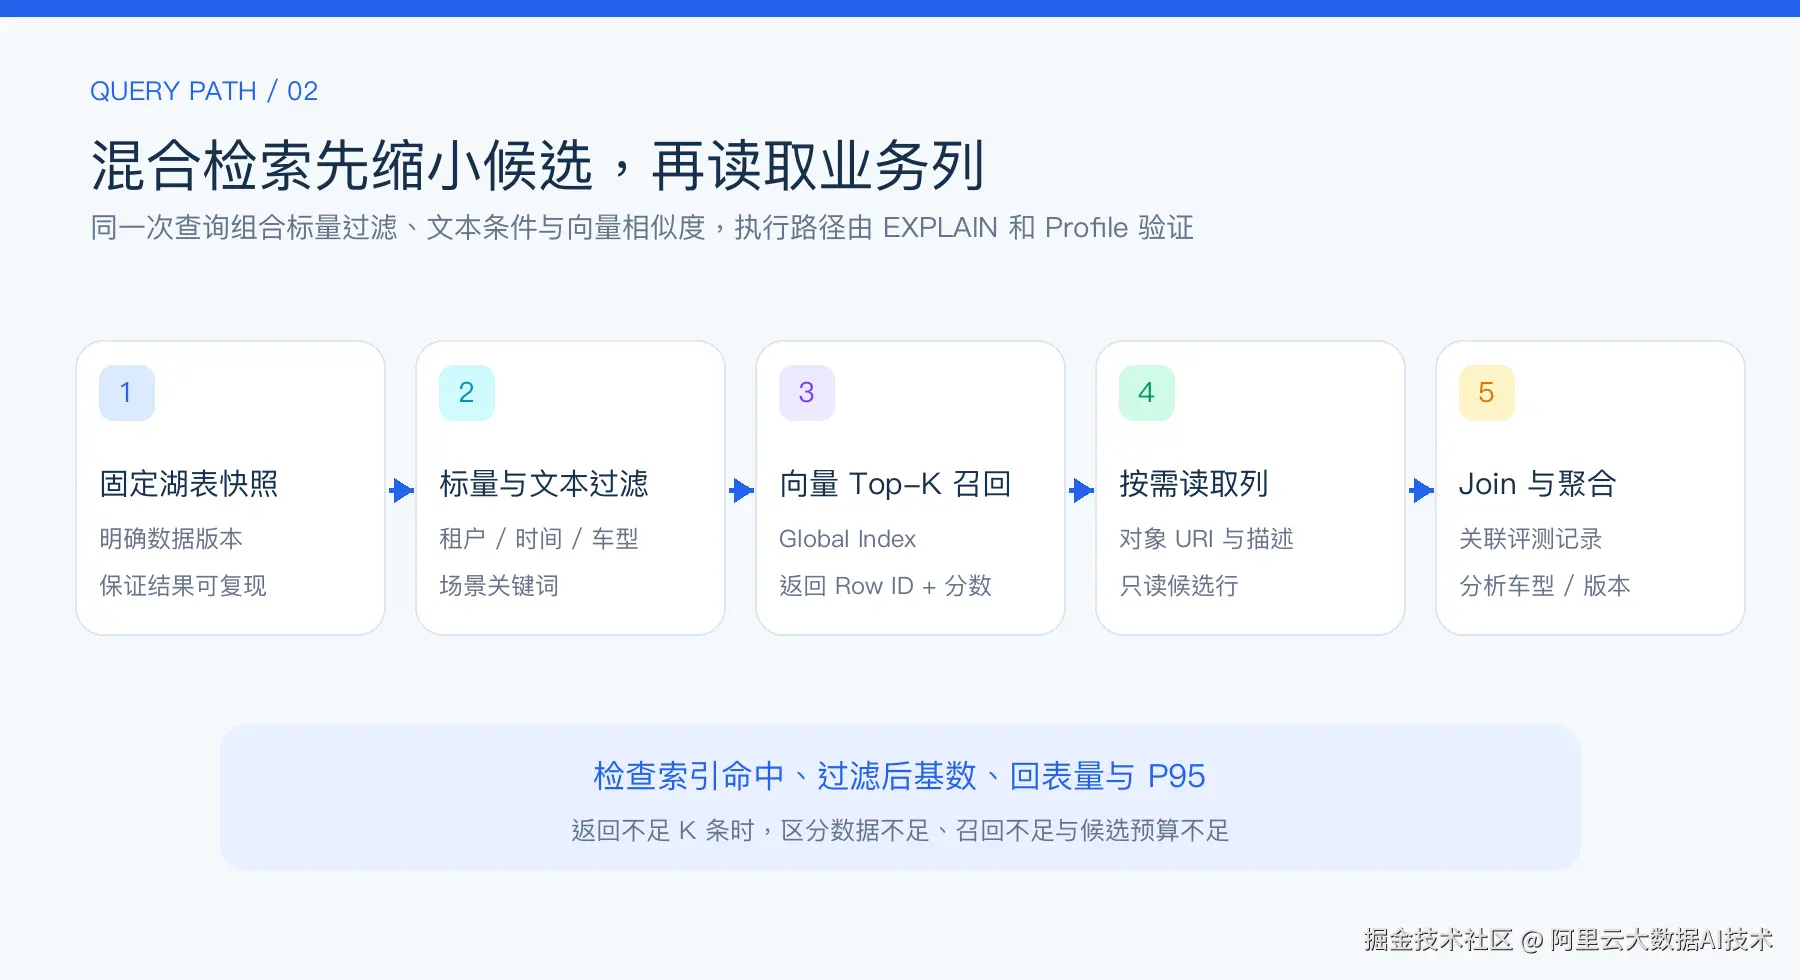
图 2:混合检索的候选收敛与回表路径。
三组 SQL:找出片段,再解释它们
假设 DLF Catalog 已连接 Paimon 表 dlf_catalog.driving.clips,该表包含 clip_id、tenant_id、event_time、car_model、scene_text、embedding、oss_uri 和 model_version。下列 {{QUERY_VECTOR}} 由客户端替换为与索引维度、距离度量一致的向量;MATCH、向量函数和索引下推需以目标版本及 Paimon 侧索引配置验收。
第一条 SQL 从指定业务范围内找雨夜加塞片段。时间、租户和车型先限定范围,文本条件表达场景,向量相似度给出排序依据:
sql
SELECT clip_id, oss_uri, model_version, event_time,
       approx_cosine_similarity(embedding, {{QUERY_VECTOR}}) AS similarity
FROM dlf_catalog.driving.clips
WHERE tenant_id = 1001
  AND event_time >= '2026-10-01 00:00:00'
  AND event_time <  '2026-11-01 00:00:00'
  AND car_model = 'model_a'
  AND scene_text MATCH '雨夜 加塞'
ORDER BY similarity DESC
LIMIT 100;
LIMIT 100 是返回目标,不等于一定有 100 个合格片段。验收时应同时记录实际返回数、过滤后基数、Recall@100、P50/P95、索引是否命中以及快照版本。检索质量要靠人工标注或可信评测集核对,不能只看相似度分数。
第二条 SQL 用同一候选集检查覆盖情况。它回答"结果是否都集中在少数车型或路线",避免把大量近重复素材误当成充分样本:
sql
WITH candidates AS (
  SELECT clip_id, route_id, car_model, model_version,
         approx_cosine_similarity(embedding, {{QUERY_VECTOR}}) AS similarity
  FROM dlf_catalog.driving.clips
  WHERE tenant_id = 1001
    AND scene_text MATCH '雨夜 加塞'
    AND event_time >= '2026-10-01 00:00:00'
    AND event_time <  '2026-11-01 00:00:00'
  ORDER BY similarity DESC
  LIMIT 500
)
SELECT car_model, model_version,
       COUNT(*) AS clip_count,
       COUNT(DISTINCT route_id) AS route_count,
       AVG(similarity) AS avg_similarity
FROM candidates
GROUP BY car_model, model_version
ORDER BY clip_count DESC;
第三条 SQL 把候选片段与模型评测记录放在一起。假设 eval_results 中保存片段、模型版本、错误类型和评分,则可以直接比较目标版本与其他版本是否有共性问题:
sql
SELECT c.model_version,
       e.error_type,
       COUNT(*) AS affected_clips,
       AVG(e.score) AS avg_score
FROM dlf_catalog.driving.clips AS c
JOIN analytics.eval_results AS e
  ON c.clip_id = e.clip_id
 AND c.model_version = e.model_version
WHERE c.tenant_id = 1001
  AND c.scene_text MATCH '雨夜 加塞'
  AND c.event_time >= '2026-10-01 00:00:00'
  AND c.event_time <  '2026-11-01 00:00:00'
GROUP BY c.model_version, e.error_type
ORDER BY affected_clips DESC;
这三条 SQL 分别回答"样本在哪里""覆盖是否充分""问题与哪个模型版本相关"。实际表中应以 clip_id、模型版本和处理版本共同确定 Join 语义,避免评测重跑或特征重算造成重复计数。生产环境还要检查租户权限和对象访问控制,保证检索结果不会越过业务边界。
Paimon、StarRocks 内表与 Lance 怎么选
多模态数据不必全部采用同一种存储方式。选择时先看已有链路和主要访问模式,再决定是否需要增加数据副本:
| 数据形态 | 优先评估的路径 | 主要验收点 |
|---|---|---|
| 已有 Flink、DLF、Paimon 实时湖仓,数据持续更新 | 保留 Paimon 湖表,由 Stella 直查 | 快照与索引一致性、过滤下推、读写并行、查询延迟 |
| 访问频繁、在线 SLA 严格的热点子集 | StarRocks 存算分离内表 | 索引构建与维护、热缓存、并发 P95/P99、写入新鲜度 |
| Python、Arrow、训练样本链路已有 Lance | 评估 Stella 访问 Lance | 连接器能力、索引与过滤支持、回表列、版本兼容 |
Paimon 适合把持续变化的样本、标签和业务记录组织成可共享的湖表;StarRocks 内表适合对热点数据做更集中的查询服务;已有 Lance 数据则应先看能否直接复用。最终以同一组业务 SQL 比较冷/热查询、写入延迟、召回质量、存储副本和维护成本,不从单次最快耗时推断整套方案的价值。
从集团实践到云上行业:同一方法服务不同数据
原文公开分享的阿里集团 ALake 平台,围绕训练前的数据检索与样本准备,把文本、图片、音频和视频的样本及特征关联在 Paimon 宽表中,再通过 StarRocks 做混合检索和筛选。算法工程师不只要找到相似内容,还要检查样本的来源、重复度与场景覆盖,决定哪些片段值得进入专项训练集。
另一类集团内部实践来自 AI Data 平台:有的任务需要一次召回很大的候选集合,后续继续过滤和关联;有的任务需要按 request ID 或 trace ID 定位 Agent 调用,再通过时间、工具、状态和错误文本追查同类问题。它们说明多模态检索既有相似内容搜索,也有大候选集分析和可观测性查询。云上汽车、智能硬件和文娱团队面对的数据不同,但"对象---处理结果---业务记录"的关联方法可以复用。
集团实践提供的是设计经验。阿里云项目需要按实际实例版本、可用索引和资源规格验证同一方法,再决定数据进入 Paimon 湖表、StarRocks 内表,或保留既有 Lance 链路。
从 Bad case 到下一版模型:闭环怎样落地
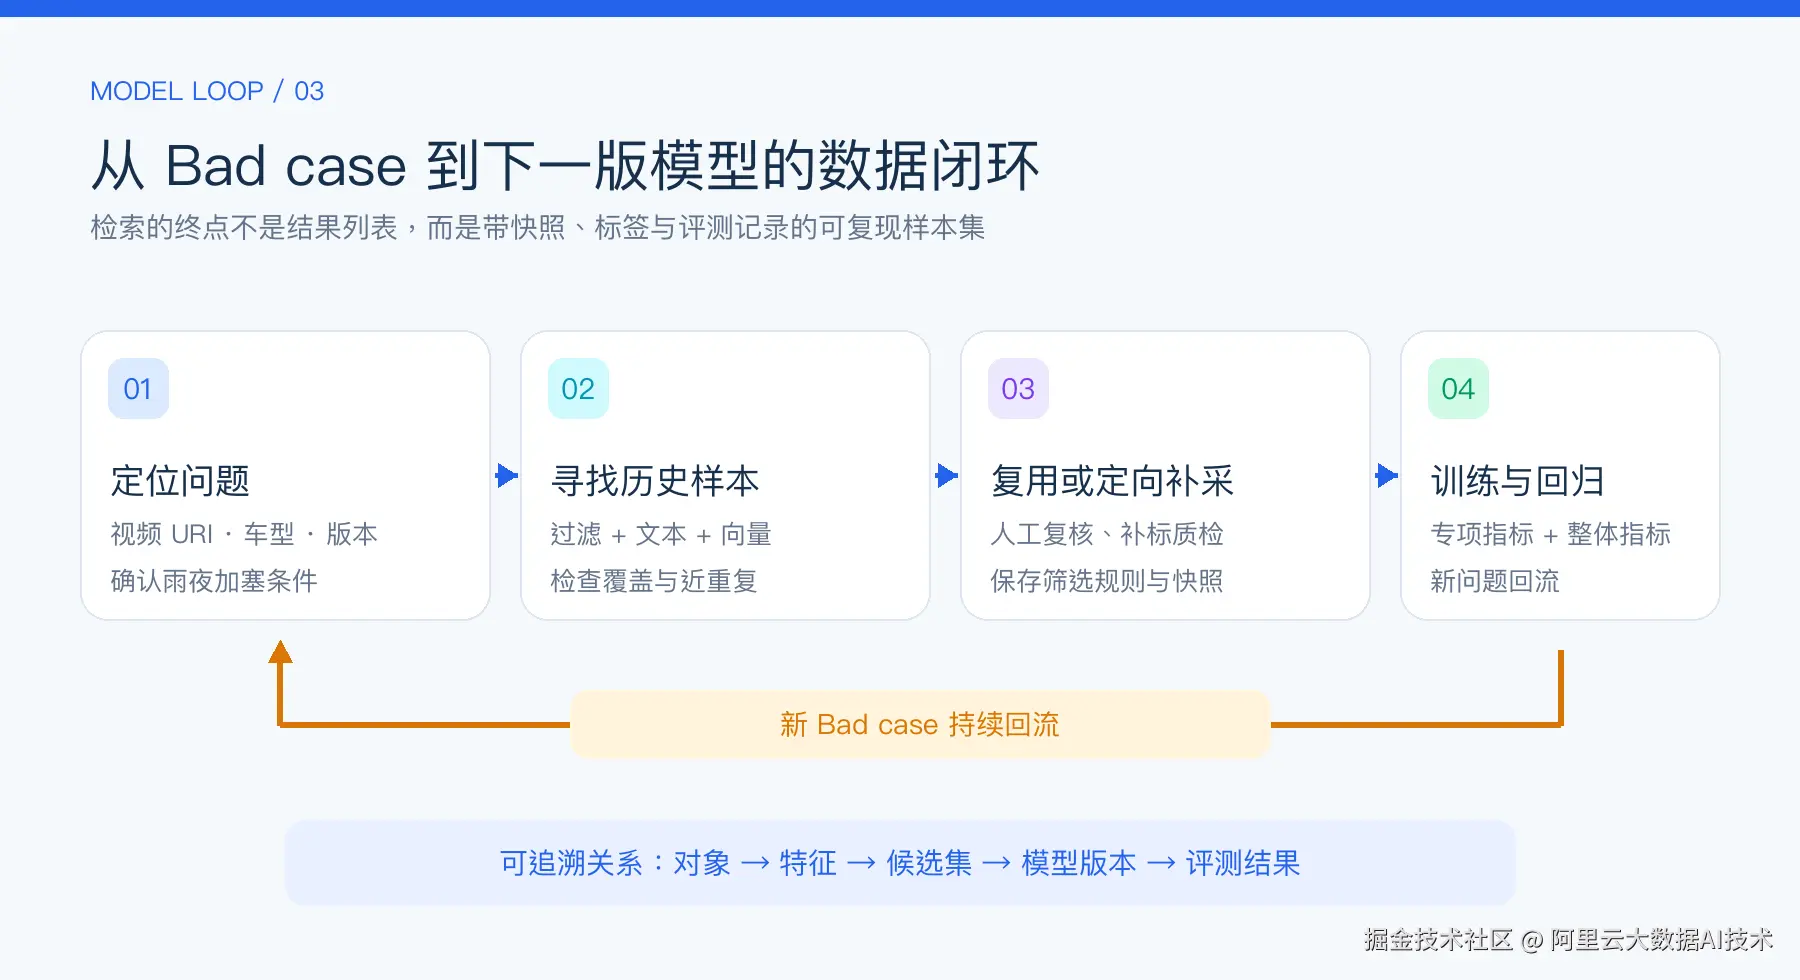
图 3:Bad case 驱动的样本与模型迭代闭环。
第一步,定位问题。 从一次接管事件或评测失败记录进入,固定原视频 URI、时间、车型、模型版本和处理版本。人工确认"雨夜加塞"的实际条件:雨量、路面反光、遮挡和切入距离。描述越具体,后续检索越可验证。
第二步,寻找历史样本。 用结构化条件限定范围,用全文检索覆盖不同描述,再用向量相似度找到语言标签没有表达出来的相近片段。返回结果按路线、车辆和时间聚合,检查近重复比例和场景覆盖。没有命中时先检查索引、特征模型与过滤条件,再判断数据确实缺失。
第三步,决定复用还是补采。 已有样本满足质量和覆盖要求时,形成专项候选集,安排人工复核、补标与质检;确实缺少某些天气、光照或道路条件时,再生成明确的定向采集清单。候选集要保存来源、筛选规则和数据快照,便于复现。
第四步,训练与回归评测。 训练任务读取确定版本的样本集,并记录标签版本与模型版本。新模型上线前,既看整体指标,也回到雨夜加塞等专项场景验证改进,检查其他场景是否退化。新出现的 Bad case 再进入下一轮数据处理和检索。
整个过程使原始对象、处理结果、检索候选和模型评测形成可追溯的关系。团队最终要回答四个问题:问题发生在哪里?相关数据在哪里?数据是否足够?改进后是否得到验证?
上线前的最小验收表
这套方案能否在生产中发挥作用,取决于索引、权限、质量和资源配置。建议至少保留一张机器可读的验收表:
| 验收维度 | 建议记录 |
|---|---|
| 数据一致性 | Paimon 快照、Global Index 版本、处理模型版本、样本数 |
| 检索质量 | 标注集、Recall@K、实际返回行数、误召回与漏召回样例 |
| 查询性能 | 冷/热缓存 P50/P95/P99、成功 QPS、并发档位、Profile |
| 资源成本 | 计算组规格、索引大小、OSS 读量、模型调用量、月度费用 |
| 业务闭环 | 样本复用率、定向补采量、从 Bad case 到可用训练集的时间 |
如果查询变慢,先用 EXPLAIN 确认 Top-K、标量条件和全文条件是否进入预期执行路径,再在 Profile 中检查索引搜索、候选数、回表读取和缓存。若返回不足 K 条,需要区分"过滤后确实不够""索引召回不足"和"候选预算过小"。把这三种情况混为一谈,会让优化方向完全不同。
结语
多模态数据湖的价值,发生在文件被理解并重新用于业务的那一刻。OSS 保存原始内容,DLF Paimon 组织可演进的数据资产,EMR Serverless StarRocks 的 Stella 内核把检索与分析接进同一条 SQL 链路。对于智能驾驶团队,这意味着一次模型 Bad case 可以顺着数据关系走到历史样本、训练集和下一轮评测,让已沉淀的数据持续参与模型迭代。