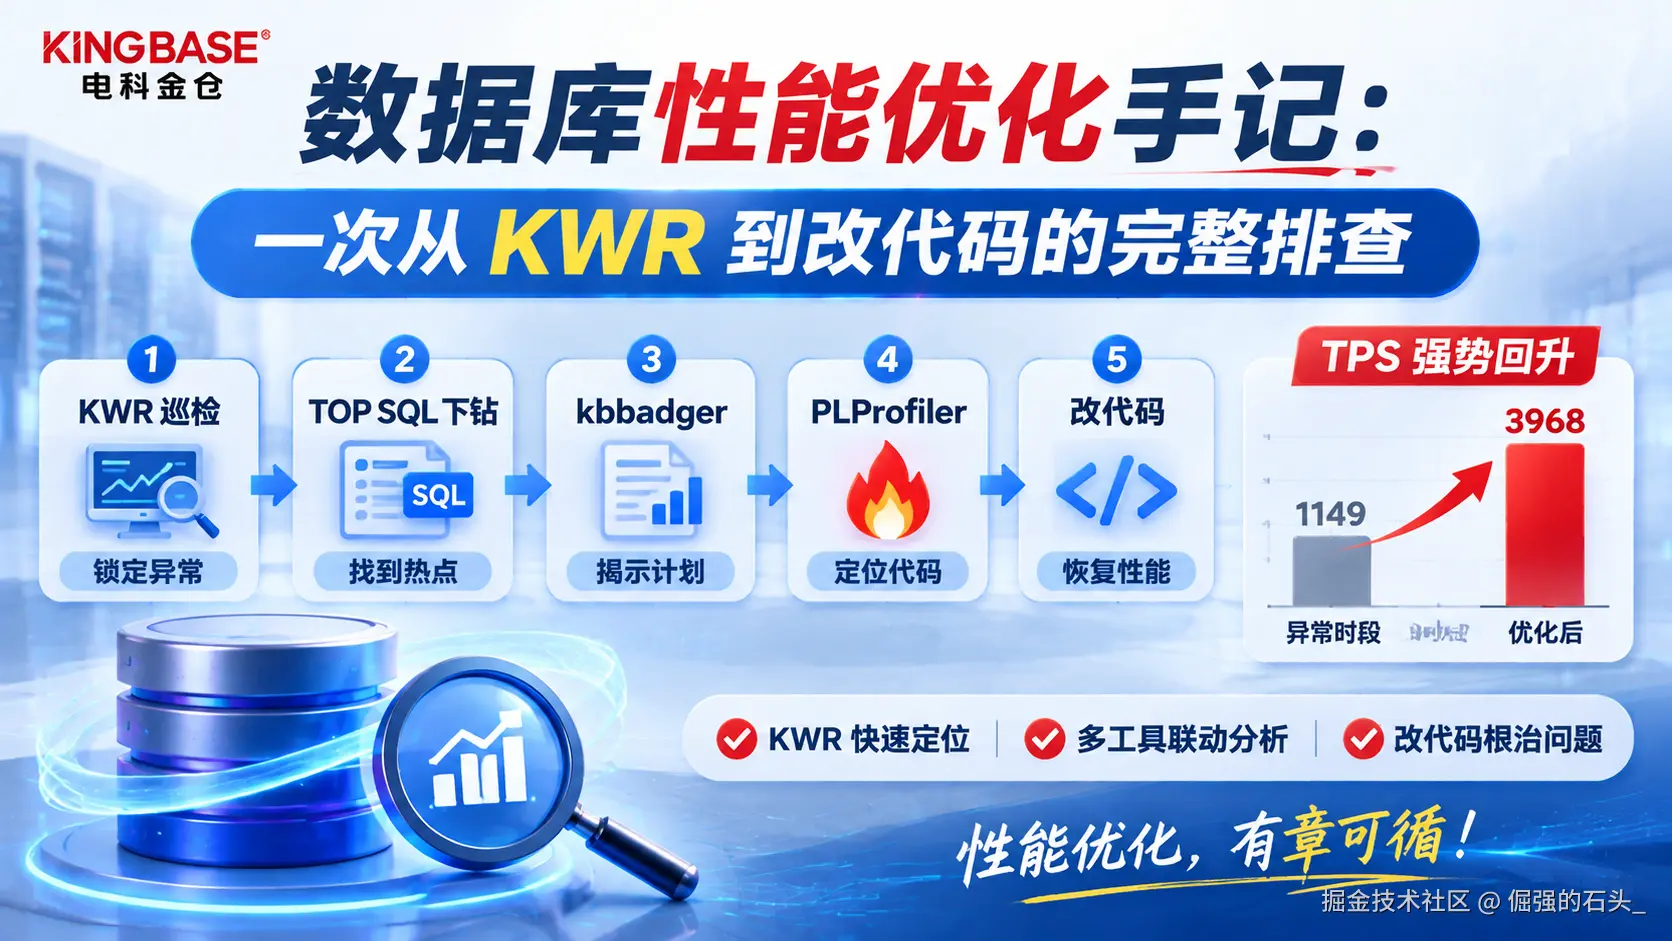
上个月我们库上出了一件怪事。没有发版,没有大促,TPS 却从 1560 掉到了 1149,降幅 26%。业务方第一反应是数据库出问题了。DBA 的第一反应是业务变了。查了一周,最后发现两个问题叠在一起。一个缺索引,一个存储过程里藏着一个循环。
这次数据库性能优化排查,走的是金仓数据库 KingbaseES 全链路诊断的完整路子。从 KWR 巡检一路下钻到代码行级热点。过程挺典型的,写出来给同行参考。
@toc
一、第一步永远是看快照,不是猜
接到告警后,很多人第一反应是上库翻 active 会话。我的习惯不太一样。先对比 KWR 的两个快照,让数字告诉你差异在哪。
KWR 是金仓的性能巡检工具。常态开启、损耗很低,会定期打快照。这里多说一句快照的机制。它隔一段时间给整个实例的活动拍一张"存照"。把这段时间的等待事件、IO、语句统计都记下来。分析问题的时候,拿异常时段的快照和平时的基线一比,差异就摆在纸面上了。这个方法的关键前提是,平时就要留基线。没有基线,出了事连"正常是什么样"都说不清。把异常时段的快照和基线一比,几个数字立刻跳出来了:
| 指标 | 基线快照 | 异常快照 | 变化 |
|---|---|---|---|
| 每秒事务 | 1560.34 | 1149.15 | -26.35% |
| Tuples Return | 100,405,494 | 1,544,350,794 | +1438.11% |
| Blocks Hit | 923,067 | 17,767,325 | +91.81% |
| Execute Calls | 95,568 | 69,987 | -26.77% |
把两张快照的负载分析从报告里导出来,就是下面这张表的样子。红框那一行是每秒事务数,其余几个跳脚的指标也都圈在里面: 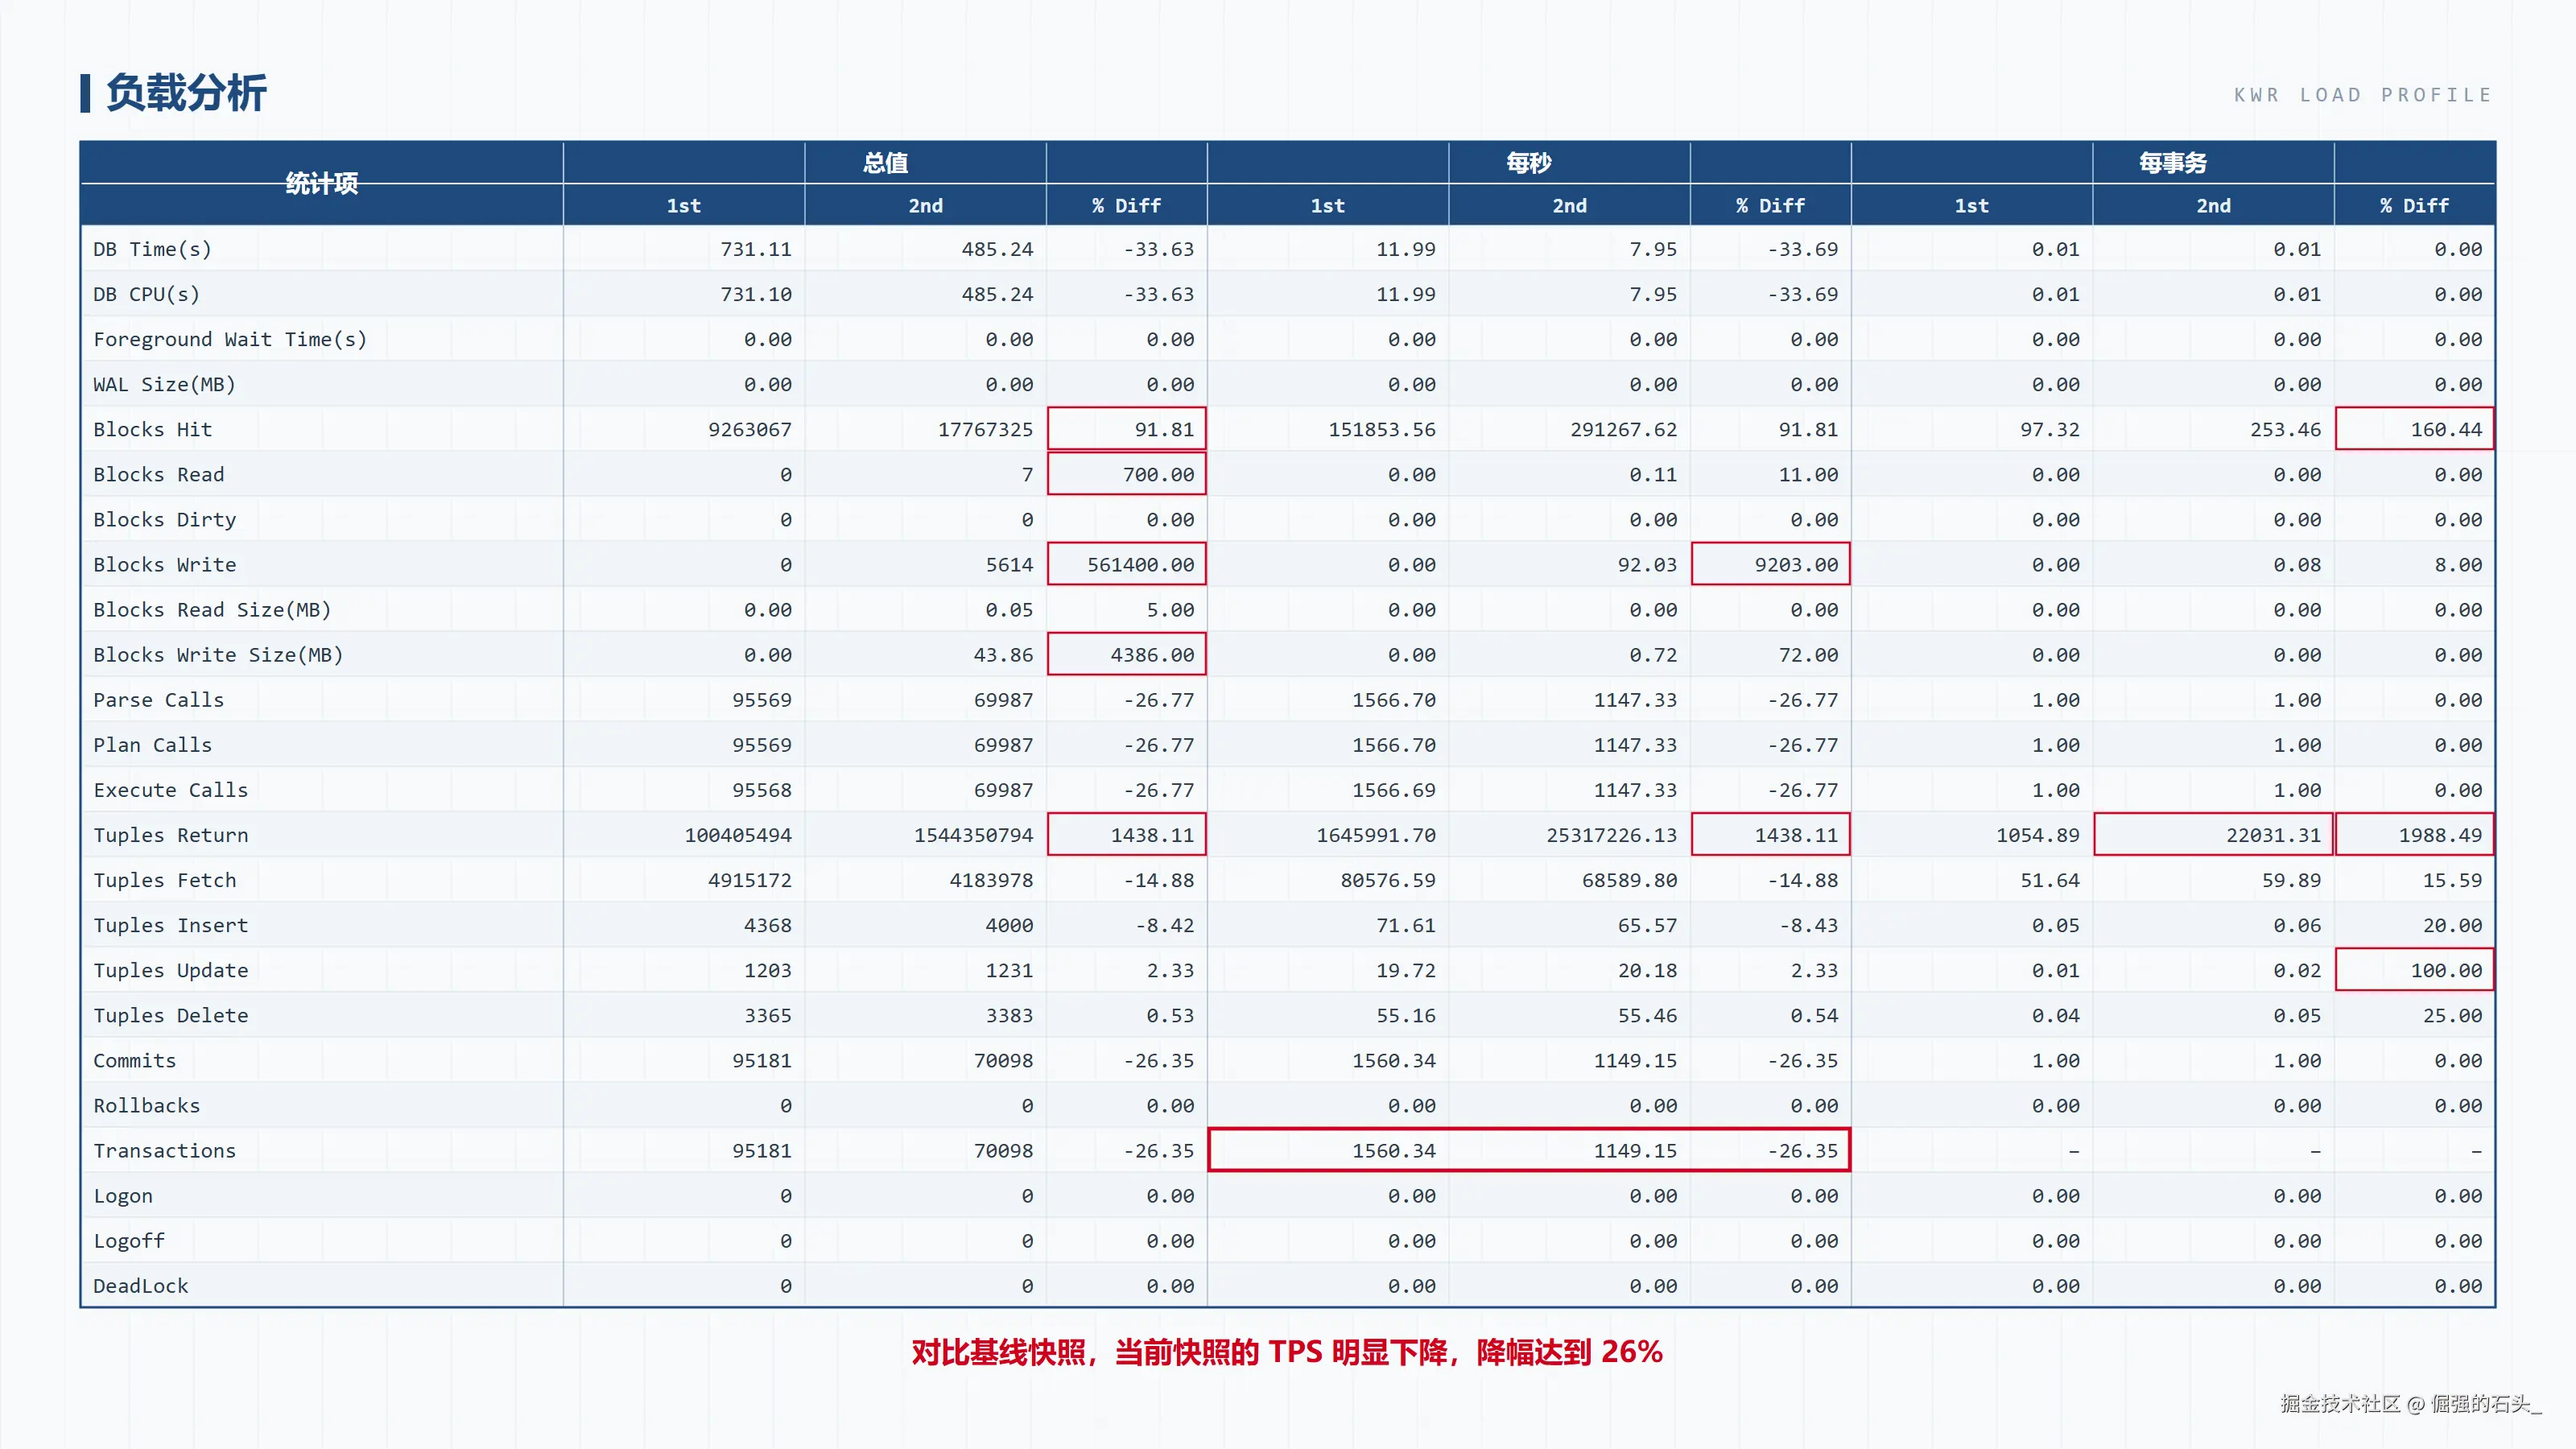
解释一下第二行。Tuples Return 是数据库返回的行数,涨了 14 倍多。事务量在降,返回的行数却在暴涨。这说明有语句在做大量无意义的扫描。缓冲命中也翻了倍。典型的"用更多内存和 IO 干同样的事"。
到这一步,方向已经清楚了。问题出在某条 SQL 上,不是资源不够。
二、TOP SQL 下钻:把热点链拉出来
KWR 报告里有个子报告,叫"按数据库时间排序的 TOP SQL"。这次它派上了大用场。因为这个版本支持语句级的 PL/SQL 下钻,能展开存储过程内部的调用关系。
展开第一层,热点就是它:fn_calc_order_b($1),占掉 99.12% 的数据库时间。继续往下钻:
- 第 1 层:
fn_resolve_order_segment占 62.32%; - 第 2 层:
fn_get_customer_profile占 62.14%; - 第 3 层:一条具体的查询语句,占 60.65%------
SELECT CASE WHEN credit_score >= ... FROM biz_customer_profiles WHERE customer_code = ...。
三层钻完,问题语句找到了。但 KWR 到这里就到了能力边界。它看不到执行计划。下一步换工具。 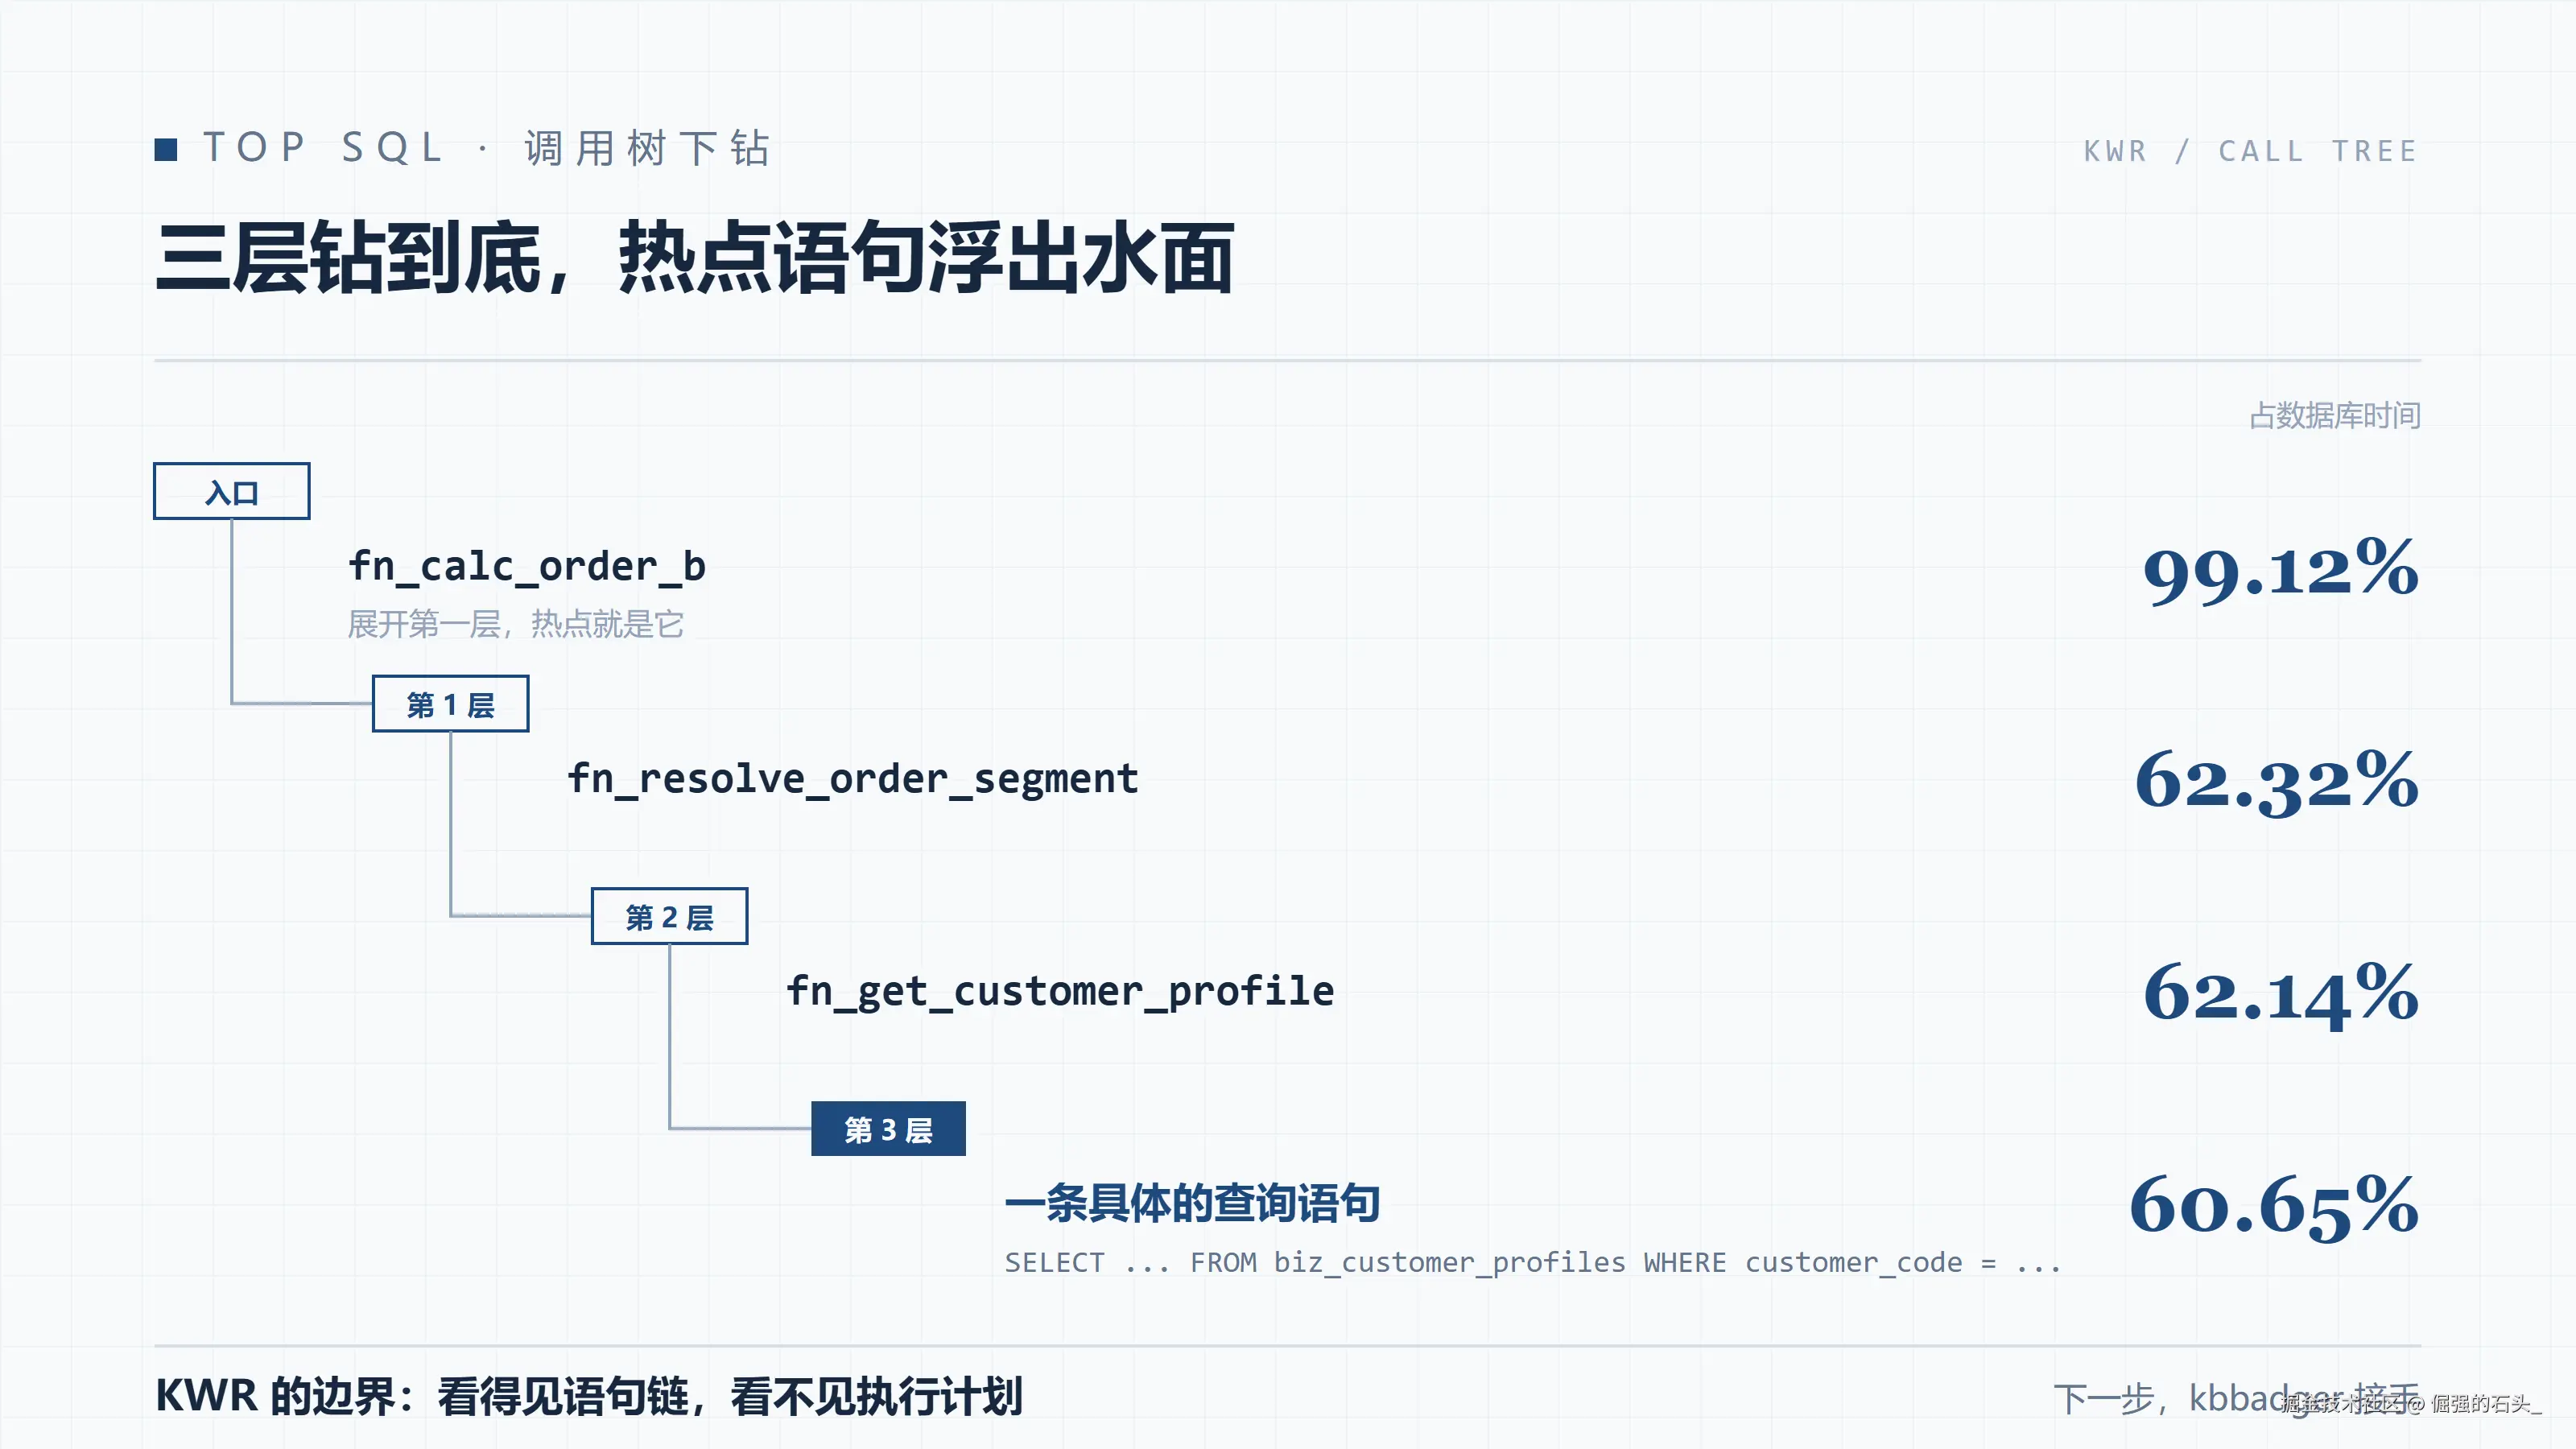
三、kbbadger:执行计划揭案
把相关日志喂给 kbbadger,拿到了这条语句的真实执行计划。真相大白:
ini
Seq Scan on biz_customer_profiles
  (cost=0.00..439.00 rows=1 width=4)
  (actual time=0.863..4.363 rows=1 loops=1)
  Filter: ((customer_code)::text = ($1)::text)
  Rows Removed by Filter: 21999
两个关键信息。第一,优化器走的是顺序扫描,没有用索引。第二,每查一次,要过滤掉 21999 行才留下 1 行。这条语句被调用了 6 万多次。每次都全表扫一遍。
解释一下这两个数字为什么扎眼。顺序扫描本身不是错误。小表全扫一遍甚至比走索引还快。但两万行里挑一行、还被外层循环驱动着调几十万次,这个组合就是灾难了。索引扫描每次的开销,和这完全是两个量级。优化器选错路的原因很简单。表上压根没有 customer_code 的索引,它没得选。
表上确实没有 customer_code 的索引。补上:
sql
CREATE INDEX idx_biz_customer
    ON biz_customer_profiles (customer_code);
索引建完,复查 KWR。Tuples Return 从 1.5 亿降到 560 万。每事务返回行数降了 93.8%。TPS 回到 1413。 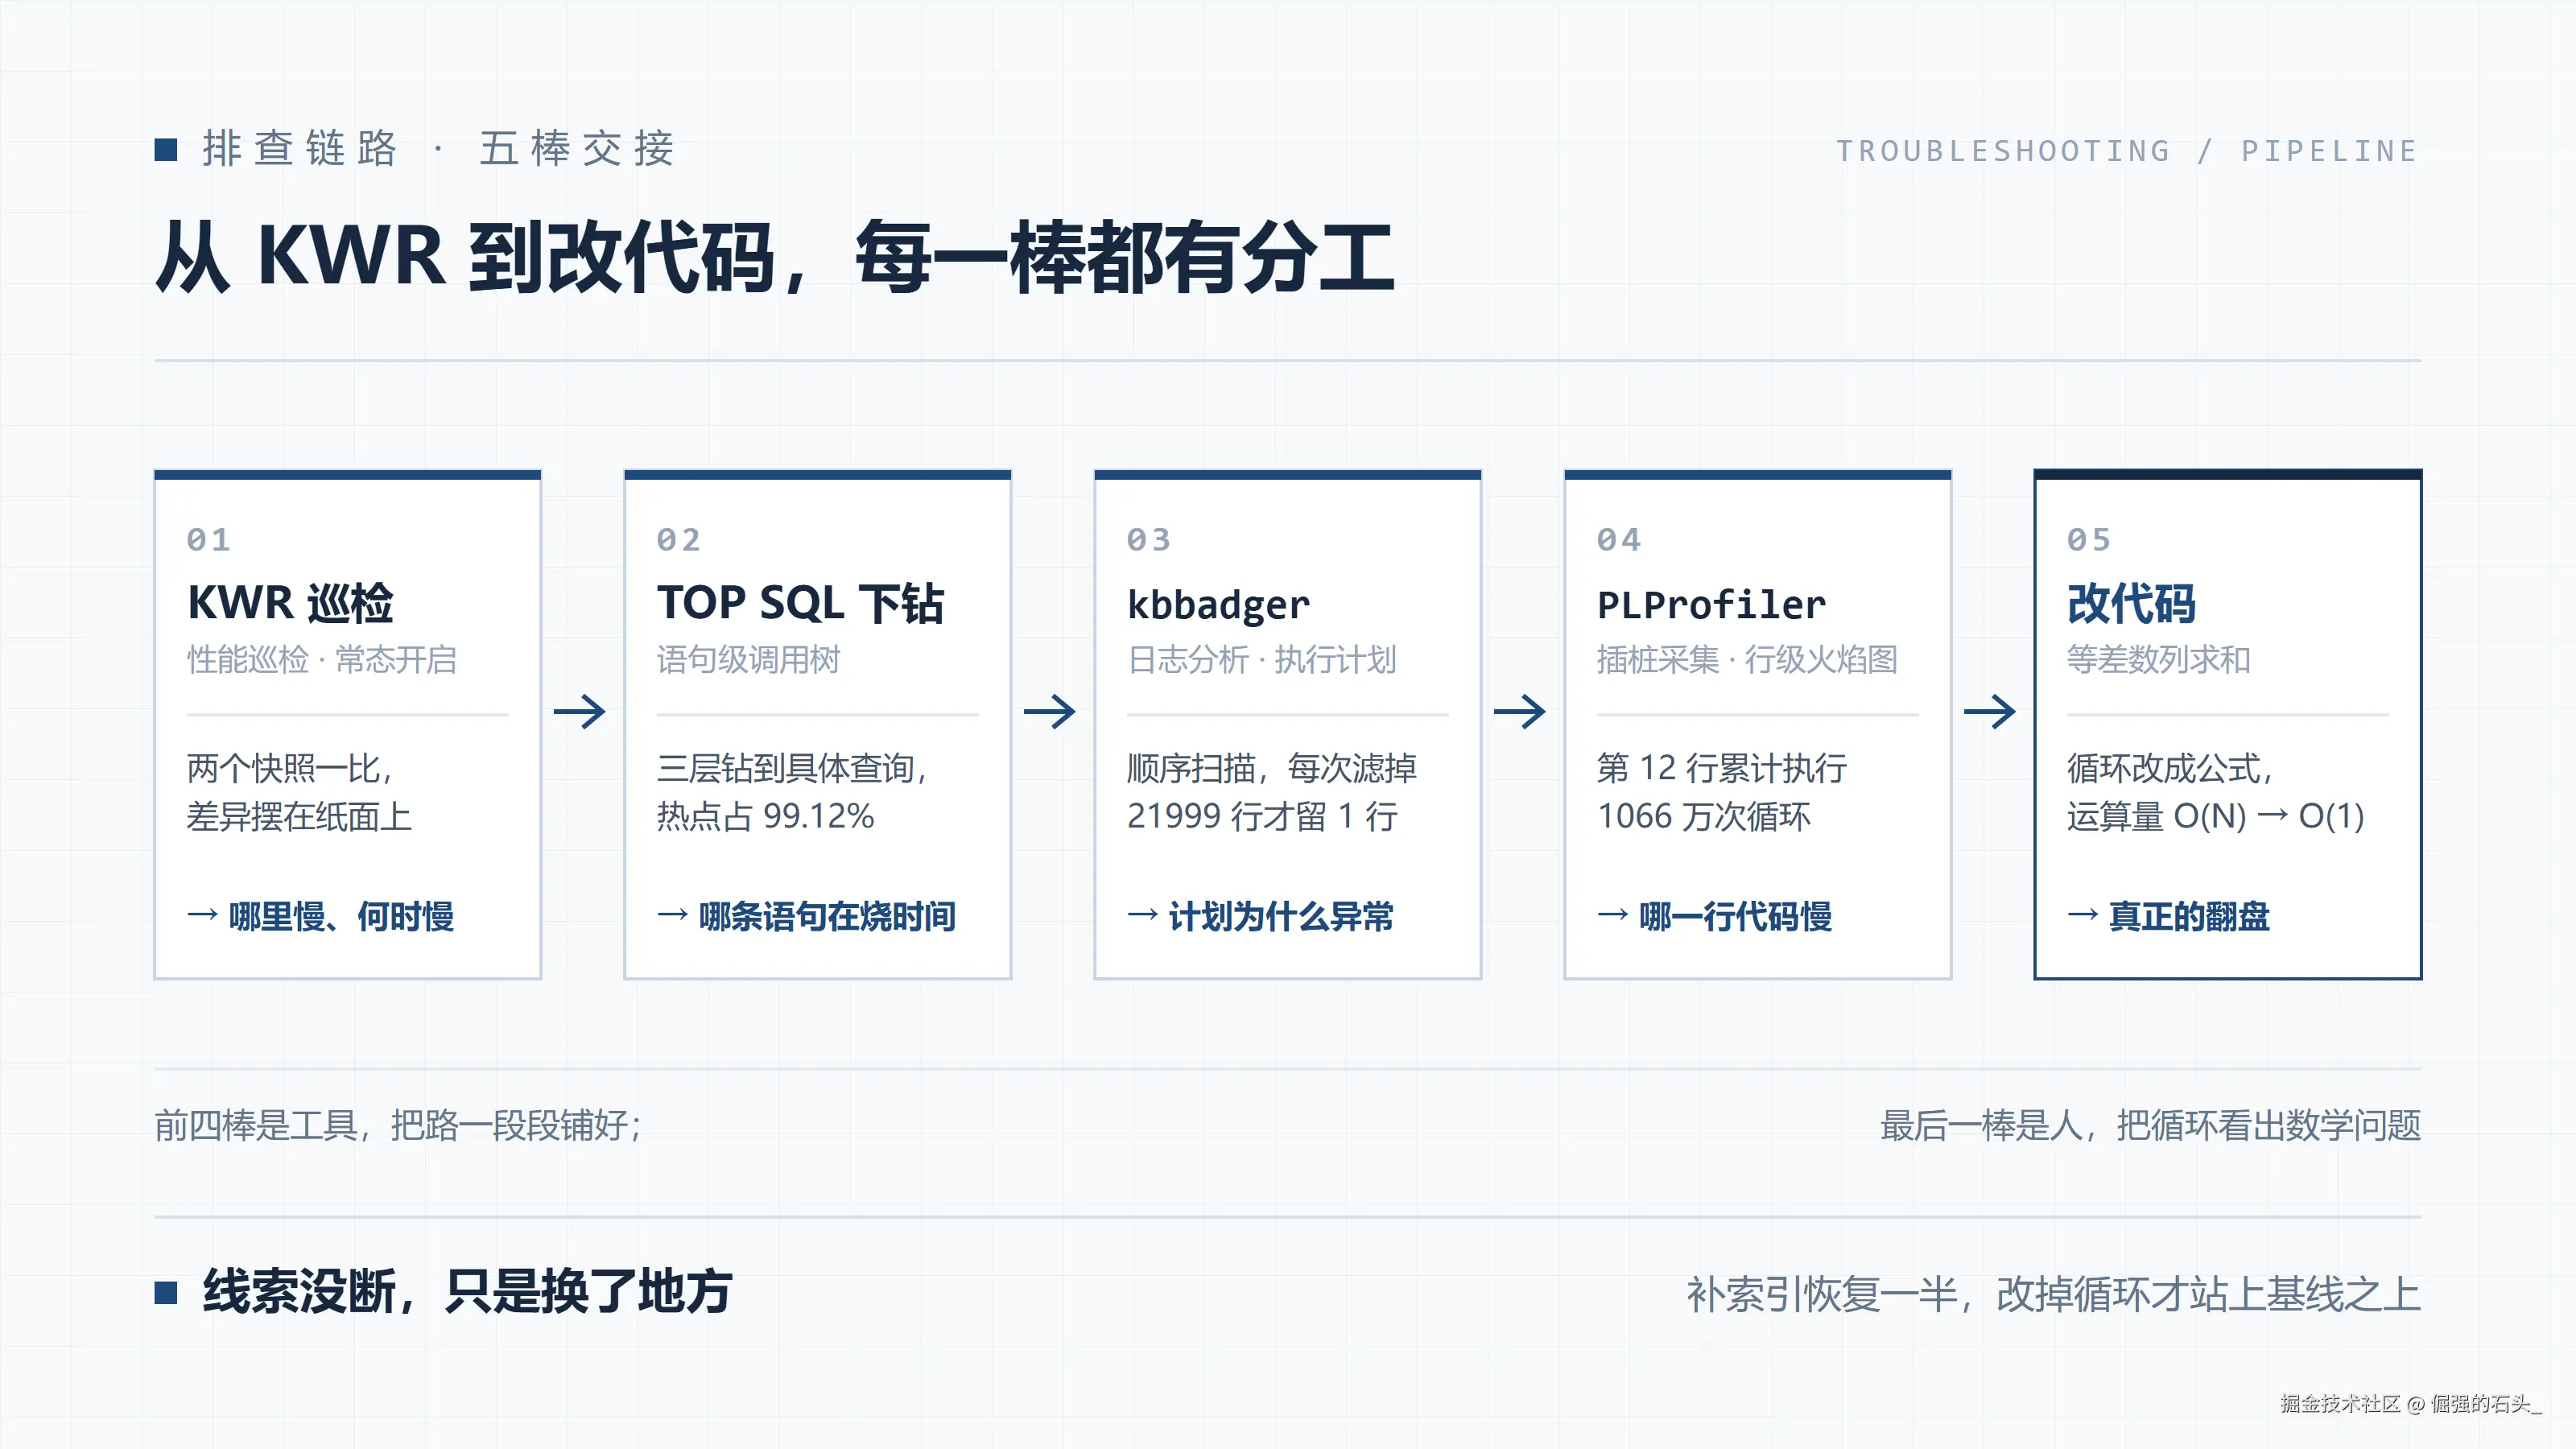
有了恢复,但没到基线。这就是这次排查有意思的地方。线索没断,只是换了地方。
四、"数据库时间空洞":剩下的时间去哪了
再翻 KWR 的调用树,我发现一个奇怪的现象。另一条热点 fn_capital_fee_by_day_b 占了 26.12% 的数据库时间。但它下面第 3 层的子调用加起来,只占了百分之几。
上层记着账,下层对不上。这个缺口,我把它叫"数据库时间空洞"。它意味着什么?意味着时间没花在 SQL 执行上,而是花在 PL/SQL 代码本身。
语句级的 KWR 到这里,又到边界了。要看代码行级别的热点,得上 PLProfiler。这个工具的原理是插桩采集。能输出函数级和代码行级的火焰图。
PLProfiler 跑出来的报告长什么样?上面是整棵调用树的火焰图,越红的地方越烫;下面直接细到每一行代码的执行次数和耗时: 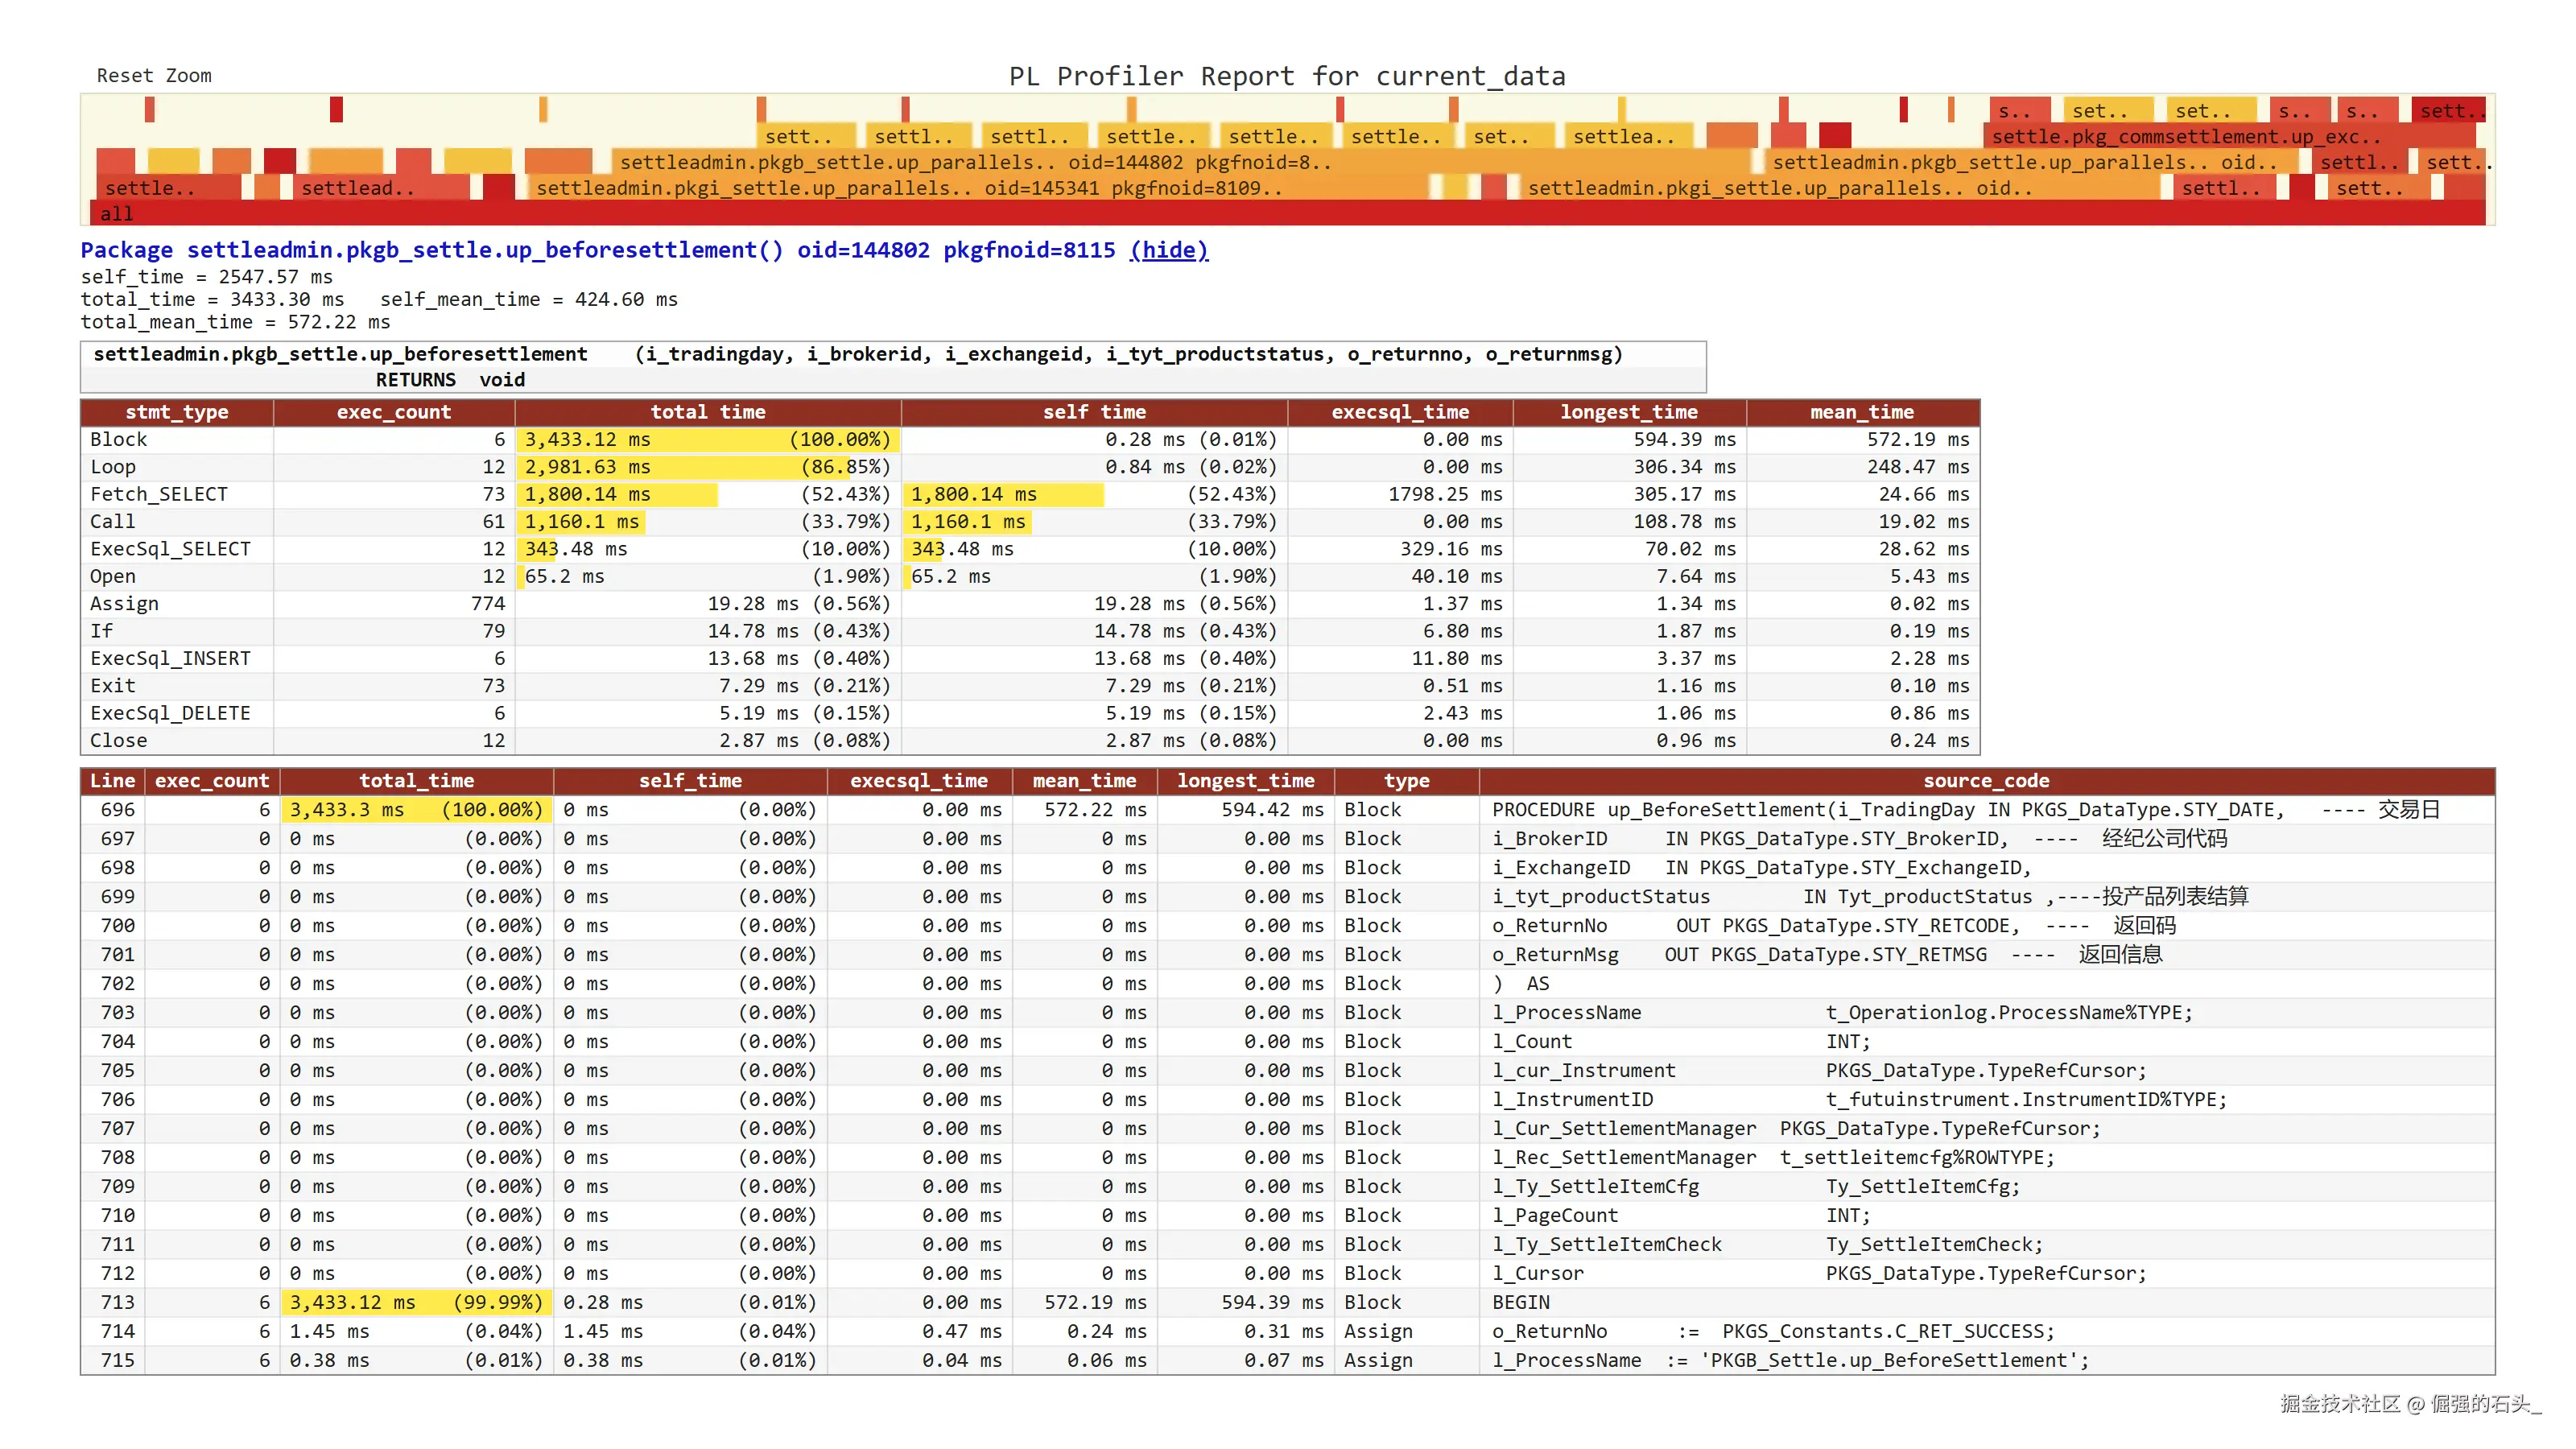
装上探针跑了一段。函数级热点直接指到了 fn_capital_fee_by_day_b。被调用 31,843 次,自身耗时 118 秒。再看行级报告,三行代码吃掉了几乎所有时间:
| 行号 | 执行次数 | 耗时占比 | 代码 |
|---|---|---|---|
| 9 | 31,843 | 97.18% | FOR d IN 1 .. p_term_days LOOP |
| 10 | 11,622,695 | 91.00% | IF d > p_grace_days THEN |
| 12 | 10,667,405 | 43.29% | v_weighted := v_weighted + ... |
看明白了吗?这是一个按分期天数循环累加资金占用费的函数。外层循环每天迭代一次。循环体内还要做判断和累加。业务量上来之后,这个循环执行了上千万次。 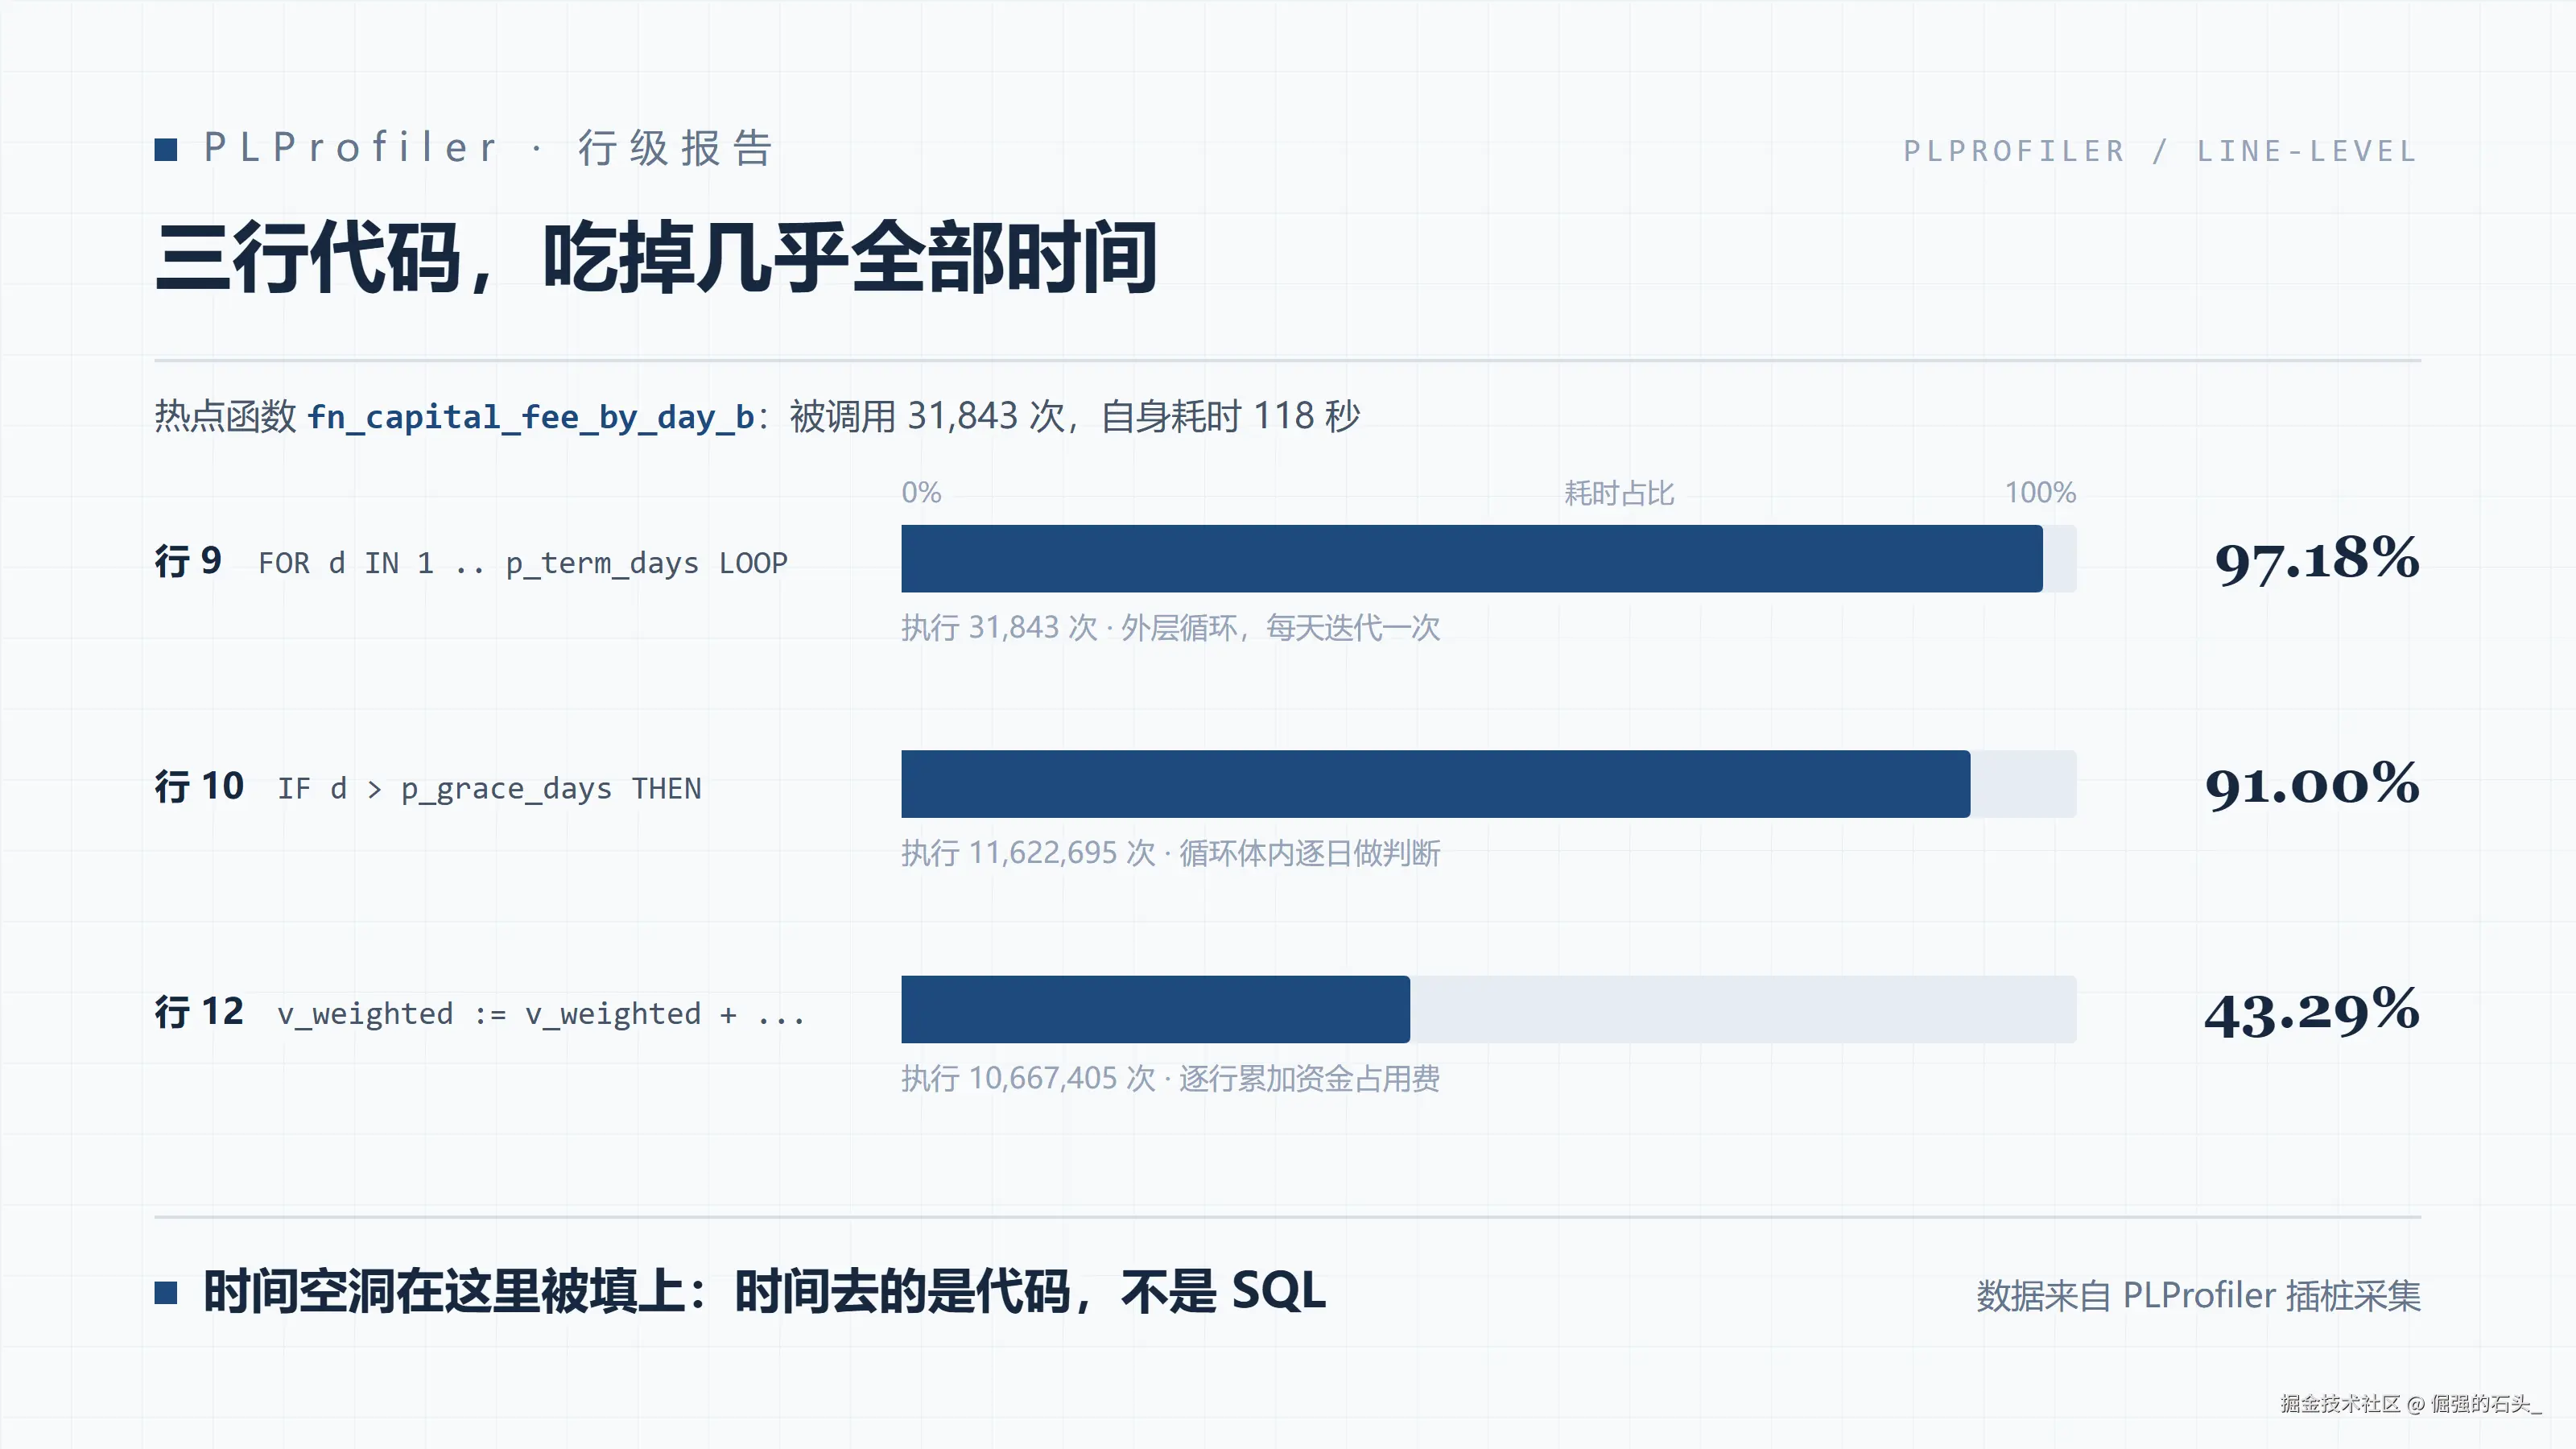
五、把循环改成公式
这种问题的解法,不在数据库参数里,在数学里。
循环累加的内容,本质是一个等差数列求和。免息期后的有效计息天数乘以权重,加起来就是 (N-G) + (N-G-1) + ... + 1。公式一步就能算出来。改造后的代码:
sql
-- 改造前:按天循环累加
FOR d IN 1 .. p_term_days LOOP
    IF d > p_grace_days THEN
        v_weighted := v_weighted + p_principal * (p_term_days - d + 1);
    END IF;
END LOOP;

-- 改造后:等差数列求和,一步到位
v_effective_days := GREATEST(p_term_days - p_grace_days, 0);
v_weighted := p_principal * v_effective_days
            * (v_effective_days + 1) / 2;
业务逻辑完全等价。运算量从 O(N) 降到 O(1)。
改这种代码,动手前有两件事必须做。一是等价性验证。把新旧两版函数放一起双跑,拿几个月的历史数据对比结果。一分钱差错都不能有。毕竟算的是资金占用费。二是灰度切换。先在测试环境跑全量业务,再小流量上线观察一周,确认无误才全量放开。性能改造翻车的案例,一半不是改得不对。是没验证就上了。
最终的 KWR 复查,数字是这样的。每秒事务 1413 → 3968 。比原始基线的 1560 还高出一大截。Tuples Return 降了 80.6%。TPS 恢复到预期标准,结案。 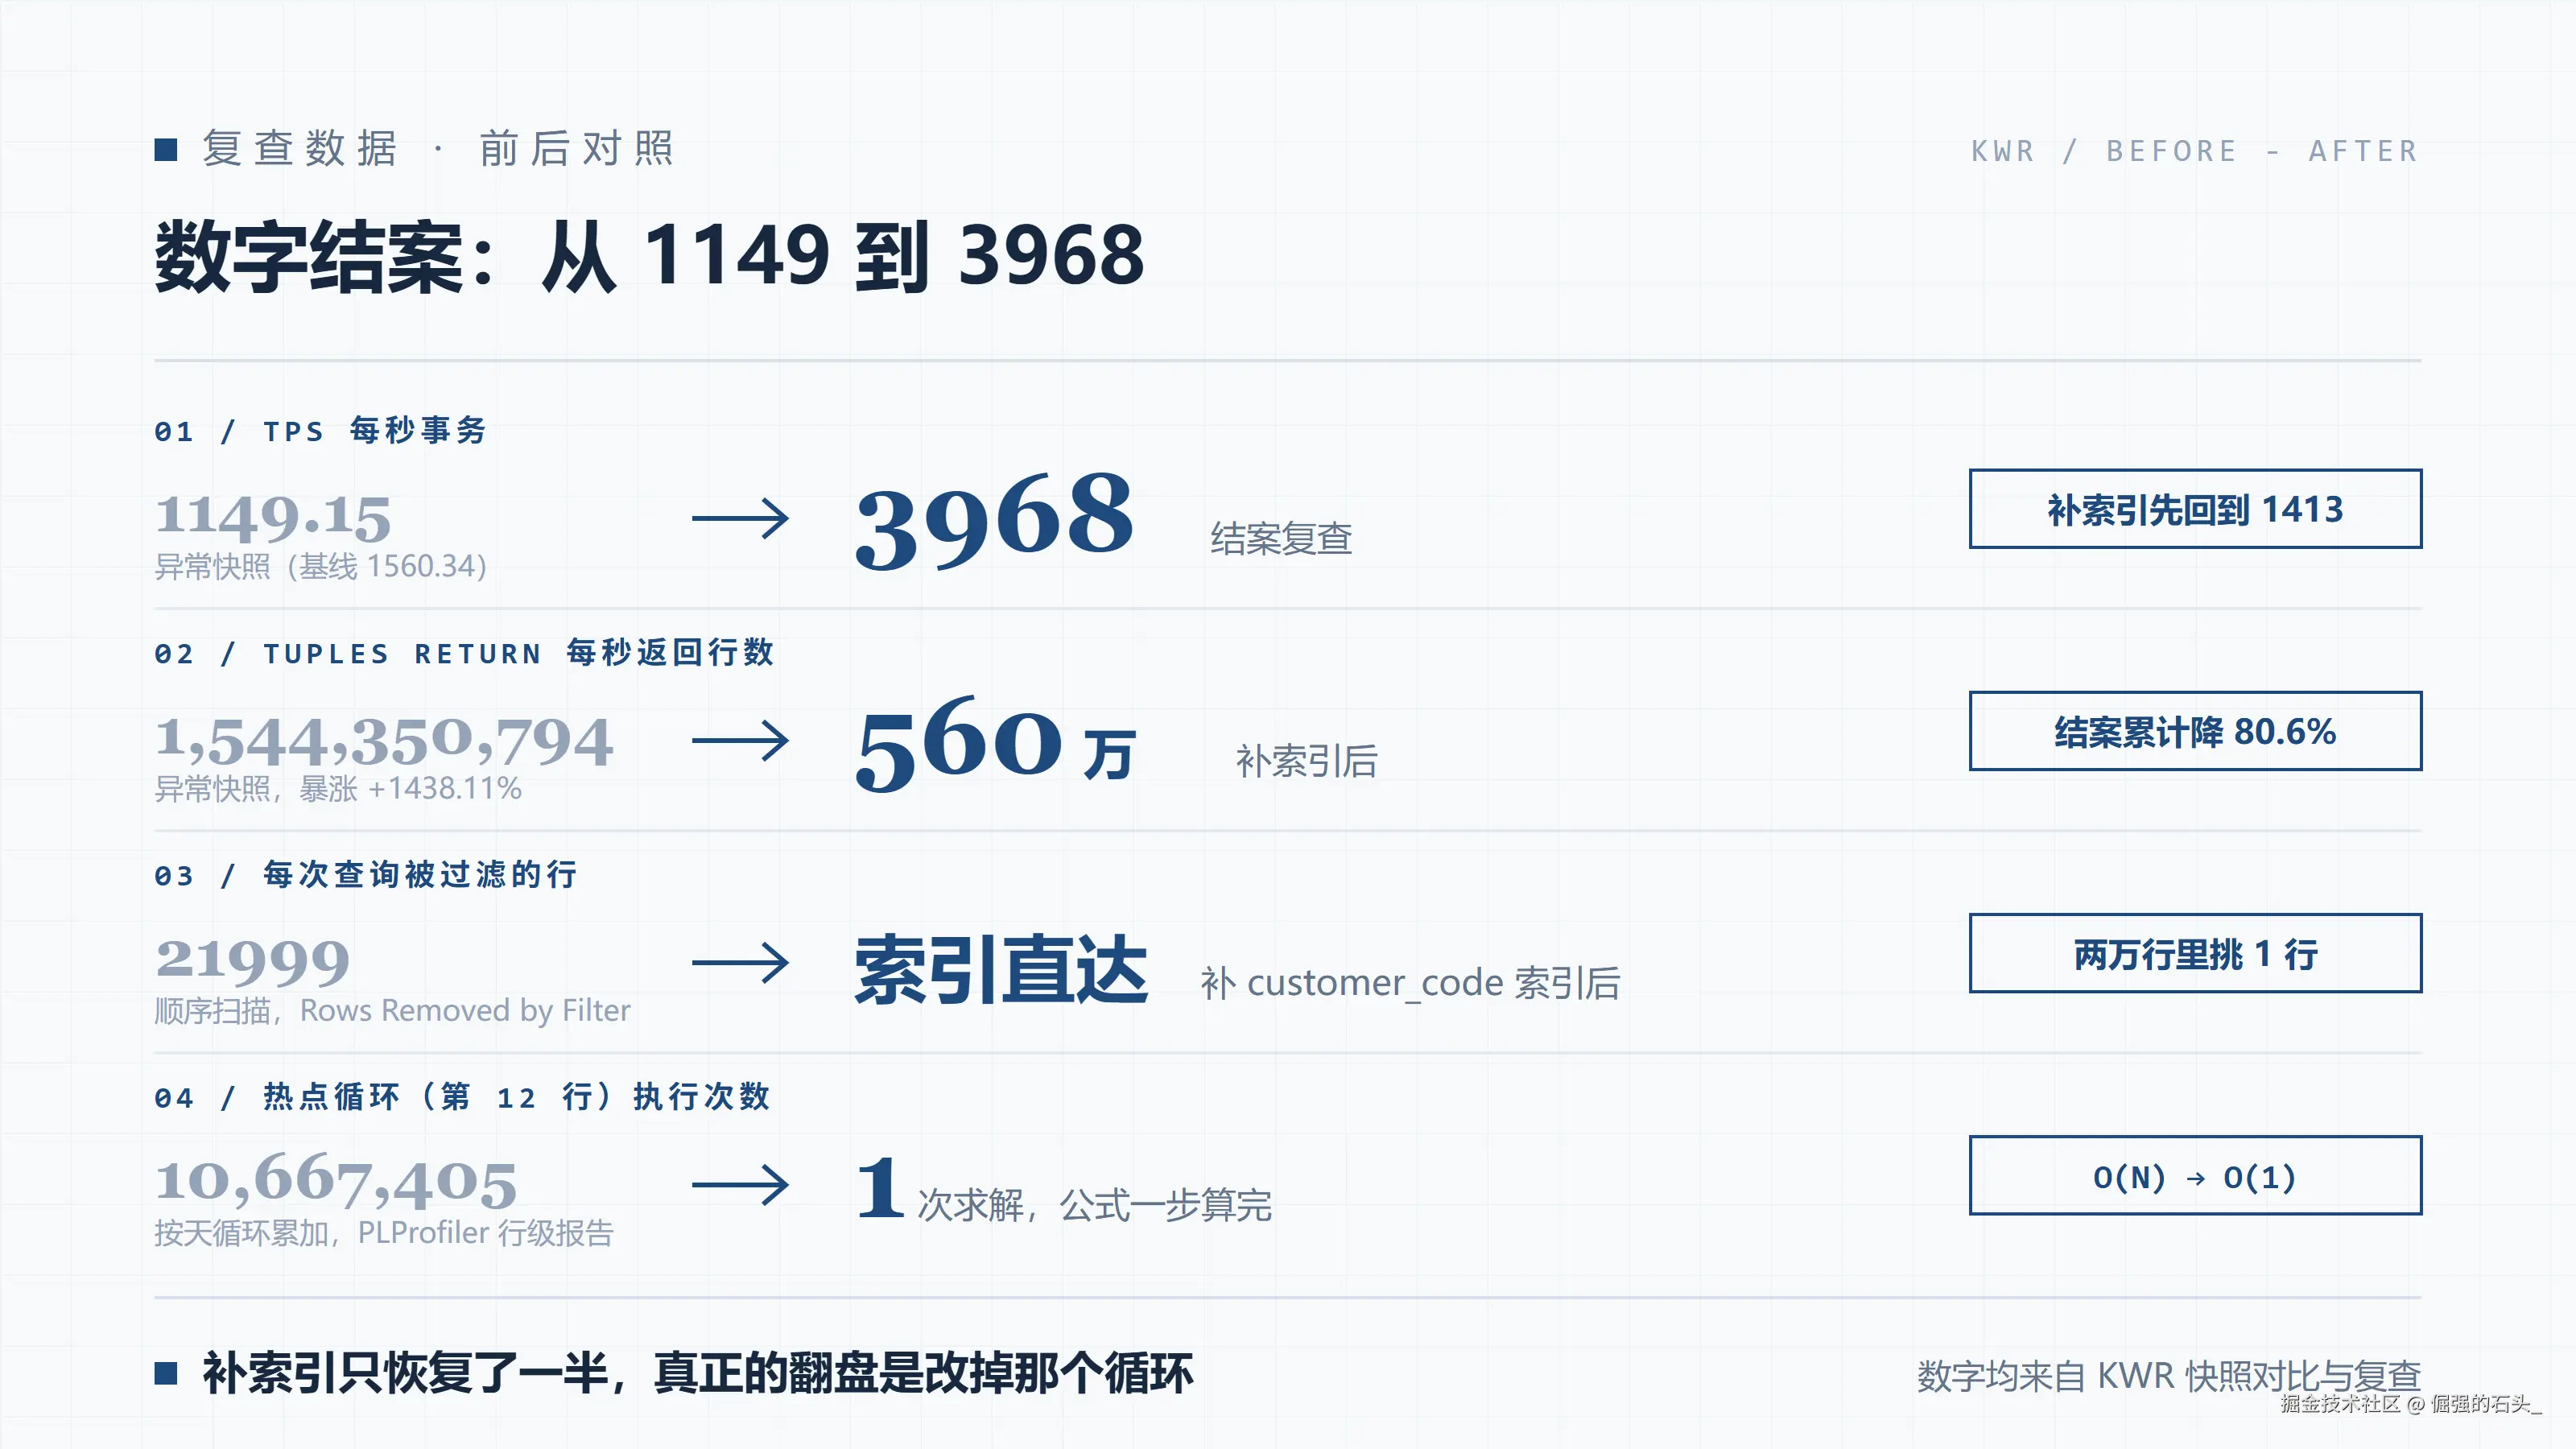
六、复盘:这次排查的方法论
回看整个流程,其实是一条清晰的工具链路。每一棒都有分工:
- KWR 巡检回答"哪里慢、何时慢"。快照对比锁定异常时段和热点语句链;
- kbbadger 回答"执行计划为什么异常"。揪出顺序扫描;
- KWR 调用树发现"时间空洞"。判断剩余时间去向;
- PLProfiler 回答"哪一行代码慢"。插桩定位到循环;
- 最后一步是人。把循环看出数学问题。
有三条经验值得记下来。第一 ,工具链要配套。KWR 管语句级、PLProfiler 管行级、PLTrace 管运行态透视。单靠一个工具的视角,一定会有盲区。第二 ,"预估行数和实际行数对不上""上层时间和下层时间对不上"这两个信号,是最值钱的线索。看到就要追。第三,数据库性能优化做到最后,很多答案不在数据库里,在代码里。补索引只恢复了一半。真正的翻盘,是改掉那个循环。
性能问题从来不是玄学。工具把路铺好了,剩下的就是一步一步走过去。这周最大的收获不是那两个数字。是团队从此有了一套完整的排查套路。
七、亡羊补牢:这次之后立下的三条规矩
案子结了,但事情没完。同样的坑,不立规矩就还会有人踩进去。复盘会上我们定了三条,写进了团队的开发规范。
第一条,索引评审进发版流程。 这次的问题表是两年前建的。当时只有主键索引。后来业务查询换到了 customer_code 这一列,没人想起来要补索引。现在的规矩是,新表上线前,开发要列出预估的高频查询列,DBA 对照建索引。老表的业务查询模式变了,改动要同步知会 DBA。一句话,索引不能等人想起来才建。
第二条,统计信息巡检制度化。 这次病例里循环那一段能藏这么久,统计信息的维护缺位是帮凶。现在我们每周跑一遍巡检脚本。把大表的 reltuples 和实际行数做个对比。偏差超过一个量级的表,直接进 ANALYZE 队列。自动 ANALYZE 的触发阈值,也按表的变更频率分了档。写入频繁的表单独收紧。
第三条,新 SQL 上线前过一眼执行计划。 不求每条都人工审。但核心链路的新增语句,上线前要用 EXPLAIN 看一眼。走没走索引、预估行数量级对不对。花三十秒,省一次半夜被告警叫醒。
三条规矩归拢成一张表,贴在开发规范的首页。比翻一段段文字好查:
| 规矩 | 针对这次的坑 | 具体动作 |
|---|---|---|
| 索引评审进发版流程 | 两年的老表没跟上查询变化 | 新表上线前列高频查询列,DBA 对照建索引 |
| 统计信息巡检制度化 | 循环在统计信息缺位下藏了很久 | 每周比对 reltuples 和实际行数,偏差超量级进 ANALYZE 队列 |
| 新 SQL 上线前过执行计划 | 顺序扫描被外层循环驱动着调了几万次 | 核心链路新增语句先 EXPLAIN 看一眼 |
这三条,没有一条是什么高深的东西。都是"早就知道"的常识。但性能优化这个领域,大部分事故不是出在不知道。是出在知道而没做。这次排查花了一周,立规矩只花了一个会。希望下一次,规矩能把这一周省下来。