做视频、做小游戏,或者给一段画面补点气氛时,经常会碰到这种需求:
想要窗外的雨声,想要一段林间鸟鸣,或者只是一扇木门打开又关上的声音。
描述起来很简单,找素材却未必省事。搜索、试听、挑版本,找着找着,就偏离了原本想做的事情。
最近,我尝试了另一种方式:把想要的声音写出来,在自己的电脑上生成。
于是,就有了这个 Windows 小工具------声景。
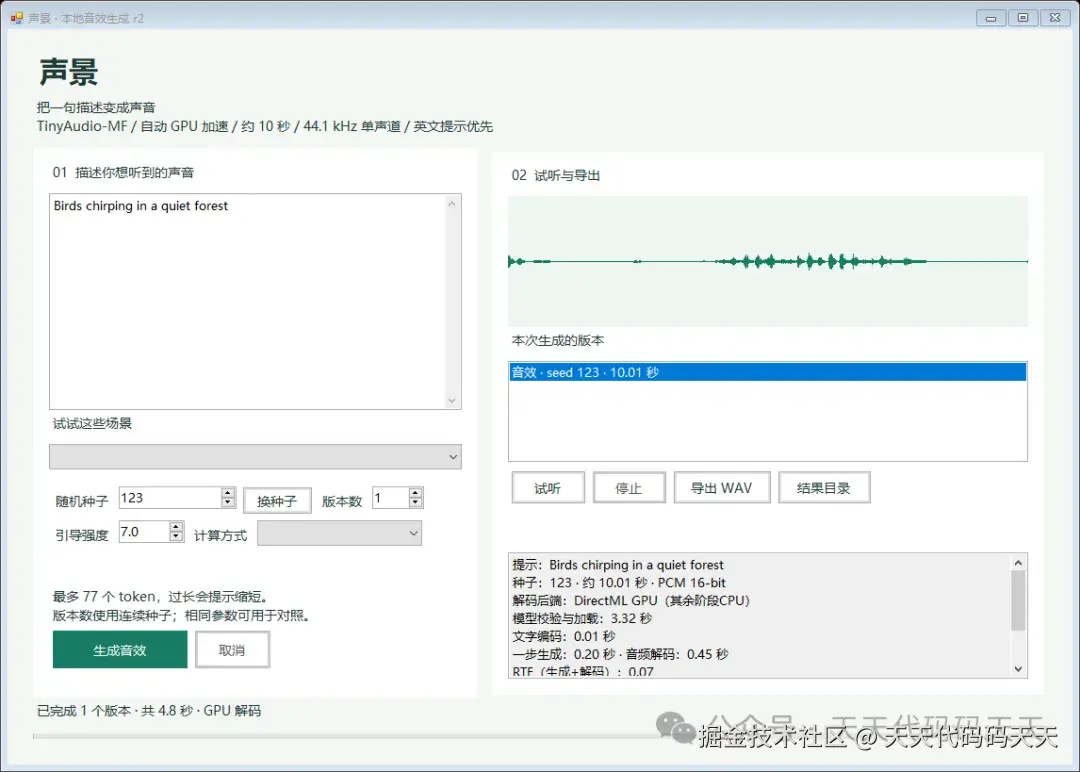
声景 r2:本地生成音效,查看波形、试听并导出 WAV
实际运行界面:输入描述后,可以查看音频波形、切换生成版本、试听并导出 WAV。
先说它能做什么
声景的使用过程很直接:
描述声音 → 点击生成 → 试听比较 → 导出 WAV。
它基于 TinyAudio-MF,主要面向短音效和环境声音。当前版本每次生成约 10 秒音频,输出为 44.1 kHz、单声道、16 位 PCM WAV。
比如,可以先从这些描述试起:
| 想要的场景 | 输入的英文描述 |
|---|---|
| 雨打窗户,远处有雷声 | Rain falling on a window with distant thunder |
| 安静森林里的鸟鸣 | Birds chirping in a quiet forest |
| 木门打开又关上 | A wooden door opening and closing |
| 海浪轻轻拍打沙滩 | Gentle ocean waves washing onto a sandy beach |
| 安静房间里的翻书声 | Pages of a book being turned in a quiet room |
这些很适合拿来做短视频的环境铺底、小游戏的音效草稿,或者给一个创意快速找找声音上的感觉。
当然,模型的输出有随机性。描述了一次关门,不代表它就一定只生成一次;声音是否合适,还是要试听、挑选和调整。
在本机生成,准备好资源后可以离线使用
声景是一个本地桌面程序。完整运行包里包含了模型和独立运行时,使用时不需要自己搭建 Python 环境,也不需要安装 PyTorch。
模型准备齐全后,输入描述、生成音效都可以在本机完成,不依赖在线生成 API。
当前支持 Windows 10/11 x64,需要 .NET Framework 4.8。GPU 加速通过 DirectML 实现,需要可用的 DirectX 12 显卡和驱动,无需另外安装 CUDA 工具包。
打开程序后,选择示例场景,或者写一句描述,就可以开始尝试。
这次最明显的改进:等待时间短了很多
第一版已经能生成声音,但速度还不够顺手:生成一段约 10 秒的音效,CPU 版往往要等几十秒。
把耗时拆开之后发现,最慢的环节是把模型生成的中间结果解码成音频。
所以,这次没有先堆更多功能,而是把音频解码接到了 GPU 上。
在本机 RTX 4060 Laptop 8GB 上,用同一个 FP32 解码网络、同一份输入分别测试,结果如下:
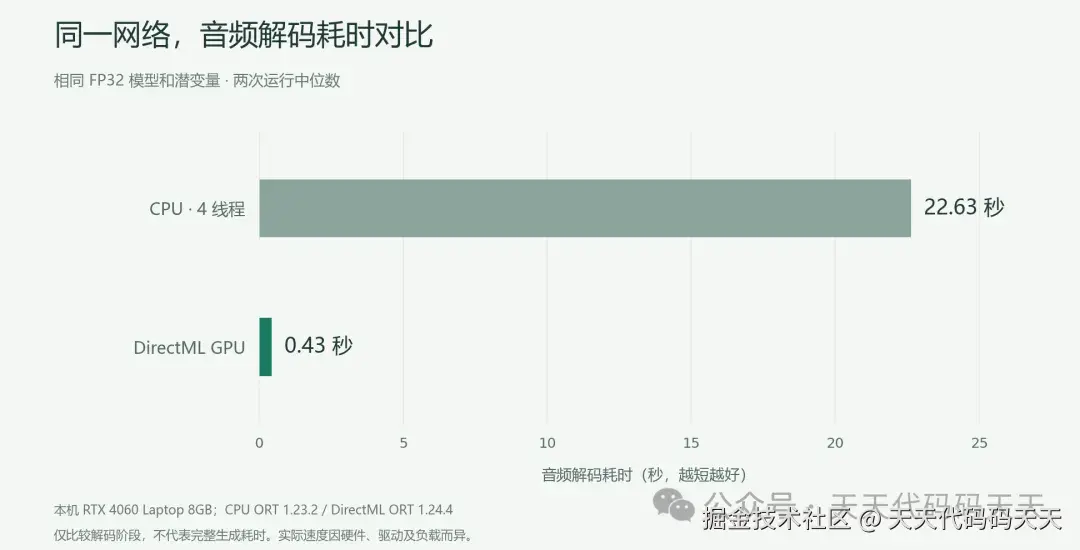
相同输入下的音频解码对比:CPU约22.63秒,DirectML GPU约0.43秒
两次运行的中位耗时:CPU 为 4 线程 ORT 1.23.2,GPU 为 DirectML ORT 1.24.4。图中只比较音频解码阶段。
解码从约 22.6 秒降到了 0.4~0.5 秒,这个阶段的耗时改善约 53 倍。
但更贴近日常使用的,是点下按钮之后一共要等多久。
实际界面测试中,生成一段约 10 秒的音效,完整等待约 4.8 秒 ;把完整运行包解压到新的中文目录,再从其他工作目录启动生成,实测约 5.4 秒。
这里包含了程序启动工作进程、资源校验、模型加载、生成、解码和结果复核。0.4 秒是解码时间,不是整个生成过程的时间。
以上是本机测试结果,其他显卡、驱动、电源模式和后台负载下,实际速度会有所不同。
提速之后,输出有没有变?
这次使用的仍是原来的模型和 FP32 精度,音频时长、采样率也保持不变。
我用同一段雨声描述、同样的随机种子,对比了 CPU 和 GPU 的结果。两种方式生成的 WAV 帧数一致,最终 16 位 PCM 的最大差异为 1 个幅度单位。
这说明本轮数值对照中的差异很小。不过,音频格式正确、波形正常,并不意味着模型一定完整理解了描述,最终效果仍然要靠实际试听判断。
文章随附了两段真实生成的样本,分别对应:
- 雨声提示:Rain falling on a window with distant thunder
- 鸟鸣提示:Birds chirping in a quiet forest
它们都由模型生成,可以结合自己的使用场景,听听是否符合预期。
做成小工具,也要把日常操作做好
除了生成按钮,这一版还补上了一些实际用起来会需要的操作。
一次生成几个版本。 可以选择生成 1~4 个版本,用连续的随机种子进行比较,挑一个更合适的结果。
保留种子,方便对照。 在相同环境和参数下,可以用固定种子复现结果,再调整描述或引导强度。不同硬件和运行时之间,不保证逐位一致。
先看波形,再试听。 生成后显示真实音频波形,也会记录生成和解码的耗时。声音不会自动播放,点"试听"后才开始。
取消任务,保留旧结果。 等待时可以取消;取消或失败,不会把之前已经完成的结果覆盖掉。
GPU 用不了,也有 CPU 入口。 计算方式可以选择"自动""GPU"或"CPU"。自动模式优先尝试 GPU;遇到 GPU 加载或执行错误,会重新启动 CPU 工作进程尝试生成,并显示回退原因。
对我来说,这些细节和模型本身一样重要。只有把等待、失败、取消、试听和保存都接起来,才更像一个可以反复使用的软件。
中文能输入吗?
能输入,但目前建议使用英文描述。
界面是中文的,程序也没有禁止中文输入。不过,这一版主要验证的是英文提示,中文描述的生成效果还没有充分验证,也没有内置自动翻译。
可以先在示例场景的基础上修改:把"海浪"换成"雨声",把"安静的房间"换成"森林",从简短、明确的描述开始。
当前提示长度上限是 77 个 token。描述太长时,程序会提示缩短,不会悄悄截断后继续生成。
从一个开源模型,到一个能直接尝试的桌面程序
声景的底层模型来自 TinyAudio 开源项目(github.com/junxi25liu/...
桌面应用这部分,则复用了我在 Lw.OnnxVulkan.VS2022 中积累的路径管理、进程取消、输出校验、异常日志和 WinForms 设计期隔离等代码。
目前使用的是 ONNX Runtime CPU + DirectML GPU 解码。基础项目名字里的 Vulkan,并不代表这次音频模型已经迁移到了 Vulkan 上。
接下来还想继续打磨的,是重复生成时的模型加载开销、中文描述的使用体验,以及更多实际场景下的音效效果。
如果你也剪视频、做游戏,或者只是对声音生成感兴趣,欢迎在评论区聊聊:
你最想用一句话生成什么声音?
是雨夜里的街道,老式机械键盘的敲击,还是某种很难在素材库里找到的小声音?
也欢迎分享你更在意的功能,后续继续围绕实际需求改进。