在湖仓中,查询需求并不总是大范围的统计分析。有时,我们只想根据订单 ID、设备 ID 找到少量记录;有时,则需要从海量商品、文档或图片向量中,召回最相似的 Top-K 结果。
以商品搜索为例,一次查询可能既要限定租户、品类和价格范围,又要找出与用户输入语义最接近的商品。这要求查询既能高效过滤业务条件,也能完成向量检索。
分区裁剪、Min/Max 统计等优化,可以帮助查询跳过不相关的文件。但对于这类只需要返回少量结果的查询,剩余文件中仍可能包含大量不符合条件的数据。能否进一步缩小读取范围,成为提升查询效率的关键。
Paimon Global Index 提供了更细粒度的数据定位方式:先通过索引找到目标数据的 Row ID,再定位并读取对应数据。基于这一能力,EMR Serverless StarRocks 支持通过 BTree 索引进行标量过滤,通过 Vector 索引进行向量检索,也支持将两者结合,先限定业务范围,再执行语义检索。
本文将从这三类查询方式出发,介绍 Paimon Global Index 的基本原理、EMR Serverless StarRocks 的执行架构,以及具体使用方法。
什么是 Paimon Global Index?
理解 Paimon Global Index,可以先从 Row ID 入手。Paimon 为表中的数据行分配全局 Row ID,Global Index 则建立业务字段或向量与 Row ID 之间的映射。查询可以先通过索引找到候选 Row ID,再定位对应的数据范围,减少后续需要读取和处理的数据。
这一能力面向开启 Row Tracking 和 Data Evolution 的 Append Table。具体的建表与索引配置,将在后文的使用示例中介绍。
查询过程可以概括为:
-
根据过滤条件或查询向量搜索 Global Index;
-
获得候选 Row ID;向量检索还会返回对应的 Score;
-
根据 Row ID 定位数据范围,读取候选数据;
-
继续执行剩余过滤、投影和 Top-K 等操作。
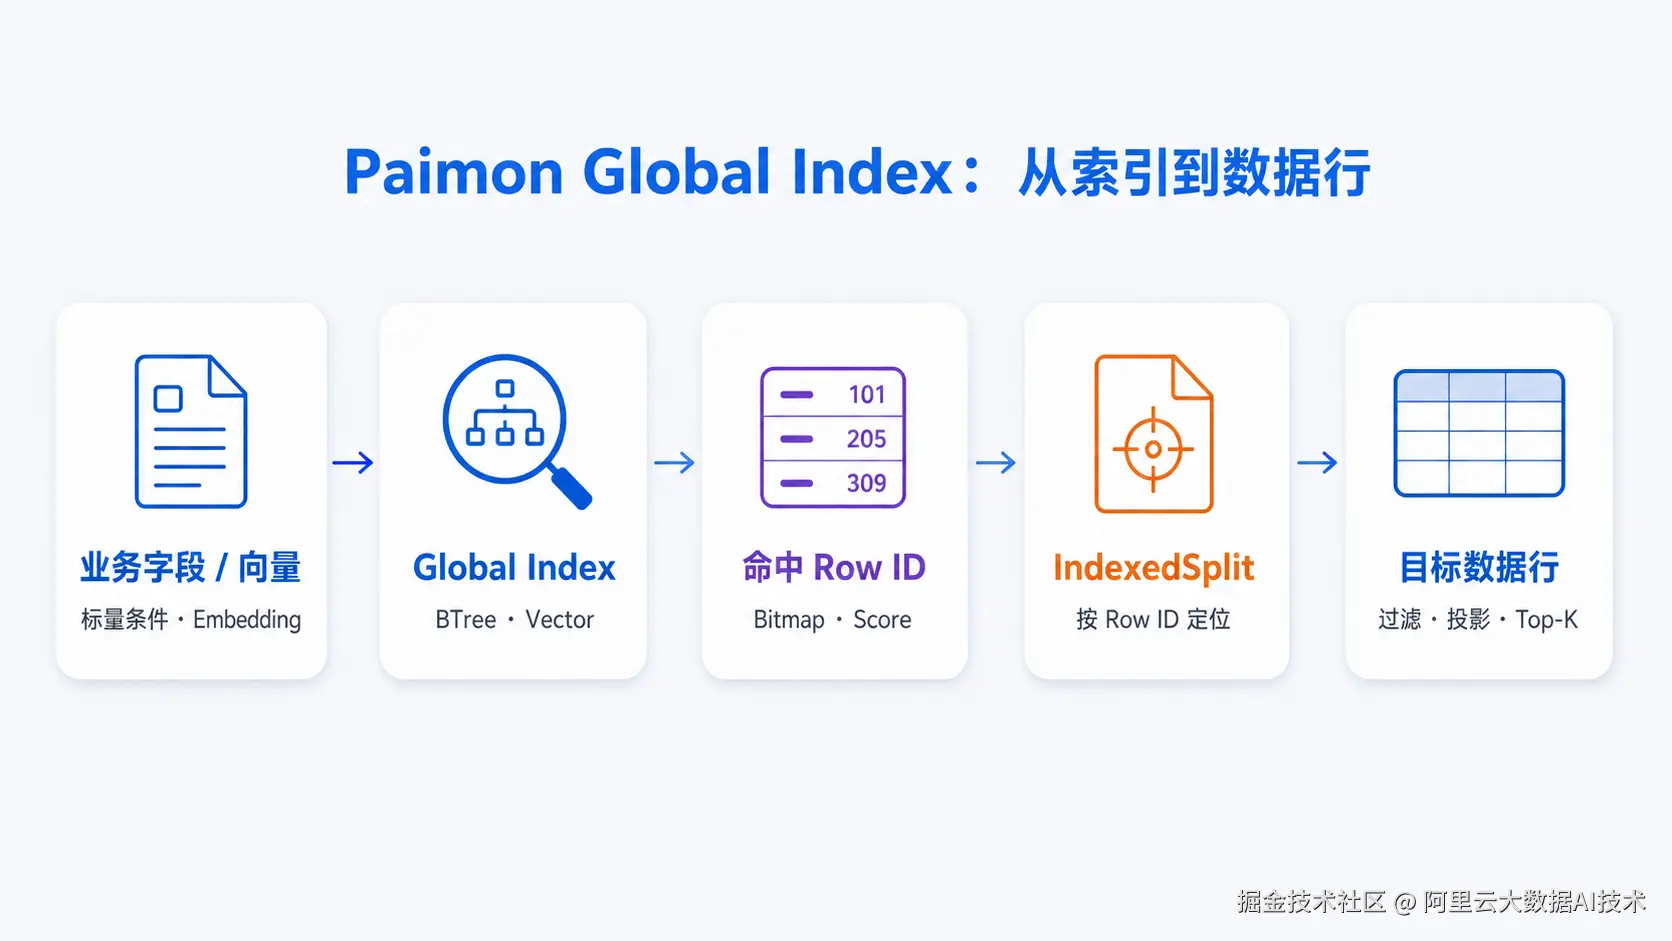
这里的"Global"指向表级的 Row ID 映射,并不意味着整张表只有一个庞大的索引文件。物理上,Global Index 按分区和 Row ID 范围拆分为多个 Index Shard,由 Paimon Snapshot 和 Index Manifest 管理。EMR Serverless StarRocks 查询时,可以将这些分片分配给多个 BE 或 CN 并行搜索。
Global Index 与普通数据裁剪有什么区别?
分区裁剪和文件级统计信息,主要帮助查询排除不相关的数据文件;Global Index 则进一步提供候选 Row ID,用于定位更细粒度的数据范围。
| 对比维度 | 分区与文件级裁剪 | Paimon Global Index |
|---|---|---|
| 定位粒度 | 分区、文件或 Row Group | 表级 Row ID |
| 查询结果 | 候选数据文件 | 候选 Row ID |
| 主要目标 | 跳过无关文件 | 直接定位目标数据行 |
| 典型场景 | 分区查询、宽范围分析 | 点查、窄范围过滤、向量 Top-K |
| 向量检索 | 不适用 | 返回 Row ID 和 Score |
这些优化可以配合使用:一次查询可以先通过分区裁剪缩小范围,再搜索相关的 Global Index Shard,最后根据候选 Row ID 读取对应数据。
BTree Global Index:加速高选择性标量查询
根据订单 ID 查找一笔订单,或限定租户和价格范围筛选商品,这类查询往往只需要返回表中的少量数据。BTree Global Index 可以先通过索引找到满足条件的 Row ID,再据此读取对应数据,减少扫描和过滤的工作量。
它适合经常出现在 WHERE 条件中的基础数值和字符串列,例如:
-
订单 ID、用户 ID、租户 ID;
-
商品编码、设备编号;
-
价格、评分等数值字段;
-
高基数的业务分类字段。
判断索引是否适合,关键在于查询条件能过滤掉多少数据。条件命中的数据占比越小,BTree Global Index 通常越有机会带来收益。 如果一个条件会命中表中大部分数据,普通列式扫描可能更加合适。
BTree Global Index 返回的是满足条件的 Row ID Bitmap,即用 Bitmap 表示的候选行集合,后续再根据这些 Row ID 读取业务数据。
当前版本主要支持以下查询条件:
| 条件类型 | SQL 示例 |
|---|---|
| 等值与不等值 | tenant_id = 1001、status != 'deleted' |
| 范围 | price >= 3000 AND price < 8000 |
| IN / NOT IN | product_id IN (101, 205, 309) |
| 空值判断 | category IS NOT NULL |
| 字符串前缀 | starts_with(product_code, 'ALI-') |
BETWEEN 可以改写为上下界条件,因此也可以使用范围索引。
为了便于优化器识别,建议将条件写成"索引列在左、常量在右"的形式。复杂 OR 和普通 LIKE 暂不应视为已支持的索引条件;前缀匹配建议使用 starts_with。
多个 BTree 条件如何组合?
以同时限定租户和价格范围的商品查询为例:
plain
WHERE tenant_id = 1001
  AND price >= 3000
  AND price < 8000
当 tenant_id 和 price 上都存在可用的 BTree Global Index 时,EMR Serverless StarRocks 可以分别查询两个索引,再合并过滤结果:
-
tenant_id 索引返回满足租户条件的 Row ID Bitmap A;
-
price 索引返回满足价格范围的 Row ID Bitmap B;
-
对两个 Bitmap 求交集,得到同时满足条件的候选 Row ID;
-
根据候选 Row ID 读取对应数据。
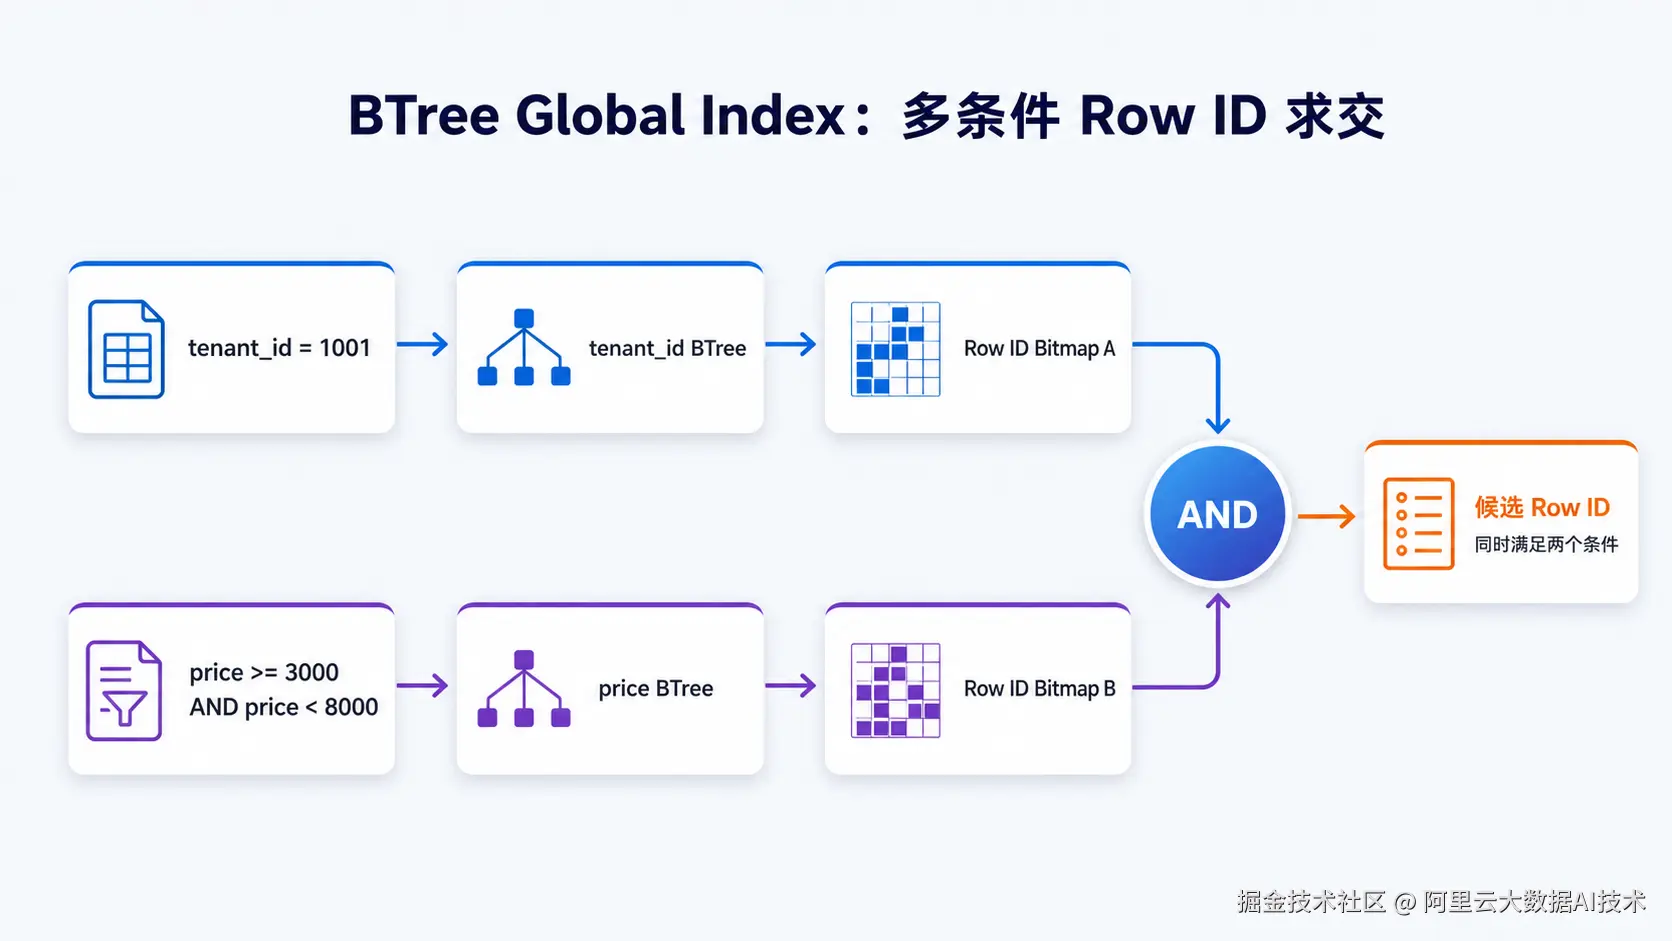
这里的 Row ID Bitmap 是 BTree 索引查询的结果,并不是另一种 Bitmap Index。
对于点查、IN 查询和窄范围查询,这条路径可以先通过索引缩小候选数据范围,再读取业务列,减少读取后才被过滤掉的数据。
Vector Global Index:面向语义 Top-K 检索
在商品语义搜索、RAG 文档召回、以图搜图等场景中,查询需要找到与输入内容最相似的结果。商品描述、文档片段、图片和音视频内容可以转换为向量(Embedding),通过向量之间的距离或相似度进行检索。
如果每次查询都读取全部向量并逐一计算,数据读取量和计算量会随着表规模增长。Vector Global Index 使用近似最近邻搜索(ANN),先从索引中召回候选 Row ID 和对应的距离或相似度分数(Score),再读取候选数据,减少需要读取和计算的向量数量。
典型场景包括:
-
RAG 文档片段召回;
-
商品语义搜索;
-
以图搜图;
-
推荐系统候选召回;
-
相似事件或相似场景检索。
EMR Serverless StarRocks 支持以下 Paimon Vector Global Index:
| Index Type | 特点 | 适用场景 |
|---|---|---|
| diskann | 基于 Vamana 图的磁盘向量检索,结合 PQ 压缩与原始向量重排 | 大规模向量库、较低内存占用 |
| ivf-flat | IVF 分区加原始向量存储 | 更关注召回率,可接受较大的索引空间 |
| ivf-pq | IVF 加乘积量化压缩 | 更关注索引体积和查询资源消耗 |
| ivf-sq | IVF 加标量量化压缩 | 希望压缩向量存储,同时兼顾召回率与查询性能 |
| ivf-rq | IVF 加旋转残差量化压缩 | 高维向量检索,需在索引体积与召回率之间折中 |
EMR Serverless StarRocks 向量查询函数
在 EMR Serverless StarRocks 中,可以使用以下向量查询函数:
| 函数 | 排序方向 | 说明 |
|---|---|---|
| approx_l2_distance | ASC | L2 距离越小越相似 |
| approx_cosine_similarity | DESC | 余弦相似度越大越相似 |
| approx_inner_product | DESC | 内积越大越相似 |
使用时需要注意两点:
-
ANN 返回的是近似 Top-K 结果,不保证与全量计算并精确排序的结果完全一致。
-
索引的距离度量必须与 SQL 查询函数匹配。 例如,使用 cosine 度量构建的索引,应搭配 approx_cosine_similarity 函数查询。
BTree + Vector:先过滤业务范围,再执行语义检索
实际业务中的向量检索,通常还需要满足结构化条件。例如,商品搜索既要找到语义相近的结果,也要限定租户、商品品类和价格范围。
如果先执行 ANN,再过滤业务条件,召回的候选中可能有大量数据不符合要求,导致最终留下的结果不足预期。
BTree 与 Vector Global Index 可以配合使用:先通过 BTree 找到符合业务条件的候选 Row ID,再将这一集合用于向量检索的预过滤(ANN Pre-filter),限定检索范围。
具体流程如下:
-
BTree 根据租户、品类、价格等条件生成 Row ID Bitmap;
-
将 Bitmap 作为 ANN Pre-filter,传入 Vector Index;
-
Vector Index 在符合业务条件的候选范围内执行近似最近邻搜索;
-
返回候选 Row ID 和 Score;
-
读取候选数据,继续执行后续处理,生成最终 Top-K 结果。
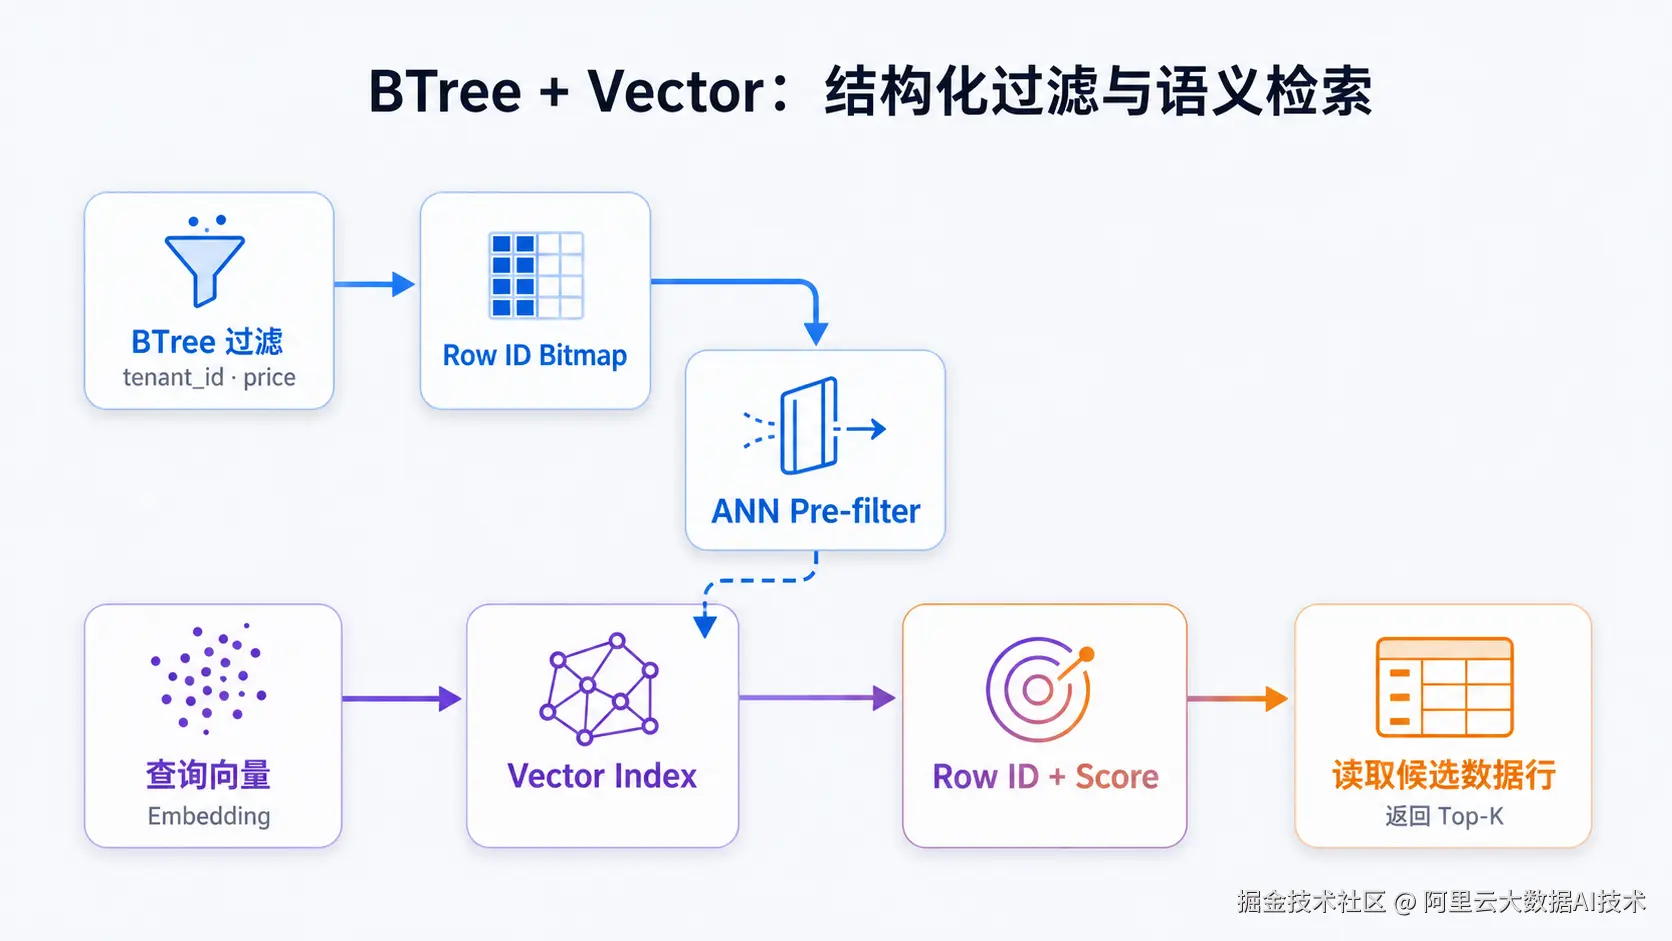
对用户而言,这仍然是一条普通 SQL,不需要显式编写索引操作。例如,下面的查询限定了租户、相机品类和价格范围,再按向量余弦相似度返回前 20 个商品:
plain
SELECT
    product_id,
    title,
    price,
    approx_cosine_similarity(
        CAST([0.12, -0.03, 0.27, 0.08] AS ARRAY<FLOAT>),
        embedding
    ) AS score
FROM paimon_dlf.demo.product_search
WHERE tenant_id = 1001
  AND category = 'camera'
  AND price >= 3000
  AND price < 8000
ORDER BY score DESC
LIMIT 20;
为便于展示,示例查询向量仅包含 4 个元素。实际使用时,查询向量的维度必须与 embedding 列及索引配置一致。
当业务过滤字段和向量字段上存在可用的对应索引,且索引完整覆盖查询所需的 Row ID 范围时,EMR Serverless StarRocks 优化器可以自动选择 BTree 与 Vector 联合检索路径,在同一条 SQL 中完成结构化过滤与语义检索。
EMR Serverless StarRocks 如何查询 Paimon Global Index?
EMR Serverless StarRocks 采用两阶段执行架构,将索引搜索与数据读取分开:第一阶段并行搜索索引,获得候选 Row ID;第二阶段根据这些 Row ID 读取对应数据,再完成后续计算。
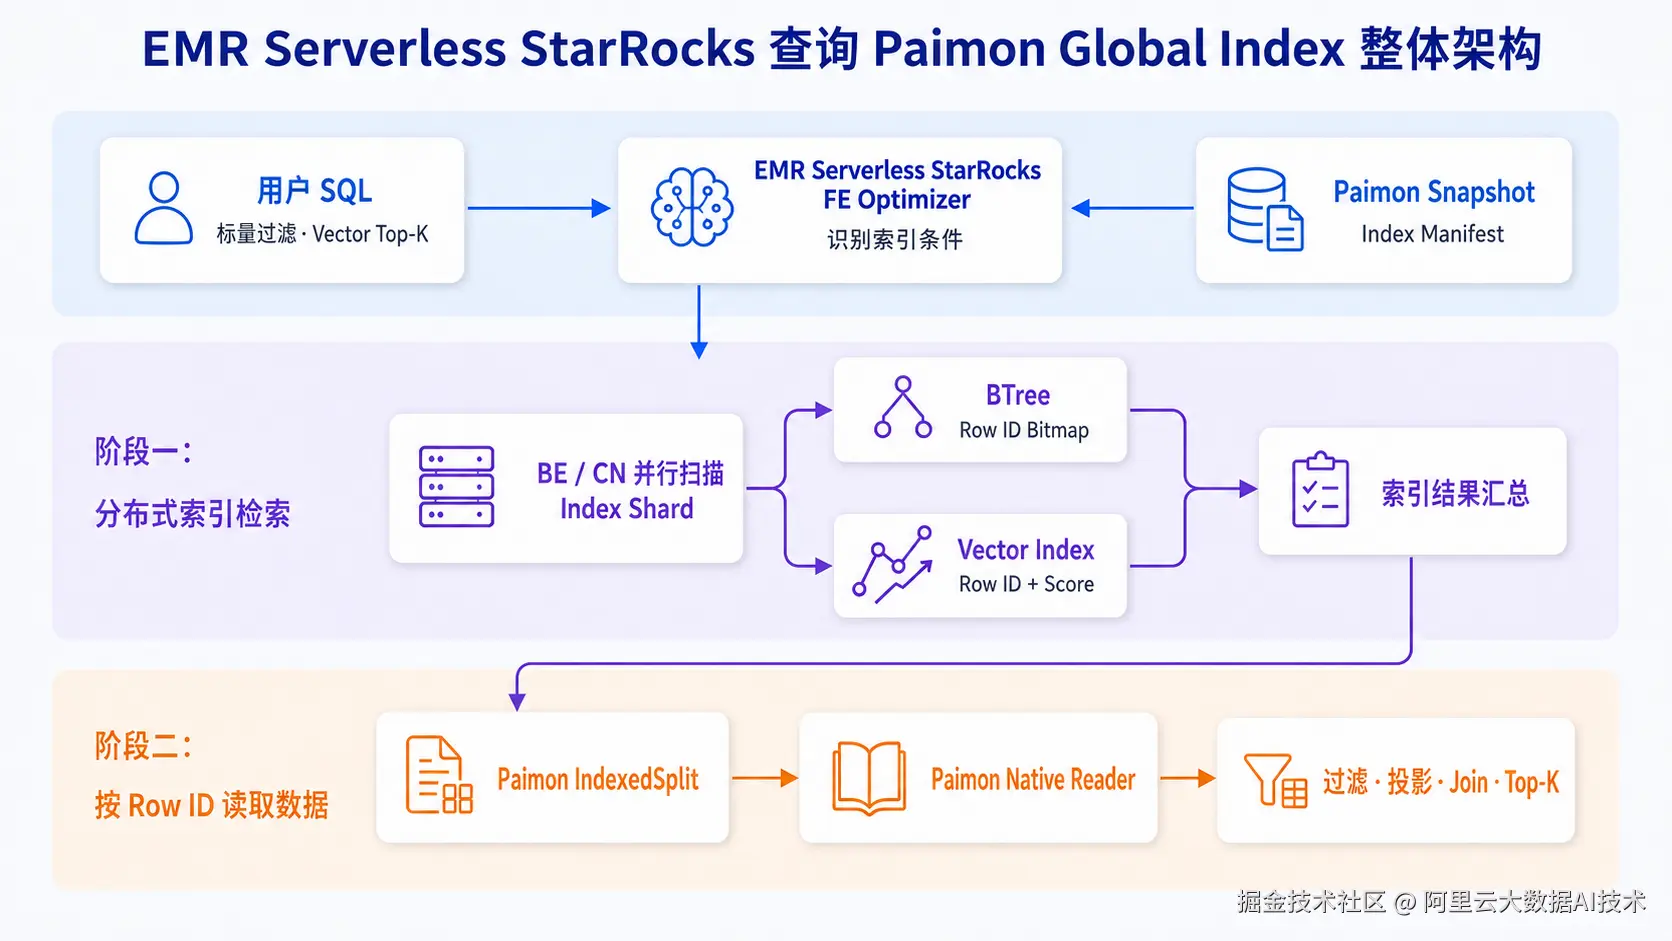
FE 识别索引条件
EMR Serverless StarRocks FE Optimizer 获取查询对应的 Paimon Snapshot 和 Index Manifest,判断哪些条件可以使用索引,并确定索引搜索范围,主要包括:
-
哪些过滤条件可以使用 BTree Index;
-
Top-K 表达式能否使用 Vector Index;
-
需要搜索哪些 Index Shard;
-
哪些 BTree 条件可以作为 ANN Pre-filter;
-
各个索引是否完整覆盖查询所需的 Row ID 范围。
索引搜索和数据读取基于同一个 Paimon Snapshot,保证两个阶段访问一致的数据版本。
第一阶段:分布式搜索 Index Shard
FE 将需要搜索的 Index Shard 分配给多个 BE 或 CN 并行执行:
-
BTree 返回命中的 Row ID Bitmap;
-
Vector Index 返回候选 Row ID 和 Score;
-
联合查询中,BTree Bitmap 可以作为 ANN Pre-filter。
随后,EMR Serverless StarRocks 汇总各个 Shard 的搜索结果。对于 BTree 查询,合并不同 Shard 返回的 Bitmap;对于向量查询,各 Shard 返回的是局部候选,需要进一步全局合并,形成供第二阶段使用的候选集。
第二阶段:按 Row ID 读取数据
EMR Serverless StarRocks 将汇总后的索引结果交给 Paimon。Paimon 根据 Row ID 与数据文件的覆盖范围生成 IndexedSplit,用于指导后续读取。
可以将 IndexedSplit 简单理解为:在原始 DataSplit 的基础上,增加需要读取的 Row Range,以及可选的向量 Score。
随后,Paimon Native Reader 根据指定范围读取候选数据,EMR Serverless StarRocks 再继续执行剩余过滤、投影、Join、聚合及最终 Top-K 等操作。
通过这一架构,索引搜索先缩小候选范围,数据读取阶段再获取所需的业务列,减少对未命中数据的读取。索引搜索与数据读取也可以分别进行扩展。
如何使用 EMR Serverless StarRocks 查询 Paimon Global Index
下面以商品语义搜索表为例,介绍从准备索引到执行查询的完整流程。
在 Paimon 侧准备表和索引
Paimon Global Index 面向无主键的 Append Table。表需要开启 Row Tracking 和 Data Evolution,并使用动态 Bucket。
以下建表及索引 SQL 在 Paimon 对应的 Spark 或 Flink 环境中执行:
plain
CREATE TABLE demo.product_search (
    product_id BIGINT,
    tenant_id  BIGINT,
    category   STRING,
    price      DOUBLE,
    title      STRING,
    embedding  ARRAY<FLOAT>
)
TBLPROPERTIES (
    'bucket' = '-1',
    'row-tracking.enabled' = 'true',
    'data-evolution.enabled' = 'true',
    'global-index.enabled' = 'true'
);
示例显式打开了 global-index.enabled,以完整展示表配置。
接下来,为租户、品类和价格字段分别创建 BTree Global Index:
plain
CALL sys.create_global_index(
    table => 'demo.product_search',
    index_column => 'tenant_id',
    index_type => 'btree'
);

CALL sys.create_global_index(
    table => 'demo.product_search',
    index_column => 'category',
    index_type => 'btree'
);

CALL sys.create_global_index(
    table => 'demo.product_search',
    index_column => 'price',
    index_type => 'btree'
);
为向量字段创建 IVF-PQ Global Index:
plain
CALL sys.create_global_index(
    table => 'demo.product_search',
    index_column => 'embedding',
    index_type => 'ivf-pq',
    options =>
      'ivf-pq.dimension=768,
       ivf-pq.distance.metric=cosine,
       ivf-pq.nlist=256,
       ivf-pq.pq.m=16'
);
主要参数说明:
-
dimension:向量维度,必须与实际 Embedding 维度一致; -
distance.metric:距离度量,必须与查询函数匹配; -
nlist:IVF 的聚类数量; -
pq.m:PQ 的分段数量,向量维度需要能被该值整除。
索引的创建和增量维护由 Paimon 侧负责,EMR Serverless StarRocks 负责发现并使用已有索引。
在 EMR Serverless StarRocks 中创建 DLF REST Catalog
集群绑定具备 DLF 权限的 RAM 用户后,可通过平台提供的身份注入访问 DLF,无需在 Catalog 中填写 AccessKey ID 和 AccessKey Secret。
plain
CREATE EXTERNAL CATALOG paimon_dlf
PROPERTIES (
    "type" = "paimon",
    "paimon.catalog.type" = "rest",
    "uri" = "https://cn-hangzhou-vpc.dlf.aliyuncs.com",
    "paimon.catalog.warehouse" = "<dlf_catalog_name>",
    "token.provider" = "dlf"
);
配置时需要注意:
-
uri需要替换为 DLF 所在地域的实际 REST 地址; -
paimon.catalog.warehouse表示 DLF Catalog 实例名称,不是 OSS 或 HDFS 路径;
启用两阶段 Global Index 查询
目标版本默认采用两阶段查询路径,也可以在当前会话中显式设置:
plain
SET paimon_global_index_scan_stage = 2;该变量的主要取值为:
| 值 | 含义 |
|---|---|
| 0 | 不使用 Global Index,执行普通数据扫描 |
| 1 | 使用 Paimon SDK 单阶段查询路径 |
| 2 | 使用 EMR Serverless StarRocks BE 分布式两阶段查询路径 |
查询 BTree Global Index
下面的查询筛选租户 1001 下价格在 [3000, 8000) 范围内的商品:
plain
SELECT
    product_id,
    title,
    category,
    price
FROM paimon_dlf.demo.product_search
WHERE tenant_id = 1001
  AND price >= 3000
  AND price < 8000;
用户只需编写普通 SQL。优化器识别到 tenant_id 和 price 上可用的 BTree Global Index 后,可以对两个索引返回的 Row ID Bitmap 求交集,再读取对应数据。
查询 IVF Vector Global Index
使用 ivf-flat 或 ivf-pq 时,需要启用对应的 Vector Index 查询改写:
plain
SET enable_paimon_vector_index = true;还可以通过 ann_params 调整 IVF 的搜索范围:
plain
SET ann_params = '{"ivf.nprobe":"32"}';下面的查询按余弦相似度返回前 20 个商品:
plain
SELECT
    product_id,
    title,
    category,
    price,
    approx_cosine_similarity(
        CAST([0.12, -0.03, 0.27, 0.08] AS ARRAY<FLOAT>),
        embedding
    ) AS score
FROM paimon_dlf.demo.product_search
ORDER BY score DESC
LIMIT 20;
示例中的 4 维向量仅用于展示 SQL 写法。前文创建的是 768 维索引,实际执行时,需要将其替换为对应的 768 维查询向量。
使用向量索引时,查询需满足以下条件:
-
查询向量为常量
ARRAY<FLOAT>; -
查询向量维度与索引一致;
-
查询函数与索引的距离度量一致;
-
只有一个向量排序表达式;
-
包含
LIMIT; -
L2 距离使用升序,Cosine 和 Inner Product 使用降序。
如需同时限定租户、品类和价格范围,可以使用第四节中的联合查询 SQL,由优化器判断是否采用 BTree 与 Vector 联合检索路径。
总结
分区裁剪和文件级统计帮助查询跳过不相关的文件,Paimon Global Index 则通过 Row ID 进一步缩小候选数据范围,让 EMR Serverless StarRocks 能够先搜索索引,再读取对应数据。
其中,BTree Global Index 适合点查、IN 查询和窄范围过滤等高选择性查询;Vector Global Index 面向 RAG、商品语义搜索、图片检索和推荐召回等场景。两者结合,可以先限定租户、品类、价格等业务范围,再执行向量检索。
通过两阶段执行架构,EMR Serverless StarRocks 先在多个 BE 或 CN 上并行搜索 Paimon 索引分片,获得候选 Row ID 及可选的 Score;再由 Paimon 生成 IndexedSplit,通过 Paimon Native Reader 读取候选数据。
对用户而言,查询方式依然是普通 SQL,可以在同一张 Paimon 表中完成结构化过滤、语义检索,并衔接后续的 Join、聚合和 Top-K 等操作。
关于 EMR Serverless StarRocks
阿里云 EMR Serverless StarRocks 是面向实时数仓与湖仓分析的全托管服务,Stella 是其企业级内核。围绕企业在开放数据湖上的查询需求,Stella 持续优化存算分离架构、数据读取、缓存与查询执行,让保留在湖中的数据可以直接用于交互式查询、多表关联与业务分析。随着湖中的数据类型与使用方式不断扩展,Stella 也在将湖上分析能力进一步延伸到多模态检索与 AI 数据准备。