【上期回顾】
上一篇讲了蒙特卡洛控制:不用环境模型,照策略跑回合,把回报取平均来估 Q,再在每个状态挑 Q 大的动作,评估和改进轮流做。
为了让每个动作都有机会被试到,用了两种探索办法:探索性启动和 ε-贪心。最后也看到了探索的代价:走廊里一路向右的 ε-贪心策略,ε = 0.1 时 s2 的价值只有 7.63,比最优的 8 低。
要探索,策略就得带点随机;可我们想学的,往往是不带随机的最优策略。这一篇讲怎样把这两件事分开。
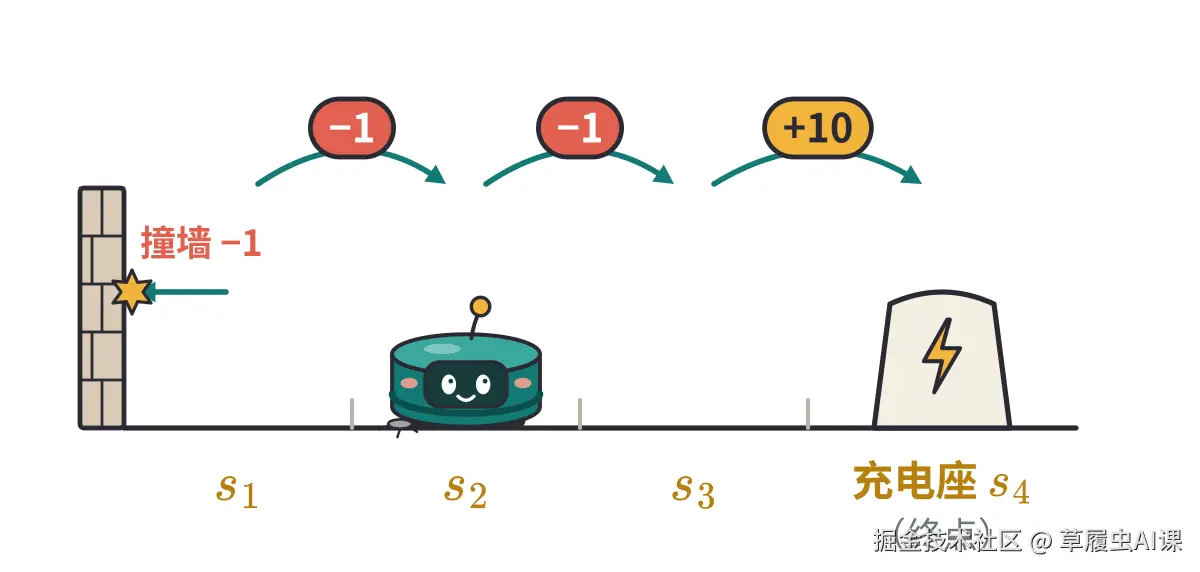
▲ 图 1 本篇例子:走廊里的扫地机器人(规则同前几篇)
【设定】走廊的规则(小扫不知道)
- 状态 :三个格子 s1,s2,s3,加上充电座 s4。进了充电座,这一回合就结束。
- 动作 :往左 ←、往右 →,结果是确定的;在 s1 按 ← 会撞墙,原地不动。
- 奖励:每走一步 −1,撞墙那一步也一样;走进充电座的那一步 +10。
- 折扣因子 : γ=0.9。
- 策略 B :每个状态都随便走,往左、往右各一半。一路向右:每个状态都往右,也就是最优策略。
- ε-贪心 :以 1−ε 的概率选 Q 最大的动作,以 ε 的概率在两个动作里随便选一个(第 05 篇讲过)。
这些规则是写给读者看的。小扫并不知道,它只能做一个动作,再看到自己到了哪、得了几分。
【说法对照】漫画说大白话,正文用正式说法
- 说明书 = 环境模型 ;账本 = 价值 V、 Q;手册 = 策略 π;"跑一趟" = 一个回合;
- 本篇新增:探路手册 = 行为策略 b;正式手册 = 目标策略 π;录像 = 跑出来的回合数据。
正文、例题和插图都用正式说法,漫画里还是老样子。
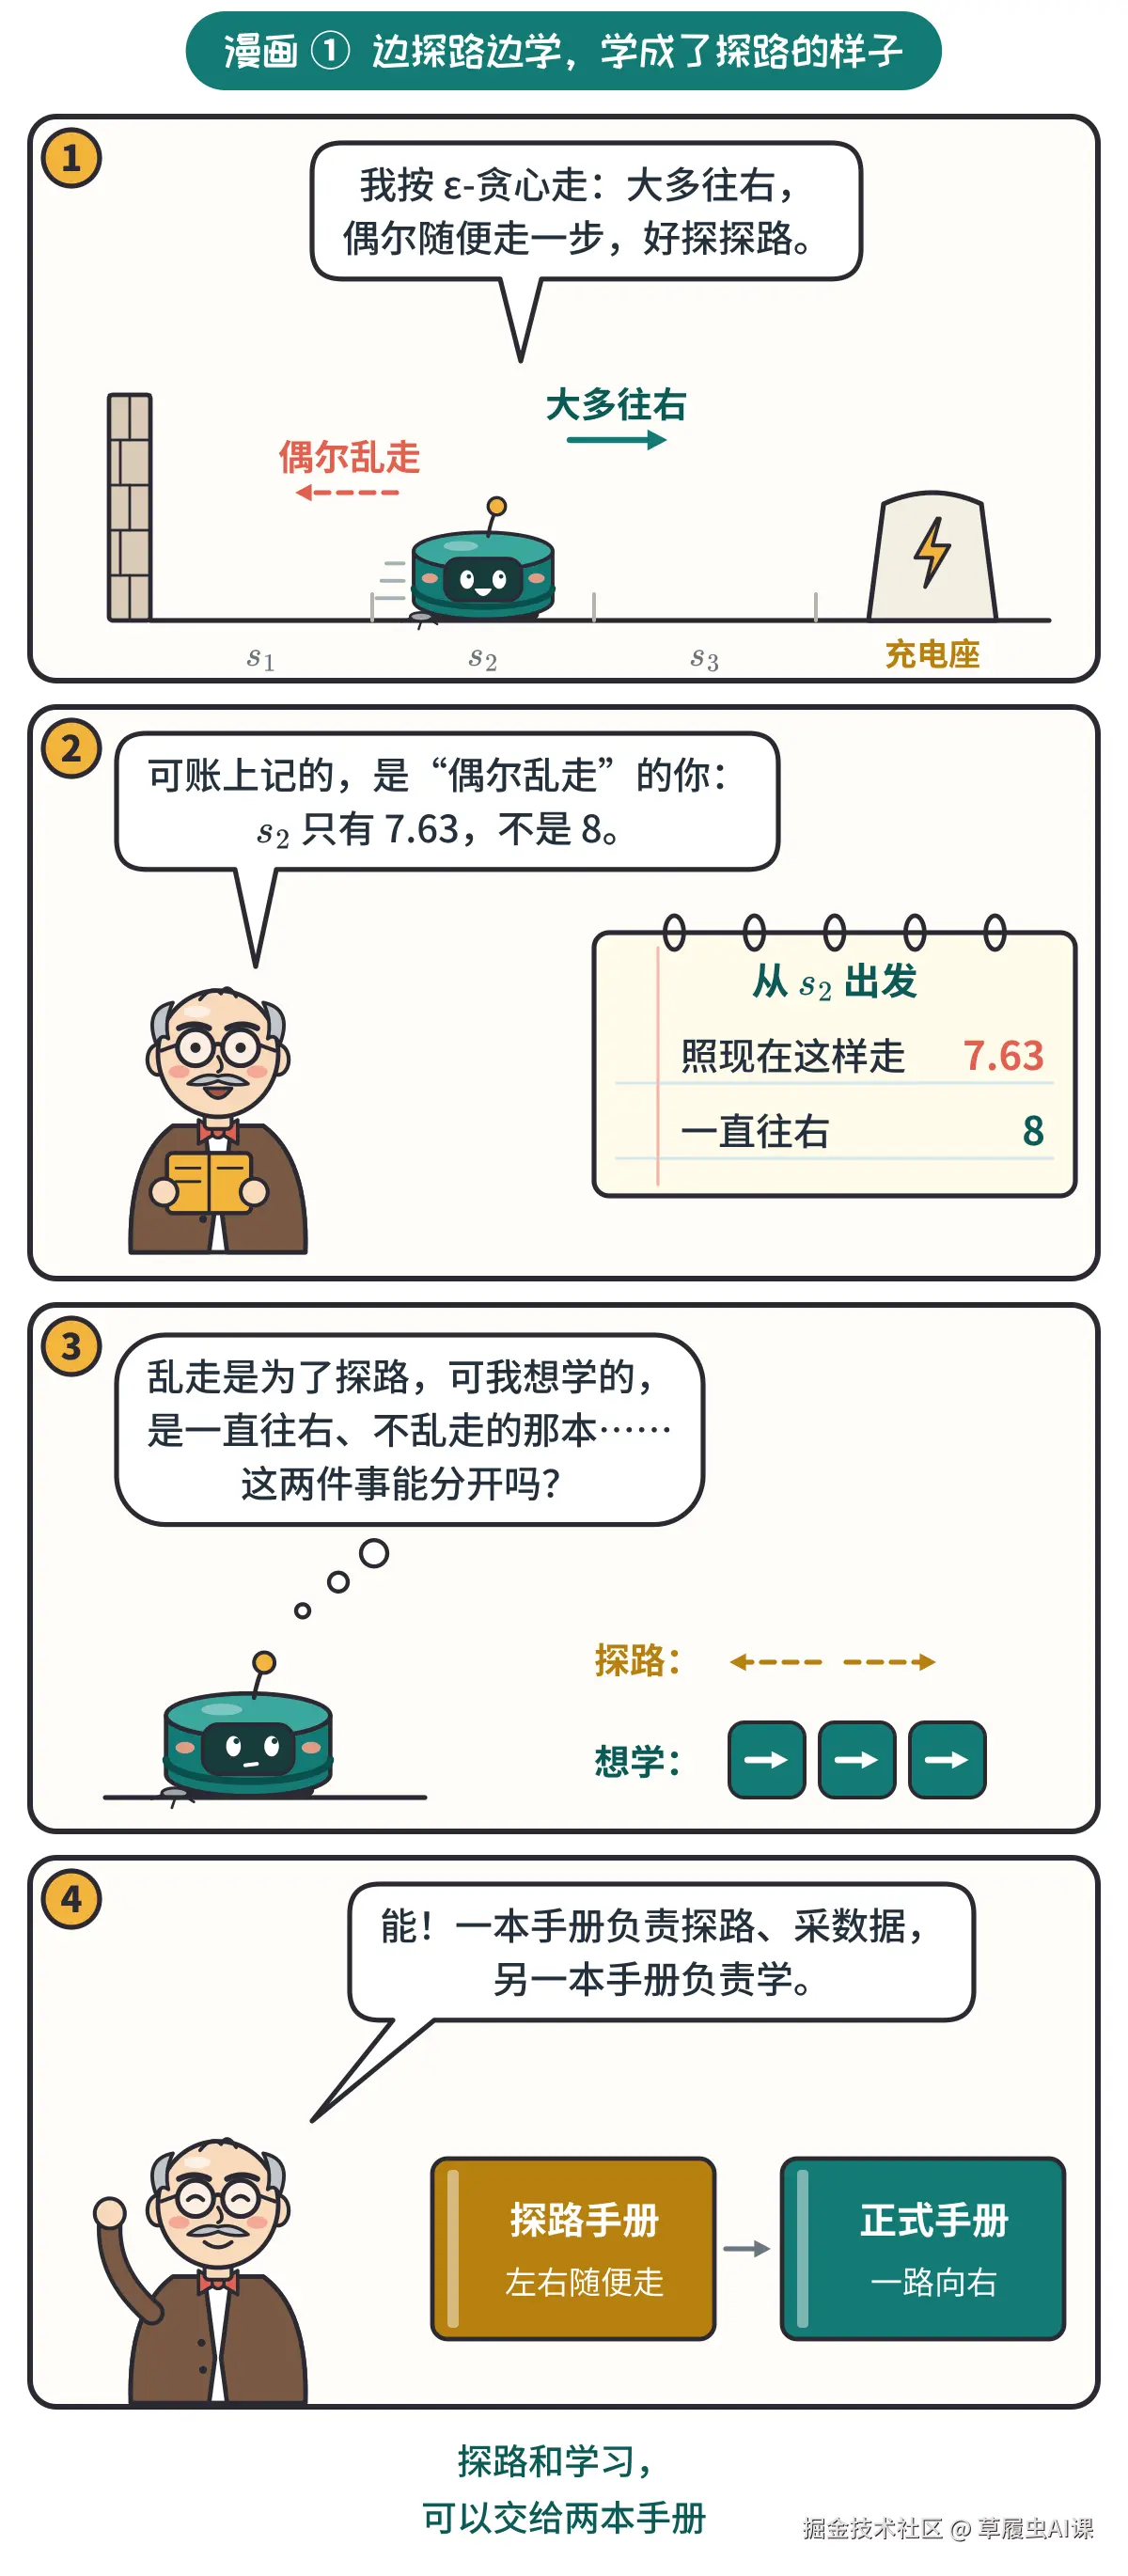
▲ 图 2 漫画 ① 边探路边学,学成了探路的样子
一、探索与利用
上一篇为了让每个动作都被试到,专门加了探索。探索为什么少不了?先离开走廊,看一个更简单的问题。
【设定】两台老虎机
- 面前有两台老虎机,每次只能拉一台,拉一下得几分就是这一次的奖励。
- A :得 0 分或 2 分,各一半,平均 1 分。B:得 0 分或 4 分,各一半,平均 2 分。
- 每台都照上一篇的办法记账:拉过的得分取平均,记作 Q(A)、 Q(B)。没拉过的先记 0(上一篇的初始值)。
两台的平均是写给读者看的,玩的人并不知道,只能拉一下、看得几分。
这个问题拉一下就结束,没有状态,只有两个动作可选,叫多臂老虎机(multi-armed bandit)问题。老虎机的英文俗称"独臂强盗"(one-armed bandit),好几台摆成一排,就成了"多臂"。
每次拉杆前都要做选择:利用 (exploitation),拉现在平均最高的那台,多拿点分;或者探索(exploration),去拉另一台,弄清它到底怎么样。只利用会怎样?
【例 1】只贪心,被困在 A 上
每次都拉 Q 大的那台,两台一样大时随便挑一台。下图是一回实际的结果:
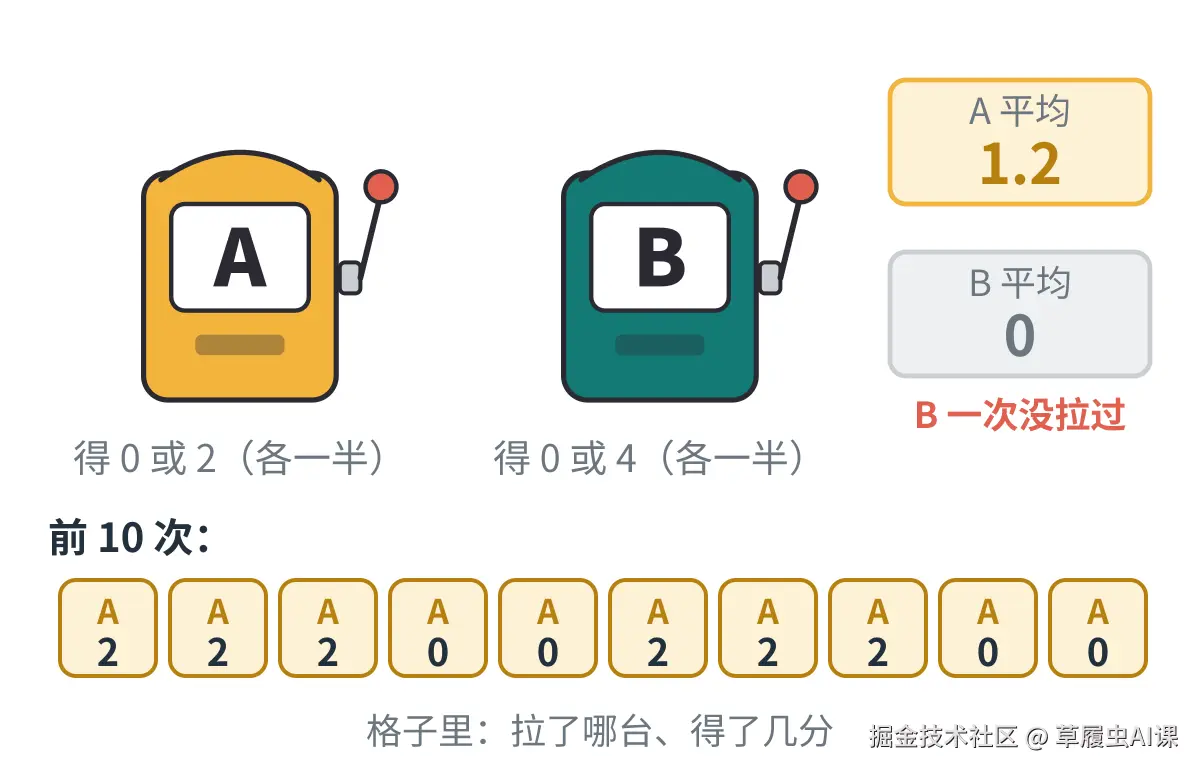
▲ 图 3 例 1 图解:只贪心拉了 10 次,全是 A
第 1 次两台都是 0,随便挑了 A,得 2 分: Q(A)=2, Q(B) 还是 0。
之后 A 有时得 2、有时得 0,平均在 1.2 到 2 之间晃,但永远大于 0:A 最少得 0 分,第一次又得了 2,平均掉不到 0。所以每次比较都是 A 大,一直拉 A,B 一次都没试过。10 次共得 12 分。
其实 B 平均 2 分,是 A 的两倍。只贪心永远发现不了,长期每次只能拿 1 分左右。这和上一篇例 6 是同一个毛病:试得少的动作估不准,估低了就再也不去试。
办法是留出探索。上一篇的 ε-贪心是一种:以 ε 的概率随便拉一台。还有一种办法,在开局就动手脚:
【例 2】乐观初始值
开局先替每台机器记一笔 5 分,比两台真实的平均都高;之后照样只贪心。每台的平均这样算:
Q=n+15+r1+⋯+rn
r1,...,rn 是这台拉过的得分, n 是拉的次数。下面这一回,前两次和例 1 一样倒霉:A 得 2,B 得 0。表里每一列是一次拉杆:
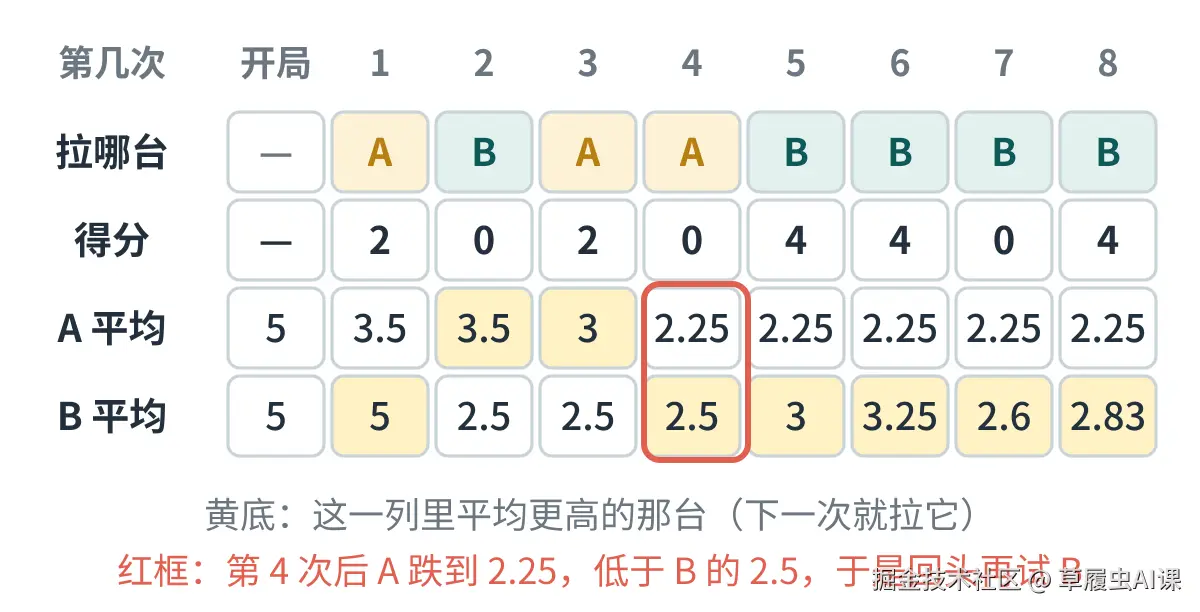
▲ 图 4 例 2 图解:开局各记 5 分,只贪心拉 8 次
第 1 次两台都是 5,随便挑了 A,得 2: Q(A)=(5+2)÷2=3.5,比 B 的 5 低,所以第 2 次去拉 B。B 得 0: Q(B)=(5+0)÷2=2.5。
第 3、4 次拉 A,得 2 和 0: Q(A)=(5+2+2+0)÷4=2.25,跌到 B 的 2.5 下面(红框),第 5 次就回头再试 B。这回 B 连得两个 4: Q(B)=(5+0+4+4)÷4=3.25,从此 B 一直领先。
道理是:开局记的 5 分比谁都高,没试够的那台总显得"还不错",迟早会被再试一次;试得越多,那笔 5 分的影响越小,平均才慢慢接近真实值。
【要点】初始值也能用来探索
上一篇说过, Q 表要先填初始值。初始值填得乐观,本身就是一种探索办法,叫乐观初始值(optimistic initial values)。
例 2 把初始值当成"已经记过的一笔",所以第一次拉完不会被整个换掉。如果像上一篇那样,第一次的得分直接把初始值换掉,乐观初始值只能保证每台至少被试一次:B 第一次碰巧得 0,就会像例 1 一样被困住。
到这里,前面几篇出现过的探索办法可以放在一起看:
| 办法 | 怎么做 | 出现在 |
|---|---|---|
| 探索性启动 | 每个回合随机挑起点和第一个动作 | 第 05 篇 |
| ε-贪心 | 以 ε 的概率随便选一个动作 | 第 05 篇 |
| UCB | 给试得少的动作加"照顾分" | 第 03 篇 |
| 乐观初始值 | 开局把 Q 填得比谁都高 | 本篇例 2 |
附一的代码让三种做法各玩 2000 回、每回拉 1000 下:只贪心平均每下 1.51 分,有 49% 的时候大部分都在拉 A,33% 的时候 B 一次都没拉过;ε-贪心(ε = 0.1)每下 1.92 分;乐观初始值每下 1.95 分。一直拉 B 是 2 分。
【注意】探索都有代价
探索时拉到差的那台、走到差的那一步,都会少拿分。ε-贪心永远留着 ε 的随机性:上一篇算过,走廊里一路向右的 ε-贪心,ε = 0.1 时 V(s2)=7.63,比最优的 8 低。
这就引出了本篇的主题:既要探索,又想学到不带探索的最优策略,能不能两全?
【档案】1952 Herbert Robbins(罗宾斯)
美国 · 北卡罗来纳大学教堂山分校
在论文《试验序贯设计的若干问题》里提出了两臂老虎机问题:两种做法各有未知的平均收益,每次只能选一种来试,怎样边试边选,让长期的总收益最大。论文最早是他 1951 年 11 月在美国数学会一次会议上做的报告,次年发表在《美国数学会通报》上。
二、行为策略与目标策略
回到走廊。学习时其实有两个角色:
- 行为策略 (behavior policy),记作 b:真正和环境打交道、跑出回合数据的那个策略。
- 目标策略 (target policy),记作 π:要评估、要改进、最后拿去用的那个策略。
两者是同一个策略( b=π),叫同策略 (on-policy);两者不是同一个( b=π),叫异策略(off-policy)。也有资料译作"在轨 / 离轨策略"。本系列统一叫同策略、异策略,不叫"在线 / 离线策略",因为"在线 / 离线"说的是另一回事,后面讲到它时再细说。
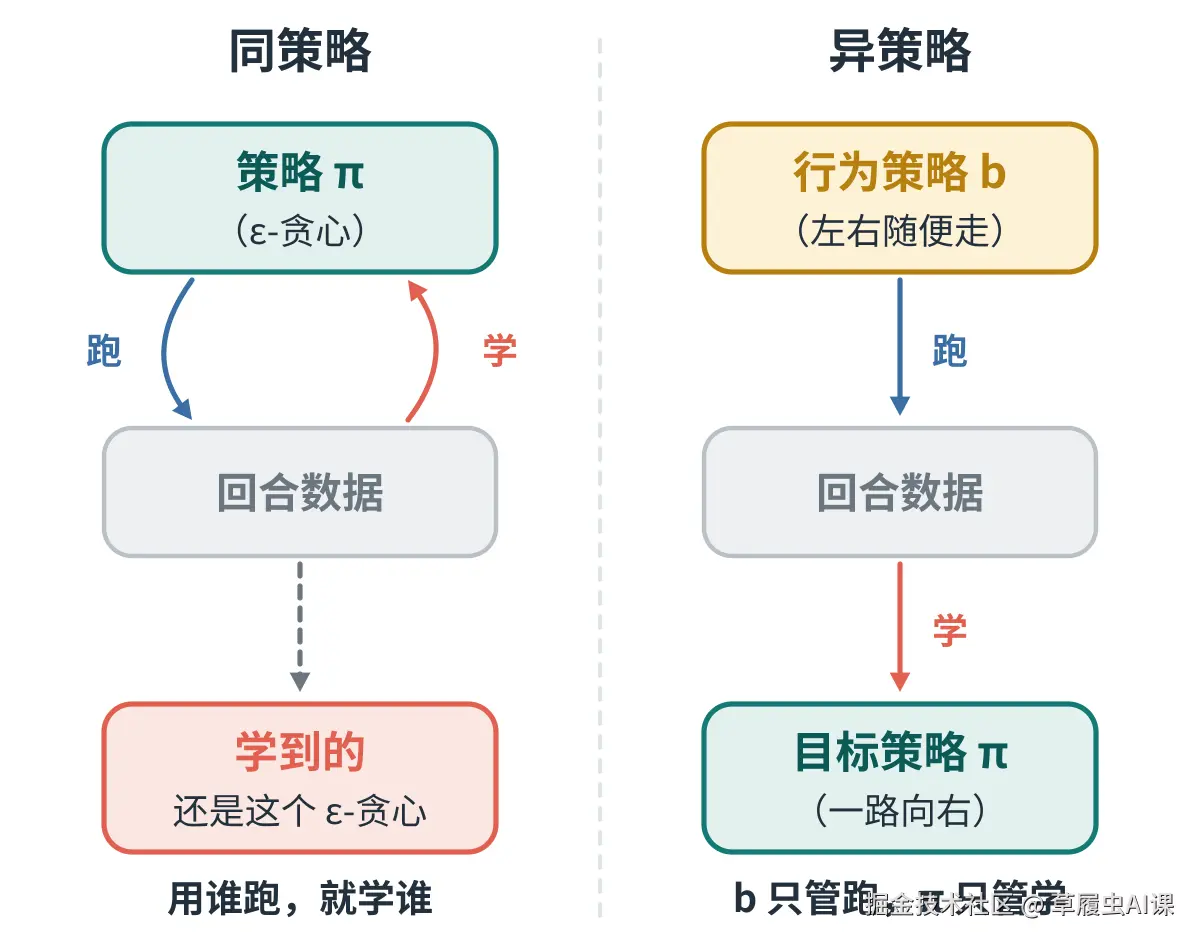
▲ 图 5 同策略:用谁跑,就学谁;异策略:b 只管跑,π 只管学
上一篇的两种蒙特卡洛控制属于哪一种?ε-贪心那种,用 ε-贪心去跑,学到的也是这个 ε-贪心,是同策略。探索性启动那种,第一步是随机挑的,之后照当前策略走,学的也是当前策略本身,同样算同策略。
【例 3】走廊里的两种安排
同样想学会在走廊里怎么走,可以这样安排:
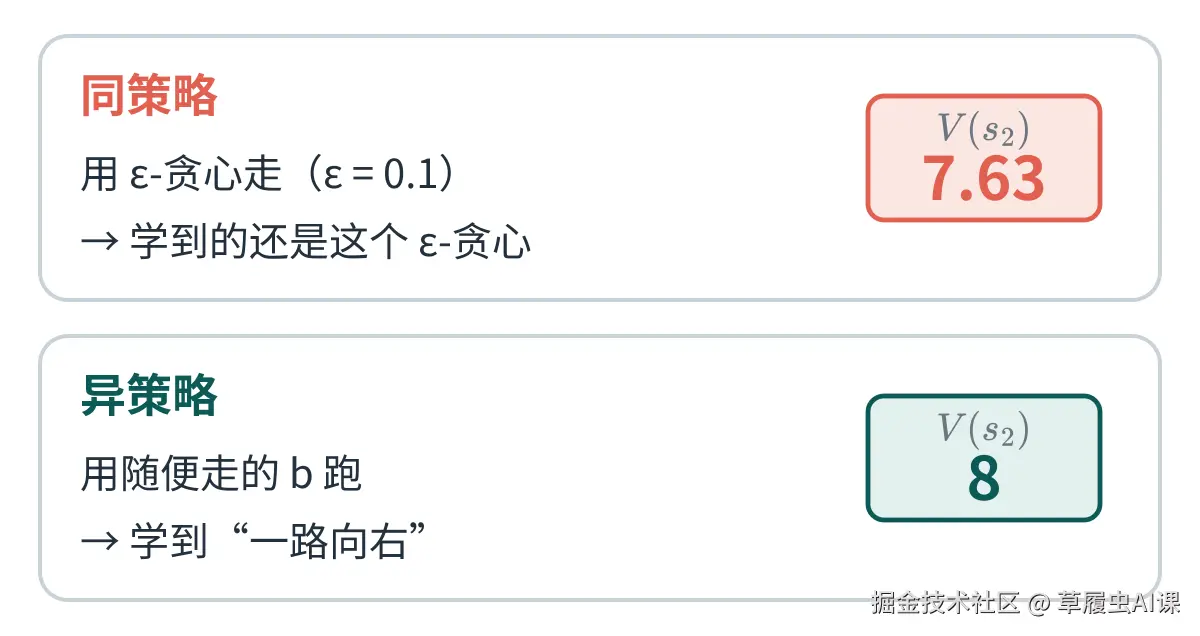
▲ 图 6 例 3 图解:同一个走廊,两种安排
- 同策略 :用 ε = 0.1 的 ε-贪心跑数据,学到的就是这个 ε-贪心。它在 s2 的价值是 7.63(上一篇算过)。
- 异策略 :用策略 B(随便走)当行为策略跑数据,目标策略是一路向右, s2 的价值是 8。
同样从 s2 出发,异策略最后学到的策略多出 0.37。差在哪,下一节细说。
三、同策略的两个麻烦
学到的策略带着探索
同策略里,跑的和学的是同一个。为了探索,它必须留着随机性,学到的策略也就带着随机性。
读者可能会想:学完以后把随机性去掉,每个状态只挑 Q 最大的动作,不就是一个确定的策略了吗?在走廊里,这样做确实行得通。把 ε = 0.1 时同策略学到的 Q 和最优的 Q∗ 放在一起看:
| s1 ← / → | s2 ← / → | s3 ← / → | |
|---|---|---|---|
| ε-贪心的 Q | 4.21 / 5.87 | 4.21 / 7.81 | 5.87 / 10 |
| 最优的 Q∗ | 4.58 / 6.2 | 4.58 / 8 | 6.2 / 10 |
每个数都偏低一点,但每个状态里两个动作谁大谁小没变,去掉随机性后得到的正好是一路向右。实际中也常这样用:训练时带着随机,用的时候只挑最好的动作。
不过这样学到的分数,回答的是"以后还会偶尔乱走,这时哪个动作好",有两个问题:
- 分数偏低 :去掉随机性后,策略是最优的了,手里记的却还是带乱走时的分( s2 往右是 7.81,不是 8)。后面拿这些分数去比较、去改进,就一直是偏的。
- 有时会挑错动作:要是乱走一步的代价特别大,比如路边就是悬崖,带乱走的分会让"离危险远一点"的动作显得更好,于是学成绕远路;这时去掉随机性,得到的还是那条远路,不是最优路线。走廊里乱走的代价不大,所以看不出来。后面讲到 Sarsa 和 Q-learning 时,会用一个例子细讲。
另一种想法是:先多探索,后面把 ε 慢慢调小,行不行?
【例 4】把 ε 调小,还差多少
一路向右的 ε-贪心在 s2 的价值,随 ε 变小是这样的(用第 2 篇的贝尔曼方程,按 ε-贪心策略解出来):
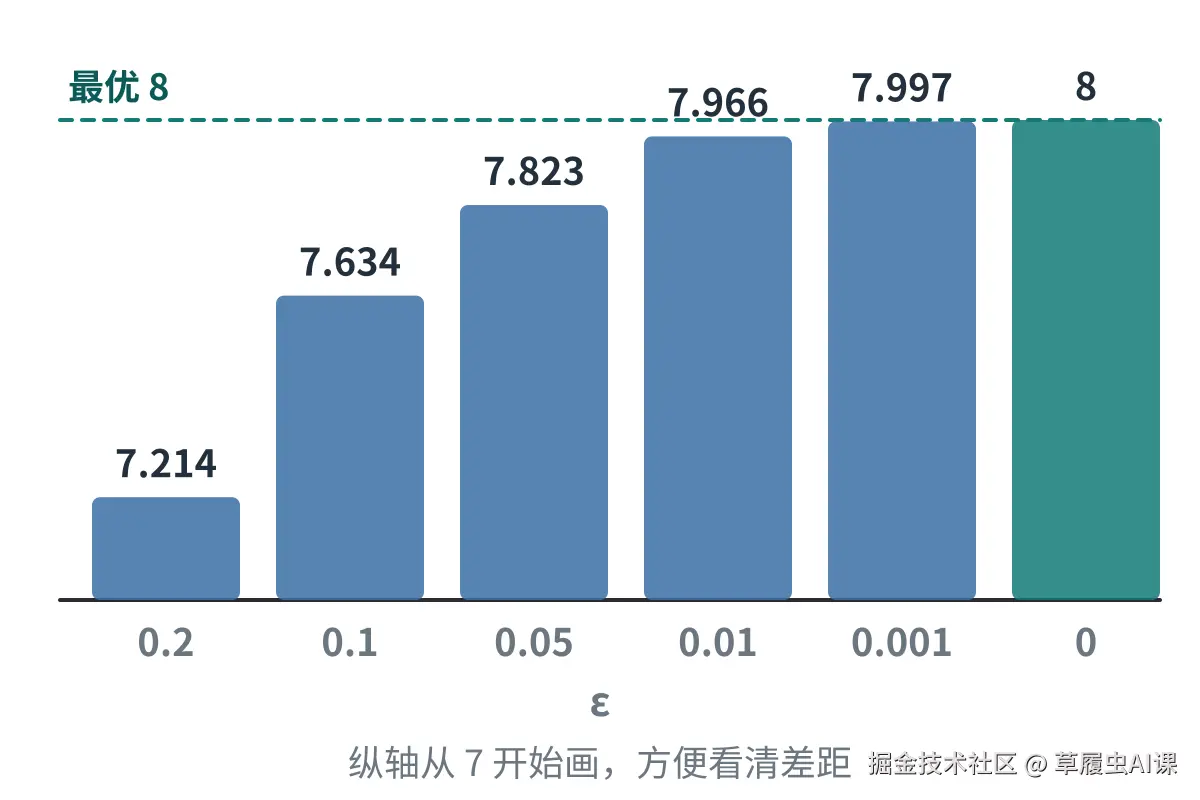
▲ 图 7 例 4 图解:ε 越小,越接近最优的 8
ε = 0.01 时是 7.966,ε = 0.001 时是 7.997,越来越接近 8;但只要 ε 不是 0,就总差一点。
理论上,让 ε 随训练慢慢降到 0,最后能学到最优策略。可实际训练只跑有限步:降得太快,像上一篇例 6 那样,没试够的动作估低了,就再也改不过来;降得太慢,学到的一直带着探索。什么时候降、降多快,都得人来定。
数据用一次就得扔
同策略的另一个麻烦更费钱:策略一改,以前跑的回合就不能接着用了。
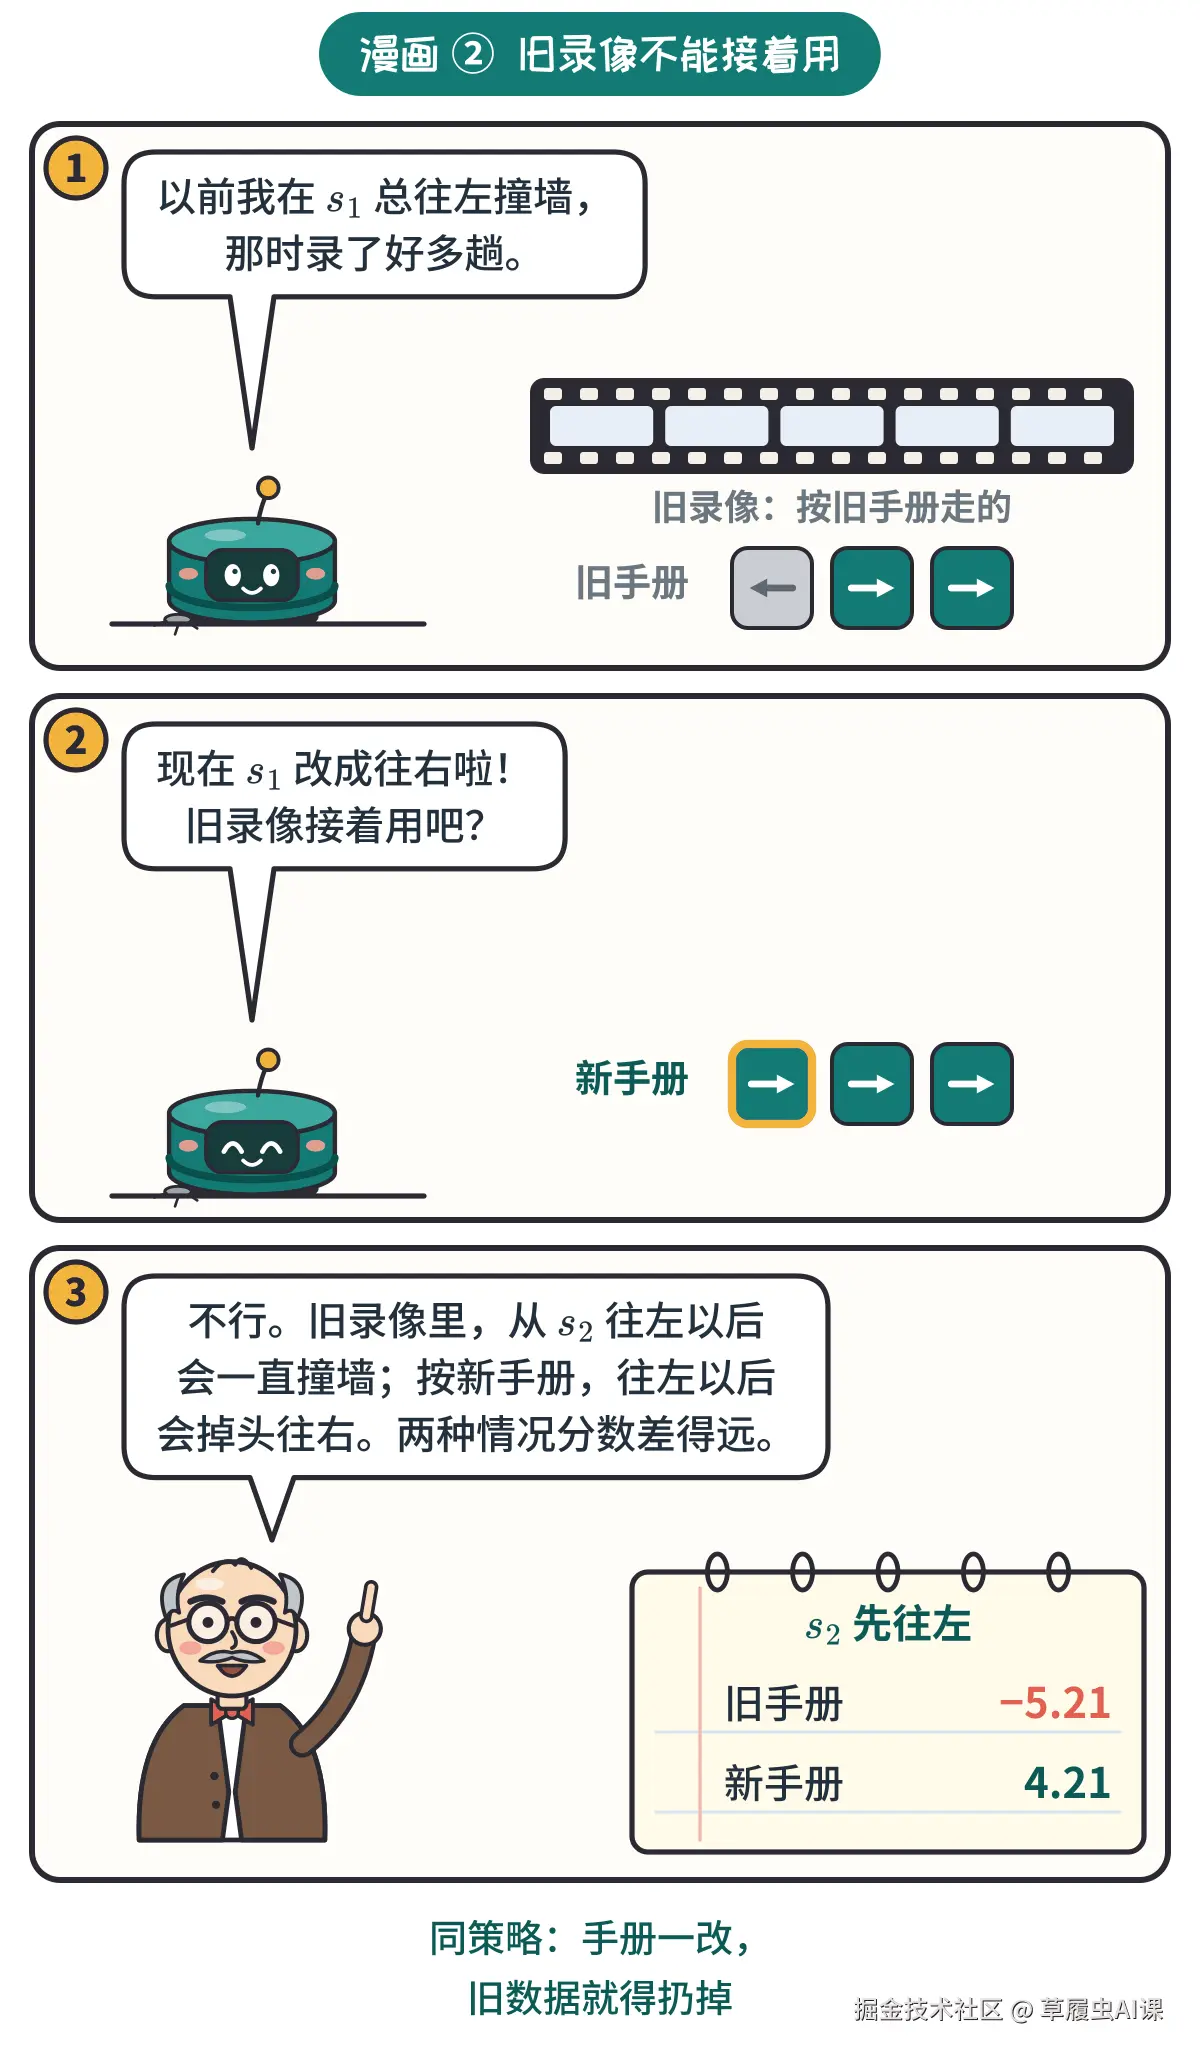
▲ 图 8 漫画 ② 旧录像不能接着用
原因是:旧回合是按旧策略走出来的,它的回报反映的是旧策略的价值;可现在要估的,是新策略的价值。
【例 5】旧数据为什么不能用
小扫原来在 s1 学错了,往左撞墙(上一篇只贪心的情形), s2、 s3 往右,三处都按 ε = 0.1 做 ε-贪心。后来 s1 改成往右。改正前后,同一个 (s,a) 的真值是:
| (s,a) | 改正前 | 改正后 |
|---|---|---|
| (s2,←) | −5.21 | 4.21 |
| (s1,→) | 5.43 | 5.87 |
| (s2,→) | 7.79 | 7.81 |
(s2,←) 变化最大:往左走到 s1 以后,改正前会一直撞墙,改正后会掉头往右。
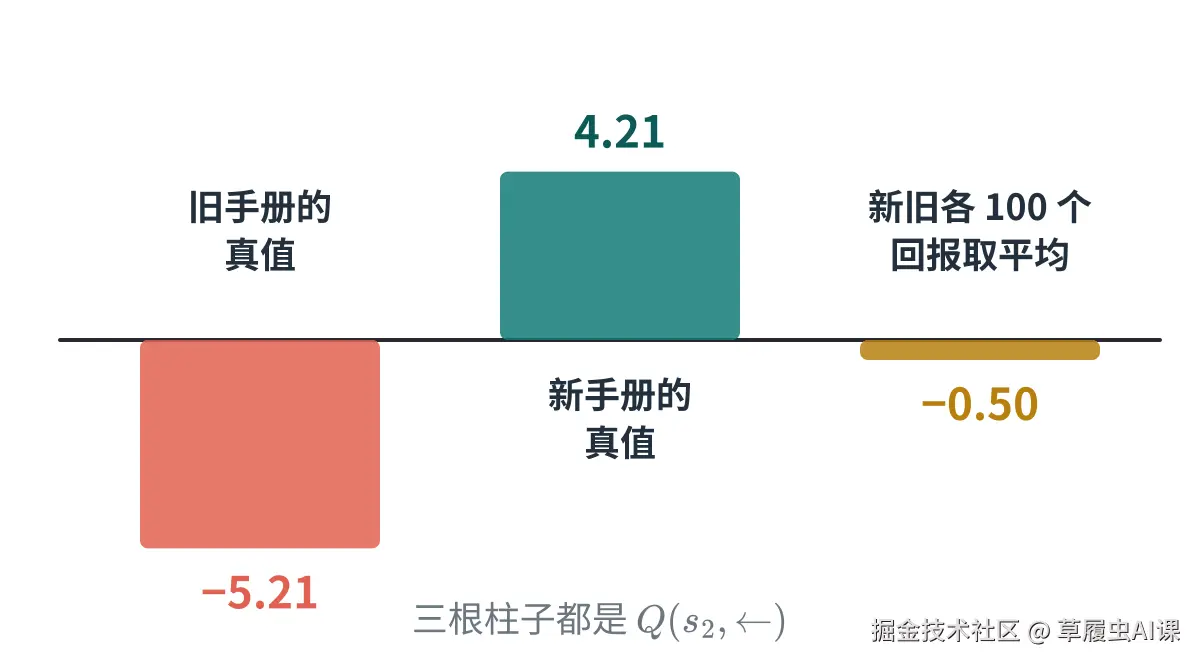
▲ 图 9 例 5 图解:旧回报混进来,Q(s₂,←) 被拉低
假设旧回合、新回合里各有 100 个 (s2,←) 的回报,平均分别是两边的真值,混在一起取平均: (−5.21×100+4.21×100)÷200=−0.50,离新策略的真值 4.21 差了 4.71。
所以同策略只能把旧回合扔掉,按新策略重新跑。
在真实机器人、医疗、金融这类试一次就很贵的场景,"策略改一次,就扔一批数据"非常浪费。
四、异策略:两本手册分开
异策略把"跑"和"学"交给两个策略,正好对上同策略的两个麻烦:
- 探索和利用分开:行为策略只管探索,可以随便走,保证什么都试过;目标策略只管利用,可以完全贪心,学到的就是不带探索的最优策略。例 3 里异策略能学到 8,就是这个原因。
- 数据可以反复用:数据是行为策略跑出来的,目标策略怎么改,都不影响这批数据本身。
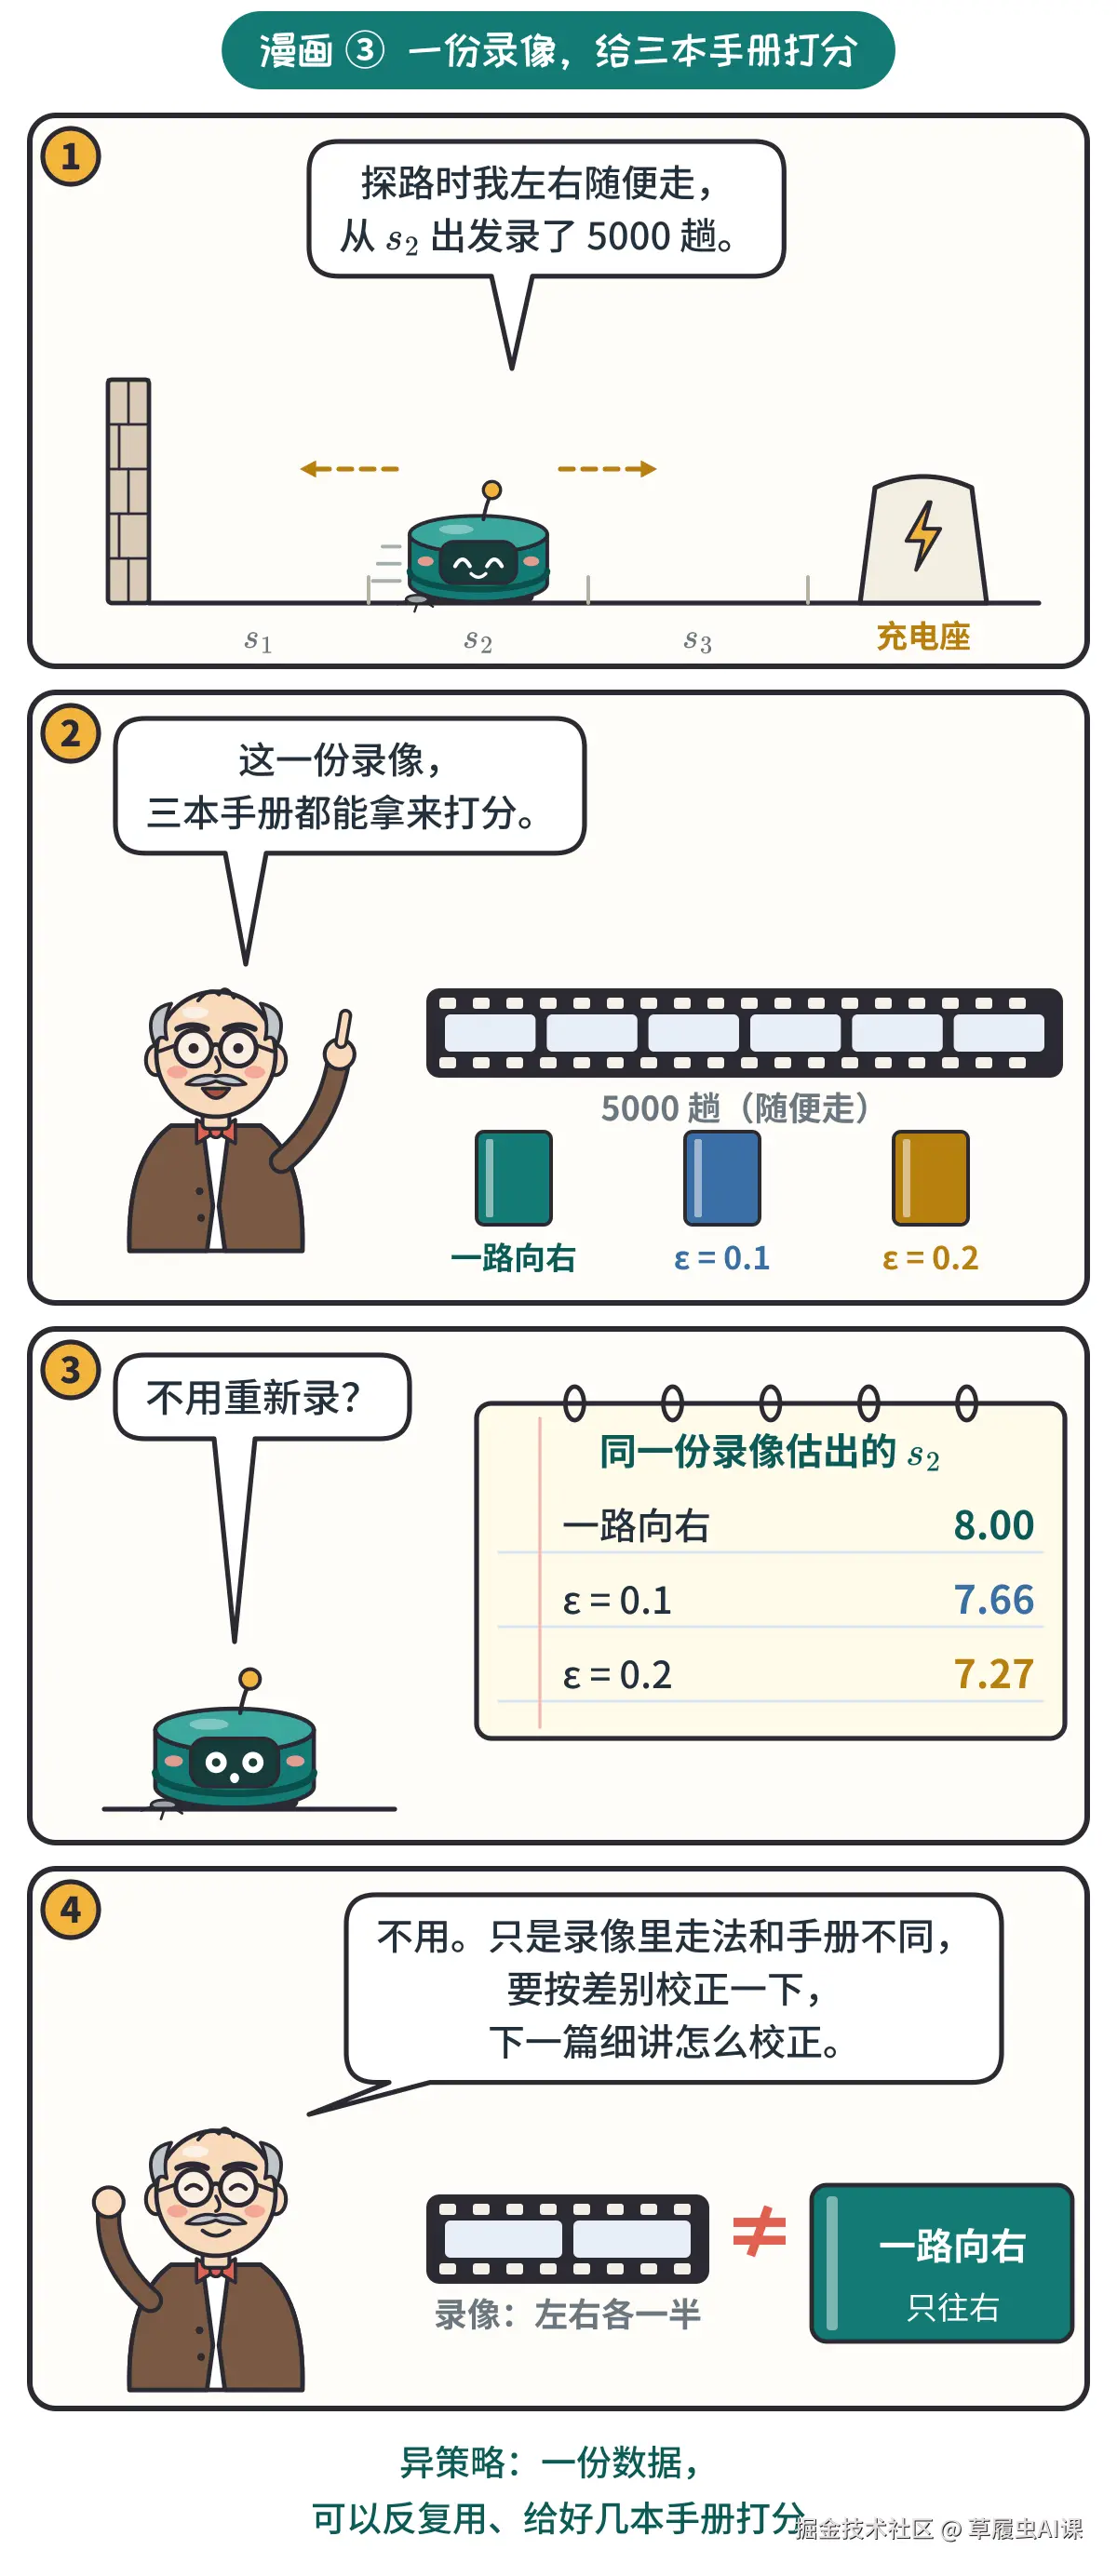
▲ 图 10 漫画 ③ 一份录像,给三本手册打分
只要把"录像里的走法和目标策略不同"这一点校正掉,同一批数据就能反复用,甚至可以同时给好几个目标策略打分。
【例 6】一批数据,评估三个策略
让小扫按策略 B(左右各一半)从 s2 出发跑 5000 个回合,存起来。之后不再跑,只用这一批数据,估三个目标策略在 s2 的价值:
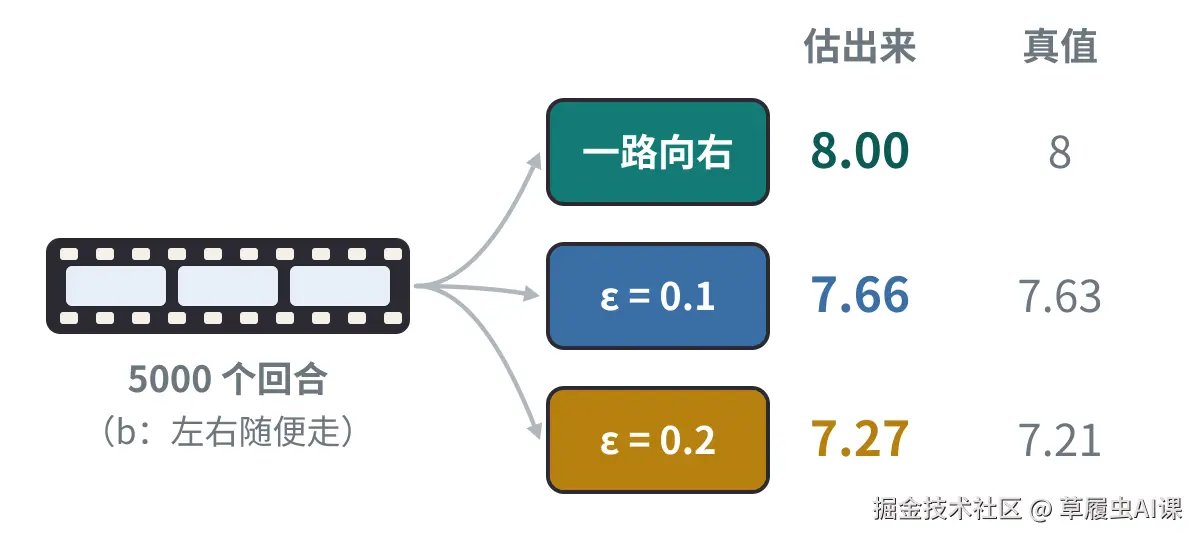
▲ 图 11 例 6 图解:同一批随机回合,估三个目标策略
三个估计都离真值不远。按同策略的做法,评估这三个策略得分别跑三批数据。
具体怎么校正,用的是重要性采样,下一篇细讲。这里先说个大意:录像里哪一趟越像目标策略会走出来的样子,就给它的回报多算点分量;目标策略几乎不会那样走的,就少算。
异策略的两个前提
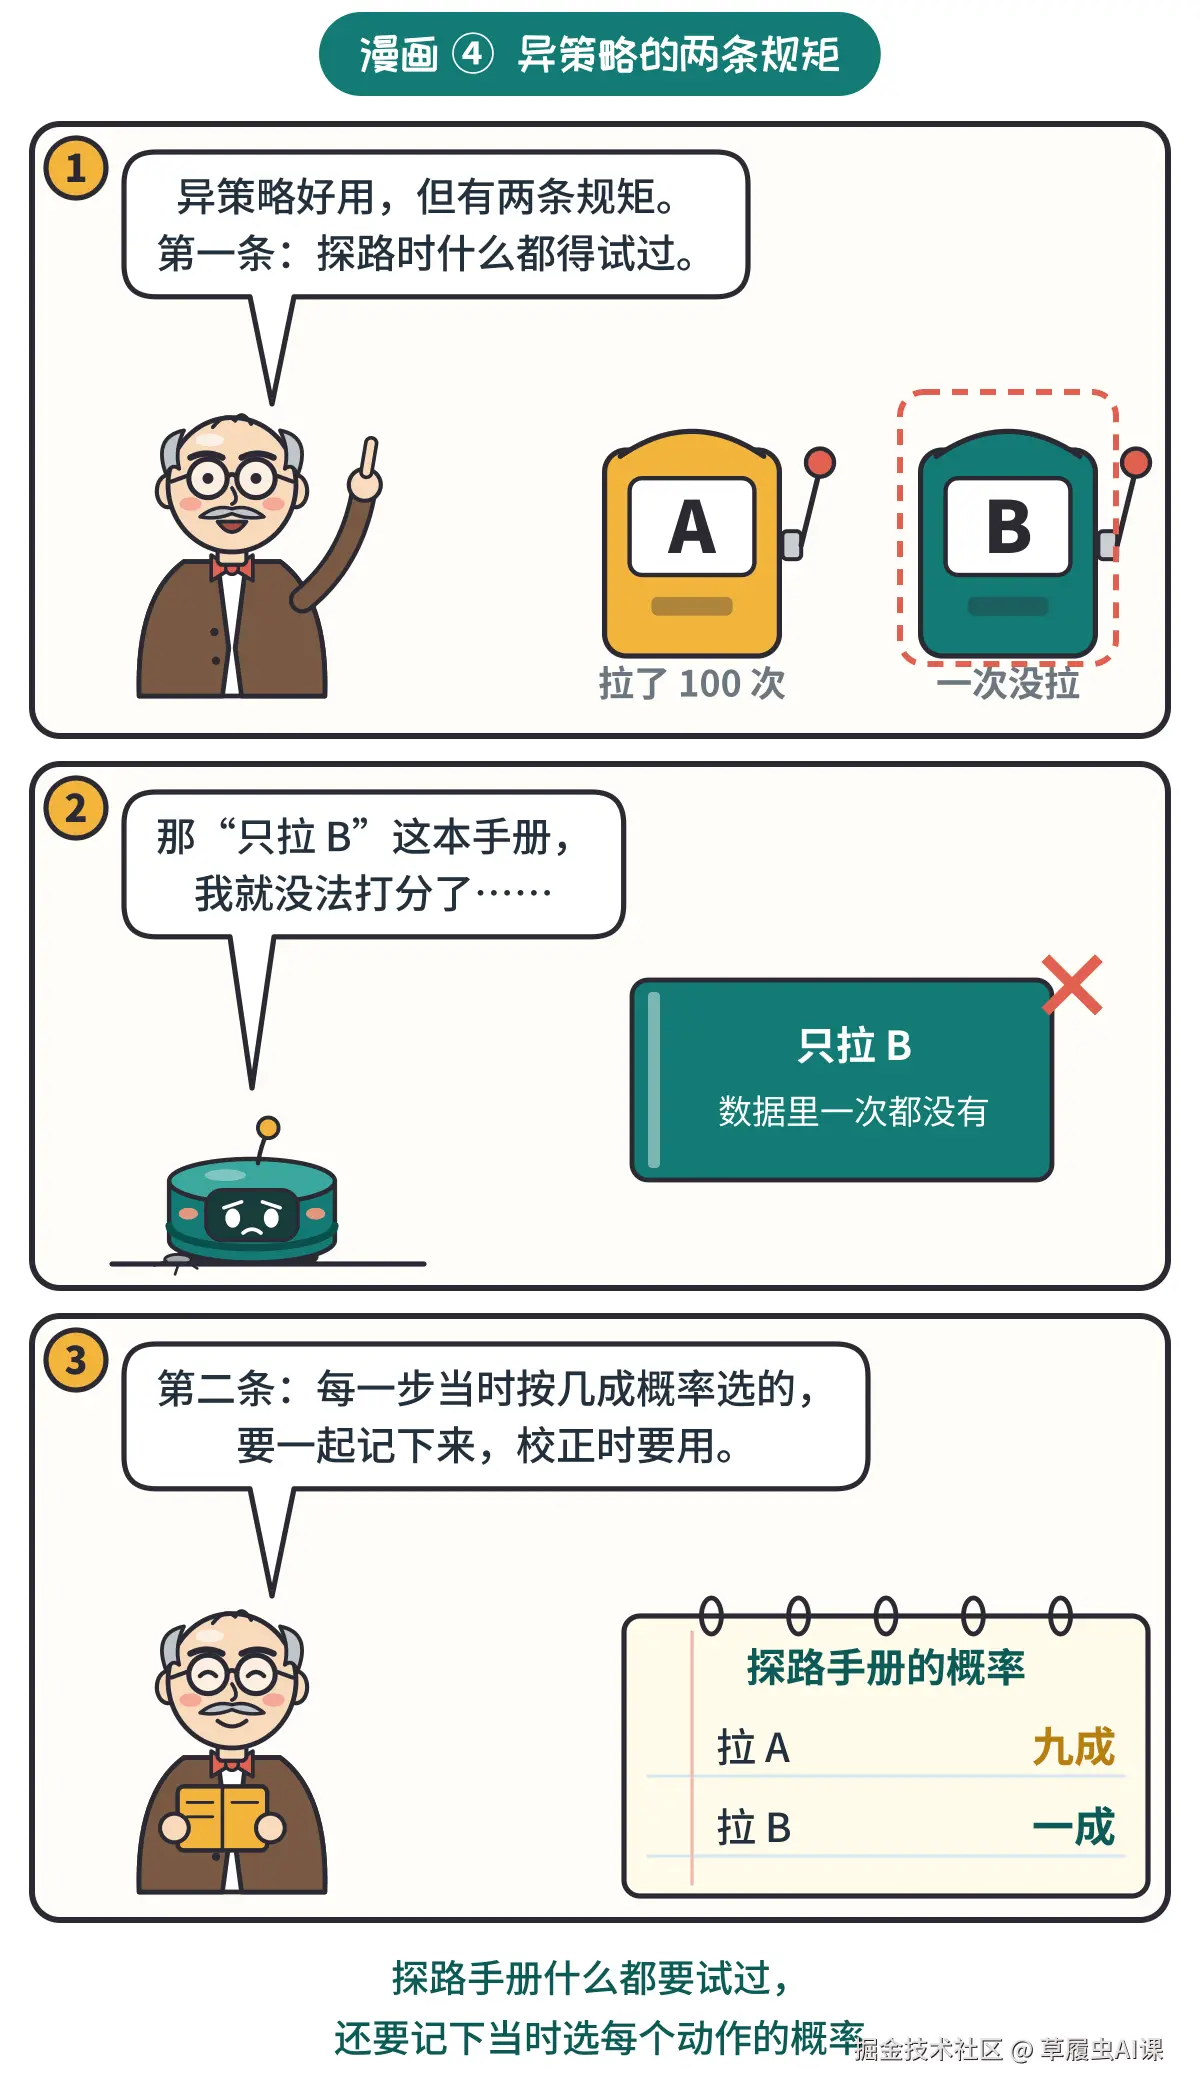
▲ 图 12 漫画 ④ 异策略的两条规矩
异策略的好处不是白来的,它有两个前提:
- 覆盖:目标策略可能做的动作,行为策略也必须有可能做到。
- 概率已知:行为策略每一步按几成概率选的,要和数据一起记下来,校正时要用。
【例 7】覆盖不住,就估不了
回到两台老虎机。目标策略是"只拉 B",想知道它平均每下能得几分(真值 2)。行为策略换两种:
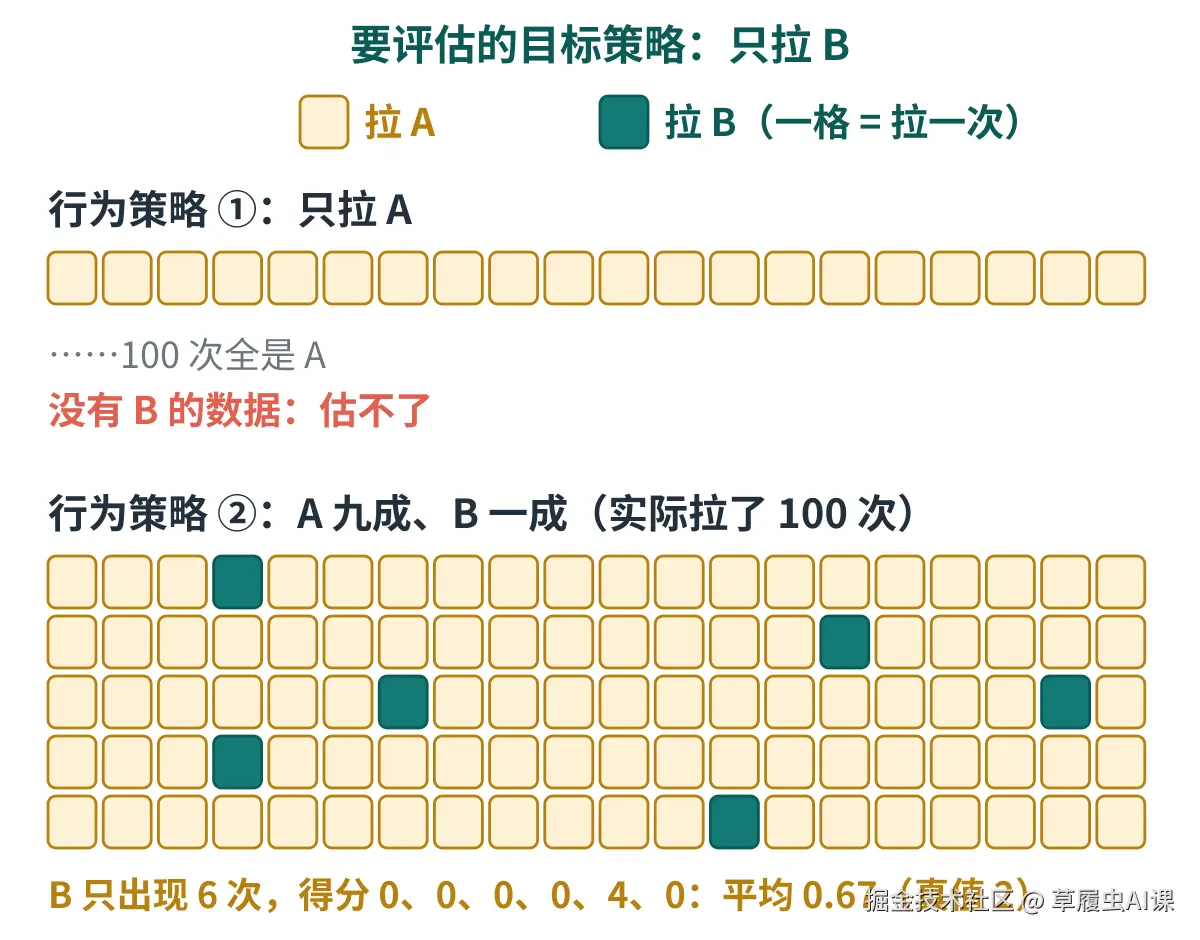
▲ 图 13 例 7 图解:行为策略很少拉 B,"只拉 B"就估不准
- 行为策略 ①:只拉 A。数据里一次 B 都没有,"只拉 B"无从估起。
- 行为策略 ②:九成拉 A、一成拉 B。拉 100 次,B 平均只被拉到 10 次左右。上图这一回只拉到 6 次,得分是 0、0、0、0、4、0,平均 0.67,离真值 2 差得远。把这件事重复 1 万遍,估计值的标准差约 0.67。
覆盖不住,就估不了;覆盖得少,估计就晃得厉害。
【注意】异策略的代价
行为策略和目标策略差得越多、回合越长,校正后的估计波动就越大。这是异策略要付的代价,下一篇会算给你看。
另外,用重要性采样来校正,是蒙特卡洛这类"拿整趟回报来学"的方法的做法,不是异策略的必需品。后面的 Q-learning 也是异策略,却换了一种办法,完全用不着重要性采样,讲到它时再细说。
五、后面的算法,各属哪一类
同策略、异策略是给算法分类的一把尺子。后面要讲的算法,先用这把尺子排一排,名字先混个眼熟,后面会一个个详细介绍:
| 算法 | 同策略 / 异策略 |
|---|---|
| 蒙特卡洛控制(ε-贪心) | 同策略 |
| 离轨蒙特卡洛控制 | 异策略 |
| Sarsa | 同策略 |
| Q-learning | 异策略 |
| DQN | 异策略 |
| REINFORCE | 同策略 |
| A2C | 同策略 |
| PPO | 同策略 |
| DDPG | 异策略 |
| TD3 | 异策略 |
| SAC | 异策略 |
顺带一句:同策略、异策略说的是"谁跑数据、谁来学";常听到的"在线、离线"说的是"数据是边跑边用,还是先存起来再学",是两回事,后面讲到它时再细说。
六、小结
把这一篇的内容串起来,就是下面这张图。每个框右上角的小签标着在第几节讲过;最下面的虚线框是下一篇要回答的问题。
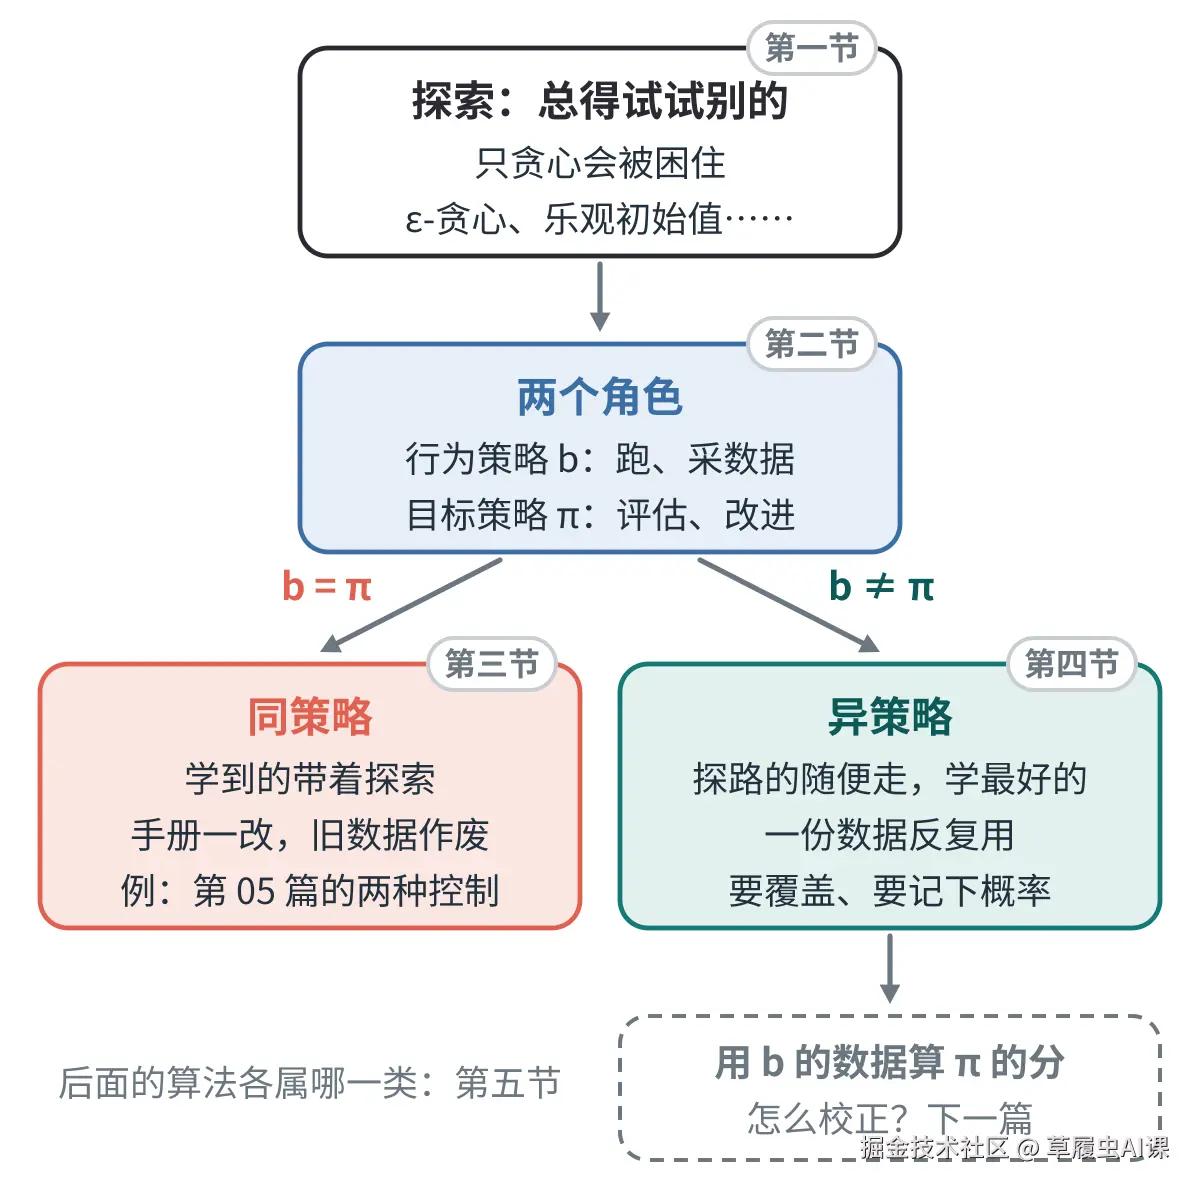
▲ 图 14 同策略与异策略:从探索讲到两个角色,再分成两条路
各个概念的一句话总结:
| 概念 | 一句话 | 例子里 |
|---|---|---|
| 探索与利用 | 只利用会被困住,要留出探索 | 只贪心 10 次全拉 A |
| 乐观初始值 | 开局把 Q 填高,没试够的显得好 | 第 5 次回头试 B |
| 行为策略 b | 跑数据的策略 | 策略 B(随便走) |
| 目标策略 π | 要评估、改进的策略 | 一路向右 |
| 同策略 | b=π:学到的带着探索;策略一改,旧数据作废 | 7.63; (s2,←) 从 −5.21 变 4.21 |
| 异策略 | b=π:可以学贪心策略,数据反复用 | 8;一批数据估三个策略 |
| 覆盖 | 目标策略可能做的,行为策略也得可能做 | 不拉 B 就估不了"只拉 B" |
一句话串起来:要学好就得探索 ;探索和学习用同一个策略,就是同策略 ,学到的带着探索、数据用一次就扔;把它们交给两个策略,就是异策略 ,行为策略随便走、目标策略只学最好的,数据还能反复用,但要覆盖住,还得校正两者的差别。
附一 动手算一算
下面让两台老虎机上的三种做法各玩 2000 回、每回拉 1000 下,比一比平均每下得几分。只用标准库。
python
import random

def pull(arm, rng):
    # A:0 或 2;B:0 或 4,各一半
    big = 2 if arm == "A" else 4
    if rng.random() < 0.5:
        return big
    return 0

def play(method, n, rng, eps=0.1):
    S = {"A": 0.0, "B": 0.0}  # 总分
    N = {"A": 0, "B": 0}      # 次数
    if method == "opt":  # 乐观初始值
        S = {"A": 5.0, "B": 5.0}
        N = {"A": 1, "B": 1}

    def Q(a):
        if N[a] == 0:
            return 0.0
        return S[a] / N[a]

    total = 0
    for _ in range(n):
        if method == "eps" and \
                rng.random() < eps:
            a = rng.choice("AB")  # 探索
        else:
            qa, qb = Q("A"), Q("B")
            if qa > qb:
                a = "A"
            elif qb > qa:
                a = "B"
            else:
                a = rng.choice("AB")
        r = pull(a, rng)
        S[a] += r
        N[a] += 1
        total += r
    return total

for m in ("greedy", "eps", "opt"):
    rng = random.Random(42)
    s = sum(play(m, 1000, rng)
            for _ in range(2000))
    print(m, round(s / 2000 / 1000, 3))
运行结果:greedy 1.513,eps 1.921,opt 1.948。乐观初始值把开局那笔 5 分算作已经记过的一次,所以 N 从 1 起算。
附二 参考文献
- Robbins H. Some aspects of the sequential design of experiments. Bulletin of the American Mathematical Society, 1952, 58(5): 527--535.
- Sutton R S, Barto A G. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018. 第 2 章、第 5 章.
【下期预告】重要性采样
异策略的关键一步,是拿行为策略跑出来的数据,去估目标策略的价值。凭什么能这样做、具体怎么校正?下一篇从一个"机器人放技能"的小例子出发,讲清重要性采样(importance sampling)。
【关注】谢谢您看到这里这个系列会一直更新下去。关注我,新文章一发布就会出现在您的关注动态里,不会错过后面的内容。
也可以收藏本系列专栏,全部文章按顺序排在一起,随时回看。
感谢关注和支持!有问题也欢迎在评论区聊聊~
------ 强化学习从零到一 · 第 6 篇 · 完 ------