11 月 16 日,首届蚂蚁灵波具身大模型挑战赛在上海张江收官。全球 1,855 支报名队伍里杀出的 15 支战队,在现场经历了一场 48 小时的极限真机黑客松。
比赛条件完全拉平。所有队伍拿到的是同一个开源底座 LingBot-VLA 2.0,同一款松灵 COBOT MAGIC 双臂机器人,以及相同的现场算力。三道考题也很实在:单臂抓取摆放蔬果、把化妆品精细收进透明盒、双臂配合清扫桌面垃圾并倒进收纳筐。
起跑线一模一样,最后跑出来的分数却拉开了巨大差距。更有意思的是高分战队的解法,几乎把具身智能现阶段的工程真相摊在了桌面上。
13 条数据怎么跑出 65.87 分
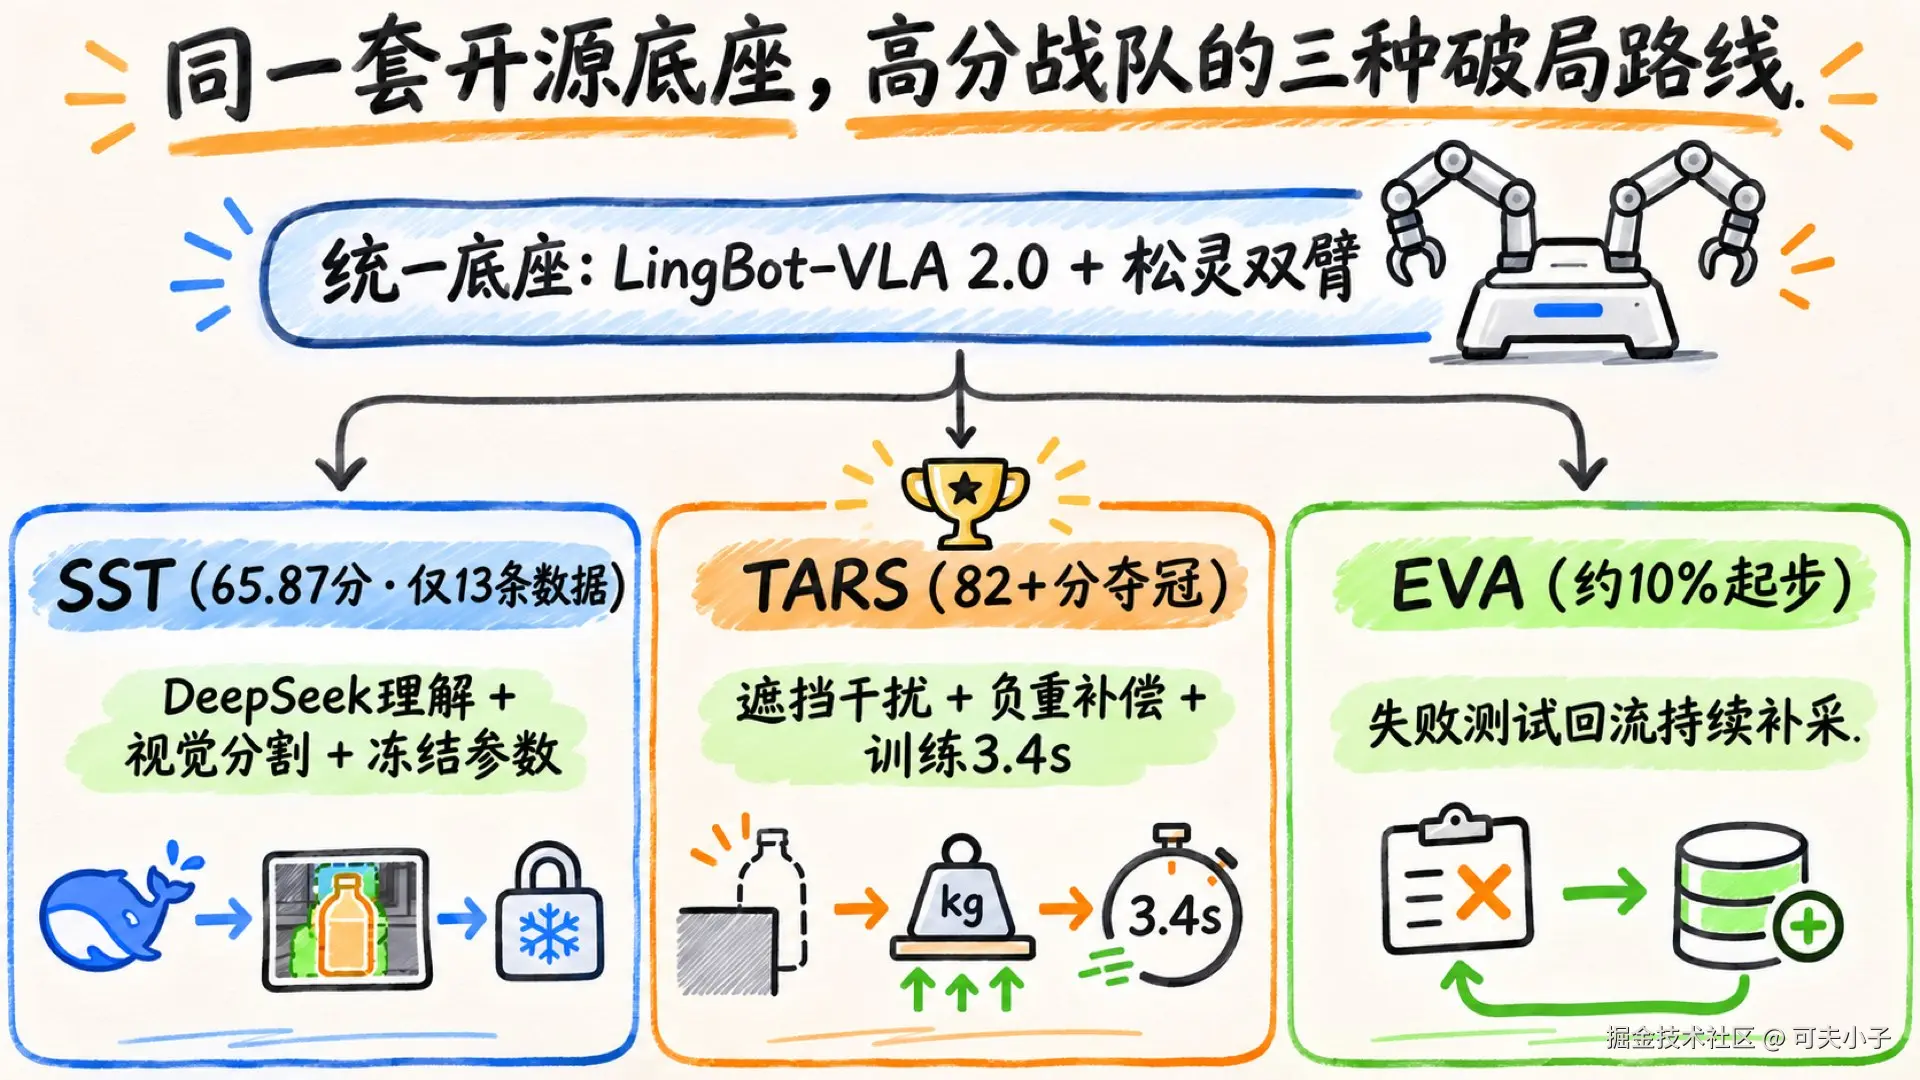
拿到总榜第三名和二等奖的 SST 战队,整个决赛只额外采集了 13 条真机数据,最终在真机评测中拿到 65.87 分。
放在过去,很多人觉得要让机器人学会一个新场景,就得靠成百上千条遥操数据硬灌。SST 换了个思路。他们没有让具身模型一个人扛下所有活,而是把任务拆成了三段。
先让 DeepSeek 读懂自然语言指令,拆清楚到底要抓什么、放到哪。接着调用视觉分割模型,在画面里把目标物体精准框出来。最后才把清晰的目标位置和指令交给 LingBot-VLA 2.0,让它专心生成机械臂动作。
在微调这 13 条补充数据时,SST 还特意冻结了一部分预训练参数。如果不冻结,十几条小样本很容易把底座模型原本积累的通用动作能力冲散。把「大脑理解」「眼睛定位」和「小脑控制」拆开各司其职,小样本反而跑出了极高的性价比。
冠军队赢在遮挡干扰和负重补偿
拿到一等奖的 TARS 战队总分超过 82 分,走的是另一条更硬核的工程路线。
他们在现场测试时很快发现,第一项蔬果摆放和第二项化妆品收纳之所以容易失败,往往在于桌面上的无关物体太多,干扰了模型判断。TARS 的做法很干脆:先用大模型识别目标物和干扰物,再把画面里的无关区域直接遮挡掉,只让机器人盯着当前要处理的东西看。靠这一招,他们在第一项任务里拿到了 10 次全部成功的成绩。
到了最难的双臂清扫环节,物理世界的麻烦全冒出来了。机械臂抓簸箕抓不稳,他们就重新选抓持点并补采针对性数据。机械臂伸远或者拿着东西负重时,手臂会自然下坠,导致动作轨迹偏掉。TARS 直接在现场测出不同负重下的下坠偏差,在控制层做了实时补偿。
获得二等奖的 EVA 战队走了相反的笨功夫。他们一开始直接用官方数据训练,真机成功率只有约 10%。团队没有放弃,而是把每一轮真机测试失败的现场记录直接转成新的训练数据,一轮轮往里喂,硬生生把成功率拉了上去。
这三支队伍放在一起看很说明问题。开源基座已经具备了基础的视觉和动作能力,但真要让机器人在真实桌面上干活,拼的已经是对失败环节的拆解能力,以及把数据喂在刀刃上的工程手艺。
5 厘米误差撞碎的仿真幻想
比高分更值得看的,是一次现场翻车。
来自大模型评测领域的「今天也要好好检东西」战队,习惯了先搭环境、做标准、再逐段排查的软件工程思路。比赛中,他们让视觉语言模型负责理解环境和规划步骤,同时专门搭建了一套仿真环境,想提前在虚拟桌面里把动作全部验证通。
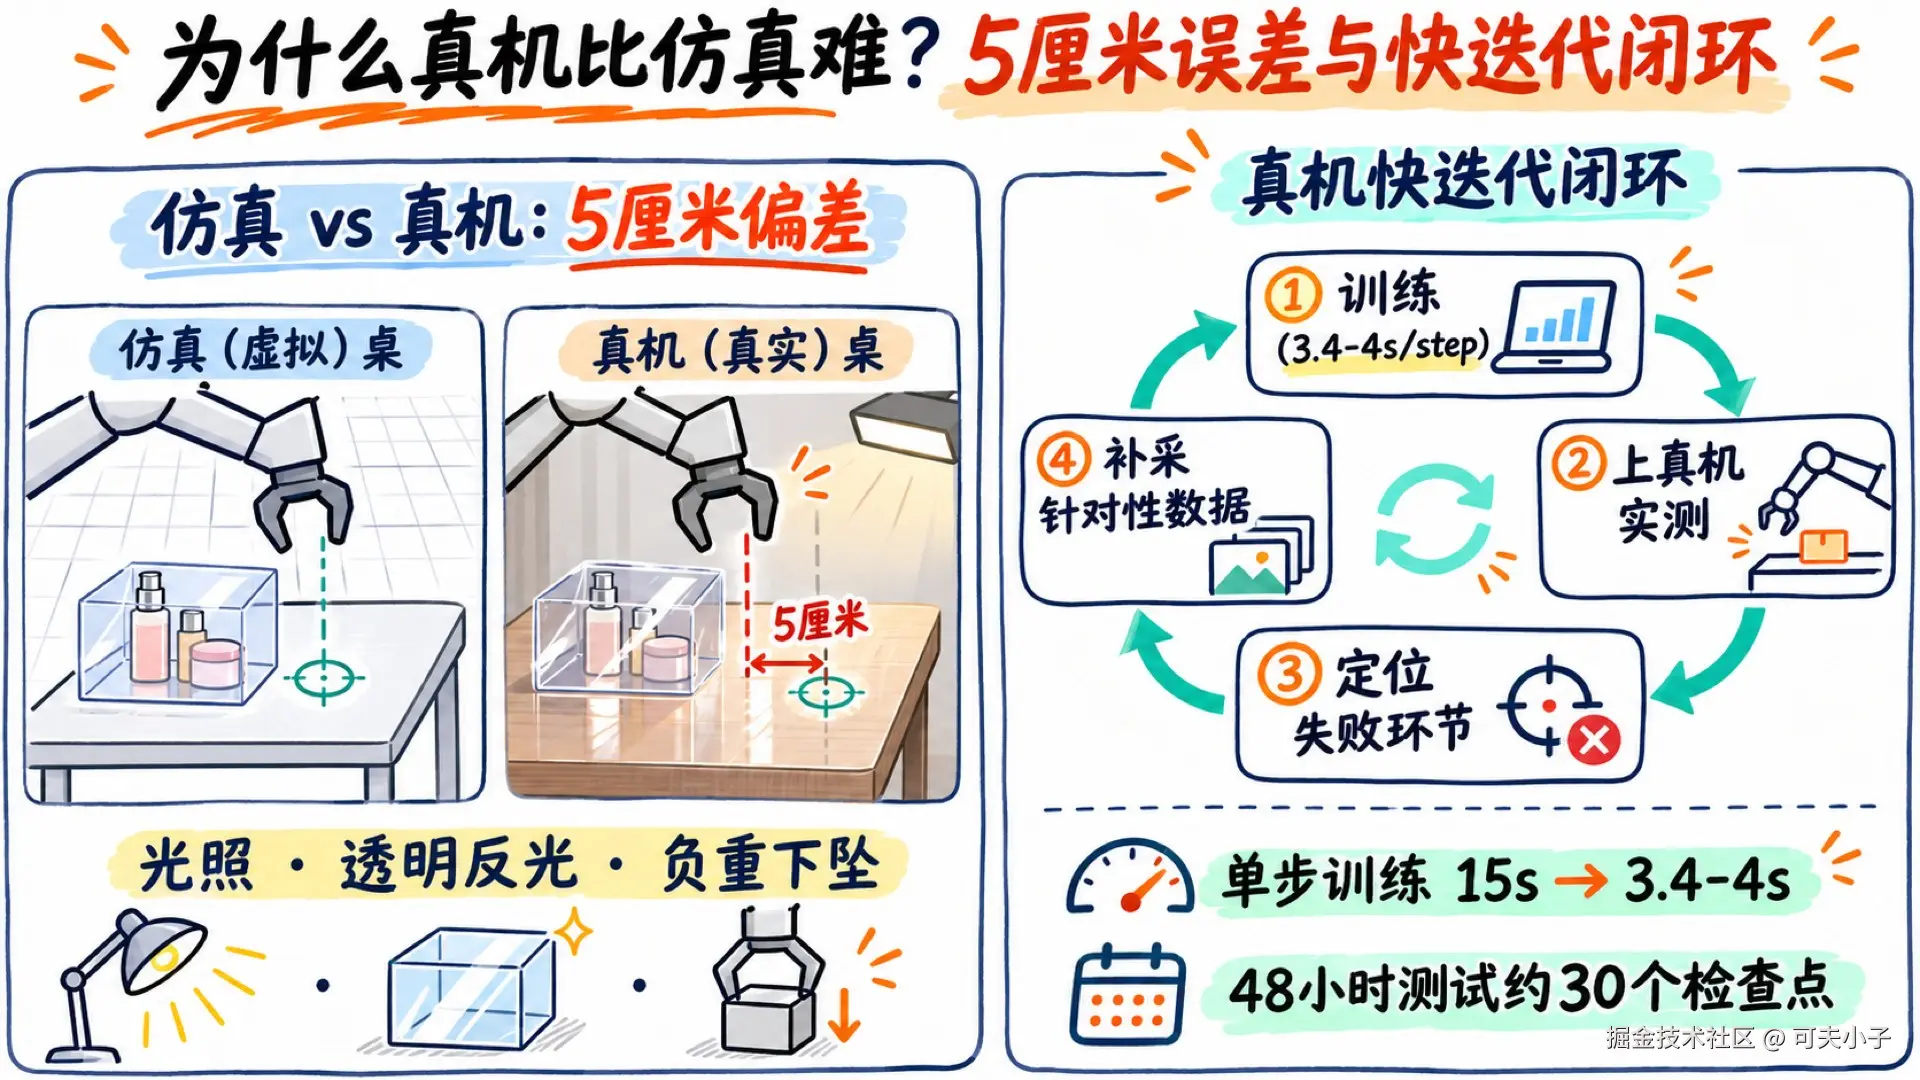
结果一上真机,原本在仿真里跑得很稳的动作直接失效。一量才发现,仿真桌面和现场真实桌面的尺寸差了大约 5 厘米。
数字世界里差 5 厘米几乎不算事,可对物理世界的机械臂来说,差 5 厘米就是抓空、撞翻甚至卡死。光线变化、透明化妆品盒的反光、桌面摩擦力、机械臂自身阻尼,这些细节在仿真里很难一比一还原。通用大模型降低了开发门槛,却抹不平仿真和现实之间的那条缝。
也正因为真机环境没法靠纯仿真偷懒,现场的另一批团队把精力全砸在了训练提速上。
冠军 TARS 把单步训练时间从大约 15 秒压到了 3.4 秒。「持续知行」团队从 15 秒压到 4 秒,48 小时里测了约 30 个模型检查点。Motion 团队也从 14 秒提到了 3.7 秒。在只有两天的极限赛里,把单步训练压缩到四分之一,意味着你能多跑好几轮「训练、上机、看哪错了、改完重训」的闭环。
具身智能还没找到自己的 Scaling Law
这次比赛的底座 LingBot-VLA 2.0,本身已经是目前开源社区里数据量相当扎实的一代模型。根据官方披露,它整合清洗了 6 万小时预训练数据,覆盖 17 个主流机器人品牌的 20 种构型,在单张 RTX 4090 上的端侧推理耗时可以压到 130 毫秒以内。
即便底座打到这个程度,真机现场依然暴露出不少硬骨头。小样本微调一不小心就会过拟合,换个角度或光照就掉点。面对透明反光物体、需要精细力控的双臂协作,以及端侧实时推理的算力开销,目前都还没有一劳永逸的通用解法。
大赛同一天举办的蚂蚁灵波开发者大会上,CEO 朱兴讲了一句很实在的话。他说目前 VLA、世界模型、通用大模型控制机器人等路线都在探索,行业还不知道哪类数据扩大规模后,能带来真正的能力跃迁。
这句话基本定调了当下的具身智能阶段。它还没有找到像语言模型那样清晰的 Scaling Law。指望一个基座模型开箱即用、通吃所有物理场景还不现实。现阶段最管用的组合,依然是通用大模型负责理解、视觉模型负责抠出目标、具身模型负责生成动作,再配上一套足够快的真机试错闭环,一厘米一厘米地把误差抠出来。