为什么 ready 了还不发
上一篇讲了 batch 什么时候变 READY。但很多人遇到过这种情况:监控显示 batch 已经 ready 了,消息却没发出去,延迟持续走高。
原因很简单:accumulator.ready() 返回的 readyNodes 只是"这个 Broker 上有 ready 的 batch",不代表"这个 Broker 现在可以接收消息"。Sender 拿到 readyNodes 后,还要逐个节点调用 client.ready(node) 做三层过滤,通过了才会真正 drain 发送。
01 三层过滤全景
从 readyNodes 到可发送节点,要经过三层过滤:
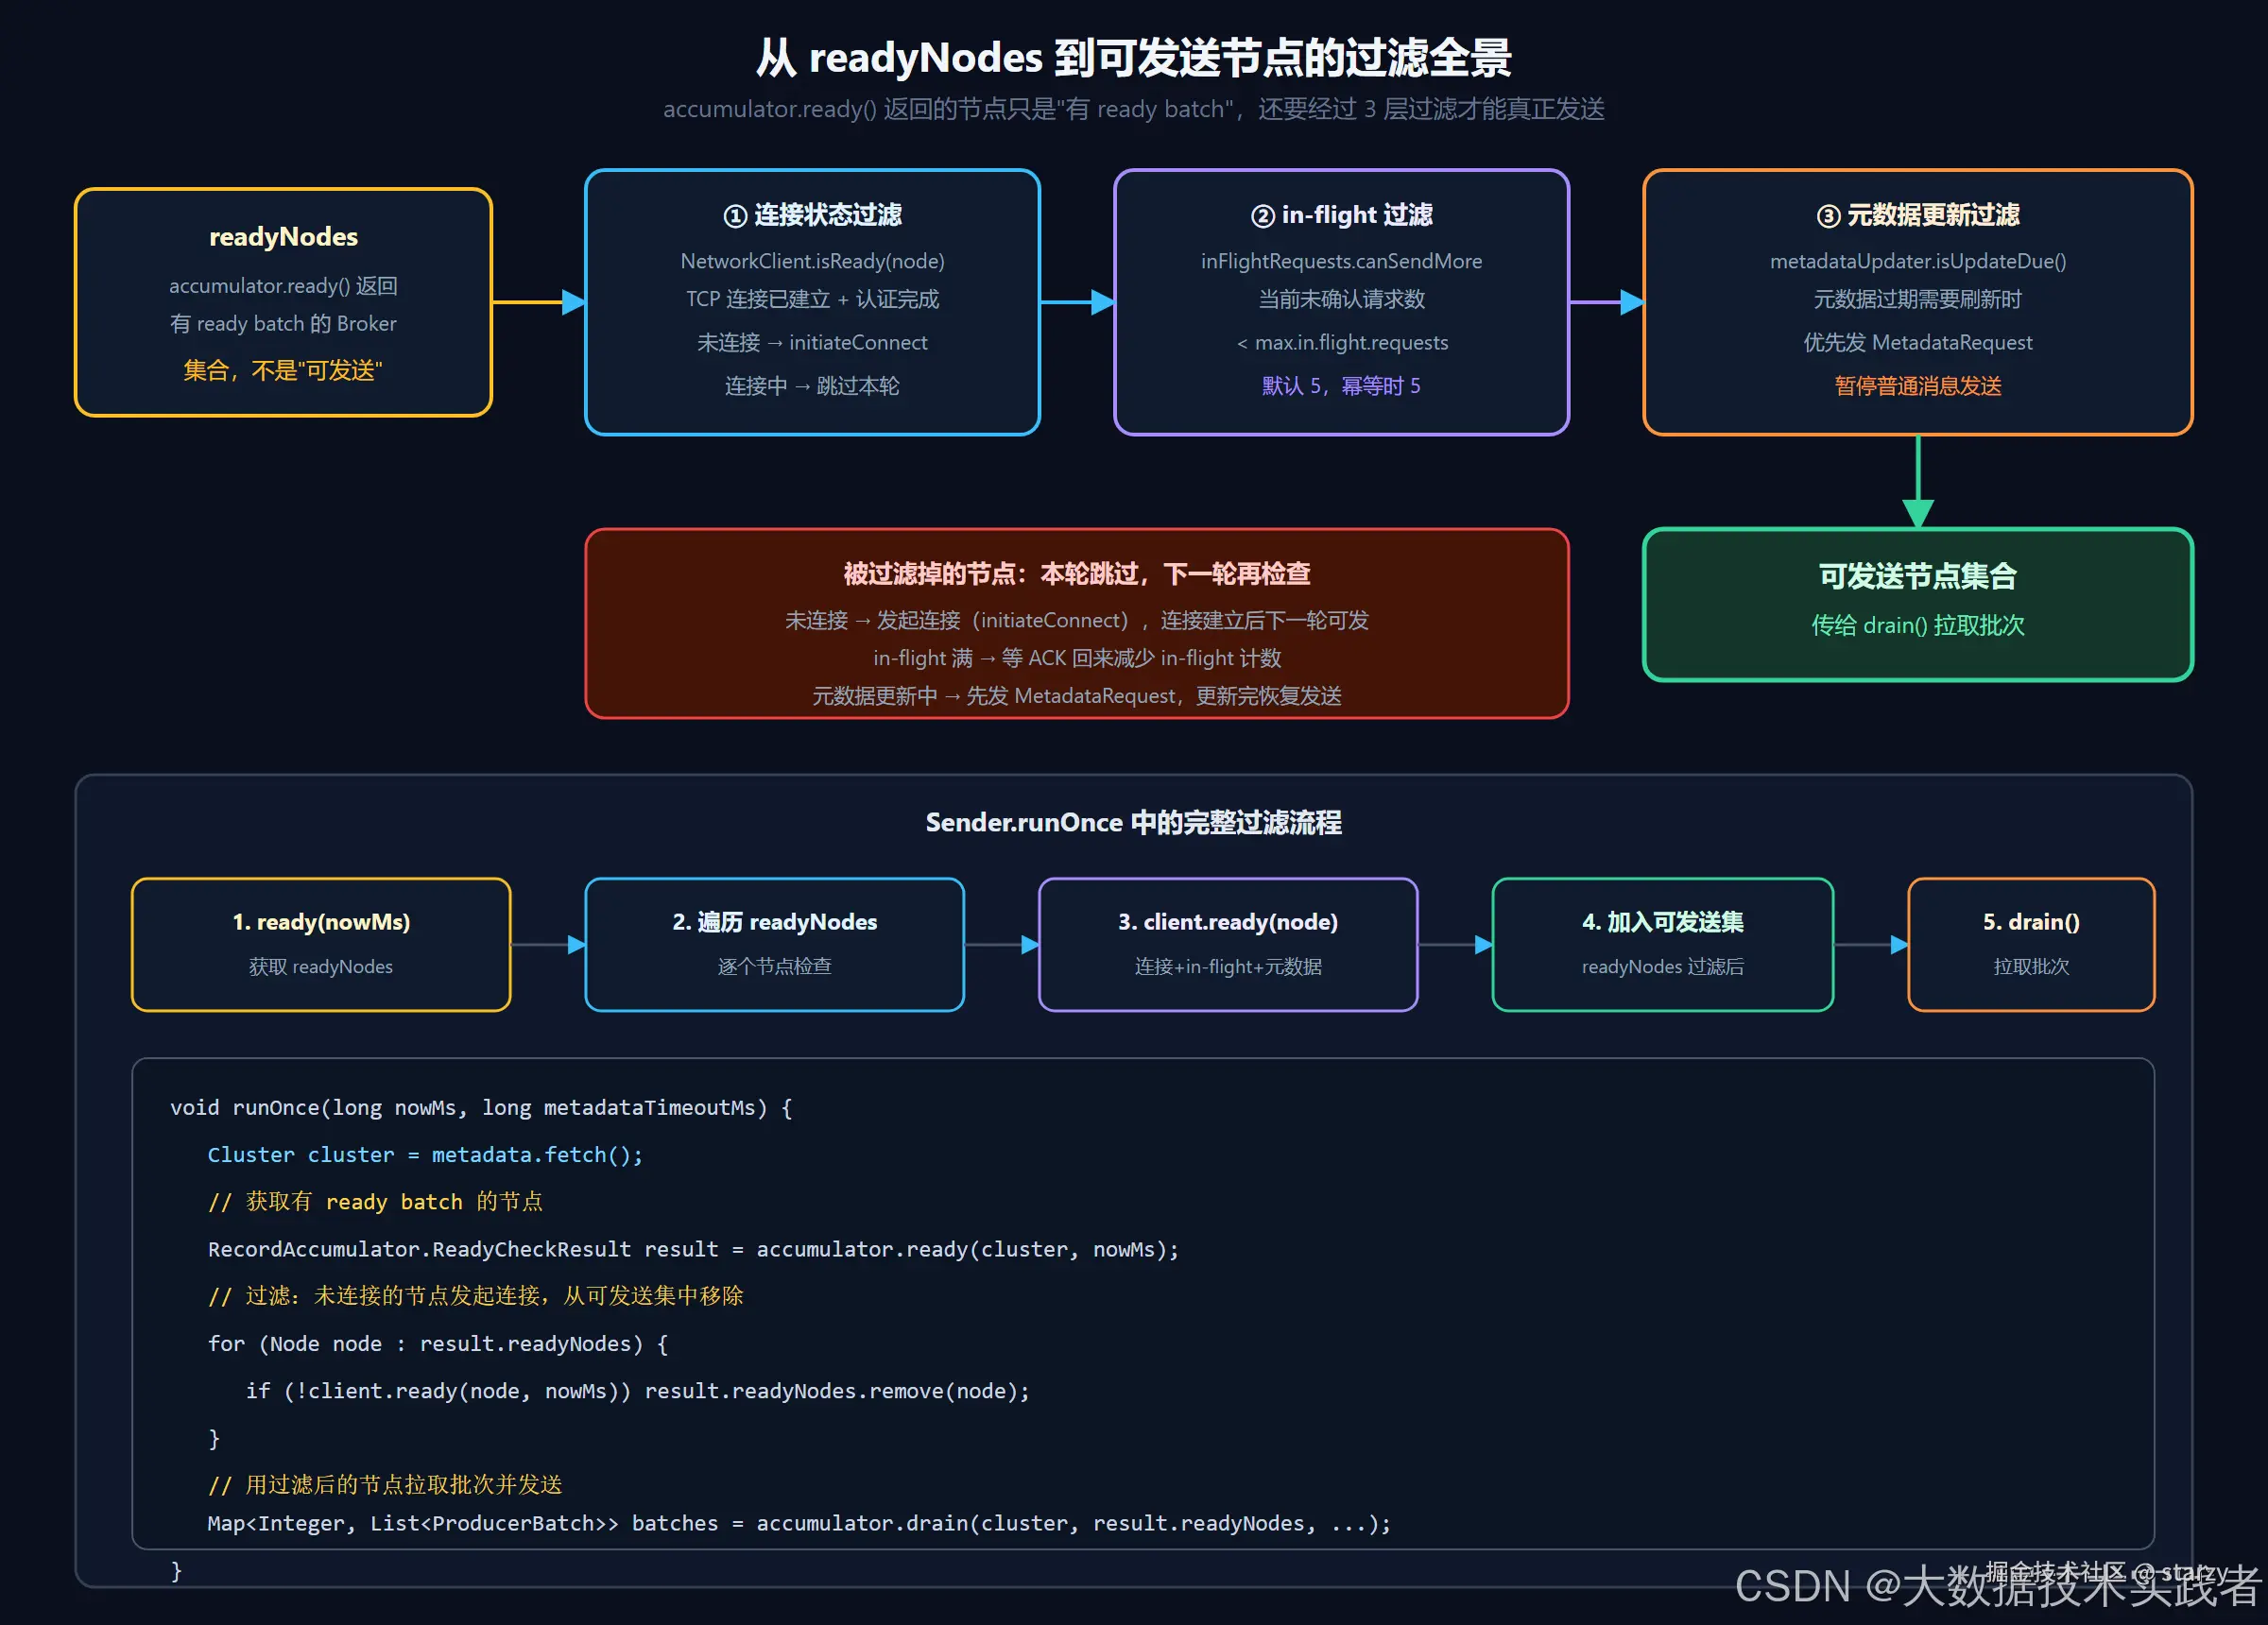
第一层:连接状态过滤。 调用 NetworkClient.isReady(node),检查 TCP 连接是否已建立、SASL 认证是否完成、握手是否完成。只有连接状态为 READY 才通过。未连接的节点会调用 initiateConnect() 发起连接,连接中的节点本轮跳过。
第二层:in-flight 过滤。 调用 inFlightRequests.canSendMore(node.id),检查该节点当前未确认的请求数是否小于 max.in.flight.requests.per.connection(默认 5)。满了说明 Broker 处理不过来,继续发只会导致请求排队超时。
第三层:元数据更新过滤。 检查 metadataUpdater.isUpdateDue(nowMs),如果元数据过期需要刷新,本轮优先发 MetadataRequest,暂停普通消息发送------避免用过期元数据把消息发到错误的 Broker。
三层都通过的节点才加入"可发送节点集",传给 accumulator.drain() 拉取批次。
02 NetworkClient.ready() 的判断逻辑
client.ready(node, nowMs) 内部是一个与逻辑,三个条件同时满足才返回 true:
java
public boolean ready(Node node, long nowMs) {
    if (node.isEmpty()) return false;
    // 条件1:连接就绪
    if (!connectionStates.isReady(node.id())) {
        if (connectionStates.canConnect(node.id(), nowMs))
            initiateConnect(node, nowMs);
        return false;
    }
    // 条件2:in-flight 未满
    if (!inFlightRequests.canSendMore(node.id()))
        return false;
    // 条件3:元数据未在更新
    if (metadataUpdater.isUpdateDue(nowMs))
        return false;
    return true;
}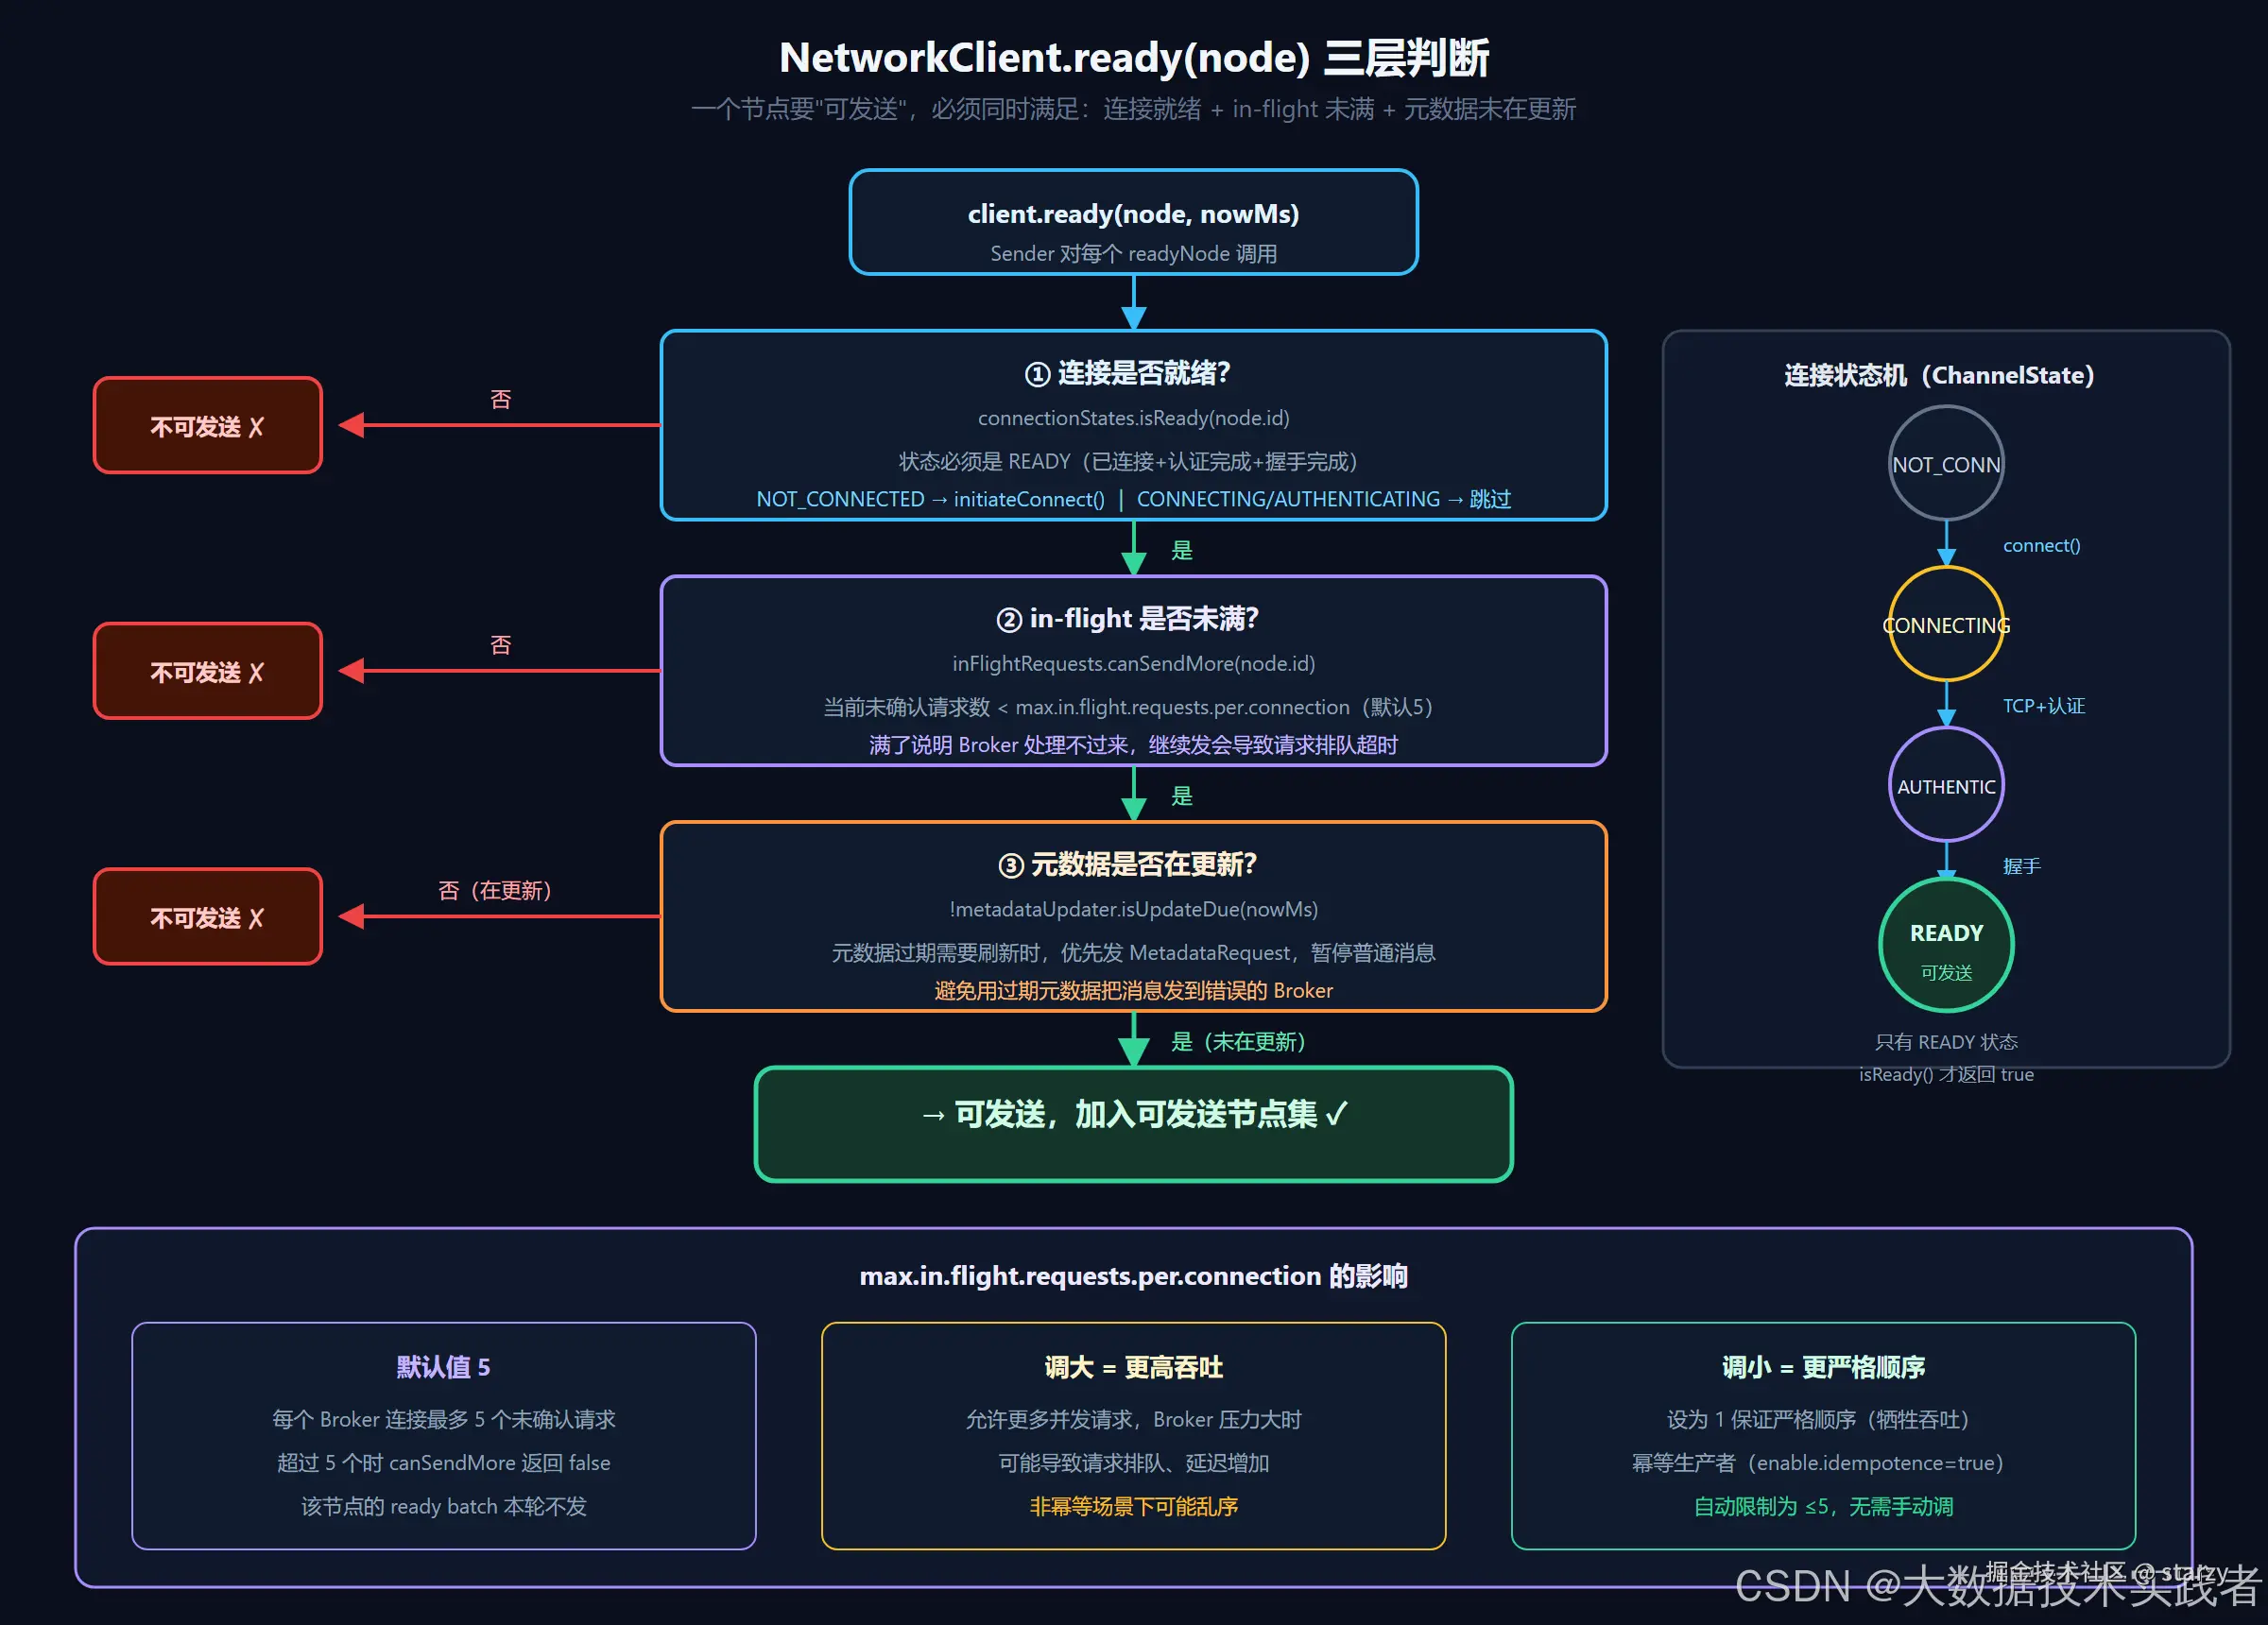
连接状态机 有 4 个状态:NOT_CONNECTED → CONNECTING → AUTHENTICATING → READY。只有 READY 状态 isReady() 才返回 true。首次发送时要经过 TCP 三次握手 + SASL 认证 + TLS 握手(如果启用),这就是为什么 Producer 启动后第一条消息延迟特别高。
in-flight 计数 是每个 Broker 连接独立维护的。发一个 ProduceRequest 计数 +1,收到 ACK 计数 -1。默认上限 5,调大能提高吞吐但可能导致 Broker 压力过大,调小(如 1)能保证严格顺序但牺牲吞吐。幂等生产者(enable.idempotence=true)会自动限制为 ≤5。
03 Sender.runOnce 中的完整流程
把过滤逻辑放回 Sender 的主循环,完整流程是这样的:
java
void runOnce(long nowMs, long metadataTimeoutMs) {
    Cluster cluster = metadata.fetch();
    // 1. 获取有 ready batch 的节点
    RecordAccumulator.ReadyCheckResult result = accumulator.ready(cluster, nowMs);
    // 2. 逐个节点过滤,未通过的从集合中移除
    for (Node node : result.readyNodes) {
        if (!client.ready(node, nowMs))
            result.readyNodes.remove(node);
    }
    // 3. 用过滤后的节点拉取批次
    Map<Integer, List<ProducerBatch>> batches =
        accumulator.drain(cluster, result.readyNodes, maxRequestSize, nowMs);
    // 4. 构建请求并发送
    sendProduceRequests(batches, nowMs);
}注意一个细节:过滤是直接修改 readyNodes 集合(remove 未通过的节点),不是创建新集合。所以传给 drain 的 readyNodes 已经是过滤后的结果。
04 为什么 ready 了但没发出去:4 种场景
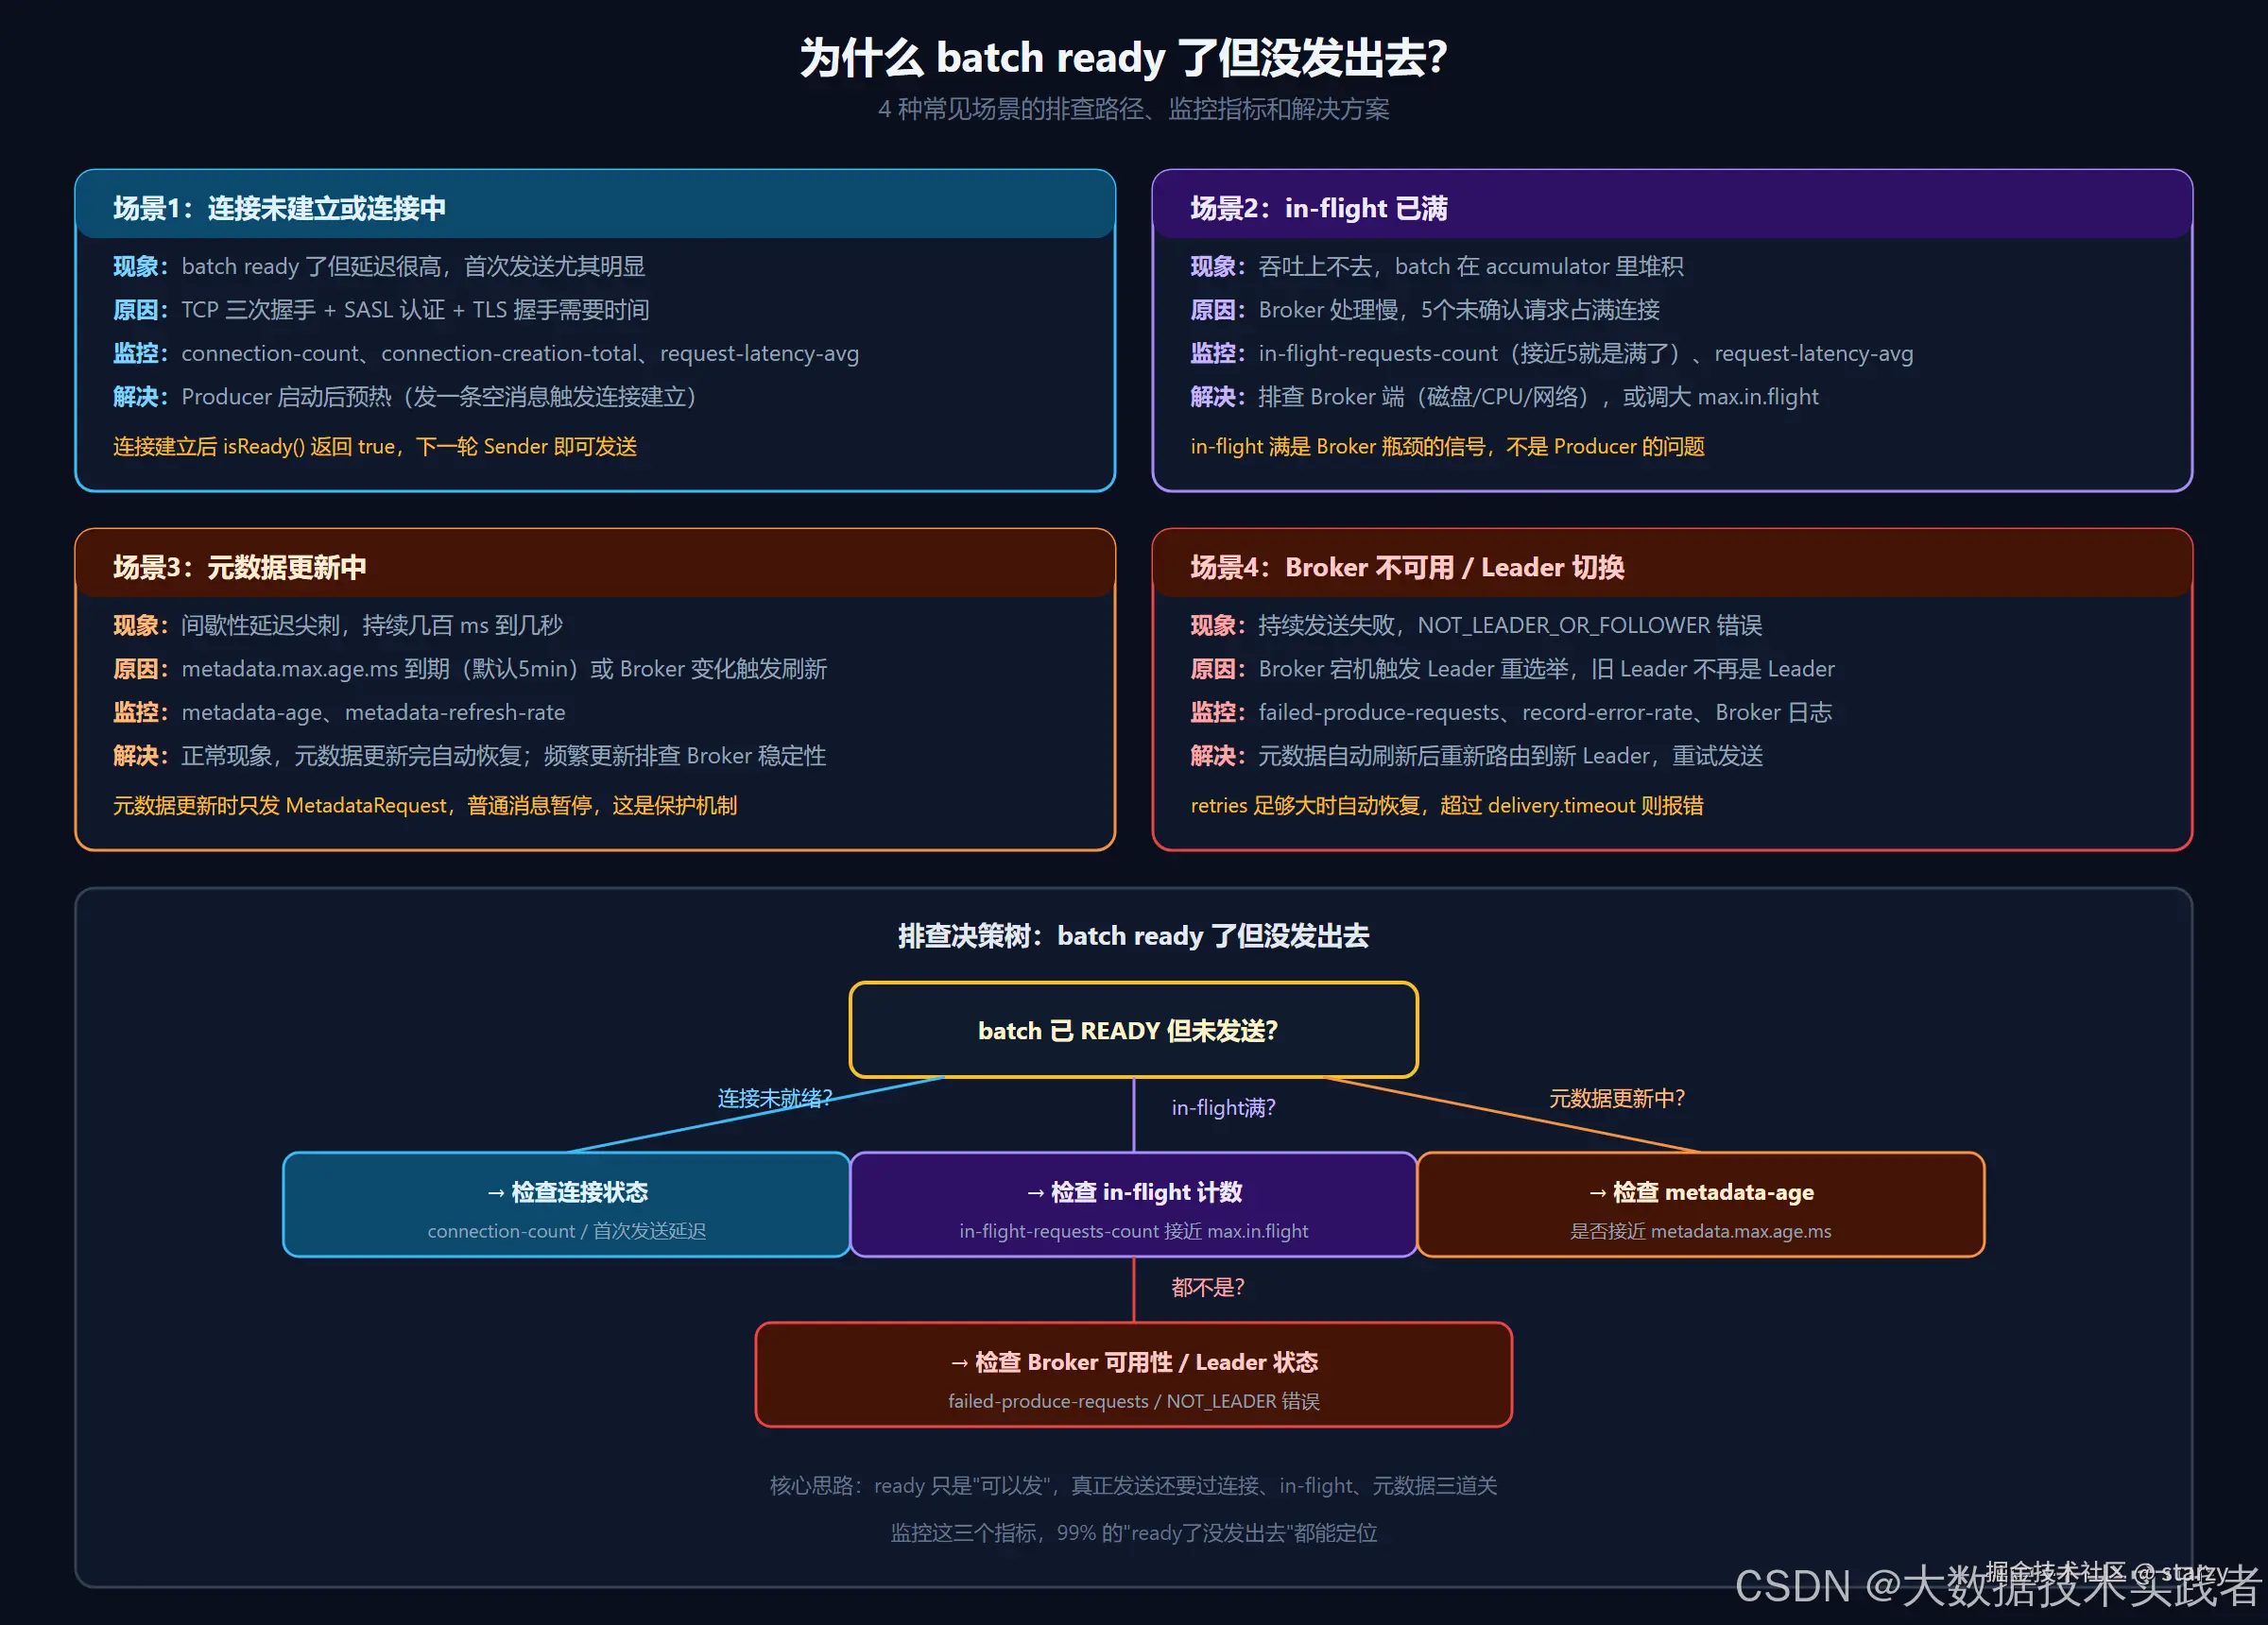
场景1:连接未建立。 首次发送或连接断开重连时,TCP 握手 + 认证需要时间。监控 connection-count 和 connection-creation-total,如果连接数持续增长说明在频繁重连。解决:Producer 启动后预热(发一条空消息触发连接建立),或者接受首次延迟。
场景2:in-flight 已满。 这是最常见的吞吐瓶颈。监控 in-flight-requests-count,如果持续接近 max.in.flight(默认5),说明 Broker 处理不过来。这不是 Producer 的问题,是 Broker 端瓶颈------排查磁盘 IO、CPU、网络。调大 max.in.flight 可能暂时缓解,但根本解决要优化 Broker。
场景3:元数据更新中。 metadata.max.age.ms 到期(默认5分钟)或 Broker 变化时触发元数据刷新,期间普通消息暂停。表现为间歇性延迟尖刺,持续几百 ms。这是正常保护机制,更新完自动恢复。如果频繁更新,排查 Broker 稳定性(是否有频繁的 Leader 切换)。
场景4:Broker 不可用 / Leader 切换。 Broker 宕机触发 Leader 重选举,旧 Leader 不再是 Leader,发送会报 NOT_LEADER_OR_FOLLOWER。元数据刷新后重新路由到新 Leader,重试发送。retries 足够大时自动恢复,超过 delivery.timeout.ms 则报错。
写在最后
理解这三层过滤后,"batch ready 了但没发出去"就不再是玄学。核心思路:ready 只是"可以发",真正发送还要过连接、in-flight、元数据三道关。
排查时按顺序检查三个监控指标:connection-count(连接是否正常)、in-flight-requests-count(是否接近上限)、metadata-age(是否在更新)。99% 的问题都能在这三个指标里定位到。