一、引言
Prometheus 让云原生监控中的指标采集、查询和告警模型深入人心。一个典型的 Prometheus 监控系统包含:
- Exporter 或应用指标端点;
- Prometheus 负责抓取和存储指标;
- PromQL 负责查询;
- Grafana 负责可视化;
- Alertmanager 负责告警通知。
对于中小规模监控系统,这套架构简单、成熟且易于落地。但随着业务规模扩大,平台团队通常会逐渐遇到以下问题:
- 指标保留周期越来越长
- Kubernetes 带来大量高 churn 指标
- 多个 Prometheus 需要统一查询
- 监控存储成本逐渐上升
VictoriaMetrics 切入的正是这一领域:在兼容 Prometheus 生态的前提下,为长期、大规模、高基数的指标数据提供更具资源效率的存储和查询能力。它可以作为 Prometheus 的长期存储,也可以通过 Prometheus 查询 API 接入 Grafana。同时,它提供 MetricsQL,即在 PromQL 基础上扩展的查询语言。
markdown
传统 Prometheus 使用方式

  Exporters ──scrape──> Prometheus ──query──> Grafana
                            │
                            └── 本地 TSDB:近期数据为主

引入 VictoriaMetrics 之后

  Exporters ──scrape──> Prometheus / vmagent
                                  │
                                  │ remote_write
                                  ▼
                         VictoriaMetrics
                                  │
                                  │ query
                                  ▼
                           Grafana / VMUI

  VictoriaMetrics 负责:
  ├── 长期存储
  ├── 统一查询
  ├── 高压缩
  ├── 高基数指标处理
  └── 多种协议接入
二、VictoriaMetrics 的整体架构
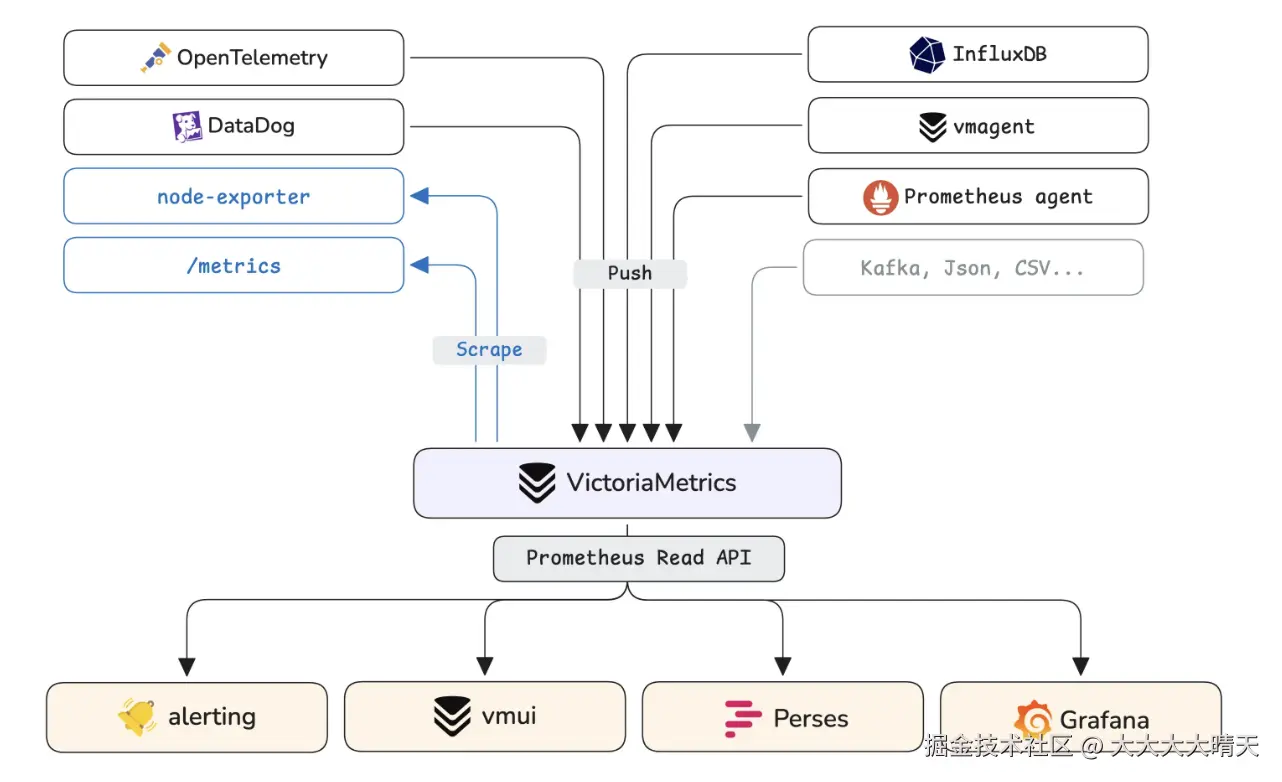
VictoriaMetrics 有两种主要部署形态:单机版和集群版。二者并不是简单的"测试版"和"生产版"关系。对于很多中小规模场景,单机版本身就可以用于生产环境。
2.1.单机版架构
VictoriaMetrics 单机版是一个独立可执行文件,单机版具有以下特点:
- 没有外部运行依赖;
- 主要通过命令行参数配置;
- 数据存放在
-storageDataPath指定的目录; - 默认监听
8428端口; - 提供 Prometheus 查询 API;
- 提供内置查询界面 VMUI;
- 可以直接接收多种协议写入;
- 可以抓取 Prometheus-compatible targets。
markdown
                  ┌─────────────────────────┐
                  │ VictoriaMetrics 单机版   │
                  │                         │
写入请求 ────────>│  接入 + 索引 + 存储     │
                  │                         │
查询请求 ────────>│  查询 + 聚合 + 返回结果 │
                  └────────────┬────────────┘
                               │
                               ▼
                    -storageDataPath
单机版的主要优点是部署和运维简单。
它不需要先维护多个分布式组件,也不需要为写入、查询和存储分别设计负载均衡。因此,对于希望快速引入长期指标存储的团队,单机版通常是更合适的起点。
但单机版主要依赖纵向扩容,即增加单机的 CPU、内存和磁盘能力。当写入量、查询量、租户数量或可用性要求超过单机边界时,再考虑集群版通常更加合理。
2.2.集群版架构
VictoriaMetrics 集群版主要由三类核心服务组成:
vminsertvmstoragevmselect
vminsert 是写入入口,负责接收指标写入请求,它会依据指标名称和完整标签集合进行一致性哈希,将数据分发到不同的vmstorage 节点。它的核心职责包括:
- 接收 Remote Write 等写入请求;
- 解析指标数据;
- 根据时间序列进行分片;
- 将数据转发到对应的存储节点。
vmstorage 是存储节点,负责保存:
- 原始时间序列样本;
- 时间序列索引;
- 标签相关索引信息。
收到查询请求时,vmstorage 会根据时间范围和标签过滤条件读取数据,并将结果返回给vmselect 。
各个vmstorage 节点之间不直接通信,也不共享数据。这是一种 shared-nothing 架构,这种架构能够减少节点间协调,但也意味着数据复制、节点故障和容量规划需要在部署时进行明确设计。
vmselect 是查询入口,负责接收查询请求,它会向多个vmstorage 节点发起查询,然后对返回结果进行合并、计算和响应。其主要职责包括:
- 接收 Prometheus 查询 API 请求;
- 拆分和分发查询;
- 从多个存储节点获取数据;
- 合并不同分片的查询结果;
- 执行 MetricsQL 查询逻辑;
- 将最终结果返回给 Grafana、VMUI 或调用方。
完整架构如下:
markdown
                         ┌─────────────────┐
                         │ Grafana / VMUI  │
                         └────────┬────────┘
                                  │ query
                                  ▼
                         ┌─────────────────┐
                         │    vmselect     │
                         │ 查询入口        │
                         │ 拆分并合并结果  │
                         └────┬───────┬────┘
                              │       │
                   ┌──────────▼─┐   ┌─▼──────────┐
                   │ vmstorage  │   │ vmstorage  │
                   │ 原始数据   │   │ 原始数据   │
                   │ 时序索引   │   │ 时序索引   │
                   └────────▲───┘   └───▲────────┘
                            │           │
                         ┌──┴───────────┴──┐
                         │    vminsert     │
                         │ 写入入口        │
                         │ 一致性哈希分片  │
                         └────────▲────────┘
                                  │
                      Remote Write / Import
                                  │
               ┌──────────────────┴──────────────────┐
               │ Prometheus / vmagent / OTel / App  │
               └─────────────────────────────────────┘
集群拆分的工程价值在于,各组件可以独立扩容:
- 写入压力大时扩容
vminsert; - 查询压力大时扩容
vmselect; - 存储容量或存储吞吐不足时扩容
vmstorage。
与此同时,集群版也带来了额外的治理成本,包括:
- HTTP 负载均衡;
- 组件发现;
- 租户路由;
- 数据复制;
- 备份和恢复;
- 容量规划;
- 集群自身监控;
- 跨可用区拓扑设计。
因此,集群版并不天然优于单机版。只有当业务规模或可用性目标确实需要时,集群化才会产生足够收益。
2.3.单机版VS集群版
| 维度 | 单机版 | 集群版 |
|---|---|---|
| 部署复杂度 | 一个进程,部署和排障相对简单 | 三类核心组件,需要额外管理负载均衡、拓扑和容量 |
| 扩展方式 | 以垂直扩展为主 | 写入、查询和存储可以分别横向扩展 |
| 运维成本 | 较低 | 较高 |
| 适用对象 | 中小规模、快速落地、长期存储 | 大规模、多租户、平台化场景 |
| 默认 HTTP 端口 | 8428 | vminsert:8480、vmselect:8481、vmstorage:8482 |
| 故障治理 | 架构简单,但需自行设计高可用 | 支持组件冗余和数据复制,但治理复杂 |
| 容量规划 | 关注单机 CPU、内存、磁盘与网络 | 需要分别规划写入、查询和存储资源 |
当写入速率低于每秒一百万个数据点时,建议优先考虑单机版,因为单机版更容易配置和运维。当单机纵向扩容、查询隔离、租户治理或可用性设计已经无法满足要求时,再引入集群版。
三、VictoriaMetrics 的数据链路
从一条指标样本的生命周期来看,VictoriaMetrics 体系主要包含以下环节:
- 指标采集;
- 指标过滤和重标记;
- 数据写入;
- 数据存储;
- 数据查询;
- 规则计算和告警。
bash
  采集层                接入层                  存储查询层                消费层

┌──────────┐      ┌─────────────────┐      ┌────────────────────┐    ┌──────────────┐
│ Exporter │──┐   │ Prometheus      │      │ VictoriaMetrics    │    │ Grafana      │
└──────────┘  ├──>│ 或 vmagent      │─────>│ 单机版 / 集群版    │───>│ VMUI         │
┌──────────┐  │   │ relabel/filter  │      │ MetricsQL / API    │    │ Alertmanager │
│ App Push │──┘   └─────────────────┘      └─────────▲──────────┘    └──────────────┘
└──────────┘                                         │
                                               ┌─────┴──────┐
                                               │  vmalert   │
                                               │ 规则与告警 │
                                               └────────────┘
3.1. 采集与写入
单机版 VictoriaMetrics 可以直接抓取 Prometheus-compatible targets。
不过在较常见的生产架构中,通常使用以下两种方式之一:
- Prometheus 采集指标,再通过 Remote Write 写入 VictoriaMetrics;
- 使用
vmagent采集指标并写入 VictoriaMetrics。
3.2.vmagent
vmagent 是 VictoriaMetrics 提供的轻量指标采集和转发代理,它可以:
- 抓取 Prometheus-compatible targets;
- 接收多种推送协议;
- 执行 relabel;
- 过滤无用指标;
- 执行流式聚合;
- 将数据远程写入一个或多个后端;
- 在网络异常时使用磁盘缓冲;
- 支持复制和分片;
- 对时间序列数量或基数进行限制。
如果 Prometheus 在现有架构中主要承担"抓取并转发指标"的职责,那么vmagent 可以替代其中一部分职责。
3.3.vmalert
vmalert 负责执行告警规则和记录规则,它会查询远程数据源,根据规则进行计算,然后:
- 将告警发送给 Alertmanager;
- 将记录规则结果通过 Remote Write 写回存储。
vmalert 支持 Prometheus 风格的规则定义,并可以从本地文件、URL、GCS、S3 等位置加载规则。
需要特别注意的是,vmalert 的规则计算依赖远程数据源,因此会受到以下因素影响:
- 网络故障;
- 查询超时;
- 数据可见延迟;
- 数据源可用性;
- 查询负载。
设计关键告警规则时,不能只关注表达式本身,还需要考虑数据链路故障。
四、VictoriaMetrics 的特性与优势
- 兼容现有监控生态
VictoriaMetrics 没有要求抛弃 Prometheus、Grafana 和 Alertmanager,支持 Prometheus 查询 API。
已有的 Exporter、PromQL 查询、Grafana 仪表盘和告警体系通常可以继续复用,从而降低迁移成本。
- 单机版降低运维复杂度
很多团队并不需要从一开始就维护复杂的分布式存储。
VictoriaMetrics 单机版让团队可以先解决长期存储和资源占用问题,再根据实际规模决定是否集群化。
- 写入、查询和存储可以分离扩展
集群版能够针对不同瓶颈独立扩容。
这比所有能力都绑定在同一进程中的模式更适合大型指标平台。
- 强调资源效率和高基数处理
在特定工作负载下,相较 InfluxDB、TimescaleDB、Prometheus、Thanos 和 Cortex 等系统具有更好的性能、内存占用或存储压缩表现。
markdown
优势更明显的区域

  写入量高 ─────────────────┐
                            │
  保留期长 ─────────────────┼──> VictoriaMetrics 值得重点评估
                            │
  集群数量多 ───────────────┘

  典型特征:
  ├── 高基数
  ├── 高 churn
  ├── 长保留期
  ├── 多 Prometheus 集中查询
  └── Prometheus 生态兼容

需要谨慎验证的区域

  查询语义强依赖 Prometheus 细节
      └──> 验证 MetricsQL 与 PromQL 的边界差异

  极复杂的多租户权限模型
      └──> 需要 vmauth、vmgateway 或外部权限系统

  跨可用区低延迟查询
      └──> 按官方建议谨慎设计集群拓扑
五、VictoriaMetrics 的适用场景
- Prometheus 长期存储:Prometheus 继续负责采集、服务发现和规则计算,通过 Remote Write 将指标写入 VictoriaMetrics。
- 多 Kubernetes 集群统一监控:多个 Kubernetes 集群分别部署 Prometheus 或
vmagent,统一将指标写入 VictoriaMetrics。 - 高基数和高 churn 指标:它面向 APM、Kubernetes、IoT、工业遥测、金融数据等具有不同 churn 特征的时序场景。
- 多租户指标平台:企业内部多个部门或业务线共享统一指标平台时,可以使用 VictoriaMetrics 集群的租户机制,对不同租户的数据进行路由和隔离。
- 指标数据长期归档与容量分析:VictoriaMetrics 可用于保存较长时间的基础设施和业务指标。
VictoriaMetrics 并不是所有监控系统的必选组件,不适合直接引入的场景:
- 监控规模很小:如果只监控少量主机和服务,Prometheus 本地保留十几天已经满足需求,引入 VictoriaMetrics 可能只会增加新的运维对象。
- 需求主要是日志全文检索:VictoriaMetrics Metrics 主要处理指标数据,不是日志全文检索系统。
- 需求主要是分布式链路追踪:如果需要分析 Trace、Span、调用树、服务依赖关系和单请求路径,应使用专门的 tracing 后端。
六、VictoriaMetrics 部署使用
单机启动:
arduino
//下载对应操作系统和架构的安装包并解压
//运行,该参数会让 VictoriaMetrics 定期抓取自身指标
./victoria-metrics-prod -selfScrapeInterval=10s

//启动后默认监听端口8428
//访问 VMUI
http://localhost:8428/vmui
配置 Prometheus Remote Write:
ruby
//在 Prometheus 配置中添加
//Prometheus 继续负责抓取指标,并将采集结果远程写入 VictoriaMetrics。

remote_write:
  - url: http://victoria-metrics:8428/api/v1/write
Grafana 接入:
arduino
//在 Grafana 中新增 Prometheus 类型的数据源,配置 URL

http://victoria-metrics:8428

//继续使用 PromQL 或 MetricsQL 查询指标
常用单机版参数:
arduino
//指定数据存储目录
-storageDataPath

//设置数据保留周期
-retentionPeriod

//设置 VictoriaMetrics 抓取自身指标的间隔
-selfScrapeInterval
在进入生产环境前,至少需要回答以下问题:
markdown
1. 数据需要保留多久?
2. 每秒写入多少样本?
3. 活跃时间序列数量是多少?
4. 标签基数是多少?
5. 查询高峰是什么模式?
6. 是否需要多租户?
7. 是否需要跨可用区容灾?
8. 备份恢复的 RPO 和 RTO 是多少?
小规模生产:
markdown
  vmagent / Prometheus
            │
            │ remote_write
            ▼
  VictoriaMetrics 单机版
            │
            ├──> Grafana
            ├──> VMUI
            ├──> 定期快照或备份
            └──> 自监控
大规模部署:
markdown
  写入链路:

  Load Balancer
        │
        ▼
  vminsert × N
        │
        ▼
  vmstorage × N

  查询链路:

  Grafana / VMUI
        │
        ▼
  Load Balancer
        │
        ▼
  vmselect × N
        │
        ▼
  vmstorage × N