作者:来自 Elastic Matthew Adams
一条 Elasticsearch 查询就能找出被人粘贴到生成式 人工智能 提示词中的专利段落,并在原文和提示词中高亮显示复制的文字,让审核人员在几秒内看清哪些内容流出了公司。
Elasticsearch 提供了丰富的新功能,帮助你针对自己的使用场景构建最佳搜索解决方案。参加我们的构建现代搜索人工智能体验实操网络研讨会,了解如何运用这些功能。你也可以立即开启免费云试用,或在你的本地计算机上试用 Elastic。
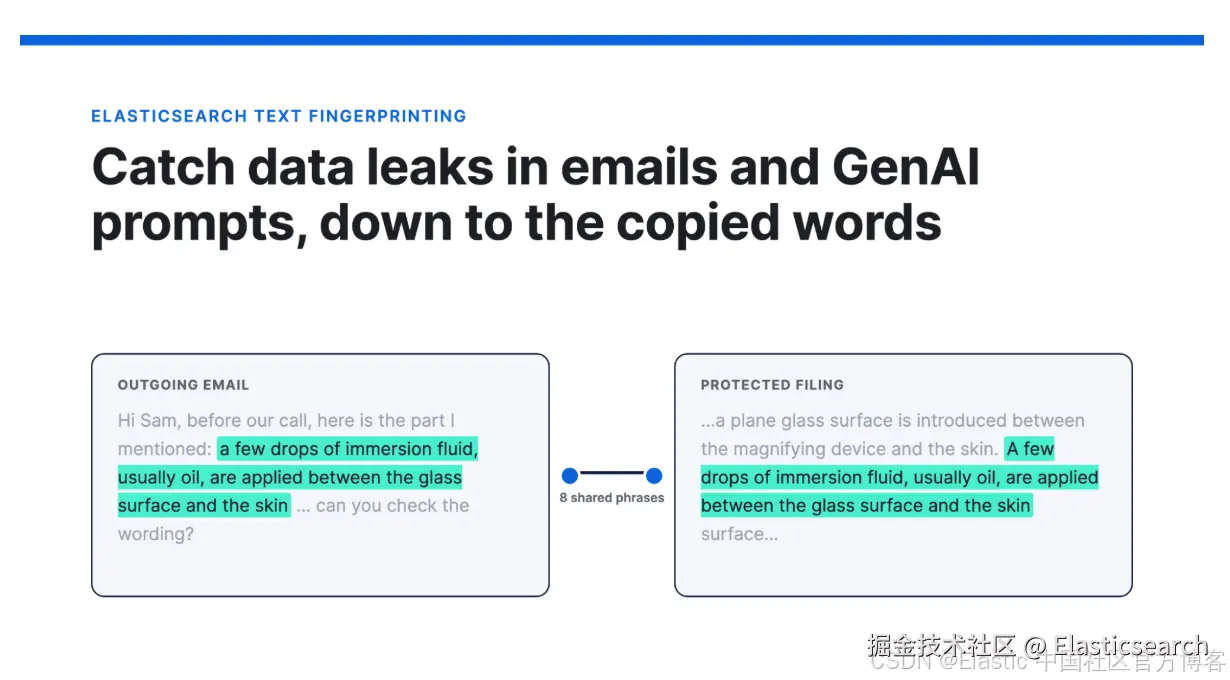
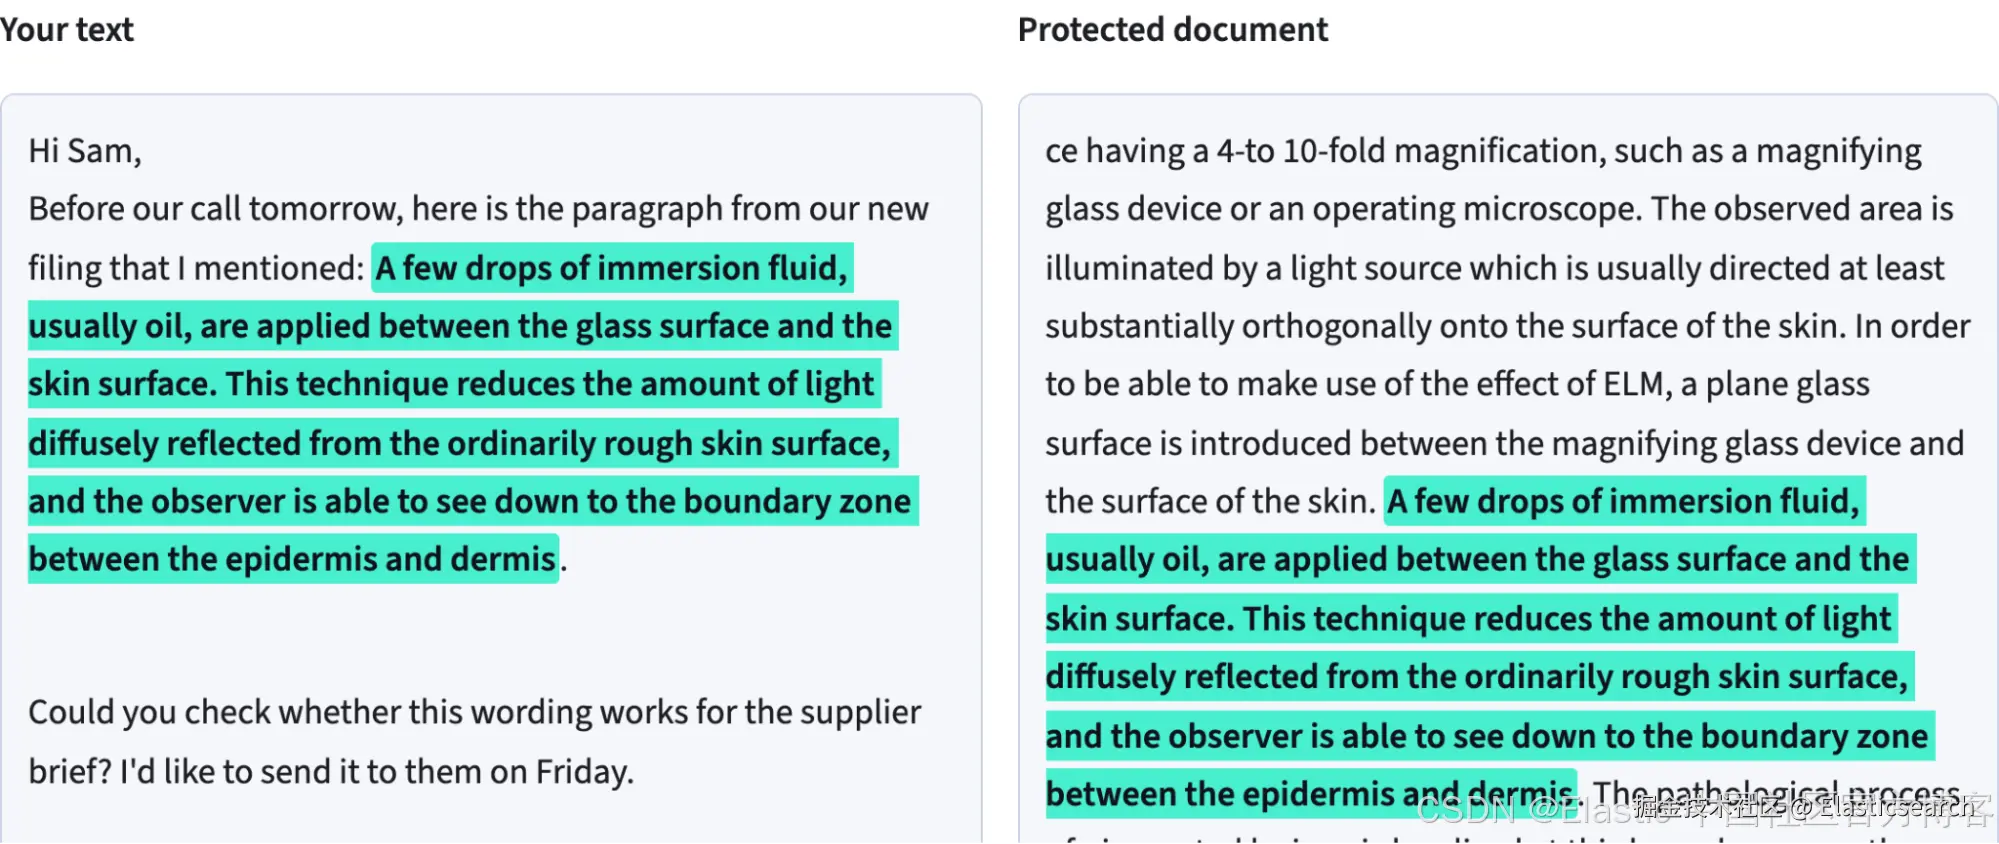 图1:一封外发电子邮件,其中复制的段落已高亮显示,旁边是该段落来源的受保护申报文件。此图由本文配套演示生成,其中的姓名和电子邮件均为虚构。
一名工程师从尚未公开的专利申请文件中复制了三句话,将其粘贴到发给供应商的电子邮件中,或粘贴到生成式人工智能(generative AI)聊天中润色措辞。消息中没有任何内容被标记为机密,其余内容也很普通。你能在消息中找出这三句话,并展示哪些文字来自哪份受保护文档吗?借助一种称为_文本指纹识别_的技术,Elasticsearch 可以利用其内置的文本分析功能检测这类数据泄露。图1展示了检测结果,电子邮件和受保护申请文件中被 复制的 文字均已高亮显示。
泄露检测只是查找复制文本这一通用能力的一种用途。文本指纹识别可以针对任意文本回答两个问题,而且都使用同一个索引:
- 第一个是_匹配_(或复制检测):这段文本是否包含从某份已知文档中复制的段落?_以及_具体是哪一段?这涵盖了泄露、抄袭和近重复文档检测,也包括在法律证据开示或执法调查中,从大量文档中找出某项合同条款或某份已知备忘录出现的位置。
- 第二个是_分类_:*这段文本使用了哪种已知模板或固定套话?*相同的免责声明可以帮助识别发送者,而相同的网络钓鱼模板可以将数千条消息关联到同一次攻击活动。
如果你已经在使用 Elasticsearch,简要做法如下:使用一个将文本切分为相互重叠的八词短语的分析器,为受保护文档建立索引,再通过普通的 match 查询检查新文本。以下内容简化自演示中的 mappings/index.json 和 check.py:
bash
`
1. PUT protected-docs
2. {
3. "settings": {
4. "analysis": {
5. "filter": {
6. "shingle_8": {"type": "shingle", "min_shingle_size": 8, "max_shingle_size": 8, "output_unigrams": false}
7. },
8. "analyzer": {
9. "fingerprint_8": {"type": "custom", "tokenizer": "standard", "filter": ["lowercase", "asciifolding", "shingle_8"]}
10. }
11. }
12. },
13. "mappings": {
14. "properties": {
15. "body": {"type": "text", "analyzer": "fingerprint_8", "index_options": "offsets", "norms": false}
16. }
17. }
18. }
21. GET protected-docs/_search
22. {
23. "query": {"match": {"body": {"query": "<the whole outgoing email>"}}},
24. "highlight": {"fields": {"body": {"type": "unified", "number_of_fragments": 0}}}
25. }
`AI代码解释如果你更喜欢使用 Elasticsearch 查询语言(ES|QL),可以通过 MATCH 函数执行相同的检查。其选项包括 minimum_should_match,用于指定所需的共有短语数量。(参见匹配规则:多少个共有短语才算复制。)从客户端将消息作为 ?email 查询参数传入:
sql
`

1.  FROM protected-docs METADATA _score
2.  | WHERE MATCH(body, ?email, {"minimum_should_match": 3})
3.  | SORT _score DESC
4.  | KEEP title, _score
5.  | LIMIT 10

`AI代码解释
本文将介绍它的工作原理、你可以调整的设置、适用场景,以及如何通过演示进行尝试。
文本指纹识别如何工作?
文本指纹识别是一种复制检测技术。它将文档切分为词数固定且相互重叠的短语,并为每个短语建立索引,因此,任何包含相同短语的文本都能追溯到其来源文档。整个过程分为三个步骤:
1. 规范化文本(Normalize the text.)。 文档不同版本之间的空白字符、标点和字母大小写很容易发生变化,因此这些差异不应影响匹配。
2. 将文本切分为词数固定且相互重叠的短语(本文采用八个词)。下面是图1中某个句子的开头:
markdown
`

1.  a few drops of immersion fluid usually oil are applied ...

3.  → "a few drops of immersion fluid usually oil"

5.  → "few drops of immersion fluid usually oil are"

7.  → "drops of immersion fluid usually oil are applied"

`AI代码解释
每个短语都是文档指纹的一部分。八词短语足够独特,两个无关文本很少会偶然包含相同的短语,因此,一个共有短语就是一条线索,而连续多个共有短语则是复制行为的有力证据。
- 在新文本中查找相同的短语。两段文本如果包含相同的段落,也就包含该段落中的相同短语,无论该段落位于各自文本的什么位置。因此,长邮件中引用的三句话,与单独出现的同样三句话都能匹配。
细微修改只会破坏包含修改内容的短语。如果有人在一段 20 词的文本中改动了一个词,最多会有八个包含该词的短语不再匹配,而两侧的短语仍然能够匹配:
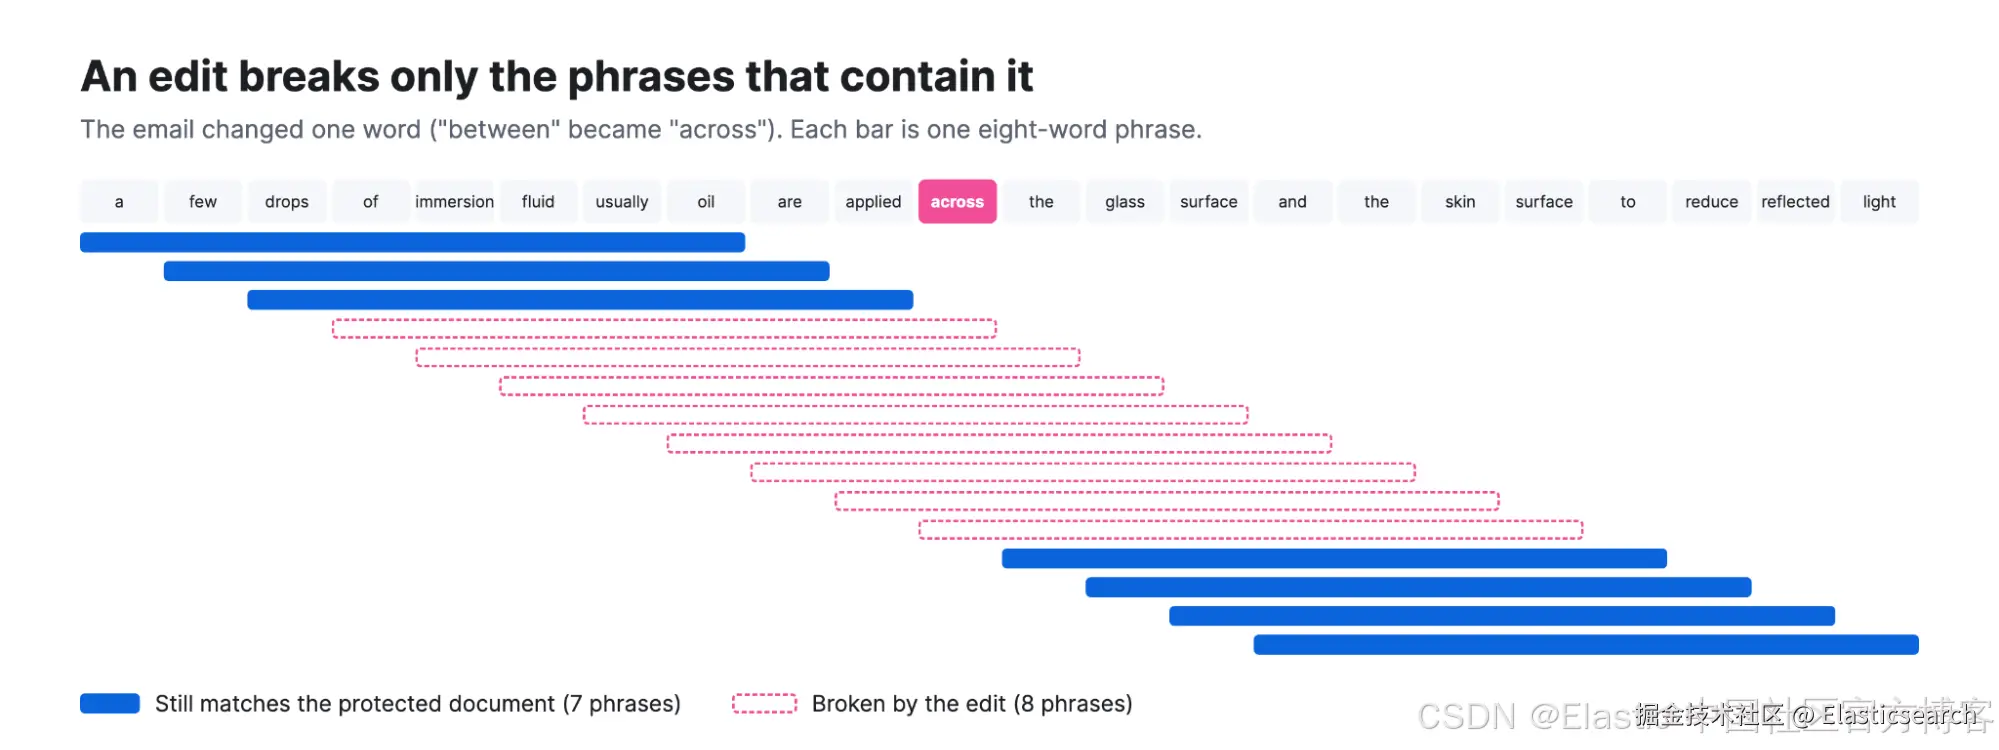 图2:一处修改只会使包含该修改的短语失去匹配。
想象一页从书中撕下的纸。即使纸上有几个词模糊不清,你仍可以通过查找连续相同的词语,找到它出自哪本书。主题和风格帮不上太多忙,因为很多书都涉及相同主题,所以真正指向来源的是连续相同的词语。
如何在 Elasticsearch 中实现文本指纹识别
Elasticsearch 已具备所需的基础组件。它的分析器会将文本转换为索引存储和查询查找的词项,因此,自定义分析器可以在文档建立索引和检查消息时直接生成这些短语。
使用词组分析器为受保护文档建立索引
标准分词器(standard tokenizer)将文本切分为单词并移除标点,小写转换(lowercase)和美国信息交换标准代码字符折叠(asciifolding)过滤器则消除大小写和重音符号的差异,因此,"浸液,通常为油"的不同英文大小写和标点写法会生成相同的短语。随后,词组词元过滤器(shingle token filter)将每八个连续单词合并为一个词项。演示中的 mappings/index.json 使用这些组件定义了两个分析器:用于建立索引的 fingerprint_8,以及用于查询的 fingerprint_8_search,后者还添加了一个用于排除固定套话的停用词表:
bash
`
1. {
2. "settings": {
3. "analysis": {
4. "filter": {
5. "shingle_8": {
6. "type": "shingle",
7. "min_shingle_size": 8,
8. "max_shingle_size": 8,
9. "output_unigrams": false
10. },
11. "boilerplate_stop": {
12. "type": "stop",
13. "stopwords": "_none_"
14. }
15. },
16. "analyzer": {
17. "fingerprint_8": {
18. "type": "custom",
19. "tokenizer": "standard",
20. "filter": ["lowercase", "asciifolding", "shingle_8"]
21. },
22. "fingerprint_8_search": {
23. "type": "custom",
24. "tokenizer": "standard",
25. "filter": ["lowercase", "asciifolding", "shingle_8", "boilerplate_stop"]
26. }
27. }
28. }
29. },
30. "mappings": {
31. "properties": {
32. "body": {
33. "type": "text",
34. "analyzer": "fingerprint_8",
35. "search_analyzer": "fingerprint_8_search",
36. "index_options": "offsets",
37. "norms": false
38. }
39. }
40. }
41. }
`AI代码解释有两个字段选项很重要。index_options: offsets 会存储每个短语的字符位置,让高亮器能够显示被复制的文字。而 norms: false 会阻止文档长度影响评分,因为无论一段短文被复制到长文档还是短文档中,都同样属于复制。
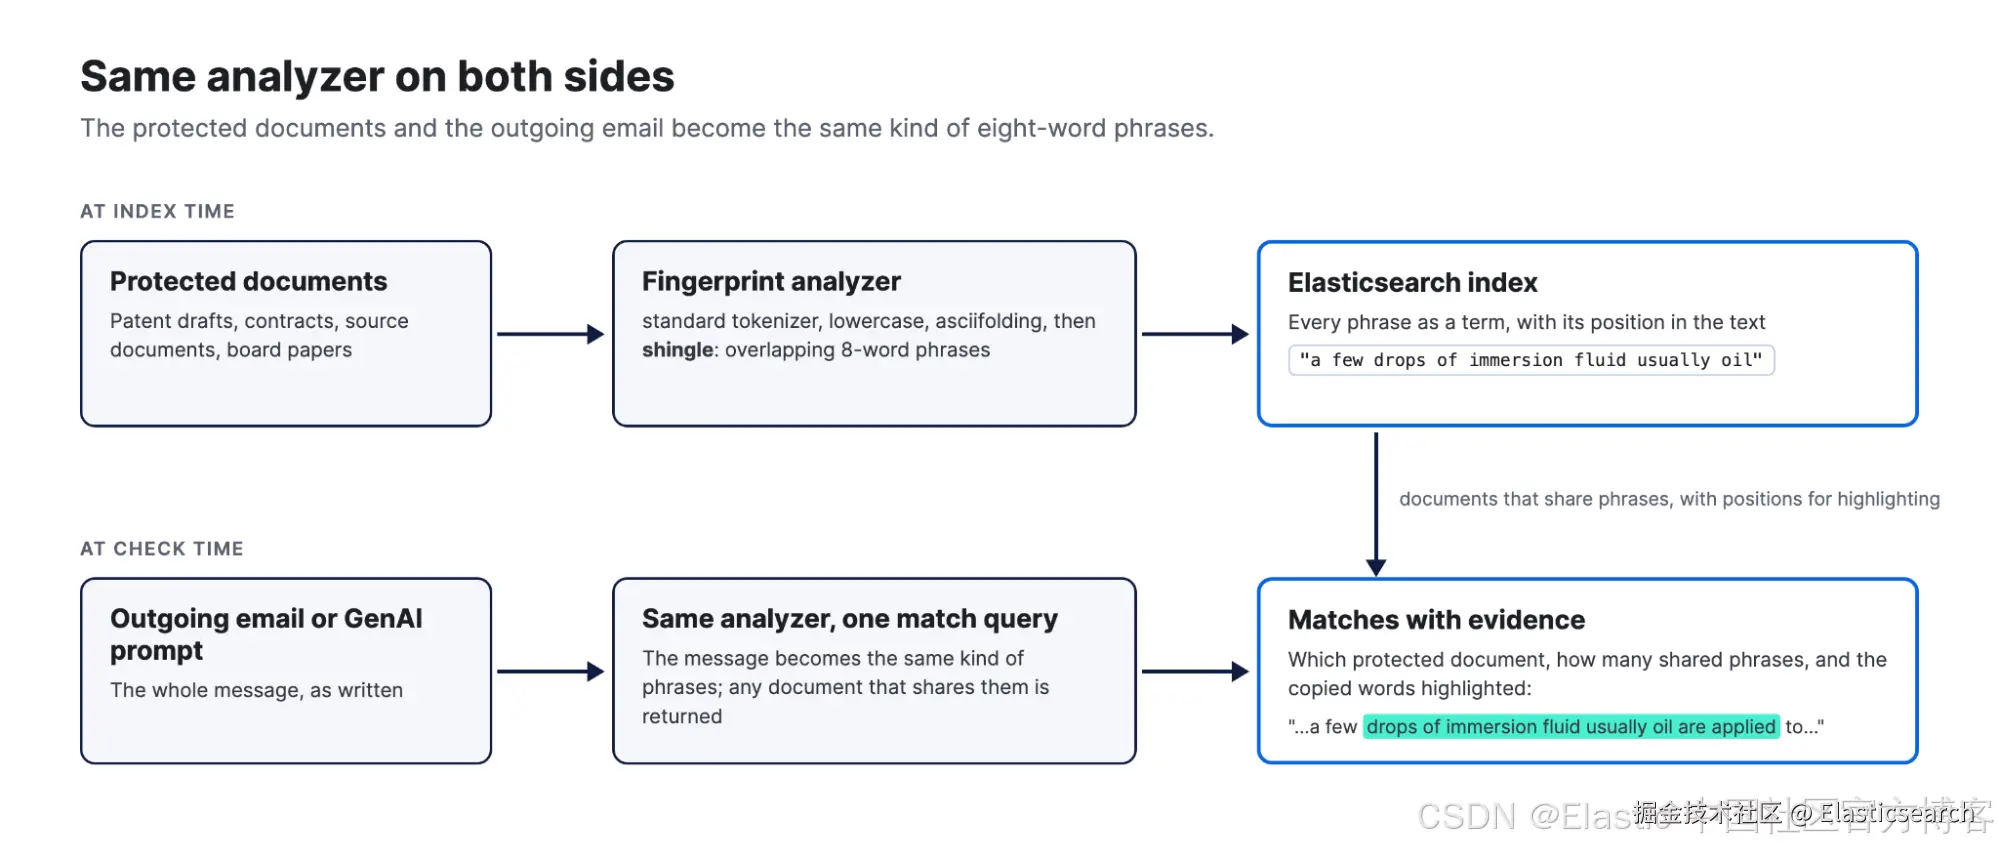 图3:同一个短语生成分析器会在受保护文档建立索引时处理文档,并在检查消息时处理消息。
使用一条匹配查询检查消息
检查时,通过一条匹配查询(match query)发送整条消息。搜索分析器会将消息切分为相同的短语,并返回至少包含其中一个短语的受保护文档,匹配程度最高的排在最前面:
vbnet
`

1.  GET protected-docs/_search
2.  {
3.    "query": {"match": {"body": {"query": "<the whole message>"}}}
4.  }

`AI代码解释
如果需要更多证据,可以使用 minimum_should_match,将匹配门槛从一个共有短语提高到至少指定数量的共有短语:
vbnet
`

1.  GET protected-docs/_search
2.  {
3.    "query": {"match": {"body": {"query": "<the whole message>", "minimum_should_match": 3}}}
4.  }

`AI代码解释
如果消息中重复出现某个短语,查询会将每次出现都计入。因此,在触发告警之前,应统计每份返回文档与消息共有的不同短语数量,并找出最长的连续复制片段。匹配查询会返回文档和高亮内容;统计不同短语和查找最长连续片段,则需要基于分析应用程序编程接口编写少量客户端代码,具体可参考演示中的 check.py。搜索只会返回少量文档,因此这项检查增加的工作量很小。
使用统一高亮器显示被复制的文字
对于每份匹配的文档,统一高亮器(unified highlighter)会返回受保护文本,并标记每个共有短语。在同一个搜索请求中添加 highlight 块;将 number_of_fragments 设为0时,它会返回整个字段,而非简短片段:
css
`

1.  GET protected-docs/_search
2.  {
3.    "query": {"match": {"body": {"query": "<the whole message>", "minimum_should_match": 3}}},
4.    "highlight": {
5.      "fields": {"body": {"type": "unified", "number_of_fragments": 0}}
6.    }
7.  }

`AI代码解释
高亮器使用索引中存储的偏移量,标记每份匹配文档中被复制的文字。对于图1中的电子邮件,响应包含以下内容(此处已简化):
css
`

1.  "highlight": {
2.    "body": ["... introduced between the magnifying glass device and the surface of the skin. <em>A few drops of immersion fluid, usually oil, are applied between the glass surface and the skin surface</em>. This technique reduces the amount of light ..."]
3.  }

`AI代码解释要在消息中标记相同的文字,请通过分析应用程序编程接口(analyze API),使用同一个分析器处理消息。该接口会返回每个短语及其字符偏移量。如图1所示,同时呈现两侧的证据,能让审核人员快速做出判断。
使用停用词忽略固定套话
有些短语出现在许多文档中,原因与复制毫无关系,例如免责声明、签名、标准标题,以及"应当理解,不存在......"之类的惯用表达。在泄露检查中,它们会导致误报,因为电子邮件与受保护文档包含相同的页脚,并不意味着发生了泄露。
Elasticsearch 可以在查询时通过停用词元过滤器(stop token filter)忽略词项。它通常用于处理英文定冠词和表示"和"的连词等单个词,但也适用于完整的八词短语。请仅将其放在搜索分析器的末尾,就像上述映射中的 fingerprint_8_search 那样。索引会保留每个短语,因此同一批文档仍可用于分类,而泄露检查不会查询列入停用词表的短语。
要构建该列表,先找出在许多文档中出现的短语。随机抽取一批文档,通过多文档词项向量应用程序编程接口(multiple term vectors API)读取其中存储的短语,然后统计每个短语出现在多少份样本文档中。演示中的 boilerplate.py 用一个简短的脚本完成了这项工作。将出现频率最高的短语作为候选,再通过一次过滤器聚合,精确统计它们在整个索引中的文档出现次数:
bash
`
1. GET protected-docs/_search
2. {
3. "size": 0,
4. "aggs": {
5. "common": {
6. "filters": {
7. "filters": {
8. "of the invention the present invention relates to": {"term": {"body": "of the invention the present invention relates to"}},
9. "brief description of the drawings fig 1 is": {"term": {"body": "brief description of the drawings fig 1 is"}}
10. }
11. }
12. }
13. }
14. }
`AI代码解释每个桶的 doc_count 表示包含该短语的文档数量。在演示的2,000份专利文档中,最常见的短语 "本of the invention the present invention relates to," 出现在295份文档中。如果某个短语出现的文档数量超过你选定的阈值,就将其加入停用词表。也请添加你自己的固定套话,例如电子邮件页脚和免责声明,因为这些短语会同时出现在你的传输内容和文档中。
json
`

1.  "boilerplate_stop": {
2.    "type": "stop",
3.    "stopwords": [
4.      "of the invention the present invention relates to",
5.      "brief description of the drawings fig 1 is"
6.    ]
7.  }

`AI代码解释
然后,根据你是否仍需使用固定套话进行分类,选择以下一种方式应用:
- 仅应用于搜索分析器。(Search analyzer only.) 更新现有索引上的停用词表。索引会保留每个短语,因此下文的分类查询仍然有效。演示中的**应用(Apply)**按钮执行的就是这项操作。
- 同时应用于索引分析器。(Index analyzer, too.) 将过滤器添加到索引分析器,创建新索引,通过重建索引应用程序编程接口(reindex API)将文档复制过去,再让检查指向新索引,例如通过切换别名实现。列入停用词表的短语将不再建立索引,因此索引会更小,但你也无法再统计这些固定套话来进行分类。
在我们的测试中,一次仅包含最常见短语的检查,在应用停用词表之前匹配了295份文档,应用之后则没有匹配任何文档;而同样的检查使用索引分析器时,仍能匹配全部295份文档。实际使用时,请先在非生产环境的数据副本上构建并审核停用词表,再使用它创建生产索引。我们测试过包含数百个短语的停用词表。当模板或页脚发生变化时,请重新审核该列表,因为列入其中的短语将无法再用于查找匹配。
对于以固定套话为识别信号的分类任务,请使用索引分析器查询同一个索引,这样就不会应用停用词表:
css
`{"match": {"body": {"query": "<the message>", "analyzer": "fingerprint_8"}}}`AI代码解释调整文本指纹识别:短语长度和匹配规则
两个设置决定哪些情况算作匹配:短语长度和匹配规则。(停用词表已在使用停用词忽略固定套话(Use stop words to ignore boilerplate phrases)中介绍。)两者都需要在检出复制内容的能力与误报数量之间进行权衡。
短语长度:5个、8个或12个词
短语长度由分析器中的 min_shingle_size 和 max_shingle_size 这对参数设置:
- 较短的短语(约五个词)能发现更短的复制内容,也能在改动较多时保持匹配,但普通短语偶然匹配的概率也更高,因此应搭配更严格的匹配规则。
- 在本演示中,八个词的效果良好,可作为合理的起点,但仍应根据你的使用场景调整长度。
- 较长的短语(约12个词)偶然匹配的概率较低,但需要更长的连续未修改文本才能匹配。
短语长度属于索引分析器的配置,因此更改它意味着需要重建索引。在确定长度之前,请用你自己的文档和传输内容样本测试两到三种长度。
匹配规则:多少个共有短语才算复制
匹配规则是你最常调整的设置:
| 规则(Rule) | 能检出什么(What it catches) | 代价(What it costs) |
|---|---|---|
| 任意一个共有短语 | 较短及经过轻微修改的复制内容 | 惯用表达也会触发匹配,且误报会随受保护文档集扩大而增加 |
| 至少三个共有短语 | 20个词及以上的复制内容,包括经过轻微修改的内容 | 误报远少于"任意一个共有短语"规则 |
| 5--10个共有短语 | 较长的复制内容 | 会漏掉经过修改的短小复制内容 |
| 连续复制16个词及以上 | 逐字复制的段落 | 连续片段中的任何修改都会打断匹配 |
对于泄露检测,采用两级规则效果较好。宽松规则(例如至少三个共有短语)将结果送入审核队列,并检出经过修改的复制内容。严格规则(例如连续复制16个词)则针对逐字复制的内容发出高置信度告警,这类告警几乎无需审核。为初步验证效果,我们使用安然电子邮件数据集(Enron Email Dataset)中的真实邮件,对照最多174,000份专利文档进行了测试。"至少三个"规则检出了我们插入的所有专利段落,包括每隔约12个词就改动一个词的段落;同时,每1,000封未复制任何内容的邮件中,约有1.2封被误报。如果每天处理100,000条消息,仍意味着约120次审核,因此请在选择规则前使用你自己的数据进行评估。
使用场景:数据泄露、抄袭、法律证据开示和网络钓鱼
文本指纹识别能够容忍修改,同时保持较低的误报率。它还能显示匹配内容来自哪份文档,以及哪些文字被复制。
| 使用场景(Use case) | 需要回答的问题(The questions) | 建立索引的内容(What you index) | 建议起点(A starting point) |
|---|---|---|---|
| 电子邮件、聊天和生成式人工智能提示词中的数据泄露 | 受保护文本是否外流?具体是哪些文字? | 你的受保护文档 | 八词短语,至少三个共有短语,并以连续16个词的复制片段触发高置信度告警 |
| 抄袭和近重复内容,包括检索增强生成(retrieval augmented generation)之前的去重 | 这段内容是否被重复使用?来自哪里? | 来源文档或文档集本身 | 较短的短语,搭配更严格的匹配规则 |
| 法律证据开示和调查 | 这份已知文档或条款还出现在哪些地方? | 待审查的文档集 | 八词短语,每个已知段落执行一次搜索 |
| 模板和分类,例如网络钓鱼 | 这段文本使用了哪种已知模板? | 已知模板和固定套话 | 使用索引分析器统计固定套话 |
- 数据泄露。(Data leakage.) 在依赖知识产权的行业中,安全和内部风险团队需要知道受保护文本何时通过电子邮件、聊天或工单外流,以及何时通过粘贴到生成式人工智能工具中的提示词外流。受保护文档集可能包含专利草稿、合同、源文档或董事会文件。Elasticsearch 负责匹配,但文本必须先送达,例如通过邮件网关的日志,或生成式人工智能工具前置代理的日志。数据防泄露产品负责覆盖各类渠道、终端 agent 以及策略执行,而文本指纹识别可为该工作流补充来自你自己文档的段落级证据。
- 抄袭和近重复检测。(Plagiarism and near duplicate detection.) 如果你想检查提交的文档等作品是否包含未注明出处的其他作品内容,就可以轻松检测出来自教科书或此前提交作品等来源的内容。
- 法律和调查文档集。(Legal and investigative collections.) 假设你掌握了一批能够揭露犯罪或证明案情的文档。你需要知道还有谁持有完整或部分副本,但你手中只有硬盘镜像,其中包含数千乃至数百万封电子邮件和各种格式的文档。文本指纹识别可以在如此大规模的数据中查找局部匹配,每个已知段落执行一次搜索,也可以通过多重搜索应用程序编程接口(multiple search API)同时搜索多个段落。一次_匹配_就是一串连续相同的词语,无需模型参与,因此你可以向审核人员准确展示触发原因。文本必须先提取出来,对于扫描文档,这意味着需要进行光学字符识别。
- 模板和分类。(Templates and classification.) 查找泄露时,固定套话是噪声;对文本分类时,它则是识别信号。假设收到一封新邮件,其中有多个短语经常出现在你的网络钓鱼索引中,却很少出现在正常邮件中。这些指纹就能发挥分类器的作用。它们无法断定某封邮件一定属于网络钓鱼,但可以将其标记为待审核,同时避免仅凭单个短语告警带来的误报。
监测近期消息中是否出现已知文本
大多数此类检查都是用一条消息搜索多份受保护文档。你也可以反过来:使用同一个分析器为消息建立索引,再定期用一段已知文本搜索最新消息。这适用于少量高价值文本,例如正在传播的网络钓鱼模板,或你想追查的泄露段落。它也适用于绝不应流出公司的免责声明。
bash
`
1. GET messages/_search
2. {
3. "query": {
4. "bool": {
5. "must": [{"match": {"body": {"query": "<the known text>", "minimum_should_match": 3}}}],
6. "filter": [{"range": {"@timestamp": {"gte": "now-15m"}}}]
7. }
8. },
9. "highlight": {"fields": {"body": {"type": "unified", "number_of_fragments": 0}}}
10. }
`AI代码解释在 Elastic 云无服务器版(Serverless)的一次测试中,该查询返回了最近15分钟内引用网络钓鱼模板的邮件,并高亮显示复制的文字,同时忽略了五小时前发送的相同模板和一封无关邮件。Kibana Elasticsearch 查询规则(Kibana Elasticsearch query rule)可以定期运行 match 部分,并在 @timestamp 上应用自己的时间窗口,在消息匹配时发出告警。我们测试了该查询,而规则配置可作为你调整的起点。这种模式是在消息发出后进行检测;要实现拦截,则需要一个策略执行点,例如在发送前先运行检查的邮件网关。
在受监管行业中保护生成式人工智能 提示词
银行、保险公司、制药企业和律师事务所希望团队使用前沿模型,但也需要控制哪些内容可以流出组织,并向审计人员证明自己确实实施了这些控制。提示词也是一种外发消息,因此可以在模型前执行相同的检查。
在生成式人工智能提示词离开公司前进行检查
在用户的聊 天工 具与模型提供商之间部署代理。对于每个请求,代理都通过相同的匹配查询将用户文本发送到 Elasticsearch,只有在没有匹配到受保护文档时才转发请求。使用你信任的匹配规则进行拦截,例如"应用固定套话停用词表后,至少有三个共有短语",并记录较弱的匹配以供审核。请检查每条消息的文本,因为客户端会随每个请求发送完整历史记录。我们建议在检查本身失败时也拦截请求。
演示包含一个小型代理 proxy.py,它只是示意实现,并非生产级网关。该代理在兼容 OpenAI 风格的聊天端点后执行上述检查,并通过 Elasticsearch 推理(Inference)应用程序编程接口,将允许通过的提示词转发给模型。
在演示数据中,使用"至少三个共有短语"作为规则时:
- 包含20--80个词的复制段落的提示词中,有99%至100%被标记,包括经过轻微修改的段落。
- 200封普通邮件均未被标记。
- 未收录在索引中的专利文本有12%被标记,主要由惯用表达造成,因此包含大量固定套话的文档集需要停用词表。
如果有人或另一个模型事先改写了段落,该方法就无法检测。这是复制检测的局限,因此应搭配其他控制措施。每个提示词的检查会额外向 Elasticsearch 发出几个请求,因此请将拦截集群部署在靠近代理的位置,以保持较低延迟。
将指纹识别与针对已知词项的反向查询匹配规则结合使用
指纹识别用于检测复制的段落。但许多策略针对的是已知词项,例如项目代号、客户姓名或账号格式。反向查询匹配器(percolator)将这些规则存储为查询,并在一次请求中使用所有规则检查每条消息。在同一集群中对同一条消息执行两种检查,代理便能获得一个包含双方证据的判定结果。
保留提示词和判定的审计记录
监管机构有时会在数年后询问:发送了什么、由谁发送,以及哪些内容被拦截。Elasticsearch 很适合长期存储这些记录。将每条提示词、响应、判定和匹配文档写入数据流(data stream),并将近期数据保留在快速存储中。通过索引生命周期管理将较旧数据迁移到更便宜的存储层级(在无服务器版中,由数据流生命周期管理保留期限),再使用 ES|QL 和 Kibana 仪表板进行分析。为这两项任务分别使用独立集群:
- **拦截集群(A blocking cluster)**保存受保护文档,并实时响应代理。它保持较小规模,并针对低延迟进行优化。
- **审计集群(An audit cluster)**按你所需的期限保留聊天历史记录。它针对数据保留和分析进行优化,并严格限制访问,因为其中包含的正是你要保护的文本。
代理可以自行写入审计记录,你也可以通过开放遥测发送。部分大语言模型(large language model)网关和软件开发工具包原生支持导出生成式人工智能遥测数据。Elastic 可以通过开放遥测协议接收这些数据:在 Elastic 云上使用托管开放遥测协议端点,自托管时则使用 Elastic 开放遥测发行版收集器。开放遥测中的提示词和响应内容记录通常需要主动启用,因此请审慎开启。
文本指纹识别为何能在 Elasticsearch 中扩展
Elasticsearch 的倒排索引专为快速回答一个问题而构建:*哪些文档包含这个词项?*指纹识别恰好将复制检测转换成了这个问题,只是使用八词短语作为词项。一次检查就是一次搜索,因此,它可以像你的其他搜索一样扩展:在自托管 Elasticsearch 或 Elastic 云托管版中使用分片和副本,在无服务器版中则通过自动扩缩容(autoscaling)扩展。
有三项因素会随数据规模增长:
- 索引会随着受保护文本的增加而增长。(The index grows with the protected text.) 每个词的位置都会生成一个新短语,每个短语都会连同偏移量一起存储,因此索引大小是原始文本的数倍。我们对174,000份专利文档强制合并后,索引大小约为原始文本的四到五倍,其中包含存储的源文档。小型索引或尚未合并的索引可能更大,因此请使用你自己的数据测量。
- 每条查询都会为传入消息中的每个短语生成一个子句(Each query has one clause per phrase in the incoming message),因此检查长消息的开销高于短消息。非常长的消息可能达到单条查询的子句数量上限,Elasticsearch 会根据各节点的堆大小和搜索线程池确定该上限。
- 误报概率会随着受保护文档集的规模增大而上升(The chance of a false alarm grows with the size of the protected set),因为文档越多,偶然共有的普通短语也越多。匹配规则可以控制这种情况。
在笔记本电脑上的单个节点中,当受保护文档集从1,000份专利扩大到174,000份时,查询耗时没有明显变化,无服务器版也产生了相同的误报。
运行成本:存储、调优和索引安全
请为以下持续性成本做好规划:
- 大小为受保护文本数倍的存储空间。
- 起步时需要一个映射和一条查询,之后需要调整匹配规则和停用词表,并安排专人负责两者及审核告警。
- 保护受保护文档索引本身。它包含敏感文本,因此应像保护源文档一样保护它。限制读取权限,包括词项向量的读取权限,并将其纳入备份策略。
文本指纹识别与语义搜索、文件哈希的比较
指纹识别和语义搜索回答不同的问题。指纹识别_查找_相同的词语,这正是证明复制行为所需的证据。_语义搜索_则查找表达_相同概念_的文本,这是大多数搜索体验所需要的。
文件哈希是第三种选择,三者在能找到什么、能展示什么方面有所不同:
| 比较项 | 文本指纹识别(Text fingerprinting) | 语义搜索(Semantic search) | 文件哈希:消息摘要算法第五版(File hashes (MD5)) |
|---|---|---|---|
| 查找内容 | 连续相同的词语 | 相似含义 | 完全相同的文件 |
| 修改后是否仍能匹配 | 可以,部分修改不影响 | 可以 | 不可以 |
| 能否找到改写文本 | 不可以 | 可以 | 不可以 |
| 需要调整的阈值 | 共有短语数量或连续片段长度 | 相似度评分 | 无 |
| 展示的证据 | 高亮显示复制的文字 | 一个评分 | 仅表明文件相同 |
| 主题重合导致的误报 | 低 | 高 | 无 |
这种差异对误报尤为重要。在语义搜索中,每份文档都与查询存在某种程度的相似性,因此检查总会返回一些结果,难点在于选择相似度阈值。阈值设得低,每封与专利主题相同的邮件都会触发告警;阈值设得高,较短的复制段落就会漏过,因为三句话的引用几乎不会改变一封长邮件的整体含义。指纹识别提供了可以理解和解释的阈值,例如共有短语的数量或连续复制的词数,而且审核人员可以看到高亮显示的对应内容。
当文本被改写、总结或翻译时,语义搜索是合适的工具,因为这些文本含义相同,但完全一致的短语很少。这两种技术相辅相成,可以通过混合搜索结合使用,例如用指纹识别提供复制证据,用语义搜索寻找改写内容的线索。
文本指纹识别无法检测哪些内容
指纹识别可以找到复制和经过轻微修改的文本,但无法找到经过大幅改写、总结或翻译的文本。短于短语长度的文本不会生成任何短语,因此永远无法匹配。
了解检查机制的人可以绕过它。以下每种情况都会减少或消除共有短语:
- 每隔几个词替换一个词。
- 将一个段落拆分到多条消息中。
- 将字母替换为其他字母表中外观相似的字符。
- 以图片或未被提取内容的附件形式发送文本。
指纹识别很适合检查常见的复制粘贴行为;如果你担心有人刻意规避检查,请将其与其他控制措施结合使用。
消息长度也存在实际限制,包括:
- 分析应用程序编程接口词元上限。(Analyze API token limit.) 默认每个请求最多10,000个词元,因此演示检查的消息最长约为9,000个词。
- 查询子句上限。(Query clause limit.) 每次检查都会为消息中的每个短语生成一个子句,因此非常长的消息可能超过 Elasticsearch 根据节点堆大小和搜索线程池确定的上限。
- 堆大小。(Heap size.) 使用1吉字节堆时,约4,000词的消息处理失败,而2,000词的消息可以正常处理;8吉字节堆则能够处理这些消息。
我们的测试使用了单节点上的一个分片和一个无服务器版项目,文档数量最多为174,000份,测试内容是用邮件匹配专利文档。请将扩展性测试结果视为该方法可行的迹象,而非容量规划指南。
试用演示
本文配套演示是一个带有网页界面的小型 Python 应用程序。它使用前文展示的映射,将2,000份专利说明和八个虚构的网络钓鱼模板加载到索引中。你可以粘贴任意文本,查看其中复制了哪些受保护文档的内容,并在两侧高亮显示复制的文字。
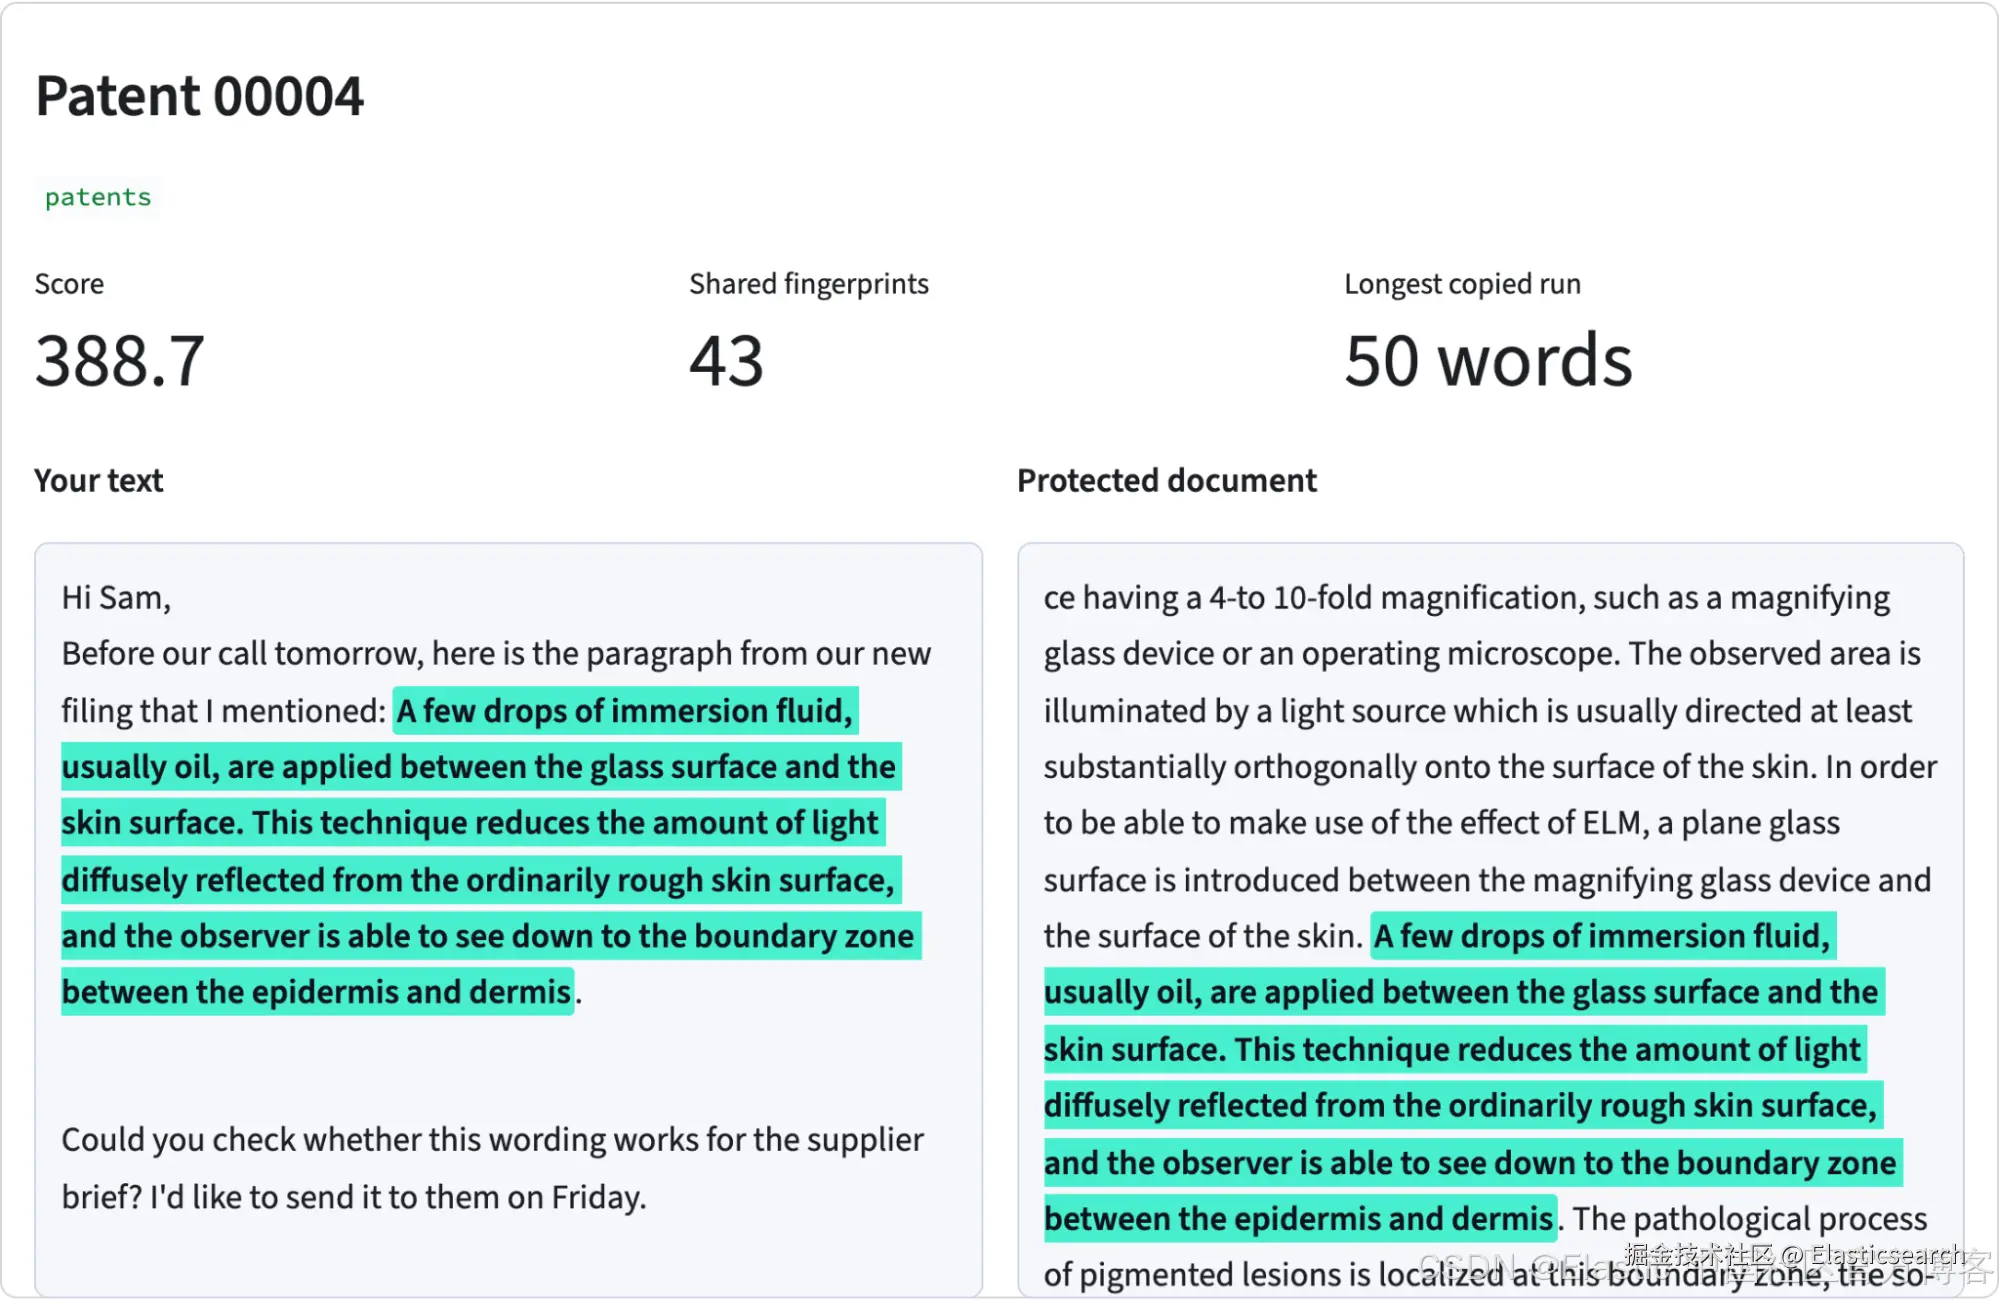 图4:演示在两侧显示被复制的文字,并展示共有短语数量和最长连续复制片段。
运行演示是熟悉各项设置最快的方式。试试示例邮件,逐词修改复制的段落,观察匹配如何减弱。切换不同的匹配规则,并使用 常见短语(Common phrases)选项卡查找固定套话,将其应用为停用词表。你还可以加载一个包含你自己文本文件的文件夹,并用邮件进行匹配检查。
代码位于 elasticsearch-labs 代码仓库(elasticsearch-labs repository),其中的自述文件包含完整的配置步骤。
运行演示所需的条件
- Elasticsearch 9.x,可自托管或部署在 Elastic 云上。我们在 Elastic 云无服务器版以及 Elasticsearch 9.5和9.6上进行了测试。Elastic 云试用版(Elastic Cloud trial)也可以使用。
- Python 3.10或更高版本。
- 一个能够创建和管理演示索引的应用程序编程接口密钥。
- 示例数据来自 BigPatent(夏尔马、李和王,计算语言学协会2019年会议,采用知识共享署名4.0许可),由加载器下载。
如何从你自己的文档开始
本文开头粘贴到邮件中的三句话,与其来源申请文件包含相同的八词短语,Elasticsearch 利用已有的分析器和查询就能找到这些短语。短语长度、匹配规则和停用词表共同决定需要多少证据才算复制,而高亮显示的文字让审核人员能够检查每个结果。作为首次实验,你可以将自己的20份非敏感文档加载到演示中,再粘贴几封引用这些文档的邮件,看看你会信任哪种规则。欢迎在 Elasticsearch 讨论区(Elasticsearch Discuss)告诉我们你的发现。
原文:Data leak detection with Elasticsearch text fingerprinting | Elasticsearch Labs