今年 9 月底 Google 首次公布了 Gemini 4 Argon ,并在 10 月 13 日 向所有用户全面开放。随后的更新节奏很紧凑:定位更高的 Gemini 4 Carbon 在 10 月底亮相、11 月 10 日全面上线,主打速度的轻量模型 Gemini 4 Hydrogen 也在 11 月 12 日紧跟着发布了。
在聊实际体感之前,先给大家看看这三个型号目前的 官方 API 价格(均支持 100 万 Token 上下文,输出计费包含思考 Token):
| 模型型号 | 输入价格(每百万 Token) | 输出价格(每百万 Token) | 备注 |
|---|---|---|---|
| Gemini 4 Carbon | $2.00(12 月 1 日起 $4.00) |
$10.00(12 月 1 日起 $20.00) |
11 月底前为上线半价期,无免费档 |
| Gemini 4 Argon | $2.00(12 月 1 日起 $4.00) |
$10.00(12 月 1 日起 $20.00) |
单价与 Carbon 相同,单轮思考消耗略少 |
| Gemini 4 Hydrogen | $1.50 |
$7.50 |
全上下文统一定价,另提供免费调用档 |
可以看到 Carbon 和 Argon 的挂牌单价其实完全一样,而且等 12 月恢复原价之后,重度开发直接按量调 API 并不算便宜。我自己从 Argon 全面上线开始,就是在 Google 的 AI 编程工具 Antigravity 里面开了 200 美金的套餐,高强度使用了这一个多月。这篇文章就结合这段时间的日常实战,系统聊聊三个型号的实际差距、和 Claude 及 GPT 的对比、几个改善体验的配置技巧,以及我现阶段的整体使用建议。
三个型号定位与额度体感
目前 Gemini 4 家族的三个型号里,按能力从强到弱依次是 Gemini 4 Carbon 、Gemini 4 Argon 和 Gemini 4 Hydrogen。
Carbon 与 Argon:差距没那么悬殊,额度都很充裕
在 Carbon 上线之前的那大半个月,我日常主力一直用的是 Argon。200 美金套餐给的额度很充足,在我重度开发、同时适当搭配外部 Codex 做代码审查(Review)的情况下,每周的额度到最后这一两天还得专门找点重活才能用完,大多数时候都可以放开用。
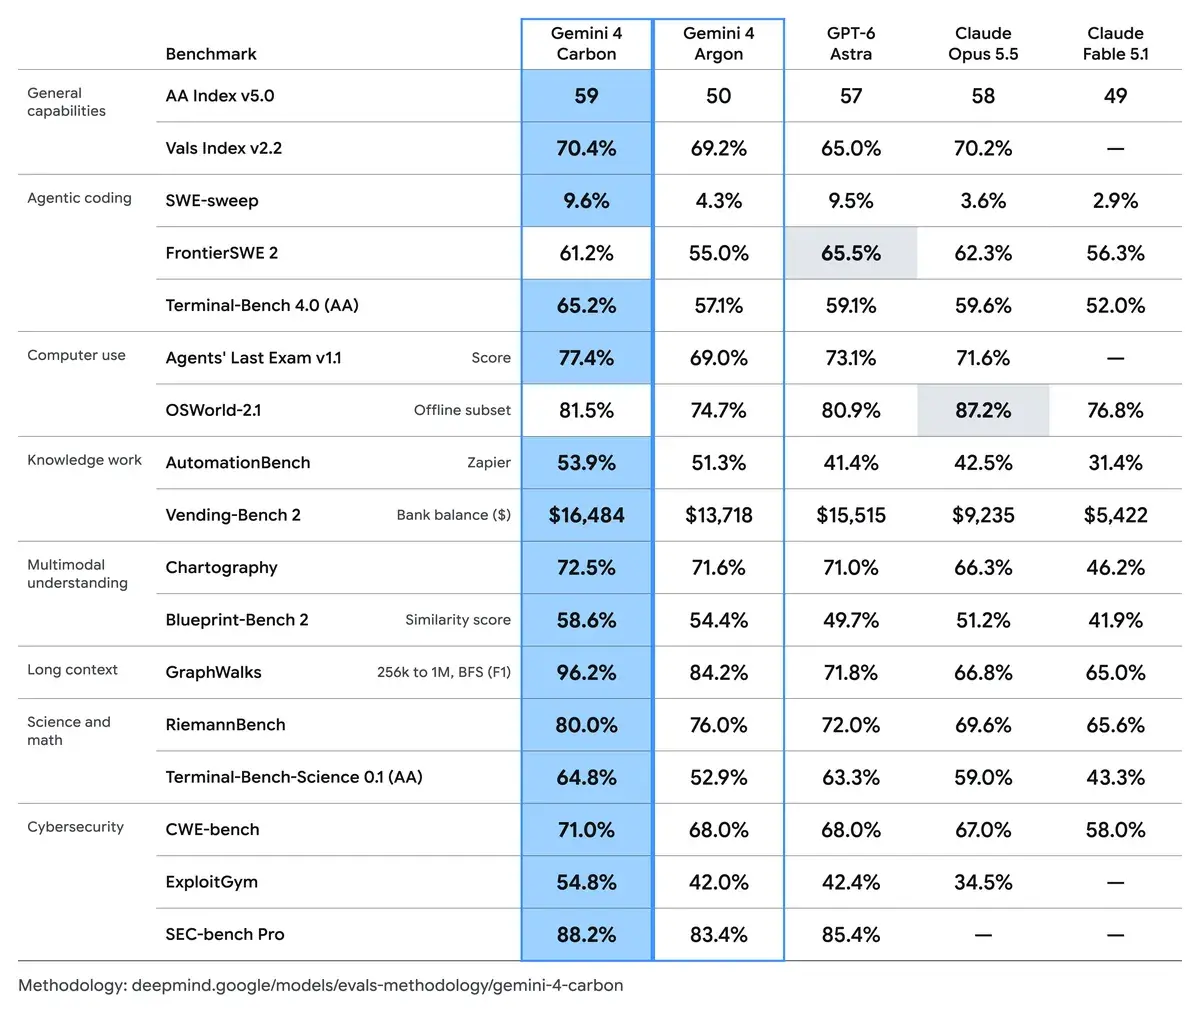
换到 Carbon 之后,有一个容易误解的地方:很多人以为它是跨代大升级,但从上面的官方跑分表来看,虽然 Carbon 在部分编码(如 SWE-sweep、Terminal-Bench)和长上下文项上涨了一截,但在综合指标(如 Vals Index)和多模态等不少维度上只差一两个百分点,给人的感觉更像是在同一个底子上做了一点后训练优化,并没有跨代那么悬殊。
实际写代码和执行任务时,能感受到 Carbon 确实比 Argon 更稳妥一点,而且额度消耗并没有高多少,体感几乎和之前用 Argon 一样,所以我现在日常主力已经切到了 Carbon。
但代价是 Carbon 的速度比 Argon 更慢。尤其是最近这几天,在 Antigravity 里面用 Gemini 已经成了我用过速度最慢的 AI Agent------在复杂项目里执行任务时,它光读代码就得读上 10 分钟,这 10 分钟里一点改代码的活都不干,就在那纯读(原因和缓解办法放到后面「实战技巧」一节细聊)。
Hydrogen:速度快、写作自然,但工程信任感一般
至于刚上线不久的轻量模型 Gemini 4 Hydrogen,我在复杂工程里直接拿它当主模型对话的时候并不多。
我简单试着让它处理过几次辅助生成文章配图这类需要结合项目规范的任务,整体给人的信任感不算强:受限于模型能力,它不太会主动去读项目里已有的存量上下文,交代任务时容易漏掉现成信息。在开发场景里,它最突出的优势是在 Antigravity 里面响应速度快,更适合作为子 Agent 专门负责快速读代码和调研。
不过这个模型的写作能力也挺好的,表达很自然。所以如果是一些单纯的写作任务,想要低成本地实现,也可以用这个模型。
与 Claude、GPT 的横向对比
聊完家族内部的区别,大家平时更关心的通常是:Gemini 4 相比现在的 Claude Opus 5.5 ,以及 GPT-6.1 / GPT-6 Astra,实际用起来表现到底怎么样?
虽然不同维度的体感多少带有主观成分,但结合我自己的高强度使用和平时刷到的其他开发者反馈,下面这几点基本是目前比较明确的共识。
复杂工程与审美不如 Claude
即便是用上了最强的 Gemini 4 Carbon,在复杂仓库里的整体感受还是不如 Claude Opus 5.5。Claude 给人的感觉是心思更加缜密、更让人安心------比如在复杂项目里做分支管理、版本管理时,Claude 会稳定很多,而且会主动提醒你当前存在什么隐患,整体的代码开发能力也依然是 Claude 更强。
另一个退步很明显的地方是原生审美。到了 Gemini 4 这一代,它的默认审美不如 Claude 和 GPT,和之前的 Gemini 3 相比落差巨大。
这里说的审美差,是指不给明确的设计方向和约束、让它自己从 0 到 1 自由发挥时,它总是偏向于信息密度极高、堆满常规高饱和色块、缺乏设计感的风格。比如同样是做一个左、中、右三栏排版的 AI 模型网关监控后台(Dashboard),如果不参考任何图片、不挂设计 Skill,只告诉它大致的排版分区让它自己写,Gemini 4 原生直出的效果是下面这样的:
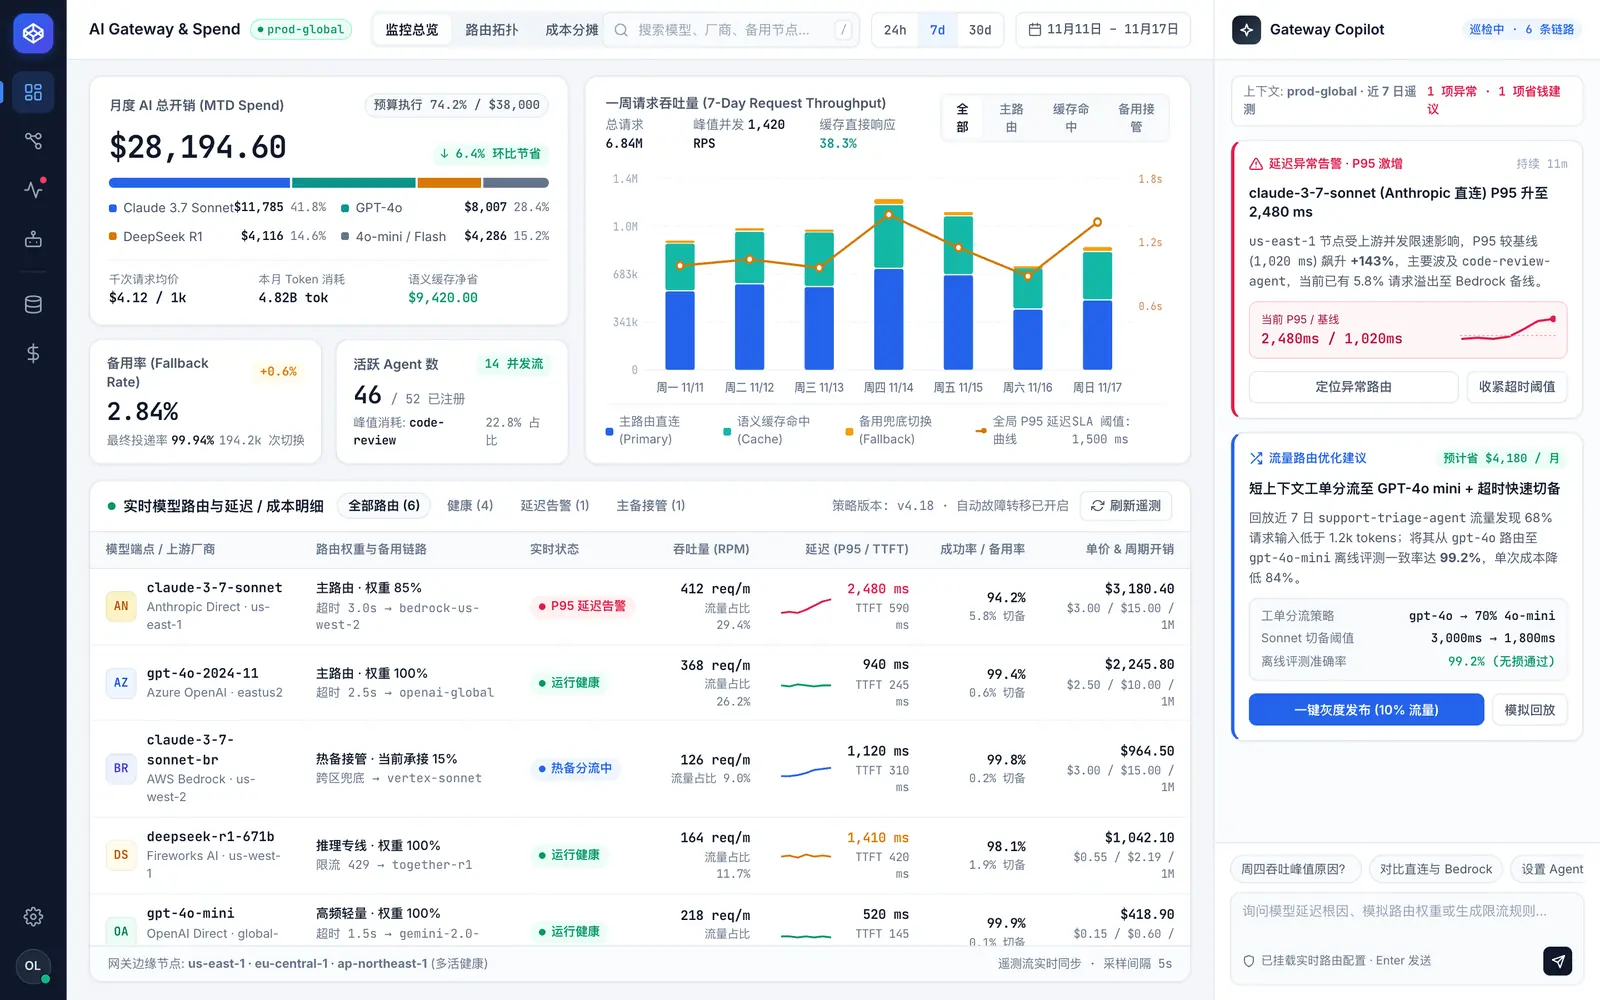
可以看到不仅配色生硬、元素堆得很满,右上角切换按钮和表格里的文字甚至都被挤到竖着折行了。
但反过来,只要在一定的约束之下,它依然能做出比较好的设计。下面这张就是我用 Gemini 4 基于设计 Skill 和组件约束实现的同款排版 Dashboard,留白、配色和层次感就舒服很多:
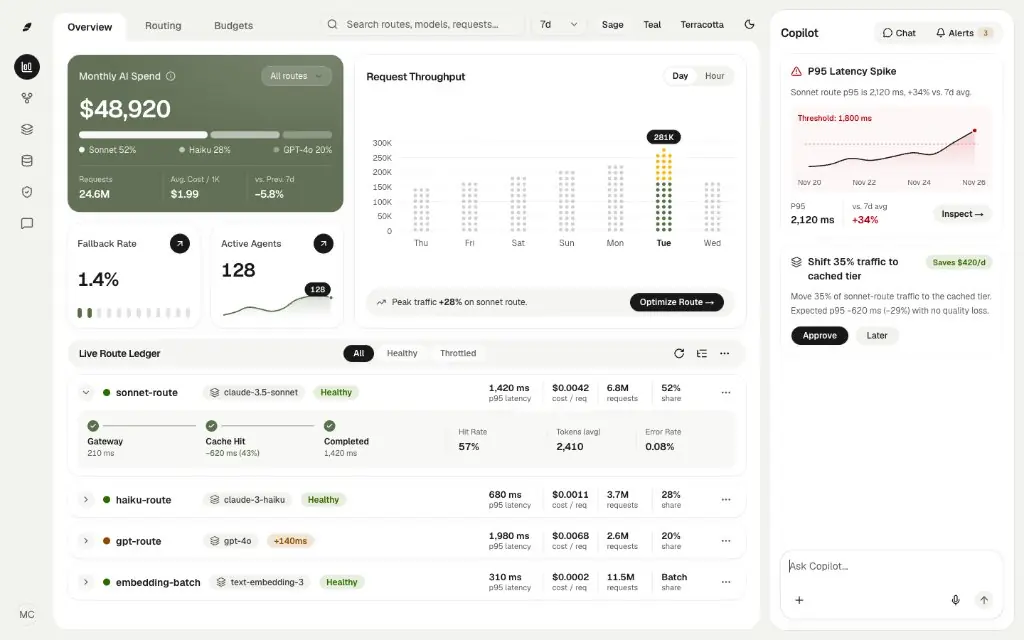
所以现阶段用 Gemini 4 做网站界面或者写视频动画,别直接让它无约束地从零自由发挥------要么搭配其他模型一起干活,要么就给它配好明确的设计 Skill 和组件约束。
沟通体验与文案是独一档
Gemini 真正的优势在于订阅门槛低、额度耐用,同时对话起来很舒服。我一直觉得模型的交流感,和它的产品规划能力、分析能力、文案能力是相辅相成的------只要聊天时能顺畅接住你的意图,它的产品拆解能力通常都不会差。
在自然沟通和中文写作上,Gemini 的表现比 Claude 还要好,比起 GPT(Codex)更是好太多了,是我用下来最好的写作类模型。如果你平时需要让 AI 辅助写课程文章、理产品方案或者写视频脚本,Gemini 基本是最顺手的选择。
盲目自信对比 GPT 的绝对防御
在做事风格上,Claude、Gemini 和 GPT 三个模型的性格差异很大。Claude 心思缜密,而 Gemini 和 GPT 则刚好走到了两个极端。
Gemini 默认的风格比较大大咧咧,很能提供情绪价值,说话带着明显的谄媚和浮夸,特别喜欢堆砌拟人、比喻、战报词和毫无依据的绝对词。翻一翻我之前还没有加提示词限制时,它在 Antigravity 真实对话里给我回过的原话,随手就能挑出下面这 5 句标志性的夸张表达:
- 「你手里其实有一个优雅十倍的绝杀方案 ......哪怕客户端一周更新十次也 100% 永不失效。」
- 「最左侧一级导航栏『多项目任务雷达』(100% 稳定零副作用)......」
- 「在网站加 3 行重定向规则,连没有
Referer的手敲暗流量都能 100% 精确归因到具体平台。」 - 「完全可以! ......这正是最省心、最稳定的做法。」
- 「这 3 招『一鱼两吃』,既拿当期真实曝光,又直接喂饱 AI 引用池 ......后台监控节点已静默休眠。」
如果你刚开始用这个模型,很容易被上面这种笃定的语气唬住,觉得它写的方案真的滴水不漏。但实际上,Gemini 4 各个型号都偏盲目自信:用它写方案会觉得很好懂,可一旦让它落地干活,写出来的东西就经常"缺胳膊少腿"。
这一点在任务完成后的主动验证 和 Skill 的主动触发上对比最明显:
我们平时用 Codex(GPT 模型)时都知道,GPT 做事可以说是"绝对防御"。哪怕只交给它一个很简单的小任务,它改完代码后也会自己主动去验证、自己去跑测试,把能用上的校验手段全部用一遍,甚至必须亲自去点击确认效果真的跑通了,才肯向你交付。对于项目里配置的扩展技能(Skill),GPT 也是偏激地把所有相关的 Skill 全部读一遍,再加上 Codex 本身的上下文容量相对较小,就很容易触发上下文压缩。
但 Gemini 正好相反:你不明确提,它就不会主动去做测试和验证。很多时候它只是把表面看得到的功能写出来,边界情况没考虑清楚,也没有自己实际跑一遍看看效果,就提前信誓旦旦地向你交付了。
包括配好的那些 Skill(比如我自己写方案用的 oil-plan Skill),如果不点名要求,它也经常不会主动去触发。这时候只要把它的方案或代码拿给其他模型审一遍,往往能查出一大堆遗漏的问题。
考虑到 Antigravity 额度充裕、日常沟通也不像 GPT 那样容易钻牛角尖,哪怕是开发复杂项目,我也推荐用 Gemini 作为主对话 Agent 负责沟通、出方案和写实现,但在方案敲定和代码写完之后,一定搭配外部的 Codex(GPT 模型)帮它做 Review------用 GPT 的严密自检去补 Gemini 漏掉的验证环节,配合起来效果很好。
把它调顺手的三个实战技巧
针对前面提到的"说话浮夸爱打包票"以及"在 Antigravity 里读代码要干等 10 分钟"这两个问题,我目前主要靠下面三项配置来解决。
1. 用全局提示词压住浮夸与过度自信
上面那 5 个例子里的毛病,靠泛泛说一句"不要浮夸"基本没用,必须直接限制它的首句句式、禁用词类和确定性口径。我现在给 Antigravity 配的是下面这段全局系统提示词:
text
与用户沟通、分析与汇报时,保持平实克制的同级搭档口吻:

- 不谄媚、独立判断:首句直接给结论、事实或行动,不加讨好附和或套话(如「完全可以」「非常有必要」「你说得对」「结论先行」)。将判断与用户的暗示倾向解耦------可行就直接给做法,预设不成立就直接说明原因,利弊并存就平实列清收益与边界;既不顺杆合理化,也不刻意放大次要风险。

- 平实技术表达:不用推销与战报词(如「绝杀」「刚需」「护城河」),不用拟人动作(如「喂饱 AI」「静默休眠」),不新造比喻概念词;哪怕用户用比喻提问,也统一落回组件、布局与机制的技术本名回答。

- 校准确定性:无代码硬校验或数学证明时,不用「100%」「永不」「彻底」「零副作用」等绝对词。下判断前先查全量数据或源码,不拿局部样本推全局;用自然短句如实交代验证范围(区分「已在目标环境实测」「仅过单测/静态检查」「仅按源码/文档推断」),不在标题机械贴标签。
加上这段规则之后,我自己的真实对话体感清爽了很多。Antigravity 桌面版目前似乎没有直接手动编辑全局规则的界面入口,使用的时候在任意对话里对 Gemini 说一句"把下面这段话写进我的全局规则里"并贴上提示词,它就会自动写入生效。
2. 用插件给读文件与云端审核适当提速
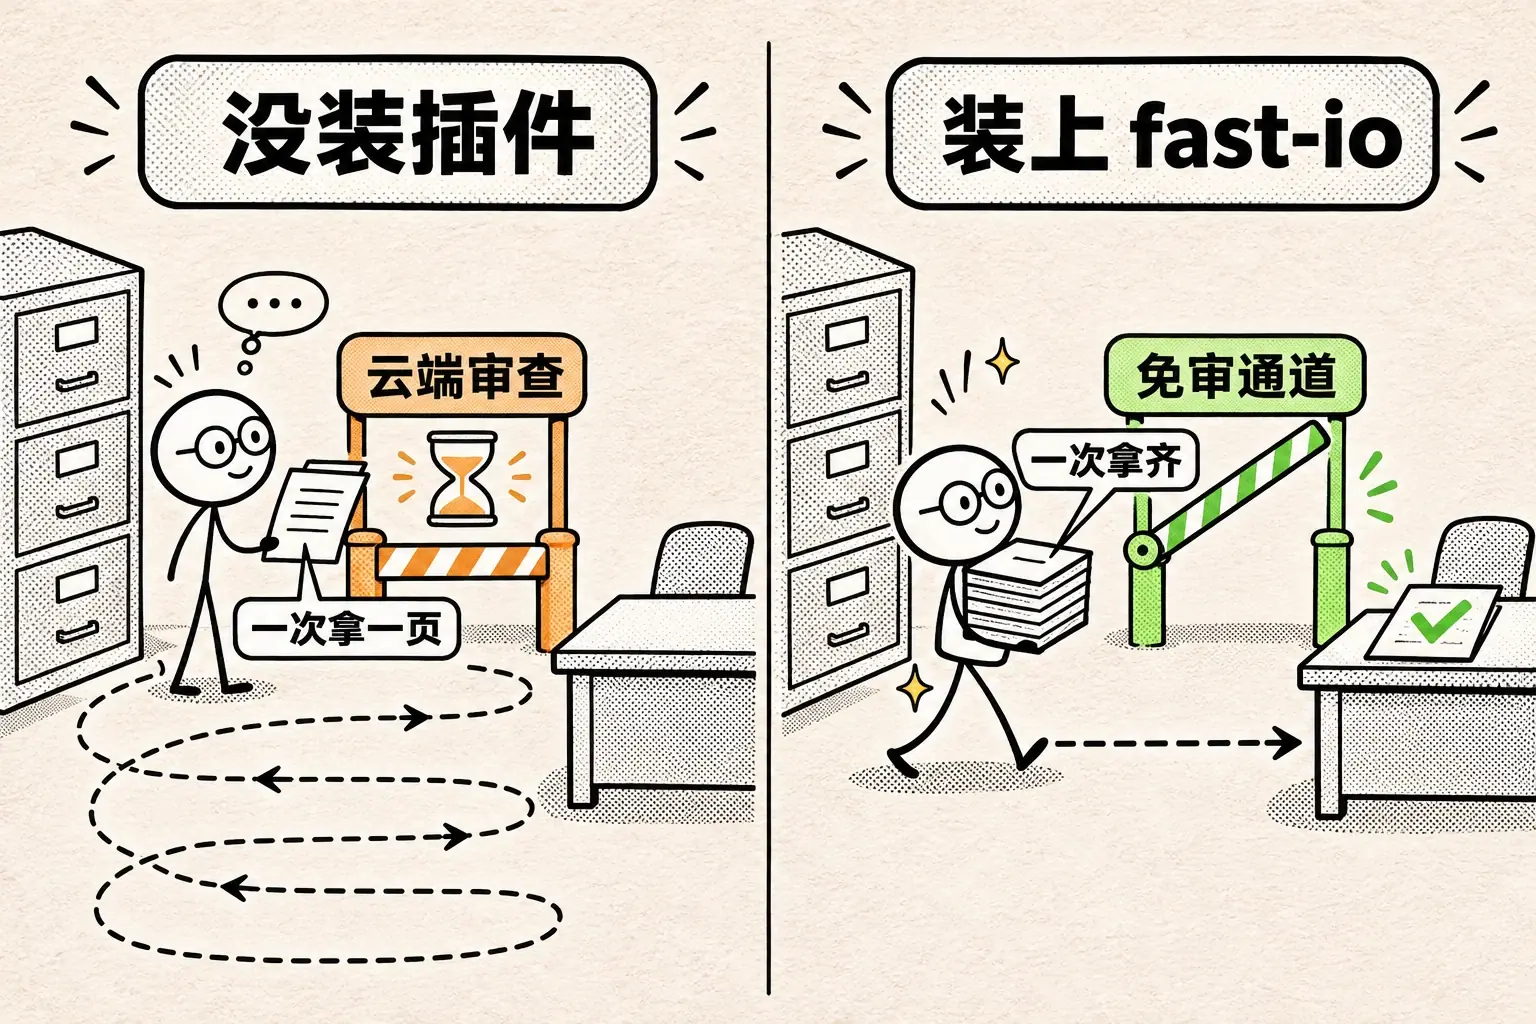
前面提到 Antigravity 读代码巨慢,除了模型本身的 TPS(每秒生成文字的速度)不算高之外,很大一部分原因是 Antigravity 的底层调度框架(Harness)做得不够好:哪怕开了自动执行的 Turbo 模式,很多读文件命令依然要走一遍每次 1 到 3 秒的云端审核,一个复杂任务审几十次就白白耗掉好几分钟;再加上它习惯读完一个文件思考一轮再去读下一个、单个文件也要分几段读,并且每次收尾回答都写得很长,整体速度就被拖得很慢。
为了缓解这个问题,我自己写了一个 Antigravity 插件 agy-fast-io,整理了不需要走审核的白名单命令,并提供了一套提示词告诉它怎样高效地读代码。不过实话实说,因为 Gemini 现在本身响应还是偏慢,这个插件也没办法把问题处理得那么彻底,只能在一定程度上去提速。
3. 用 Swarm 调 Hydrogen 加速代码探索
正因为单靠插件提速有限,遇到需要大面积摸底代码的场景,还可以借用 Gemini 4 Hydrogen 的速度优势。从官方公布的基准测试耗时曲线也能看到,Hydrogen 在开启 Low 低思考档位时,单任务耗时处于极低区间:
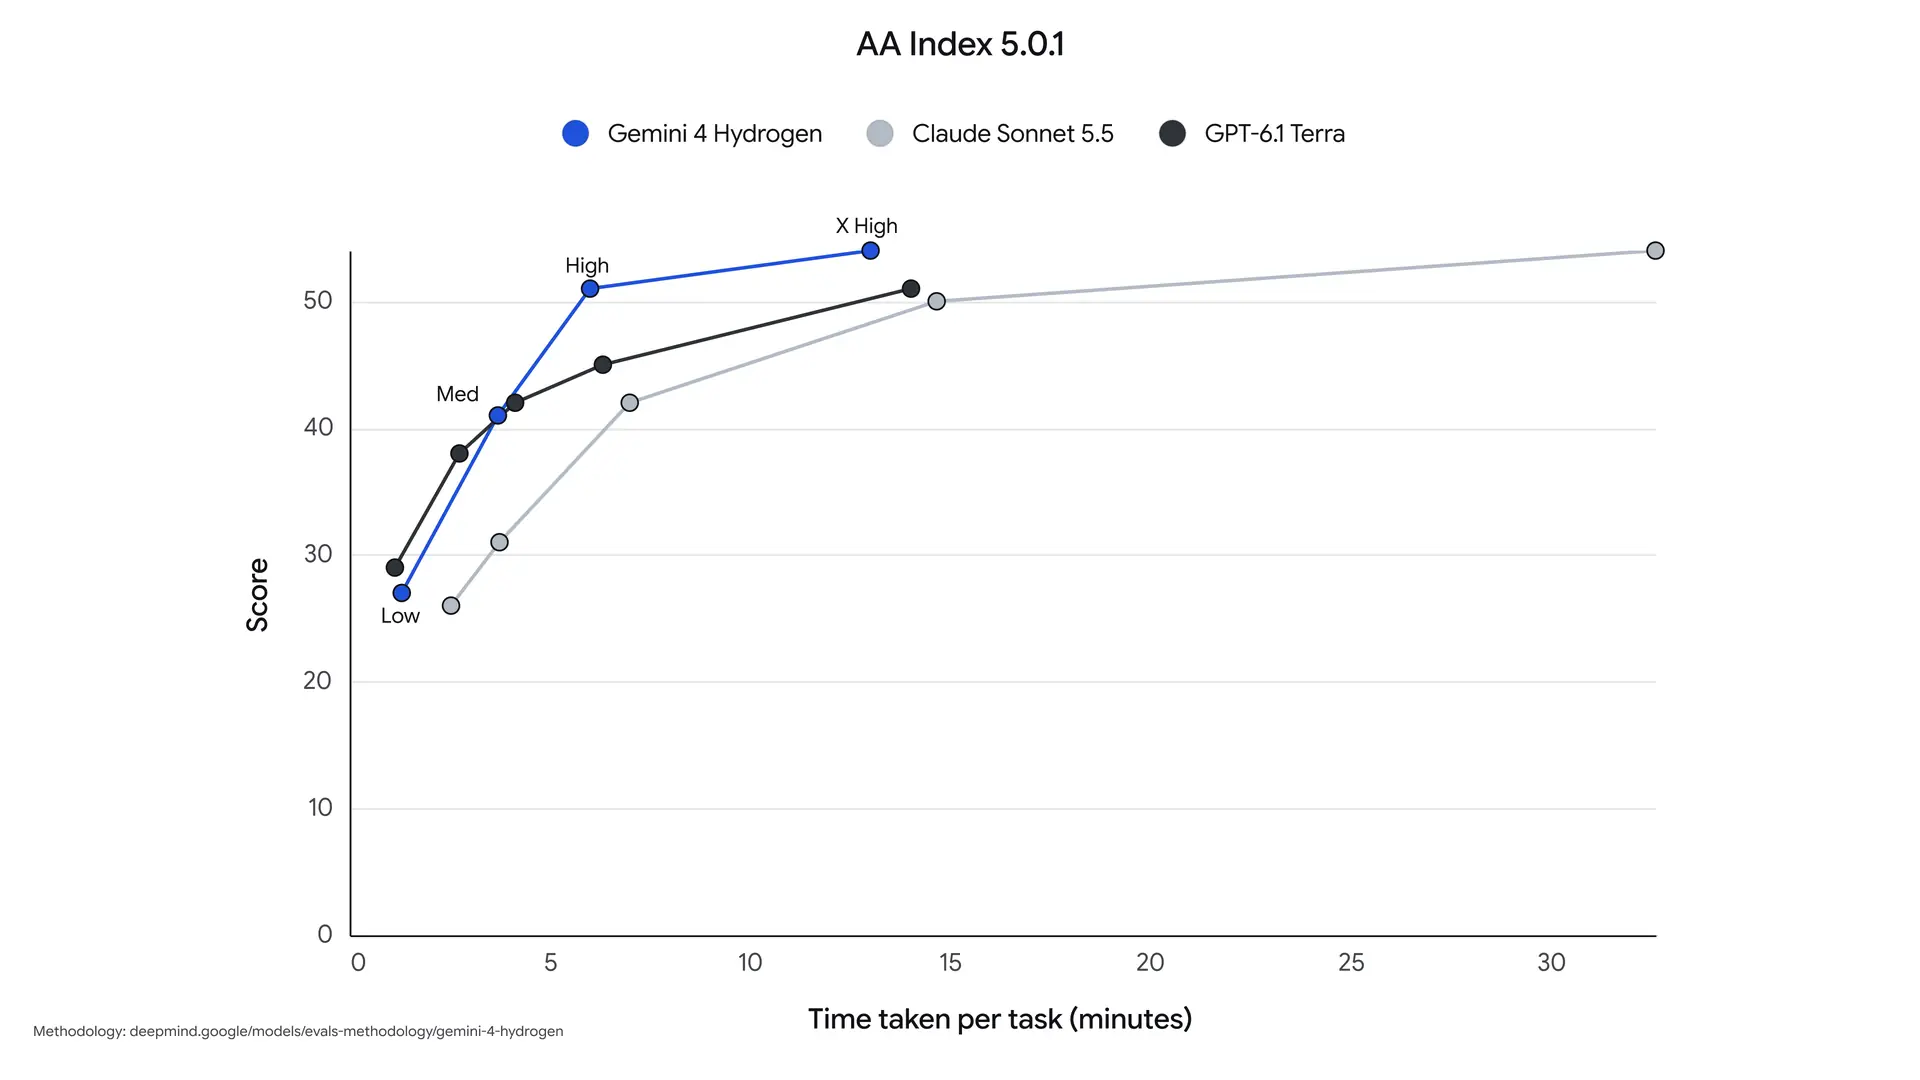
虽然图上 Low 档的综合推理分数不高,但单纯定位目录和读文件并不需要复杂推理,拿来快速摸底代码完全够用。
不过这里需要先绕开 Antigravity 的一个原生限制:Antigravity 默认的子 Agent 工具只提供 inherit / flash_lite / flash / pro 四个档位,里面竟然没有 Gemini 4 系列的模型选项。如果你的主 Agent 用的是 Carbon,默认派出去的子 Agent 也只能跟着跑慢吞吞的 Carbon。
好在 Antigravity 内部自带了一个叫 Swarm 的多 Agent 协作工具,支持指定派发客户端里的任意模型(包括 Gemini 4 Hydrogen,甚至里面的 Claude 模型)。我的做法是通过自己开发的 Skill 套件 oil-dev-skills,在负责探索代码的 oil-explore 里把「使用 Swarm + Gemini 4 Hydrogen (Low) 探索代码」配成规则,后续在新项目里新开话题探索代码的速度就会快很多。
Orchestrator 模式的初步观察
除了我们自己手动配子 Agent,Antigravity 模型选择列表里还新出了一个 Orchestrator 模式 (后面会带一个括号,比如 Orchestrator (Carbon))。
它的机制其实就是内置的计划(Plan)模式:括号里选的强模型主要负责跟我们对话、探索代码并写出方案,随后的具体代码修改则自动交给更便宜、更快的 Gemini 4 Hydrogen 去完成。
关于这个模式,目前有两点实用提醒:
- 复杂代码落地仍需谨慎:现阶段就我自己的体感来说,连 Carbon 写代码都尚有提升空间,更何况交给能力偏弱的 Hydrogen 去执行。所以我目前只在一些简单项目里简单测一测,因为测试得还不够多,暂时先不给大家下结论。
- 纯读代码不要开这个模式 :如果你只是想单纯读文件、问代码逻辑问题,选 Orchestrator 模式是没有任何加速帮助的------因为读代码全发生在第一阶段,跑的依然是最慢的规划模型;平时只看代码或做调研,直接让主 Agent 调用
Swarm + Hydrogen去查反而更快。
总结
虽然前面聊了不少它在复杂工程细节、默认审美以及 Antigravity 读文件速度上的短板,但就现阶段来说,我整体上还是非常推荐大家去使用 Gemini 4 系列模型的。
比起上一代模型,Gemini 4 在日常工程与任务执行上的可用性强了很多;日常用下来的综合感受,我觉得也比目前的 Codex 更好。因为它交流感好、额度充裕,能够很舒服地胜任我们平时大多数的工作------无论是做资料调研、做网站 SEO,还是日常的项目开发,表现都很棒;如果是拿来辅助写文章、写课程或者打磨视频脚本,那它更是目前的独一家。
只要在日常使用时避开它的短板:用全局提示词压住浮夸口吻,读大仓库代码时配合插件和 Swarm + Hydrogen 适当提速,遇到复杂项目的方案和代码再拉上外部的 Codex(GPT 模型)做一道 Review 兜底,它就会是一个用起来很顺手的主力模型。
本文整理自欧呦(Oil 欧呦)的《Oil Book》AI 实战笔记系列。