企业数据 API 这两年冒出来不少,做开发的朋友选型时却很容易踩坑。
最近手上有个项目要接企业数据,试了试鲸海 API,刚开始关注到这家,是因为试用额度给的比较大方,但我还是按一套通用的选型标准(数据维度、接口设计、计费方式、文档调试、稳定性、接入形态)逐条测评了一遍。
整体看下来还可以,尤其在维度覆盖和成本控制上有亮点,比较适合做批量数据处理、要把数据嵌进业务系统、预算敏感的中小团队。下面是具体的测评内容,供有需要的同学参考。
一、企业数据维度够不够全
企业数据 API 的选型,第一关就是看维度覆盖。真正能扛住复杂场景的平台,往往覆盖企业全生命周期,工商信息、司法诉讼、经营风险、知识产权、招投标、税务、媒体舆情等。只做一个维度或者维度之间七零八落的,场景一复杂就得换平台,迁移成本很高。
鲸海数据的API有一百多个接口,覆盖工商、司法、知产、招投标、税务、媒体等 16 大类,点这里
arduino
https://www.kqdaas.com/market可以看具体的清单明细,从维度数量和覆盖面看,属于比较全的一档,多数开发场景能在一个平台里凑齐。 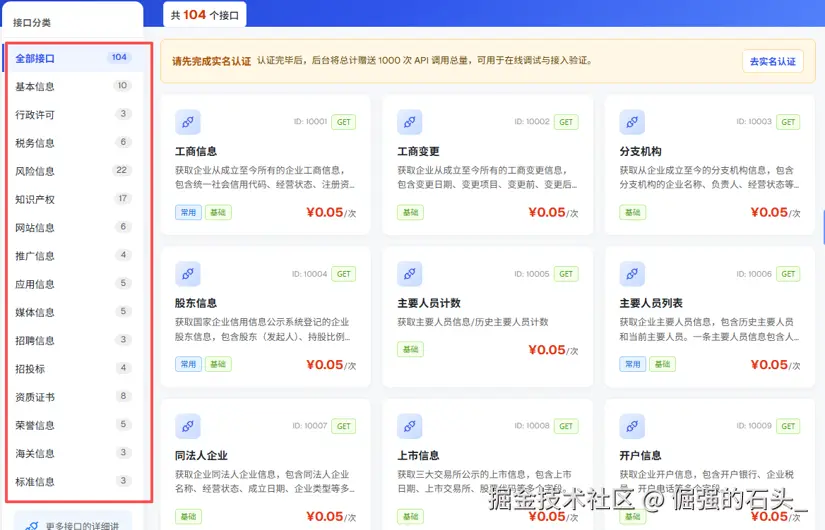
客观地说,维度的"全"和"深"是两回事:它的接口数量多、覆盖面广,但在股权穿透、关联关系图谱这类需要深度加工的 analysis 型场景上,和深耕多年的老平台比,积累未必占优。追求广度和性价比的话,它是够用的;要做特别深的研判分析,还得具体场景具体评估。
二、接口设计的层级和颗粒度
很多平台喜欢把所有数据塞进一个大而全的接口里,看似省事,实际又慢又贵。好的设计应该是按维度拆成独立接口,同一维度再分列表和详情两层,这样可以先调列表确认"有没有",再对有数据的调详情,避免为用不上的数据买单。 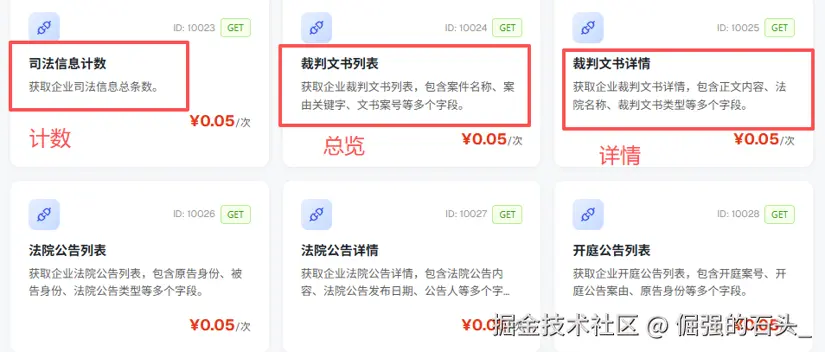
鲸海在这块做得比较规整,工商、工商变更、股东、主要人员、开户、司法、招投标、知识产权各是各的接口,很多维度还分了列表和详情两层,GET 请求 + Header 鉴权(X-Jinghai-App-Id / X-Jinghai-Api-Key)。按需取用这一点落到了实处,代码写起来也清爽。
注意了,接口拆得细意味着数量多,初次接入时需要花点时间熟悉接口清单,不像"一个大包打天下"那样拿来就用。属于前面省事、后面省钱的取舍。
三、免费额度与计费模式
重点看两点:免费额度是全平台通用还是阉割版?计费是不是按次、单次成本能不能算清?有些平台"送 1000 次",但只能测一个接口,深度数据照样收费,这种额度等于没给。 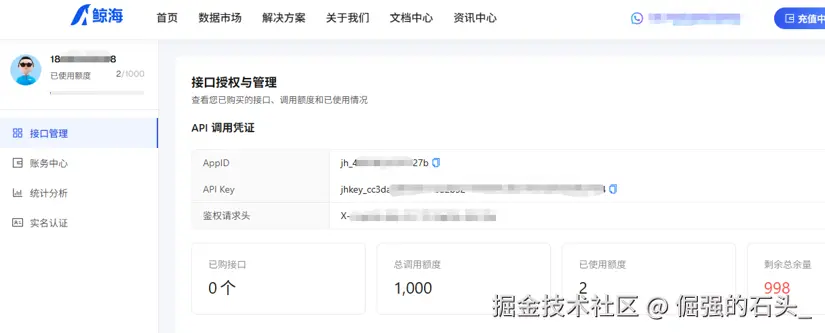
鲸海这边直接送 1000 次调用,全平台所有 API 通用,不是只能测单接口的阉割版;正式使用按次计费,单次 0.05 元。这个组合对试错很友好,你可以不花一分钱把批量回填、风控预警这类流程完整跑一遍,确认数据能用再决定要不要继续。
放个传送门:
arduino
https://www.kqdaas.com/market感兴趣的,可以先去领个额度自己跑一遍看看。
四、文档与调试
文档质量是最容易被低估、却最影响效率的一项,尤其在线调试,按提示填参数就能直接验证数据结构和字段完整性,不用先写一堆代码。
鲸海数据这块做得比较省事:每个接口都配齐了请求地址、参数说明和 JSON 返回示例,在线调试页填参即用。我实测的几个接口,十分钟就能确认字段对不对,对接效率不错。 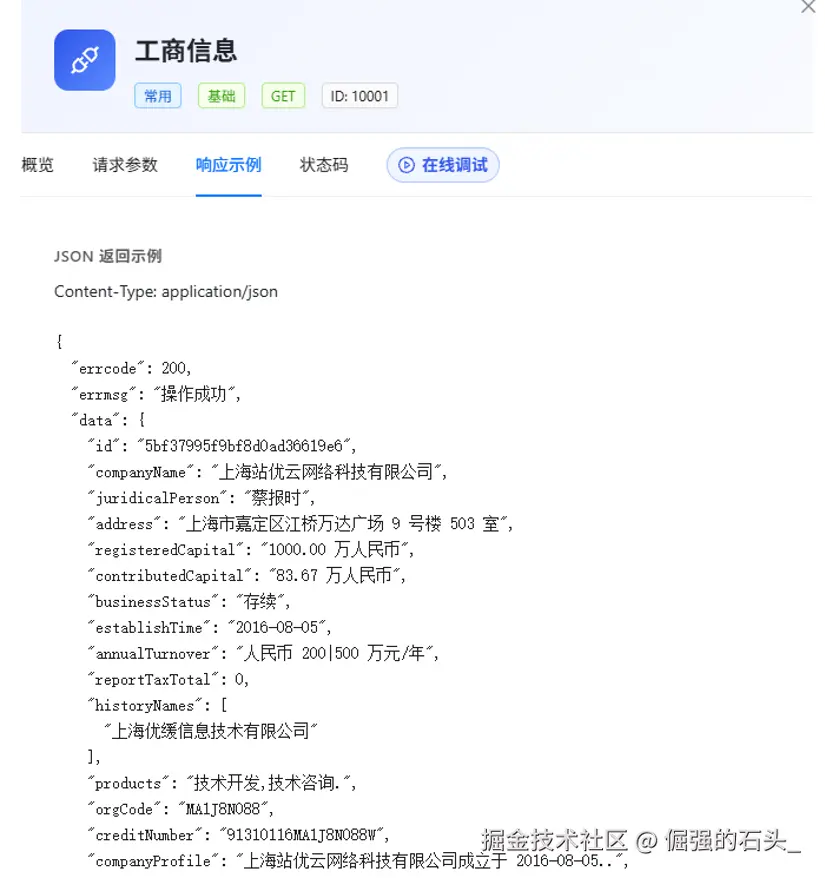
我实测的几个接口,靠调试页十分钟就能确认字段对不对,对接效率不错。这块没发现明显短板。唯一建议是接入前先把要用的那几个接口的返回示例过一遍,确认字段名和你的数据结构能对上,别等写到一半才发现要改映射。
五、接口稳定性与数据质量
批量任务最怕跑到一半被掐断,封 IP、弹验证码、触发限速,前面全白跑。我拿鲸海API连续跑了一批数据做测试,暂时没遇到这些问题,响应速度也在可接受范围。抽样和官方公示信息交叉比对,准确度没问题。
不过稳定性这东西,短期压测说明不了全部问题。我的测试量级有限,长期高并发场景下的表现,还需要放到真实项目里验证。建议正式接入前,先拿你的真实业务量跑一轮压力测试。
六、接入形态
如果你的场景涉及 AI Agent、智能助手这类应用,可以留意平台有没有配套的 MCP 服务,这样就不用自己手搓了,方便很多。
鲸海除了面向开发者的 API,还有一条面向 AI Agent 的 MCP 产品线,鲸海MCP
arduino
https://www.kqdaas.com/market有94个原子工具,而且和 API 基于同一份数据底座,口径一致。如果你在做智能尽调、AI 助手这类应用,等于多了一种接入选择,两种形态还能组合用。 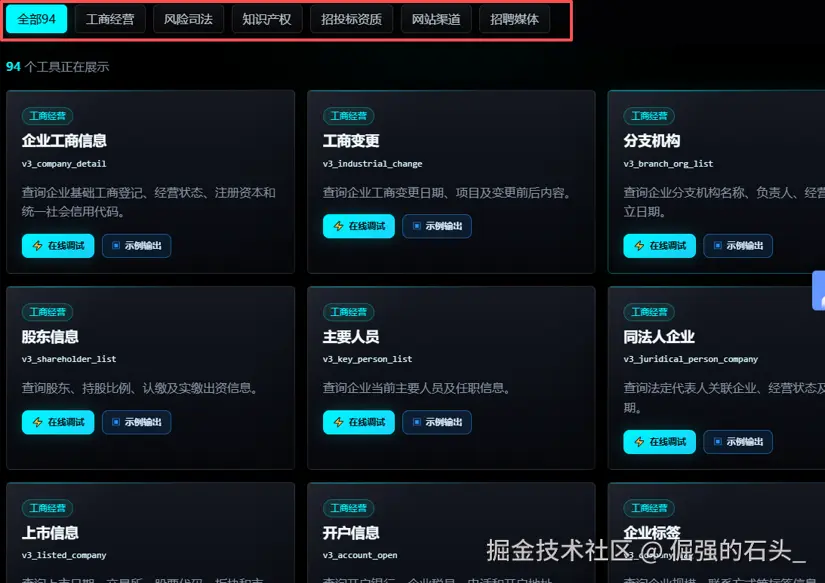
这块算是加分项。对纯 API 场景的开发者来说没影响,对做 AI 应用的人来说是个实用的补充。
七、总结:鲸海数据适合哪些场景和人群
总的来说,鲸海数据维度全、接口设计规整、成本低、文档也比较友好,在广度、性价比和接入效率上表现还可以,下面这些场景和人群可以考虑:
-
做批量数据治理、CRM 清洗的开发者:几千条只有公司名的名单,写个脚本批量回填信用代码、法人、注册资本,几分钟搞定,配合免费额度能先跑通再决定
-
要把数据嵌进业务系统的团队:风控预警、获客筛选、准入审核这类场景,接口按维度拆分、列表详情分层,用起来省事、开销可控
-
预算有限但要多维度数据的中小团队:1000 次全平台通用试用额度,试错成本低,性价比较高
-
在 AI Agent 里用数据的开发者:有配套 MCP,和 API 同底座、口径一致
但是对数据权威性、背书要求极高的强合规场景(如监管报送、法律取证、甲方指定数据源),以及需要特别深的股权图谱、关联研判的分析型场景,还是建议优先考虑深耕多年、有公信力背书的老平台。