字段抽取的难处不在于"抽不到",而在于抽不到的时候要分清是哪种抽不到。三种情况的改法完全不同:
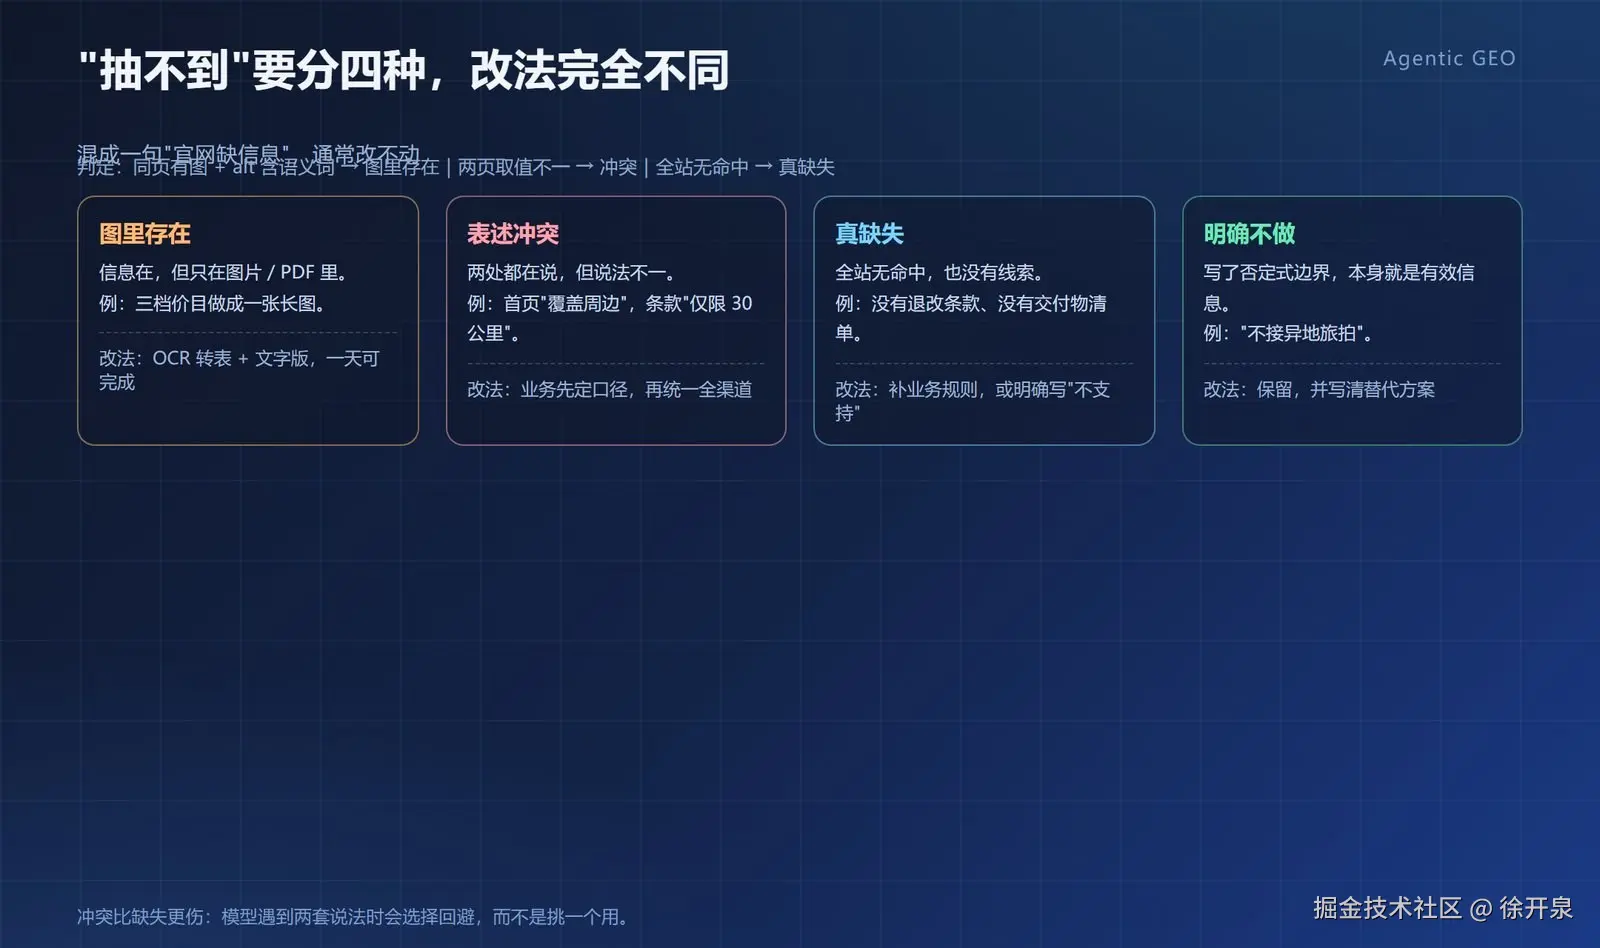
- 信息存在,但只存在于图片或 PDF 里(图里存在)
- 信息存在,但两处说法矛盾(表述冲突)
- 信息从未存在,或明确写了"不做"(真缺失)
前两种能修,第三种要么补业务要么放弃这个问法。抽取器如果不区分,会把三种都记成"缺失",然后给出一个"你缺 7 项"的结论------客户拿着这个结论去改,改了三项没变化,因为那三项本来就在图里,只是图没被读。
一、三种形态的判定依据
| 形态 | 判定信号 | 典型例子(婚摄) | 改法 |
|---|---|---|---|
| 图里存在 | 同页有 <img> 且 alt/相邻文本含该字段语义词;文本层无该字段 |
三档套系价目做成一张长图 | OCR 转表 + 文字版价目 |
| 表述冲突 | 同一字段在两个页面命中,但取值不一致 | 首页写"覆盖芜湖及周边",价格页写"仅限市区" | 统一口径,保留一个来源 |
| 真缺失 | 全站无命中,且无相关图片线索 | 全站没有退改条款 | 补业务规则,或明确写"不支持改期" |
| 明确不做 | 出现否定式表述 | "不接旅拍""不做跟妆" | 保留,作为边界字段 |
第四种严格来说不是缺失,是有效信息。很多商家把"不做"藏起来,怕丢单,结果模型误以为他能做,新人来了发现不对,双方都浪费时间。明确写"不接异地旅拍""不含跟妆",反而是可被引用的边界。
二、实现:三态分类而非布尔值
js
// classify.mjs ------ 返回 'in-image' | 'conflict' | 'absent' | 'declared-no' | 'present'
const SEMANTIC = {
  F05: { re: /(\d{3,6})\s*(元|起|套系)/, img: /(价目|价格|套系|套餐)/ },
  F06: { re: /(精修|底片|相册|视频)/, img: /(交付|成品|清单)/ },
  F07: { re: /(定金|改期|延期|退款)/, img: /(须知|条款|说明)/ },
  F09: { re: /(酒店|草坪|礼堂|庄园)/, img: /(客片|作品|案例)/ },
};

export function classifyField(id, pages) {
  const spec = SEMANTIC[id];
  const hits = pages.map(p => ({ url: p.url, text: spec.re.test(p.text), img: spec.img.test(p.altText + p.nearText) }));
  const textHits = hits.filter(h => h.text);
  const imgHits = hits.filter(h => !h.text && h.img);

  if (textHits.length >= 2) {
    const vals = textHits.map(h => norm(valuesOf(id, h)));
    return new Set(vals).size > 1 ? 'conflict' : 'present';
  }
  if (textHits.length === 1) return 'present';
  if (imgHits.length) return 'in-image';
  if (pages.some(p => spec.re.test(p.text) === false && NEGATIVE[id].test(p.text))) return 'declared-no';
  return 'absent';
}

const NEGATIVE = {
  F09: /(不接|不做|暂不).{0,6}(旅拍|异地|外景)/,
  F06: /(不含|不提供).{0,6}(底片|相册|跟妆)/,
};
norm 的作用是把"6800 元起""6800起""6,800 元"归一,否则会把同一件事误判成冲突。这一步不做,conflict 会大量误报------实测里误报率能到三成以上。
三、冲突为什么比缺失更伤
按缺失处理,客户补一段文字就能解决;按冲突处理,要业务方先定口径。但从模型侧看,冲突的伤害更直接:同一个实体在两处给出不同说法时,模型倾向回避,而不是挑一个用。
婚摄里最常见的三处冲突:
| 冲突项 | 常见表现 | 后果 |
|---|---|---|
| 服务范围 | 首页"覆盖芜湖及周边",FAQ"仅限市区 30 公里" | 异地问法直接被排除 |
| 价目 | 首页"6800 起",价格页最低档 8800 | 被判定为低价引流,可信度下降 |
| 交付物 | 套系写"精修 60 张",另页写"底片全送"但未说是否含修 | 追问时答不出,答案里只剩模糊描述 |
这三类都能被 conflict 检出,只要抽样页面覆盖到首页、价格页、条款页。只抓首页的检测工具永远发现不了冲突------这是它最大的盲区。
四、图里存在的处理:OCR 只是第一步
价目图转文字,OCR 出来是一坨没有结构的文本。要变成 F05 需要的区间与档位,还得做一次轻量解析:
js
// ocr-price.mjs ------ 从 OCR 文本里提档位与区间
export function parsePriceTiers(ocrText) {
  const lines = ocrText.split(/\n|。|·/).map(s => s.trim()).filter(Boolean);
  const tiers = [];
  for (const l of lines) {
    const m = l.match(/(\d{3,5})\s*[-~到]\s*(\d{3,5})|(\d{3,5})\s*元?\s*(起)?/);
    if (!m) continue;
    const name = (l.match(/^([\u4e00-\u9fa5A-Za-z]{2,10})/) || [, ''])[1];
    if (m[1]) tiers.push({ name, min: +m[1], max: +m[2] });
    else tiers.push({ name, min: +m[3], max: null });
  }
  const mins = tiers.map(t => t.min), maxs = tiers.map(t => t.max ?? t.min);
  return { tiers, range: mins.length ? [Math.min(...mins), Math.max(...maxs)] : null };
}
换算出来之后再回填到页面文字层,才算真的"补上"。只做 OCR 不落文字,下一次抽取还是 in-image。
五、两个坑
坑一:数字归一没做,冲突误报。 "6800 元起"和"6,800"被判成两个值。修法:先去掉千分位、空格、全角字符,再比较。
坑二:把导航文字当命中。 页脚菜单里常有"价格""案例""须知"这些词,用宽松正则会把所有页面判成 present。修法:抽取范围限定在 main/article,并排除 nav/footer 的短文本块,同时要求命中片段长度 ≥8 字。
六、边界
三态分类能说清"缺的是哪一类",但它判断不了"这个字段重不重要"。同样缺 F07 退改,对一个只做熟客转介的工作室影响很小,对一个靠投放拉新的工作室影响很大。
它也无法处理"信息正确但过期"这一类:页面写着 2023 年的价目,抽取完全正常,回收率也正常,只是答案是错的。要发现过期,得有 dateModified 或人工核价机制,那是另一层工作。
一个立刻能用的动作:把自己的三个页面跑一遍 classifyField,看 F05/F06/F07 落在哪一态。落在 in-image 的,一天能改完;落在 conflict 的,要先开会;落在 absent 的,得问业务到底做不做。三种情况混在一起谈"优化",通常谈不出结论。