数据库自动整理诊断上下文,大模型提供调优建议,用户验证后实施。
分析慢查询,只看 SQL 文本还不够。同一条查询,在不同的数据规模和索引条件下,执行效率可能相差很大。大模型也需要了解数据库采用了什么执行计划、为什么这样选择,以及相关表和索引的情况。
TaurusDB 的 AI_ANALYZE_SLOW_SQL 函数接口会自动采集执行计划、优化器跟踪信息(optimizer trace),以及相关表结构、索引和统计信息,交给 MaaS 大模型分析。用户通过 SQL 获取诊断报告,不必逐项准备这些材料。本文以标准 TPC-H 查询为例,根据模型建议验证索引,将耗时从 2.2 秒降至 0.2 秒。
1 诊断原理:数据库提供上下文,大模型辅助分析
MaaS(Model as a Service,模型即服务)提供远程模型推理服务。一次慢查询诊断中,TaurusDB 负责采集和整理查询信息,模型负责分析并给出建议。
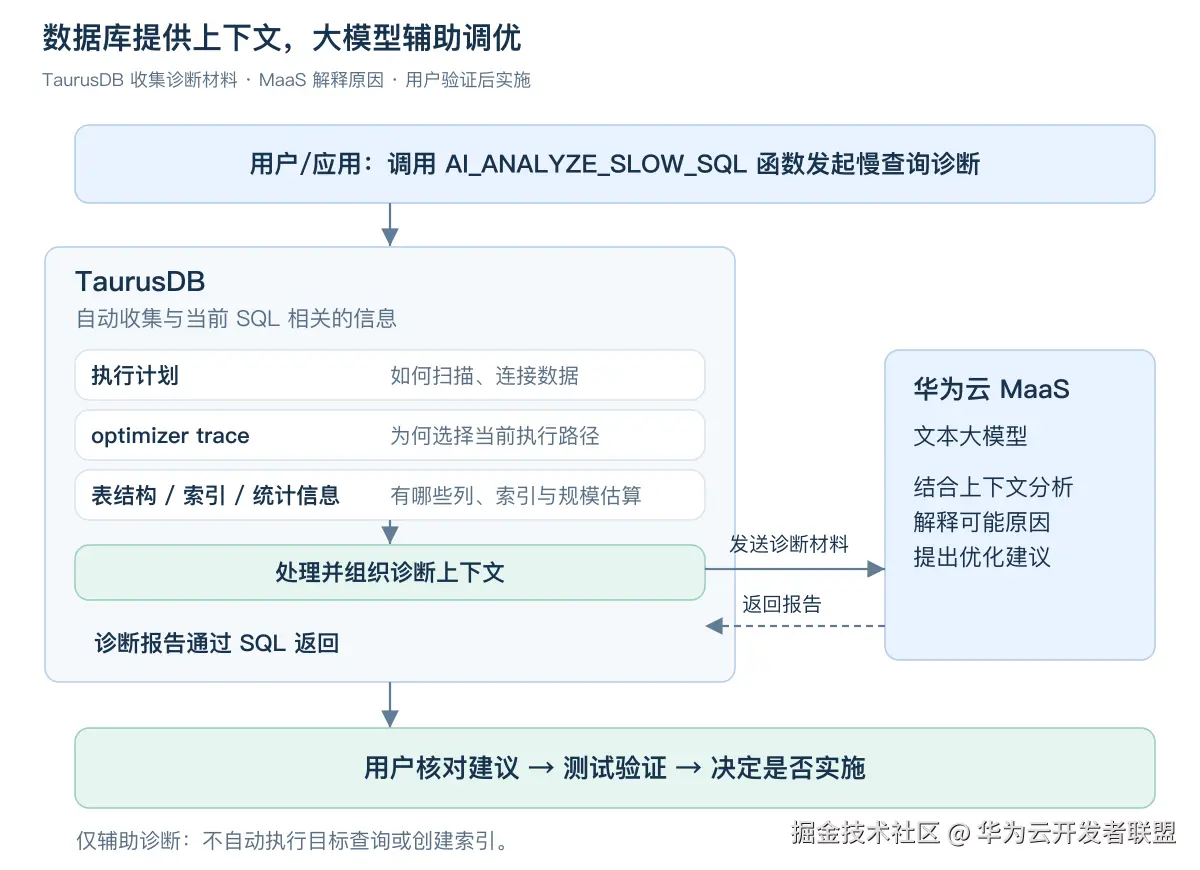 图1:TaurusDB 采集查询信息并调用 MaaS,用户根据报告验证、实施优化。
诊断所需的信息主要有三类:
诊断材料
帮助回答的问题
执行计划
数据库准备怎样读取、关联数据?
优化器跟踪(optimizer trace)
优化器如何评估并选择当前路径?
表结构、索引及统计信息
已有哪些索引,涉及多大规模的数据?
表统计中的行数可能是估算值,不等于实时精确计数。模型会结合这些信息分析问题,建议是否有效仍需实际执行确认。
TaurusDB 将这些材料连同待分析的 SQL 发送给预置文本模型,返回包含诊断结论、依据、优化建议和风险说明的报告。
数据库会将 SQL、表名、列名、索引名、执行计划和优化器跟踪,以及最小化的表与索引元数据摘要发送到 MaaS;未参与的表数据不会外发。诊断使用估算执行计划,不会执行目标查询来测量耗时,也不会自动创建索引;建议需要验证后实施。
2 诊断入口:通过 SQL 获取调优建议
函数支持三个必填参数和一个可选参数:
scss
AI_ANALYZE_SLOW_SQL(model_name, sql_text, database_name [, options])方括号表示可选参数,不需要输入方括号。
参数
必填
说明
model_name
是
实例预置的文本模型名。本例为 huawei/deepseek-v4.1-flash
sql_text
是
待分析的完整 SELECT 语句,以字符串传入,也可以先保存到会话变量
database_name
是
业务数据所在的数据库。本例使用 sales_analytics(销售分析库)
options
否
JSON 格式的调用选项,可设置等待模型返回的超时时间和输出长度,见附录
函数返回诊断报告文本,不返回业务查询结果。使用前,实例需已启用 MaaS,账号需具备模型调用和相关表的访问权限。请在显式事务之外,通过独立 SELECT 调用该函数。
下面以月度促销收入报表为例。
3 案例验证:促销收入查询从 2.2 秒降至 0.2 秒
3.1 TPC-H 数据与促销收入查询
月度促销复盘需要统计促销产品的收入贡献。本例采用TPC-H 标准数据模型及 Q14 查询,使用tpchgen-cli 4.0.0按SF=1生成并导入八张表。SF 是数据规模因子;本次八表源文本合计约1.10 GB,数据库存储还会包含索引等额外空间。
本次实测在华为云 TaurusDB MySQL 实例(2.0.81.260900 版本)完成。
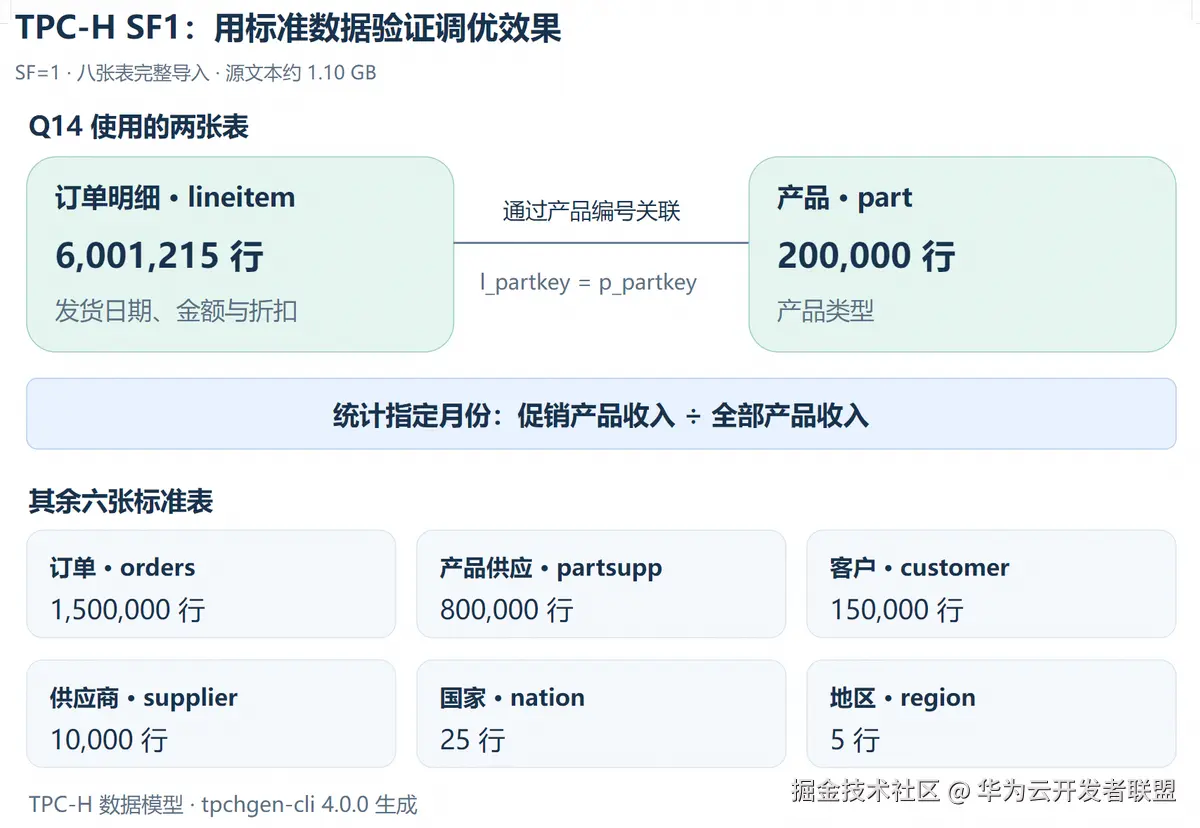 图2:TPC-H SF1 数据规模;本例使用产品表与订单明细表。
这条报表要回答:指定月份发货的产品中,促销产品收入占比是多少? 查询月份沿用 Q14 标准案例的 1995 年 9 月。Q14 用当月促销产品的折后收入作分子,用当月全部产品的折后收入作分母,计算收入占比。lineitem 表提供日期与金额,part 表提供产品类型,两表通过产品编号关联。
3.2 模型诊断与问题定位
示例使用业务库名 sales_analytics(销售分析库);执行前需准备上述 TPC-H 数据。复现时请替换为实际库名。先将完整查询保存到 @slow_sql,再调用诊断函数:
vbnet
USE sales_analytics;
SET @slow_sql = 'SELECT
100.00 * sum(
CASE WHEN p_type LIKE ''PROMO%'' THEN
l_extendedprice * (1 - l_discount)
ELSE
0
END) / sum(l_extendedprice * (1 - l_discount)) AS promo_revenue
FROM
lineitem,
part
WHERE
l_partkey = p_partkey
AND l_shipdate >= date ''1995-09-01''
AND l_shipdate < CAST(''1995-10-01'' AS date)';

SELECT AI_ANALYZE_SLOW_SQL(
'huawei/deepseek-v4.1-flash',
@slow_sql,
'sales_analytics'
) AS diagnostic_report;
优化前,模型给出了以下索引建议:
评估在 lineitem 上增加以 l_shipdate 为前导列的索引。若查询频繁且日期范围较窄,可考虑覆盖索引,例如 (l_shipdate, l_partkey, l_extendedprice, l_discount),以减少全表扫描和回表;但需评估索引大小和写入开销。
原始计划显示,查询先扫描整张订单明细表,再筛选指定月份。独立计数发现,lineitem 共有 6,001,215 行 ,当月只有 75,983 行 ,约占 1.27%。已有索引没有以发货日期开头,无法直接按月份定位数据。模型建议的索引正是针对这部分无关明细的读取。
3.3 索引优化前后的执行计划与耗时
按照大模型提供的调优建议,在测试环境增加以下索引,再执行相同查询。
scss
CREATE INDEX ix_lineitem_shipdate_cover
ON lineitem(l_shipdate, l_partkey, l_extendedprice, l_discount);
l_shipdate 用于定位月份范围,其他三列提供产品编号、金额和折扣。索引包含查询所需的全部明细字段,因此称为"覆盖索引",可以避免为取得这些字段再读取完整明细记录。
数据库按日期找到当月明细后,再按产品编号查询产品类型。查询逻辑保持不变,促销条件仍放在 CASE 中,分母包含当月全部产品收入。
以下是同一测试库索引优化前后的 EXPLAIN FORMAT=TREE 输出,实际执行耗时见下文测试结果。
F优化前:扫描整张明细表,再过滤日期
sql
-> Aggregate: sum((lineitem.l_extendedprice * (1 - lineitem.l_discount))), sum((case when (part.p_type like 'PROMO%') then (lineitem.l_extendedprice * (1 - lineitem.l_discount)) else 0 end))
-> Nested loop inner join (cost=839965.00 rows=659804)
-> Filter: ((lineitem.l_shipdate >= DATE'1995-09-01') and (lineitem.l_shipdate < <cache>(cast('1995-10-01' as date)))) (cost=609033.76 rows=659804)
-> Table scan on lineitem (cost=609033.76 rows=5939420)
-> Single-row index lookup on part using PRIMARY (p_partkey=lineitem.l_partkey) (cost=0.25 rows=1)
优化后:通过日期索引范围读取当月明细
sql
-> Aggregate: sum((lineitem.l_extendedprice * (1 - lineitem.l_discount))), sum((case when (part.p_type like 'PROMO%') then (lineitem.l_extendedprice * (1 - lineitem.l_discount)) else 0 end))
-> Nested loop inner join (cost=83069.08 rows=149806)
-> Index range scan on lineitem using ix_lineitem_shipdate_cover (cost=30636.98 rows=149806)
-> Single-row index lookup on part using PRIMARY (p_partkey=lineitem.l_partkey) (cost=0.25 rows=1)
产品表仍通过主键查找,明细表则由全表扫描改为索引范围扫描。cost 与 rows 是估算值,实际耗时见下表。
对比项
优化前
优化后
明细表读取方式
全表扫描后过滤日期
日期索引范围扫描
执行耗时(五次中位数)
2.2 秒
0.2 秒
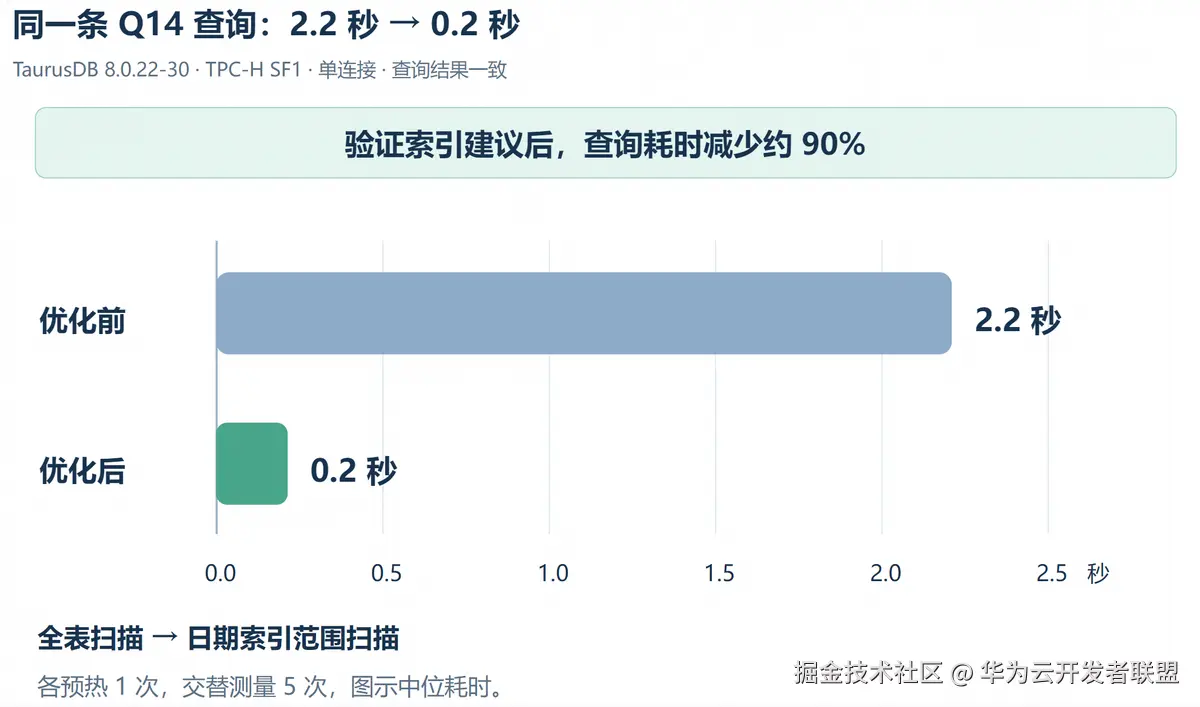 图3:性能测试,预热一次后交替测量五次,展示中位耗时。
增加索引后,查询耗时减少约 90%。优化前后的业务结果一致:
promo_revenue
16.3807786264
促销产品收入占比约为 16.38%。
本次仅增加索引,未修改查询逻辑。索引会占用空间、增加写入维护成本,实际业务需结合负载评估;本例的提速幅度不代表其他慢查询也有同样收益。
结语
TaurusDB 自动整理执行计划、索引和统计信息等诊断材料,交给大模型分析,用户通过 SQL 即可获取调优建议。本例从模型提出的覆盖索引建议入手,通过实际执行验证了优化效果,展示了 AI4DB 在慢查询调优中的用法。
未来,还可探索锁等待与阻塞诊断、系统负载分析等场景,结合事务等待关系、CPU 和 I/O 指标,辅助排查数据库运行中的问题。
附录:参数设置与案例补充
A 调整模型调用参数
如需调整模型调用的超时时间或输出长度,可通过第四个参数 options 传入以下设置:
选项
说明
示例值
timeout_ms
等待模型返回的超时时间,单位毫秒
180000,即 3 分钟
max_output_tokens
模型输出 token 数上限,token 不等于中文字数
4096
沿用正文定义的 @slow_sql,下面将超时时间设为 3 分钟,输出上限设为 4096 token:
less
SELECT AI_ANALYZE_SLOW_SQL(
'huawei/deepseek-v4.1-flash', @slow_sql,
'sales_analytics',
JSON_OBJECT('timeout_ms', 180000, 'max_output_tokens', 4096)
) AS diagnostic_report;
B 本例诊断报告
以下结合本例整理了报告要点,不是逐字原始返回。
诊断结论
lineitem 当前采用全表扫描,再按发货日期过滤。建议评估以发货日期开头的覆盖索引,减少无关明细的读取。
关键证据
lineitem 的访问方式为 ALL,part 通过主键关联;已有明细索引没有以 l_shipdate 为前导列。
可能原因
发货日期条件缺少匹配的索引入口,查询无法直接定位指定月份的数据。
优化建议
评估在订单明细表 lineitem 上创建索引 ix_lineitem_shipdate_cover,索引列依次为 (l_shipdate, l_partkey, l_extendedprice, l_discount),按发货日期定位,并覆盖明细表中查询所需的列。保留 CASE 中的促销条件,确保收入占比的分母不变。
变更风险
新增索引会增加空间和写入维护成本,需要结合业务负载评估。
诊断局限
报告基于当前统计信息和估算执行计划,不包含目标查询的实际运行耗时;建议是否有效,需要通过实际执行验证。
C 执行案例查询
完成正文中的 @slow_sql 定义后,可在同一会话中执行以下语句,查看业务查询结果。使用时请将 sales_analytics 替换为实际库名。
sql
USE sales_analytics;
PREPARE q14_stmt FROM @slow_sql;
EXECUTE q14_stmt;
DEALLOCATE PREPARE q14_stmt;