一份 12 页的技术排查记录,要整理成 5 分钟团队汇报。资料里有 SQL、日志和测试数据,我希望 AI 能提炼重点、保留关键数字,还能标出原文页码。先用哪个模型来做?
模型更新很快,我先到 SwanArc(Model4Task · 模型指南 · Beta) 模型指南查看最新对比,按文档任务和质量、费用偏好筛选候选,最终选用 GPT-6.2 Astra 处理这份资料。下面用一份模拟技术案例,记录从模型筛选到结果核验的完整过程。
1. 按最终要完成的任务来选
资料虽然涉及接口性能排查,但我需要的是汇报提纲。因此进入模型指南后,选择了"办公 / 文档"方向。
这次更看重内容质量:如果数字抄对了,统计口径却变了,汇报仍然会出问题。截图中的偏好设置为 质量 89%、费用 11% (可自由调整),耗时项未参与当前比较,厂商范围保留为全部。 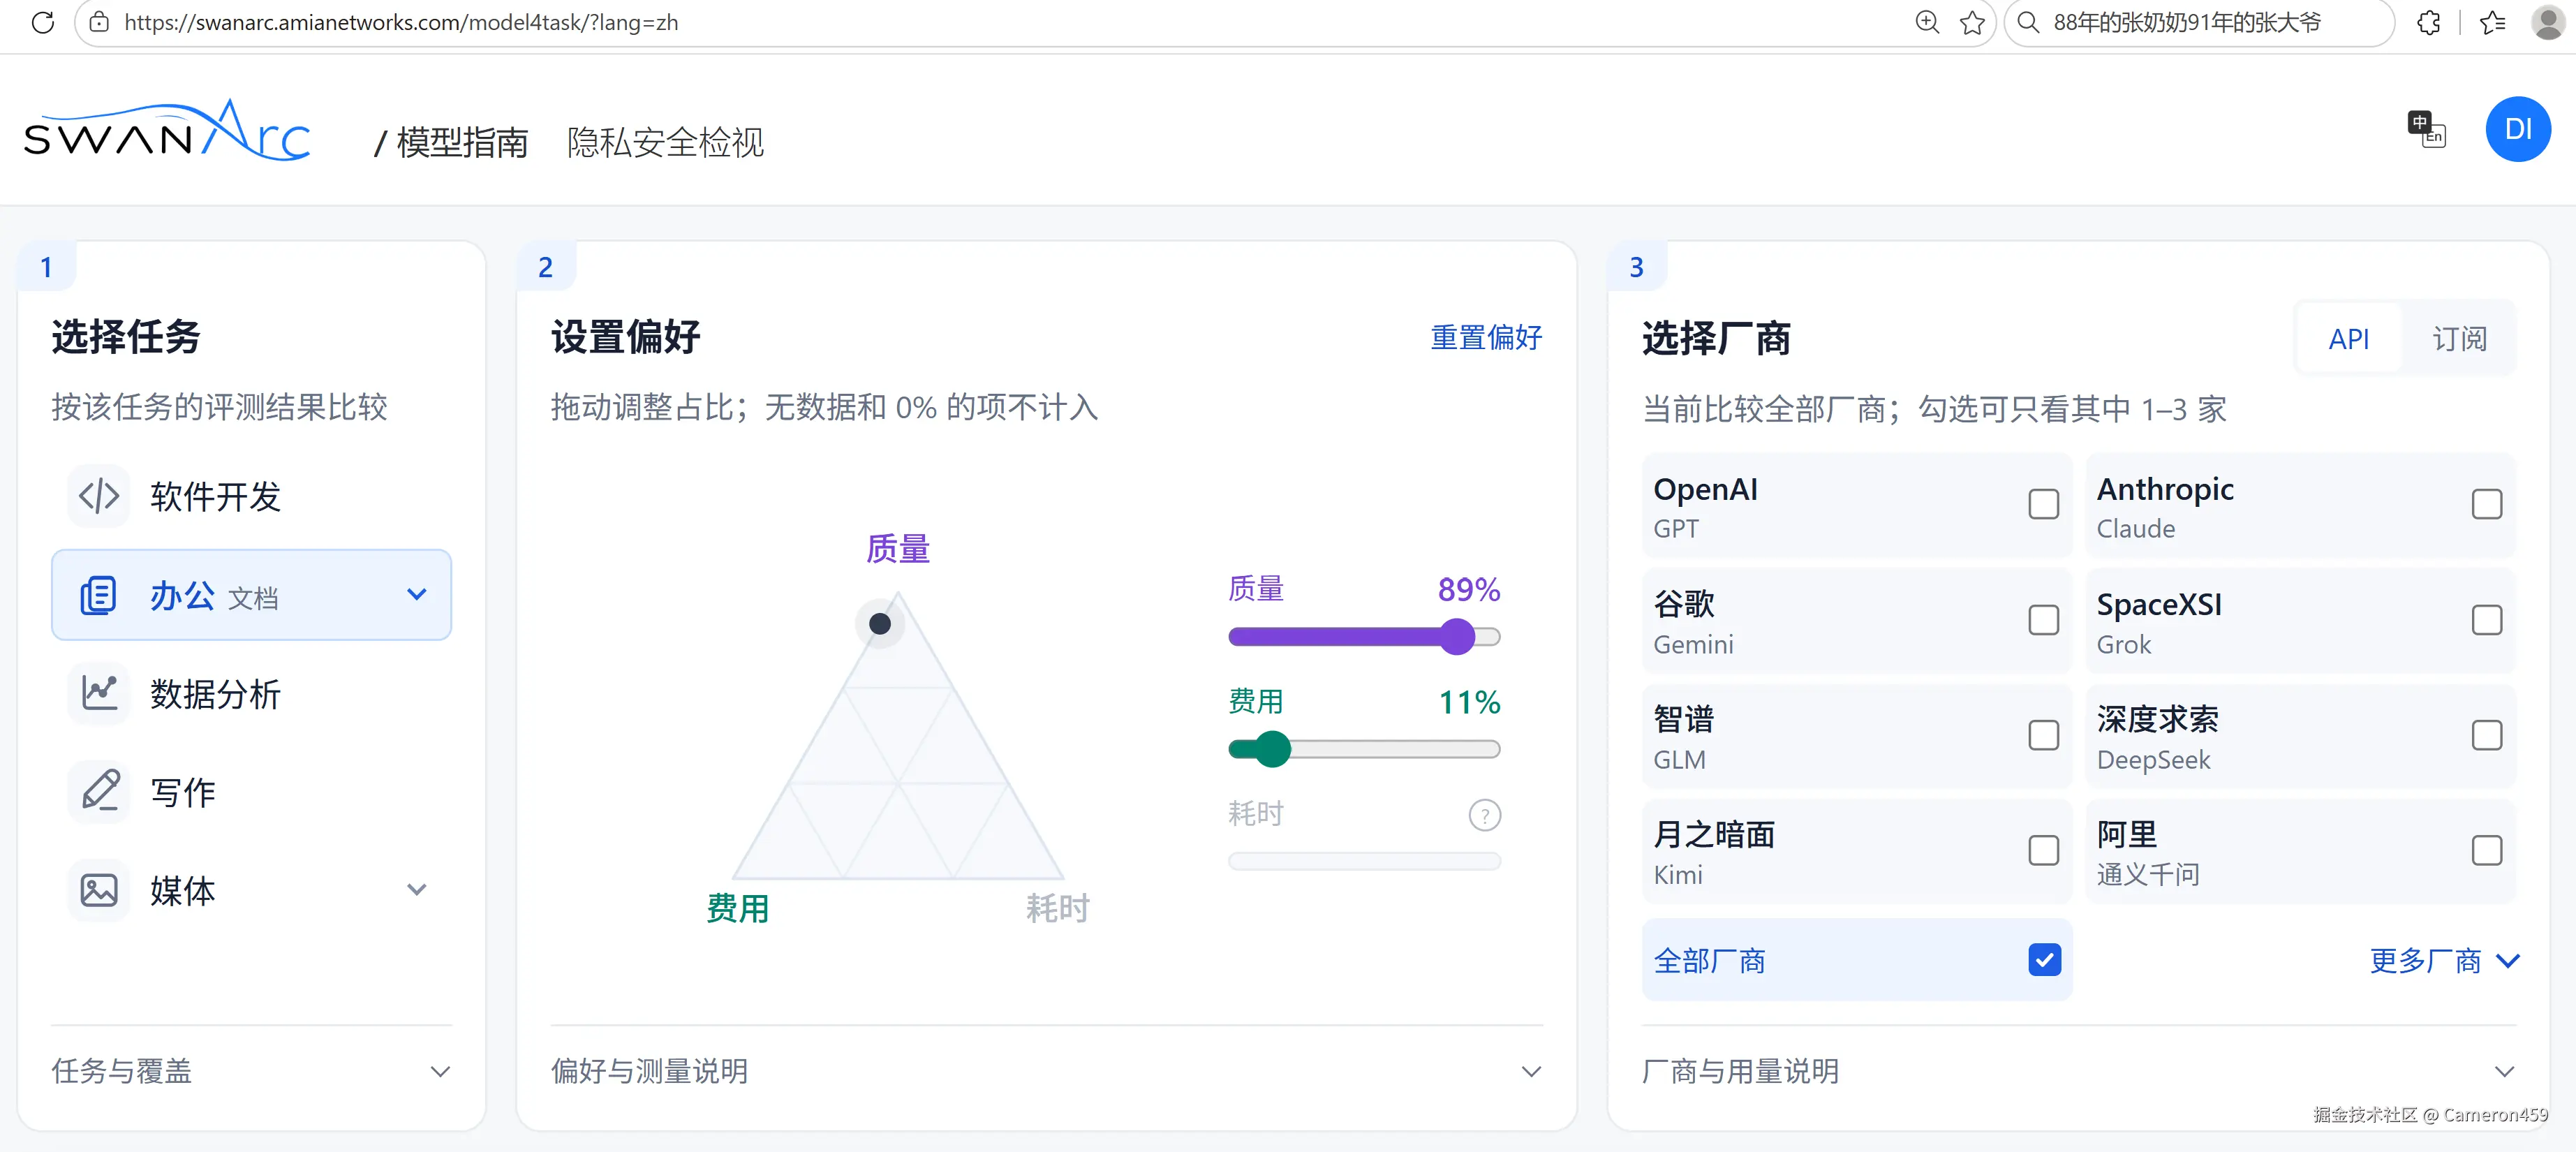 任务和偏好确定后,再看候选就有了具体的比较条件。需要控制预算时可以调整费用偏好;只想看自己能使用的模型,也可以缩小厂商范围。
2. 看候选之间的区别,确定先试谁
当前设置下,页面列出了三个候选:
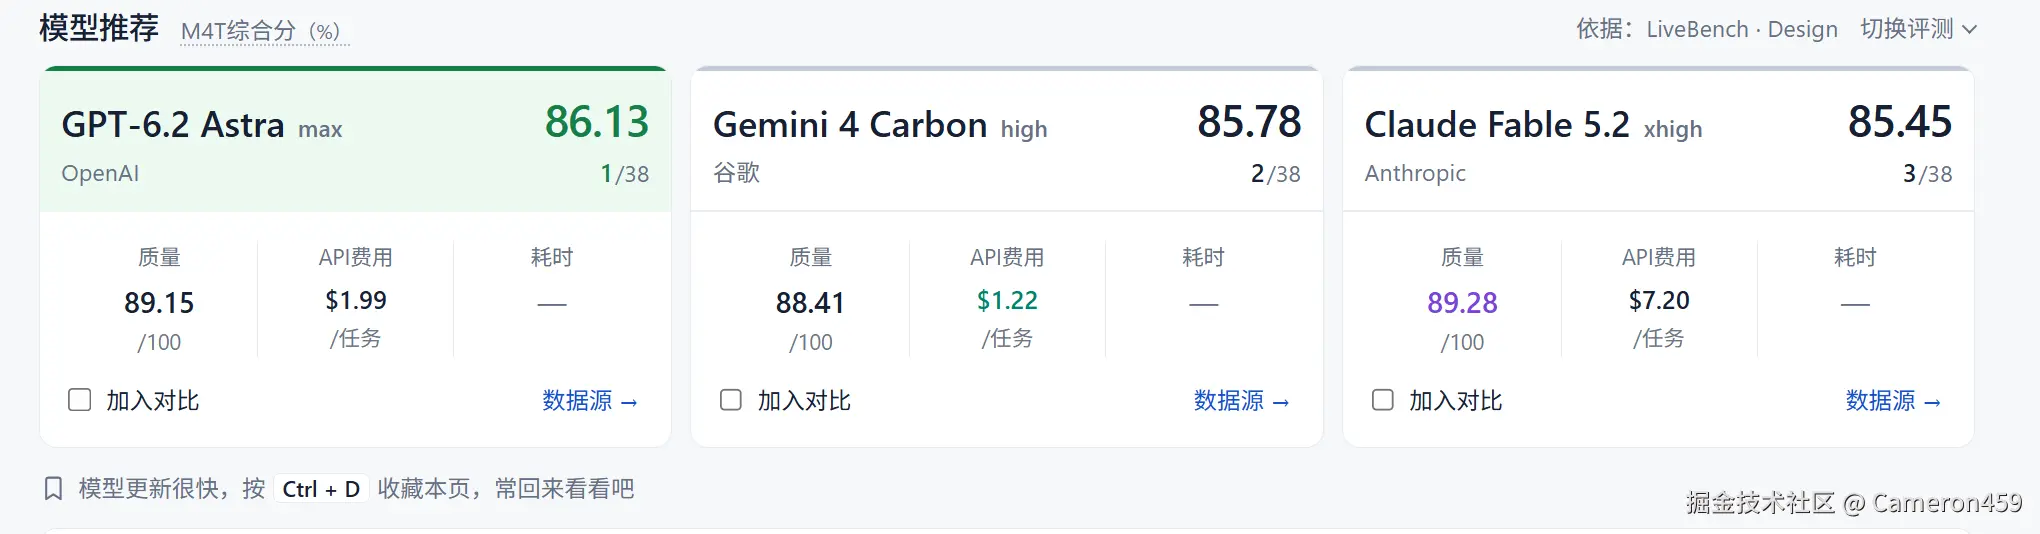
| 候选模型 | 页面质量分 | API 费用参考 / 任务 | 综合分 |
|---|---|---|---|
| GPT-6.2 Astra max | 89.15 | $1.99 | 86.13 |
| Gemini 4 Carbon high | 88.41 | $1.22 | 85.78 |
| Claude Fable 5.2 xhigh | 89.28 | $7.20 | 85.45 |
能看到,质量单项最高的是 Claude,而当前综合排序里最新的GPT-6.2 Astra 在前,Gemini 的费用参考更低。综合分把多个比较维度放到了一起,选择时仍然可以展开看各项差异。
结合自己可用的账号,我决定先试 Astra。实际使用的是 GPT-6.2 Astra,推理设置为"高";指南候选标注为 max,这两个设置分别记录。
到这里,模型指南已经帮我把"先打开哪个 AI"落实成了一个尝试对象。而且里面的测评数据更新非常快,基本上出一个新模型数据推荐就会更新。接下来就用手里的资料检查输出。
3. 上传 PDF,给出明确的交付要求
我没有只让它"总结一下",而是说明听众、时长、结构和核验要求。提示词的核心内容是:
面向没读过原文的研发同事,整理约 5 分钟的技术复盘提纲。按背景、瓶颈、方案、改动、结果和局限组织,每部分保留关键证据和 PDF 页码。最后附五项"关键结论---原文证据---页码"核对表。
仅依据附件,保留模拟案例说明,区分单次请求与多轮统计、测试结果与尚未执行的计划。
这样,拿到回答后就能检查它是否完成了具体任务。
4. 对照结果,判断这次选择是否合适
回答生成了六部分提纲,给出了建议讲述时间、原文页码和五项核对表。
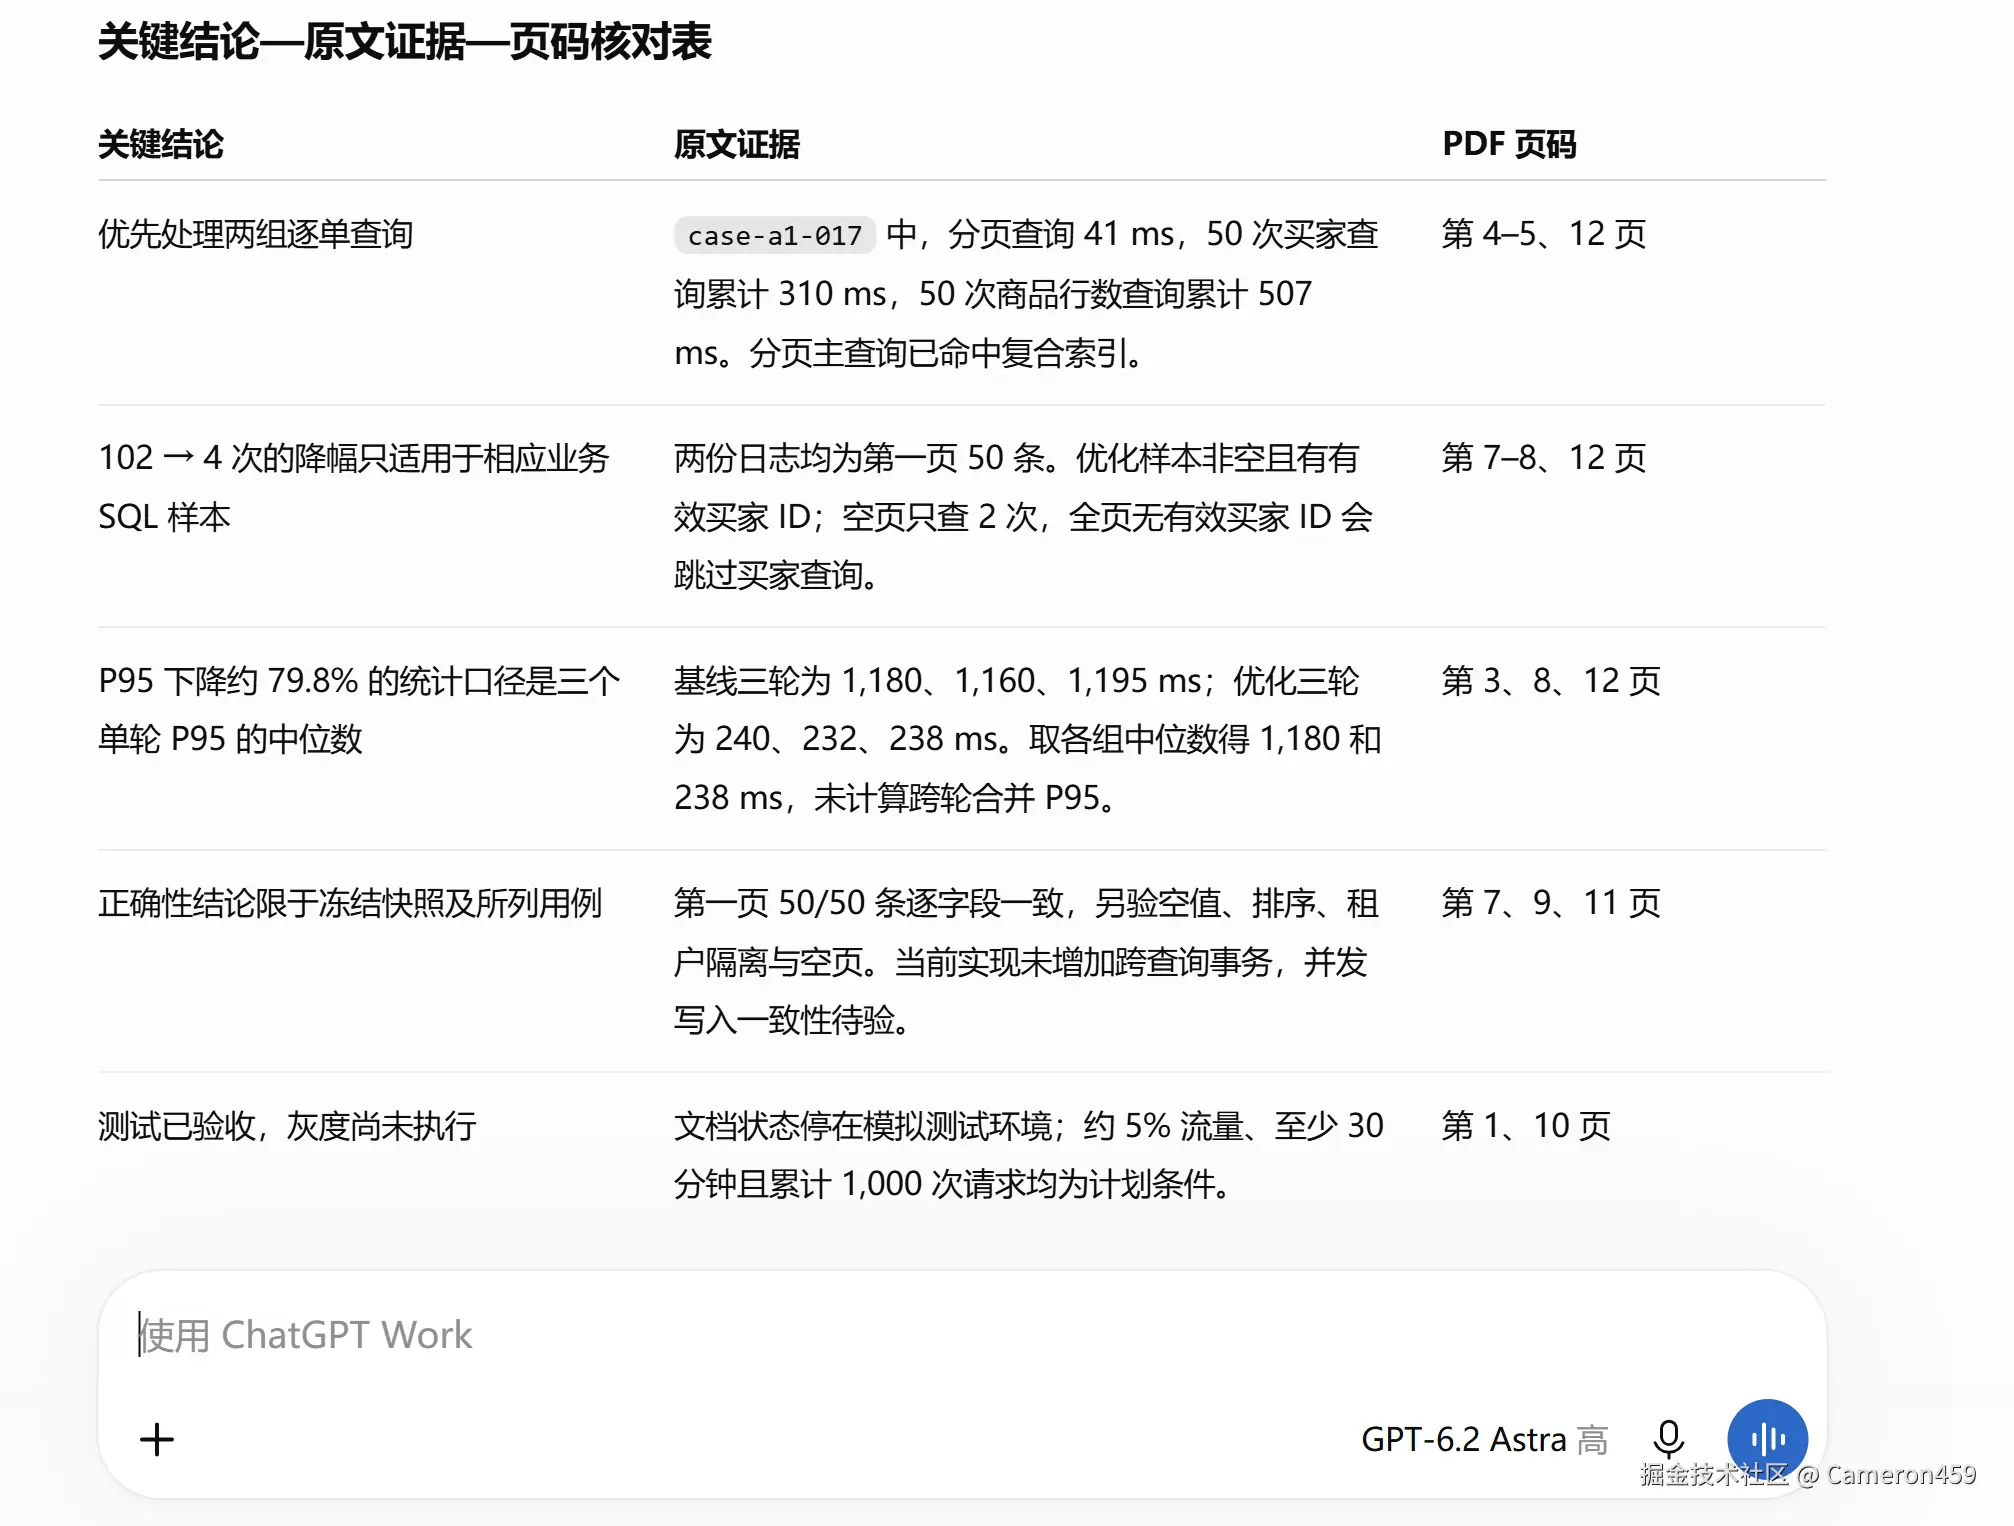
我重点检查了三处:
- SQL 次数的条件有没有丢。 原文中"102 次降为 4 次"针对特定样本,回答保留了空页等例外,对应第 7 页。
- 数字口径有没有变。 1,180 ms 和 238 ms 是两组单轮 P95 的中位数,回答没有写成平均耗时,对应第 3、8 页。
- 计划有没有被写成成果。 回答说明生产灰度尚未执行,与第 10 页一致。
这些抽查项能够对应原文,提纲结构也可以继续使用。不过部分章节要点偏多,用于口头分享前还需要精简。这次只尝试了一个模型,没有做多个候选的同条件对比。
下一次换任务时,可以重新调整指南中的任务与偏好,再选候选试用。