上周翻一个老模块的代码,100 万条 int 先装箱塞进 ArrayList,再序列化上传。我顺手把它和 List<int> 各跑了一遍:GC 统计的存活内存 30.9MB 对 3.8MB,差了八倍。
代码没报错,测试也全绿,问题藏了两年。
集合选错就是这样,编译器不提醒,运行时也不吭声,它只在某天用内存和延迟把账单一并寄过来。
我把 System.Collections 下面常用的类型按五层过了一遍,顺手在本机跑了一组数据。机器是 Xeon E5-2667 v4,16 个逻辑核,32GB 内存,runtime 10.0.11,所有测试都在 Release 下跑三遍取最好成绩。
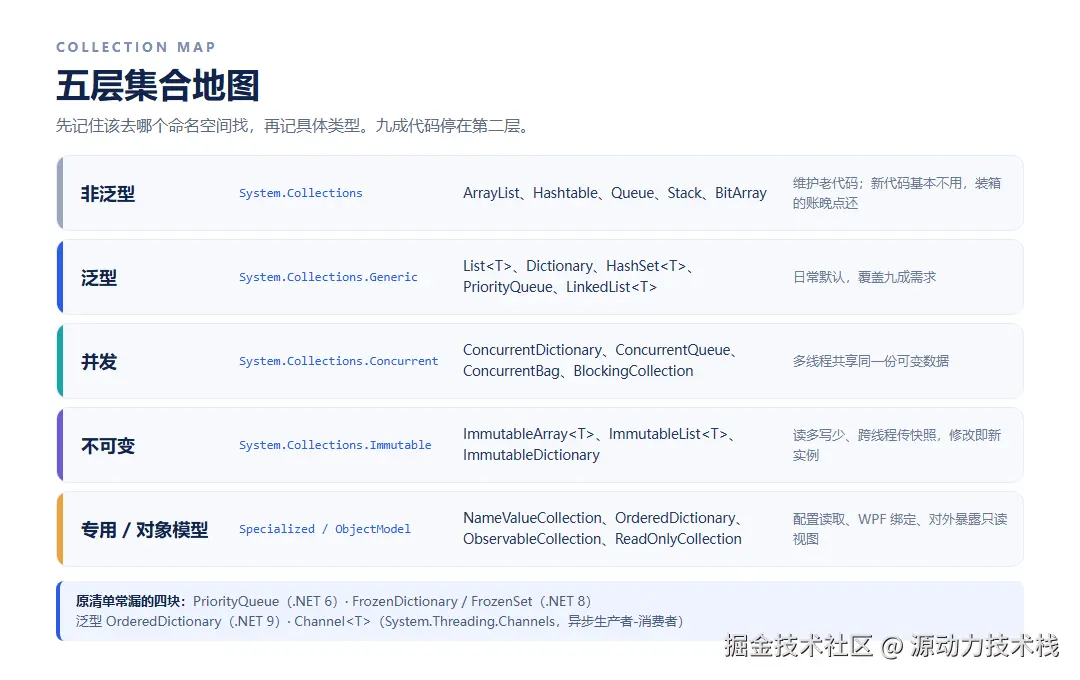
先铺地图:集合分五层
按命名空间切,C# 的集合就五层。前两层是老面孔;后三层决定你在多线程和只读场景里写不写得干净。
| 层 | 命名空间 | 代表类型 | 什么时候看它 |
|---|---|---|---|
| 非泛型 | System.Collections |
ArrayList、Hashtable、Queue、Stack、BitArray |
维护老代码;新代码基本不用 |
| 泛型 | System.Collections.Generic |
List<T>、Dictionary、HashSet<T>、PriorityQueue、LinkedList<T> |
日常默认 |
| 并发 | System.Collections.Concurrent |
ConcurrentDictionary、ConcurrentQueue、ConcurrentBag、BlockingCollection<T> |
多线程共享同一份数据 |
| 不可变 | System.Collections.Immutable |
ImmutableArray<T>、ImmutableList<T>、ImmutableDictionary |
读多写少、要跨线程传快照 |
| 专用与对象模型 | Specialized / ObjectModel |
NameValueCollection、OrderedDictionary、ObservableCollection<T>、ReadOnlyCollection<T> |
配置、WPF 绑定、只读视图 |
网上流传的清单通常会漏掉三块,这篇补上:PriorityQueue<TElement,TPriority> 是 .NET 6 才加的,FrozenDictionary / FrozenSet<T> 到 .NET 8 才出现,泛型 OrderedDictionary<TKey,TValue> 要 .NET 9。还有一个不在 Collections 命名空间、但天天干集合活的 Channel<T>,在 System.Threading.Channels 里。
List:容量在构造时定,时间省六成
List<T> 背后是一个连续数组。没有给容量时,第一次 Add 分配 4 个位置,之后装不下就翻倍:8、16、32,一路涨到装下 1000 万条,最终容量停在 16,777,216。
这个数字是 2 的 24 次方,也就是 64MB。实际只用了 40MB,剩下 24MB 是最后一次翻倍时多要的。
扩容那次复制不便宜。同样 1000 万条数据,不预分配跑了 6171ms,构造时写 25ms。省下的时间全是复制。new List<int>(10_000_000) 只要 23
csharp
// 知道大概多少条,就把容量写进去
var ids = new List<int>(100_000);

// 只读遍历交给数组或 Span,别再 ToArray 复制一遍
foreach (var id in CollectionsMarshal.AsSpan(ids))
{
    Process(id);
}
CollectionsMarshal.AsSpan 从 .NET 5 起可用,拿到的是底层数组的视图,零复制。要喂给 Span<T> 重载的 API(比如解析、哈希、批量计算),它比先 ToArray() 划算。
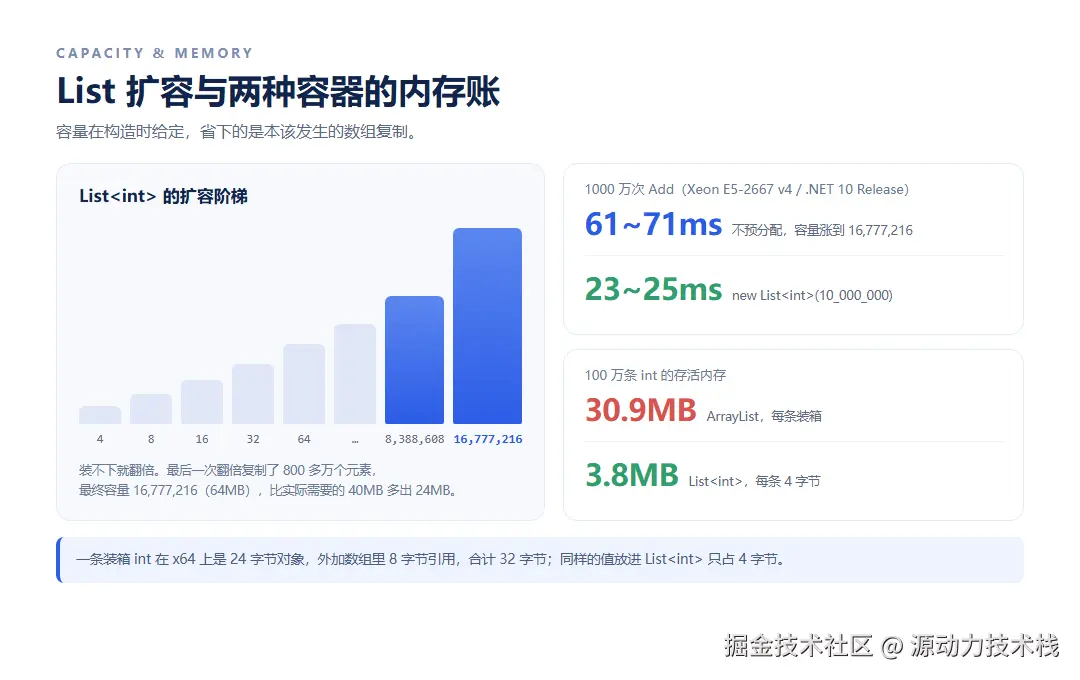
我的习惯:能预估规模的 List 一定给容量;纯读数据用数组或 AsSpan。为了「统一用 List」在中间来回复制,是最不划算的写法。
字典三兄弟:先看插入,再谈查找
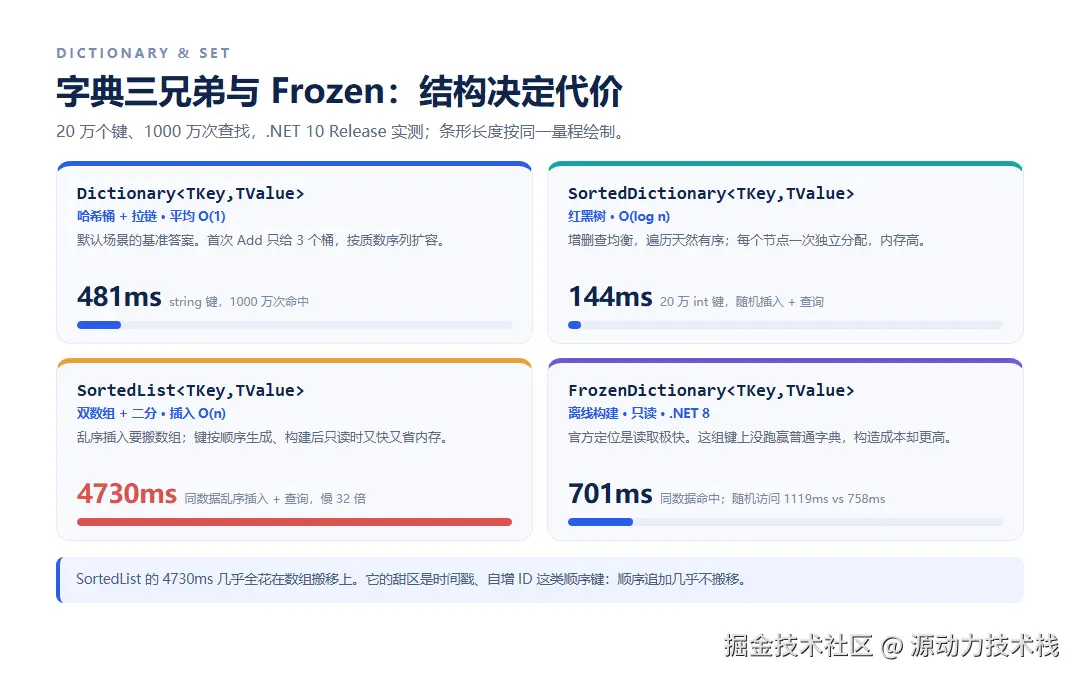
Dictionary<TKey,TValue> 是哈希桶加拉链,查找平均 O(1)。它第一次 Add 只给 3 个桶,装不下按质数序列涨:3、7、17、37、71、163......所以键多的时候,构造函数里给个预估容量,一样能省掉反复重排。
SortedDictionary<TKey,TValue> 是红黑树,增删查都是 O(log n),遍历天然有序。
SortedList<TKey,TValue> 内部是两个数组,一个存键一个存值。查找用二分,插入要搬数组。
老话都说「只读操作多,SortedList 比 SortedDictionary 省内存」。这话只对一半。我拿 20 万个随机 int 键,先乱序插入再逐个查询:SortedList 用了 4730ms,SortedDictionary 144ms。差 32 倍,全耗在数组搬移上。
它真正舒服的场景是键本来就按顺序来:时间戳、自增 ID、按日期归档的账单。顺序追加不搬移,内存又比树结构省,这时它又快又轻。
还有一个 .NET 8 的新面孔:FrozenDictionary。官方定位是「构造成本高、读取极快」,专门给启动时建好、之后只读的配置表。
我按 20 万个 string 键、1000 万次 TryGetValue 测了一遍。普通 Dictionary 481ms,ToFrozenDictionary() 701ms;换成随机顺序访问,758ms 对 1119ms。它没赢,两次都没有。
原因我不敢下结论,可能是这组键的长度分布没让它的分桶策略占到便宜。能确认的只有两点:构造成本确实高,只读场景才有意义。至于「快多少」,别信宣传,信自己机器上的数。
热路径上还有一个省事的小工具:CollectionsMarshal.GetValueRefOrAddDefault,.NET 6 起可用,一次查找同时拿到值和「是否存在」,省掉「先 ContainsKey 再取」的两次哈希。
Set:唯一性和集合运算归它们
HashSet<T> 管去重和集合运算。并集、交集、差集都是一行,底层和 Dictionary 共用一套桶结构,查找 O(1),顺序不保证。
SortedSet<T> 是红黑树版,元素唯一且有序。要按范围取子集(比如取某个时间段内的 ID),它有 GetViewBetween,HashSet 做不到。
FrozenSet<T> 和 FrozenDictionary 同批进来,定位也一样。我测了 100 万个 int、1000 万次 Contains:HashSet 65ms,FrozenSet 63ms。基本打平,构造成本却高出一截。这组数据里,它没体现出「读取极快」。
去重这件事我一般就三步:数据进 HashSet,看 Add 的返回值,最后需要顺序再排一次。比 List.Contains 挨个扫快得多,代码也不长。
队列、栈、LinkedList:出场顺序排好
Queue<T> 先进先出,Stack<T> 后进先出,都是数组实现,进出 O(1)。消息缓冲、撤销栈、广度优先搜索,用它们就够。
PriorityQueue<TElement,TPriority> 是 .NET 6 加的二叉堆,按优先级出队。任务调度、Dijkstra、按超时时间排序的重试队列,用它比每次 List.Sort() 一遍干净。
LinkedList<T> 的名声一直很怪:教科书说它「中间插入删除 O(1)」,实际项目里几乎见不到。我测了一组:10 万个元素,在中间插 2 万次,List 229ms,LinkedList 3ms。插入本身确实是碾压。
但它有两个隐性成本,而且都很致命。第一,找位置不算。你手里没有节点引用时,先遍历到中间就已经 O(n),优势全没了。第二,每个节点单独分配在堆上,前后指针加对象头,遍历时缓存命中率很差。
我的用法只剩一种:先拿到节点引用,再增删 。典型是 LRU 缓存,Dictionary 存 key 到节点的映射,LinkedList 维护顺序。其余场景,List 更好。
并发集合:Concurrent 打底,Channel 收尾
多线程共享一份数据,第一反应该是 System.Collections.Concurrent,不是给普通集合套一把 lock。
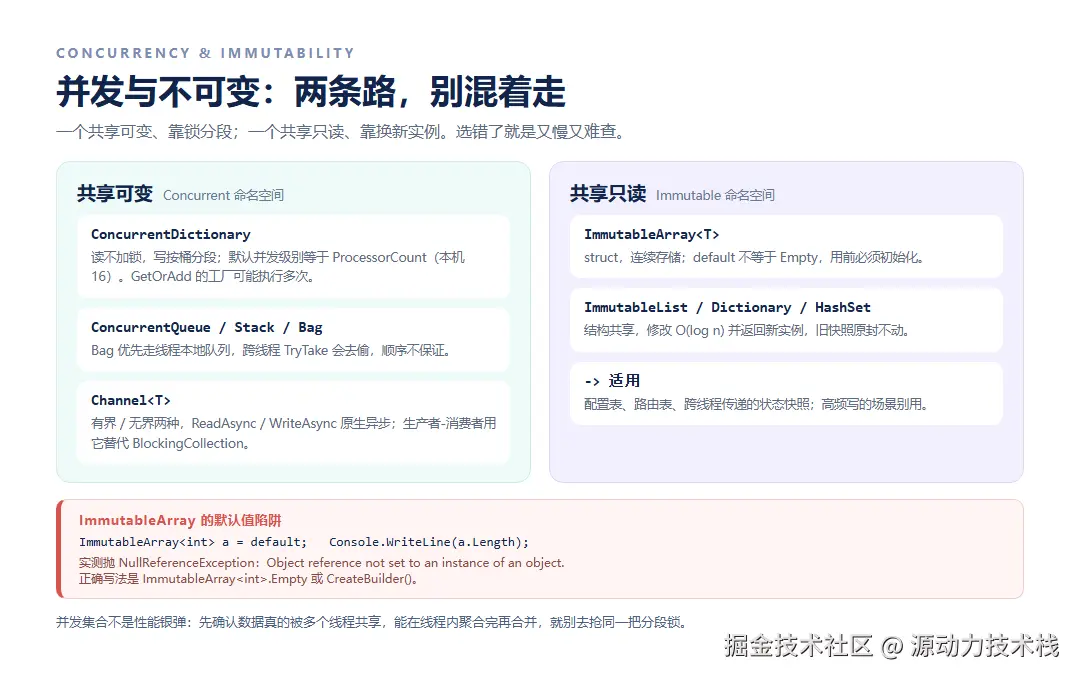
ConcurrentDictionary 是里面最常用的。读基本不加锁,写按桶分段锁。它的默认并发级别等于 Environment.ProcessorCount,我这台机器上是 16。有个坑必须记住:GetOrAdd 和 AddOrUpdate 传进去的工厂委托可能被执行多次,委托里别放发短信、扣库存这种有副作用的操作。
ConcurrentQueue<T>、ConcurrentStack<T> 对应先进先出和后进先出。ConcurrentBag<T> 优先用线程本地队列,适合「同一个线程生产、同一个线程消费」的池化场景;跨线程 TryTake 时会去偷别人的本地队列,顺序完全不保证。
BlockingCollection<T> 不是新容器,是给上面这些集合加「阻塞」和「限界」的包装。默认无界,Take 在空的时候挂起,配合 CompleteAdding 收尾,生产者-消费者能写得很短。
新代码我更倾向 Channel<T>(System.Threading.Channels)。它有有界和无界两种,ReadAsync / WriteAsync 原生异步,不会拿一个线程去阻塞等。BlockingCollection 留给必须同步阻塞的老接口。
不可变集合:ImmutableArray 的 default 会炸
System.Collections.Immutable 里每个常用集合都有一个不可变版本:ImmutableArray<T>、ImmutableList<T>、ImmutableDictionary、ImmutableHashSet<T>、ImmutableSortedSet<T>、ImmutableQueue<T>、ImmutableStack<T>。任何「修改」都返回新实例,旧实例原封不动。
这里有个必须知道的坑。ImmutableArray<T> 是 struct,default 和 Empty 不是一回事:
csharp
ImmutableArray<int> a = default;
Console.WriteLine(a.Length);   // NullReferenceException
我在 .NET 10 上跑出来的异常原文是 NullReferenceException: Object reference not set to an instance of an object.,连读 Length 都炸。正确写法是 ImmutableArray<int>.Empty,批量构建用 CreateBuilder(),最后 ToImmutable()。
ImmutableList<T> 的增删是 O(log n),靠结构共享,不是整份复制。但每次修改仍然分配新对象,高频写的场景别用。
我的判断:配置表、路由表、跨线程传的状态快照,这类读多写少的数据用不可变集合很省心,传出去就不怕别人改。高频写、大对象,老老实实用可变集合加锁或者 Concurrent*。
对象模型集合:只读视图不是快照
ReadOnlyCollection<T> 是包装器,不是副本。它挡住的是「通过这个引用修改」,挡不住别人手里原来的 List。
csharp
var inner = new List<int> { 1, 2, 3 };
var view = inner.AsReadOnly();
inner.Add(4);            // view 里立刻能看到 4
ObservableCollection<T> 实现了 INotifyCollectionChanged,WPF、MAUI 的数据绑定靠它刷新界面。坑在跨线程:后台线程直接 Add,绑定层会抛「不支持从其他线程修改集合」的异常。要么切回 UI 线程,要么在 ViewModel 里自己封一层。
KeyedCollection<TKey,TItem> 是列表和字典的混合体,既能按索引取,也能按键取。适合「有主键、又要保持顺序」的小型领域集合。
Collection<T> 是给你继承的基类,重写 InsertItem、RemoveItem 就能在增删时做校验或通知。System.Collections.Specialized 底下那几个则偏配置场景:NameValueCollection 一个键挂多个值(HTTP 头就是这形状),ListDictionary 给十个八个元素的小字典省内存,HybridDictionary 在元素变多后自动换成哈希表,OrderedDictionary 保持插入顺序,泛型版从 .NET 9 开始才有。
对外暴露集合时,我返回 IReadOnlyList<T> 或 ReadOnlyCollection<T>,不直接 return 内部的 List。调用方拿到可变引用,早晚会有人往里塞东西。
怎么选:速查清单与三条经验
| 场景 | 选型 | 代价 |
|---|---|---|
| 顺序列表、按索引访问 | List<T>,预估容量 |
中部插入要搬数组 |
| 键值查找 | Dictionary<TKey,TValue> |
无序;扩容要重排 |
| 有序遍历、频繁增删 | SortedDictionary<TKey,TValue> |
每节点一次分配,内存高 |
| 键按顺序来、构建后只读 | SortedList<TKey,TValue> |
乱序插入会退化 |
| 构建后只读、追求读性能 | FrozenDictionary / FrozenSet<T> |
构造成本高,先实测 |
| 去重、交并差 | HashSet<T> |
顺序不保证 |
| 有序去重、范围查询 | SortedSet<T> |
增删 O(log n) |
| 先进先出 / 后进先出 | Queue<T> / Stack<T> |
只能从两端操作 |
| 按优先级出队 | PriorityQueue<TElement,TPriority> |
遍历无序 |
| 多线程共享 | ConcurrentDictionary、ConcurrentQueue<T> |
单次操作比非并发版慢 |
| 生产者-消费者 | Channel<T> |
要处理完成与异常传播 |
| 只读快照、跨线程传递 | ImmutableArray<T>、ImmutableList<T> |
每次修改分配新对象 |
| WPF 数据绑定 | ObservableCollection<T> |
跨线程更新要切 UI 线程 |
| 小配置、多值键 | NameValueCollection、ListDictionary |
只适合小数据量 |
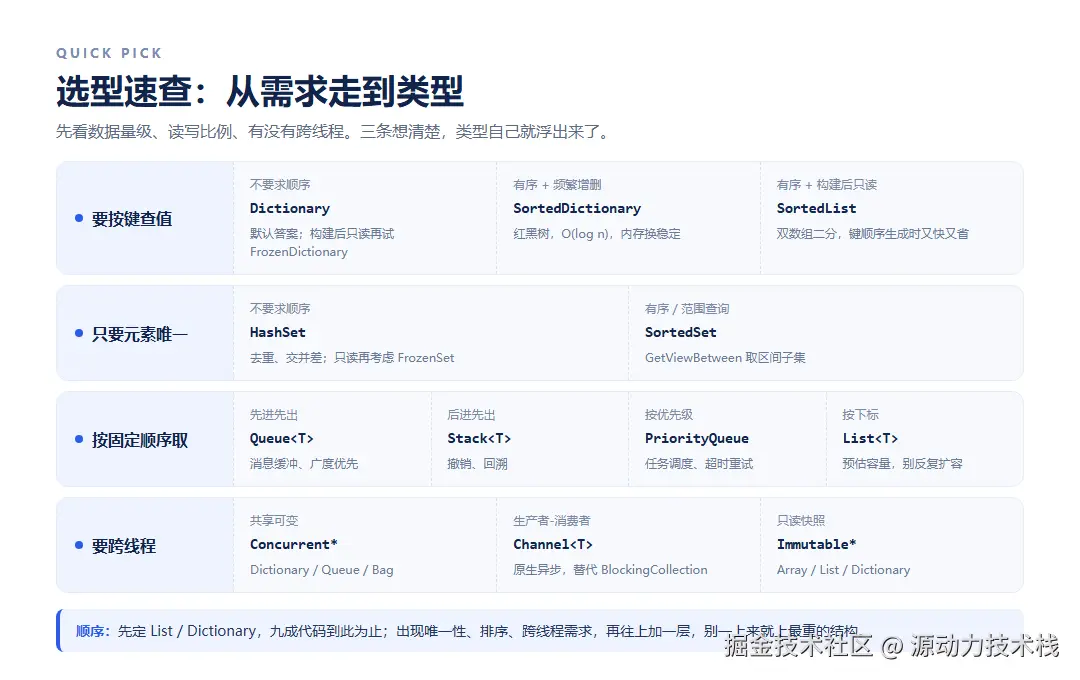
三条经验,都是踩过坑之后留下的:
- 默认就用
List<T>和Dictionary<TKey,TValue>。九成代码到这里就结束了,别为了「用上高级集合」把简单逻辑写复杂。 - 新代码别碰非泛型集合,
ArrayList那 30.9MB 就是前车之鉴。装箱的账不是不还,是晚点还。 - 并发集合不是性能银弹,它只是把竞争挪了个位置。先问是不是真的共享:能在线程内聚合完再合并,就别让 16 个线程去抢同一把分段锁。
选集合这件事,我最后只看三条:数据量级、读写比例、有没有跨线程。三条想清楚,类型自己就浮出来了。
如果这篇文章对你有帮助,欢迎关注公众号「阿波技术栈」,后续会继续输出全栈、工业软件与效率工具的实践内容。