作者:范振,StarRocks TSC Member;阿里云开源 OLAP 负责人
构建 Lakehouse 原生 OLAP 引擎,一直是 StarRocks 的首要方向。用户可以把业务数据留在开放湖表里,直接用 StarRocks 做多表关联、聚合和交互式分析。报表和临时查询都可以围绕同一份湖上数据展开。
近两年,随着 AI 应用和模型训练越来越多地用到图片、视频、音频和文本,StarRocks 加大了对多模态分析与检索的投入。做报表时,分析师通常知道该查哪些表。准备训练数据时,工程师手里可能只有一句描述或一张参考图,需要先找到一批相关样本,再决定怎样筛选和分析这批数据。
为什么要统一分析与检索
拿雨夜道路图片做训练集为例,团队希望用同一条 SQL 完成两件事。先取少量样本预览,确认找出的图片符合预期。条件确定后,只需调大返回数量,就能用同一套检索和筛选条件生成训练样本清单。
过去,这类任务往往由两个系统接力完成。检索服务先找一批相似图片,把候选 ID 交给 OLAP 引擎,再关联标签和采集记录,筛选并统计样本。小批量预览时,跨系统传一份清单的开销有限。要生成几万张图的训练集,候选清单也跟着变大,筛完数量不够还得回到检索端补查。
两个系统各自生成执行计划,很难联合优化。比如,城市和路况只保存在分析库时,检索服务无法提前利用这些条件,可能返回大量随后会被剔除的图片。要让检索服务也能按城市和路况过滤,就得再存一份业务属性,还要跟踪源表更新,保证两边的数据一致。
StarRocks 把向量检索和 OLAP 放进同一条湖表查询。优化器能看到检索、过滤、关联和聚合的完整计划,可以在不改变查询语义的情况下把部分过滤条件提前执行。检索结果直接在引擎内关联图片标签、统计样本分布,应用不用在两个系统之间传候选 ID,也不必为这条链路单独同步一份业务属性。
AI 多模态分析与检索
AI 多模态分析与检索的典型场景
智驾、具身智能、广告投放和游戏资产管理都用得到相似检索。找到相似内容之后,四个行业要做的判断各不相同。
智驾。 工程师拿一帧雨夜接管画面找相似片段,再对照命中时刻的点云、车速和软件版本,判断这些片段能否用于复盘同一类问题。
具身智能。 机器人团队想复盘一次抓取失败,可以先找动作相近的任务片段,再把视频和接触力、动作轨迹对上,弄清失败发生在哪一步。
广告投放。 投放团队用一条参考广告找画面相近的素材,再关联各渠道的点击和转化数据,判断哪些素材值得复用或追加预算。
游戏资产管理。 美术团队用参考图检索相似的角色或场景资产。找到素材之后,还要核对版本、项目归属和使用授权,才能决定能否复用。
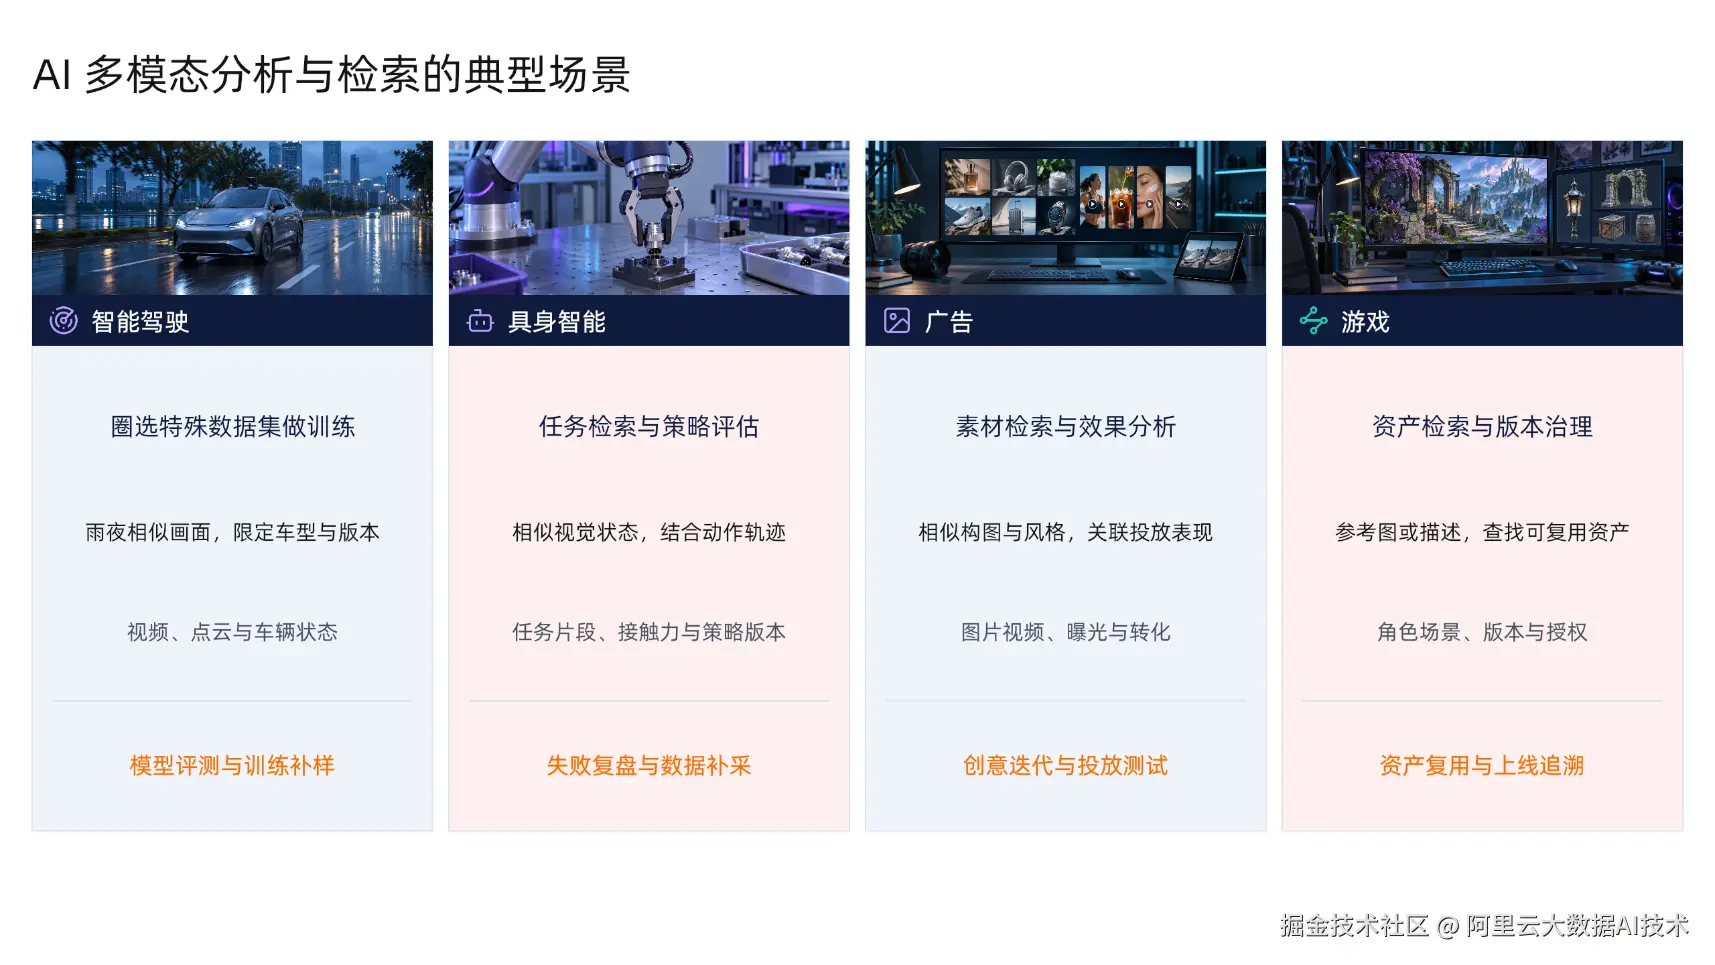
图 1 智驾、具身智能、广告和游戏的多模态查询场景
同一份数据支撑多种查询模式:智能驾驶案例
智驾数据宽表把帧 ID、车辆、软件版本、采集时间、场景标签、视频和向量关联起来。同一份数据可以支持几种查询。
-
KV 主键点查。 已知帧 ID
frame_018,用WHERE frame_id = 'frame_018'精确取回对应记录和视频地址。如果表以车辆和采集时间作为组合键,也可以用这两个值定位驾驶帧。 -
OLAP 分析。 按车型和软件版本统计接管事件,看看接管集中在哪些版本。
-
全文与向量检索。 记得「雨夜加塞」这样的关键词,可以搜场景描述。手里有一张问题截图,可以按向量找相似画面。
-
混合检索与结果分析。 想找某车型在雨夜的相似画面,可以用车型和天气限定范围,再按相似度排序。拿到候选后,还能按软件版本聚合,查看命中样本的分布。
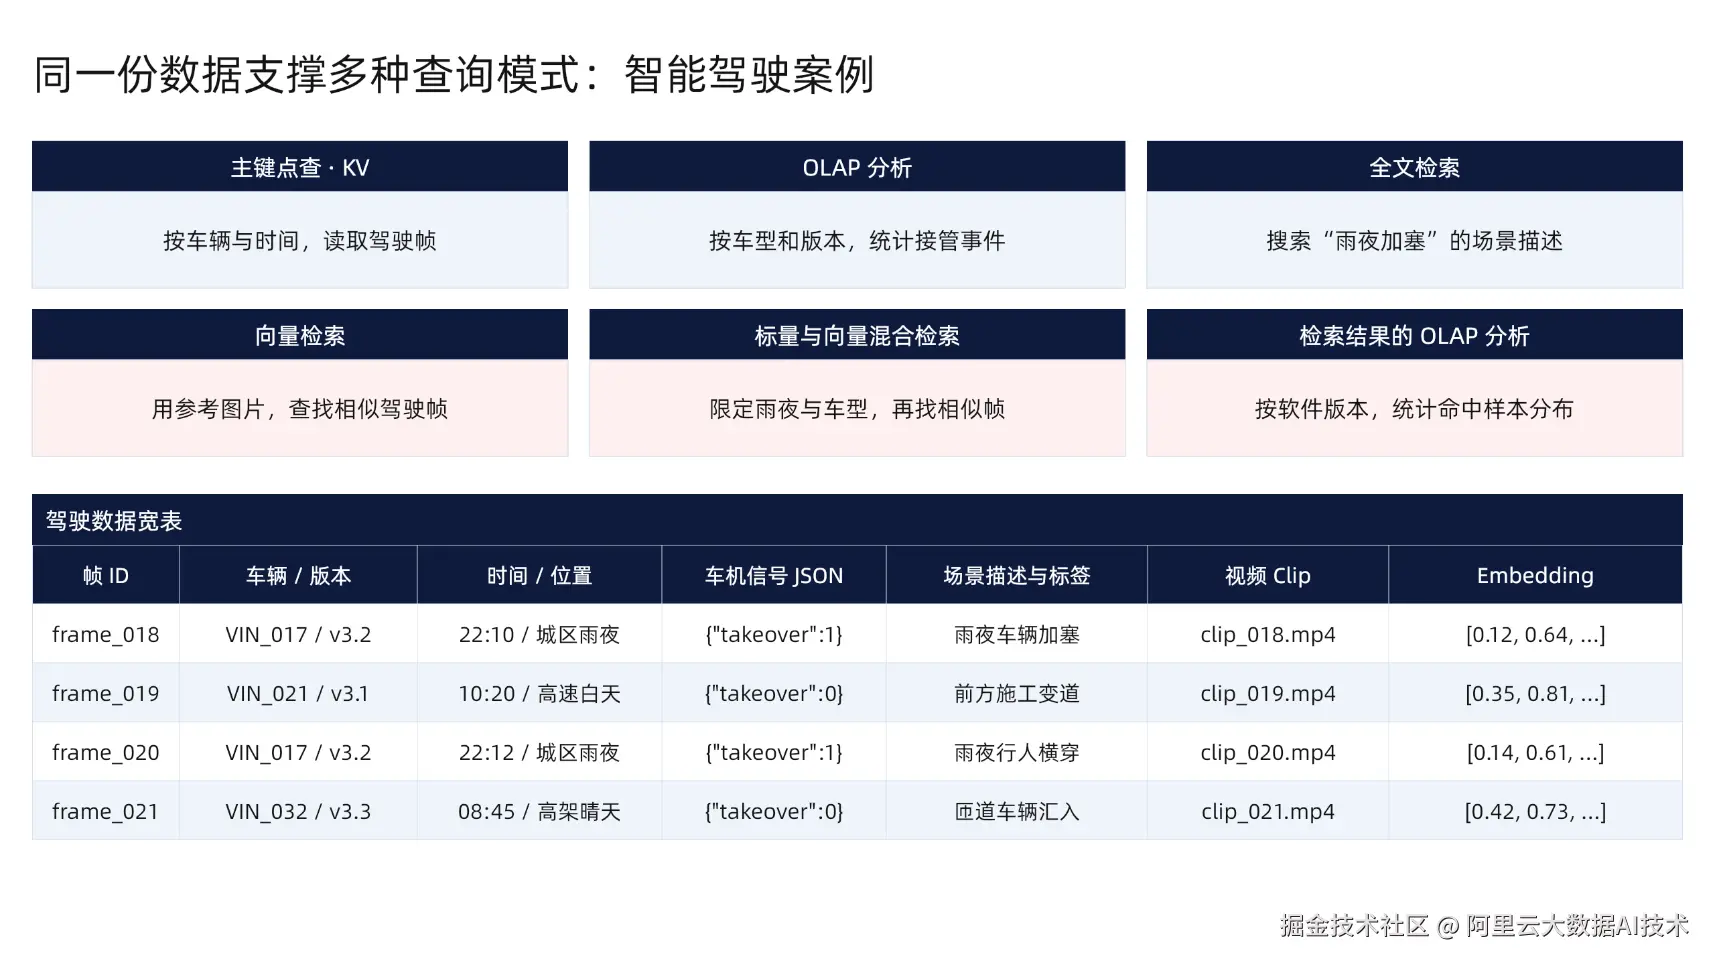
图 2 驾驶数据宽表及其支持的查询模式
多模态 Lakehouse:AI 与 BI 共用一份数据
训练、检索和分析都要用到这些图片和视频。媒体保存在对象存储里,湖表用稳定的样本 ID 关联原始内容、业务属性、标签和向量。工程师从检索结果可以回到原视频,特征加工任务也可以把新标签或向量对回已有样本。不同环节可以复用同一份湖上数据,减少复制大文件的开销。
Flink、Ray 或 Spark 可以负责入湖和加工,StarRocks 做分析和检索,Python SDK 为数据准备提供程序化访问。Paimon、Iceberg 和 Lance 各有适用场景,选型时还要看读写方式、数据类型和索引需求。
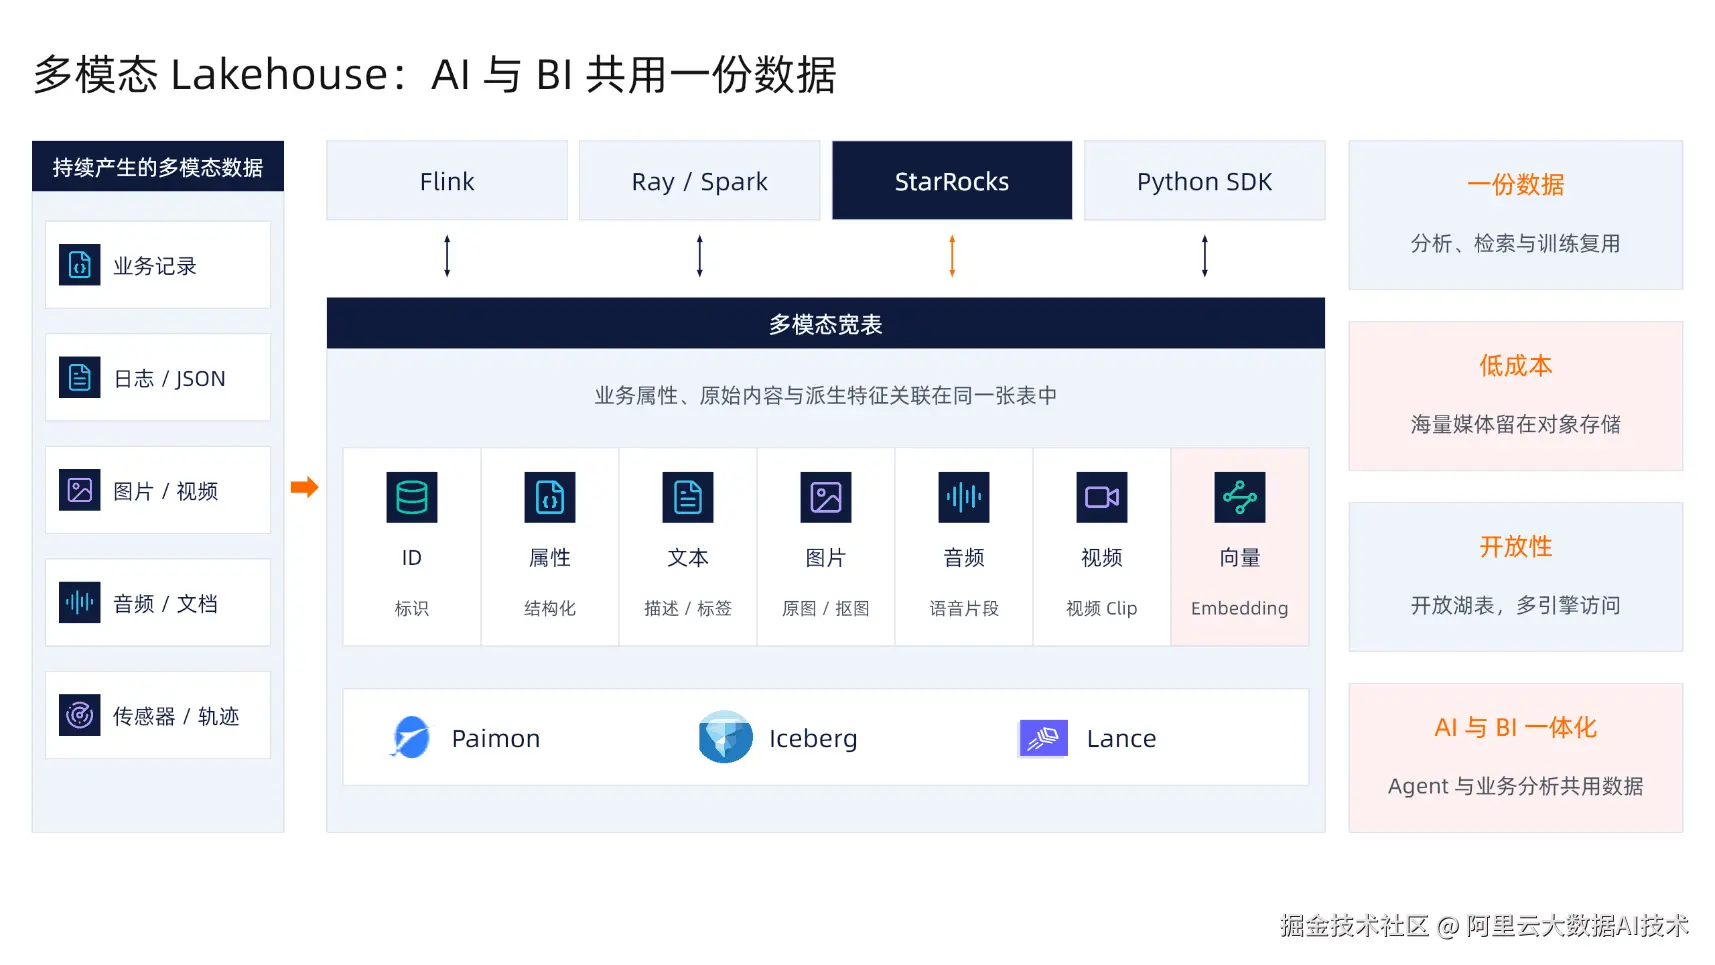
图 3 开放湖表上的原始内容、业务属性和派生特征
EMR Serverless StarRocks 产品能力
EMR Serverless StarRocks 多模态统一检索分析
从结构化数据分析,到多模态混合检索,再到 AI 应用。
-
结构化数据分析。 先做好湖上的 SQL 查询。实时 BI 需要对业务明细做关联、聚合和下钻,已知键值的请求则可以直接点查。
-
多模态混合检索。 当数据里有文本、图片和视频时,可以用关键词或向量找到相关内容,同时用时间、标签等属性限定候选范围。检索出来的样本还能继续用 SQL 关联和聚合。
-
AI 应用。 同一套查询能力可以供模型训练圈选样本和评估候选集,也可以用在 RAG 的知识检索和 AI Memory 的历史记录检索中。
这条演进主线基于同一个 SQL 入口。StarRocks 能查询内表,也能读取 DLF 管理的 Paimon、Lance 和 Iceberg 湖表。Kafka、Flink CDC 和 DataX 等工具负责接入数据,文档解析和 Embedding 则把原始内容加工成可查询的文本和向量。
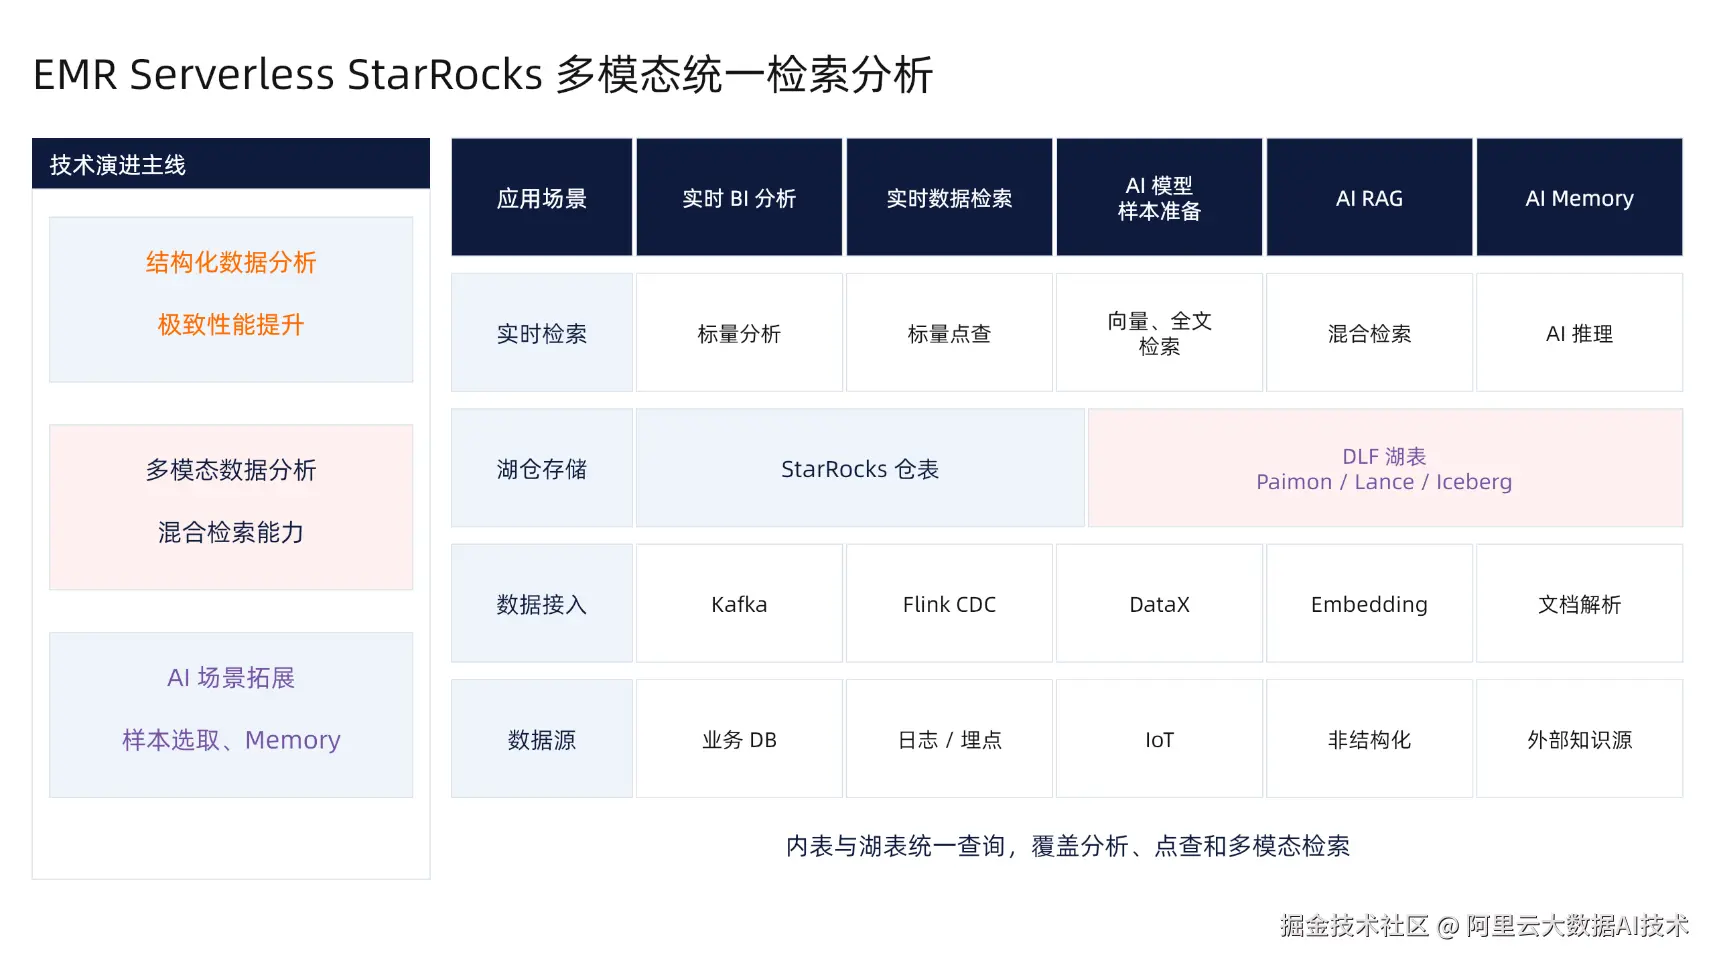
图 4 EMR Serverless StarRocks 的统一查询架构
EMR Serverless StarRocks 四类应用场景
实时分析。 这是 StarRocks 最早发力、落地也最广的场景。电商团队要实时跟踪订单和支付,广告团队要随时看投放消耗。指标一有波动,运营人员还要从看板下钻到明细,查清变化来自哪里。围绕这类需求,我们在多个行业积累了大量生产案例。
统一数仓。 数据到了几十 TB,很多团队希望用一个大数据引擎同时做加工、报表和即席分析。复杂关联和聚合要跑得快,长期运行的算力成本也要控制住。除了优化查询性能和性价比,我们用多个 Warehouse 把导入、ETL 和在线查询隔开,让各组独立伸缩。许多客户已经用这套方式搭建统一数仓。
湖仓分析。 当业务明细已经存进数据湖,分析人员希望直接查湖上的数据。这是我们近几年持续投入的方向。对 Paimon 和 Iceberg,StarRocks 既能通过 Catalog 直接查明细,也能在湖表上建物化视图,加速经常重复的查询。湖上数据还可以继续供其他引擎使用。
AI Native。 近两年,我们进一步把能力扩展到 AI 数据准备。找素材或圈选训练样本时,可以结合业务条件、关键词和向量相似度做多模态检索。素材需要打标签、提取字段或生成向量时,也可以在 SQL 中通过 AI Function 调用模型,把结果写回表里供后续查询使用。
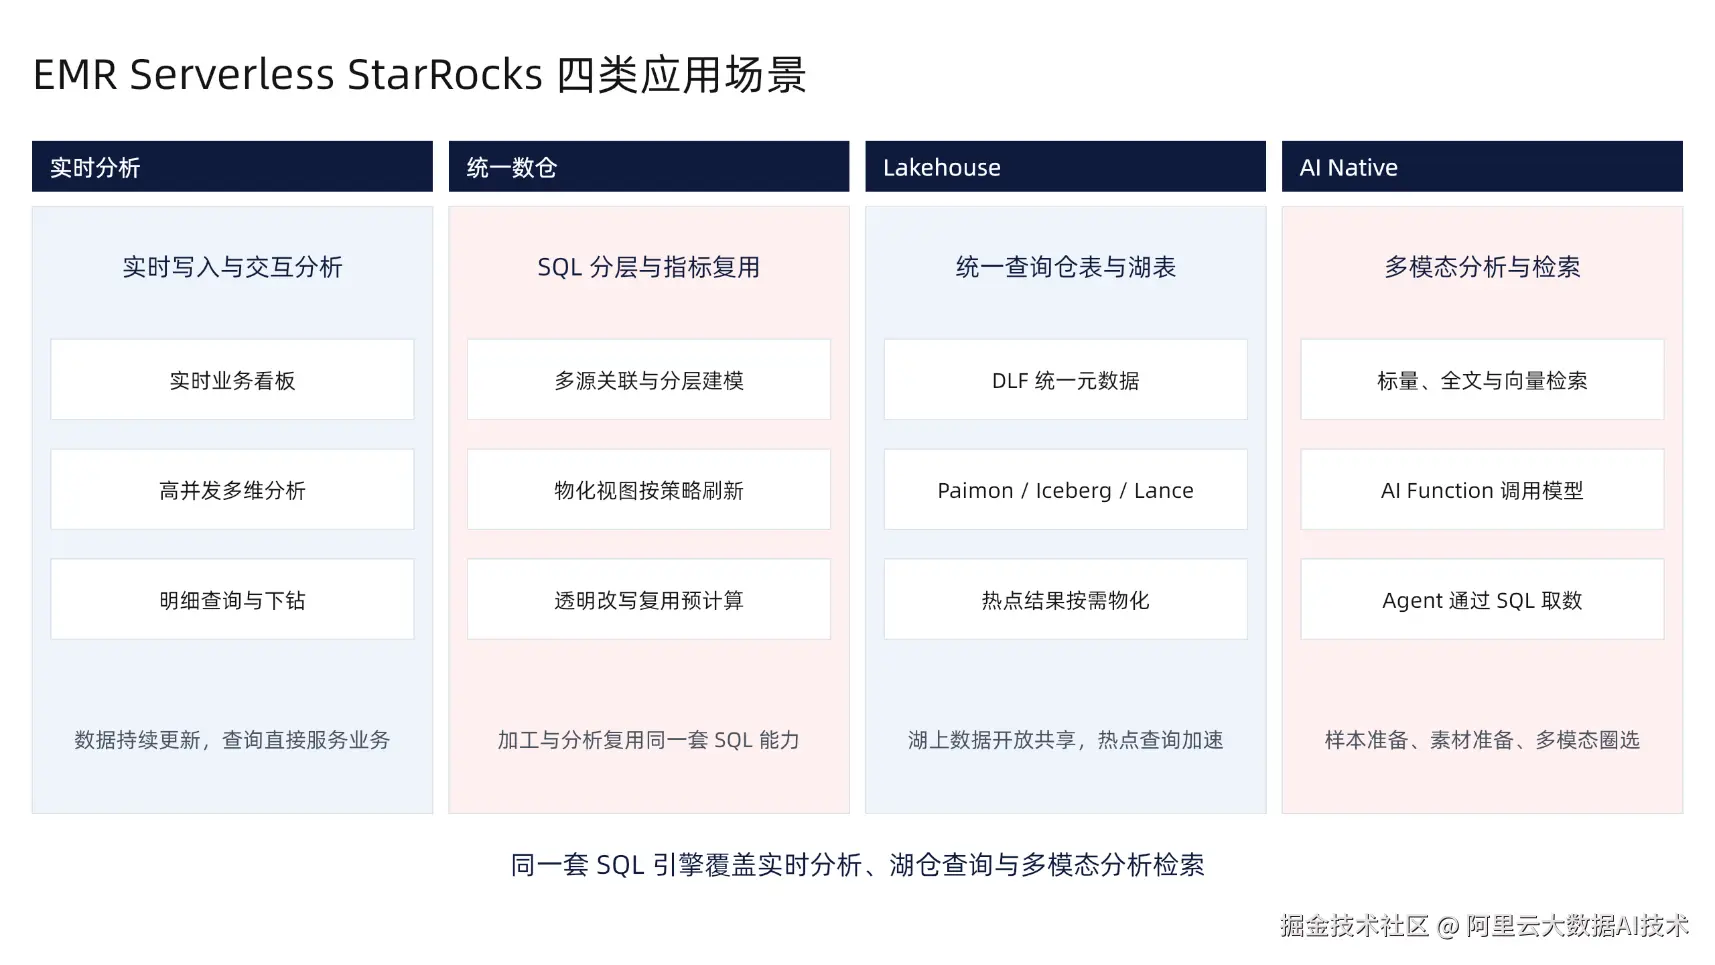
图 5 实时分析、统一数仓、湖仓分析和 AI 应用
EMR Serverless StarRocks 云原生产品架构
批量导入和 ETL 容易在短时间内占用大量资源,在线报表、点查和多模态检索则各有并发和时延要求。这些任务可以放在不同的 Warehouse 里,由 FE 调度。每个计算组按自己的负载伸缩,计算节点有本地 StarCache,底层共用 OSS 对象存储。
新数据在 OSS 发布后,读侧可以提前预热接下来要访问的数据块。预热时可以根据节点繁忙度和带宽,从已经缓存这些数据块的 Peer 节点读取。取不到时再回源 OSS。两种方式取得的数据都填到当前节点缓存里。这样,各组使用各自的计算资源,同时可以少做一部分重复的对象存储读取。
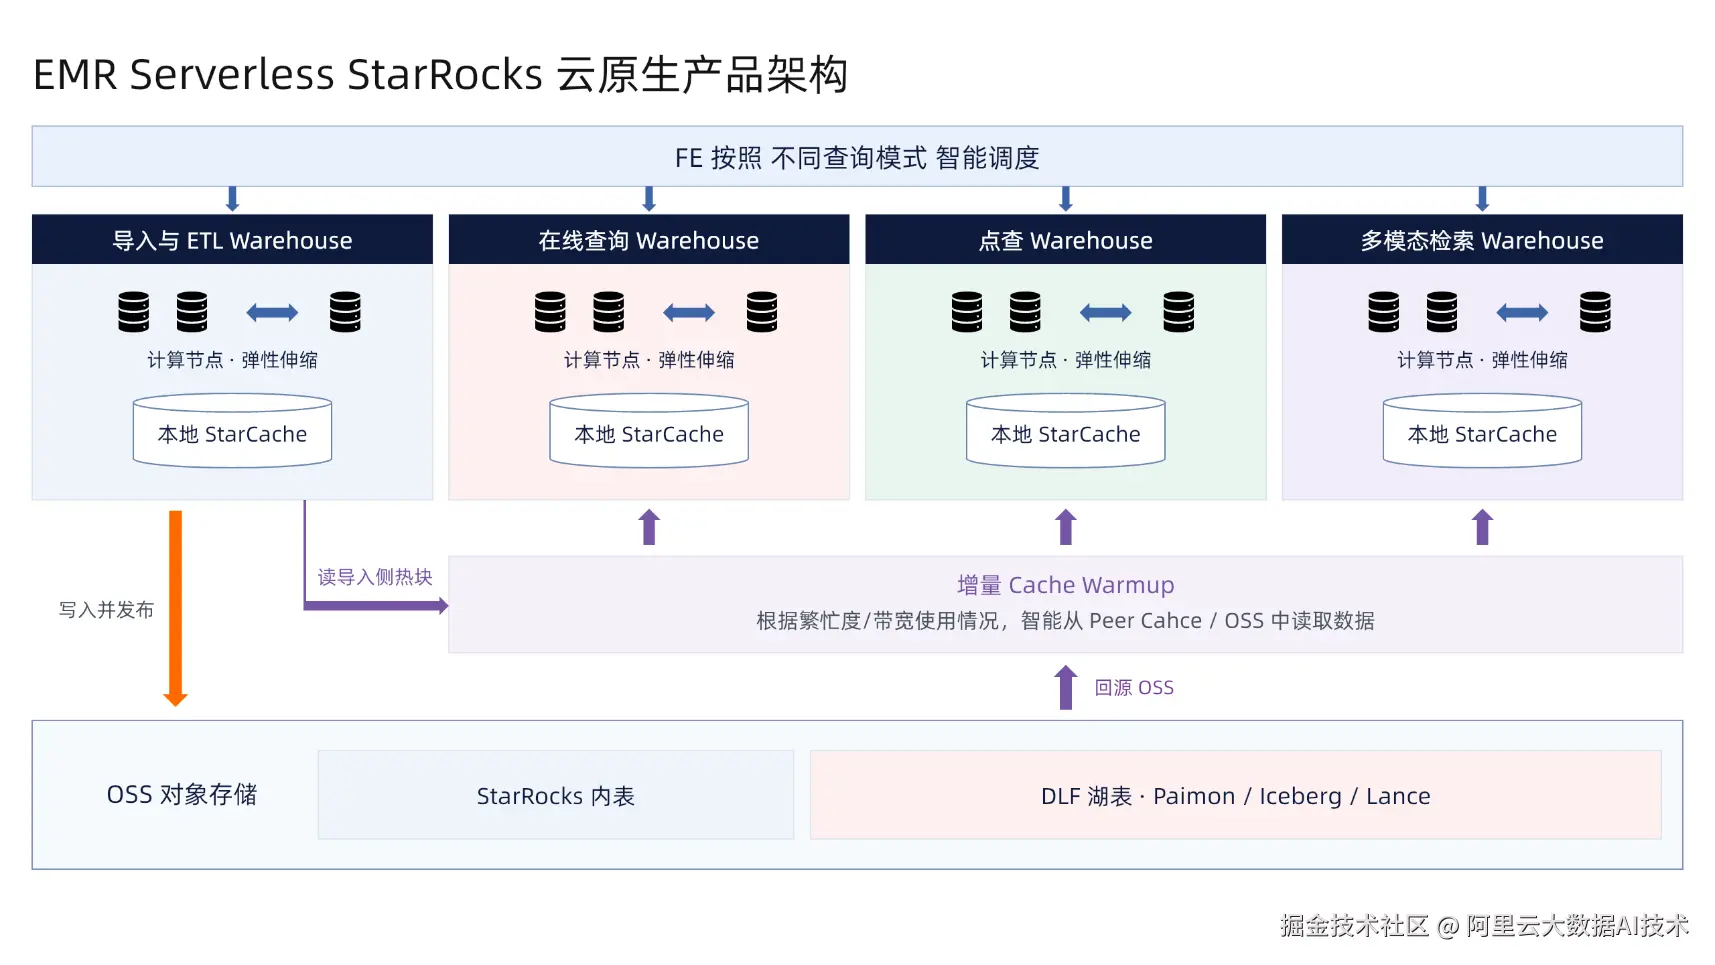
图 6 计算组隔离与缓存预热路径
商业版本引擎Stella3.0
Stella 是阿里云为 EMR Serverless StarRocks 自研的商业内核。Stella 3.0 面向湖仓上的多模态分析与检索,在同一个 SQL 引擎里支持 OLAP、KV 点查、全文和向量检索。比如,准备训练数据时,一条 SQL 可以先在湖表上找相似素材,再关联样本标签、统计各类场景的覆盖情况。
我们在 Stella 3.0 上分别测试了这四类查询。OLAP 看大规模分析的性价比,KV 点查和向量检索看吞吐,全文检索同时看吞吐和查询时延。
-
OLAP。 在 TPC-DS 10 TB 测试中,StarRocks 与 DLF Paimon 的组合相比我们选用的基线,性价比提升 100%。
-
KV 点查。 湖表 YCSB 测试中,1 KB 与 10 KB 两种数据规格的吞吐分别为 105,000 QPS 和 44,000 QPS。
-
向量检索。 在 99% 召回率下,DLF Paimon 和 Lance 湖表的查询吞吐分别为 19,308 QPS 和 18,772 QPS。
-
全文检索。 我们用 StarRocks 与 DLF Paimon 查询 1.5 亿行 Amazon Reviews 数据,测得吞吐为 353 QPS,查询时延为 130 ms。
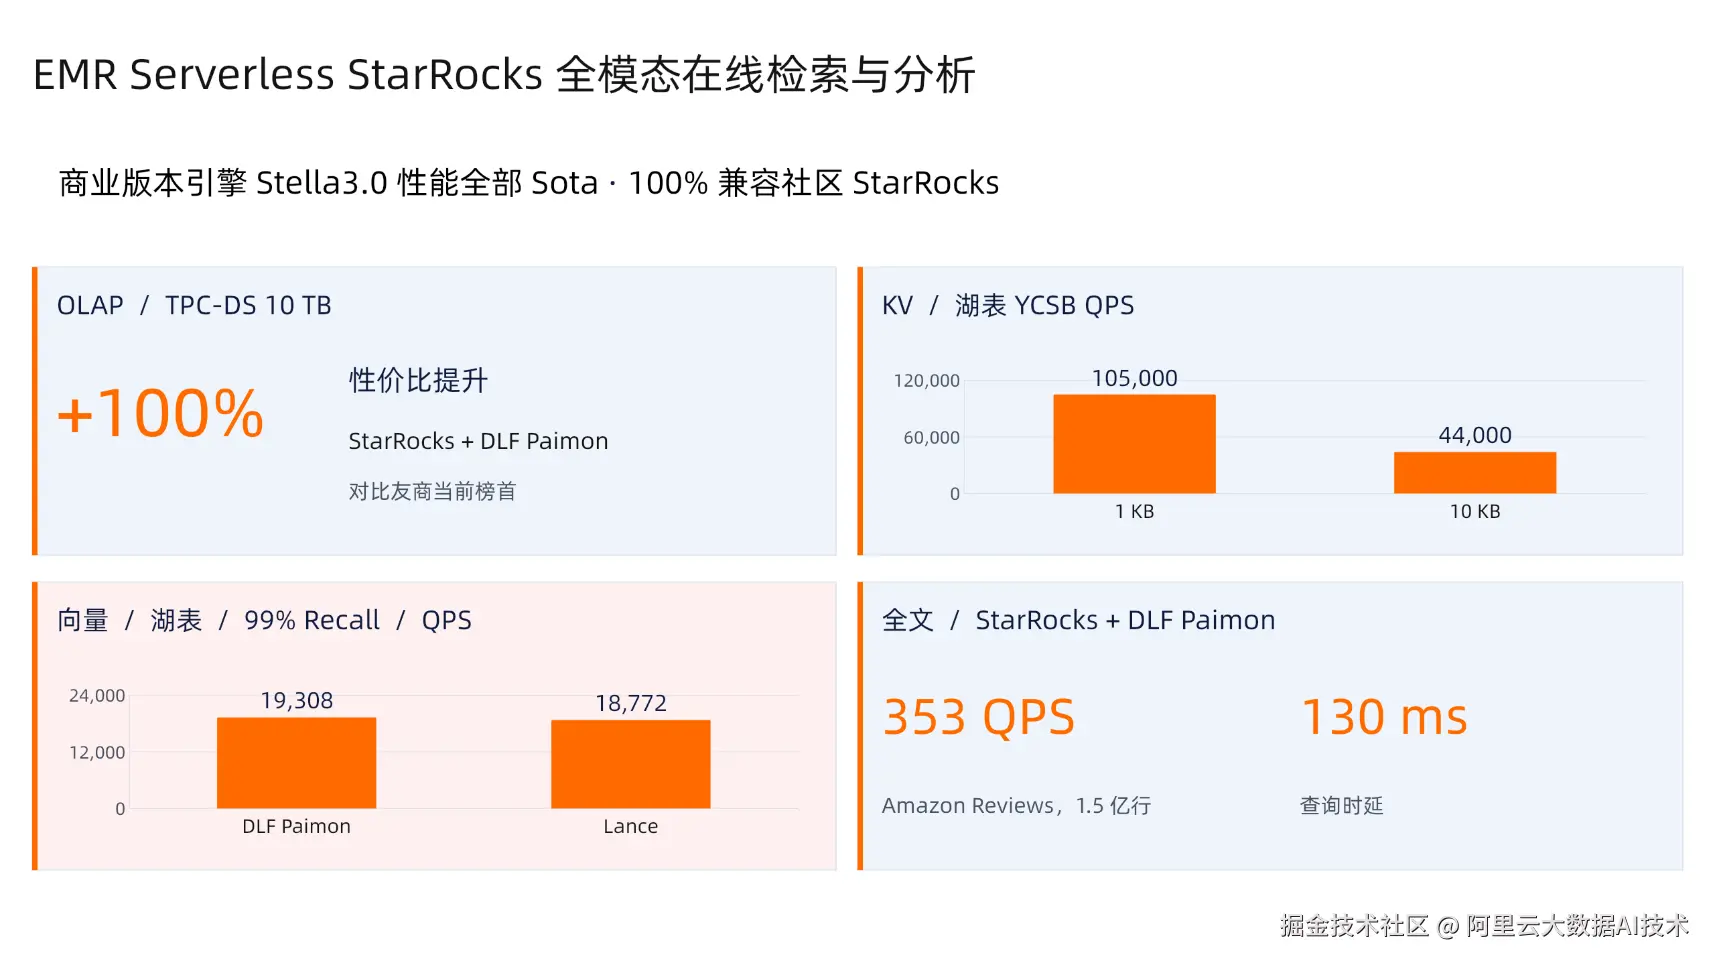
图 7 Stella 3.0 的四组性能测试结果
EMR Serverless StarRocks AI Function
除了多模态检索,Stella 还提供 AI Function,可以在 SQL 里直接调用百炼模型做内容识别、语音转写、标签提取和向量化。
拿广告视频来说,Object Table 记录原始文件的路径和元数据,SQL 通过 FILE 引用按需读取素材。模型生成的转写文本、标签和向量可以写回 StarRocks 内表或多模态湖表。这样,运营人员就能按台词搜视频,也能按画面找相似素材。
检索时还可以调用 Rerank,对召回的候选重新打分。文档解析、结构化字段抽取和内容审核也可以通过 AI Function 完成。
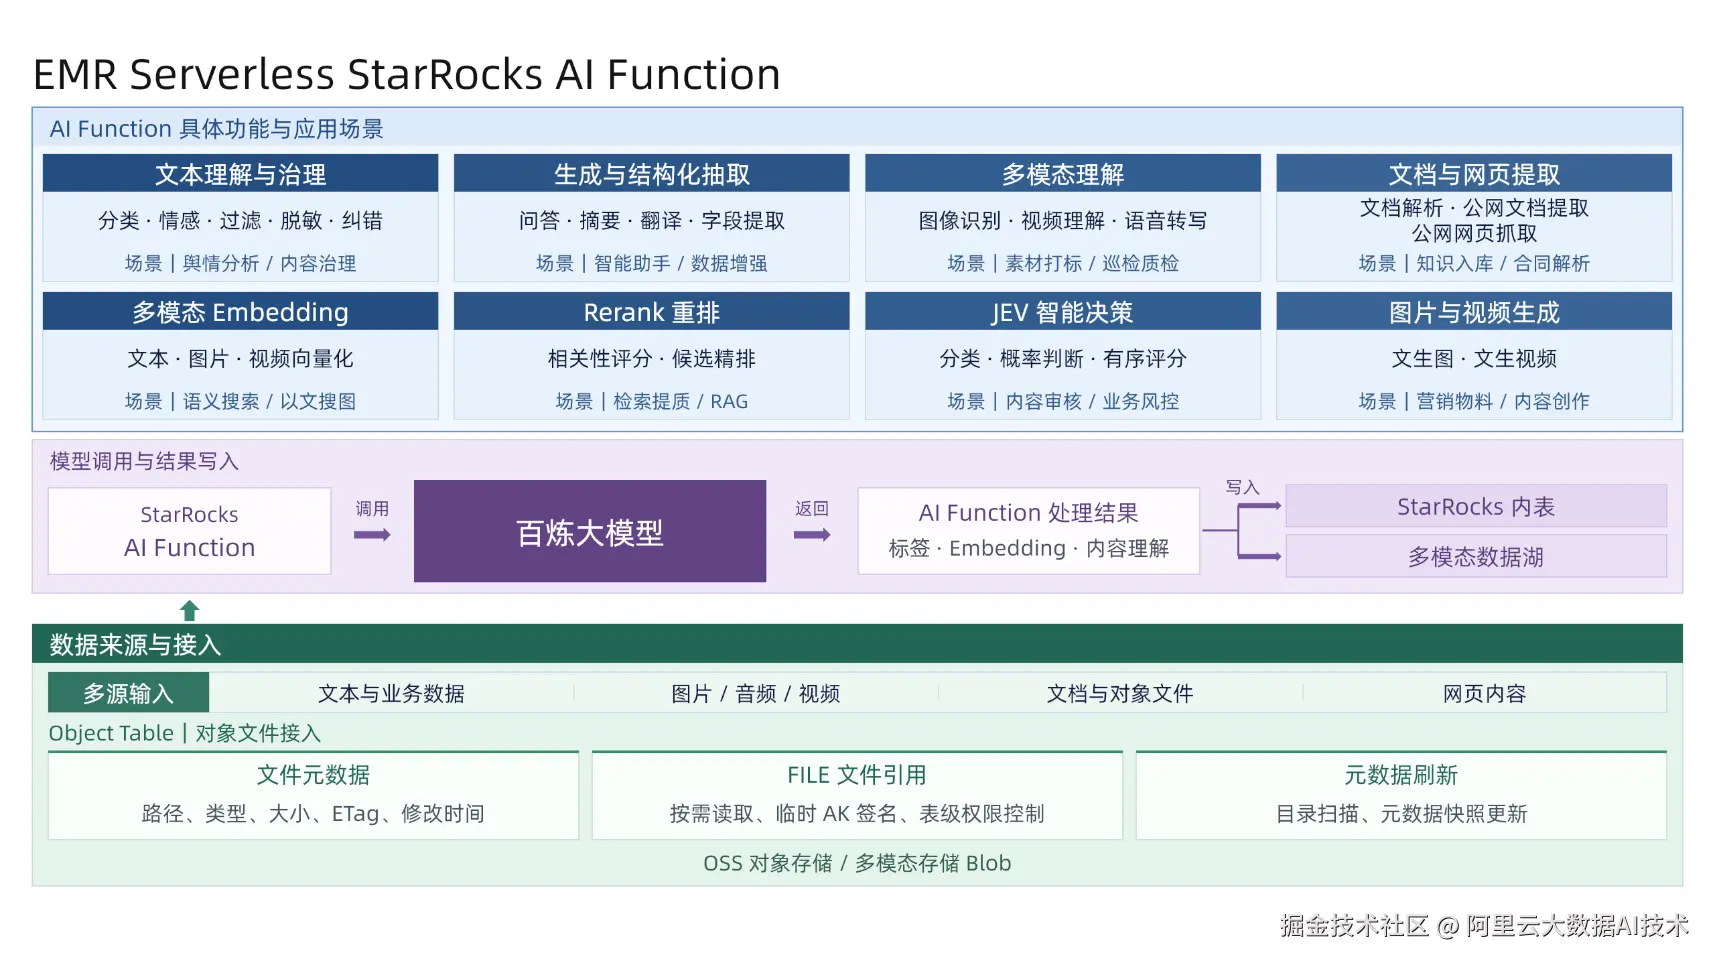
图 8 Object Table 接入、AI Function 调用与结果写入
EMR Serverless StarRocks Agent Skill 能力地图
用户可以让 Agent 先用 schema-explore 看库表结构,再用 data-profile 看字段分布。遇到慢 SQL,可以用 query-tune-skill 分析;遇到实例异常,可以调用诊断和巡检工具。产品材料把这些工具按知识、开发管理、数据分析、性能分析、诊断和运维来组织,Agent 根据当前任务选择。
Agent 执行的仍是具体的 SQL、API 或实例操作,能读哪些表、能否执行迁移或恢复,取决于 RAM 和系统授权。
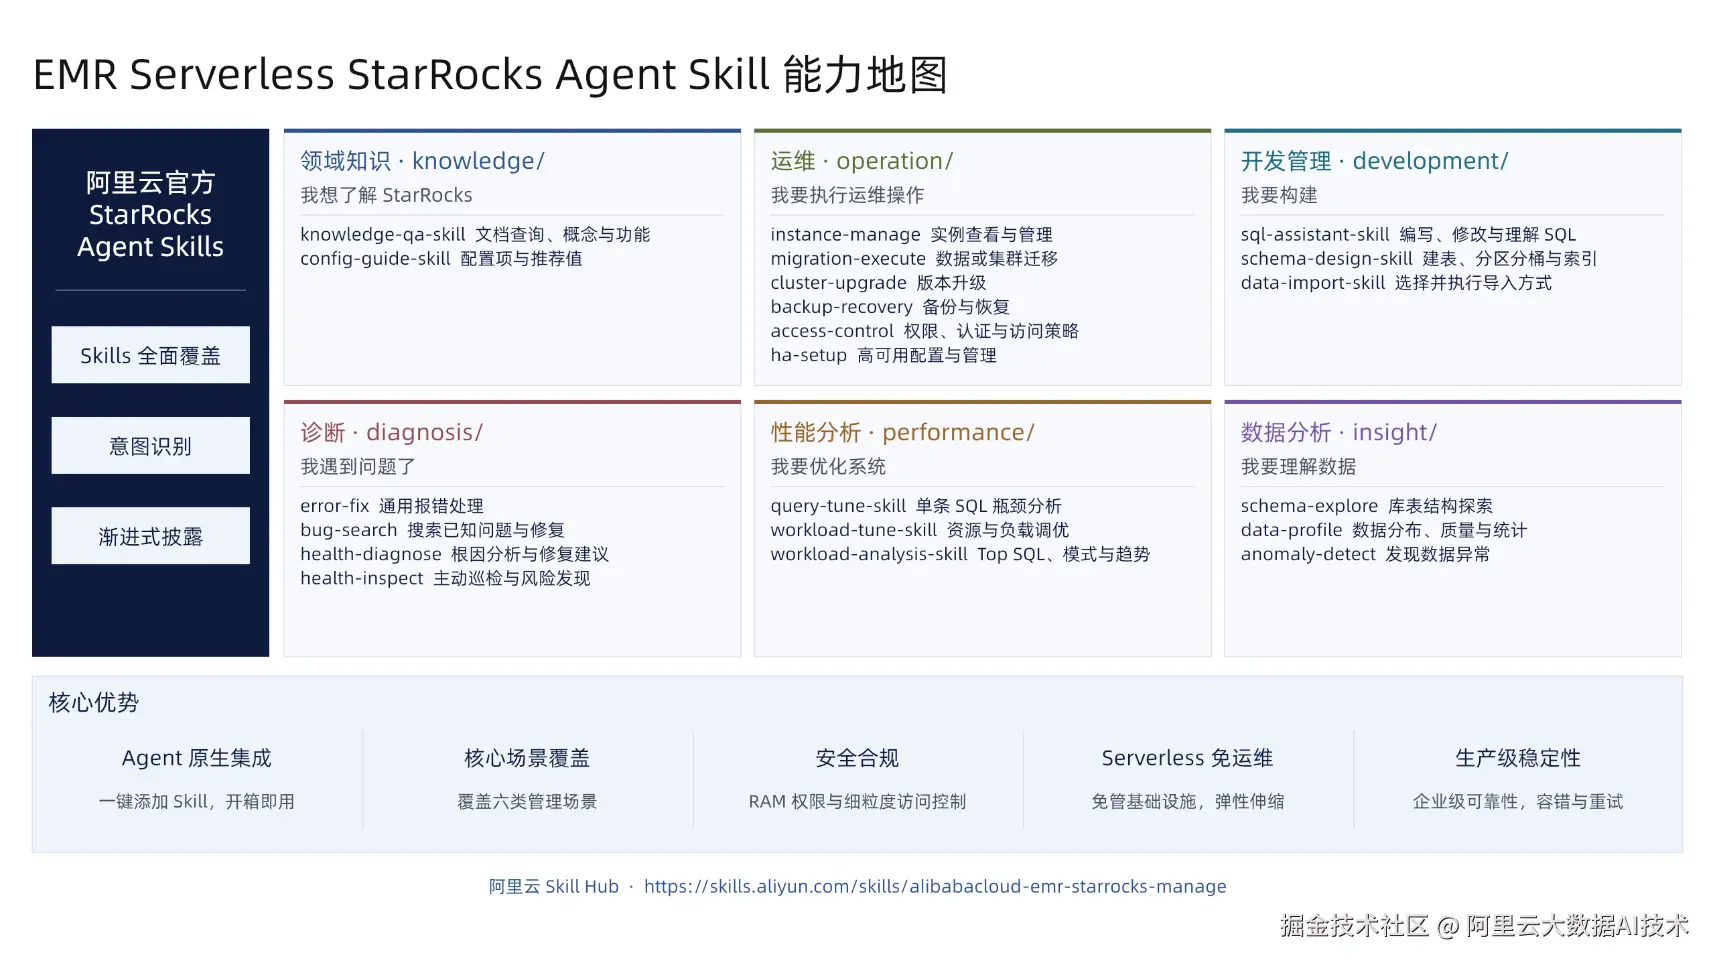
图 9 Agent Skills 的操作领域与权限管理
客户案例
某海外头部短剧App - 广告投流分析
同一部短剧往往会剪成多条广告,分到不同渠道投放。要决定给哪条素材加预算,光看点击数还不够。团队得把每条广告的花费、激活和付费数据连起来,才能比较获客成本和广告支出回报(ROAS)。看板上的某个数字有异常时,还要能顺着剧集和渠道找到具体的投放计划。
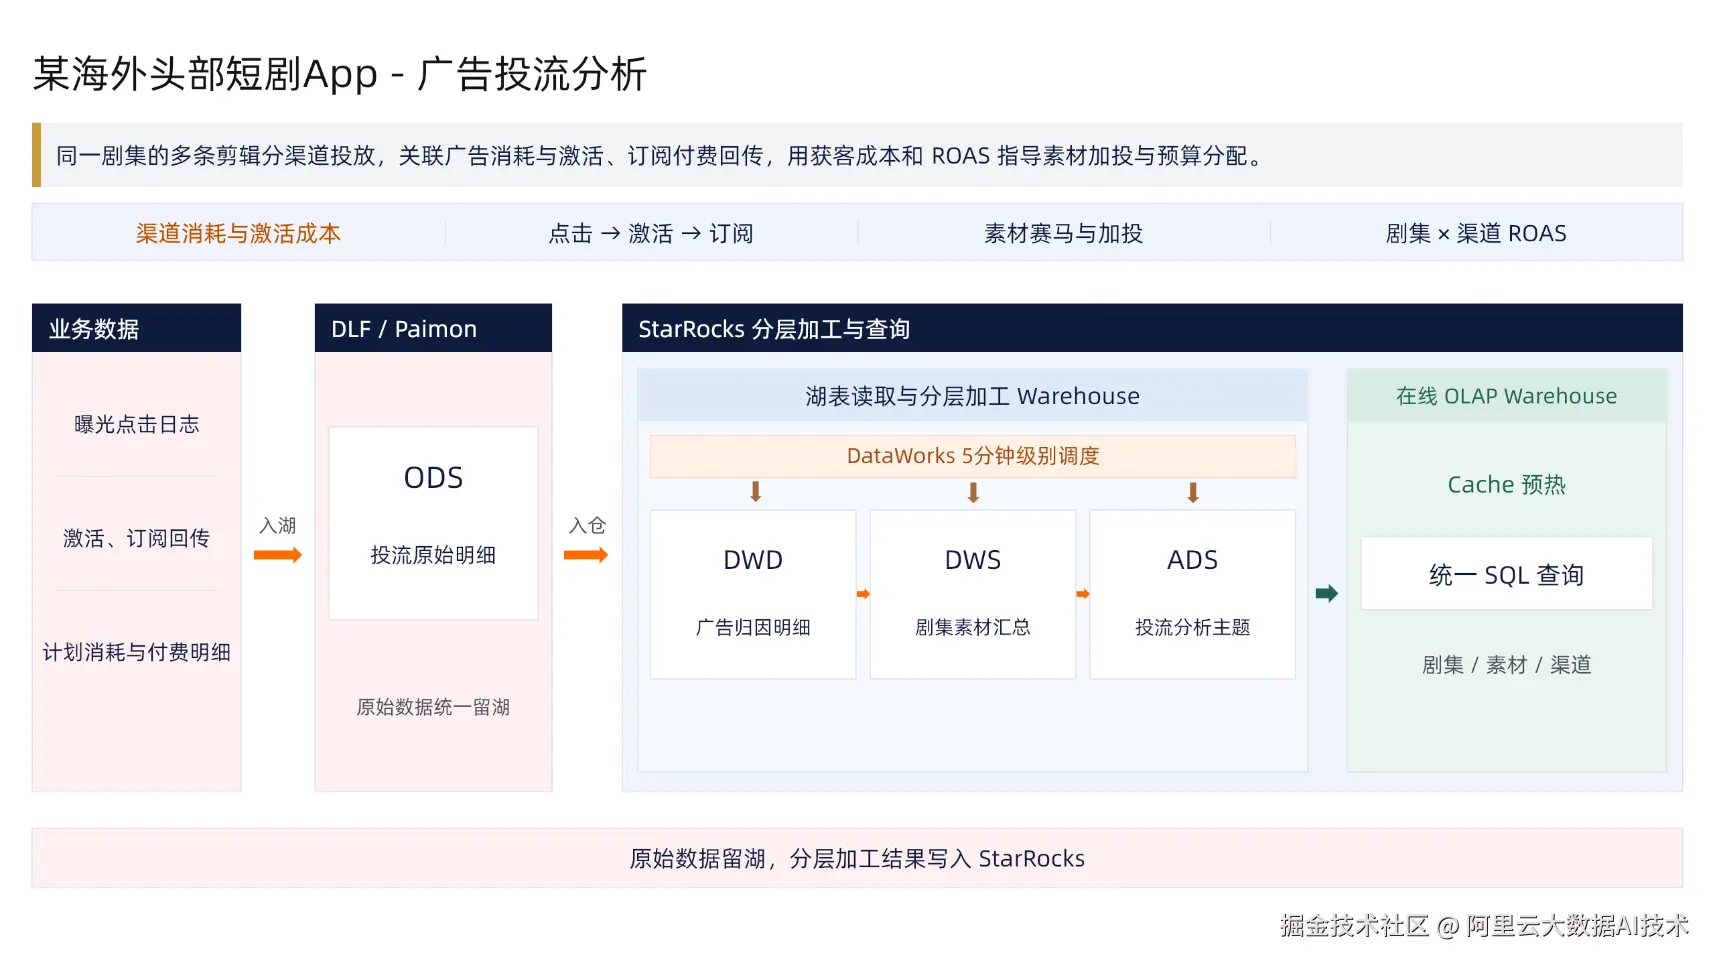
图 10 短剧投流分析的数据分层与计算组划分
这家海外短剧 App 把曝光、点击、转化回传和消耗明细留在 DLF 管理的 Paimon 湖表里。加工 Warehouse 从湖表读数据,把广告归因明细、素材汇总和看板指标写入 StarRocks。在线 OLAP Warehouse 独立处理报表和下钻查询,常用数据可以提前预热。DataWorks 以 5 分钟级的频率调度加工任务,数据什么时候能在看板上看到,还要看转化回传和加工各花了多久。
某头部 Web3 交易所链上数据分析与实时点查
一家 Web3 交易所持续接入区块交易和合约事件。分析人员想知道过去一段时间哪些协议活跃,要按时间、链和协议聚合交易明细。在线接口手里已有钱包地址,查的是这个地址的标签和风险评分。一个请求会读大量记录,另一个通常只取一条画像。
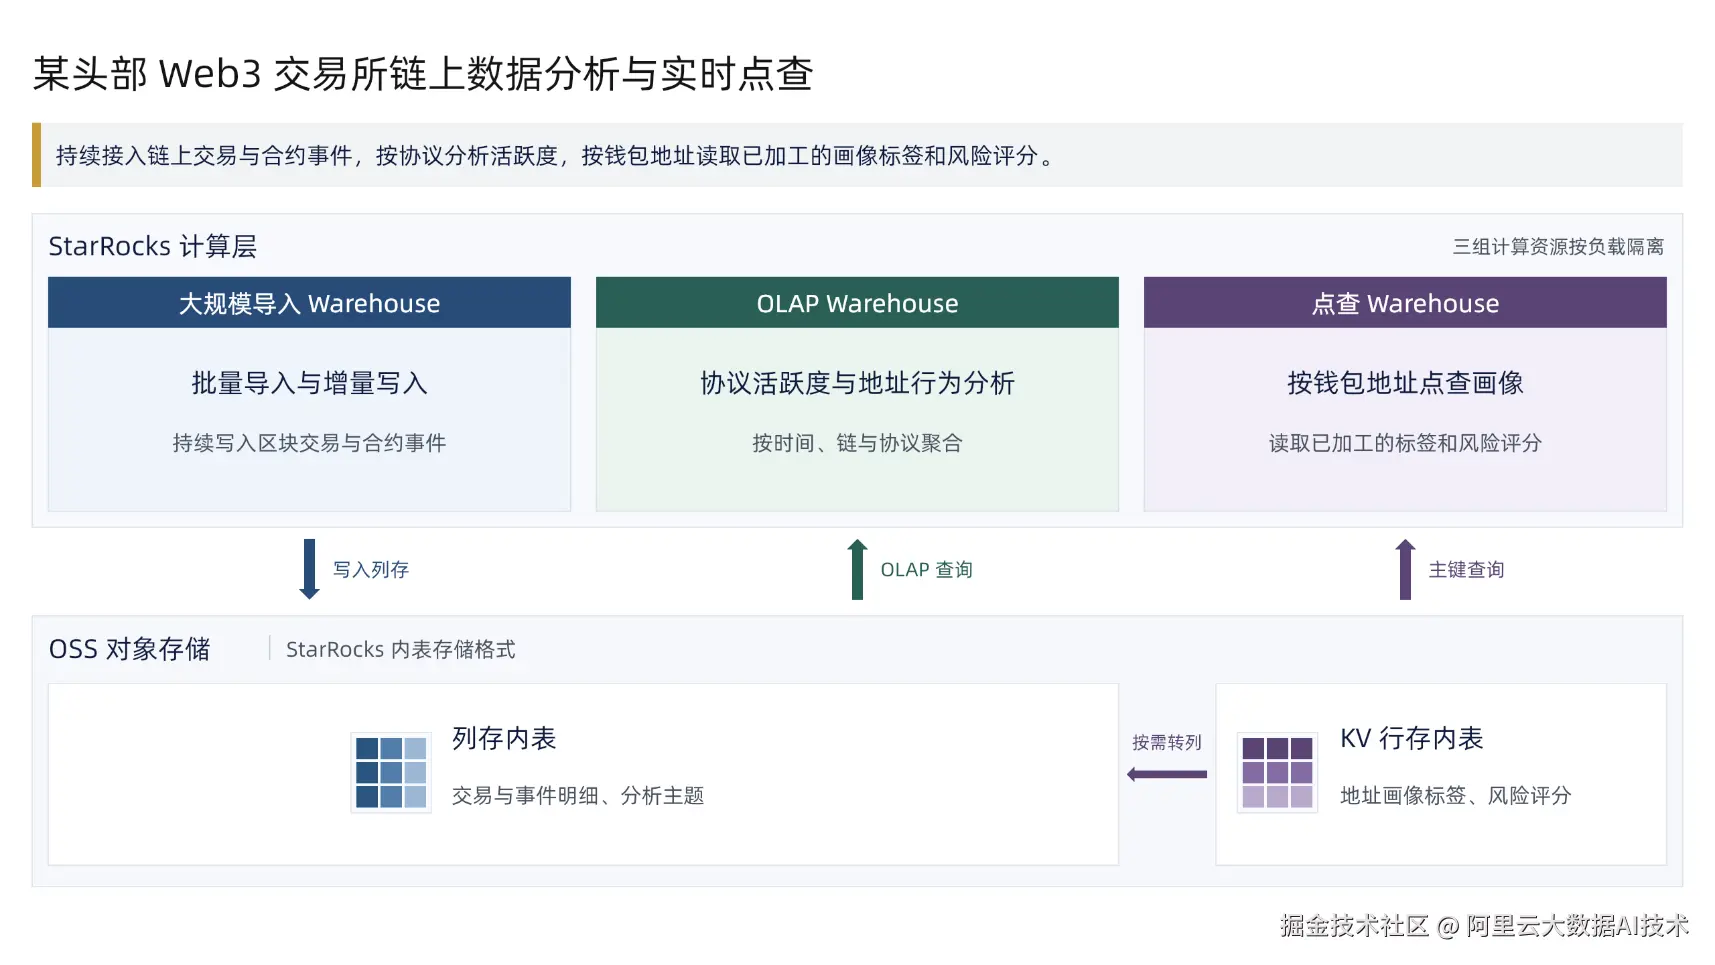
图 11 链上事件分析与钱包画像点查架构
交易所用 StarRocks 的列存内表保存交易和事件明细,聚合时可以只读用到的列。钱包画像提前算好,放进 KV 行存内表,在线接口按地址点查。导入、OLAP 和点查分别使用独立的 Warehouse,计算资源可以按负载分别配置,两类内表的数据都存放在同一对象存储底座上。
卓驭科技数据基础架构平台
工程师找雨夜难例时,可以拿过去的一帧故障画面做参考。检索结果还得带上原始视频和命中时间,工程师才看得到这一帧前后发生了什么。复盘也可能需要对照同一时刻的点云、车速、驾驶模式和软件版本。
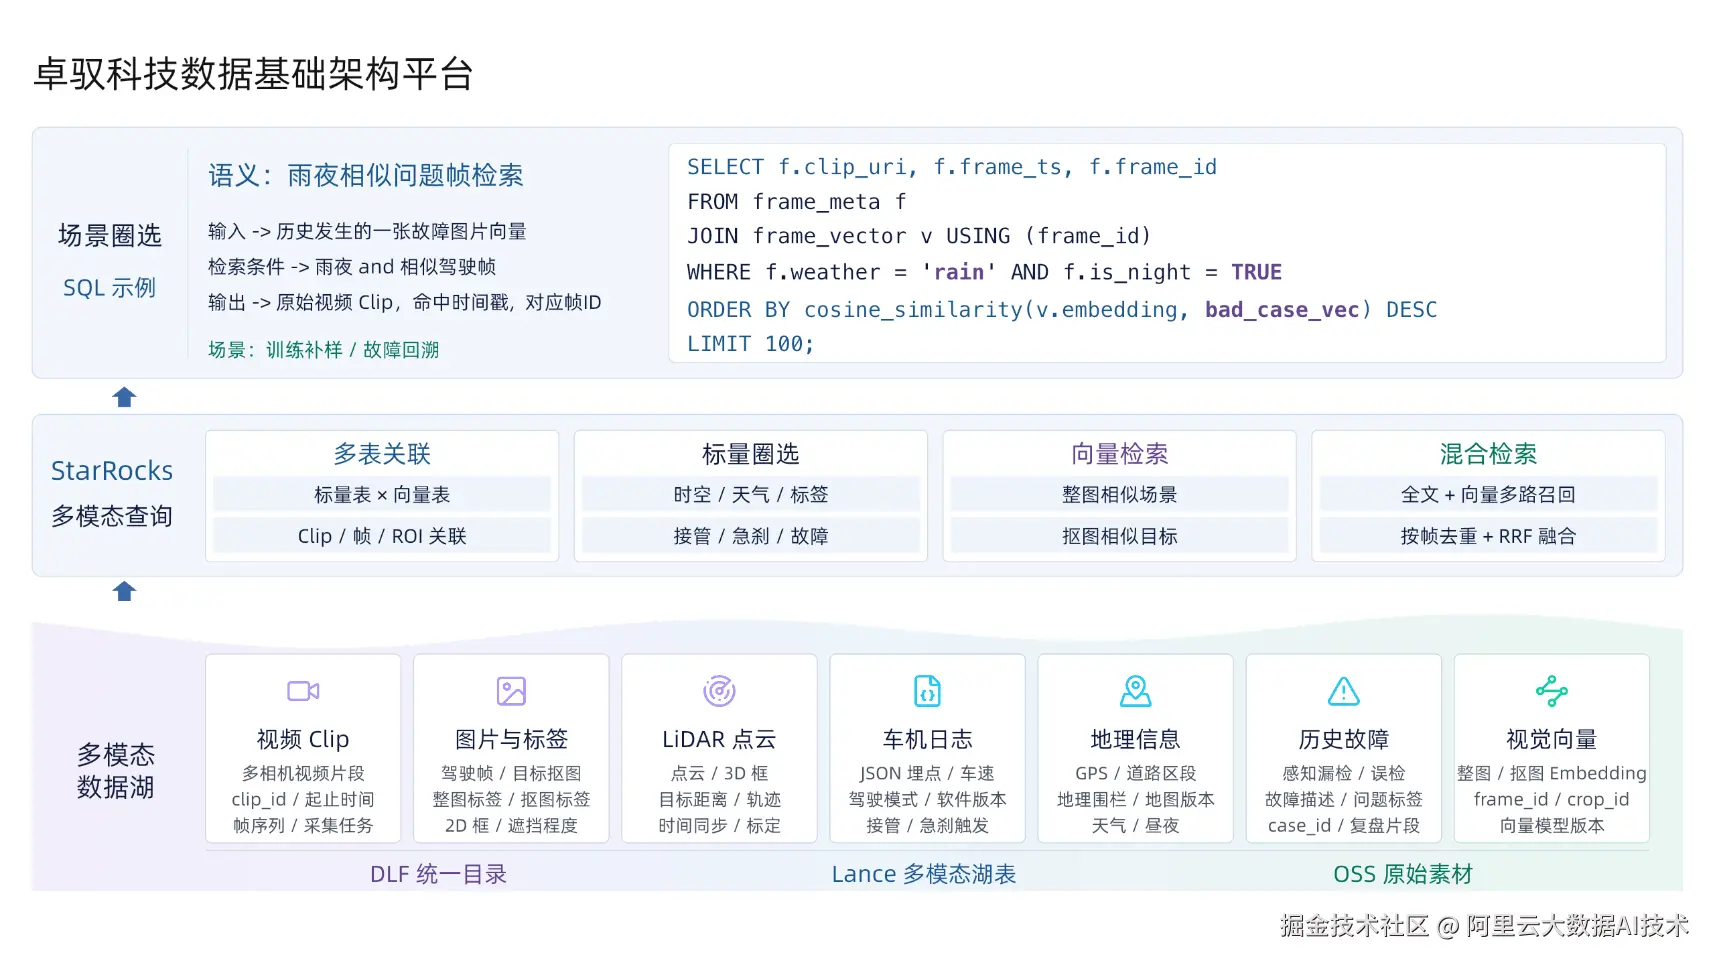
图 12 智驾难例的条件筛选、相似检索与视频回放
卓驭科技把原始素材放在 OSS,用 DLF 管理目录,通过 Lance 湖表组织相关属性和视觉向量。帧 ID 把场景属性和向量连起来,也能帮助工程师从命中的画面找回视频片段。下面用简化的 SQL 表达这个查询。先限定雨天、夜间,再按参考图片的相似度找 100 条结果,返回回放需要的视频地址和时间戳。函数和参数绑定方式取决于部署版本。
sql
SELECT f.clip_uri, f.frame_ts, f.frame_id
FROM frame_meta f
JOIN frame_vector v USING (frame_id)
WHERE f.weather = 'rain' AND f.is_night = TRUE
ORDER BY cosine_similarity(v.embedding, :bad_case_vec) DESC
LIMIT 100;
如果手里还有故障描述,可以用关键词搜一遍、用向量再搜一遍,把两路结果按帧 ID 汇总,用倒数排名融合(RRF)综合排序。这样工程师能先查看凭画面或故障描述找出的候选片段。
EMR Serverless StarRocks 支撑短剧广告投流与素材复用
一条短剧广告跑得好,运营团队可能想从旧素材里找可以复用的剪辑。为了让运营同时查视频内容和投放表现,DSP 平台用 DLF 和 Lance 组织素材宽表,把封面、字幕、OCR 文本和视频向量,跟剧集、投放计划、渠道和转化数据关联起来。
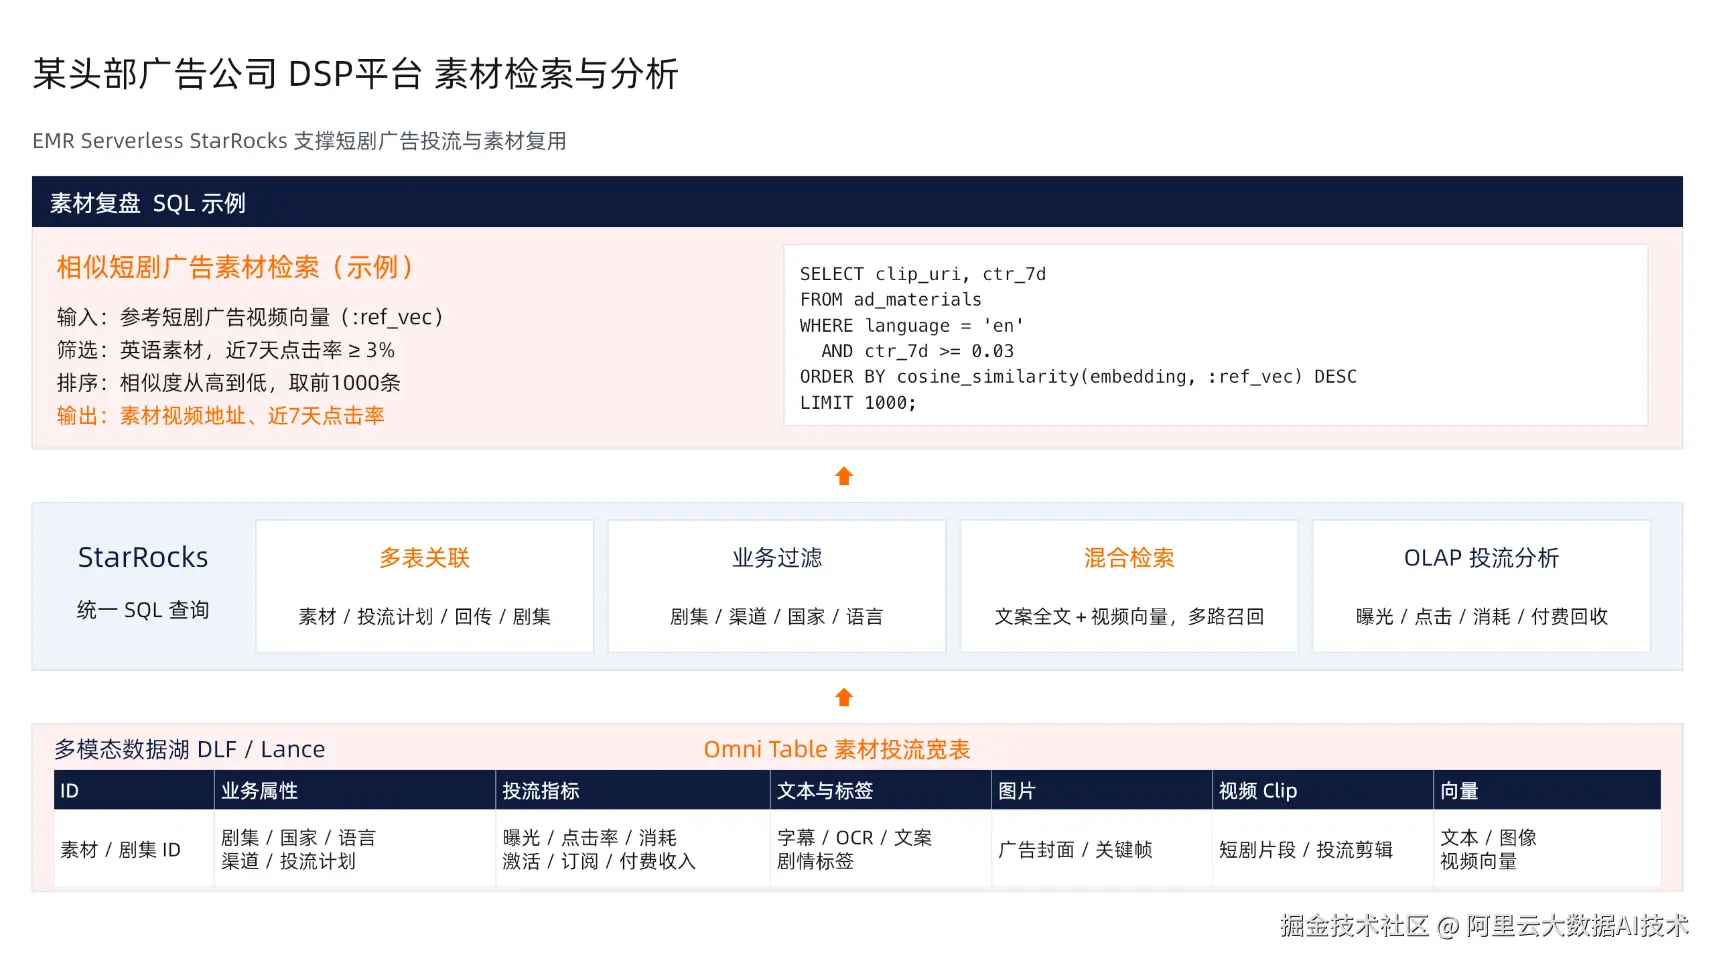
图 13 DSP 平台的短剧广告素材复盘示例
例如,运营拿一条广告做参考,想找近 7 天点击率达到 3% 的相似英语素材。语言和点击率决定哪些素材有资格入选,查询按视频相似度取最多 1000 条,附上视频地址和近 7 天点击率。运营可以回看素材,也可以追溯它在哪些投放计划里表现得好。3% 和 1000 都是示例参数,可以随任务调整。
阿里巴巴集团 AI Data 平台
采集来的素材要经历两次筛选。第一次发生在入湖前。阿里巴巴集团的 AI Data 平台抽取一批图片、视频、音频或文本,与湖内已有数据做混合检索对比,根据相关性、重复率和覆盖度评估这批素材。通过审核的素材进入多模态宽表,同一条记录关联来源、标签、质量信息、原始内容和 Embedding。
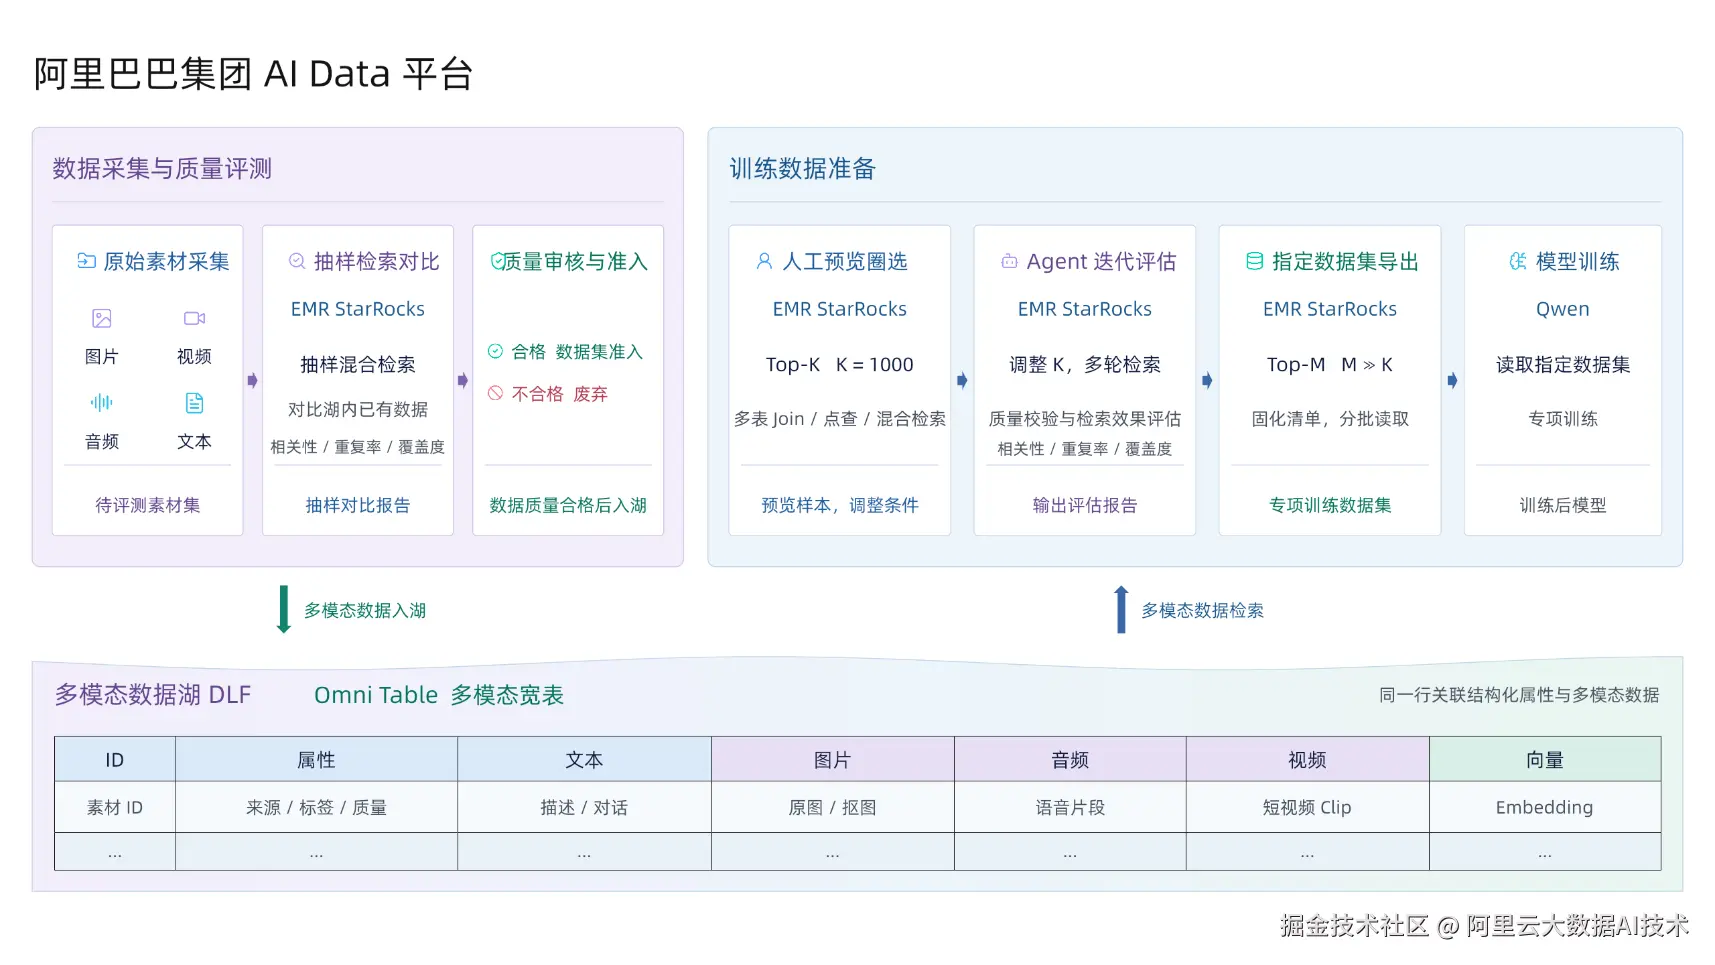
图 14 AI Data 平台的素材准入、候选评估与训练集导出
第二次筛选发生在准备专项训练集时。团队先用关联查询、点查或混合检索圈一批样本,人工预览后调整筛选条件。图中的例子先取 Top-K,K 为 1000。Agent 可以调整 K 值,多轮检索,评估这一批样本和训练目标是否相关、是否有重复、需要的场景是否覆盖。条件确定后,平台按更大的 Top-M 生成数据清单,分批读取样本,交给 Qwen 做专项训练。
结语
多模态 Lakehouse 是 StarRocks 社区持续投入的方向。欢迎更多开发者和用户带着真实场景和查询负载参与进来,分享测试结果、反馈遇到的问题,或贡献代码,共同完善多模态分析与检索能力。