一、简介:
神经网络的训练主要使用反向传播算法,模型预测值(logits)与正确标签(label)送入损失函数(loss function)获得loss,然后进行反向传播计算,求得梯度(gradients),最终更新至模型参数(parameters)。自动微分能够计算可导函数在某点处的导数值,是反向传播算法的一般化。自动微分主要解决的问题是将一个复杂的数学运算分解为一系列简单的基本运算,该功能对用户屏蔽了大量的求导细节和过程,大大降低了框架的使用门槛。
MindSpore使用函数式自动微分的设计理念,提供更接近于数学语义的自动微分接口grad和value_and_grad,简便模型反向传播的使用。
二、环境准备:
老规矩,没有下载MindSpore框架的友友们,回看昇思25天学习打卡营第1天|快速入门-CSDN博客
python
import numpy as np
import time
import mindspore
from mindspore import nn
from mindspore import ops
from mindspore import Tensor, Parameter
三、函数和计算图:
计算图是用图形语言表示数学函数的一种方式,也是深度学习框架表达神经网络模型的统一方法。我们将根据下面的计算图构造计算函数和神经网络。
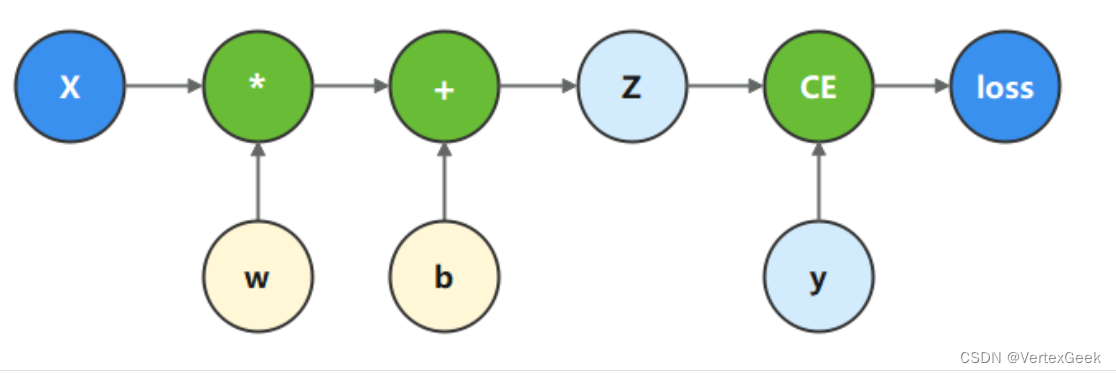
在这个模型中,𝑥𝑥为输入,𝑦𝑦为正确值,𝑤𝑤和𝑏𝑏是我们需要优化的参数,也就是我们常说的权重和偏置。我们根据计算图描述的计算过程,构造计算函数。 其中binary_cross_entropy_with_logits 是一个损失函数,计算预测值和目标值之间的二值交叉熵损失。
python
x = ops.ones(5, mindspore.float32)  # 创造输入X
y = ops.zeros(3, mindspore.float32)  # 创造Y
w = Parameter(Tensor(np.random.randn(5, 3), mindspore.float32), name='w') # 权重
b = Parameter(Tensor(np.random.randn(3,), mindspore.float32), name='b') # 偏置

def function(x, y, w, b):
    z = ops.matmul(x, w) + b #简单的线性变换,也就是Y = WX + b
    # 计算交叉熵损失
    loss = ops.binary_cross_entropy_with_logits(z, y, ops.ones_like(z), ops.ones_like(z))
    return loss

loss = function(x, y, w, b)
print(loss)
print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time.time())), "VertexGeek")
四、微分函数和梯度计算:
为了优化模型参数,需要求参数对loss的导数:∂loss∂𝑤∂loss∂𝑤和∂loss∂𝑏∂loss∂𝑏,此时我们调用mindspore.grad函数,来获得function的微分函数。
这里使用了grad函数的两个入参,分别为:
fn:待求导的函数。grad_position:指定求导输入位置的索引(这里的索引是指待求导函数中输入的形参,在我们这个例子中是w和b,对应的index分别是2和3)。
python
grad_fn = mindspore.grad(function, (2, 3))

grads = grad_fn(x, y, w, b)
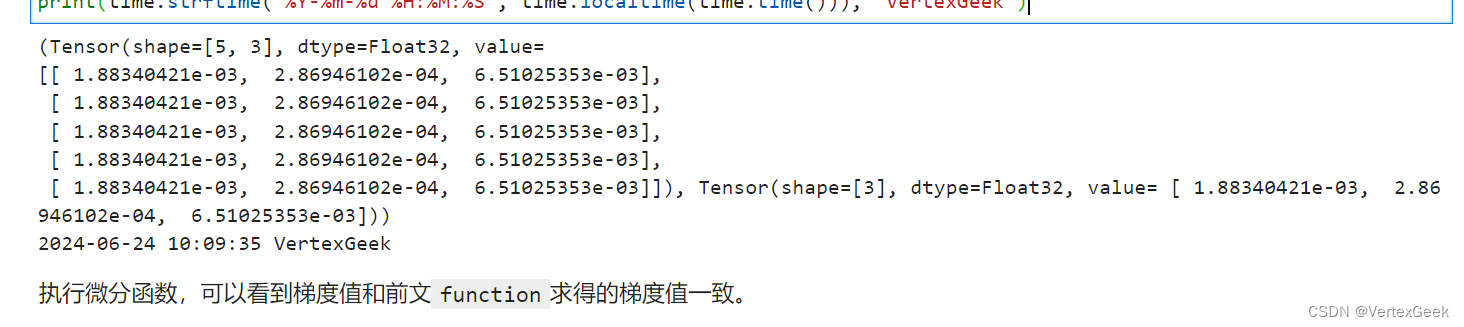
print(grads)
print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time.time())), "VertexGeek")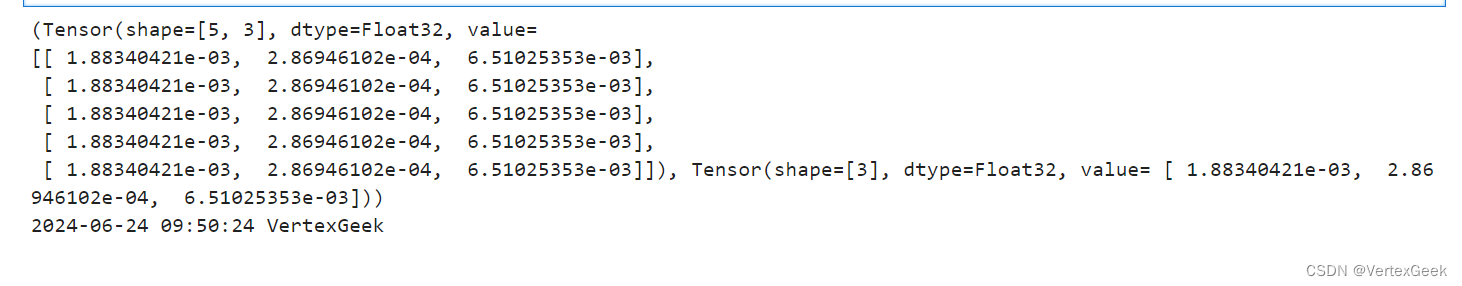
五、Stop Gradient:
通常情况下,求导时会求loss对参数的导数,因此函数的输出只有loss一项。当我们希望函数输出多项时,微分函数会求所有输出项对参数的导数。此时如果想实现对某个输出项的梯度截断,或消除某个Tensor对梯度的影响,需要用到Stop Gradient操作。MindSpore提供了ops.stop_gradient方法实现对梯度的截断:
python
def function_with_logits(x, y, w, b):
    z = ops.matmul(x, w) + b
    loss = ops.binary_cross_entropy_with_logits(z, y, ops.ones_like(z), ops.ones_like(z))
    # 这里返回损失和预测两个值
    return loss, z

grad_fn = mindspore.grad(function_with_logits, (2, 3))
grads = grad_fn(x, y, w, b)
print(grads)


# 使用stop_gradient方法后:
def function_stop_gradient(x, y, w, b):
    z = ops.matmul(x, w) + b
    loss = ops.binary_cross_entropy_with_logits(z, y, ops.ones_like(z), ops.ones_like(z))
    return loss, ops.stop_gradient(z)

grad_fn = mindspore.grad(function_stop_gradient, (2, 3))
grads = grad_fn(x, y, w, b)
print(grads)
print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time.time())), "VertexGeek")
未截断的输出:
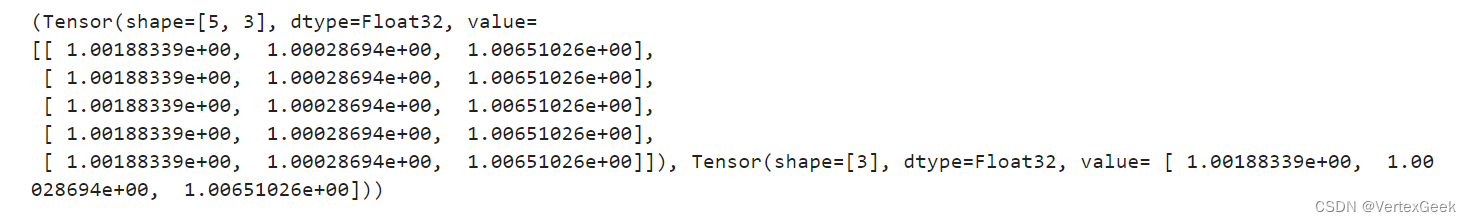 截断后的输出:

六、Auxiliary data:
Auxiliary data意为辅助数据,是函数除第一个输出项外的其他输出。通常我们会将函数的loss设置为函数的第一个输出,其他的输出即为辅助数据。在MindSpore中,grad和value_and_grad提供has_aux参数,当其设置为True时,可以自动实现前文手动添加stop_gradient的功能,满足返回辅助数据的同时不影响梯度计算的效果。
python
grad_fn = mindspore.grad(function_with_logits, (2, 3), has_aux=True)

grads, (z,) = grad_fn(x, y, w, b)
print(grads, z)
print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time.time())), "VertexGeek")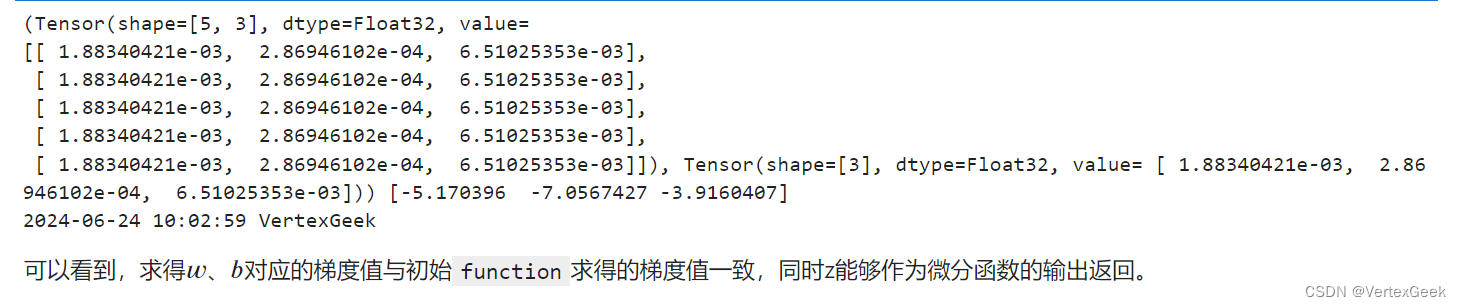
七、神经网络梯度计算:
下面我们要把前面介绍的自动微分方法运用到神经网络中,以实现反向传播,对神经网络还不熟悉的友友,可以阅读昇思25天学习打卡营第5天|网络构建-CSDN博客。
python
# 定义一个简单的神经网络
class Network(nn.Cell):
    def __init__(self):
        super().__init__()
        self.w = w
        self.b = b

    def construct(self, x):
        z = ops.matmul(x, self.w) + self.b
        return z

# 实例化模型和损失参数:
model = Network()
loss_fn = nn.BCEWithLogitsLoss()

# 前向计算:
def forward_fn(x, y):
    z = model(x)
    loss = loss_fn(z, y)
    return loss

# 计算梯度
grad_fn = mindspore.value_and_grad(forward_fn, None, weights=model.trainable_params())

loss, grads = grad_fn(x, y)
print(grads)
print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(time.time())), "VertexGeek")