目录
1.什么是互联网爬虫?
如果我们把互联网比作一张大的蜘蛛网,那一台计算机上的数据便是蜘蛛网上的一个猎物,而爬虫程序就是一只小蜘蛛,沿着蜘蛛网抓取自己想要的数据.
解释1:通过一个程序,根据Url(http://www.taobao.com)进行爬取网页,获取有用信息
解释2:使用程序模拟浏览器,去向服务区请求,获取响应信息
2.爬虫核心?
1.爬取网页:爬取整个网页 包含了网页中所有得内容
2.解析数据:将网页中你得到的数据进行解析
3.难点:爬虫和反爬虫之间的博弈
3.爬虫的用途?
- 数据分析/人工数据集
- 社交软件冷启动
- 舆情监控
- 竞争对手监控
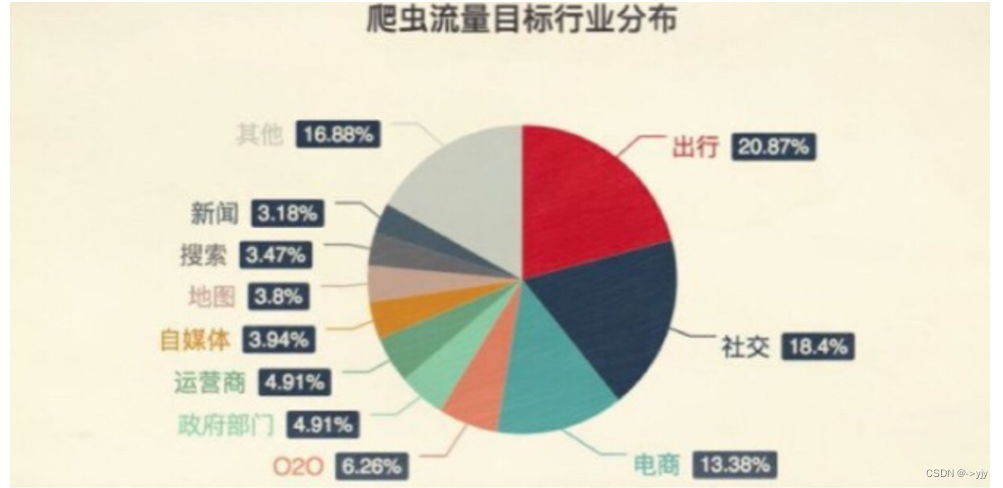
出行:票都只有在12306平台售卖 但是你会发现飞猪等平台也有这是为什么?因为这些其他平台利用爬虫高频次地访问12306网站.
社交:陌陌这款软件很久以前如果你有在上面进行一定的社交你会发现大部分人都不会理你,因为他们都从微博上爬下来的假人.
4.爬虫分类?
通用爬虫:
实例
百度、360、google、sougou等搜索引擎‐‐‐伯乐在线
功能
访问网页‐>抓取数据‐>数据存储‐>数据处理‐>提供检索服务
robots协议
一个约定俗成的协议,添加robots.txt文件,来说明本网站哪些内容不可以被抓取,起不到限制作用
自己写的爬虫无需遵守
网站排名(SEO)
- 根据pagerank算法值进行排名(参考个网站流量、点击率等指标)
2. 百度竞价排名缺点
- 抓取的数据大多是无用的
2.不能根据用户的需求来精准获取数据
聚焦爬虫功能
根据需求,实现爬虫程序,抓取需要的数据
设计思路
1.确定要爬取的url
如何获取Url
2.模拟浏览器通过http协议访问url,获取服务器返回的html代码
如何访问
3.解析html字符串(根据一定规则提取需要的数据)
如何解析
5.反爬手段?
1.User‐Agent:
User Agent中文名为用户代理,简称 UA,它是一个特殊字符串头,使得服务器能够识别客户使用的操作系统及版
本、CPU 类型、浏览器及版本、浏览器渲染引擎、浏览器语言、浏览器插件等。
2.代理IP
西次代理
快代理
什么是高匿名、匿名和透明代理?它们有什么区别?
1.使用透明代理,对方服务器可以知道你使用了代理,并且也知道你的真实IP。
2.使用匿名代理,对方服务器可以知道你使用了代理,但不知道你的真实IP。
3.使用高匿名代理,对方服务器不知道你使用了代理,更不知道你的真实IP。
3.验证码访问
打码平台
云打码平台
超级🦅
4.动态加载网页 网站返回的是js数据 并不是网页的真实数据
selenium驱动真实的浏览器发送请求
5.数据加密
分析js代码