爬虫:爬取知乎热榜一级评论及回答2024不包含翻页

一、先上结果(注:本文仅为兴趣爱好探究,请勿进行商业利用或非法研究,负责后果自负,与作者无关)

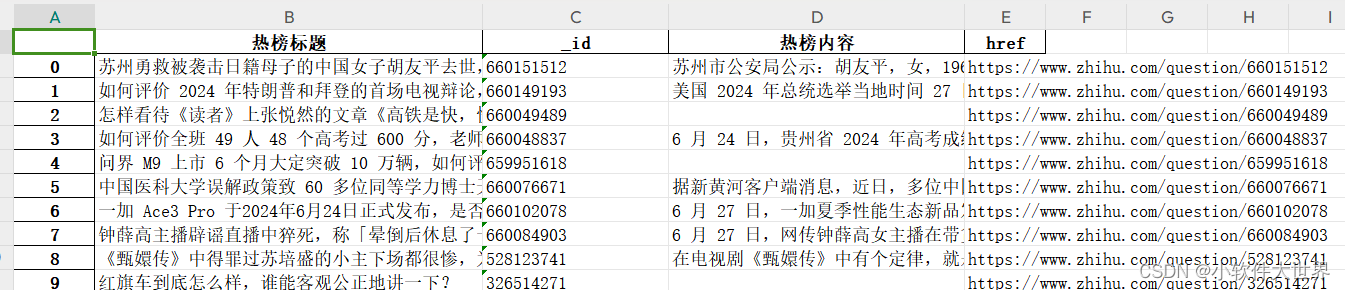
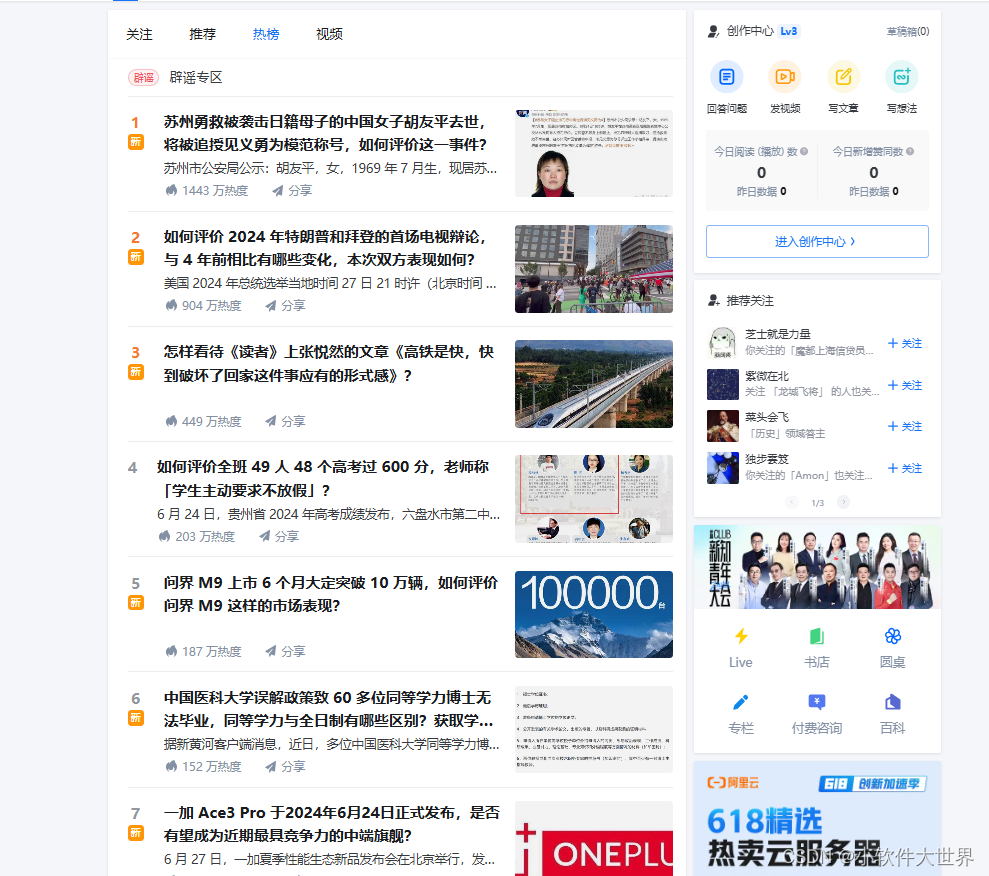
1、爬标题及其具体内容
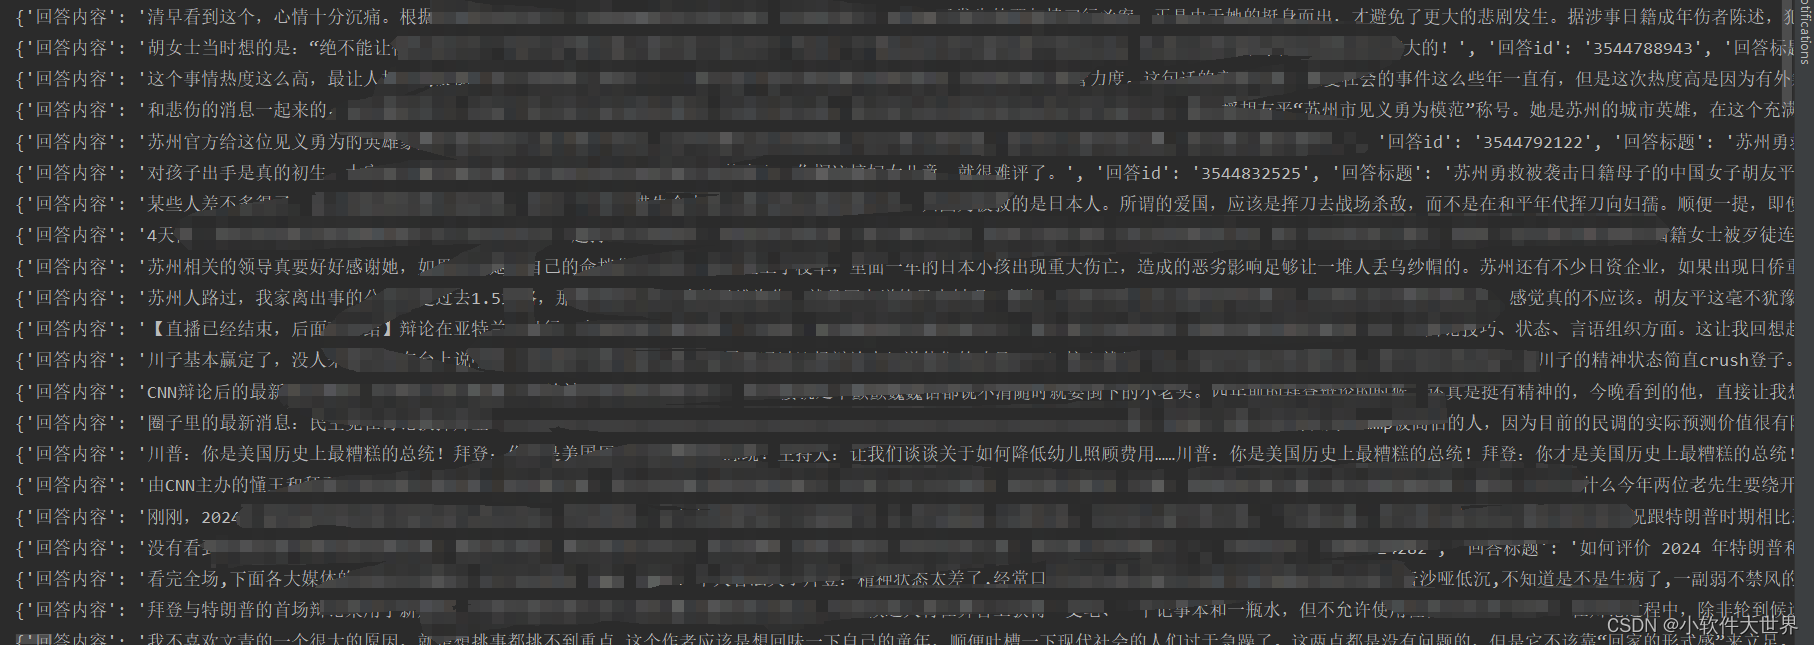
2、抓标题下的对应回答
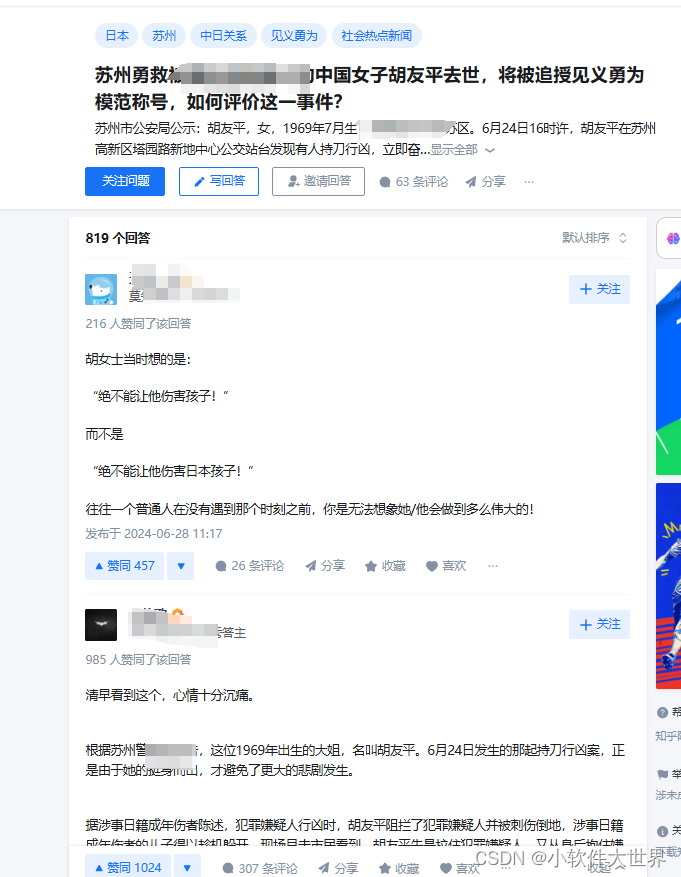
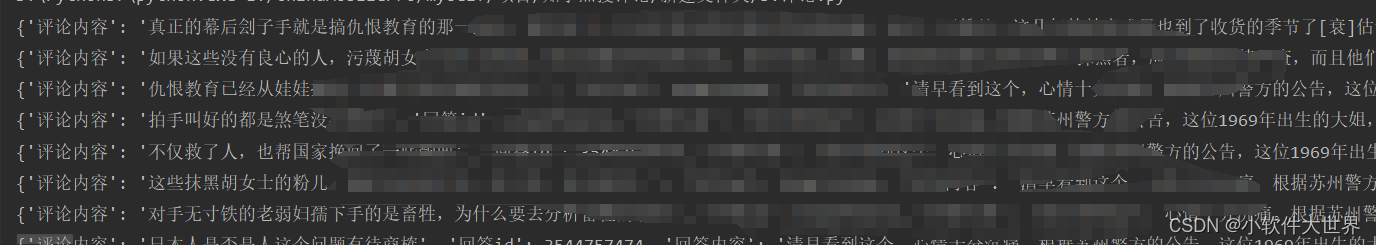
3、爬取对应一级评论

二、上流程

1、获取cookies(相信哥哥姐姐们都会得啦,F12抓一下便知)

2、获取标题的定位(大差不差用了基本的etree,根据路径找到对应的标签位置,因为有些具体的细节涉及商业,打了马赛哈)
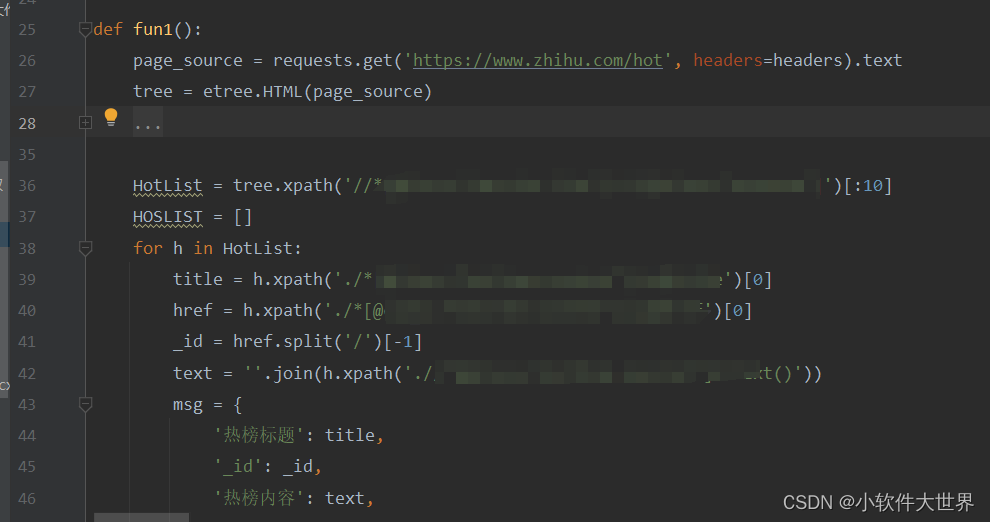
3、获取回答内容

4、获取评论内容
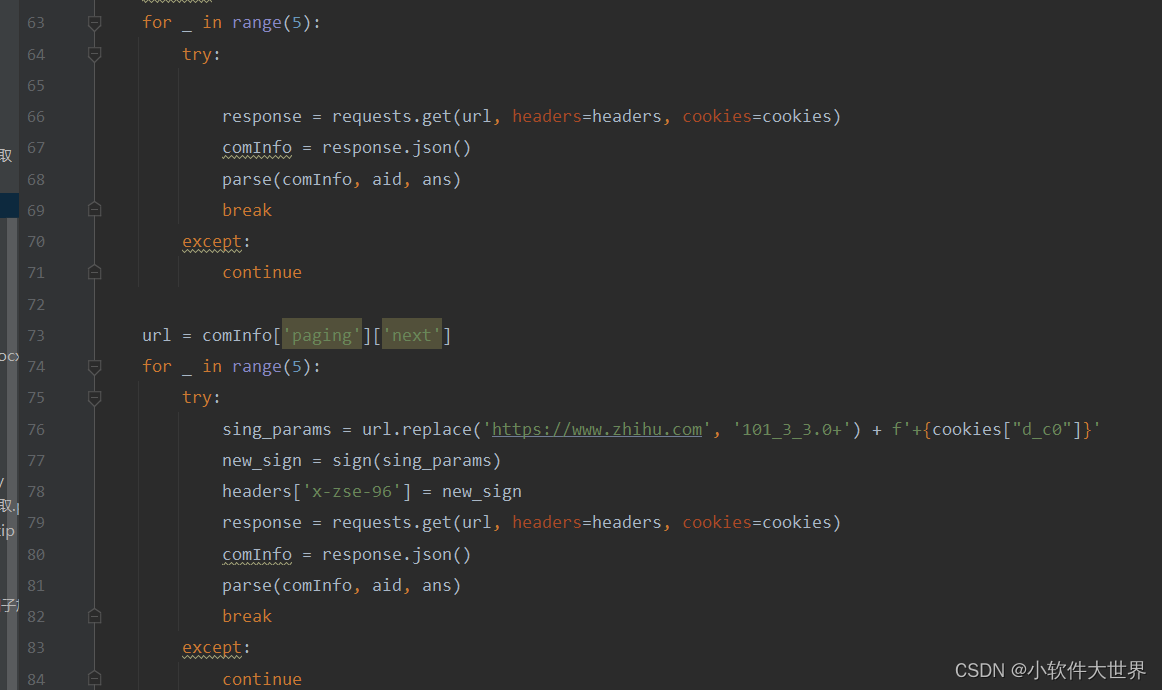
5、最后获得结果

【做了一些补环境和逆向,具体的哥哥姐姐们可以详细研究下,文章只是简单写了一些,能完成基本的想要的任务,想要源码的哥哥姐姐们,可以私信或者评论区小留言哈,微偿哦,看到会给对应答复,谢谢大家支持,以后还会陆续更新新的内容】

相关推荐
傻啦嘿哟2 天前
高德地图POI爬虫:爬取商户与景点数据,做LBS应用
爬虫
weixin199701080163 天前
官方授权通道和灰色爬虫,做数据服务该选哪条路(附 python 源码)
c++·爬虫·python
正飞信息技术4 天前
llms.txt部署指南:给AI爬虫一张清晰的网站地图
人工智能·爬虫
NeoGressAI外贸数字化5 天前
外贸独立站robots.txt怎么写:6个AI爬虫放行规则
人工智能·爬虫
OnlineProxy5 天前
移动应用数据爬取:通过模拟器与流量嗅探对 API 进行逆向工程
爬虫·python·httpx
傻啦嘿哟5 天前
分布式爬虫架构:Redis+Scrapy打造企业级爬虫系统
分布式·爬虫·架构
梯度下降者6 天前
零基础入门Python 爬虫
爬虫·python·数据分析·入门指南·webcrawler
2601_967979126 天前
0 到 1 学爬虫:用 Python 爬取网页数据指南一(附实战案例)
爬虫·python·实战案例·html解析·网页数据
姚瑞南6 天前
【PRD】招投标商机雷达爬虫系统
人工智能·经验分享·笔记·爬虫·产品运营·产品经理
嫂子的姐夫7 天前
055-wasm:爬虫练习网spa15(token 纯算还原)
爬虫·wasm