Prompt-Free Diffusion: Taking “Text” out of Text-to-Image Diffusion Models

  1. 问题引入
  • 在SD模型的基础之上,去掉text prompt,使用reference image作为生成图片语义的指导,optional structure image作为生成图片structure的指导来进行生成;
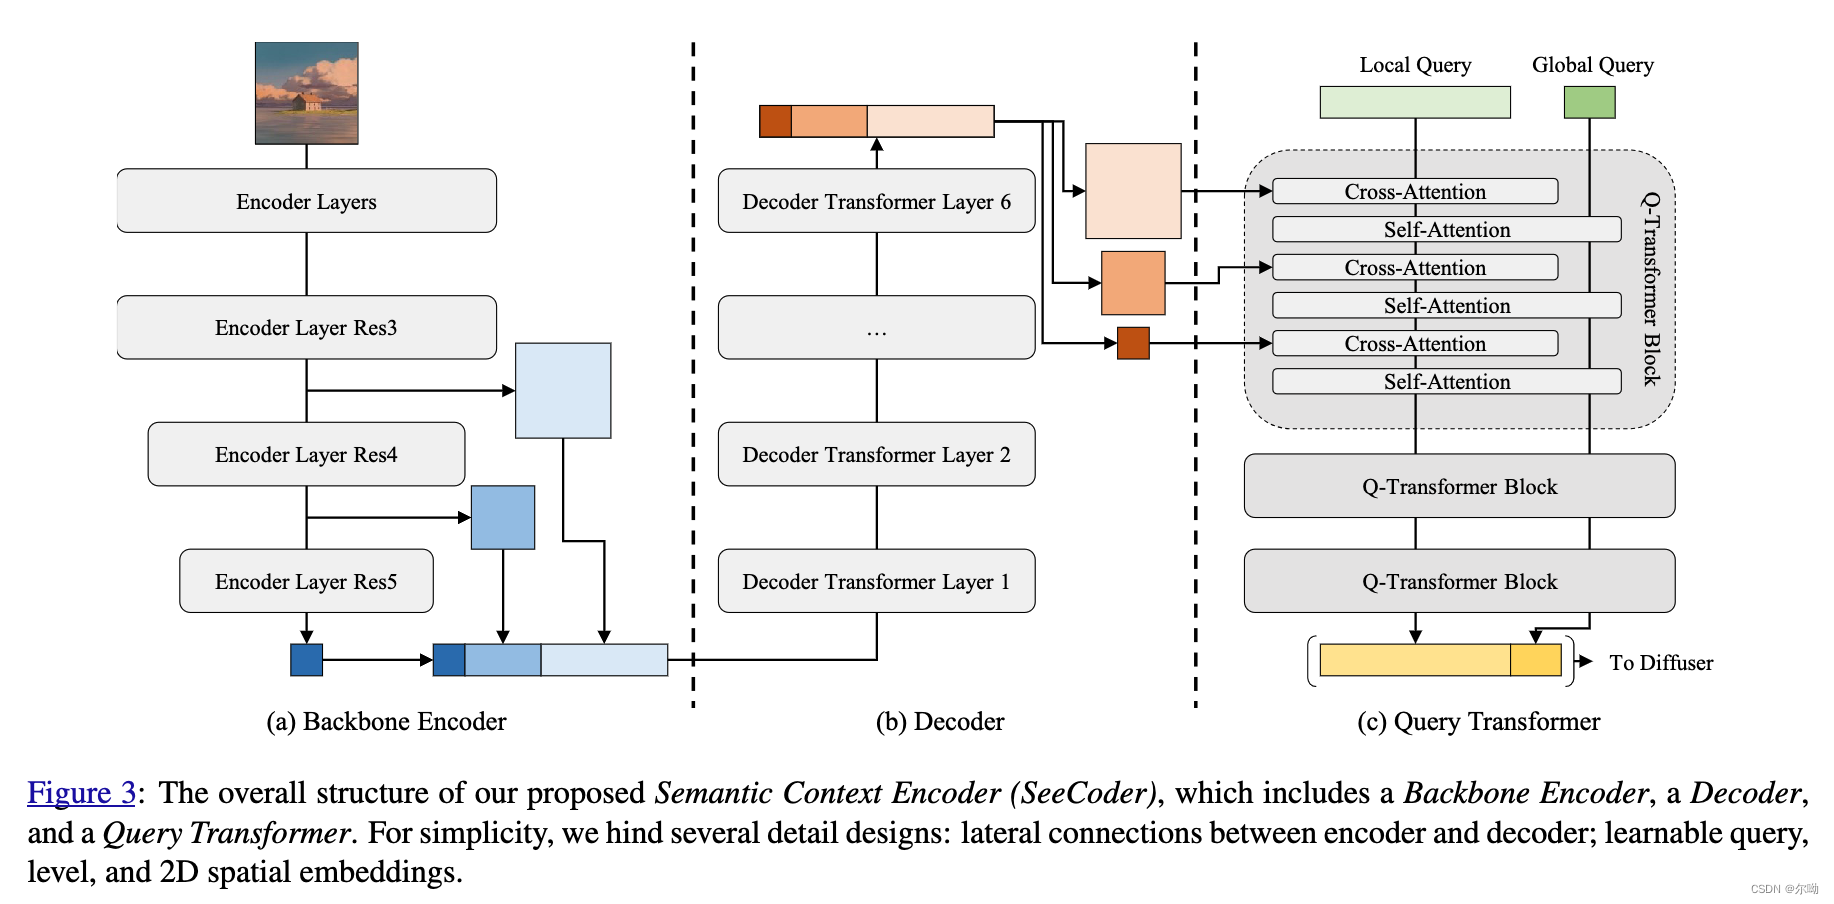
  • 使用SeeCoder来提取参考图片的embedding作为生成条件,且SeeCoder是可以重复使用的,可以直接集成到另外的T2I模型中;
  1. methods
  • 使用SeeCoder代替CLIP text embedding;
  • SeeCoder包含三个部分,Backbone Encoder, Decoder, and Query Transformer,其中Backbone Encoder使用SWIN-L提取多尺度特征,该部分参数是冻结的;之后decoder使用卷积来使得多尺度特征通道数相同,然后进行flatten+concat,得到的结果通过self attn + ffn;之后Query Transformer输出视觉embedding;
相关推荐
量子-Alex8 小时前
【大模型后训练SFT】Finetuning with Sampling: SFT Learns Better Than You Think
人工智能·深度学习·机器学习
ForDreamMusk8 小时前
Transformer Encoder Block
人工智能·深度学习·transformer
打工仔折腾 AI8 小时前
LLaMA 1 到 LLaMA 3 架构演进拆解:从 RoPE、GQA 到词表扩张
人工智能·后端·python·深度学习·langchain·llama
这张生成的图像能检测吗10 小时前
(论文速读)LINN:液体神经网络与脉冲神经元融合的可解释旋转机械故障诊断
人工智能·深度学习·神经网络·故障诊断
东方佑10 小时前
v24 (Hybrid2Fast) 架构与实验报告
人工智能·深度学习·语言模型·自然语言处理·架构
龍德明宇11 小时前
无摩擦的智能与有重力的主体-龍德明宇
人工智能·深度学习·ai哲学·负主体性·ai存在论
成为深度学习高手13 小时前
SEMixer:以随机注意力增强patch语义、渐进混合多尺度的轻量长期时序预测模型
人工智能·深度学习·机器学习·数据挖掘·时间序列
阡陌数智14 小时前
大模型领域自适应微调:小样本场景下过拟合抑制与数据构建方法论
人工智能·深度学习·机器学习
超大青花鱼15 小时前
Ubuntu20.04安装CUDA11.8教程
人工智能·深度学习·计算机视觉
Ivanqhz16 小时前
BURG(自底向上重写生成器)
服务器·数据库·人工智能·深度学习·算法