LLMs之gptpdf:gptpdf的简介、安装和使用方法、案例应用之详细攻略
目录
[第一步,使用 PyMuPDF 库,对 PDF 进行解析出所有非文本区域,并做好标记,比如:](#第一步,使用 PyMuPDF 库,对 PDF 进行解析出所有非文本区域,并做好标记,比如:)
[第二步,使用视觉大模型(如 GPT-4o)进行解析,得到 markdown 文件。](#第二步,使用视觉大模型(如 GPT-4o)进行解析,得到 markdown 文件。)
gptpdf的简介
gptpdf是一款主要使用视觉大语言模型(如 GPT-4o)将 PDF 解析为 markdown。我们的方法非常简单(只有293行代码),但几乎可以完美地解析排版、数学公式、表格、图片、图表等。每页平均价格仅需0.013 美元,我们使用 GeneralAgent lib 与 OpenAI API 交互。pdfgpt-ui 是一个基于 gptpdf 的可视化工具。
Github地址 :GitHub - CosmosShadow/gptpdf: Using GPT to parse PDF
1、 处理流程
第一步,使用 PyMuPDF 库,对 PDF 进行解析出所有非文本区域,并做好标记,比如:
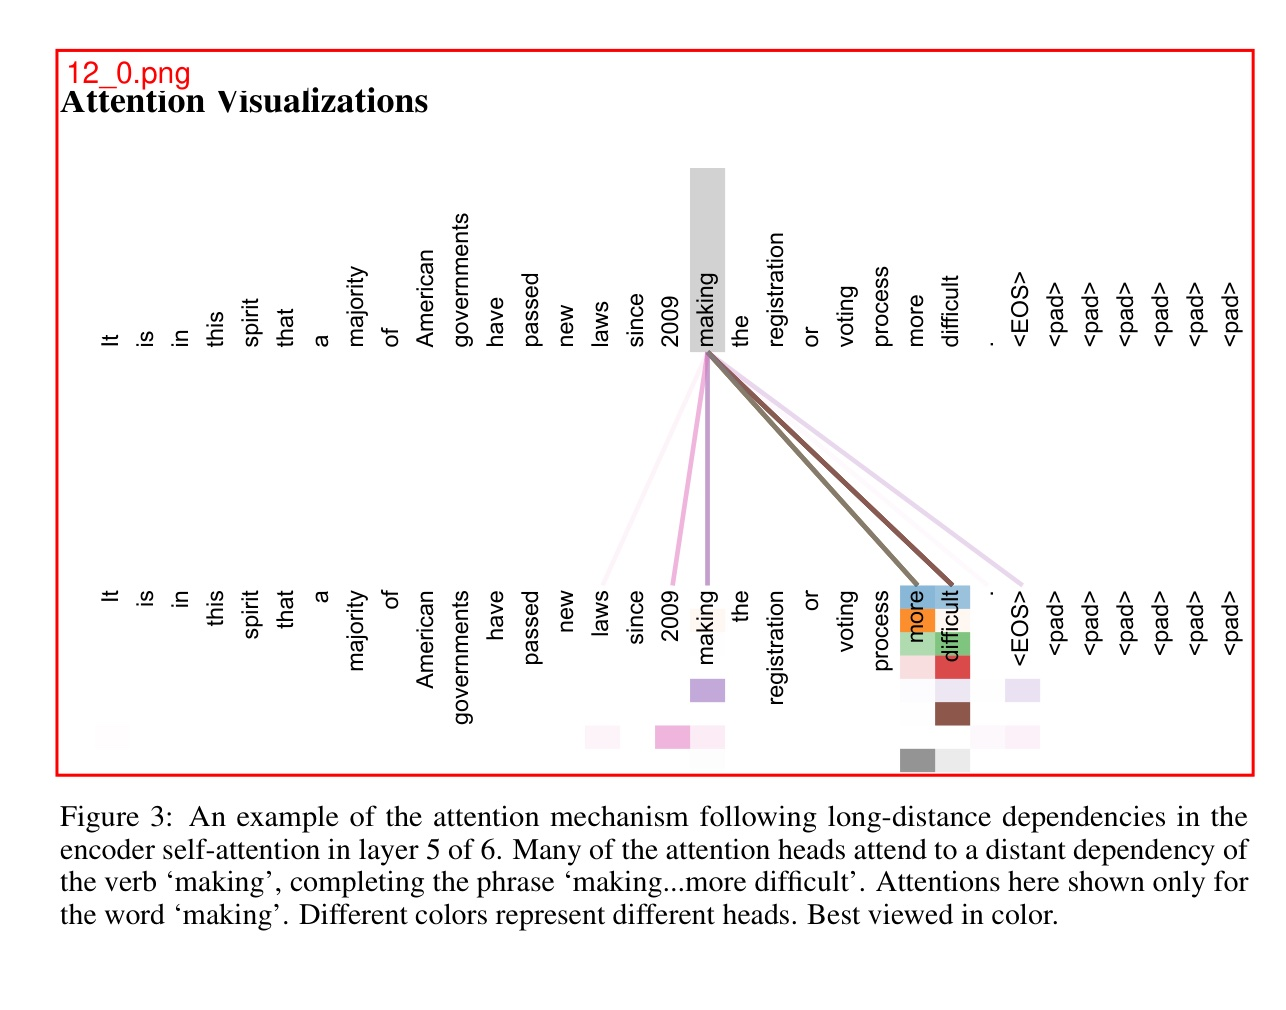
第二步,使用视觉大模型(如 GPT-4o)进行解析,得到 markdown 文件。
gptpdf的安装和使用方法
1、 安装
pip install gptpdf2、 使用
python
from gptpdf import parse_pdf

api_key = 'Your OpenAI API Key'
content, image_paths = parse_pdf(pdf_path, api_key=api_key)
print(content)
更多内容请见 test/test.py
地址:https://github.com/CosmosShadow/gptpdf/blob/main/test/test.py
解读test.py代码
python
import os

# 从 .env 文件中加载环境变量
import dotenv
dotenv.load_dotenv()

def test_use_api_key():
    from gptpdf import parse_pdf
    pdf_path = '../examples/attention_is_all_you_need.pdf'
    output_dir = '../examples/attention_is_all_you_need/'
    # 从环境变量中获取 OPENAI_API_KEY 和 OPENAI_API_BASE
    api_key = os.getenv('OPENAI_API_KEY')
    base_url = os.getenv('OPENAI_API_BASE')
    # 手动提供 OPENAI_API_KEY 和 OPENAI_API_BASE
    content, image_paths = parse_pdf(pdf_path, output_dir=output_dir, api_key=api_key, base_url=base_url, model='gpt-4o', gpt_worker=6)
    # 输出解析后的内容和图像路径
    print(content)
    print(image_paths)
    # 同时会生成 output_dir/output.md 文件

def test_use_env():
    from gptpdf import parse_pdf
    pdf_path = '../examples/attention_is_all_you_need.pdf'
    output_dir = '../examples/attention_is_all_you_need/'
    # 使用环境变量中的 OPENAI_API_KEY 和 OPENAI_API_BASE
    content, image_paths = parse_pdf(pdf_path, output_dir=output_dir, model='gpt-4o', verbose=True)
    # 输出解析后的内容和图像路径
    print(content)
    print(image_paths)
    # 同时会生成 output_dir/output.md 文件

def test_azure():
    from gptpdf import parse_pdf
    # Azure API Key
    api_key = '8ef0b4df45e444079cd5a4xxxxx'
    # Azure API 基础 URL
    base_url = 'https://xxx.openai.azure.com/'
    # Azure 部署的模型 ID 名称(不是 OpenAI 模型名称)
    model = 'azure_xxxx'

    pdf_path = '../examples/attention_is_all_you_need.pdf'
    output_dir = '../examples/attention_is_all_you_need/'
    # 使用提供的 Azure API Key 和基础 URL
    content, image_paths = parse_pdf(pdf_path, output_dir=output_dir, api_key=api_key, base_url=base_url, model=model, verbose=True)
    # 输出解析后的内容和图像路径
    print(content)
    print(image_paths)

if __name__ == '__main__':
    # 取消注释以运行特定的测试函数
    # test_use_api_key()
    # test_use_env()
    test_azure()
3、API
parse_pdf (pdf_path, output_dir='./', api_key=None, base_url=None, model='gpt-4o', verbose=False)
将 pdf 文件解析为 markdown 文件,并返回 markdown 内容和所有图片路径列表。
-
pdf_path:pdf 文件路径
-
output_dir:输出目录。存储所有图片和 markdown 文件
-
api_key:OpenAI API 密钥(可选)。如果未提供,则使用 OPENAI_API_KEY 环境变量。
-
base_url:OpenAI 基本 URL。(可选)。如果未提供,则使用 OPENAI_BASE_URL 环境变量。
-
model :OpenAI API格式的多模态大模型,默认为 "gpt-4o"。 如果您需要使用其他模型,例如 qwen-vl-max (尚未测试)
GLM-4V, 可以通过修改环境变量
OPENAI_BASE_URL或 指定API参数base_url来使用。 (已经测试)您也可以通过将
base_url指定为https://xxxx.openai.azure.com/来使用 Azure OpenAI,api_key 是 Azure API 密钥,模型类似于 'azure_xxxx',其中 xxxx 是部署的模型名称(不是 openai 模型名称)(已经测试) -
verbose:详细模式
-
gpt_worker: gpt解析工作线程数,默认为1. 如果您的机器性能较好,可以适当调高,以提高解析速度。
gptpdf的案例应用
持续更新中......