搜索引擎中的相关性模型

一、什么是相关性模型?

相关性模型主要关注的是query和doc的相关性。例如给定query,和1000个doc,找到哪个doc是好query最相关的。

二、为什么需要相关性模型?

熟悉es的应该都熟悉BM25相关性算法。它是一个很简单的相关性算法。我们实际使用中,经常会遇到一个问题就是如何。搜的内容和我给定的query不相关。换句话说,返回的结果不包含先要的结果。

相关性是一个复杂的问题。不是简单的Bm25算法。我们需要相关性模型来更好的做这件事。

三、相关性模型

交叉BERT模型,准确性好,推理代价大,更适合用在粗排或者精排阶段。

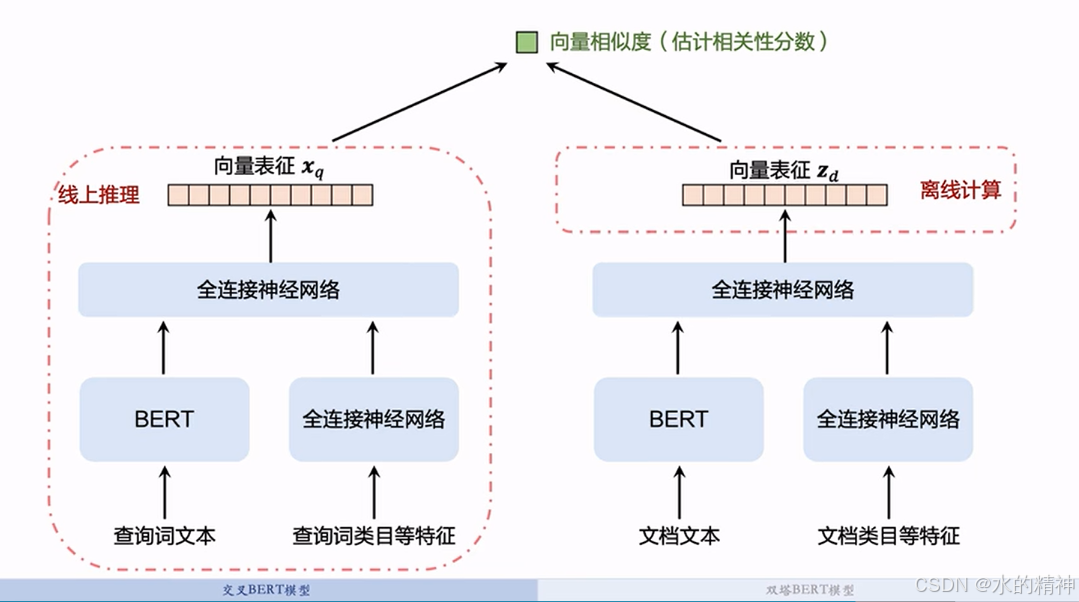
双塔BERT模型,不够准确,但是推理代价小。适合用来召回阶段。

3.1 交叉BERT模型
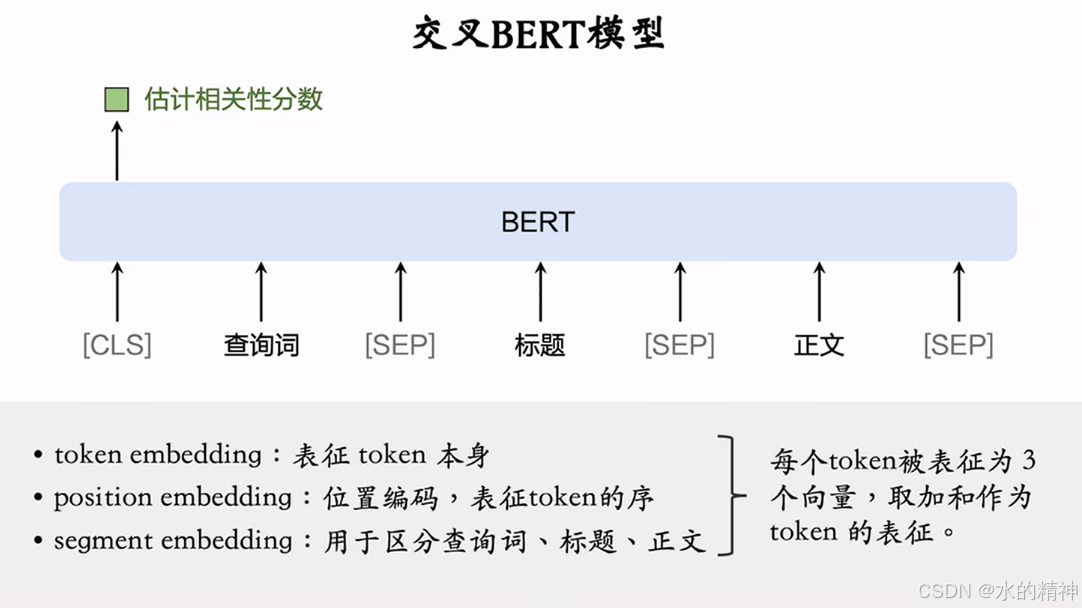
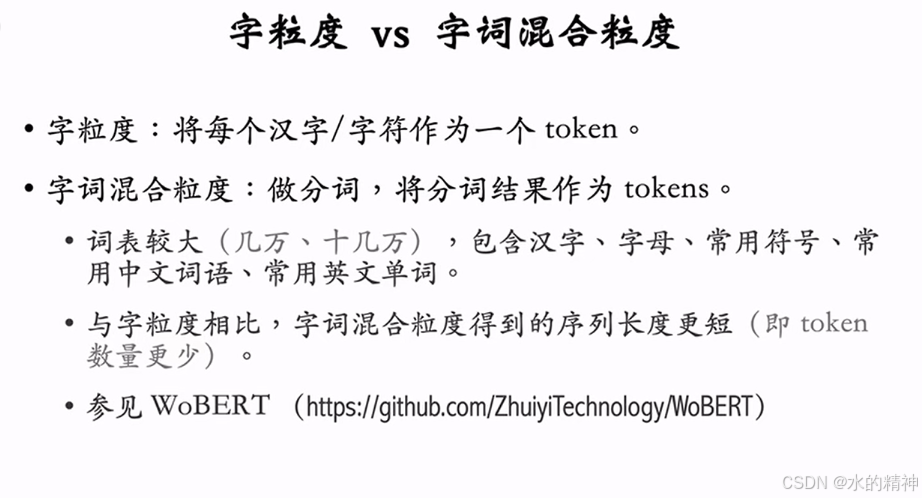
分词:字粒度与词粒度
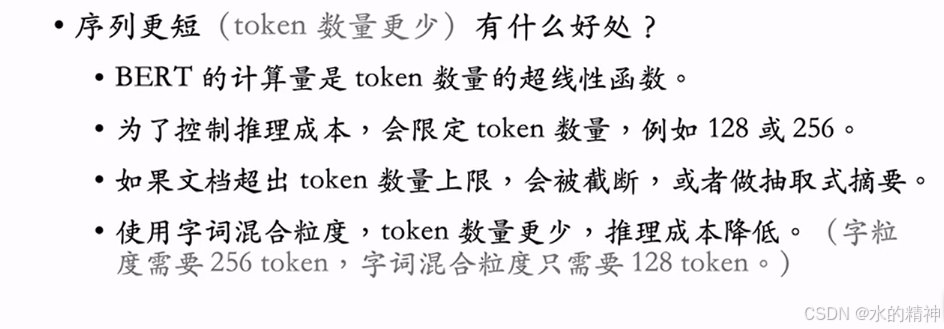
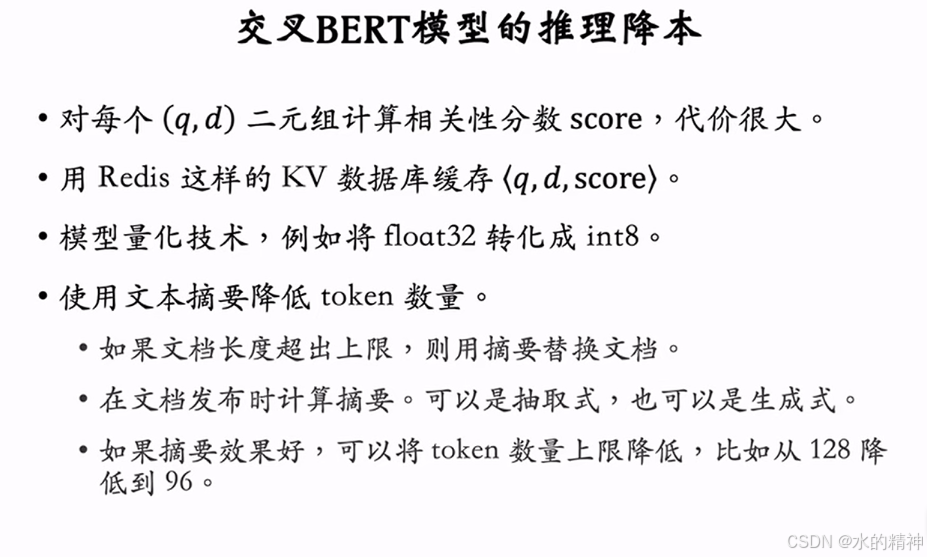
如何减低交叉BERT模型的推理成本
3.2 双塔BERT模型
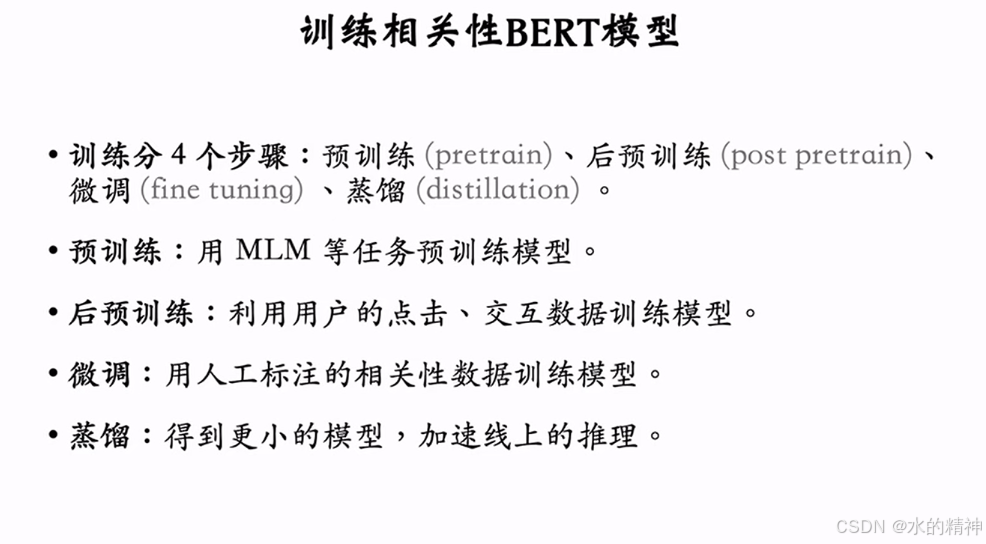
四、训练相关性模型
4.1 微调
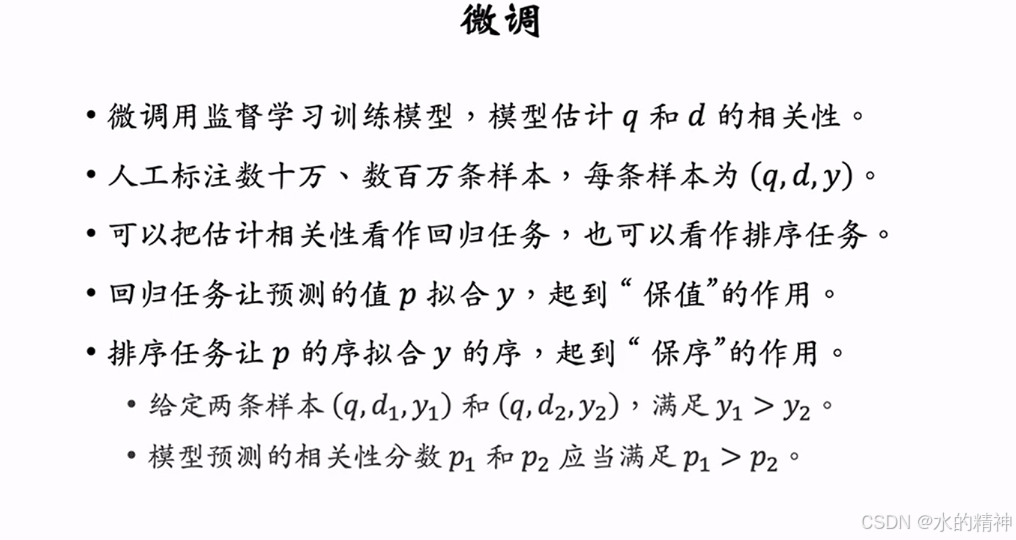
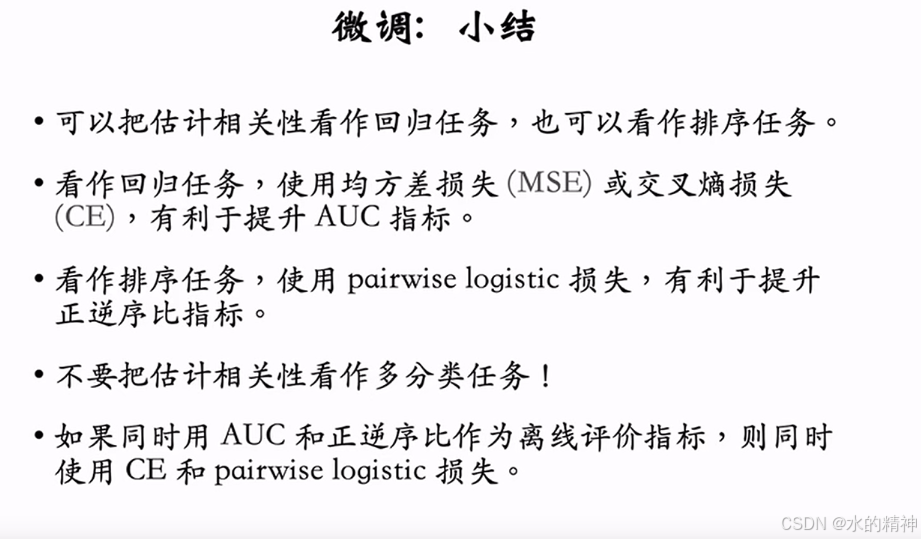
回归任务
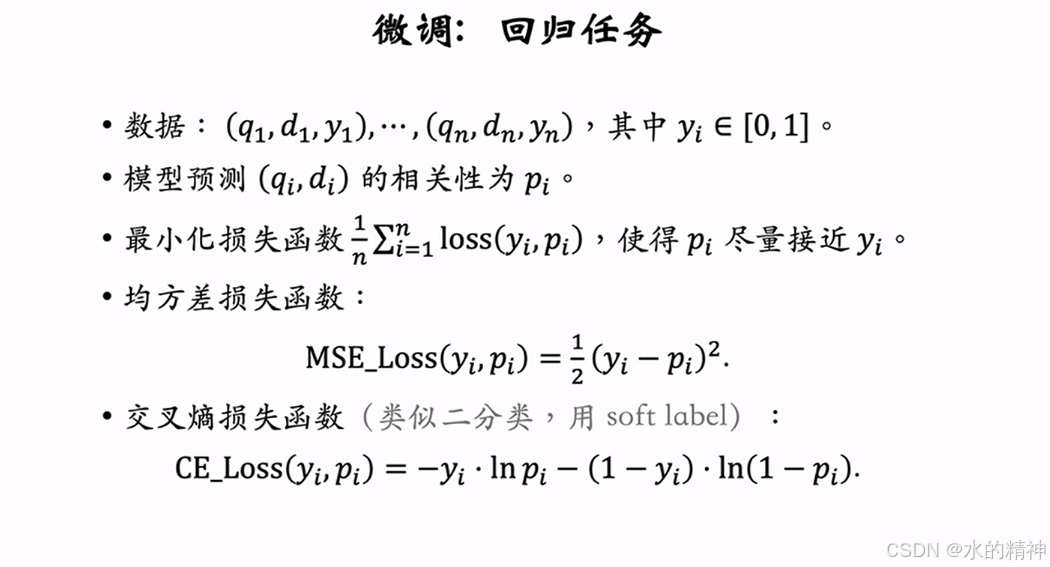
排序任务
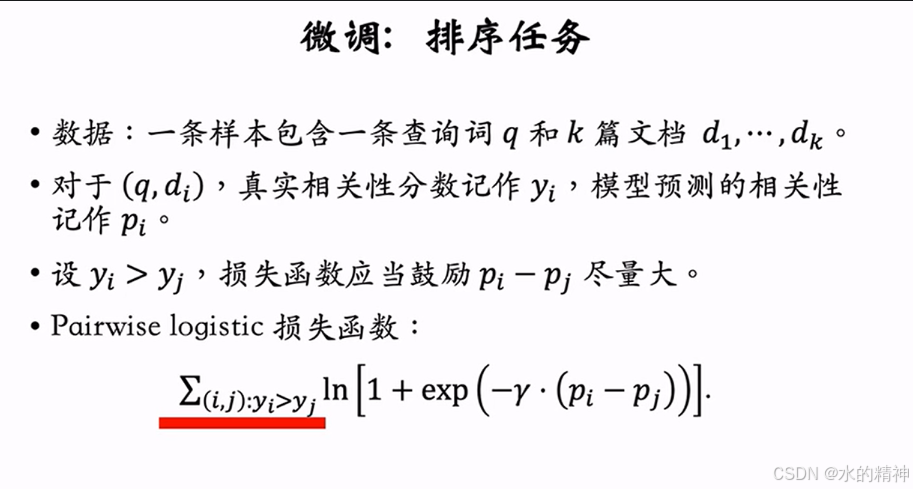
4.2 后预训练

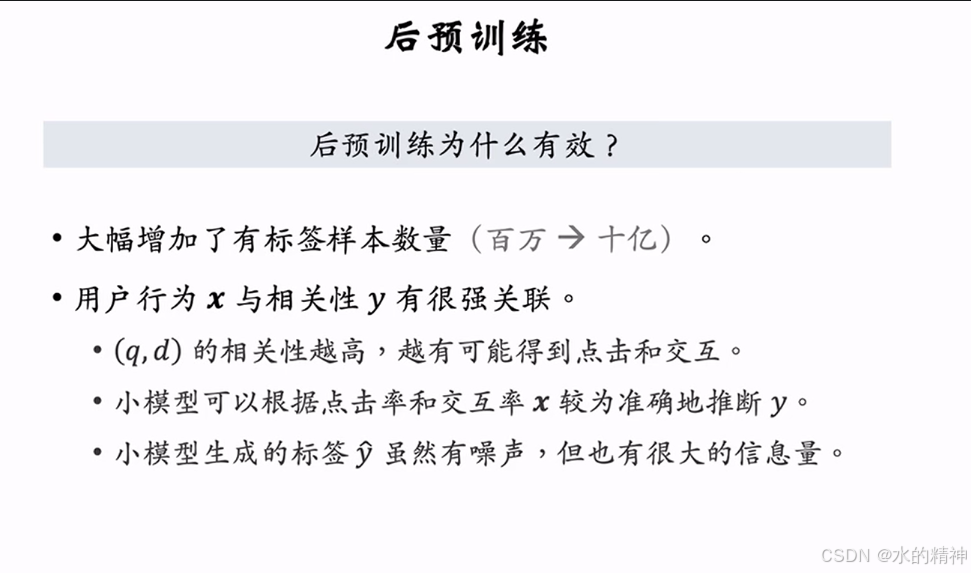
从事发后,从以发生的事中,去再提升当前的能力。通过用户的点击行为来有优化模型。
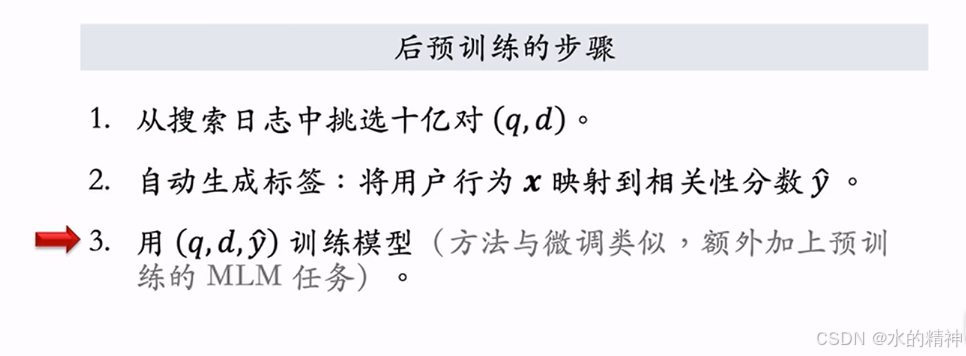
4.2.1 数据筛选
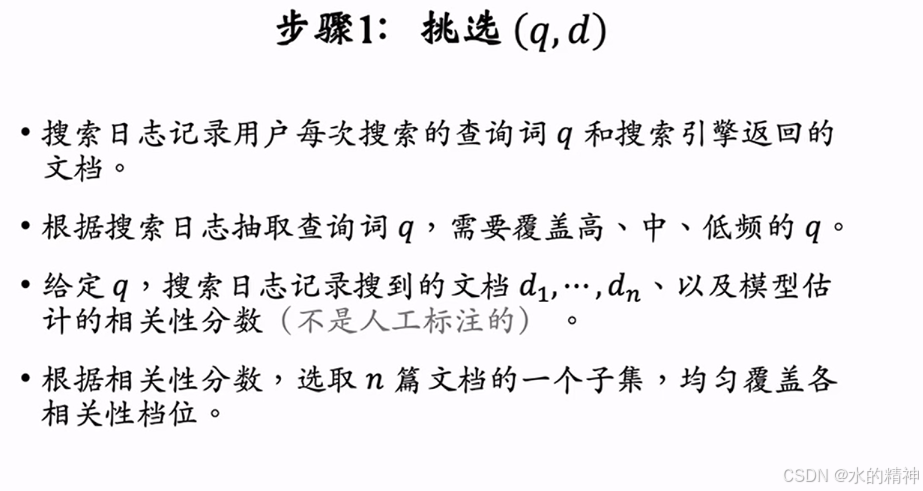
4.2.2 后训练,构造训练数据

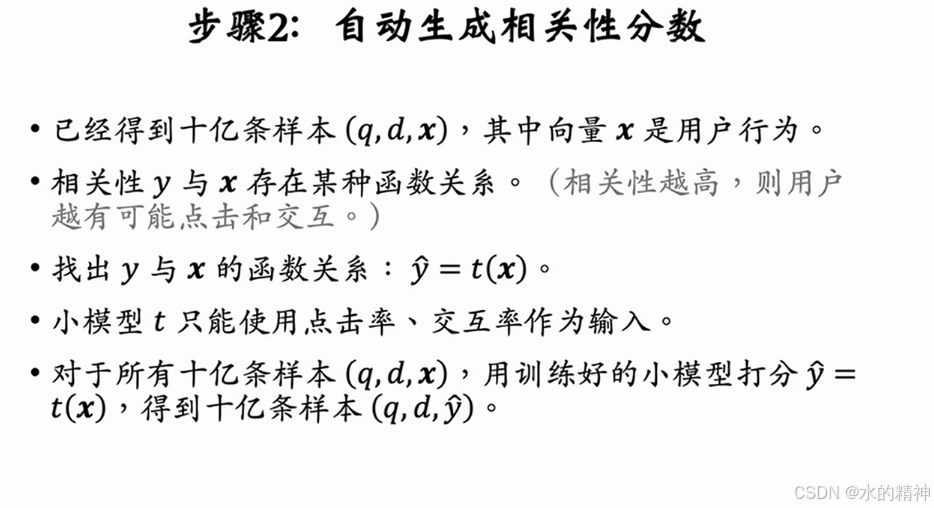
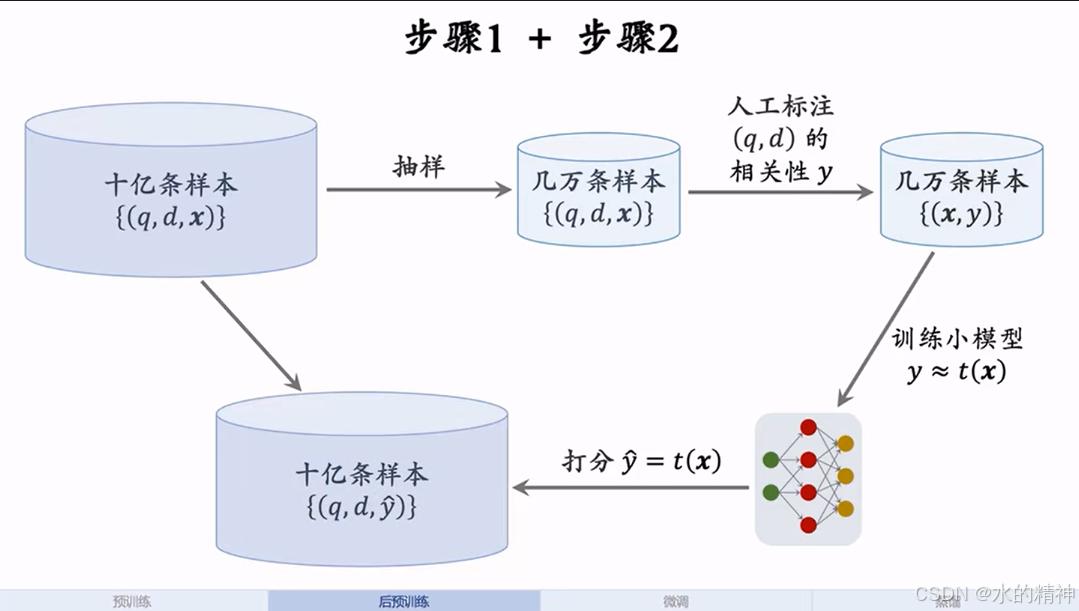
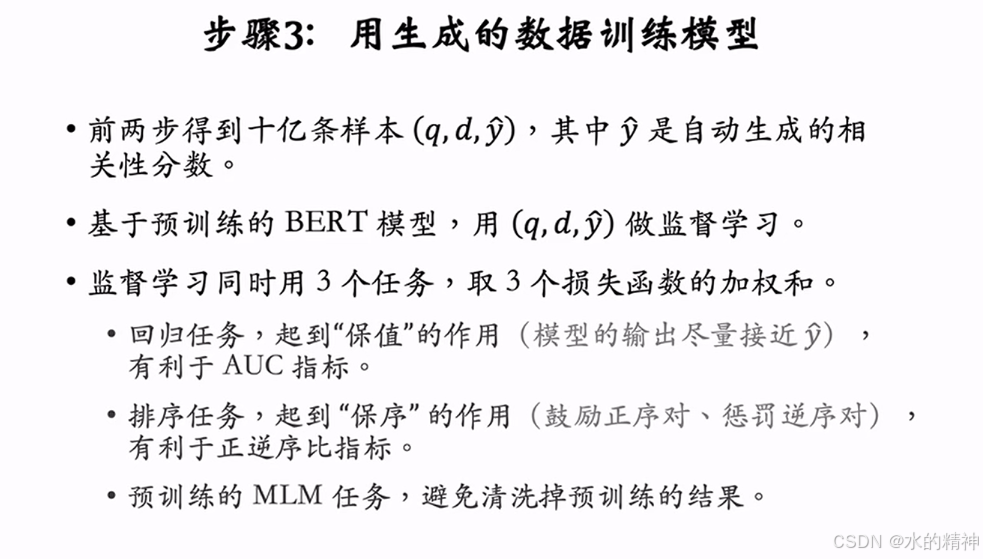
挑选用户的点击数据。得到query,topk的doc,以及用户的点击行为x。然后抽样几万条数据,去人工标注,标注得到相关性y,然后用这几万条数据去训练一个小模型来计算点击行为x和相关性y的关系。然后再用这个小模型去预测10亿条数据的相关性分数。
4.3 蒸馏

蒸馏是把一个大模型变成一个小模型。为什么要蒸馏,模型越大,推理成本越大,时间成本也越大,当然也越准确。

4.3.1 为什么要蒸馏?
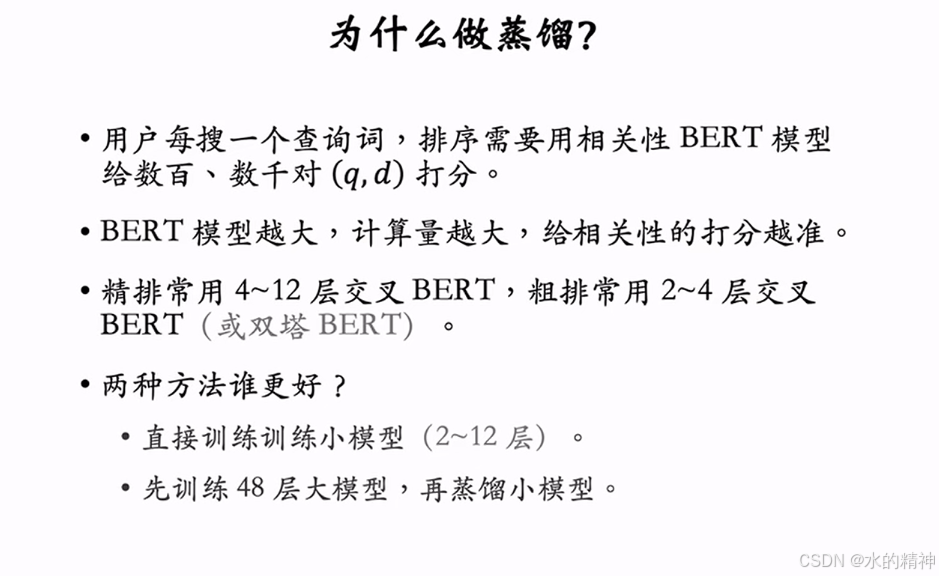
用大模型,蒸馏得到小模型,最终的效果比直接训练一个小模型得到的效果更好。

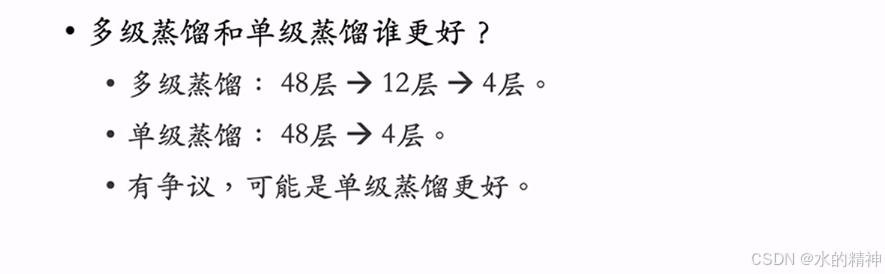
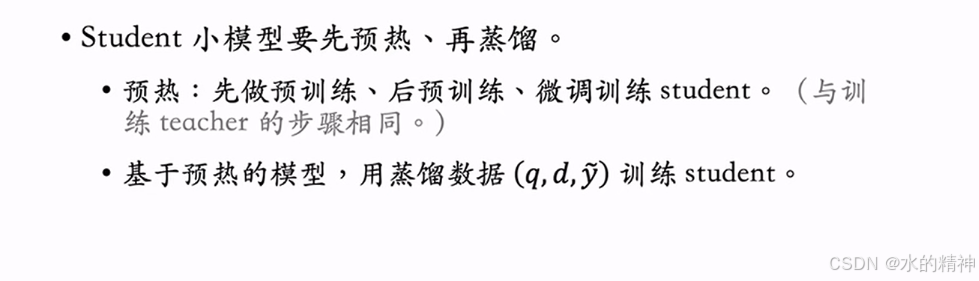
4.3.2 如何做蒸馏
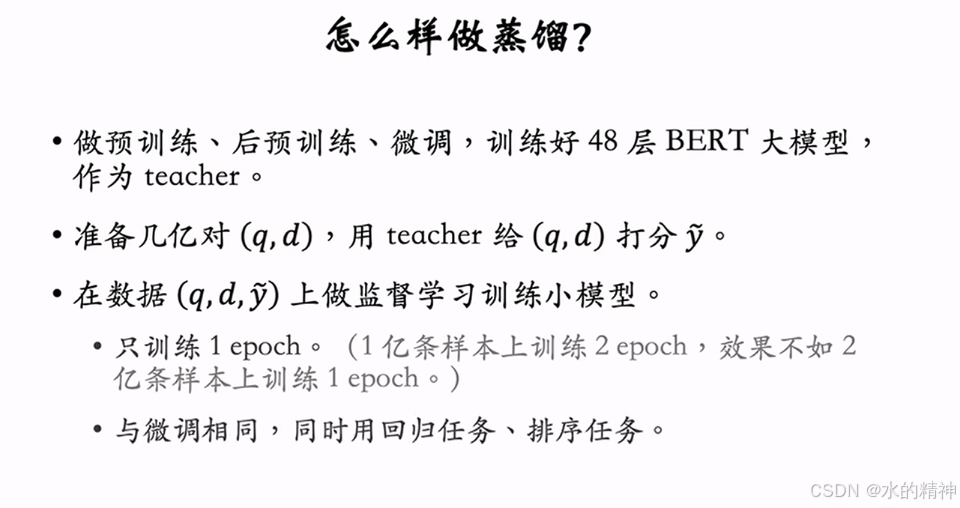
蒸馏的技巧
相关推荐
喵个咪4 天前
GoWind CMS 拆解:搜索三板斧——高亮、联想、同义词
后端·搜索引擎·go
Elastic 中国社区官方博客4 天前
更少的位数,相同的召回率:DiskBBQ 更保守的自动校准扫描
大数据·运维·开发语言·人工智能·elasticsearch·搜索引擎
翊众建站11 天前
用 JSON-LD 给企业官网做结构化数据:LocalBusiness 与 FAQPage 实践笔记
人工智能·搜索引擎·json
fengye20716111 天前
第三章 编译cpython
大数据·elasticsearch·搜索引擎
Elastic 中国社区官方博客11 天前
AgentHack Shanghai|基于阿里云AI搜索 Elasticsearch x Qoder 构建AI Agent应用
大数据·人工智能·elasticsearch·搜索引擎·阿里云·云计算·全文检索
真上帝的左手11 天前
30. 技术专题-‌应用框架组件-搜索引擎-ES
大数据·分布式·elasticsearch·搜索引擎·中间件
极限实验室12 天前
Easysearch 布尔查询子句重排序(二)|ConjunctionDISI 按 cost 排序源码解析
后端·搜索引擎·性能优化
Elastic 中国社区官方博客12 天前
基于 Elasticsearch 与 Jina AI 的全模态智能搜索实践:技术全解析
大数据·人工智能·elasticsearch·搜索引擎·ai·信息可视化·jina
Sayai12 天前
Elasticsearch ingest pipeline 被禁用之后:性能代价、安全治理与数据入库时间的四种替代方案
大数据·运维·安全·elasticsearch·搜索引擎·性能优化
LaughingZhu12 天前
Product Hunt 热榜 2026-11-02:Screen Studio 4.0、ClawsGO Science、Riverside Agents
人工智能·深度学习·神经网络·数码相机·搜索引擎·百度