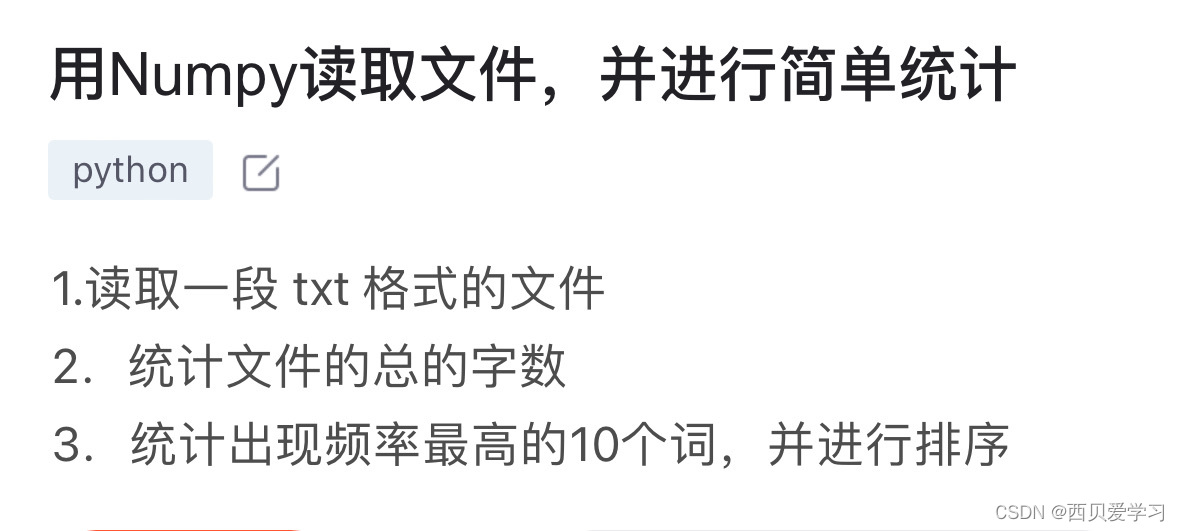
我们需要编写一个脚本来读取文本文件,然后进行字数统计和词频统计。
以下是一个简单的Python脚本,它使用numpy来处理数据。
首先,确保你已经安装了numpy库。如果没有安装,可以通过运行pip install numpy来安装。
然后,你可以使用以下脚本:
import numpy as np
import re
from collections import Counter
假设你的文本文件名为'file.txt'
file_path = 'file.txt'
1. 读取文件
with open(file_path, 'r', encoding='utf-8') as file:
text = file.read()
2. 统计文件的总字数
total_words = len(text.split())
print(f'Total number of words: {total_words}')
3. 统计出现频率最高的10个词,并进行排序
使用正则表达式来找到单词,这里假设单词由字母组成
words = re.findall(r'\b\w+\b', text.lower())
word_counts = Counter(words)
获取出现频率最高的10个词
most_common_words = word_counts.most_common(10)
print('Most common words:')
for word, count in most_common_words:
print(f'{word}: {count}')
如果你想使用numpy来处理数据,你可以将文本转换为numpy数组,但这在这个例子中是多余的
text_array = np.array(text)
请将file.txt替换为你的文件名。这个脚本首先读取文件内容,然后统计总字数,接着使用正则表达式来找到所有的单词,并使用collections.Counter来统计每个单词的出现次数,最后输出出现频率最高的10个词。
请注意,这个脚本假设文本文件是UTF-8编码的。如果你的文件使用不同的编码,请相应地更改open函数中的encoding参数。