【爬虫脚本】实现批量pdf文件下载
xlwin136 人工智能教学实践 2025年03月30日 14:09
【爬虫脚本】实现批量pdf文件下载
python
import requests
from bs4 import BeautifulSoup
import os
from urllib.parse import urljoin, unquote
import re
import chardet
import signal

# 修复Ctrl+C中断问题
signal.signal(signal.SIGINT, lambda sig, frame: exit(0))


def download_all_pdfs(url, save_dir='downloads'):
    os.makedirs(save_dir, exist_ok=True)
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'}

    try:
        # 自动检测网页编码
        response = requests.get(url, headers=headers, timeout=10)
        encoding = chardet.detect(response.content)['encoding'] or 'gbk'
        response.encoding = encoding  # 关键修复

        soup = BeautifulSoup(response.text, 'html.parser')

        for link in soup.find_all('a', href=re.compile(r'\.pdf$')):
            try:
                # 双保险文件名提取
                filename = link.get('title', '').strip() or unquote(link['href'].split('/')[-1])

                # 多层解码处理
                for _ in range(3):
                    filename = unquote(filename)

                # 清洗文件名
                filename = re.sub(r'[\\/*?:"<>|]', '_', filename)  # 替换非法字符
                filename = filename.replace(' ', '_')  # 替换空格
                filename = filename.replace('、', '_')  # 替换全角符号

                # 确保扩展名正确
                if not filename.endswith('.pdf'):
                    filename += '.pdf'

                # 唯一文件名处理
                counter = 1
                base, ext = os.path.splitext(filename)
                while os.path.exists(os.path.join(save_dir, filename)):
                    filename = f"{base}_{counter}{ext}"
                    counter += 1

                save_path = os.path.join(save_dir, filename)

                # 检查并下载
                if os.path.exists(save_path):
                    print(f"跳过已存在文件:{filename}")
                    continue

                full_url = urljoin(url, link['href'])
                with requests.get(full_url, headers=headers, stream=True, timeout=15) as r:
                    r.raise_for_status()
                    with open(save_path, 'wb') as f:
                        for chunk in r.iter_content(chunk_size=8192):
                            f.write(chunk)

                print(f"成功下载:{filename}")

            except Exception as e:
                print(f"下载失败:{full_url},原因:{str(e)}")

    except requests.exceptions.RequestException as e:
        print(f"网页请求失败:{e}")


if __name__ == "__main__":
    target_url = 'http://www.hebeea.edu.cn/html/mtyj/2025/0211-193727-999.html'
    download_all_pdfs(target_url)
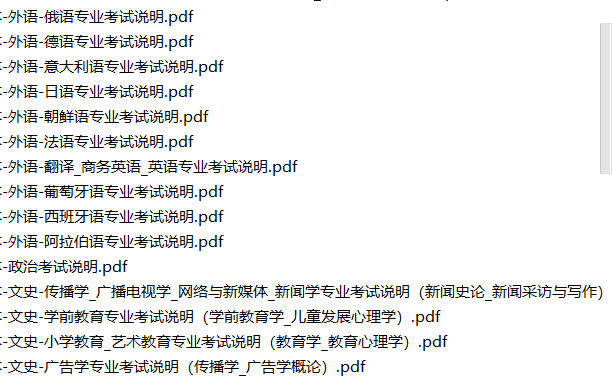
下载了一堆考试说明文档